Comparatif de 10 outils de validation big data
|
10
minute de lecture

Les meilleurs outils de validation big data ne sont pas ceux qui affichent la plus longue liste de fonctionnalités. Une plateforme peut proposer du profilage, des alertes, du lignage et des dizaines de connecteurs, tout en laissant une équipe finance incapable de prouver qu'une règle critique sur les transactions a bien été exécutée, où un contrôle en échec a tourné ou qui est responsable de l'exception.
La validation à grande échelle recouvre des problèmes différents. Les règles métier au niveau de l'enregistrement vérifient que les valeurs et les relations ont un sens. La détection statistique d'anomalies repère les distributions inhabituelles. La surveillance de la fraîcheur détecte les chargements en retard ou manquants. Le suivi de schéma identifie les changements structurels. Les tests de migration comparent les résultats entre systèmes, tandis que le lignage et la surveillance de la santé des plateformes éclairent l'impact et le contexte opérationnel. Ces contrôles se recoupent, mais ils ne sont pas interchangeables. Cette distinction est au cœur de la question de l'importance des tests de validation.
Ce comparatif évalue dix outils selon le périmètre de validation, le modèle d'exécution, le déploiement, la responsabilité opérationnelle, l'effort de mise en œuvre, la gouvernance, la transparence tarifaire et l'adéquation aux cas d'usage. Il considère aussi les tests à base de règles et l'observabilité automatisée comme des approches complémentaires plutôt que concurrentes. digna est une option pertinente pour les équipes qui ont besoin de validation et d'observabilité directement dans la base de données, au sein de leur propre infrastructure, mais ce n'est pas le gagnant universel pour tous les patrimoines de données.
Table des matières
1. Data Validation
La place de digna sur le plan opérationnel
Points forts et compromis
2. Great Expectations, GX Cloud et open source
3. Soda, Soda Core et Soda Cloud
4. Monte Carlo
5. Anomalo
6. Bigeye
7. Datafold
8. AWS Deequ
9. Acceldata
10. Talend Data Quality, désormais intégré à Qlik Talend Cloud et Talend Data Fabric
Comparatif des 10 meilleurs outils de validation big data
Choisir l'outil en fonction de la défaillance à éviter
1. Data Validation
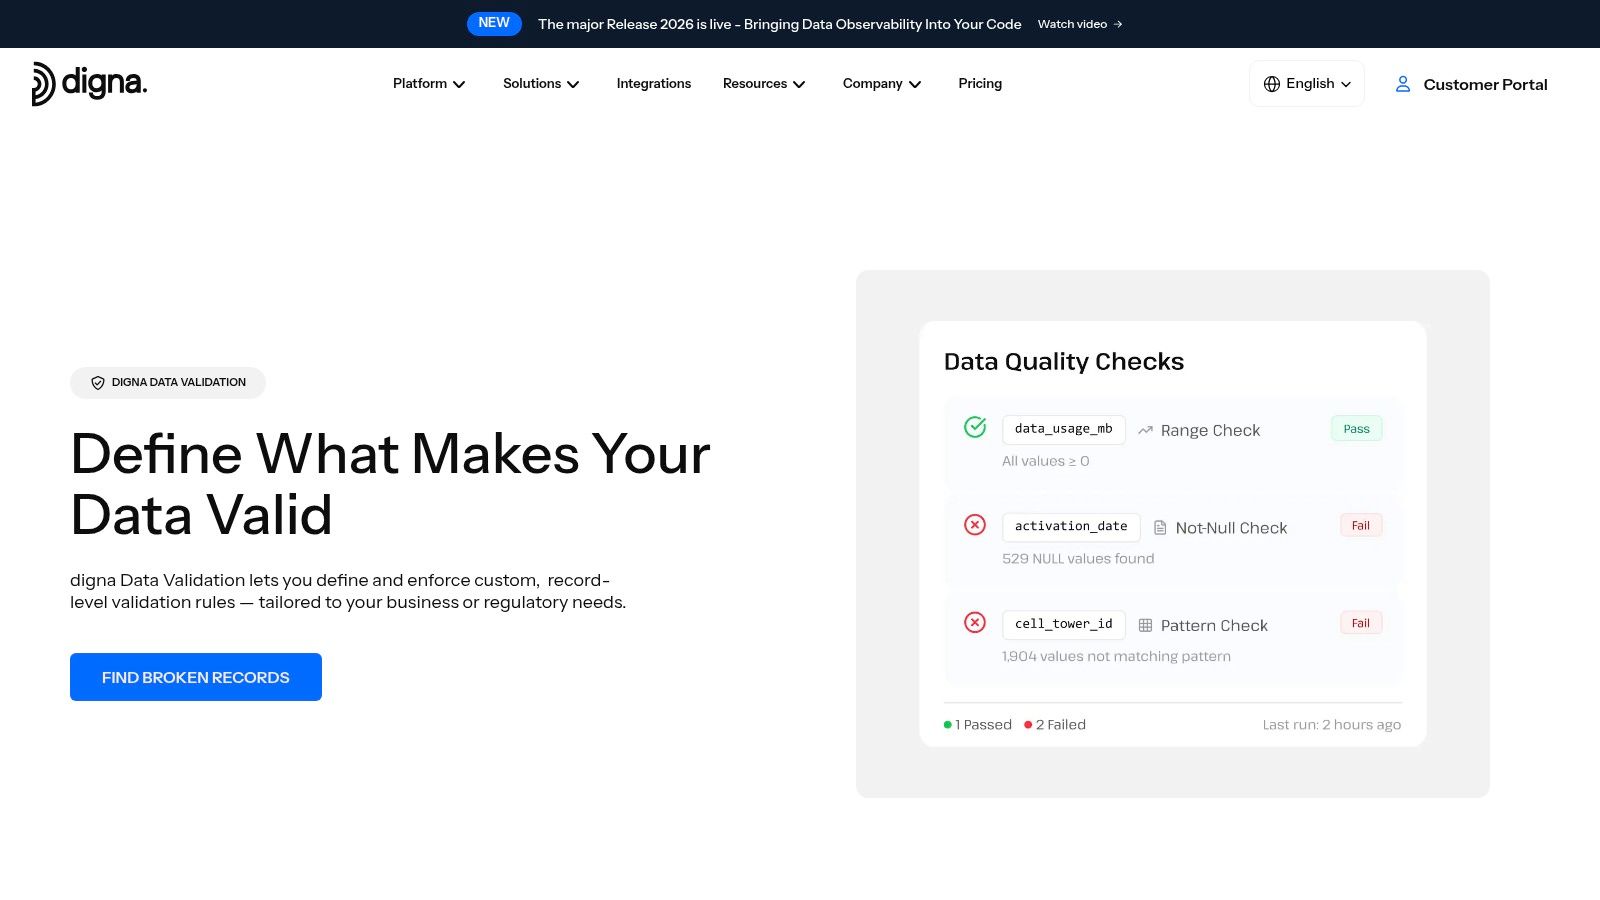
Le module Data Validation de digna répond au problème que les scores d'anomalie ne peuvent pas résoudre seuls : prouver que chaque enregistrement respecte une logique métier explicite. Les équipes peuvent définir des contrôles sur des valeurs exactes, des seuils, des plages, la gestion des valeurs nulles, des listes de référence et la cohérence entre colonnes, puis s'appuyer sur les résultats pour l'analytique, le reporting, les processus opérationnels et les revues réglementaires. La distinction est importante, car un jeu de données peut suivre un schéma statistique familier tout en enfreignant une règle métier critique.
La place de digna sur le plan opérationnel
digna effectue la validation et le calcul des métriques directement dans les bases de données du client, au lieu de déplacer les données de production vers un environnement de traitement externe. La solution s'exécute dans le cloud, le VPC ou le data center du client, ce qui rend ce modèle de déploiement pertinent pour les organisations soumises à des exigences strictes de résidence des données, d'accès ou de gouvernance. Sa documentation produit décrit une exécution sur des bases comme Teradata, Snowflake, Databricks et PostgreSQL, avec journalisation des résultats de réussite et d'échec et pistes d'audit.
Le module relie également les échecs au niveau de l'enregistrement à la détection d'anomalies par IA, au suivi de la ponctualité et au suivi de schéma. Cette corrélation peut être plus utile qu'une alerte isolée. Une règle en échec accompagnée d'un chargement tardif ou d'un changement structurel récent offre à l'enquêteur un bien meilleur point de départ qu'une règle en échec sans contexte.
Règle pratique : choisissez digna lorsque les preuves derrière un contrôle en échec comptent autant que l'alerte elle-même.
Points forts et compromis
Exécution dans la base de données : les données de production restent en place, ce qui limite leurs déplacements et aligne la validation sur les exigences de déploiement privé.
Contrôles prêts pour l'audit : les résultats au niveau de la ligne apportent des preuves pour les règles métier, le traitement des exceptions et les revues de conformité.
Incidents corrélés : anomalies, retards de livraison et changements de schéma peuvent être examinés en parallèle des échecs de validation.
Extension modulaire : les équipes peuvent commencer par les tables prioritaires, puis ajouter des modules de surveillance à mesure que la couverture s'étend.
Le compromis tient à la prise en charge de la mise en œuvre. digna nécessite un déploiement et une intégration avec les bases de données du client, ce qui peut exiger davantage de travail d'infrastructure qu'un service purement SaaS. La rédaction et la maintenance des règles restent également nécessaires, et une tarification par table active signifie que le coût et l'effort opérationnel peuvent croître avec la couverture. Les équipes qui l'évaluent devraient définir les responsables des tables et des règles, l'expiration des exceptions et les niveaux de service de remédiation avant tout déploiement à grande échelle.
Pour approfondir les modèles de mise en œuvre, consultez le guide de digna sur les règles de validation, les contrôles et la qualité continue des données. Rendez-vous sur la page produit Data Validation de digna pour connaître les modalités actuelles de déploiement et de licence.
2. Great Expectations, GX Cloud et open source
Great Expectations convient bien aux équipes qui veulent une validation déclarative à base de règles reposant sur un socle open source. Son modèle d'Expectations permet aux ingénieurs de définir des assertions sur les jeux de données, les colonnes, les distributions et les valeurs, puis d'exécuter ces suites sur des entrepôts SQL, des data lakes, des fichiers ou des dataframes. La séparation entre l'écriture des tests et la gestion des exécutions est utile aux équipes qui veulent des contrôles revus dans le code tout en disposant d'une vue opérationnelle partagée.
GX open source convient mieux aux équipes à l'aise avec la maintenance de workflows Python, de dépôts et d'une infrastructure d'exécution. GX Cloud ajoute la collaboration hébergée, l'historique des validations, les alertes et des workflows de gouvernance. Le produit est donc moins un choix de déploiement unique qu'un chemin allant des tests « code-first » vers des opérations managées.
La principale limite est l'effort de couverture. Un catalogue d'expectations bien fourni ne dispense pas de décider quelles règles sont critiques pour le métier, comment fonctionnent les exceptions et où les suites s'exécutent en production. La rédaction des règles peut devenir très chronophage lorsqu'un vaste patrimoine exige une couverture explicite sur de nombreuses tables. GX n'est pas non plus avant tout une plateforme d'observabilité automatisée : les équipes qui recherchent l'apprentissage de références, une intelligence sur la fraîcheur ou une corrélation étendue des incidents auront peut-être besoin de capacités complémentaires.
Pour situer le framework dans l'univers open source de la qualité des données, comparez-le avec la revue par digna des fonctionnalités des outils open source de qualité des données. Consultez les offres actuelles sur Great Expectations, surtout si la tarification, les limites de l'offre hébergée ou le packaging cloud pèsent sur vos achats.
3. Soda, Soda Core et Soda Cloud
Soda sépare le moteur d'exécution du plan de contrôle opérationnel. Soda Core et Soda Library permettent aux développeurs d'exprimer des contrôles en SodaCL, une syntaxe basée sur YAML conçue pour s'intégrer aux pipelines. Soda Cloud ajoute une interface partagée pour les résultats, les alertes, les tendances, le contrôle d'accès basé sur les rôles et le tri des incidents.
Cette répartition convient aux équipes qui veulent une validation proche de l'entrepôt tout en offrant aux analystes et aux responsables de données une interface cloud pour la revue. Les intégrations de Soda avec des plateformes comme Snowflake et Databricks, ainsi que ses connexions CI/CD, permettent d'exécuter les contrôles dans les workflows de livraison, et pas seulement sous forme d'analyses planifiées dans un tableau de bord.
La distinction utile ici est l'accessibilité. Le YAML peut abaisser la barrière pour les ingénieurs qui ne veulent pas intégrer chaque contrôle dans le code applicatif, tandis que le profilage et les suggestions automatiques aident les équipes à établir une première référence de qualité. Le produit exige néanmoins de trancher sur la gravité, la responsabilité et l'escalade. Un contrôle qui s'exécute correctement mais n'a aucun responsable n'est qu'un événement technique, pas un contrôle opérationnel.
Le lieu d'exécution compte davantage que l'écran d'alerte. Une interface cloud soignée ne signifie pas automatiquement que les données de production ont quitté l'entrepôt.
Le cas d'usage le plus fort de Soda est un programme qualité centré sur l'entrepôt, qui combine des contrôles écrits par les développeurs et un tri collaboratif des incidents. Sa limite tient au packaging. Certaines capacités avancées ne sont disponibles que dans l'offre Cloud, et les prix publics ne sont pas affichés : les acheteurs doivent donc confirmer directement le périmètre fonctionnel actuel et les hypothèses du devis. Les équipes qui le comparent à digna devraient se demander si elles ont besoin d'un plan de contrôle SaaS, d'une installation privée ou d'une surveillance corrélée plus large. La plateforme Soda présente le périmètre produit, les modalités de déploiement et les informations commerciales à jour. Pour des alternatives orientées validation et observabilité sur place, consultez les alternatives à Soda selon digna.
4. Monte Carlo
Monte Carlo répond à un autre type de défaillance qu'une bibliothèque de règles. Sa proposition centrale est l'observabilité des données sur la fraîcheur, le volume, le schéma, le lignage et la BI, appuyée par des moniteurs pilotés par le machine learning et des workflows de gestion d'incidents. C'est donc un choix naturel pour les grandes équipes data qui doivent repérer des comportements inattendus sans écrire une règle pour chaque table et chaque métrique.
Le lignage et l'analyse d'impact de la plateforme sont particulièrement utiles lors des investigations. Un problème de fraîcheur devient plus facile à traiter lorsqu'une équipe voit les actifs, tableaux de bord ou workflows en aval qui sont touchés. Les capacités de tri des incidents et de runbooks orientent aussi le produit vers la réponse opérationnelle plutôt que vers la seule écriture de tests.
Monte Carlo est souvent évalué via des canaux d'achat d'entreprise, dont AWS Marketplace. Son modèle de consommation par crédits peut simplifier l'achat pour les organisations qui utilisent déjà ce canal, mais il soulève des questions de coûts variables. Les équipes devraient modéliser l'effet du nombre d'actifs surveillés, de la fréquence des analyses, de la durée de conservation de l'historique et du volume d'incidents sur la consommation, au lieu de considérer le passage par la marketplace comme une réponse tarifaire complète.
La limite réside dans la couverture déterministe. L'observabilité peut indiquer qu'une distribution a changé ou qu'un chargement est arrivé en retard, mais elle ne remplace pas une règle explicite pour une condition qui a une portée juridique ou opérationnelle. Une mise en œuvre solide associe les moniteurs automatisés de Monte Carlo à des tests ciblés, portés par l'équipe métier concernée.
Consultez le périmètre actuel et les options d'achat sur Monte Carlo. Les acheteurs devraient demander un modèle de coût fondé sur leur patrimoine réellement surveillé, puis comparer la réponse avec des outils qui exécutent les contrôles dans leur propre infrastructure. Pour un autre point de vue produit, consultez l'analyse par digna des alternatives à Monte Carlo.
5. Anomalo
Anomalo s'adresse aux équipes qui veulent une détection automatisée des anomalies pour obtenir rapidement une large couverture. L'outil analyse le comportement des tables, des colonnes, des métriques et des distributions, puis permet une validation configurable au niveau de la table, de la colonne et de la ligne. Cette combinaison répond à une tension fréquente lors de la mise en œuvre : les équipes ont besoin de contrôles explicites, mais elles ne peuvent souvent pas écrire à la main chaque référence utile avant de lancer la surveillance.
L'interface privilégie la revue à grande échelle. Les connexions natives aux entrepôts modernes et à des catalogues comme Alation permettent d'afficher la santé des données là où les consommateurs et les data stewards travaillent déjà. La détection automatisée peut révéler des variations inhabituelles qu'un seuil choisi manuellement ne verrait pas, en particulier dans de vastes environnements d'entrepôt où la bonne référence n'est pas évidente au moment de la conception.
Le compromis porte sur le calibrage des alertes. Les moniteurs pilotés par le machine learning exigent toujours des politiques de tri, des décisions de mise en sourdine et des responsables. Si les équipes considèrent chaque écart comme un défaut, elles génèrent du bruit. Si elles suppriment trop d'alertes, le système perd en couverture. Le bon modèle opérationnel classe les problèmes selon leur conséquence métier et conserve des contrôles déterministes pour les conditions qui ne doivent jamais être ambiguës.
La couverture automatisée réduit l'effort d'écriture des règles, mais elle ne supprime pas le besoin de décisions assumées par des responsables.
Anomalo convient aux organisations qui privilégient une observabilité rapide sur de vastes patrimoines d'entrepôts et un workflow visuel de revue des problèmes. Il peut être moins adapté lorsque le déploiement privé, les preuves produites dans la base de données ou des pistes d'audit strictes au niveau de l'enregistrement sont les principaux critères de choix. La tarification passe par l'équipe commerciale et n'est pas publiée : les acheteurs devraient donc valider le périmètre des connecteurs, les limites d'accès aux données et l'accompagnement au réglage pendant l'évaluation. Découvrez l'offre actuelle sur Anomalo, et comparez son approche centrée sur les anomalies avec le guide de digna pour repérer tôt les problèmes de données grâce à la détection d'anomalies.
6. Bigeye
Bigeye inscrit l'observabilité dans un modèle opérationnel d'AI Trust. Sa surveillance couvre la fraîcheur, le volume, le schéma et les distributions, tandis que le lignage et l'analyse d'impact relient un jeu de données anormal à ses consommateurs en aval. Cette orientation le rend pertinent lorsque les équipes de gouvernance ont besoin de plus qu'une notification : il leur faut du contexte sur ce qui a changé et sur les traitements potentiellement touchés.
Le vrai point fort du produit est un tri des incidents qui tient compte du lignage. Les enquêteurs peuvent s'appuyer sur les relations amont et aval pour cerner plus vite la cause racine, tandis que les fonctions de sécurité d'entreprise et un large portefeuille de connecteurs prennent en charge des patrimoines hétérogènes. Bigeye fournit aussi des guides et de la documentation qui aident les équipes à standardiser le déploiement, plutôt que de laisser chaque domaine inventer son propre processus de surveillance.
Son périmètre plus large peut aussi être un inconvénient. Une équipe qui cherche une petite bibliothèque de contrôles déterministes risque de trouver une plateforme d'AI Trust surdimensionnée par rapport à son besoin immédiat. Plus de capacités signifie plus de décisions sur la responsabilité, l'intégration, la gravité des incidents et les procédures d'exploitation. L'équipe d'achat devrait distinguer le besoin d'observabilité de celui de contrôles de gouvernance des modèles, et confirmer quels composants du produit sont réellement nécessaires.
Bigeye est un bon candidat lorsque le lignage est central dans les investigations et que l'organisation souhaite une mise en œuvre d'entreprise structurée. Ce n'est pas le premier choix évident pour une bibliothèque de développement native Spark ou un workflow de comparaison de migration. Les prix ne sont pas publiés et l'achat passe principalement par une démonstration : l'évaluation devrait donc inclure les limites de déploiement, le traitement des données sensibles et la conservation des preuves. Les informations produit à jour sont disponibles sur Bigeye.
7. Datafold
Datafold résout un problème plus ciblé, et le résout remarquablement bien : la comparaison au niveau des valeurs et les tests de régression. Sa fonction Data Diff compare les résultats sur de grands jeux de données, tandis que le lignage au niveau des colonnes relie les changements entre entrepôts, projets dbt et actifs BI. L'outil est donc utile avant la fusion d'une pull request, pendant une migration d'entrepôt ou lorsqu'une transformation a été réécrite et que l'équipe doit mesurer l'impact réel sur les données.
Il ne s'agit pas d'observabilité continue. Datafold est le plus efficace lorsqu'un changement connu doit être justifié par la preuve que le nouveau résultat est identique, meilleur ou volontairement différent de l'ancien. Les intégrations CI intègrent cette comparaison au workflow de développement, où les ingénieurs peuvent repérer les régressions avant que les consommateurs en production ne les subissent.
Une option de déploiement en VPC répond aux besoins des organisations qui exigent une exécution privée. La question clé de la mise en œuvre est la conception des comparaisons. Les équipes doivent définir quelles lignes, colonnes, agrégats, tolérances et exclusions constituent un test de parité pertinent. Un diff mécaniquement complet peut produire un résultat inutilisable sur le plan opérationnel si les changements validés par le métier ne sont pas pris en compte dans le test.
Datafold convient aux environnements riches en migrations, centrés sur dbt et sensibles aux régressions. Il ne remplace ni la surveillance de la fraîcheur, ni les références d'anomalies, ni les règles de conformité au niveau de l'enregistrement. La tarification de la plateforme complète est personnalisée et passe par l'équipe commerciale, et le projet open source data-diff a été abandonné au profit du produit cloud : les acheteurs doivent donc vérifier l'offre commerciale actuelle. Découvrez les dernières fonctionnalités sur Datafold.
8. AWS Deequ
AWS Deequ est une bibliothèque Scala et Apache Spark, pas une plateforme d'observabilité complète. Cette distinction détermine à la fois son attrait et son coût d'exploitation. Les équipes data qui travaillent directement dans l'écosystème JVM et Spark peuvent exprimer des contraintes de complétude, d'unicité, de distribution et d'autres métriques, puis les exécuter en parallèle de leurs traitements ETL ou ELT à grande échelle.
Le modèle Metrics Repository de Deequ permet aux équipes de conserver des profils dans le temps. Cela pose les bases d'une analyse de tendances, mais tout l'environnement autour reste à la charge du client. Les ingénieurs doivent construire la planification, les alertes, la présentation des résultats, les workflows de responsabilité et la conservation des incidents si la plateforme existante ne les fournit pas.
La bibliothèque est intéressante lorsqu'éviter la dépendance à un éditeur est important et que Spark est déjà l'environnement d'exécution. Elle peut être intégrée aux traitements ETL et aux workflows CI, et des bindings Python communautaires existent pour les équipes qui ont besoin d'une interface Python. Cette flexibilité a un prix en expertise. Les équipes sans solide maîtrise opérationnelle de Scala ou de Spark risquent de consacrer plus d'efforts à maintenir la couche de validation qu'à écrire les contraintes elles-mêmes.
Deequ est un composant que l'on assemble pour construire un système de validation. Ce n'est pas un workflow de gouvernance clé en main.
Utilisez Deequ pour des tests de contraintes natifs Spark lorsque la maîtrise technique et la licence open source l'emportent sur le besoin d'une interface intégrée. Préférez une plateforme lorsque des analystes, des data stewards ou des auditeurs ont besoin d'un contexte d'incident partagé sans développement spécifique. Le code et la documentation à jour du projet sont disponibles dans le dépôt AWS Deequ.
9. Acceldata
Acceldata associe la fiabilité des données à l'optimisation des coûts et à la santé des plateformes. C'est donc un candidat pour les patrimoines complexes où les équipes ne veulent pas que les alertes de qualité des données restent isolées du comportement des charges de travail, des signaux de performance et des variations de consommation. Son périmètre dépasse les contrôles de lignes pour englober les conditions opérationnelles qui déterminent si les plateformes de données restent utilisables et économiquement maîtrisées.
La plateforme propose des moniteurs de fiabilité, des alertes et des contrôles de type contrat de données sur des stacks hétérogènes. Ses capacités de déploiement et de sécurité d'entreprise sont pertinentes pour les organisations présentes à la fois on-premise et dans le cloud, surtout lorsque les ingénieurs plateforme et les équipes de gouvernance partagent la responsabilité des niveaux de service.
L'étendue fonctionnelle peut être précieuse, mais elle élargit aussi le périmètre de mise en œuvre. Une équipe qui cherche uniquement des contrôles de valeurs nulles, une validation par listes de référence ou quelques contrôles de schéma risque d'évaluer des capacités qu'elle n'exploitera jamais. Le processus de sélection devrait identifier la défaillance qui justifie la plateforme, puis vérifier si les signaux de coût et de santé seront pris en charge par la même équipe ou par des fonctions plateforme distinctes.
Acceldata convient aux patrimoines où la qualité, la fiabilité et l'économie des plateformes doivent être examinées ensemble. La tarification passe par l'équipe commerciale et repose sur devis : les acheteurs devraient demander une ventilation claire des modules, des actifs surveillés, du déploiement et du support. Le positionnement et les détails actuels de la plateforme sont disponibles sur Acceldata.
10. Talend Data Quality, désormais intégré à Qlik Talend Cloud et Talend Data Fabric
Talend Data Quality est l'option d'entreprise historique de cette liste, avec des capacités couvrant le profilage, le nettoyage, la standardisation, l'enrichissement, la gestion par les data stewards et le scoring de confiance. Il est surtout pertinent pour les organisations qui standardisent déjà sur Qlik ou Talend pour l'intégration, la gouvernance et la gestion des données, car sa valeur vient autant de l'écosystème qui l'entoure que des règles de validation elles-mêmes.
L'outillage prend en charge les règles de qualité et le profilage aux côtés de workflows de stewardship. Des abonnements sont proposés via Qlik Talend Cloud, tandis que des options on-premise et gérées par le client existent au sein de la famille Data Fabric. Cette diversité peut aider les organisations aux exigences de déploiement mixtes, mais elle rend aussi indispensable la vérification du packaging produit.
Talend relève moins de la bibliothèque légère pour développeurs que de l'institutionnalisation des workflows qualité à travers les rôles. Les data stewards peuvent participer à la remédiation, tandis que les équipes d'intégration relient les processus qualité aux flux de données et à la gouvernance au sens large. Le compromis est la complexité. Aucun tarif public n'est affiché, les niveaux d'offre et les références peuvent être difficiles à comparer, et le changement de marque sous Qlik oblige les acheteurs à vérifier quelles capacités appartiennent à quel package actuel.
Talend est un excellent choix pour les entreprises déjà investies dans l'écosystème Qlik et Talend. Il peut être disproportionné pour un simple diff de migration, une bibliothèque de contraintes Spark ou un déploiement limité à la détection d'anomalies. Vérifiez le packaging, le déploiement, le support et les licences actuels sur Qlik Talend Data Fabric.
Comparatif des 10 meilleurs outils de validation big data
Outil | Capacités clés | UX & qualité (★) | Atouts distinctifs (✨ / 🏆) | Public cible (👥) | Prix / valeur (💰) |
|---|---|---|---|---|---|
Data Validation (digna) | Validation au niveau de l'enregistrement dans la base, intégrée aux anomalies, à la ponctualité & au schéma | ★★★★★ Interface partagée, niveau entreprise | ✨ S'exécute dans l'infrastructure du client ; incidents corrélés → analyse des causes racines plus rapide 🏆 | 👥 Entreprises réglementées (finance, santé, télécoms, secteur public) | 💰 Licence modulaire + par table active ; transparente, stable selon l'usage |
Great Expectations (GX) | Suites d'expectations déclaratives, profilage, support multi-backend | ★★★★ UX orientée code ; GX Cloud ajoute une interface managée | ✨ Riche bibliothèque d'expectations, documentation & lignage des tests 🏆 | 👥 Data engineers, équipes orientées code | 💰 OSS gratuit ; GX Cloud en offres payantes (variable) |
Soda (Core + Cloud) | Contrôles YAML (SodaCL), profilage, interface cloud, exécution au plus près des données | ★★★★ Pensé pour les développeurs ; Cloud pour le tri & le RBAC | ✨ YAML + intégration simple aux pipelines, suggestions automatiques 🏆 | 👥 Équipes de développement voulant CI/CD + UX cloud | 💰 Core OSS gratuit ; Cloud = sur devis |
Monte Carlo | Moniteurs ML (fraîcheur, volume, schéma), lignage, surveillance BI | ★★★★★ Tri des incidents & runbooks matures | ✨ Surveillance ML d'entreprise + workflows de tri complets 🏆 | 👥 Grandes organisations aux data ops matures | 💰 Sur devis ; modèle à crédits / consommation (variable) |
Anomalo | Détection d'anomalies par IA, validations déclaratives, intégrations aux catalogues | ★★★★ Couverture rapide ; interface de revue des problèmes | ✨ Contrôles automatisés pour une couverture rapide 🏆 | 👥 Équipes ayant besoin d'une détection d'anomalies rapide à grande échelle | 💰 Tarification entreprise sur devis |
Bigeye | Surveillance automatisée (fraîcheur/volume/schéma), lignage approfondi | ★★★★ Tri tenant compte du lignage & UX de gouvernance | ✨ Lignage + observabilité au service de la gouvernance 🏆 | 👥 Équipes axées gouvernance/conformité | 💰 Sur démo/devis (entreprise) |
Datafold | Comparaison des données au niveau des valeurs, tests de régression CI, lignage des colonnes | ★★★★ UX de validation avant fusion très solide | ✨ Data diff + intégration CI pour PR & migrations 🏆 | 👥 Équipes d'ingénierie, workflows dbt & migration | 💰 Sur devis ; option de déploiement en VPC |
AWS Deequ (OSS) | Contraintes Spark déclaratives, dépôt de métriques, contrôles à l'échelle de Spark | ★★★ Bibliothèque (sans interface intégrée), code/natif | ✨ Gratuit, natif Spark à grande échelle pour les équipes JVM 🏆 | 👥 Ingénieurs big data JVM/Spark | 💰 Open source (gratuit) ; seulement coûts d'infra/dev |
Acceldata | Moniteurs de fiabilité, optimisation des coûts, santé des plateformes | ★★★★ Tableaux de bord d'entreprise & outillage SLO | ✨ Combine qualité des données et vision coûts/plateforme 🏆 | 👥 Entreprises complexes et multi-plateformes | 💰 Tarification entreprise sur devis |
Talend Data Quality (Qlik) | Profilage, nettoyage, stewardship, scoring de confiance | ★★★★ UX de gouvernance & de stewardship mature | ✨ Longue expérience en qualité des données + intégration 🏆 | 👥 Entreprises standardisées sur Talend/Qlik | 💰 Abonnements par niveaux (sur devis) |
Choisir l'outil en fonction de la défaillance à éviter
Le choix d'un outil devient plus clair lorsque l'équipe nomme la défaillance avant de comparer les fonctionnalités. Si le risque principal est un montant invalide, un statut interdit, une valeur de référence manquante ou une paire de champs incohérente, commencez par une validation déterministe des enregistrements. digna, Great Expectations, Soda, Talend et Deequ prennent tous en charge des contrôles à base de règles, mais ils diffèrent par leur exécution, leurs interfaces, leur déploiement et la quantité de workflow que l'équipe doit construire autour.
Si la préoccupation est une variation inattendue sur un vaste patrimoine, donnez la priorité à la détection automatisée des anomalies. Monte Carlo, Anomalo, Bigeye, Acceldata et digna abordent ce problème par la surveillance et le contexte comportemental. La question importante n'est pas de savoir si un outil utilise le machine learning. Demandez plutôt comment les équipes ajustent les alertes, désignent les responsables, expliquent un écart et relient l'événement à son impact en aval.
Les défaillances de fraîcheur et de schéma méritent leur propre évaluation. Une suite de règles peut réussir alors qu'un chargement arrive en retard, et un changement de schéma peut être techniquement accepté par un format de table tout en cassant une hypothèse en aval. La documentation d'Apache Iceberg montre pourquoi l'évolution des schémas doit être suivie activement : des champs peuvent être ajoutés, supprimés, modifiés ou renommés au fil des changements de métadonnées, et des données plus anciennes peuvent rester sous des spécifications de partition antérieures. Un changement structurellement valide doit malgré tout laisser une trace opérationnelle de ce qui a changé, de sa date d'effet et des consommateurs qui en dépendent.
Les migrations et les changements de transformation exigent des preuves de comparaison et de non-régression, domaine où Datafold est plus clairement adapté qu'une plateforme d'observabilité généraliste. Les équipes centrées sur Spark peuvent préférer Deequ, car les contrôles s'exécutent dans le même environnement de traitement. Les organisations qui ont besoin d'un tri piloté par le lignage devraient évaluer Monte Carlo, Bigeye, Acceldata ou Talend selon la profondeur de l'analyse d'impact et les rôles impliqués dans la remédiation.
Suivez cette démarche pendant l'évaluation :
Définir la défaillance : distinguez les violations d'enregistrements, les comportements anormaux, les livraisons tardives, la dérive structurelle, les écarts de migration et la dégradation de la plateforme.
Localiser l'exécution : vérifiez si les contrôles s'exécutent dans l'entrepôt, dans l'environnement Spark, dans un VPC, dans un cloud privé, sur une infrastructure on-premise ou dans un service contrôlé par l'éditeur.
Attribuer les responsabilités : identifiez qui écrit les règles, enquête sur les alertes, approuve les exceptions et confirme la remédiation.
Tester les preuves : exigez des résultats reproductibles, les enregistrements ou métriques concernés, des horodatages, le contexte de lignage et un historique des exceptions auditable.
Modéliser le coût d'exploitation : comparez les tables actives, le comportement des analyses, la consommation de calcul, les crédits, les modules, le support et l'effort de mise en œuvre, plutôt que de vous fier au nombre de licences.
Mener un pilote représentatif : incluez une table critique, un chargement tardif, un changement de schéma, une violation connue d'une règle métier et une modification délibérée d'une transformation.
La mauvaise qualité des données est un risque métier bien réel. Dans un rapport 2025 de l'IBM Institute for Business Value, 43 % des directeurs des opérations ont désigné les problèmes de qualité des données comme leur priorité data la plus importante. Le même rapport indique que plus de 25 % des organisations estiment leurs pertes annuelles à plus de 5 millions USD, et que 7 % déclarent des pertes d'au moins 25 millions USD. Il s'agit d'estimations issues d'une enquête, et non d'une mesure comptable universelle, mais elles expliquent pourquoi la validation doit être traitée comme un contrôle de gouvernance et d'exploitation.
Une enquête menée en 2025 auprès de plus de 200 professionnels de la donnée a montré que 23,4 % utilisaient des outils dédiés d'observabilité des données, contre 39,2 % recourant aux tests automatisés et 22,6 % utilisant des outils de validation comme Great Expectations. Ce profil d'adoption plaide pour une approche en couches. Les équipes n'ont pas à choisir entre règles et observabilité lorsque des données critiques exigent à la fois des contraintes métier explicites et une alerte précoce en cas de changement de comportement. Mesurez la couverture en production, le temps d'investigation, le poids des faux positifs, la responsabilité de la remédiation et les preuves conservées.
digna est particulièrement pertinent lorsque l'exécution dans la base de données, le déploiement privé, la surveillance corrélée et l'extension modulaire sont des exigences centrales. Il permet aux équipes de combiner la validation au niveau de l'enregistrement avec des contrôles d'anomalies, de ponctualité et de schéma au sein de leur propre environnement. Pour d'autres priorités, Great Expectations, Soda, Monte Carlo, Anomalo, Bigeye, Datafold, Deequ, Acceldata ou Talend peuvent être plus directement adaptés.
digna combine la validation des enregistrements dans la base de données avec la détection d'anomalies, le suivi de la ponctualité et le suivi de schéma, dans votre cloud, votre VPC ou votre data center. Si votre équipe a besoin de contrôles prêts pour l'audit sans déplacer les données de production, découvrez digna et évaluez la plateforme sur un jeu de données critique représentatif.
Si votre budget exclut pour l'instant une plateforme commerciale, notre sélection d'outils gratuits de validation des données présente les options open source qui méritent un pilote avant de vous engager avec l'un des produits ci-dessus.
Questions fréquentes
Qu'est-ce qu'un outil de validation big data ?
Un logiciel qui vérifie si de grands jeux de données respectent les règles et le comportement attendus. Certains outils contrôlent des règles métier au niveau de l'enregistrement, comme les plages, les valeurs nulles et les valeurs de référence, d'autres détectent des anomalies de fraîcheur, de volume ou de distribution, et quelques-uns comparent les résultats d'une version à l'autre pour repérer les régressions avant la fusion d'un changement.
Quels outils de validation big data sont open source ?
Great Expectations, Soda Core et AWS Deequ reposent tous sur un socle open source. Great Expectations utilise des Expectations déclaratives, Soda Core la syntaxe SodaCL basée sur YAML, et Deequ est une bibliothèque Scala et Apache Spark. Chacun dispose d'une couche payante ou managée, comme GX Cloud ou Soda Cloud, pour partager les résultats et gérer les alertes.
Quelle est la différence entre validation des données et observabilité des données ?
La validation prouve que chaque enregistrement respecte une logique métier explicite, comme un statut autorisé ou un montant valide. L'observabilité surveille la fraîcheur, le volume, le schéma et les distributions pour repérer des comportements inattendus sans règle pour chaque table. Monte Carlo et Bigeye penchent vers l'observabilité, tandis que Great Expectations et Soda penchent vers les règles.
La validation des données peut-elle s'exécuter sans sortir les données de l'entrepôt ?
Oui. digna calcule les métriques et exécute la validation directement dans les bases de données du client, dans son cloud, son VPC ou son data center, si bien que les données de production restent en place. Deequ s'exécute aussi en parallèle des traitements Spark, là où se trouvent déjà les données, tandis que plusieurs plateformes SaaS traitent les résultats dans un environnement hébergé par l'éditeur.
Comment choisir le bon outil de validation big data ?
Nommez la défaillance à éviter avant de comparer les fonctionnalités. Les valeurs invalides et les relations brisées entre champs appellent une validation déterministe des enregistrements, les variations inattendues de volume ou de distribution appellent la détection d'anomalies, et les modifications de code risquées appellent une comparaison au niveau des valeurs, comme Datafold, avant la fusion d'une pull request.


