Processus de suivi des KPI : le guide complet étape par étape
|
6
minute de lecture

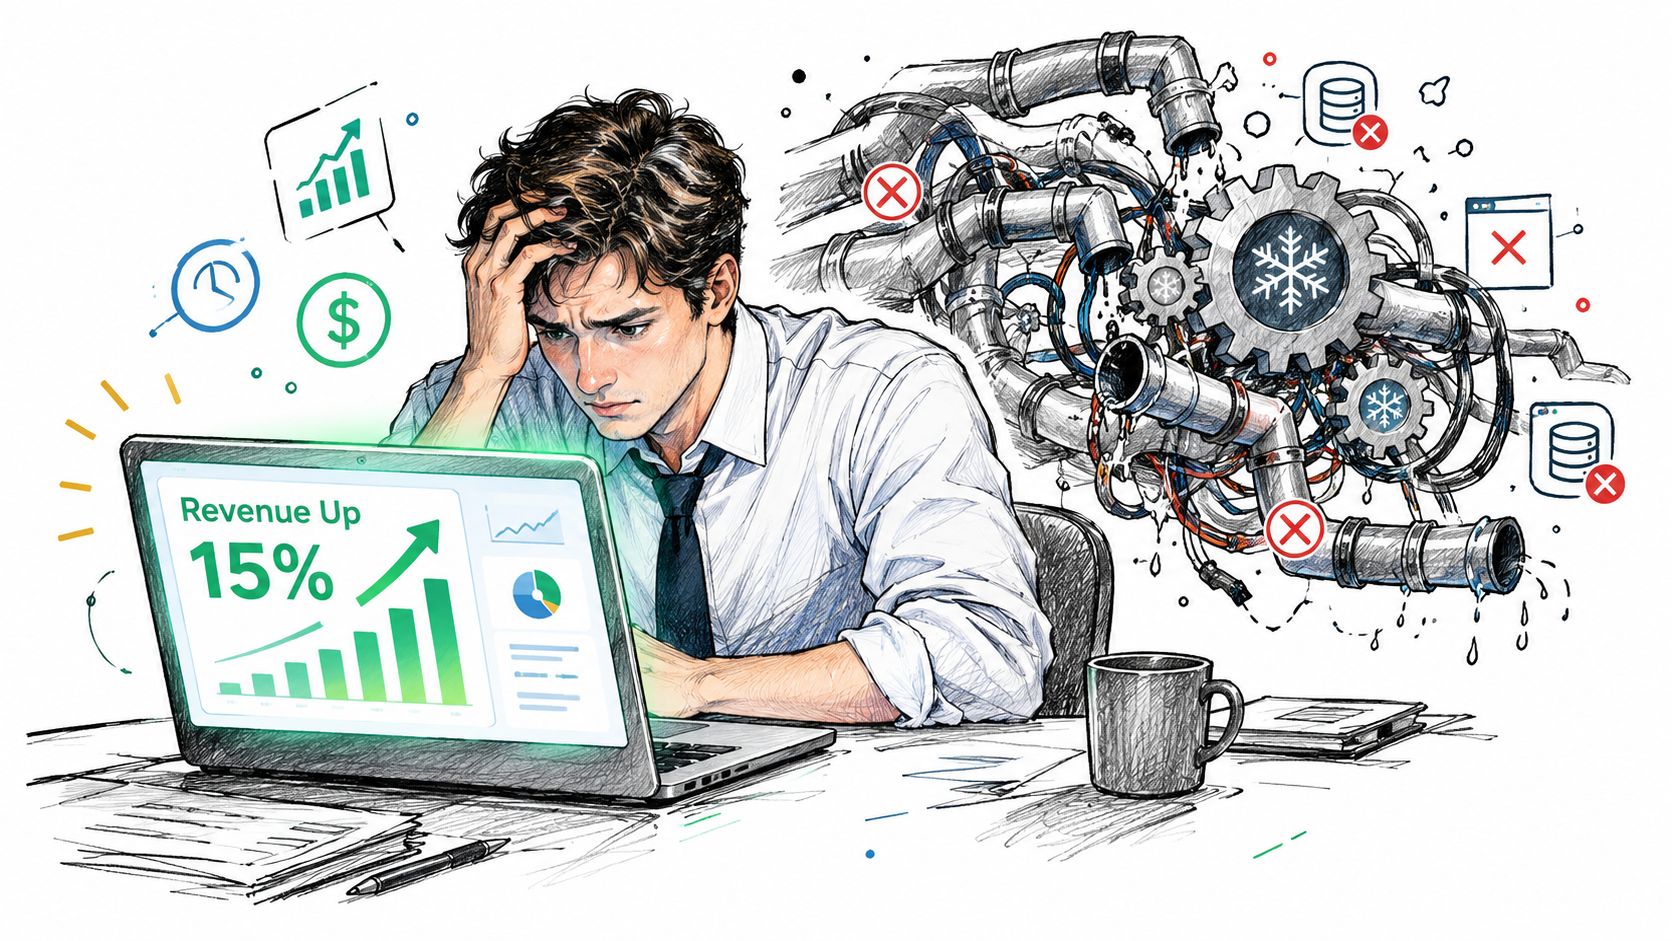
9 h du matin : un responsable métier appelle parce que le tableau de bord du chiffre d'affaires affiche une hausse de 15 %. L'équipe se réjouit un instant, puis quelqu'un vérifie le flux de transactions et découvre que le pipeline a été chargé en retard et a omis les deux derniers jours. Le KPI ne révélait pas une meilleure performance. Il reflétait des données incomplètes.
C'est pourquoi un processus de suivi des KPI fiable doit surveiller bien plus que la valeur des indicateurs. Il doit déterminer si les données sont fraîches, complètes, structurellement valides et exploitables pour l'interprétation. Un tableau de bord peut être visuellement soigné et pourtant donner aux décideurs une fausse assurance.
Table des matières
Pourquoi votre tableau de bord KPI vous ment
Les six étapes d'un processus de suivi des KPI
Définir la décision et le responsable
Établir une référence représentative
Valider le lignage avant d'interpréter une variation
Calculer à la source de référence
Détecter les dépassements et les comportements inhabituels
Acheminer, résoudre et améliorer les alertes
Distinguer la performance métier de la fiabilité des données
Utiliser deux circuits d'alerte
Rendre le résultat auditable
Règles traditionnelles ou détection d'anomalies par IA
Là où les règles déterministes fonctionnent
Là où la détection adaptative aide
Rôles, responsabilités et pratiques opérationnelles
Attribuer explicitement les responsabilités
Caler la fréquence sur la capacité d'action
Erreurs courantes et comment les éviter
Schémas d'échec fréquents
Construire votre stratégie de suivi des KPI avec digna
Pourquoi votre tableau de bord KPI vous ment
L'échec part généralement d'une conception raisonnable. Un analytics engineer définit le chiffre d'affaires, relie le calcul à une table de l'entrepôt, ajoute une ligne d'objectif et publie le résultat dans Power BI ou une autre plateforme BI. Du point de vue de l'outil de reporting, l'actualisation du tableau de bord réussit, mais le chargement des transactions en amont est arrivé en retard ou ne contenait qu'une partie des données attendues.
Le responsable métier voit une évolution positive. Le data engineer voit un incident de livraison. Tous deux regardent le même KPI, mais un seul dispose du contexte nécessaire pour l'interpréter.
Règle pratique : ne considérez jamais la valeur d'un KPI comme fiable tant que son statut de fraîcheur, de complétude, de lignage et de validation n'est pas affiché à côté.
La surveillance traditionnelle ne regarde souvent que le chiffre final. Un seuil peut déclencher une alerte lorsque le chiffre d'affaires passe sous un objectif fixe, mais il ne signalera pas forcément un chargement retardé, une partition manquante, un type de colonne modifié ou une extraction partielle. Les équipes reçoivent alors des alertes qui n'expliquent pas si c'est l'activité qui a changé ou la mesure qui a échoué.
Cette distinction conditionne chaque réponse opérationnelle. Un véritable recul peut nécessiter une analyse commerciale. Un jeu de données en retard nécessite une correction du pipeline. Un changement de schéma peut imposer de mettre à jour les transformations. Si le processus de surveillance envoie la même alerte dans les trois cas, la responsabilité devient floue et les intervenants perdent du temps à diagnostiquer le mauvais problème.
Les tableaux de bord restent importants, surtout lorsque les équipes doivent créer des visuels Power BI exploitables. Mais la visualisation n'est que la dernière couche, pas le système de surveillance lui-même. Le processus sous-jacent doit relier le KPI affiché aux conditions de données qui l'ont produit.
Un tableau de bord de suivi des KPI réellement utile doit donc montrer à la fois le signal métier et les preuves de sa validité. Cela implique d'enregistrer les heures de livraison prévues et réelles, le nombre de lignes, les résultats de validation, les versions de schéma et le statut des calculs. Sans ces contrôles, un tableau de bord au vert signifie seulement que le tableau de bord s'est affiché correctement.
Les six étapes d'un processus de suivi des KPI
Un processus défendable est une boucle fermée. Le modèle opérationnel détaillé comprend huit étapes distinctes, de la définition de la décision et du responsable jusqu'à la revue des seuils au regard des faux positifs et de l'évolution des conditions, comme le décrit le NIST AI Risk Management Framework Playbook. En pratique, ces activités peuvent être regroupées en six étapes de mise en œuvre que les équipes peuvent piloter au quotidien.
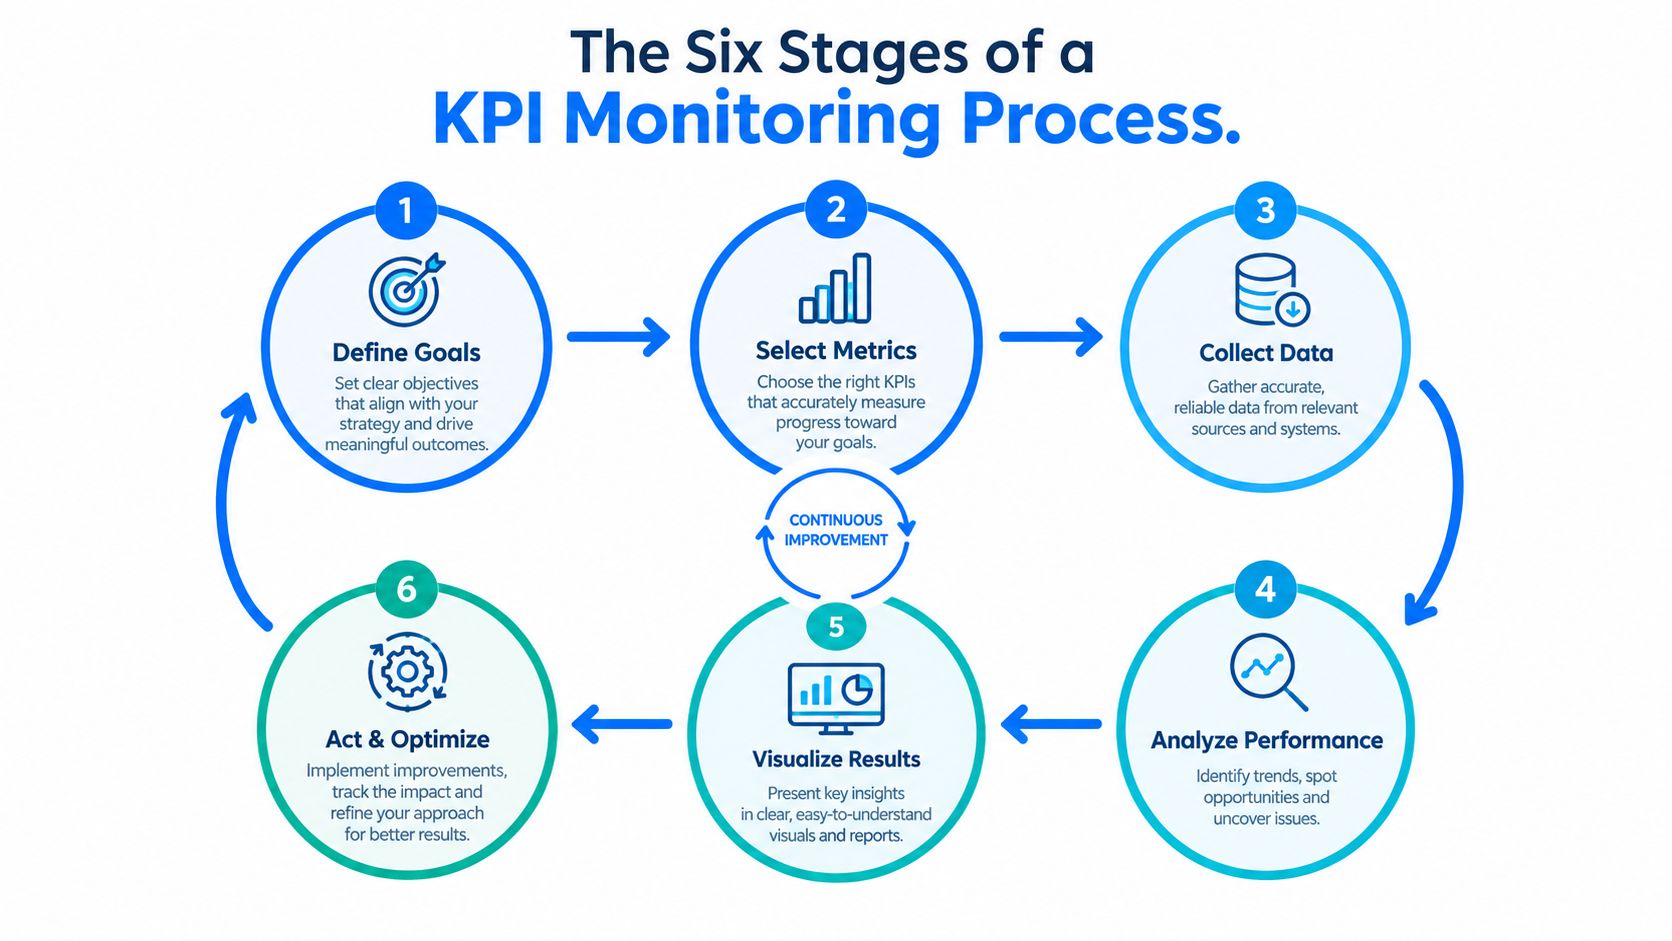
Définir la décision et le responsable
Commencez par la décision, pas par le graphique. Notez l'action que le KPI doit éclairer, qui est responsable du résultat et qui enquête en cas d'écart. Définissez le numérateur, le dénominateur, la granularité du calcul, les filtres, l'exigence de fraîcheur, la plage de fonctionnement acceptable et le circuit d'escalade.
Une équipe de services financiers peut confier un KPI de volume de règlements à un responsable des opérations, tandis qu'un établissement de santé peut confier un KPI de complétude des demandes de remboursement à un responsable de la gouvernance des données. Dans les deux cas, le responsable a besoin d'un niveau de détail sémantique suffisant pour juger si une variation est significative.
Établir une référence représentative
Un objectif n'est pas une référence. Construisez le comportement historique à partir de périodes représentatives et séparez la saisonnalité normale, les effets de calendrier, les promotions, les maintenances planifiées et les pannes connues des véritables changements. Une limite fixe peut être utile pour une frontière de conformité stricte, mais elle ne décrit pas la variation normale.
Valider le lignage avant d'interpréter une variation
Vérifiez que les tables sources, les transformations, les jointures, les filtres et les traitements de livraison fonctionnent comme prévu. Un KPI doit pouvoir être retracé jusqu'à sa source de référence, avec les résultats de validation et le statut de fiabilité des données. Si la source est incomplète, signalez ou masquez le résultat métier au lieu de le présenter comme à jour.
Calculer à la source de référence
Le calcul dans la base de données limite les déplacements inutiles et maintient la logique au plus près des données gouvernées. Il facilite aussi l'audit du calcul, car l'équipe peut associer le résultat à l'horodatage de la source, à la version de la requête, à l'état du schéma et au résultat de validation.
Détecter les dépassements et les comportements inhabituels
Utilisez des contrôles déterministes pour les limites définies et les défauts d'intégrité. Ajoutez une surveillance statistique pour les niveaux inhabituels, les changements de rythme d'évolution, la volatilité et les modifications de distribution. Cette combinaison détecte à la fois les violations connues et les comportements qui ne correspondent pas à la référence historique.
Acheminer, résoudre et améliorer les alertes
Envoyez les alertes, selon leur gravité, à un responsable identifié. Un écart persistant de faible gravité peut donner lieu à un ticket, tandis qu'un défaut d'intégrité grave peut exiger une astreinte immédiate. Chaque alerte doit comporter un runbook, une fenêtre de mise en sourdine, un circuit d'escalade, un diagnostic, une remédiation et une évaluation de l'impact métier.
Le processus ne devient fiable que lorsque les équipes examinent ses performances. Suivez les faux positifs, les incidents manqués, le délai de détection, le délai de prise en compte et le délai de remédiation, puis recalibrez les seuils lorsque les conditions d'exploitation évoluent.
Distinguer la performance métier de la fiabilité des données
Une alerte de performance métier répond à la question : « L'activité s'est-elle comportée différemment ? » Une alerte de fiabilité des données répond à la question : « Pouvons-nous nous fier à la mesure ? » Ces questions sont liées, mais elles ne doivent partager ni le même statut ni la même réponse.
Une lacune majeure des recommandations sur le suivi des KPI est qu'elles expliquent le choix des indicateurs sans préciser comment agir lorsque les données sous-jacentes sont en retard, incomplètes ou structurellement modifiées. Les conseils habituels alignent souvent la fréquence de surveillance sur la capacité d'action, mais définissent rarement ce qui se passe lorsqu'une actualisation planifiée manque sa fenêtre d'arrivée ou lorsqu'une colonne est ajoutée, supprimée ou change de type, comme le décrit ce guide de conception des KPI.
Utiliser deux circuits d'alerte
Imaginons qu'un KPI télécom montre une baisse soudaine de l'activité clients. Il existe au moins deux explications plausibles :
Signal métier : le comportement des clients a changé, l'équipe commerciale ou opérationnelle doit donc enquêter.
Signal de livraison : la dernière partition d'événements manque, l'équipe de la plateforme de données doit donc réparer le chargement.
Signal structurel : une colonne source a changé de type ou a disparu, les responsables des transformations et de la gouvernance doivent donc en évaluer l'impact.
Une simple tuile rouge ne permet pas de distinguer ces cas. Le système doit associer au calcul du KPI les statuts de fraîcheur, de complétude, de schéma et de validation. Si les données sont arrivées en retard, le résultat peut être marqué comme affecté et l'alerte métier mise en sourdine jusqu'à ce que la source soit rétablie.
Rendre le résultat auditable
Chaque exécution d'un KPI doit conserver l'horodatage des données, l'heure de livraison prévue et réelle, le nombre de lignes, la version du schéma, le statut du calcul, la version du seuil et l'identifiant d'incident. Ces champs permettent à un analyste d'expliquer pourquoi une valeur a changé sans devoir reconstituer tout l'historique du pipeline pendant un incident.
Cette distinction est particulièrement importante dans la santé et le secteur public, où un rapport apparemment à jour peut influencer des décisions opérationnelles ou réglementaires. Un résultat qui reflète des données partielles ne doit pas ressembler en tout point à un résultat issu d'un chargement complet et validé.
L'approche d'observabilité de la qualité des données de digna reflète ce modèle opérationnel en reliant les métriques métier à des contrôles de ponctualité, de validation, d'anomalies et de changements de schéma, au sein même de l'environnement de données du client. Le bénéfice concret n'est pas un tableau de bord de plus. C'est une réponse plus claire à la première question que les intervenants devraient se poser : la variation du KPI est-elle réelle, ou la mesure est-elle devenue inexploitable ?
Règles traditionnelles ou détection d'anomalies par IA
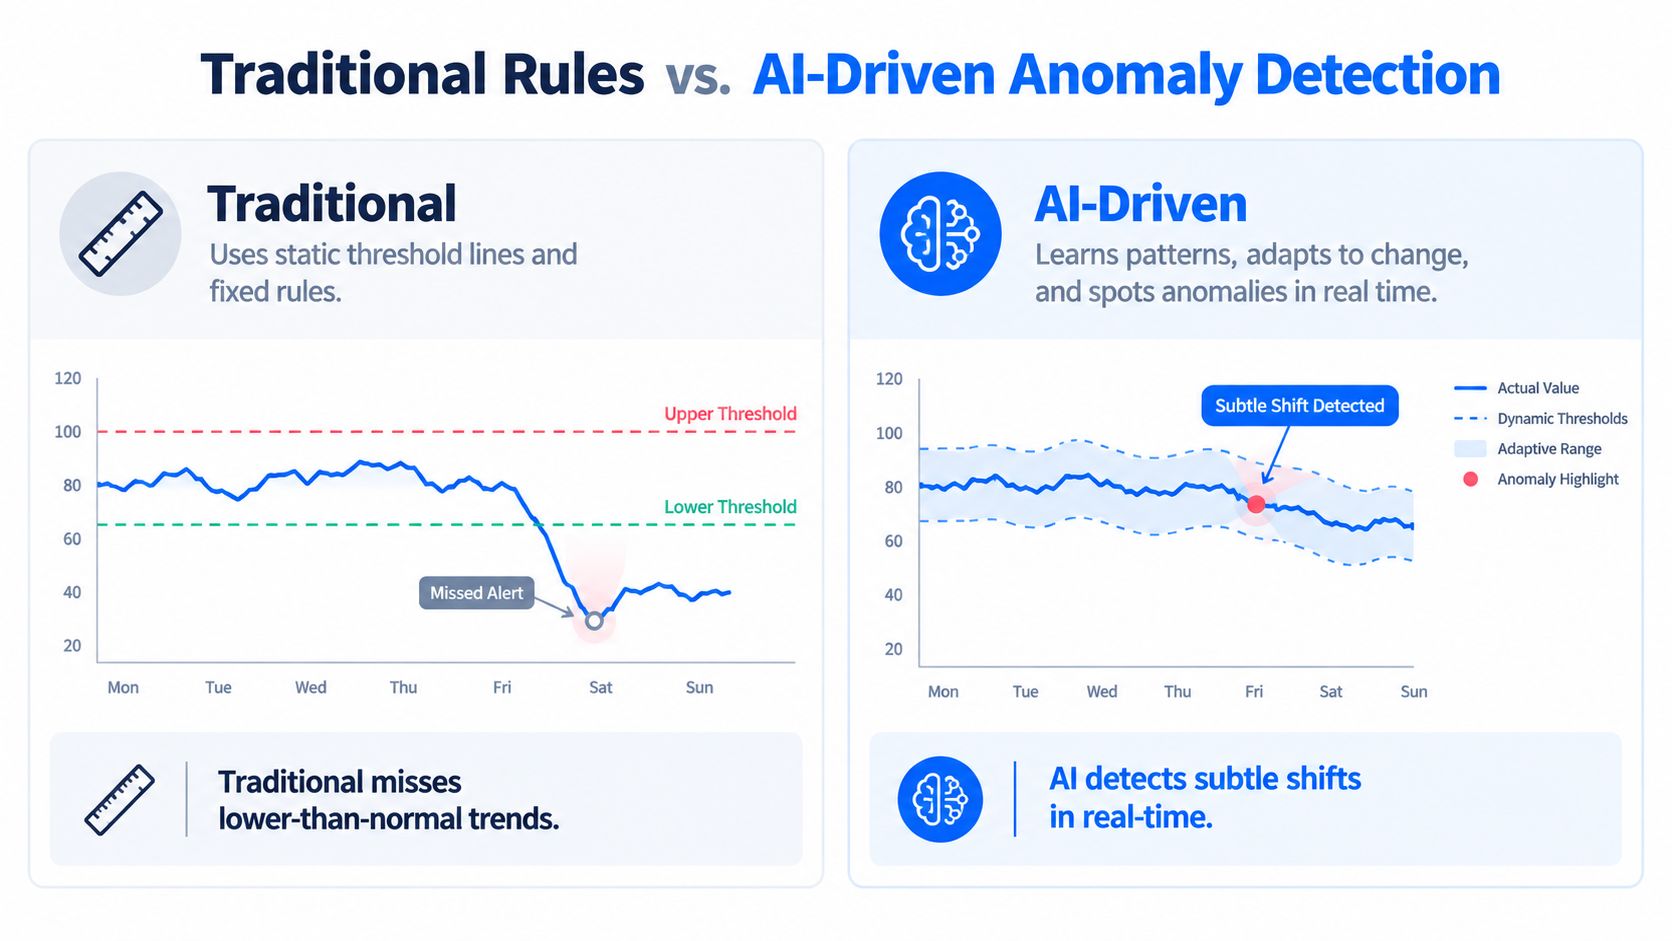
Un seuil fixe peut protéger une limite métier claire, par exemple en alertant lorsque les transactions passent sous un plancher approuvé. Il ne peut pas décrire toutes les conditions normales d'exploitation. Les week-ends, la demande saisonnière, les périodes de faible trafic, la dérive progressive et l'évolution de la volatilité peuvent tous rendre ce même seuil trompeur.
Il en résulte deux défaillances opérationnelles. Un seuil trop sensible génère du bruit, tandis qu'un seuil trop large manque un recul significatif. Les équipes se mettent à optimiser le volume d'alertes plutôt que la qualité des décisions, un problème abordé dans ces recommandations sur la surveillance des golden signals SRE.
Là où les règles déterministes fonctionnent
Les contrôles déterministes conviennent aux conditions explicites et testables :
Contrôles de valeurs nulles : les champs obligatoires doivent contenir une valeur.
Contrôles d'unicité : les identifiants ne doivent pas être dupliqués au sein de la granularité définie.
Contrôles d'intégrité référentielle : les enregistrements enfants doivent correspondre à des enregistrements parents valides.
Contrôles de schéma : les colonnes requises et les types de données doivent rester compatibles.
Contrôles de fraîcheur : les données attendues doivent arriver dans leur fenêtre de livraison définie.
Contrôles de limites : une limite réglementaire ou opérationnelle ne doit pas être dépassée.
Ces contrôles sont transparents, explicables et faciles à rattacher à un runbook. Les remplacer par de la détection d'anomalies affaiblirait les contrôles là où la condition attendue est déjà connue.
Là où la détection adaptative aide
La surveillance statistique compare le comportement actuel à l'historique propre du jeu de données. La présentation des types de détection d'anomalies explique comment cette approche peut repérer un niveau, un rythme d'évolution, un profil de volatilité ou un changement de distribution inattendus, sans que les ingénieurs aient à coder manuellement chaque condition normale. Elle est utile lorsqu'une métrique change pendant des périodes de faible trafic ou dérive avant de franchir une limite fixe.
Le module Data Anomalies de digna applique un apprentissage des références par IA et une détection continue des anomalies, sans configuration manuelle de règles. Son exécution dans la base de données maintient les calculs dans l'environnement du client, ce qui limite les déplacements de données et évite tout accès de l'éditeur aux données de production. Cette conception permet aussi de relier une alerte sur une métrique métier au problème de fiabilité des données sous-jacent, au lieu de traiter le KPI comme un signal isolé.
Adoptez un modèle hybride. Les règles déterministes doivent faire respecter les contrats connus et les conditions de conformité, tandis que la surveillance adaptative doit couvrir les comportements qu'aucun seuil unique ne peut représenter. Faites passer les deux types d'alertes par le même workflow d'incident, mais conservez la méthode de détection, les preuves et le KPI concerné, afin que les intervenants puissent distinguer un véritable changement d'activité d'un problème de mesure.
Rôles, responsabilités et pratiques opérationnelles
Un processus de suivi des KPI échoue lorsque la responsabilité s'arrête au tableau de bord. Les data engineers assurent la livraison et le calcul, les analytics engineers garantissent l'exactitude sémantique, les équipes de gouvernance définissent les exigences de qualité et les responsables métier décident de l'action qu'appelle un changement.
Le NIST recommande de choisir des métriques qui donnent des indications pertinentes sur l'état de la situation aux niveaux concernés, de définir les fréquences de surveillance et d'évaluation des contrôles, et d'automatiser autant que possible la collecte, l'analyse et le reporting, comme l'indique sa publication sur la surveillance continue.
Attribuer explicitement les responsabilités
Le data engineer est responsable de la santé des pipelines, des calendriers de livraison, des changements de sources et des procédures de reprise. L'analytics engineer est responsable des définitions des KPI, des jointures, des filtres, de la logique d'agrégation et de l'exactitude des tableaux de bord. L'équipe de gouvernance ou de qualité des données définit les règles de validation, les exigences de preuve et les conditions de données acceptables.
Le responsable métier interprète le KPI et décide de ce qui doit se passer en cas d'écart. Il peut approuver une réponse commerciale, accepter une exception connue ou faire remonter un incident opérationnel. Un modèle partagé de rôles et responsabilités en qualité des données permet d'éviter la situation classique où tout le monde reçoit l'alerte, mais où personne n'est responsable de la décision.
Caler la fréquence sur la capacité d'action
Les indicateurs opérationnels très volatils peuvent nécessiter une évaluation fréquente, tandis que des mesures stratégiques plus lentes peuvent être revues moins souvent. L'essentiel est de consigner explicitement la fréquence, y compris l'intervalle de mesure, le calendrier de mise à jour prévu, l'horodatage et le groupe de destinataires.
Chaque exécution doit comporter :
Métadonnées de livraison : heures d'arrivée prévues et réelles.
Preuves sur les données : nombre de lignes, horodatage de la source et statut de complétude.
Contexte technique : version du schéma et statut du calcul.
Contexte de contrôle : version du seuil et résultat de validation.
Trace opérationnelle : identifiant d'incident, responsable et état de résolution.
Avant d'activer une alerte en production, exigez une gravité, un runbook, une fenêtre de mise en sourdine, un responsable et un circuit d'escalade. L'automatisation doit collecter et analyser les preuves, mais ce sont des personnes qui doivent rester responsables du jugement et de la remédiation.
Erreurs courantes et comment les éviter
Plus d'alertes ne signifie pas une meilleure surveillance. Si le moindre écart déclenche une notification, les intervenants apprennent à ignorer le canal, et un incident important peut se perdre parmi les avertissements de routine.
L'erreur la plus dommageable consiste à optimiser le volume d'alertes plutôt que la qualité des décisions. Mesurez si les alertes débouchent sur une action à l'aide de la précision, de la couverture des incidents ou rappel, du délai moyen de détection, du délai moyen de prise en compte et du délai moyen de remédiation. Un système d'alerte silencieux peut être sain, ou il peut passer à côté d'incidents. Il vous faut des preuves.
Schémas d'échec fréquents
Fatigue d'alerte : trop de notifications habituent les équipes à ignorer les alertes. Combinez des niveaux de gravité, supprimez les doublons pendant les fenêtres de maintenance connues et n'envoyez que des événements exploitables.
Indicateurs de vanité : une métrique peut sembler impressionnante sans pour autant éclairer une décision. Reliez chaque KPI à un objectif métier et identifiez l'action qui suit un changement significatif.
Absence de responsable : une alerte sans intervenant désigné devient un bruit de fond partagé. Désignez un responsable unique, même lorsque plusieurs équipes contribuent au diagnostic.
Seuils statiques : les limites fixes ignorent la saisonnalité, les défaillances en heures creuses et la dérive progressive. Associez les limites à une surveillance qui tient compte des références.
Données non vérifiées : un KPI peut varier parce que la source est en retard ou incomplète. Affichez le statut de fiabilité des données à côté de la valeur métier et séparez les circuits de réponse.
Chaque alerte doit disposer d'une réponse prédéfinie avant sa mise en production. Si l'équipe ne peut pas expliquer qui enquête, de quelles preuves elle a besoin, combien de temps dure la mise en sourdine et quand intervient l'escalade, l'alerte n'est pas prête sur le plan opérationnel.
Construire votre stratégie de suivi des KPI avec digna
Commencez par les KPI qui orientent de vraies décisions, et non par toutes les métriques disponibles dans l'entrepôt. Définissez les responsables et la logique de calcul, établissez des références représentatives, validez le lignage, associez des métadonnées de fiabilité des données et combinez contrôles fixes et détection adaptative des anomalies.
Un déploiement pragmatique peut commencer par un seul jeu de données critique ou un seul domaine métier. Ajoutez ensuite la surveillance de la ponctualité pour le risque de livraison, la validation pour les règles métier, le suivi de schéma pour les changements structurels et l'observabilité de la plateforme lorsque la charge ou les performances affectent le reporting. Les outils de suivi des KPI doivent s'adapter au modèle opérationnel plutôt qu'imposer à toutes les équipes le même schéma d'alerte.
digna s'exécute dans l'environnement du client, avec des contrôles réalisés dans la base de données sur les entrepôts, les data lakes et les pipelines. Grâce à son modèle de licence modulaire, les équipes peuvent commencer avec un seul module puis étendre la couverture, tandis que le SDK Python permet une intégration programmatique aux workflows existants. Un tableau de bord partagé et centré sur l'utilisateur offre aux data engineers, aux analystes et aux parties prenantes un point unique pour suivre les incidents, les tendances et les statuts.
La mise en œuvre la plus solide relie la conception des métriques à la collecte, à l'interprétation, à l'escalade et à la remédiation. Avec digna, les équipes peuvent passer de l'installation aux premiers enseignements en moins de deux heures, puis affiner les seuils et les workflows à mesure qu'elles comprennent le comportement de leurs données en production.
digna relie le suivi des KPI métier à la qualité des données, à la ponctualité, à la validation, à la détection d'anomalies et au suivi de schéma, au sein de votre propre environnement. Rendez-vous sur digna pour découvrir comment construire un processus de surveillance auditable qui distingue les véritables évolutions de performance des données peu fiables.
Pour chiffrer ce que coûte réellement à l'entreprise un flux de KPI en retard ou incomplet, passez vos propres données dans le calculateur du coût des interruptions de données avant de décider du niveau de surveillance que mérite chaque métrique.
Questions fréquentes
Qu'est-ce qu'un processus de suivi des KPI ?
Une boucle fermée qui définit pour chaque KPI la décision et le responsable, établit une référence représentative, valide le lignage, calcule à la source de référence, détecte les dépassements et les comportements inhabituels, et achemine les alertes vers une personne responsable. L'objectif est de savoir à la fois ce que dit l'indicateur et si les données qui le sous-tendent sont fiables.
Pourquoi un tableau de bord KPI peut-il afficher des chiffres trompeurs ?
L'outil de reporting peut s'actualiser sans erreur alors que le chargement en amont est arrivé en retard ou incomplet. Dans l'exemple de l'article, le chiffre d'affaires semblait 15 % plus élevé parce que le pipeline avait omis les deux derniers jours de transactions. Sans contrôles de fraîcheur et de complétude, des données incomplètes ressemblent exactement à une meilleure performance.
Quelle est la différence entre une alerte métier et une alerte de fiabilité des données ?
Une alerte de performance métier demande si l'activité s'est comportée différemment : c'est alors au responsable commercial ou opérationnel d'enquêter. Une alerte de fiabilité des données demande si la mesure est digne de confiance : l'équipe de la plateforme de données répare alors une partition manquante ou un schéma modifié. Deux circuits d'alerte distincts envoient chaque problème à la bonne équipe.
Le suivi des KPI doit-il reposer sur des seuils fixes ou sur la détection d'anomalies ?
Les deux. Les seuils fixes conviennent aux limites strictes et explicites, comme les contrôles de valeurs nulles, l'unicité, l'intégrité référentielle, la compatibilité des schémas et les fenêtres de livraison. La détection adaptative des anomalies compare une métrique à son propre historique : elle repère ainsi les niveaux inhabituels, les changements de rythme et les dérives qu'une limite statique unique manquerait ou signalerait comme du bruit.
Qui doit être responsable du suivi des KPI ?
La responsabilité est partagée. Les data engineers gèrent la santé des pipelines et les calendriers de livraison, les analytics engineers les définitions des KPI et la logique des tableaux de bord, les équipes de gouvernance fixent les règles de validation et les exigences de preuve, et le responsable métier décide de l'action qu'appelle un écart. Un KPI sans intervenant désigné devient vite le problème de tous et la tâche de personne.


