Cadres de gestion des données : guide pour choisir et mettre en œuvre
|
7
minute de lecture

Vos tableaux de bord disent une chose, vos analystes une autre, et l'entreprise prend toujours des décisions basées sur des extraits obsolètes. Quelque part dans ce désordre, quelqu'un insiste sur le fait que l'entreprise dispose déjà d'un cadre de gestion des données, mais les données se détériorent toujours en milieu de semaine et la confiance continue de s'effriter. Ce fossé entre la politique et la réalité est l'endroit où la plupart des programmes s'enlisent.
Un cadre opérationnel n'est pas un document. C'est le système d'exploitation de la manière dont les données circulent, sont vérifiées, détenues et corrigées avant d'atteindre les personnes qui en dépendent.
Table des matières
Pourquoi la plupart des stratégies de gestion des données échouent
Le mode d'échec est familier. Une équipe financière voit un chiffre, les opérations un autre, et l'ingénierie des données court après un lignage brisé, des flux tardifs et des champs qui ont changé de format du jour au lendemain. Le cadre existe sur le papier, mais le pipeline se comporte toujours comme une collection de corrections ponctuelles.
La dure vérité est que la gouvernance formelle ne crée pas automatiquement des données fiables. Dans un résumé de statistiques de 2026, 85 % des organisations ont déclaré disposer d'un cadre formel de Data Governance en 2023, pourtant seulement 3 % des données d'entreprise répondent aux normes de qualité de base, et une mauvaise qualité des données coûte aux entreprises en moyenne 12,9 millions de dollars par an. C'est un signal d'alarme clair : disposer d'un cadre ne signifie pas que ce cadre est opérationnel (statistiques de gestion des données Gitnux).
La gouvernance sur papier se brise lors du transfert
Les organisations commencent généralement par des politiques, des conventions de nommage et des circuits d'approbation. Le problème apparaît lorsque personne n'est responsable de leur application dans les systèmes qui déplacent les données. La propriété est sous-entendue plutôt qu'attribuée, et chaque exception se transforme alors en un travail de nettoyage manuel.
La solution commence par un modèle opérationnel différent. Un cadre doit s'intégrer dans l'ingestion, la transformation, la validation et la publication, et non se situer au-dessus d'elles. Si une règle n'est pas appliquée là où la donnée est créée ou déplacée, ce n'est que de la documentation.
Règle pratique : si un contrôle ne peut pas être observé en production, ce n'est pas encore un contrôle.
C'est pourquoi le cadre doit se connecter directement au travail quotidien des ingénieurs de données et des équipes d'analytique. Il a besoin de vérifications mesurables, de propriétaires clairs et d'une escalade rapide lorsque les données s'écartent du comportement attendu. Si vous souhaitez une vision plus approfondie de la manière dont cette couche de gouvernance doit être structurée, la ressource sur la stratégie de digna data governance est un point de référence utile pour la réflexion opérationnelle.
Un deuxième point de défaillance est la centralisation excessive. Lorsque chaque décision passe par un seul comité, les équipes contournent le processus. Il en résulte des pipelines de l'ombre, des définitions incohérentes et des problèmes de qualité qui apparaissent en aval plutôt qu'à la source.
Les composants essentiels d'un cadre efficace
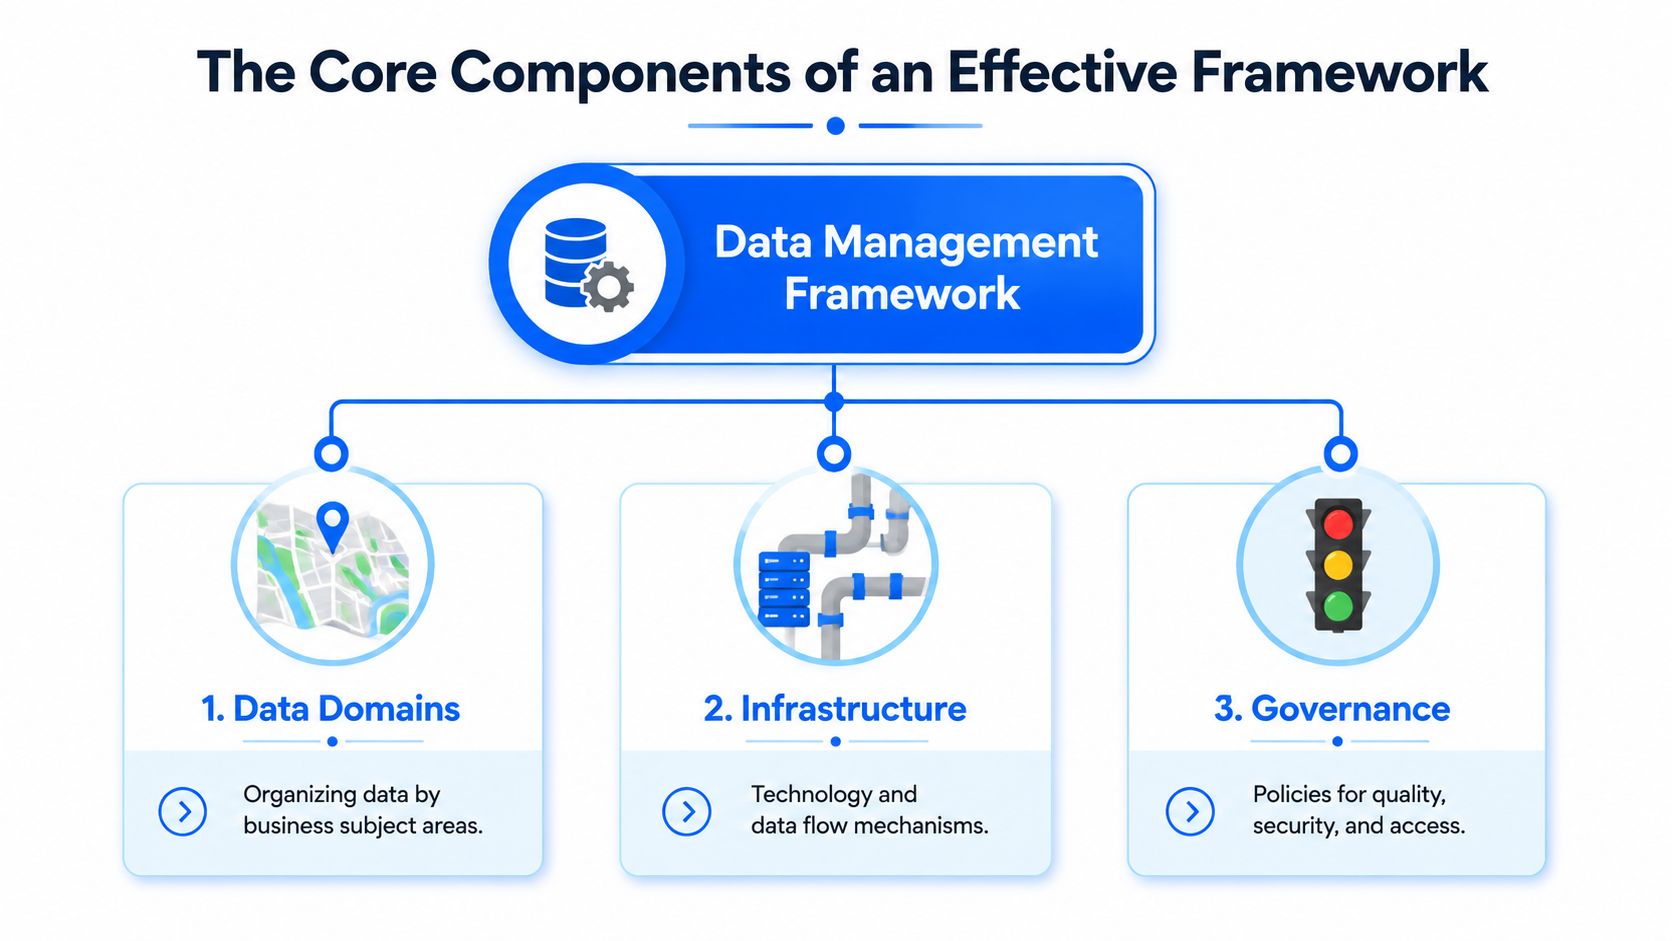
Pensez à un cadre de gestion des données comme à un plan de ville. Les domaines de données sont les quartiers, l'infrastructure est le réseau routier, de services publics et de transport, et la gouvernance est le code de la route qui maintient le tout utilisable. Si l'une de ces couches est manquante, la ville existe toujours, mais elle est plus difficile à gérer, plus facile à endommager et beaucoup plus coûteuse à réparer.
Gouvernance, architecture, qualité, security, métadonnées
Les cadres les plus solides réunissent systématiquement cinq piliers. La Data Governance définit les droits de décision. L'architecture des données définit la manière dont les systèmes, les pipelines et les produits s'articulent. La qualité des données applique les règles qui maintiennent les enregistrements utilisables. La sécurité des données contrôle l'accès et la manipulation. La gestion des métadonnées indique aux utilisateurs ce que signifient les données, d'où elles viennent et comment elles se déplacent.
L'erreur consiste à traiter ces piliers comme des flux de travail distincts. Ils n'ont de valeur que s'ils se renforcent mutuellement. Une règle de qualité sans métadonnées est difficile à interpréter. Des métadonnées sans governance n'indiquent pas qui doit agir. La sécurité sans propriété se transforme en file d'attente de tickets.
Un cadre solide a également besoin d'une responsabilité explicite. De nombreux cadres échouent parce que la propriété, l'intendance et les responsabilités des producteurs/consommateurs ne sont pas formellement attribuées et appliquées (Dataversity sur la crise de la responsabilité). C'est le fossé opérationnel que la plupart des présentations ignorent. Les personnes qui créent les données, celles qui les consomment et celles qui en assurent la gestion ont des responsabilités différentes, et ces responsabilités doivent être visibles dans le flux de travail.
Intégrer la responsabilité dans la conception
De nombreuses équipes rencontrent des difficultés pratiques. Elles nomment un propriétaire de données, mais celui-ci n'a aucune autorité sur les systèmes ou le budget qui façonnent les données. Elles désignent un intendant, mais celui-ci n'entend parler des problèmes qu'après l'échec des rapports. Elles publient un glossaire, mais personne ne l'utilise lors de la construction des pipelines.
La responsabilité fonctionne lorsque le cadre modifie la façon dont le travail est effectué, et non lorsqu'il se contente de nommer des rôles.
Pour les équipes gérant des systèmes riches en données personnelles, la couche opérationnelle importe encore plus. Une ressource pratique telle que le recrutement informatique pour les solutions de confidentialité des données est utile car elle met en évidence la réalité de la dotation en personnel et de l'exécution derrière des environnements aux politiques strictes, en particulier là où la sécurité et la Compliance ne peuvent être séparées de la plateforme de données elle-même.
Ce que le cadre doit définir
Un cadre utile répond à des questions concrètes, pas à des questions abstraites.
Quels domaines sont concernés ? Commencez par les ensembles de données qui orientent les décisions commerciales critiques.
Qui est propriétaire de chaque règle ? Associez chaque règle de qualité, de confidentialité et d'accès à un rôle désigné.
Quelles métadonnées sont requises ? Définissez les descripteurs minimaux nécessaires à la découverte et à la traçabilité.
Quels contrôles sont obligatoires ? Intégrez les règles de validation, de lignage et de transport au pipeline lui-même.
Sans ces spécificités, les équipes improvisent. Avec elles, le cadre devient opérationnel plutôt que cérémoniel.
Comparaison des principaux cadres de gestion des données
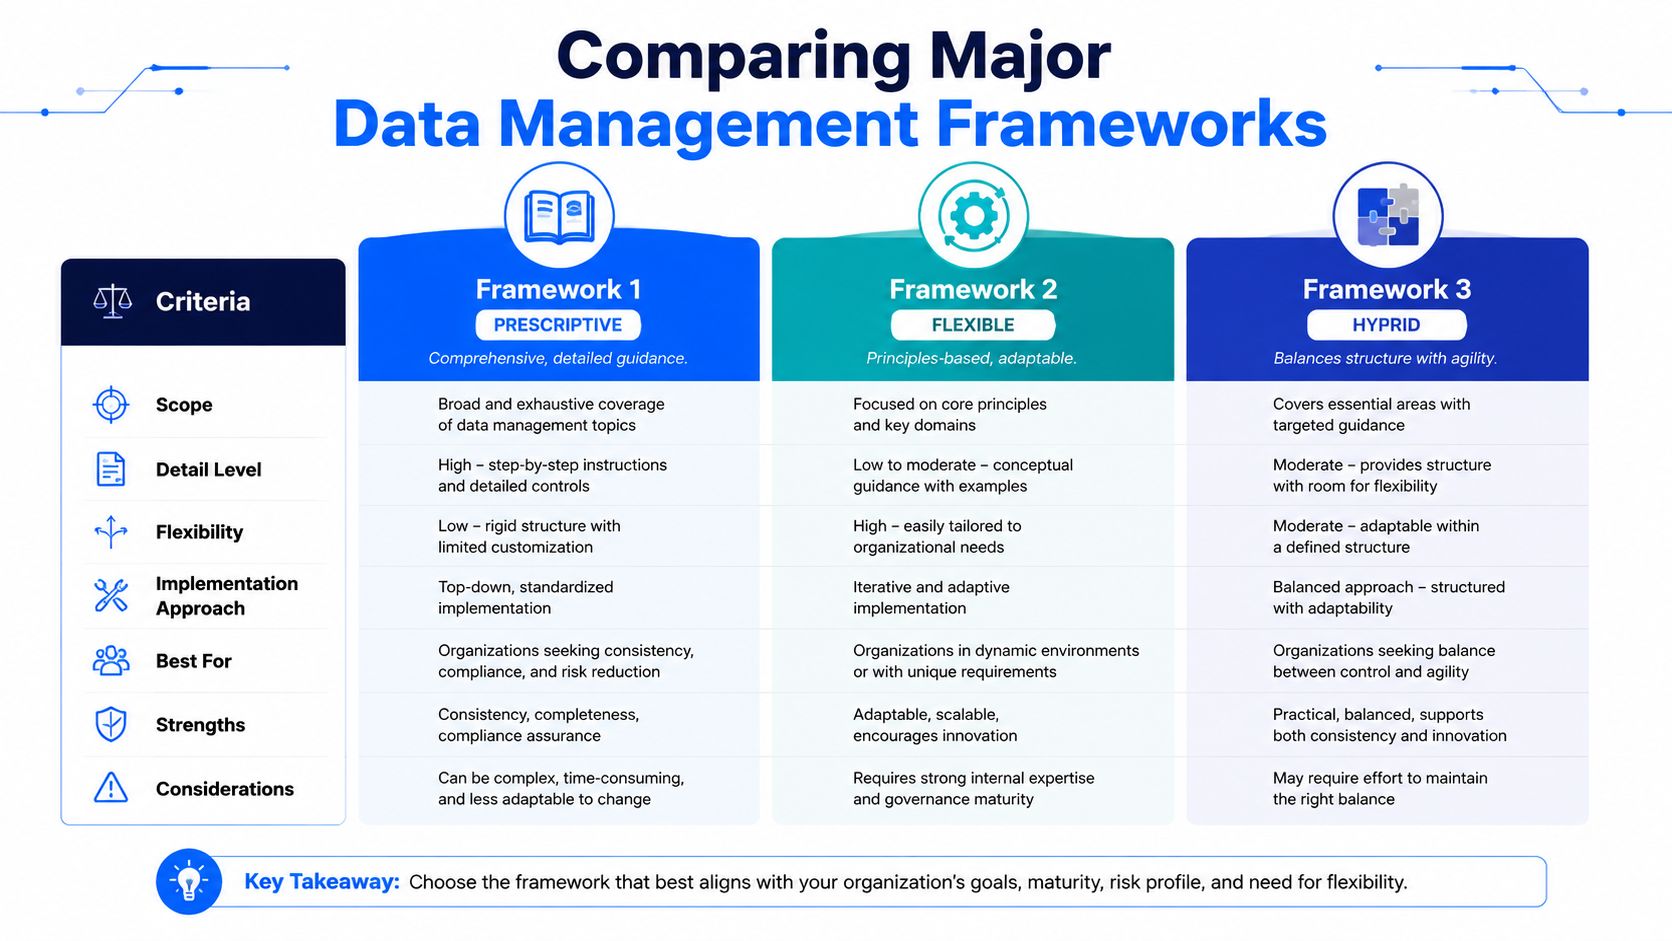
Différents cadres résolvent différents problèmes. Certains sont de vastes corpus de connaissances, d'autres sont des modèles de maturité, et d'autres encore sont des modèles opérationnels. Le mauvais choix ne fait pas que ralentir les progrès, il pousse les équipes à débattre de la terminologie au lieu de déployer des contrôles.
Les cadres prescriptifs et flexibles répondent à des besoins différents
DAMA-DMBOK 2 est généralement le point de référence le plus familier pour les équipes qui recherchent de l'exhaustivité. Il offre un large vocabulaire englobant la gouvernance, la qualité, l'architecture, les métadonnées et l'intendance. Cette ampleur est utile lorsqu'un programme est récent et a besoin d'un langage partagé, mais elle peut sembler lourde si une équipe souhaite un chemin rapide vers le contrôle opérationnel.
DCAM, abréviation de Data Management Capability Assessment Model, est davantage axé sur l'évaluation de la maturité et la discipline de contrôle. Dans le benchmark 2026 de l'EDM Council, 49 % des personnes interrogées utilisant un modèle standard de gestion des données de l'industrie ont déclaré utiliser DCAM, avec une adoption particulièrement forte dans la Finance (62,6 %) et le Secteur Public (70,4 %) (benchmark 2026 de l'EDM Council). Cette tendance est importante car les environnements réglementés ont besoin de contrôles auditables, de pratiques standardisées et de preuves reproductibles.
Data Mesh adopte une position différente. Il pousse la responsabilité vers les équipes de domaine et s'appuie sur des normes partagées plutôt que sur une équipe centrale unique contrôlant tout. Cela fonctionne mieux lorsque l'organisation possède déjà une maturité technique, une approche produit et une responsabilité au niveau du domaine.
Aperçu des cadres de gestion des données
Cadre | Philosophie centrale | Cas d'utilisation principal | Idéal pour |
|---|---|---|---|
DAMA-DMBOK 2 | Corpus de connaissances complet | Construire un langage commun et des bases de gouvernance larges | Équipes définissant des pratiques à l'échelle de l'entreprise |
DCAM | Évaluation de la maturité et des capacités | Mesurer et renforcer les environnements de contrôle | Industries réglementées et programmes soumis à de nombreux audits |
Data Mesh | Propriété décentralisée avec des normes partagées | Passer à l'échelle la propriété des données à travers les domaines | Grandes organisations dotées d'équipes de plateforme solides |
Une décision pratique est rarement une question d'idéologie. C'est une question d'adéquation. Si l'entreprise a besoin d'un vocabulaire commun, commencez par l'exhaustivité. Si l'auditabilité est la pression immédiate, concentrez-vous sur des capacités mesurables. Si les équipes de plateforme sont déjà des goulots d'étranglement centralisés, un modèle fédéré peut être la seule structure viable à l'échelle.
Règle pratique : choisissez le cadre qui correspond à votre mode d'échec actuel, et non celui qui semble le plus avancé.
Un moyen utile d'évaluer les options est de se demander là où le cadre sera le plus sollicité. Si le plus grand problème est l'incohérence des définitions, choisissez une option qui améliore le langage partagé. Si le problème est la faiblesse des contrôles, choisissez une option qui renforce les preuves et la responsabilité. Si le problème est que les équipes locales attendent l'approbation centrale, choisissez une option qui rapproche la propriété du domaine.
Le meilleur cadre est celui que votre organisation peut exécuter, et non celui qui est le plus séduisant dans une présentation. C'est pourquoi de nombreuses équipes mélangent les approches, en adoptant le vocabulaire d'un modèle, la discipline de maturité d'un autre et le modèle de propriété d'un troisième.
Comment choisir le bon cadre

Le bon choix commence par l'adéquation, pas par la popularité. Un cadre qui fonctionne dans une banque fortement réglementée peut ralentir une équipe SaaS axée sur le produit s'il introduit trop d'approbations trop tôt. Un modèle léger peut aider une startup à avancer plus vite, puis devenir un handicap une fois que l'organisation a besoin de traçabilité et de contrôles reproductibles.
Poser les questions qui révèlent la véritable contrainte
Commencez par la pression commerciale. La priorité est-elle la Compliance, la rapidité, la confiance ou la cohérence de la plateforme ? Vérifiez ensuite la réalité opérationnelle. Les propriétaires de données existent-ils déjà ou ne sont-ils que des contacts informels ? L'ingénierie peut-elle appliquer des normes dans les pipelines, ou cela nécessiterait-il d'abord un changement de plateforme ?
Les compétences comptent aussi. Une équipe disposant d'outils d'ingénierie analytique et de métadonnées solides peut absorber un cadre plus détaillé. Une équipe qui nettoie encore des feuilles de calcul à la main a besoin de quelque chose de beaucoup plus pratique, avec moins d'abstractions et plus de vérifications automatiques.
L'infrastructure de données façonne également la réponse. Des entrepôts multiples, des flux en continu et des charges de travail d'IA créent plus de pièces mobiles qu'une simple couche de reporting. Plus l'environnement est complexe, plus un cadre doit définir comment les données sont transportées, quelles métadonnées les accompagnent et quels contrôles sont essentiels.
Utiliser un filtre de décision simple
La pression réglementaire est forte lorsque l'entreprise a besoin de pistes d'audit, de contrôles d'accès et de preuves claires.
La maturité opérationnelle est faible lorsque la propriété n'est pas claire et que les problèmes de qualité sont gérés manuellement.
Les équipes de domaine sont compétentes lorsqu'elles peuvent gérer les normes localement sans perdre en cohérence.
La dispersion de la plateforme est élevée lorsque les outils, les pipelines et les définitions dérivent entre les équipes.
Le délai d'obtention de la valeur est critique lorsque les dirigeants ont besoin de victoires rapides avant un déploiement généralisé.
Si la plupart des réponses s'orientent vers le contrôle et la preuve, choisissez un modèle plus structuré. Si elles s'orientent vers la flexibilité et la propriété distribuée, utilisez un cadre qui peut être adapté sans créer de goulots d'étranglement. Si l'organisation se situe entre les deux, commencez petit et prévoyez de combiner la discipline de gouvernance avec une exécution pratique.
C'est également à ce stade qu'une vision neutre vis-à-vis des fournisseurs est utile. Certaines organisations ont besoin d'outils qui soutiennent le cadre plutôt que de le redéfinir. Si le cadre doit faire ses preuves en production, la plateforme doit aider à l'appliquer, et pas seulement à le documenter. Une couche de surveillance telle que la mise en œuvre de la qualité des données digna correspond à cette réalité car elle prend en charge les contrôles opérationnels plutôt que de s'appuyer sur la seule révision manuelle.
Ne choisissez pas un cadre pour l'organisation que vous souhaitez dans trois ans si l'équipe ne peut pas le faire fonctionner ce trimestre.
Le meilleur processus de sélection est direct. Identifiez le goulot d'étranglement, associez-le au style de cadre, puis seulement décidez de la part d'adaptation raisonnable.
Une feuille de route pratique pour la mise en œuvre
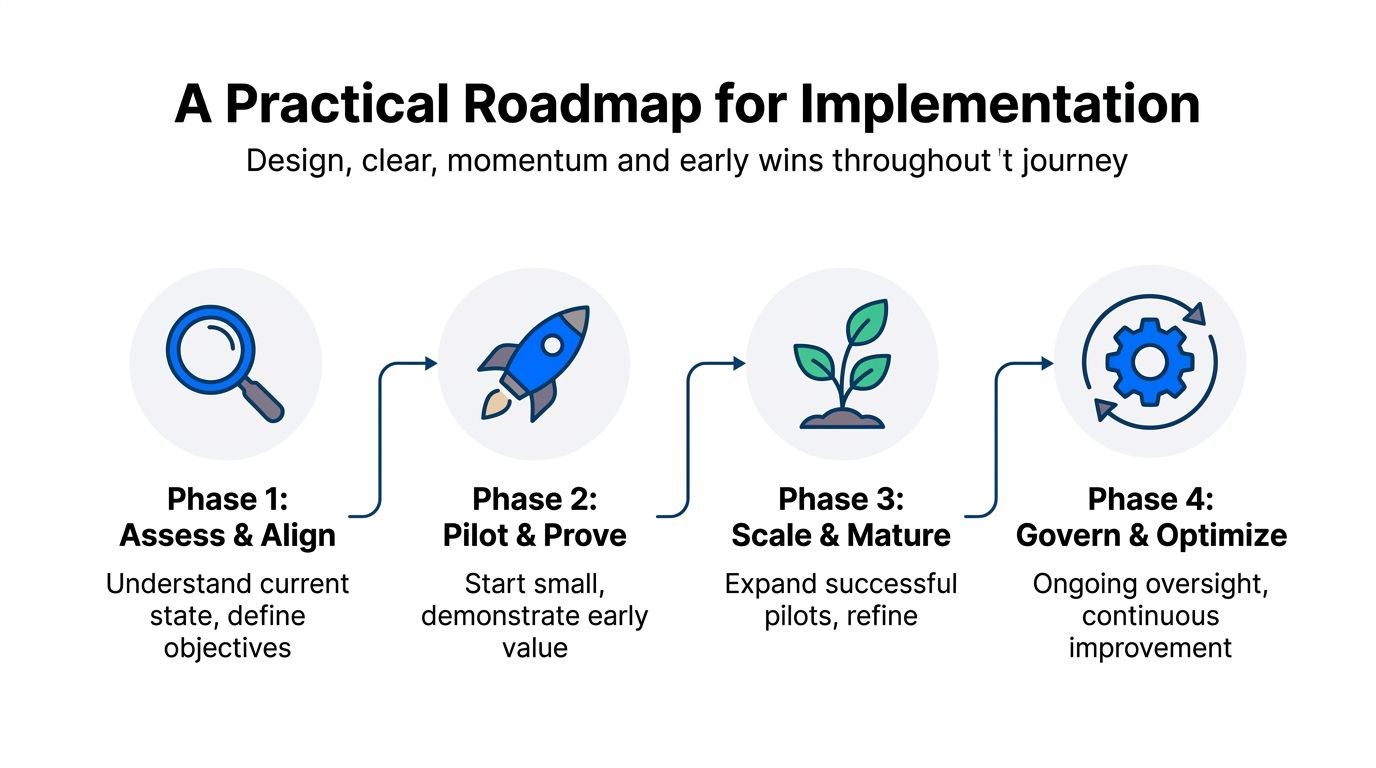
Un cadre ne prend vie que lorsque le pipeline, les métadonnées et les contrôles commencent à fonctionner ensemble. Cela signifie que la mise en œuvre doit ressembler à une séquence de changements gérés, et non à un projet unique de transformation de l'entreprise. L'objectif est de créer une structure suffisante pour améliorer la fiabilité sans bloquer les livraisons.
Phase 1 Évaluer et aligner
Commencez par les domaines de données qui causent le plus de difficultés. Recherchez les tableaux de bord sur lesquels les gens se disputent, les flux qui arrivent en retard et les ensembles de données ayant le plus grand nombre de consommateurs en aval. Identifiez ensuite les propriétaires, les intendants et les systèmes techniques qui touchent à ces domaines.
Cette phase fonctionne le mieux lorsque les équipes documentent le comportement actuel plutôt que le comportement idéal. Qu'est-ce qui arrive et quand, qui le modifie, et quels rapports en dépendent ? Ces réponses deviennent la base de référence du cadre et permettent de garder la conception ancrée dans les conditions d'exploitation réelles.
Phase 2 Piloter et prouver
Choisissez un périmètre restreint et définissez des normes qui peuvent être appliquées immédiatement. Cela signifie un petit ensemble de champs de métadonnées obligatoires, quelques règles de validation à forte valeur ajoutée et une ou deux règles de transport que chaque pipeline du projet pilote doit suivre. Le but n'est pas l'exhaustivité, mais la preuve.
Un document de recherche sur les opérations de big data recommande de combiner un cadre conceptuel, un inventaire d'outils analytiques, des métadonnées minimales requises, des spécifications de transport et des règles d'amélioration des flux de travail afin que les mouvements de données puissent être gouvernés de manière systématique plutôt qu'ad hoc (Journal of Big Data). Cette orientation correspond bien à la mise en œuvre, car le pilote doit démontrer que les contrôles peuvent accompagner les données.
Phase 3 Déployer à l'échelle et mûrir
Une fois que le pilote s'avère utile, étendez-le aux domaines adjacents. Ne copiez pas aveuglément le pilote. Ajustez les règles là où le comportement des domaines diffère, mais conservez le modèle de contrôle central intact. La formation, l'intendance et le traitement des incidents font alors partie intégrante du cadre, et non de tâches secondaires.
Quelques habitudes de mise en œuvre rendent cette phase plus saine :
Standardiser les métadonnées requises afin que le lignage et la propriété ne disparaissent pas aux frontières.
Intégrer la validation dans les pipelines pour que les défaillances apparaissent avant que les tableaux de bord ne se brisent.
Documenter les processus d'escalade afin que les problèmes de qualité parviennent rapidement au bon propriétaire.
Examiner régulièrement les exceptions afin que les contournements ne deviennent pas des raccourcis permanents.
Phase 4 Gouverner et optimiser
À grande échelle, le cadre nécessite un examen continu. Les contrôles dérivent, les règles de gestion changent et de nouvelles sources apparaissent. Le cadre doit absorber ces changements sans se transformer en barrière bureaucratique.
C'est également la phase où l'automatisation importe le plus. Les révisions manuelles ne s'adaptent pas aux entrepôts, aux lacs de données et aux systèmes de streaming. Plus le cadre dépend d'humains repérant les problèmes à la main, plus il sera en retard sur les données elles-mêmes. Si vous voulez que le cadre reste utile, assurez-vous que les contrôles soient suffisamment explicites pour que les systèmes puissent les vérifier en continu.
Moderniser les cadres avec la Data Observability
Les cadres traditionnels deviennent souvent obsolètes parce qu'ils se contentent de décrire les règles. Ils ne vous disent pas si les règles fonctionnent en production. C'est une lacune sérieuse à l'heure où les pipelines de données sont dynamiques, où les systèmes d'IA dépendent d'entrées changeantes et où les modifications de schéma peuvent impacter les consommateurs sans avertissement.
L'Observability offre une boucle de rétroaction au cadre
Un cadre moderne a besoin de preuves, pas d'hypothèses. À mesure que les données deviennent plus non structurées et centrales pour l'IA, les cadres doivent évoluer vers un lignage automatisé et une surveillance continue du comportement des données, de leur ponctualité et des signaux de qualité en production (Alation sur les cadres de gestion des données). Cela transforme la gouvernance, qui passe d'un exercice d'évaluation périodique à un système de contrôle en direct.
C'est là que les plateformes d'observabilité entrent en jeu. Elles surveillent les données après qu'elles ont été définies, modélisées et publiées. Elles détectent les anomalies, les arrivées tardives et les dérives de schéma avant que les utilisateurs métier ne les découvrent dans un rapport erroné ou un modèle défaillant. Si vous évaluez comment cette couche s'intègre dans des environnements riches en IA, le guide des plateformes d'observabilité de l'IA est un compagnon utile car il présente la surveillance comme une partie intégrante du modèle opérationnel, et non comme un ajout.
L'aspect interne est également important. Une couche de Data Observability telle que digna data observability s'aligne sur ce modèle car elle surveille le comportement, suit la ponctualité, détecte les changements structurels et valide les enregistrements au sein même de l'environnement du client. Ce type de boucle de rétroaction est ce qui transforme un cadre statique en quelque chose auquel les équipes peuvent faire confiance en production.
Règle pratique : si le cadre ne peut pas vous dire quand il échoue, il n'est qu'à moitié construit.
L'observabilité comble également le manque de responsabilité. Lorsque le propriétaire constate un incident clair, que l'intendant voit la règle affectée et que l'ingénieur repère l'anomalie exacte dans le comportement, la résolution devient plus rapide et moins politique. C'est ainsi qu'un cadre commence à produire des preuves plutôt que de simples politiques.
Construisez le cadre autour du travail de vos équipes, puis renforcez-le avec des contrôles qui s'exécutent en production. Si vous souhaitez une plateforme de qualité des données et d'observabilité qui reste au sein de votre environnement et prend en charge la détection d'anomalies, la surveillance de la ponctualité, la validation et le suivi des schémas, visitez digna et découvrez comment elle s'intègre dans un cadre qui doit fonctionner, et pas seulement exister.


