10 alternatives à Bigeye pour la Data Observability
|
7
minute de lecture

Choisir une alternative à Bigeye en se basant uniquement sur la détection d'anomalies revient à répéter le problème que les acheteurs essaient de résoudre. La plupart des plateformes établies peuvent identifier des comportements inhabituels en matière de volume, de fraîcheur, de schéma ou de distribution. Elles se différencient plus nettement sur l'endroit où les contrôles sont exécutés, la manière dont les équipes valident les enregistrements, la couverture du lignage et des pipelines, la façon dont les alertes s'intègrent dans les flux opérationnels, l'évolutivité des tarifs et le niveau de contrôle des infrastructures conservé par le client.
Cette distinction est cruciale car les équipes chargées de l'Observability passent encore un temps considérable à réagir après que les utilisateurs ont rencontré des données erronées. Une enquête auprès de responsables de la gestion des données a révélé que seulement 7% résolvent les problèmes de données avant que les utilisateurs ne soient impactés, tandis que 39% consacrent 20 à 40% de leur temps à corriger des problèmes de pipeline. La même étude a révélé que 51% ont besoin de quelques heures et 36% de quelques jours ou plus pour résoudre un seul incident, ce qui rend la prévention, la rapidité d'investigation et l'adéquation du déploiement plus importantes qu'une longue liste de fonctionnalités. (Résumé du rapport Kensu par CDO Magazine)
La comparaison ci-dessous évalue dix alternatives à Bigeye par rapport à des critères d'entreprise pratiques : la localisation des données, la couverture des anomalies, la validation, la Timeliness, la surveillance des schémas, le déploiement, les indicateurs tarifaires et l'effort de migration. Elle associe également chaque option aux capacités modulaires de digna, afin que les équipes puissent distinguer une large suite d'Observability SaaS d'une plateforme en base de données conçue pour un fonctionnement en cloud privé, VPC ou sur site (on-premises).
Table des matières
Top 10 des alternatives à Bigeye : Comparaison des fonctionnalités
Transformer la présélection en une décision de migration sécurisée
1. digna
digna est le choix le plus solide lorsque le contrôle du déploiement et la résidence des données vont de pair avec la couverture d'Observability. Il s'exécute dans l'environnement propre du client, y compris un cloud privé, un VPC ou un centre de données sur site, et effectue le calcul des métriques et les contrôles au sein des bases de données du client. Cette architecture maintient les données de production en place, réduit les mouvements inutiles et prend en charge les exigences de governance pour les données sensibles de la finance, de la santé, des télécommunications et du secteur public. Les recommandations sur la surveillance en base de données soutiennent ce modèle car les contrôles peuvent s'exécuter là où résident les données au lieu de copier des enregistrements sensibles ailleurs. (Guide de surveillance de la qualité des données de Digna)
La plateforme combine la détection automatique avec des contrôles déterministes. Data Anomalies apprend les comportements normaux et identifie en continu les changements inhabituels sans exiger des équipes qu'elles écrivent chaque règle de surveillance. Timeliness apprend les schémas de livraison attendus et signale les arrivées manquantes, tardives ou précoces. Data Validation applique des règles métier au niveau de l'enregistrement, tandis que Schema Tracker détecte les modifications structurelles telles que l'ajout ou la suppression de colonnes et les types de données modifiés. Data Analytics ajoute une analyse des tendances historiques et de la volatilité, ce qui aide les équipes à distinguer un événement ponctuel d'une dégradation continue de la fiabilité.
Là où digna s'intègre le mieux
La conception modulaire de digna permet à une équipe de commencer avec une seule capacité et de s'étendre à mesure que son modèle opérationnel mûrit. Le planificateur, le catalogue de données, les intégrations et les fonctionnalités de collaboration sont disponibles dès la sélection initiale du module, et un tableau de bord partagé offre aux ingénieurs de données, aux analystes et aux parties prenantes une vue commune des incidents, des tendances et des statuts. Le fournisseur indique que l'installation jusqu'aux premières analyses prend moins de deux heures, une affirmation qui doit néanmoins être testée au regard des autorisations de l'acheteur, de la topologie de la base de données et de l'examen de sécurité.
La tarification s'appuie sur des frais de base auxquels s'ajoute un coût par table active et par module. Ce modèle n'applique aucun frais d'API, de volume d'analyse ou de volume d'alertes, ce qui donne aux achats un indicateur d'utilisation plus clair qu'une tarification qui varie à chaque requête ou notification. Le compromis est qu'une empreinte de table très importante peut nécessiter un dimensionnement minutieux, et le déploiement privé place les responsabilités d'infrastructure, d'autorisations et de maintenance du côté du client.
Règle pratique : Choisissez digna lorsque le maintien des données dans votre environnement est une exigence de premier ordre, puis validez le coût total par rapport aux tables actives et aux modules sélectionnés avant de signer.
Consultez la plateforme de Data Observability digna pour découvrir l'architecture et le modèle de modules.
Avantages : Exécution en base de données, déploiement privé, surveillance des anomalies et de la Timeliness pilotée par l'IA, validation au niveau de l'enregistrement, suivi des schémas (Schema Tracker), flux de travail partagés et licences modulaires.
Inconvénients : La tarification par table active et par module nécessite un dimensionnement pour les grands parcs de données, et le déploiement privé exige une prise en charge opérationnelle interne.
2. Monte Carlo Data
Monte Carlo Data est une large suite d'Observability destinée aux organisations qui surveillent des entrepôts, des lacs de données, des systèmes ETL, des actifs de Business Intelligence (BI) et des pipelines d'IA ou d'agents. Ses moniteurs automatisés couvrent la fraîcheur, le volume, le schéma et la distribution, tandis que la détection d'anomalies basée sur le machine learning identifie les écarts par rapport aux comportements attendus. Le lignage au niveau des colonnes et des tableaux de bord relie les incidents aux actifs en aval, aidant les équipes à évaluer l'impact au-delà de la table affectée.
La plateforme prend également en charge la réponse opérationnelle. Le triage des incidents et le routage des alertes vers Slack, Jira et d'autres outils associés connectent la détection à la responsabilisation et à la résolution. Cela fait de Monte Carlo un candidat pour les grands environnements de données modernes (modern data stacks) dotés de nombreux connecteurs et de flux de travail établis. Les acheteurs doivent vérifier que le lignage s'étend bien aux colonnes, tableaux de bord et étapes de pipeline spécifiques utilisés par leurs équipes.

Le compromis face au contrôle en base de données
Le facteur de différenciation de Monte Carlo est l'étendue opérationnelle. digna adopte une approche différente en exécutant les contrôles à l'intérieur des bases de données des clients et en combinant la détection d'anomalies avec la Timeliness, la validation, le suivi des schémas et les analyses historiques via une interface modulaire. La décision dépend donc du modèle opérationnel : Monte Carlo convient aux équipes qui privilégient le lignage et la couverture de l'écosystème, tandis que digna convient aux équipes qui exigent que les données restent dans leur environnement.
Le déploiement et la migration nécessitent leur propre étude de faisabilité (POC). Les équipes doivent tester la couverture des connecteurs, la précision du lignage, la propriété des alertes, les règles de validation et l'effort requis pour traduire les moniteurs Bigeye existants. Les tarifs de Monte Carlo ne sont pas publics ; le service des achats doit donc demander un devis basé sur le périmètre surveillé et les exigences d'intégration.
Avantages : Large couverture de connecteurs, lignage de bout en bout, flux de travail pour les incidents et envergure adaptée aux grandes entreprises.
Inconvénients : Tarification sur devis uniquement, et l'étendue des fonctionnalités peut dépasser les besoins immédiats d'une plus petite équipe.
Consultez cette alternative d'entreprise à l'Observability de données par Monte Carlo pour comparer son architecture et son approche modulaire avec le modèle opérationnel plus large de Monte Carlo.
3. Acceldata
Acceldata cible les environnements hétérogènes où la qualité des données n'est qu'une composante de la fiabilité. Son champ d'action englobe les plateformes de données, les pipelines, les tâches (jobs), les coûts et les performances, incluant les parcs de données cloud, sur site, hybrides, Hadoop et plus largement de Big Data. Cela le rend particulièrement pertinent pour les équipes de plateforme qui modernisent des infrastructures patrimoniales (legacy) sans avoir à migrer chaque charge de travail vers une nouvelle plateforme avant de pouvoir démarrer l'Observability.
La plateforme organise les opérations autour d'un modèle observer, détecter, diagnostiquer et agir. En pratique, les acheteurs doivent évaluer dans quelle mesure ce flux de travail relie les signaux de qualité à l'exécution des pipelines, au comportement de la plateforme, à la governance et à l'optimisation. L'offre Data Observability Cloud d'Acceldata ajoute des flux de travail et une documentation packagés, tandis que son positionnement hybride comble un angle mort fréquent des outils conçus exclusivement pour le cloud.
Couverture globale versus adoption ciblée
Acceldata peut être une excellente solution pour les grands parcs de données comportant plusieurs générations de technologies, mais son étendue peut s'avérer superflue pour une petite équipe d'analyse. La tarification est gérée par l'équipe commerciale et non publique ; une étude de faisabilité doit donc intégrer l'effort de déploiement, les limites de responsabilité et le coût d'activation de fonctionnalités que l'équipe pourrait ne pas utiliser immédiatement.
digna aborde la même problématique d'entreprise par le biais de la modularité et de l'exécution en base de données. Ses modules Data Anomalies, Timeliness, Data Validation, Schema Tracker et Data Analytics se concentrent sur le comportement et la fiabilité des données tout en maintenant les calculs au sein des bases de données du client. Acceldata s'impose plus naturellement sur la liste des candidats lorsque les performances de la plateforme, l'infrastructure et la governance doivent être réunies dans une même vue opérationnelle. digna s'avère plus attractif lorsque le déploiement contrôlé et l'adoption progressive de modules sont les principales contraintes.
Utilisez les outils de Data Observability de digna comme point de référence pour comparer l'étendue d'une plateforme avec une surveillance ciblée résidant dans la base de données.
Avantages : Prise en charge des environnements hybrides et sur site, large visibilité de la plateforme et combinaison de l'Observability, de la governance et de l'optimisation.
Inconvénients : Périmètre potentiellement excessif pour les petites équipes, et tarification nécessitant une mise en relation avec le service commercial.
4. Anomalo
Anomalo est une plateforme de qualité des données native IA, construite autour d'une détection automatisée des problèmes avec un minimum de rédaction de règles. Son approche non supervisée est conçue pour identifier les comportements anormaux sur l'ensemble des données structurées, semi-structurées et non structurées, puis pour accompagner l'investigation des causes profondes. Cela la rend attractive pour les équipes qui souhaitent une couverture des anomalies rapide sans avoir à maintenir une large bibliothèque de contrôles rédigés manuellement.
L'accent mis sur l'écosystème est évident. Des intégrations profondes avec Databricks, Snowflake et des partenaires de catalogues peuvent réduire les frictions d'installation lorsque ces systèmes structurent déjà le patrimoine de données. Des options de déploiement pour grandes entreprises et des accords de niveau de service (SLA) sont disponibles, mais l'acheteur doit tout de même distinguer la détection d'anomalies du contrôle déterministe. Un modèle peut identifier qu'un ensemble de données a changé de manière inattendue, alors qu'une règle critique pour l'entreprise nécessite toujours une condition de validation explicite.
La détection d'anomalies ne constitue pas toute la couche de contrôle
digna couvre ce même cas d'usage d'anomalie à faible configuration via le module Data Anomalies, mais y ajoute des modules distincts pour Data Validation, Timeliness et Schema Tracker. Ce cloisonnement est important pour les équipes qui ont besoin à la fois de modèles d'apprentissage de référence et de règles métier auditables. Un contrôle de dérive de schéma (schema-drift), par exemple, compare une structure entrante avec un schéma de référence ou cible et alerte lorsque des colonnes ou des types de données changent. (Guide pratique de détection de dérive de schéma)
La tarification d'Anomalo n'est pas publique et nécessite de contacter l'équipe commerciale. Les détails disponibles en libre-service sont également plus limités que ceux de certains concurrents SaaS. La planification de la migration doit donc inclure une évaluation technique, un examen de sécurité et une phase de découverte commerciale plutôt que de s'appuyer uniquement sur une démonstration produit.
Avantages : Rédaction minimale de règles, prise en main rapide axée sur les anomalies, options de déploiement en entreprise et fortes intégrations avec les entrepôts de données.
Inconvénients : Tarification non publique, et les équipes peuvent avoir besoin de contrôles supplémentaires pour l'application de règles métier explicites ainsi que pour les exigences de déploiement en base de données.
5. Soda
Soda associe un point d'entrée open-source à un produit d'Observability géré. Soda Core prend en charge les contrôles et les Data Contracts sous forme de code, incluant des définitions au format YAML et des contrôles intégrés, afin que les ingénieurs puissent intégrer la validation au sein du développement de pipelines et des flux de travail CI/CD. Soda Cloud ajoute la surveillance des métriques, l'établissement de références historiques, la détection d'anomalies, la collaboration et des flux de travail de governance.
Ce double modèle modifie la question de la migration. Une équipe peut démarrer avec une interface CLI et un flux de travail open-source, puis évoluer vers des fonctionnalités managées lorsqu'elle a besoin d'une surveillance et d'une collaboration centralisées. Cette approche peut réduire la dépendance vis-à-vis du fournisseur, mais l'Observability avancée et la governance restent associées au produit géré Cloud, et non à la seule couche open-source.
Là où la propriété des règles compte
Soda convient aux équipes qui souhaitent que les ingénieurs expriment les exigences de qualité des données au plus près du code et de l'orchestration. Il est moins adapté aux organisations qui recherchent une surveillance de livraison et d'anomalies automatisée sans avoir à maintenir de nombreuses définitions de tests. digna propose ces deux aspects grâce aux modules automatiques Data Anomalies et Timeliness, complétés par les modules explicites Data Validation et Schema Tracker.
La fraîcheur et la Timeliness doivent être testées séparément lors de la migration. La fraîcheur vérifie si les enregistrements sont arrivés dans un intervalle attendu, tandis que la Timeliness détermine si les données sont devenues exploitables dans le délai imparti pour la prise de décision. (Guide de contrôle de la qualité des données en entreprise) Cette distinction peut révéler des lacunes masquées par un moniteur de « fraîcheur » générique.
Les tarifs publics de Soda Cloud ne sont pas diffusés ; les acheteurs doivent donc obtenir un devis basé sur les sources, les contrôles, les utilisateurs et le périmètre géré.
Avantages : Entrée par l'open-source, contrôles sous forme de code, intégration dans les pipelines et transition claire vers l'Observability managée.
Inconvénients : La collaboration avancée et la governance nécessitent Soda Cloud, et la tarification Cloud se fait sur devis.
Comparez les modèles opérationnels dans cette alternative à Soda pour la qualité des données en entreprise.
6. Metaplane fait désormais partie de Datadog
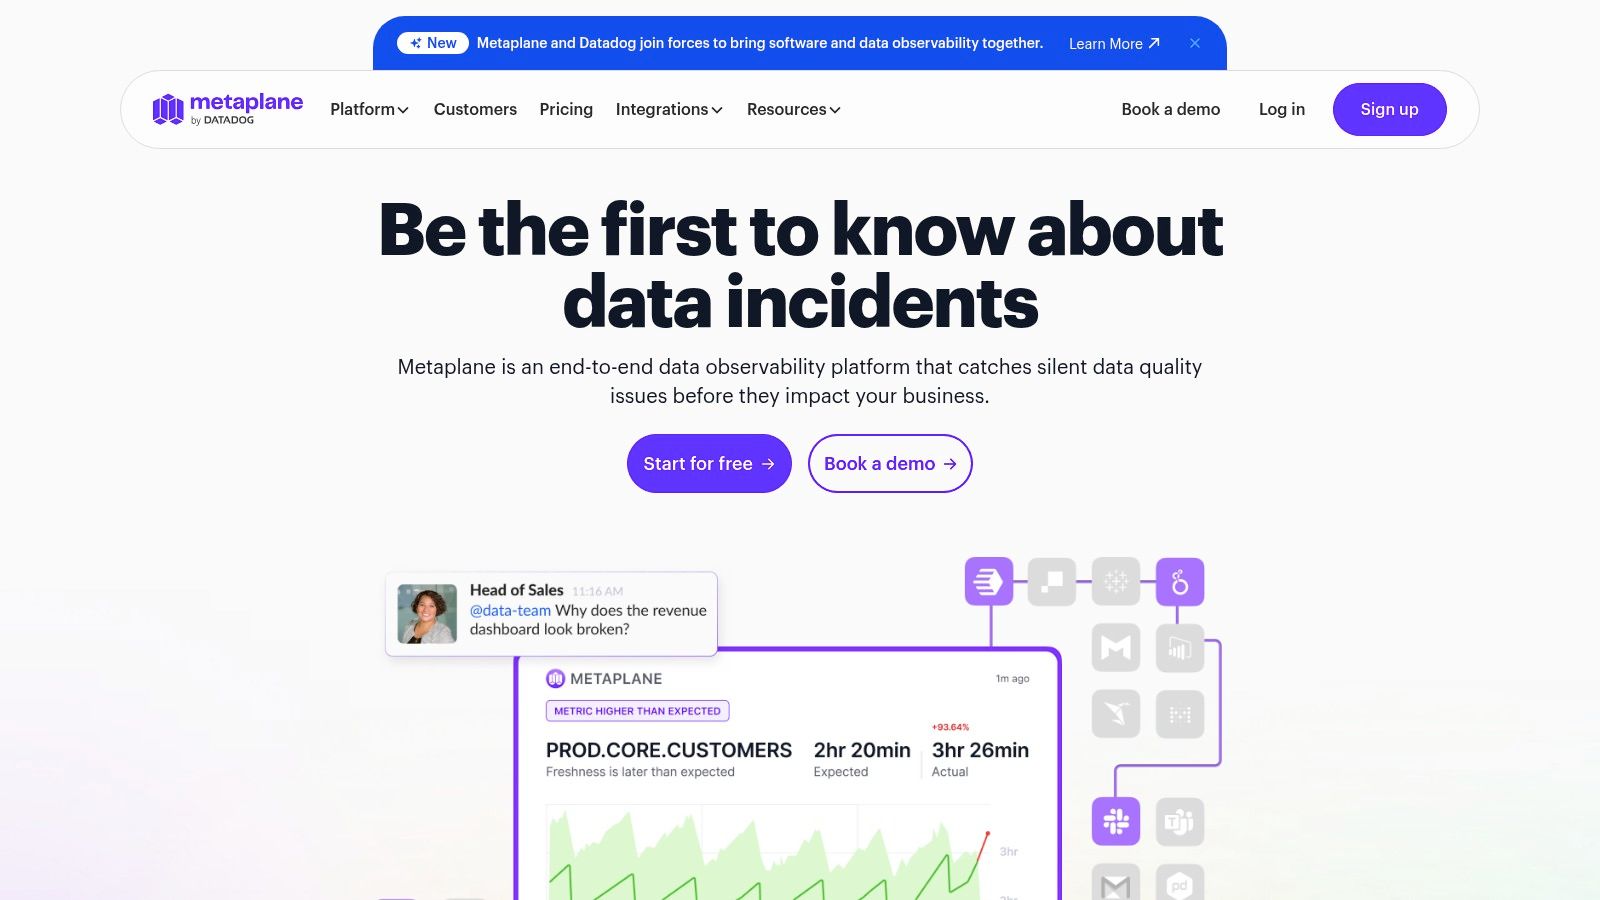
Metaplane se concentre sur l'intégration SaaS rapide pour les architectures de données modernes. Sa détection d'anomalies basée sur le machine learning prend en compte la saisonnalité et les tendances, tandis que le lignage au niveau des colonnes et l'analyse d'impact aident les équipes à comprendre les conséquences en aval. La CI/CD des données détecte les régressions dans les pull requests, et les alertes Slack ou Microsoft Teams connectent la détection aux outils de communication existants des ingénieurs.
L'option d'application native Snowflake (Snowflake Native App) constitue une distinction architecturale majeure. Elle conserve les données au sein de l'entrepôt et permet un paiement via les crédits Snowflake, ce qui peut simplifier l'examen de sécurité et l'achat pour les équipes centrées sur Snowflake. Cela ne correspond pas pour autant à un contrôle étendu sur un cloud privé ou sur site. Les acheteurs disposant d'environnements hétérogènes ou réglementés doivent tester la manière dont la profondeur des fonctionnalités évolue en dehors du périmètre Snowflake.
Démarrage rapide, périmètre d'entreprise plus restreint
L'offre gratuite de Metaplane encourage l'expérimentation, et son modèle d'accès en lecture seule peut faciliter les discussions initiales sur la sécurité. En contrepartie, l'étendue des fonctionnalités est plus limitée. Il se peut qu'il ne remplace pas une suite d'entreprise plus vaste lorsque les équipes ont besoin d'une governance globale, de multiples modèles de déploiement ou d'une couverture approfondie des anciennes plateformes.
Le point de comparaison avec digna ne se limite pas à la rapidité d'intégration. digna propose l'exécution en base de données, le déploiement sur cloud privé ou sur site, un tableau de bord partagé et des modules couvrant les anomalies, la Timeliness, la validation, les modifications de schéma et les analyses historiques. Les équipes devraient comparer le temps nécessaire pour connecter une source représentative, configurer les autorisations, analyser une alerte et produire des preuves pour la governance.
Un bon point de départ consiste à consulter cette explication sur le rôle d'une plateforme d'Observability, puis à valider ces détails au regard de votre propre entrepôt et de votre chaîne d'orchestration.
Avantages : Prise en main rapide, version gratuite, accès en lecture seule, lignage, contrôles CI/CD et option de déploiement natif Snowflake.
Inconvénients : La suite est plus restreinte que les plus grandes plateformes d'entreprise, et les capacités varient selon les systèmes de données.
7. IBM Data Observability par Databand
IBM Data Observability par Databand est centré sur la fiabilité des pipelines et des tâches (jobs). Il surveille les tâches, suit les accords de niveau de service (SLA) et alerte les équipes en cas de défaillances ou de risques de livraison sur l'ensemble des outils d'orchestration et d'entrepôt de données. Le cadre d'assistance, d'approvisionnement, de documentation et de contractualisation d'IBM peut être décisif pour les entreprises réglementées qui standardisent déjà leurs services sur les solutions IBM.
Cette option relève moins d'un libre-service léger que d'une intégration de l'Observability dans un modèle opérationnel d'entreprise bien établi. Les équipes doivent s'attendre à un processus d'achat et de mise en œuvre façonné par les normes internes, les exigences d'assistance et la governance des intégrations. Cette expérience peut convenir aux organisations qui privilégient la responsabilité du fournisseur et la continuité contractuelle plutôt qu'une activation rapide en version d'essai.
L'adéquation dépend de l'attribution interne et de l'approvisionnement
La tarification s'effectue par contrat et peut utiliser des licences par unité de ressource pour certaines références (SKU). Cela rend difficile une comparaison à périmètre constant, à moins que l'acheteur ne définisse les tâches surveillées, les environnements, les utilisateurs, les attentes en matière d'assistance et les hypothèses de renouvellement avant de demander un devis.
digna propose une autre voie. Sa licence modulaire débute avec un seul module et s'étend par table active et par module, tandis que son architecture en base de données maintient les analyses au sein de l'environnement du client. La comparaison pratique s'établit donc entre un modèle de fiabilité des pipelines centré sur IBM et un modèle modulaire de qualité et d'Observability des données qui comprend Data Anomalies, Data Analytics, Timeliness, Data Validation et Schema Tracker.
IBM est un candidat logique à présélectionner lorsque l'assistance et les canaux d'achat IBM existants ont un poids important. digna mérite une évaluation plus approfondie lorsque les ingénieurs de données et les équipes de governance ont besoin d'une interface partagée unique pour les comportements appris et les contrôles de qualité explicites.
Avantages : Support IBM, contractualisation d'entreprise, documentation, alignement sur la governance et surveillance des SLA de pipelines.
Inconvénients : L'expérience peut s'avérer moins autonome, et la tarification se fait sur devis avec une facturation par unité de ressource possible sur certaines offres.
8. Lightup
Lightup associe des contrôles basés sur des règles à une détection d'anomalies par l'IA, du lignage, de la réconciliation et de la gestion des incidents. Son approche Zero-Config Auto Metrics vise à générer rapidement une couverture de base, tandis que les recommandations de l'IA aident les équipes à identifier les zones où une surveillance supplémentaire s'avère utile. Des intégrations avec Collibra, Alation, ainsi que des outils de ticket et d'alerte étendent la plateforme aux flux de governance et de gestion des incidents.
La structure des forfaits Cloud et Enterprise pose aux acheteurs une question de déploiement pertinente plutôt qu'une simple question de fonctionnalités. Un déploiement cloud peut alléger la responsabilité opérationnelle, tandis que les options d'entreprise ou hybrides peuvent mieux répondre aux contraintes de résidence et d'accès aux données. L'évaluation doit confirmer où s'effectue le calcul des métriques, quelles données de production quittent l'environnement et comment les autorisations sont administrées.
Auto-activation versus déploiement modulaire contrôlé
L'activation rapide de Lightup peut réduire le délai d'obtention de la première couverture. digna propose une idée similaire d'adoption progressive grâce à ses licences modulaires, mais son facteur de différenciation réside dans le fait que les contrôles et les calculs de métriques s'exécutent au sein des bases de données du client. Cela peut s'avérer plus important que la vitesse d'installation initiale pour les équipes qui gèrent des données de production sensibles.
Aucun tarif public en devises n'est disponible ; le devis doit donc distinguer les frais de plateforme, le périmètre surveillé, le niveau de déploiement, les intégrations et l'assistance. Les acheteurs doivent également tester si les métriques générées automatiquement produisent des incidents utiles ou s'il s'agit simplement d'étendre la surface d'alerte. L'objectif n'est pas d'activer tous les moniteurs possibles, mais d'identifier les défaillances le plus tôt possible sans obliger les ingénieurs à analyser des événements à faible valeur ajoutée.
Avantages : Configuration rapide de la base de référence, détection d'anomalies par IA, lignage, réconciliation, intégrations de governance et options de déploiement cloud ou d'entreprise.
Inconvénients : Tarification sur devis, et sa visibilité sur l'écosystème est plus restreinte que celle des leaders du marché.
9. Telmai
Telmai est conçu pour les architectures ouvertes et les environnements lakehouse structurés autour de formats comme Iceberg, Hudi ou Delta. Son positionnement sans code ou à faible code, sa détection d'anomalies sans règles, son suivi de la dérive (drift), ses contrôles de Timeliness, sa surveillance des schémas et ses requêtes d'incidents en langage naturel s'adressent aux équipes qui recherchent une large couverture sans concevoir manuellement chaque détecteur.
L'outil Root-cause Investigator de la plateforme vise à dépasser la simple alerte initiale pour fournir des explications. La disponibilité sur l'AWS Marketplace peut également simplifier une phase d'essai initiale ou le processus d'achat pour les équipes opérant déjà via AWS. Cette commodité ne dispense pas de modéliser le périmètre surveillé, les responsabilités de déploiement et la façon dont la plateforme interagit avec les formats de table ouverts.
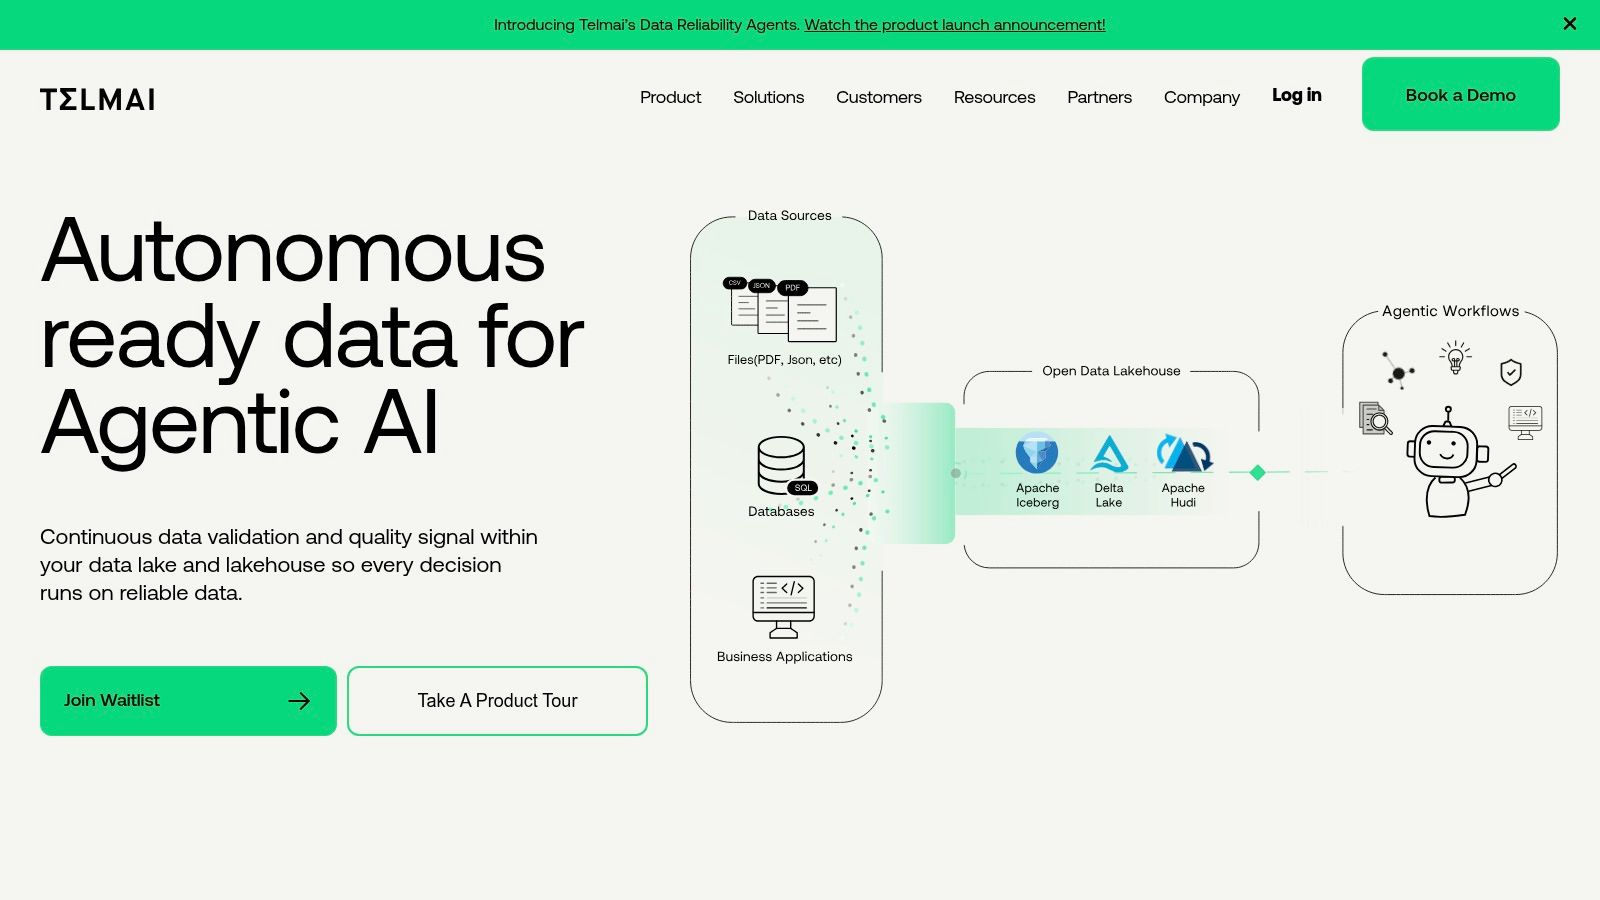
Les formats ouverts modifient le test de migration
Telmai est un candidat solide lorsque l'ouverture du lakehouse est la principale exigence architecturale. digna s'impose d'autant plus si l'équipe a également besoin d'une exécution en base de données, d'un déploiement privé, de validations au niveau de l'enregistrement, d'un suivi de la Timeliness appris par l'IA et d'une interface partagée par les ingénieurs, les analystes et les responsables de la governance.
Les pratiques de Data Observability regroupent généralement la qualité, la fraîcheur, le lignage et les modifications de schéma comme signaux de surveillance clés, les contrôles en temps réel contribuant à prévenir les défaillances des analyses et des systèmes d'IA en aval. (Étude sur les signaux de Data Observability) Lors d'un POC, comparez non seulement si les deux plateformes détectent la même dérive, mais aussi si chacune peut expliquer le problème dans la terminologie opérationnelle préférée de l'équipe.
La tarification de Telmai n'est pas publique et dépend du périmètre surveillé ainsi que du déploiement. Sa présence communautaire est également plus restreinte que celle de fournisseurs installés de longue date ; les acheteurs doivent donc évaluer la documentation, l'accompagnement à la mise en œuvre et la gestion interne.
Avantages : Excellente adéquation avec le modèle lakehouse et les formats ouverts, couverture des anomalies sans règles, investigation en langage naturel et disponibilité sur l'AWS Marketplace.
Inconvénients : Tarification dépendante d'un devis, et présence communautaire plus réduite que celle des acteurs historiques du marché.
10. Kensu
Kensu utilise des agents déployables pour observer les données en mouvement et au repos. Son approche instrumente les pipelines là où les données sont utilisées, en collectant en temps réel le lignage, le schéma et les métriques de qualité sur des outils tels que dbt, Databricks ou Spark, Azure Data Factory et Snowflake. Cela permet de réduire les angles morts dans les environnements distribués où un moniteur limité à l'entrepôt voit la destination mais pas le chemin de transformation qui l'a générée.
Des contrôles de type coupe-circuit (circuit-breaker) et des flux de traitement d'incidents permettent à Kensu d'aller au-delà de la simple notification passive. Une version Community Edition et des options d'étude de faisabilité peuvent aider les développeurs à évaluer ce modèle d'instrumentation avant de s'engager dans un déploiement plus large. La question clé de la migration est de savoir si l'équipe souhaite des agents intégrés dans les pipelines ou si elle préfère des contrôles s'exécutant directement dans la base de données.
Profondeur de l'instrumentation versus exécution résidente dans les données
Le modèle d'observation de Kensu là où les données sont utilisées peut révéler un contexte que la seule surveillance des tables ne permet pas de voir. digna emprunte une voie différente avec l'exécution en base de données, maintenant le calcul des métriques et l'analyse au sein des bases de données du client tout en couvrant les anomalies, les analyses historiques, la Timeliness, la validation et les modifications de schémas grâce à des modules distincts.
La tarification de Kensu n'est pas publiée et se fait généralement sur devis. Les détails présents sur le site web sont également plus succincts que ceux des plus grands éditeurs, certains contenus étant transmis par le biais de la documentation ou de canaux professionnels. L'évaluation doit donc inclure une présentation détaillée de la mise en œuvre, des autorisations des agents, du comportement en cas de panne, de la responsabilité des mises à jour et de la conservation des données de preuve.
Avantages : Instrumentation des pipelines en temps réel, surveillance du lignage et des schémas, visibilité distribuée et options d'évaluation communautaire.
Inconvénients : Tarification non publique, et les équipes doivent évaluer la charge opérationnelle liée au déploiement et à la maintenance des agents.
Top 10 des alternatives à Bigeye : Comparaison des fonctionnalités
Fournisseur | Capacités clés | Arguments clés de vente | Public cible | Déploiement et Sécurité | Tarification et Valeur |
|---|---|---|---|---|---|
🏆 digna | Détection d'anomalies, Timeliness, Validation d'enregistrements, Suivi des schémas (Schema tracker), Métriques et analyses en base de données (In‑DB) | ✨ Exécution en base de données (In‑DB), apprentissage de référence par IA, déploiement modulaire, TTV rapide ★★★★★ | 👥 Ingénieurs de données, BI/analystes, governance ; finance/santé/télécom/secteur public | S'exécute dans l'infrastructure du client (cloud privé/VPC/sur site) ; le fournisseur n'accède pas aux données de production | 💰 Tarification modulaire transparente : base + par table active/module ; prévisible mais dépend de l'échelle |
Monte Carlo Data | Moniteurs de fraîcheur, volume, schéma et distribution ; lignage colonnes/tableaux de bord ; flux d'incidents | ✨ Large couverture de connecteurs/technologies ; solides références d'entreprises ★★★★ | 👥 Grandes entreprises avec des architectures et des équipes d'analyse diversifiées | Connecteurs Cloud/SaaS sur les entrepôts, lacs de données, ETL, BI | 💰 Tarification d'entreprise sur devis ; peut être lourde pour de petites équipes |
Acceldata | Observability des plateformes/pipelines/tâches, coûts, performances, flux de travail packagés | ✨ Prise en charge hybride/sur site + orientation governance et optimisation ★★★★ | 👥 Environnements vastes et hétérogènes ; entreprises modernisant le Big Data | Options de déploiement cloud, sur site et hybride ; contrôles d'entreprise | 💰 Tarification gérée par l'équipe commerciale ; adapté aux grands parcs de données |
Anomalo | Détection non supervisée d'anomalies, analyse des causes profondes, intégrations (Databricks/Snowflake) | ✨ Détection sans règles, retour sur investissement rapide (time‑to‑value) ★★★★ | 👥 Équipes nécessitant une détection rapide d'anomalies sans règles lourdes | SaaS avec options de déploiement en entreprise ; fortes intégrations cloud | 💰 Sur devis ; accords de niveau de service (SLA) d'entreprise disponibles |
Soda | Contrôles/contrats sous forme de code (Soda Core OSS) ; Soda Cloud pour références et alertes | ✨ Entrée par l'OSS (plus de 50 contrôles) → parcours de migration vers Cloud managé ★★★ | 👥 Développeurs/ingénieurs souhaitant une approche axée sur l'OSS et l'intégration dans les pipelines | OSS (CLI) + Cloud managé ; s'intègre aux entrepôts de données et aux outils d'orchestration | 💰 OSS gratuit ; Soda Cloud = contact commercial pour la tarification |
Metaplane (Datadog) | Détection d'anomalies par ML, lignage des colonnes, Data CI/CD, application native Snowflake | ✨ Prise en main rapide, offre gratuite à vie, option native Snowflake ★★★★ | 👥 Équipes de petite à moyenne taille, organisations centrées sur Snowflake, POC rapides | SaaS + Snowflake Native App (les données restent dans l'entrepôt) | 💰 Version gratuite disponible ; forfaits payants / tarification Datadog |
IBM Data Observability (Databand) | Observability de pipelines/tâches, suivi des SLA, intégrations orchestration et entrepôt | ✨ Support IBM, conformité d'achat et adéquation entreprise/réglementaire ★★★ | 👥 Entreprises réglementées et acheteurs standardisés sur les solutions IBM | Déploiements d'entreprise, support IBM / structures de produits IBM | 💰 Tarification par contrat/commerciale ; modèle d'achat d'entreprise |
Lightup | Contrôles de règles + détection d'anomalies par IA, lignage, réconciliation, gestion des incidents | ✨ Indicateurs automatiques sans configuration pour une couverture rapide ★★★ | 👥 Équipes souhaitant une couverture automatique et une collaboration rapides | Forfaits Cloud et Enterprise ; options hybrides | 💰 Sur devis ; clarté entre les offres Cloud et Enterprise |
Telmai | Observability de lacs/lakehouses (Iceberg/Hudi/Delta), dérive/Timeliness/schémas, requêtes en langage naturel | ✨ Orientation formats ouverts, requêtes d'incidents en langage naturel, disponibilité AWS Marketplace ★★★ | 👥 Équipes lakehouse, environnements à formats ouverts, préparation GenAI | Déploiements cloud ; option d'achat sur la place de marché (AWS) | 💰 Tarification selon le périmètre ; contact commercial requis |
Kensu | Lignage basé sur des agents, métriques de schéma et de qualité, observations et profils en temps réel | ✨ Observation là où les données sont utilisées ; édition communautaire/POC ★★★ | 👥 Équipes nécessitant une instrumentation en temps réel et une évaluation développeurs | Déploiement d'agents à travers les pipelines ; télémétrie en temps réel | 💰 Tarification commerciale ; version Community Edition pour évaluation |
Transformer la présélection en une décision de migration sécurisée
Le choix de la bonne alternative à Bigeye dépend moins du nombre de moniteurs présentés lors d'une démonstration que de la manière dont la plateforme se comporte face à la localisation réelle de vos données, à votre modèle de responsabilité et à vos processus de gestion des incidents. La demande du marché évolue dans cette direction. Une étude estime que le marché de la Data Observability passera de 3,51 milliards USD en 2026 à 6,03 milliards USD d'ici 2031, avec un taux de croissance annuel composé attendu de 11,42% sur cette période. (Étude de marché 2026 sur la Data Observability) La croissance à elle seule ne désigne pas le bon produit, mais elle montre que les équipes prennent une décision d'infrastructure à long terme plutôt que d'acheter un système d'alerte temporaire.
Commencez par un inventaire, pas par une grille d'évaluation des fournisseurs. Listez les tables critiques, les pipelines, les tableaux de bord, les modèles et les utilisateurs opérationnels. Identifiez les actifs contenant des données sensibles, les systèmes fonctionnant sur des réseaux privés ou sur site, et les charges de travail qui ne peuvent tolérer aucune copie de données de production. Classez ensuite les contrôles requis :
Couverture des anomalies : Identifiez les comportements qui nécessitent des références apprises, notamment le volume, la distribution, les indicateurs métiers et les signaux de plateforme.
Exigences de Timeliness : Définissez distinctement les fenêtres d'arrivée et de décision attendues. Un ensemble de données peut arriver dans un intervalle de fraîcheur nominal sans pour autant respecter le moment où un processus métier en a besoin.
Règles de validation : Documentez la logique métier au niveau des enregistrements, les contrôles réglementaires, les conditions de réconciliation et les contrôles qui doivent rester explicites plutôt que déduits.
Surveillance des schémas : Spécifiez comment les ajouts de colonnes, les suppressions de champs et les modifications de types doivent impacter les utilisateurs en aval.
Flux d'investigation : Évaluez si un ingénieur peut passer de l'alerte à l'actif concerné, identifier la cause probable, le propriétaire et la résolution sans avoir à basculer entre des outils déconnectés.
Testez les finalistes avec des charges de travail représentatives, et non un échantillon épuré. Intégrez une table à haute valeur, un pipeline retardé, un changement de schéma planifié, un décalage de distribution inattendu et une violation de règle. Comparez la qualité des alertes, le temps d'investigation, l'utilité du lignage et l'effort nécessaire pour affiner les moniteurs. Ne considérez pas le nombre d'alertes comme un succès. Comptez les alertes qui mènent à une action claire.
La modélisation des coûts exige le même réalisme. Certains fournisseurs facturent en fonction du périmètre surveillé, d'autres utilisent des indicateurs de ressources ou d'utilisation, et digna applique des frais de base plus un coût par table active et par module, sans frais d'API, de volume d'analyse ou de volume d'alertes. Demandez à chaque fournisseur de modéliser l'évolution des coûts en fonction de vos tables actives, des modules sélectionnés, de vos environnements, de vos intégrations et de vos exigences de support. Le constat sur la prolifération des outils est ici parlant : 46,7% des organisations utilisent deux à trois outils d'Observability en parallèle, tandis que seulement 7,4% s'appuient sur une seule plateforme unifiée. (Résumé d'une enquête indépendante sur l'Observability) La consolidation peut améliorer la clarté des processus, mais uniquement si la solution de remplacement couvre les contrôles qui ont initialement contraint les équipes à ajouter des outils complémentaires.
La cartographie des modules de digna offre une base de comparaison pratique :
Data Anomalies : Apprentissage de référence basé sur l'IA et détection continue des anomalies sans configuration manuelle des règles.
Data Analytics : Tendances historiques, volatilité et analyse statistique pour comprendre la fiabilité au fil du temps.
Timeliness : Calendriers de livraison appris par IA, délais de livraison attendus, chargements tardifs, données manquantes et arrivées précoces.
Data Validation : Application de règles métier au niveau de l'enregistrement pour les contrôles de qualité, d'audit et de Compliance.
Schema Tracker : Détection continue des colonnes ajoutées ou supprimées et des modifications de types de données.
Exécution en base de données : Calcul des métriques et analyses au sein des bases de données du client, maintenant les données sur place.
Options de déploiement : Installation sur cloud privé ou sur site au sein du cloud, du VPC ou du centre de données du client.
Tableau de bord partagé : Une interface unique pour les ingénieurs, les analystes, les équipes de governance et les autres parties prenantes.
Composants inclus : Planificateur, catalogue de données, intégrations et fonctionnalités de collaboration dès la sélection initiale du module.
Licences modulaires : Démarrez avec un seul module et étendez par table active et par module.
Rigueur de migration : Maintenez Bigeye et l'alternative sélectionnée en parallèle sur les mêmes charges de travail représentatives suffisamment longtemps pour comparer la détection, l'investigation, le comportement des coûts et l'effort d'administration.
Documentez les critères de retour arrière (rollback) avant de démarrer la migration. Définissez ce qui constitue un niveau inacceptable de bruit d'alerte, d'incidents manqués, de consommation de calcul inattendue, d'intégrations défaillantes ou de preuves insuffisantes pour la governance. Procédez par étapes, en commençant par un ensemble restreint d'actifs critiques et en élargissant le périmètre uniquement après que les responsables ont validé l'efficacité des nouveaux processus. Retirez Bigeye une fois que la solution de remplacement a démontré sa couverture, sa gestion des incidents, ses contrôles d'accès et son comportement en termes de coûts en production, et non simplement après la signature du contrat par le service des achats.
Le meilleur choix peut être Monte Carlo pour un lignage étendu, Acceldata pour des environnements hybrides complets, Soda pour des contrôles sous forme de code, Metaplane pour une intégration rapide sur une architecture moderne, Telmai pour des formats ouverts de lakehouse, Kensu pour une instrumentation des pipelines par agents, ou IBM Data Observability par Databand pour des opérations d'entreprise centrées sur l'écosystème IBM. Ce choix peut se porter sur digna lorsque les exigences décisives sont le déploiement privé, l'exécution résidente dans les données, l'adoption modulaire, la surveillance de la Timeliness et des anomalies par apprentissage, la validation explicite et le contrôle des schémas. L'adéquation dépend de l'architecture et du modèle opérationnel. Ainsi, la présélection doit se clore par un test de charge de travail et une décision d'attribution interne, et non par un classement générique.
digna combine la détection d'anomalies basée sur l'IA, la surveillance de la Timeliness, la validation au niveau de l'enregistrement, le suivi des schémas, les analyses historiques et l'exécution en base de données au sein de votre propre environnement. Visitez digna pour évaluer une alternative modulaire à Bigeye adaptée à vos exigences de plateforme de données, de governance et de fiabilité.


