9 tipos de detección de anomalías explicados
|
10
minuto de lectura

La mayoría de los consejos sobre detección de anomalías empieza por los algoritmos. Eso va al revés. La detección de anomalías empieza por la definición correcta de lo normal.
Ningún método único encaja con todos los conjuntos de datos porque las anomalías vienen en formas distintas. Una anomalía puntual es un valor raro aislado, como un pico repentino de pagos fallidos. Una anomalía contextual solo parece errónea en contexto, como un volumen de transacciones de aspecto normal que aparece a la hora equivocada. Una anomalía colectiva es un patrón a lo largo de varios registros o pasos temporales, como un lote retrasado seguido de una avalancha de recuperación. En la práctica, los equipos también deben separar los problemas univariantes de los multivariantes, porque una sola columna comportándose de forma extraña es muy distinto de varios campos derivando juntos.
Esa distinción tiene raíces profundas. Una revisión histórica reciente rastrea el pensamiento temprano sobre anomalías en series temporales hasta Bernoulli en 1777, luego hasta la distinción de tipos de anomalía de Fox en 1972 y la ampliación de Tsay en 1988, mientras la práctica moderna sigue apoyándose en anomalías puntuales, contextuales y colectivas como categorías centrales (revisión histórica de la detección de anomalías en series temporales). Sigue siendo el punto de partida correcto para elegir entre los principales tipos de detección de anomalías.
Una regla práctica funciona mejor que una receta universal. Usa validación determinista para condiciones conocidas. Usa métodos estadísticos o de series temporales cuando el comportamiento es medible y recurrente. Usa aprendizaje automático cuando los patrones son complejos, multivariantes o cambian demasiado rápido para una lógica estática. Plataformas como digna combinan métodos estadísticos, aprendizaje automático, validación, Timeliness y monitorización de esquema dentro de la infraestructura del cliente cuando ese modelo operativo importa.
Tabla de contenidos
1. Aprendizaje de líneas base estadísticas
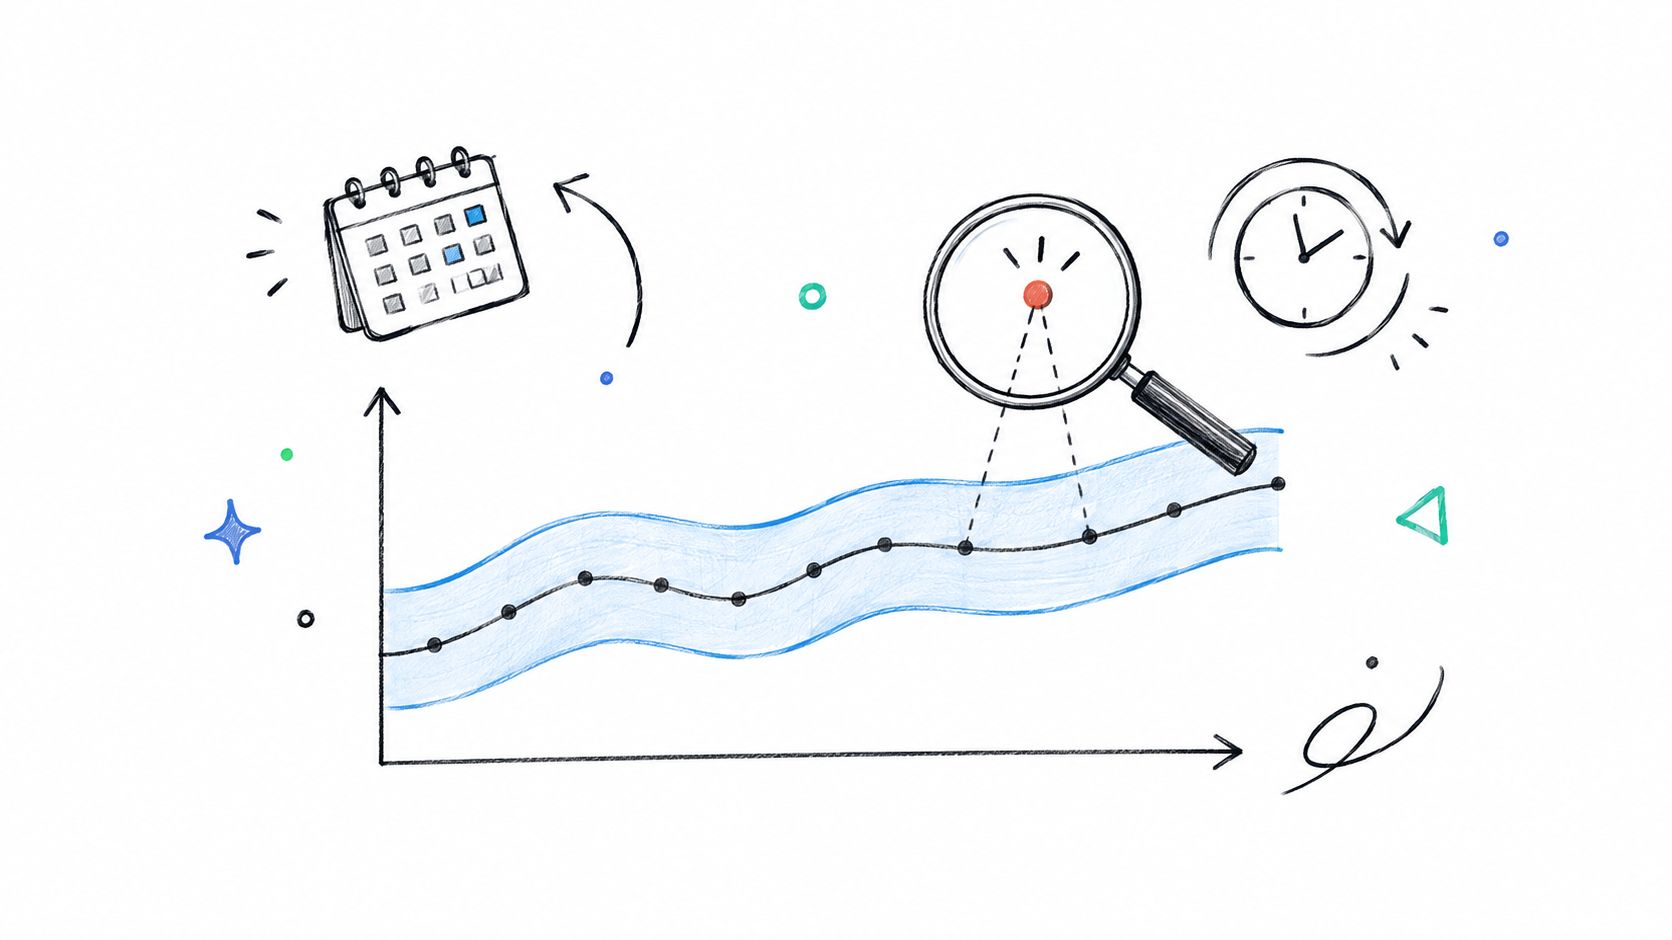
Algunos equipos lo llaman «detección de anomalías con IA», pero la idea útil es más simple. El sistema aprende del histórico cómo es el comportamiento normal y luego señala las desviaciones respecto a esa línea base.
Este método funciona mejor cuando una métrica tiene un comportamiento reconocible en el tiempo. Los recuentos de transacciones pueden subir entre semana y bajar el fin de semana. Los datos de siniestros pueden llegar en oleadas previsibles. Los eventos de soporte pueden dispararse cada mañana y luego estabilizarse. Un modelo de línea base absorbe esos patrones mejor que un umbral fijo.
Esta es la intuición visual.
Qué evidencia usa
El aprendizaje de líneas base se apoya en el comportamiento estadístico observado a lo largo del tiempo. En vez de preguntar «¿superó este valor un límite fijo?», pregunta «¿es este valor inusual para este conjunto, a esta hora, bajo este patrón reciente?».
Eso lo hace un encaje práctico para la observabilidad de datos. Un equipo financiero puede vigilar el volumen diario de transacciones. Un equipo de operaciones sanitarias puede monitorizar los flujos de ingresos hospitalarios. Una plataforma de datos de telecomunicaciones puede seguir los registros de uso que llegan tarde. En cada caso, el modelo aprende rangos esperados, tendencias y variación recurrente.
Un concepto de fondo útil es la distribución de los datos en el análisis de anomalías. Los equipos que entienden dispersión, asimetría y variación esperada suelen ajustar las líneas base con más eficacia.
Regla práctica: combina el aprendizaje de líneas base con comprobaciones deterministas en los conjuntos de alto riesgo. El comportamiento aprendido capta la deriva. Las reglas captan las violaciones conocidas.
Dónde ayuda y dónde flaquea
Ayuda cuando lo «normal» cambia con el tiempo pero sigue un patrón. Flaquea cuando tienes poco histórico, cuando el proceso cambió la semana pasada o cuando la métrica es sobre todo ruido.
Ejemplos:
Finanzas: deriva inesperada en el volumen de transacciones aunque no se cruzara ningún umbral
Sanidad: cambios inusuales en la actividad de pacientes entre centros
Telecomunicaciones: tasas anómalas de llegada de datos en las pipelines de ingesta
Contrapartidas habituales:
Fuerte en interpretabilidad: los equipos suelen ver la banda esperada y explicar por qué saltó una alerta
Sensible a ventanas de entrenamiento malas: los periodos de incidente pueden contaminar la línea base
Mejor con controles de apoyo: las comprobaciones de validación y Timeliness aumentan la confianza
2. Isolation Forest
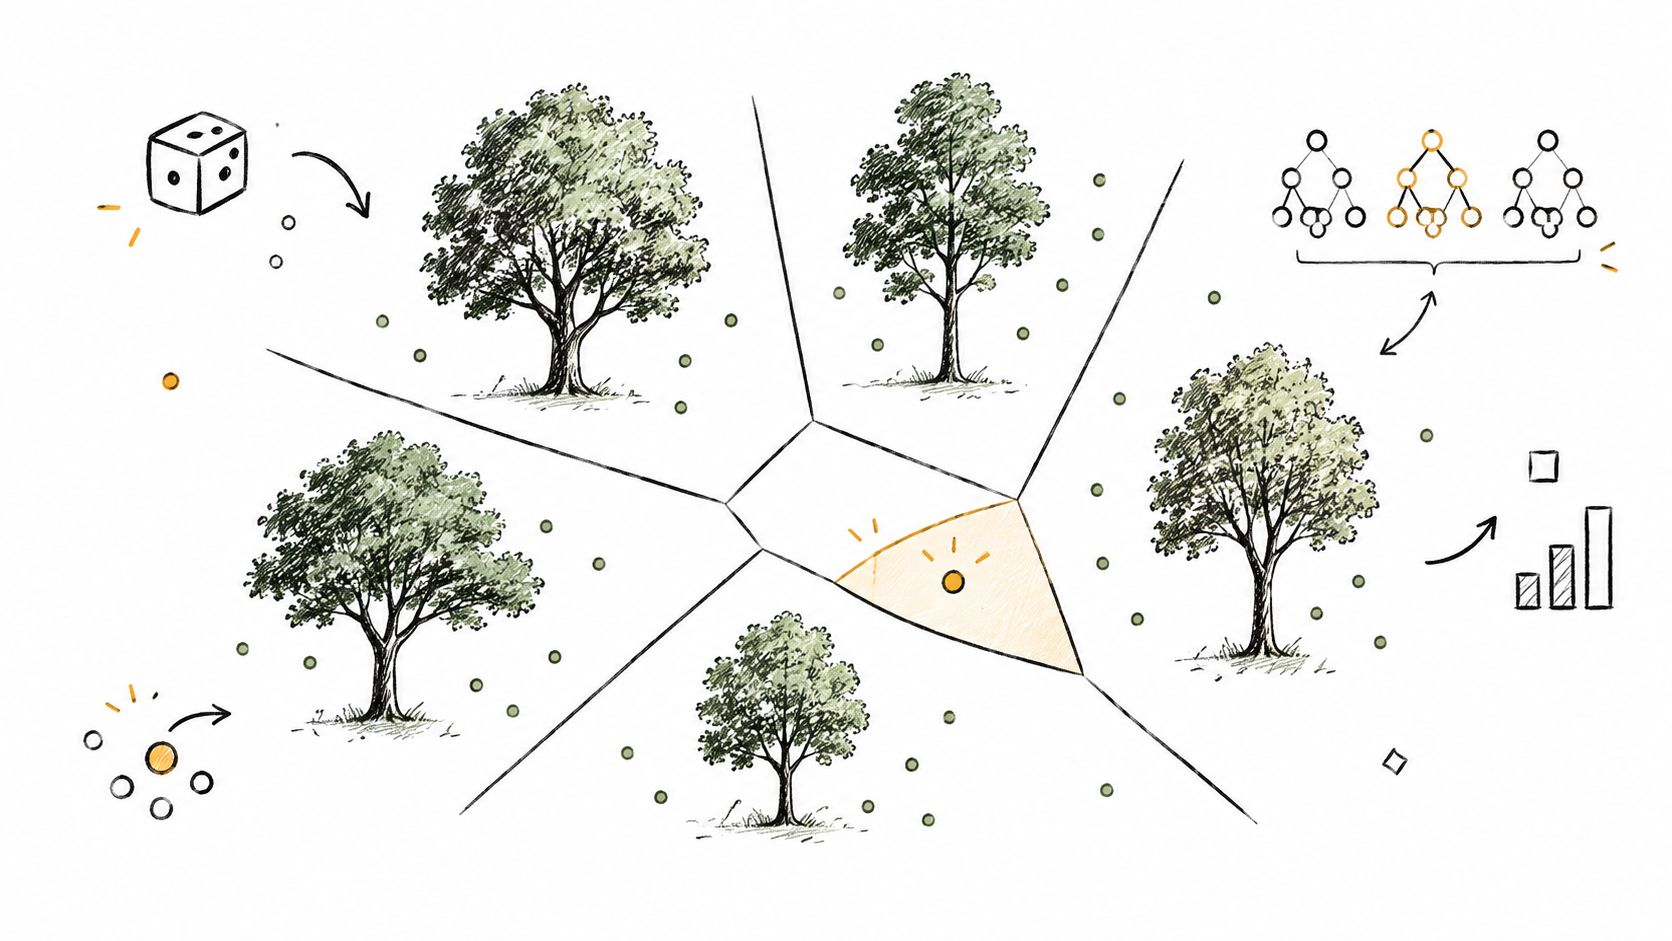
Isolation Forest es un método de aprendizaje automático que solo parece extraño hasta que imaginas lo que hace. Va partiendo los datos en subconjuntos más pequeños al azar. Los puntos que quedan aislados rápido tienen más probabilidad de ser anomalías.
Ese enfoque lo hace útil para datos de alta dimensión. Si evalúas muchas características a la vez, los métodos basados en distancia pueden volverse incómodos. Isolation Forest evita parte de esa complejidad al centrarse en lo fácil que resulta separar un punto del resto.
Cómo funciona en la práctica
Entrenas el modelo con datos sin etiquetar. Crea muchos árboles aleatorios. Una observación normal suele necesitar más particiones para quedar aislada porque está en una región densa. Una observación inusual se separa en menos pasos.
Eso lo convierte en una opción razonable cuando no tienes etiquetas y no quieres escribir a mano reglas para cada combinación sospechosa. Un banco puede puntuar transacciones usando importe, categoría de comercio, hora, geografía y canal. Un hospital puede analizar combinaciones de medidas operativas. Un equipo de telecomunicaciones puede monitorizar el comportamiento de red en varias dimensiones.
Si quieres prototipar el método de forma práctica, un flujo de detección de anomalías en Python es un punto de partida común.
Contrapartidas a vigilar
Isolation Forest puede funcionar bien con datos multivariantes, pero no es magia. La elección de características sigue importando. El escalado también. Si una variable domina el rango, el modelo puede aislar los registros equivocados por el motivo equivocado.
Buenos usos incluyen:
Cribado de fraude: combinaciones inusuales entre muchos atributos de transacción
Monitorización operativa: comportamiento que parece normal en cada métrica aislada pero extraño en combinación
Exploración: grandes conjuntos sin etiquetar donde necesitas candidatos para revisión
Empieza con los parámetros por defecto y luego revisa las alertas reales con los responsables de dominio. Un punto matemáticamente inusual no siempre es una anomalía relevante para el negocio.
3. Métodos de puntuación Z y desviación estándar
Si necesitas una respuesta simple a «¿está este valor inusualmente lejos de la media?», la puntuación Z suele ser el primer método que probar.
Mide cuán lejos está un punto de la media en unidades de desviación estándar. Suena técnico, pero la lógica de decisión es directa. Si el valor está lo bastante lejos de lo típico, señálalo.

Mejor caso de uso para las puntuaciones Z
Las puntuaciones Z son útiles cuando la métrica es bastante estable y su distribución se comporta razonablemente bien. Las técnicas base habituales para la detección estadística práctica de anomalías incluyen la puntuación Z, el rango intercuartílico y los métodos de media móvil, y los equipos pueden combinarlos mediante votación o puntuación ponderada para reducir falsas alarmas y mejorar la detección (notas prácticas sobre métodos de detección de anomalías en series temporales).
Por eso las puntuaciones Z siguen apareciendo en la monitorización empresarial. Son fáciles de explicar. Un equipo financiero puede señalar importes de transacción inusuales. Un equipo asistencial puede vigilar constantes vitales atípicas. Un equipo de datos puede monitorizar recuentos de filas en cargas recurrentes.
Si necesitas pensar con más cuidado si la media y la dispersión son el resumen adecuado, esta guía sobre cómo describir la distribución de los datos aporta contexto útil.
Límites y ajustes prácticos
La debilidad es el contexto. Una puntuación Z sobre datos en bruto puede pasar por alto estacionalidad, deriva o distribuciones asimétricas. Una métrica diaria de ventas con fuerte patrón de días laborables puede parecer anómala cada fin de semana si ignoras el contexto temporal.
Usa las puntuaciones Z con cuidado cuando:
La métrica es estable: recuentos de filas, tamaños de archivo, duraciones o importes con poca deriva
Necesitas transparencia: la auditoría o la revisión por interesados es más fácil con matemáticas simples
Quieres una referencia de partida: es una primera pasada sólida antes de modelos más pesados
Ajustes prácticos breves:
Usa ventanas móviles: mejor para comportamientos de series temporales cambiantes
Prefiere variantes cuando haga falta: las alternativas basadas en la mediana manejan mejor los valores atípicos
Añade reglas de negocio: un valor estadísticamente inusual puede seguir siendo aceptable en la operación
4. Local Outlier Factor
Algunas anomalías no son extremas a nivel global. Solo son extrañas respecto a los datos cercanos. Ahí es donde Local Outlier Factor, o LOF, resulta útil.
LOF compara la densidad local de un punto con la densidad de sus vecinos. Si el punto está en una región más rala que los registros a su alrededor, el método lo trata como sospechoso. Eso lo hace bueno para datos agrupados donde «lo normal» tiene varias modas.
Por qué importa la densidad
Piensa en el uso de clientes en telecomunicaciones. Grandes consumidores, usuarios ocasionales y cuentas de empresa pueden formar grupos separados. Un registro puede parecer normal frente a toda la población y aun así resultar raro dentro de su propio grupo. LOF está hecho para esa comparación contextual.
La misma lógica ayuda en la monitorización de plataforma. Un conjunto de trabajos puede ejecutarse dentro de una banda de latencia mientras otra familia de pipelines corre en otra banda. LOF puede detectar una tarea anómala para su grupo de pares aunque no parezca grande en términos absolutos.
Encaje práctico y contrapartidas
LOF es más fuerte cuando los vecindarios son significativos. Se debilita cuando se multiplican las dimensiones y todo se vuelve disperso. En datos de alta dimensión, las relaciones de vecino más cercano pueden volverse menos informativas.
Escenarios útiles:
Telecomunicaciones: comportamiento inusual de clientes dentro de cohortes de uso similares
Plataformas de datos: trabajos anómalos frente a trabajos comparables
Operaciones sanitarias: registros que no encajan con los patrones operativos cercanos
Puntos a recordar:
Elige con cuidado el tamaño del vecindario: demasiado pequeño y las alertas se vuelven nerviosas, demasiado grande y el contexto local desaparece
Escala primero las características: las comparaciones de densidad se rompen cuando una característica domina
Usa bucles de revisión: LOF suele encontrar casos sutiles que necesitan interpretación de negocio
LOF suele funcionar mejor como parte de un conjunto que como detector solitario. Combínalo con un filtro estadístico simple o una regla determinista para recortar el ruido de revisión.
5. Redes neuronales autocodificadoras
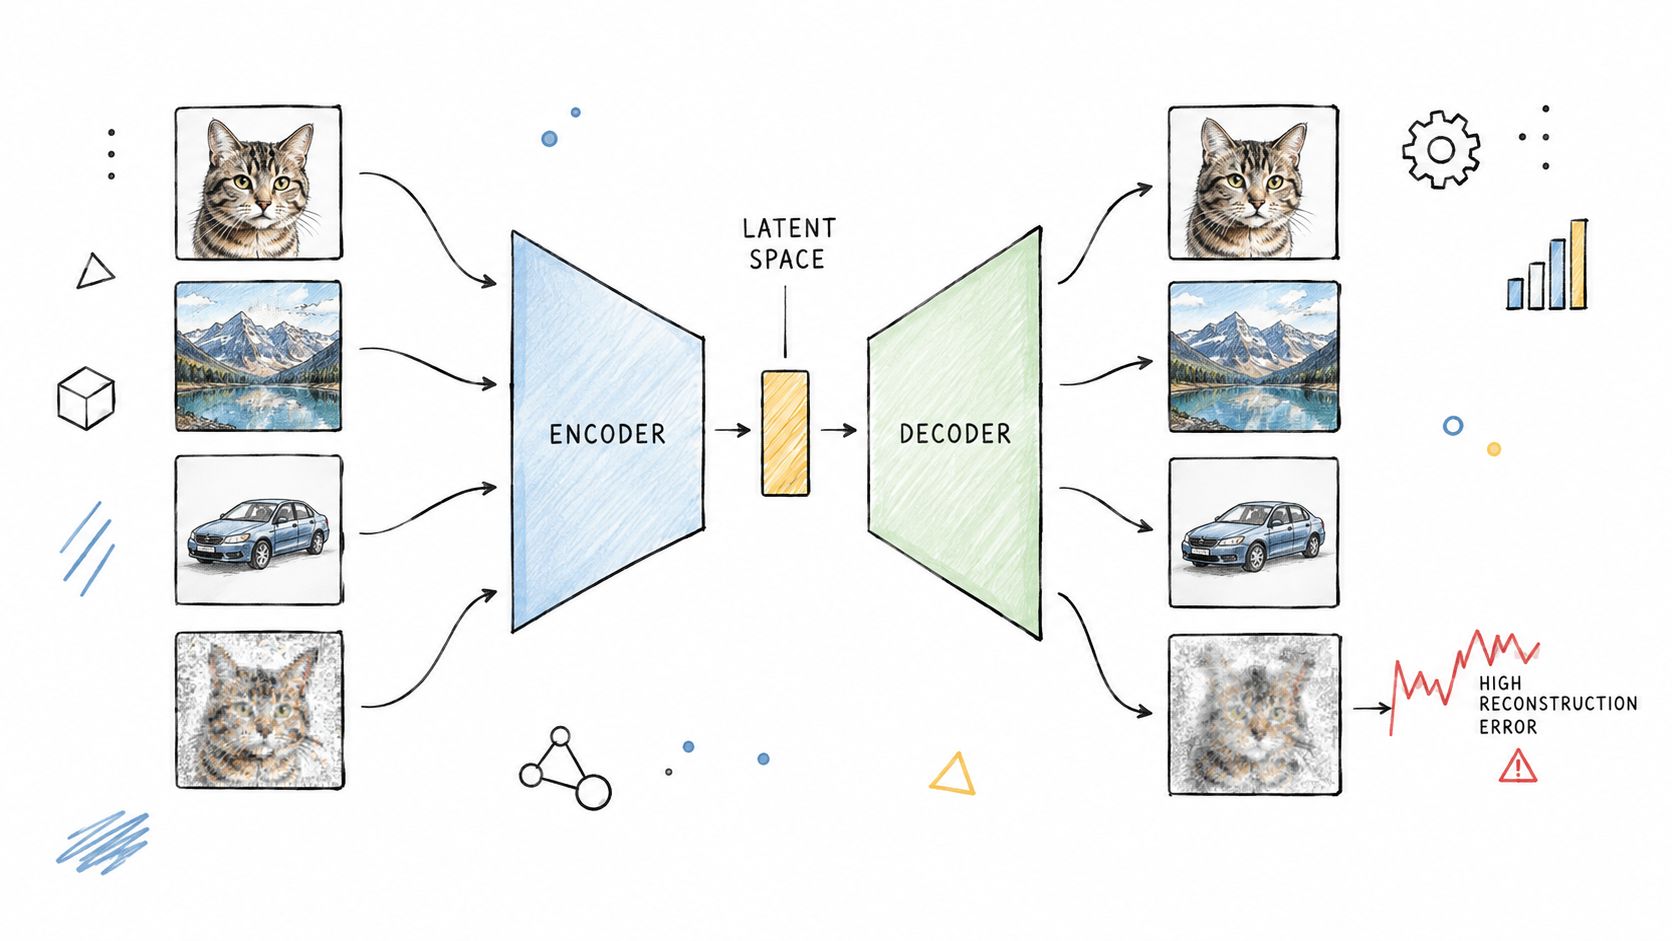
Los autocodificadores pertenecen a la familia de la reconstrucción. En vez de fijar límites explícitos o medir densidad, aprenden a comprimir y reconstruir datos normales. Cuando la reconstrucción sale mal, la entrada puede ser anómala.
Esa idea es potente cuando el patrón es complejo y no lineal. También es el punto en que la detección de anomalías se vuelve más difícil de explicar a interlocutores no técnicos.
Dónde ayuda la reconstrucción
Los autocodificadores son útiles cuando el comportamiento normal depende de muchas variables que interactúan y las fronteras simples no lo captan. Un equipo financiero puede puntuar comportamientos complejos de precios. Un equipo sanitario puede monitorizar combinaciones de varios dispositivos o sensores. Un equipo de telecomunicaciones puede evaluar firmas de tráfico que no se separan limpiamente con métodos lineales.
En revisiones amplias, los métodos de detección de anomalías suelen agruparse en enfoques estadísticos, enfoques clásicos de aprendizaje automático y métodos basados en redes neuronales (revisión de métodos estadísticos, de aprendizaje automático y de aprendizaje profundo). Los autocodificadores están claramente en ese tercer grupo.
Para comportamientos ligados al tiempo, aparecen a menudo en flujos más amplios de detección de anomalías en series temporales, sobre todo cuando las relaciones entre señales importan más que cualquier métrica aislada.
Las contrapartidas son reales
Los autocodificadores pueden capturar patrones que los métodos simples se pierden. También necesitan datos de entrenamiento más limpios, más ajuste y una disciplina operativa mayor. Si el modelo aprende un «normal» corrompido, el error de reconstrucción pierde significado.
Úsalos cuando:
Los patrones son complejos: las interacciones no lineales importan
Las anomalías etiquetadas escasean: la reconstrucción no requiere muchos ejemplos de fallo
Puedes sostener el modelo: el entrenamiento, el reentrenamiento y la revisión de umbrales necesitan responsables
Los métodos neuronales suelen encontrar anomalías valiosas, pero rara vez sustituyen a controles más simples. Los equipos siguen necesitando comprobaciones explicables para revisiones de incidentes y conversaciones de auditoría.
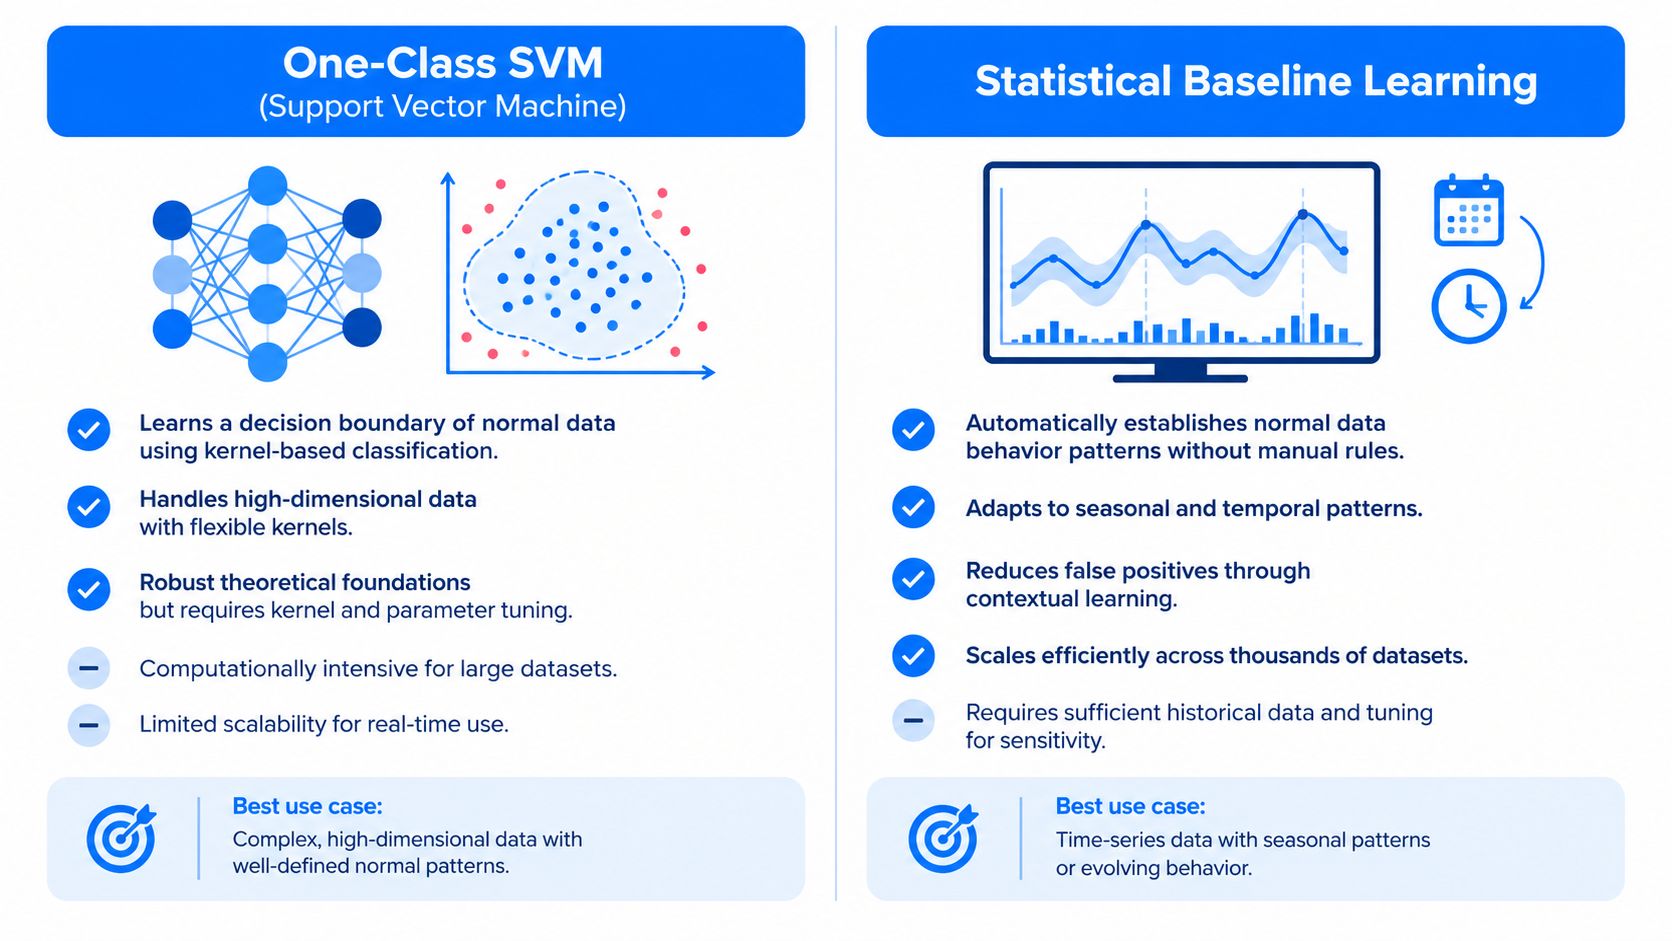
6. SVM de una clase (Support Vector Machine)
La SVM de una clase intenta aprender la frontera alrededor de los datos normales. Todo lo que quede fuera de esa frontera aprendida se trata como inusual.
Eso la hace conceptualmente distinta de Isolation Forest. Isolation Forest pregunta lo fácil que es separar un punto. La SVM de una clase pregunta si el punto cae dentro de la región aceptada de comportamiento normal.
Cuándo tiene sentido aprender la frontera
Este método es útil cuando los registros normales forman una figura coherente, aunque esa figura no sea lineal. Las funciones núcleo permiten al modelo trazar fronteras más flexibles, lo que puede ayudar con patrones multivariantes.
Algunos ejemplos:
Servicios financieros: transacciones que caen fuera del comportamiento normal del cliente
Sanidad: perfiles clínicos inusuales a través de varias mediciones
Analítica de clientes: patrones de actividad de cuenta que se desvían de las normas conocidas
El principal reto es la sensibilidad. La SVM de una clase puede reaccionar con fuerza al escalado de características, a la elección de parámetros y a datos de entrenamiento ruidosos. En conjuntos grandes también puede volverse cara computacionalmente frente a métodos más ligeros.
Qué deberían esperar los equipos
La SVM de una clase suele ser buena elección para conjuntos estructurados de tamaño medio donde aprender «solo la clase normal» encaja con el problema de negocio. Es menos atractiva cuando necesitas explicabilidad fácil o un comportamiento en producción de bajo mantenimiento.
Hábitos operativos útiles:
Normaliza las entradas: esto rara vez es opcional
Mantén características significativas: las características débiles distorsionan la frontera
Reentrena tras cambios de proceso: nuevos productos, canales o flujos pueden desplazar la región normal
Si necesitas un modelo más fácil de discutir con auditores o responsables de operaciones, la validación determinista o las líneas base estadísticas suelen ganar.
7. Descomposición estacional y ARIMA
El tiempo lo cambia todo en la detección de anomalías. Un valor puede parecer erróneo solo porque apareció a la hora equivocada, el día equivocado o tras la secuencia equivocada. La descomposición estacional y ARIMA están hechas para ese problema.
Estos métodos usan la expectativa temporal como evidencia. Preguntan qué debería ocurrir a continuación, dada la historia de la serie.
El entorno de benchmarking muestra por qué importa elegir el método con cuidado. ADBench evaluó 30 algoritmos de detección de anomalías en 57 conjuntos de datos, y el UCR Time Series Anomaly Archive ofrece 250 series temporales curadas para investigación, lo que refuerza que la elección de algoritmo depende mucho de las características del conjunto (panorámica del benchmark ADBench y del archivo UCR).
Qué buscan
La descomposición estacional separa una serie en tendencia, estacionalidad y comportamiento residual. ARIMA modela directamente la dependencia temporal. Ambos sirven cuando la anomalía no es solo «alta» o «baja», sino «inesperada para este momento».
Eso importa en la operación real. Una carga nocturna por lotes que no llega a su hora es un problema de Timeliness. Un pico de actividad de clientes en un festivo puede ser normal si la estacionalidad y el contexto de eventos están bien modelados. Una caída de ingresos en un fin de semana tranquilo puede no merecer escalada.
Esta familia de métodos es especialmente relevante para anomalías colectivas y de subsecuencia. Una revisión reciente señala que muchos incidentes en producción no son puntos aislados sino anomalías colectivas o de subsecuencia, y subraya la brecha práctica en la elección de método para casos como cargas retrasadas, deriva de esquema y comportamiento de pipelines con múltiples señales (revisión sobre detección de desplazamientos sistémicos y datos de observabilidad). Si trabajas en monitorización de entrega de datos, esa brecha te sonará.
Una referencia útil de implementación es esta guía para detectar anomalías en series temporales.
Buen encaje para la observabilidad de datos
Estos métodos suelen ser la respuesta correcta para:
Cargas ausentes o tardías: las ventanas de llegada esperadas importan más que los valores en bruto
Métricas de negocio estacionales: los patrones diarios, semanales o mensuales rigen el comportamiento normal
Deriva en procesos recurrentes: alejamientos graduales del calendario o el volumen histórico
Una pipeline retrasada suele ser una anomalía colectiva, no puntual. Los métodos conscientes del tiempo la detectan antes que los umbrales estáticos.
8. Distancia de Mahalanobis
La distancia de Mahalanobis es una de las herramientas estadísticas multivariantes más útiles que muchos equipos se saltan. Mide cuán lejos está un punto del centro de los datos teniendo en cuenta escala y correlación.
Esa última parte importa. Si dos variables suelen moverse juntas, un registro puede parecer perfectamente normal en cada columna por separado y ser extraño como combinación.
Por qué la correlación cambia la respuesta
Supón que el crecimiento de ingresos, el margen y el ratio de deuda siguen normalmente una relación conocida en un segmento. Un registro de empresa con valores ordinarios en cada métrica puede violar igualmente el patrón multivariante habitual. La distancia de Mahalanobis puede sacar a la luz ese desajuste con más eficacia que la distancia euclídea simple.
Eso la hace útil en finanzas, operaciones clínicas y monitorización de calidad de datos. Un registro sanitario puede mostrar valores individualmente plausibles que crean un perfil implausible al combinarse. Una plataforma de datos puede observar métricas de calidad aceptables por separado y sospechosas juntas.
Cuándo usarla
La distancia de Mahalanobis es un buen término medio entre la estadística simple y el aprendizaje automático completo. Sigue siendo interpretable, pero maneja la estructura multivariante mejor que los umbrales por columna.
Funciona mejor cuando:
Las variables están correlacionadas: la covarianza lleva información útil
Necesitas comprobaciones multivariantes explicables: los analistas pueden inspeccionar qué relaciones se movieron
Los datos son estructurados: las métricas estables suelen encajar mejor que los flujos de eventos en bruto
Las estimaciones de covarianza pueden volverse inestables en entornos ruidosos o de alta dimensión. La estimación de covarianza por segmentos y la segmentación suelen mejorar la fiabilidad.
9. Validación basada en reglas y determinista
El consejo más desatendido en la detección de anomalías es este. Si el negocio ya sabe que una condición es inaceptable, no entrenes un modelo para redescubrirla.
La validación basada en reglas usa lógica explícita. Los campos obligatorios deben estar rellenos. Los valores de referencia deben coincidir con listas aprobadas. Las fechas deben respetar restricciones de secuencia. Las condiciones regulatorias deben cumplirse exactamente. Esto no es monitorización «a la antigua». Es la forma más clara de evidencia que puedes tener.
La clase de señal más fuerte
Las reglas usan conocimiento de negocio explícito en vez de patrones inferidos. Si un fichero sanitario debe incluir identificadores obligatorios, no aporta nada preguntar a un modelo estadístico si los identificadores ausentes parecen inusuales. Son inválidos. Si un proceso financiero exige que los importes se mantengan dentro de un rango de política definido, un control determinista es la comprobación principal.
Por eso los métodos basados en reglas siguen siendo esenciales en entornos regulados y flujos de reporte críticos. Dan a los equipos auditabilidad completa y un comportamiento operativo estable.
Ejemplos:
digna Data Validation: comprobaciones a nivel de registro contra reglas de negocio
Servicios financieros: controles atados a restricciones de política o regulatorias
Sanidad: completitud de campos obligatorios y consistencia lógica
Sector público: aplicación auditable de condiciones de datos requeridas
Dónde terminan las reglas
Las reglas son precisas, pero solo captan lo que alguien pensó en definir. No detectarán una mezcla inusual de clientes, una deriva sutil de métricas ni una línea base cambiante en los tiempos de llegada.
Revisiones recientes subrayan que la evaluación práctica de la detección de anomalías todavía necesita mejor orientación bajo restricciones de privacidad, despliegue, explicabilidad y operación, mientras la investigación en observabilidad sigue destacando el reto de reducir ruido entre registros, trazas y métricas con automatización fiable (revisión de detección de anomalías operativa, explicable y consciente del despliegue). La validación determinista ayuda a la confianza porque los equipos pueden ver la condición exacta que falló.
Usa reglas para:
Requisitos de negocio conocidos
Controles de cumplimiento y auditoría
Campos y registros de alto riesgo
Rutas de escalada claras
Comparación de 9 métodos de detección de anomalías
Método | 🔄 Complejidad de implementación | ⚡ Requisitos de recursos | 📊 Resultados esperados | 💡 Casos de uso ideales | ⭐ Ventajas clave |
|---|---|---|---|---|---|
Aprendizaje de líneas base estadísticas | Moderada, configuración automatizada, ajuste de sensibilidad | Baja-media, necesita histórico, cómputo modesto | Detección de anomalías consciente del contexto con menos falsos positivos | Monitorización continua de KPI y calidad de datos, métricas estacionales | Se adapta sola a tendencias y estacionalidad; escalable; valor rápido |
Isolation Forest | Moderada, entrenar árboles y ajustar parámetros | Baja-media, eficiente para datos grandes o de alta dimensión | Detección multivariante potente en dimensiones altas | Detección de fraude, conjuntos operativos de alta dimensión | Eficiente, robusto ante características irrelevantes, sin métrica de distancia |
Puntuación Z y desviación estándar | Baja, cálculos estadísticos simples | Mínimos, cómputo insignificante | Señales rápidas e interpretables de valores atípicos de una métrica | Recuentos de filas, umbrales de métrica única, primera línea de monitorización | Extremadamente rápido, transparente, fácil de auditar e implementar |
Local Outlier Factor (LOF) | Moderada-alta, selección de vecinos y métrica de distancia | Media-alta, costoso con muestras grandes o dimensiones altas | Detecta desviaciones de densidad local y atípicos específicos de cada grupo | Conjuntos con densidades variables o anomalías dependientes del grupo | Capta el contexto local; sin supuesto de distribución global |
Redes neuronales autocodificadoras | Alta, diseño de arquitectura y ajuste de hiperparámetros | Altos, GPU y un buen conjunto de entrenamiento limpio o etiquetado ayudan | Detecta anomalías no lineales complejas mediante el error de reconstrucción | Patrones complejos de alta dimensión, datos multisensor o temporales | Modela relaciones no lineales; escala a conjuntos de características complejos |
SVM de una clase | Alta, selección de núcleo y ajuste de parámetros | Media-alta, memoria y cómputo crecen con el tamaño de los datos | Detección basada en fronteras; sensible al escalado y a los núcleos | Conjuntos con región normal cohesionada donde las anomalías quedan fuera | Fronteras de decisión flexibles con base teórica sólida |
Descomposición estacional y ARIMA | Moderada, selección de parámetros estacionales y ARIMA | Baja-media, necesita series históricas largas | Componentes interpretables de tendencia y estacionalidad y anomalías previstas | Series temporales con fuerte estacionalidad, Timeliness de pipelines | Diseñado para datos temporales; descomposición y previsiones claras |
Distancia de Mahalanobis | Baja-moderada, estimación e inversión de covarianza | Baja-media, necesita muestras suficientes por dimensión | Puntuaciones de atípicos multivariantes que tienen en cuenta correlaciones | Comprobaciones y monitorización de calidad multivariante correlacionada | Tiene en cuenta covarianza y escala; eficaz con variables correlacionadas |
Validación basada en reglas y determinista | Alta, redacción y mantenimiento manual de reglas | Medios, esfuerzo humano; poco cómputo | Resultados deterministas de aprobado o fallo con auditabilidad completa | Comprobaciones regulatorias y reglas de negocio críticas | Totalmente transparente, auditable, aplicación exacta de la lógica de negocio |
Elige el método que encaje con la señal
La forma más práctica de entender los tipos de detección de anomalías es dejar de tratarlos como bandos rivales. Son distintas maneras de reunir evidencia.
Usa puntuaciones Z cuando una métrica sea simple, estable y fácil de resumir con media y dispersión. Usa aprendizaje de líneas base cuando el comportamiento del conjunto cambie con el tiempo pero siga formando un patrón esperable. Usa descomposición estacional o ARIMA cuando importen el momento, la tendencia y la recurrencia, sobre todo en cargas ausentes, retrasos de entrega y actividad de negocio con ritmo diario o semanal. Usa LOF y distancia de Mahalanobis cuando el contexto venga de puntos vecinos o variables correlacionadas. Usa Isolation Forest, SVM de una clase o autocodificadores cuando los datos estén sin etiquetar, sean multivariantes y demasiado complejos para una lógica estática.
El área metodológica más amplia refleja esa diversidad. La detección de anomalías en series temporales se clasifica habitualmente en tipos de aprendizaje no supervisado, supervisado y semisupervisado, y la misma literatura agrupa los métodos en familias de previsión, reconstrucción, distancia, codificación, vecindad y probabilísticas (panorámica VLDB de familias de detección de anomalías en series temporales). Es un recordatorio útil de que la elección de algoritmo debería empezar por la señal y no por el modelo favorito.
La dirección del mercado también apunta a combinaciones operativas más que a herramientas aisladas. Una previsión del sector proyecta que el mercado de detección de anomalías crezca de 4.280 millones de dólares en 2024 a 9.250 millones en 2032, y atribuye el liderazgo de adopción en 2025 al software con un 81,6 % de cuota y al despliegue en la nube con un 72,8 % (previsión de mercado de detección de anomalías). Eso no significa que cada equipo deba correr hacia un stack solo en la nube. Sí muestra que la detección de anomalías escalable y orientada a producción ha entrado en la operación empresarial habitual.
Para la observabilidad de datos, la configuración más sólida suele combinar métodos. Una regla determinista puede rechazar registros imposibles. Un modelo de línea base puede detectar deriva gradual en recuentos de filas o valores. Un detector de Timeliness puede descubrir cargas retrasadas. Un monitor de esquema puede captar cambios estructurales antes de que fallen los consumidores posteriores. Ese diseño por capas encaja con cómo ocurren los incidentes. Pocos fallos de producción se anuncian con una única señal perfecta.
digna es un ejemplo relevante de ese enfoque combinado. Su plataforma se ejecuta dentro del entorno del propio cliente y reúne detección de anomalías guiada por IA, validación a nivel de registro, monitorización de Timeliness, seguimiento de esquema, monitorización de métricas de negocio y plataforma, y ejecución dentro de la base de datos. Esa combinación importa a los equipos que necesitan a la vez detección adaptativa y aplicación controlada y auditable.
Usa esta lista antes de elegir un método:
Define la anomalía con claridad: ¿es un problema puntual, contextual, colectivo, univariante o multivariante?
Confirma el histórico de datos: ¿tienes suficiente histórico limpio para aprender el comportamiento normal?
Mide los falsos positivos: ¿quién revisará las alertas y qué nivel de ruido es aceptable?
Asigna responsabilidad de respuesta: ¿qué equipo investiga la deriva, las reglas fallidas o los retrasos de entrega?
Revisa tras cambios de proceso: reentrena, reajusta o reescribe los controles cuando cambien productos, pipelines o calendarios
El método correcto es el que encaja con la señal, con los datos y con la realidad operativa que rodea a ambos.
digna da a los equipos de datos una vía modular para aplicar estos enfoques de detección de anomalías en producción, desde el aprendizaje de líneas base guiado por IA hasta la validación determinista, la monitorización de Timeliness y el seguimiento de esquema. Como se ejecuta dentro del entorno del propio cliente y realiza las comprobaciones dentro de la base de datos, encaja con equipos que necesitan observabilidad con un control firme sobre el movimiento de datos y los flujos de revisión. Si eso coincide con tu configuración, visita digna.
Elegir un método es la mitad fácil; mantenerlo calibrado mientras los datos cambian es el trabajo, y ahí es donde la monitorización continua de la calidad de datos se gana su sitio.
Preguntas frecuentes
¿Por dónde debería empezar de verdad la detección de anomalías?
Por la definición correcta de lo normal, no por los algoritmos. La mayoría de los consejos parten del método, lo cual va al revés: la misma desviación puede ser un incidente en un conjunto y estacionalidad esperada en otro, y ningún modelo resuelve esa cuestión por ti.
¿Qué diferencia hay entre líneas base estadísticas e isolation forests?
El aprendizaje de líneas base estadísticas modela el comportamiento esperado a partir del histórico y señala lo que se aparta de él. Los isolation forests aíslan en cambio los puntos fáciles de separar del resto, lo que escala bien en datos de alta dimensión pero da menos intuición sobre por qué se señaló un punto.
¿Cuándo usar puntuaciones Z en vez de métodos de densidad?
Las puntuaciones Z sirven para distribuciones de una sola variable aproximadamente normales, donde la desviación respecto a la media es significativa. Local Outlier Factor se gana su sitio cuando importa la densidad: cuando un punto es normal globalmente pero inusual respecto a sus vecinos inmediatos, algo que las puntuaciones Z no pueden ver.
¿Qué métodos sirven para datos de series temporales?
La descomposición estacional y ARIMA, porque separan tendencia y estacionalidad del residuo y buscan desviaciones en lo que queda. Eso encaja bien con la observabilidad de datos, donde un pico un lunes es rutina y el mismo pico un miércoles no lo es.
¿Siguen importando las comprobaciones basadas en reglas junto al aprendizaje automático?
Sí: la validación determinista es la clase de señal más fuerte, porque es explicable y auditable de un modo que la puntuación de un modelo no lo es. Las reglas terminan donde empiezan los desconocidos desconocidos, que es justo donde toman el relevo los métodos de comportamiento.