Data Validation: Reglas, controles y monitoreo continuo de la calidad de los datos
|
9
minuto de lectura

¿Qué pasa si un conjunto de datos cumple con la definición de validez sobre el papel pero nadie prueba la regla antes de que los datos lleguen a un cuadro de mando, modelo o informe regulatorio? La Data Validation es el proceso operativo de aplicar reglas, restricciones, formatos, dominios y condiciones de negocio definidas para determinar si los datos cumplen con los requisitos especificados. Convierte una expectativa de calidad abstracta en una prueba explícita que puede aprobar, fallar, advertir, rechazar o poner en cuarentena un registro.
La Validez de Datos es una dimensión de Calidad de Datos. La Data Validation es el proceso utilizado para probar esa dimensión frente a los requisitos definidos.
Esa distinción es importante. La Calidad de Datos describe si los datos son adecuados para su uso previsto, mientras que la validación proporciona el mecanismo ejecutable que comprueba los registros frente a las condiciones acordadas. Esta guía explica cómo las reglas de validación de datos, las comprobaciones de validación de datos, la medición, la automatización y el monitoreo continuo funcionan en conjunto.
Índice de contenidos
Flujo de trabajo de validación de extremo a extremo con un conjunto de datos de clientes
Qué es la Data Validation y por qué existe
La validación de datos comprueba si los registros se ajustan a las expectativas predefinidas sobre estructura, contenido, relaciones y significado comercial. Una regla puede requerir un identificador de cliente, restringir un código de país a un dominio aprobado, confirmar que una fecha tiene el formato esperado o garantizar que el monto de un pedido cumpla con una condición comercial.
La validación existe porque los errores se vuelven más difíciles de aislar después de pasar por múltiples sistemas. Un registro malformado puede afectar a la analítica, los flujos de trabajo de aprendizaje automático, los procesos operativos o los informes regulatorios antes de que alguien note el problema en la capa del cuadro de mando. Las pruebas en la ingesta o durante la transformación brindan a los equipos la oportunidad de detener, marcar o aislar el registro mientras su origen aún es visible.
La distinción entre una dimensión de calidad y su prueba operativa también se refleja en la DAMA-DMBOK® 2.0 Edición Revisada, comúnmente utilizada como punto de referencia para las prácticas de gestión de datos. La validez describe la conformidad con formatos, dominios y reglas definidos. La validación de datos es la actividad que mide esa conformidad en un conjunto de datos particular y en un punto específico de un flujo de trabajo.
Por qué la limpieza única no es suficiente
Un proyecto de limpieza puede reparar defectos conocidos, pero no protege la siguiente carga. El monitoreo continuo de la calidad de los datos mide la calidad a lo largo del tiempo y aplica controles para que los datos continúen ajustándose a las expectativas del negocio. El ciclo de retroalimentación persistente ayuda a los equipos a identificar desviaciones, degradación y rupturas en los procesos antes de que los consumidores intermedios utilicen valores no confiables, como se describe en la investigación sobre el monitoreo continuo de la calidad de los datos.
La guía de Gartner sobre calidad de datos hace referencia a un costo anual promedio de $12.9 millones asociado con una calidad de datos deficiente, lo que convierte a la validación sistemática y al monitoreo tanto en un control comercial como en una práctica técnica (guía de Gartner sobre calidad de datos). La respuesta práctica no es realizar pruebas ilimitadas, sino elegir las reglas que protegen los datos más importantes y conectar cada falla con un propietario y una acción.
Cómo funcionan las reglas de Data Validation
Una regla de validación de datos tiene tres partes esenciales: condición, alcance y acción. La condición define la prueba lógica, el alcance identifica dónde se aplica la prueba y la acción determina qué debe hacer el flujo de trabajo cuando la prueba falla.
Considere una tabla de customer_orders:
order_total > 0customer_emailcoincide con el patrón de correo electrónico aprobadocountry_codepertenece a un conjunto permitido
La misma condición puede producir diferentes resultados según la gravedad. Un identificador regulatorio faltante podría bloquear una carga, mientras que un valor inusual pero revisable podría generar una advertencia. Un registro malformado podría moverse a cuarentena en lugar de desaparecer, preservando la evidencia para su corrección y reproducción.
Componente | Función | Ejemplo ( |
|---|---|---|
Condición | Define la prueba lógica |
|
Alcance | Identifica el objeto y la etapa que se están comprobando |
|
Acción | Especifica la respuesta ante una falla | Poner en cuarentena el registro y notificar al propietario de los datos |
Las reglas pueden ser declarativas, como restricciones SQL o configuraciones YAML, o procedimentales, como pruebas implementadas con dbt o Great Expectations. Las integraciones empresariales también pueden exponer comprobaciones a través de una API, incluida la API REST de digna para la validación de datos.
Una regla útil debe ser reutilizable y parametrizada. Por ejemplo, una única plantilla de comprobación de rango puede aceptar diferentes valores mínimos y máximos para diferentes campos monetarios. Almacene la definición de la regla, la gravedad, el propietario y la versión junto al modelo de datos que protege. Eso hace que los cambios sean revisables cuando cambia un esquema o una política comercial.
Types of Data Validation Checks
Ningún tipo de comprobación individual detecta todas las fallas. Un marco de validación de datos maduro superpone pruebas estructurales con comprobaciones de contenido, de relación y de comportamiento.
Tipo de comprobación | Propósito | Ejemplo de conjunto de datos de clientes |
|---|---|---|
Esquema | Confirma columnas, tipos de datos y nulabilidad |
|
Dominio | Restringe los valores a un conjunto aprobado |
|
Formato | Prueba un patrón requerido | El correo electrónico sigue la estructura aceptada |
Rango | Aplica límites numéricos o de fecha | La cantidad no es negativa |
Unicidad | Detecta identificadores duplicados |
|
Integridad referencial | Confirma relaciones entre conjuntos de datos | Cada pedido hace referencia a un cliente existente |
Estadística o de distribución | Encuentra comportamientos agregados inusuales | Las tasas de nulos o los recuentos de filas cambian inesperadamente |
Comprobaciones estructurales y de contenido
Las comprobaciones de esquema detectan la falta de una columna, un tipo inesperado o un cambio en la bandera de nulabilidad antes de que fallen las transformaciones posteriores. Las comprobaciones de dominio detectan valores que son sintácticamente aceptables pero no aprobados, como un código de país desconocido o un estado de cliente no admitido.
La validación de formato maneja patrones para direcciones de correo electrónico, fechas, códigos postales y números de cuenta. La validación de rango comprueba valores como edad, cantidad, porcentajes e importes monetarios frente a los límites definidos.
La validación de nulabilidad separa los campos obligatorios de los atributos opcionales. Un ID de cliente puede ser obligatorio, mientras que un número de teléfono secundario puede ser opcional. Tratar cada nulo como un error crea ruido, por lo que el requisito debe provenir del uso previsto.
Comprobaciones de relación y comportamiento
La validación de campos cruzados prueba la lógica entre atributos. Una fecha de finalización no puede preceder a una fecha de inicio, y un valor de moneda debe satisfacer su condición de negocio definida. La validación referencial comprueba que exista un ID de cliente en los datos maestros del cliente y que exista un ID de producto en un conjunto de datos de referencia aprobado.
Las comprobaciones estadísticas añaden una capa diferente. Pueden monitorear recuentos de filas, tasas de nulos, medias, desviaciones estándar y distribuciones, ayudando a los equipos a encontrar desviaciones silenciosas que las reglas estáticas pueden pasar por alto. Las pautas sobre comprobaciones de consistencia de datos son útiles cuando varias fuentes deben describir la misma entidad o evento.
Para los elementos críticos, combine comprobaciones de esquema, dominio, formato, relación y distribución en lugar de depender de una sola categoría.
Diseño de reglas que se mantengan en producción
Las reglas de calidad de datos efectivas deben ser explícitas, medibles, relevantes, comprobables, mantenibles y trazables a un requisito de negocio. Una regla como “los datos del cliente deben estar completos” no es ejecutable. “El ID del cliente no debe ser nulo para cada registro de facturación” es lo suficientemente específica para probarse y asignarse.
Las reglas pueden apuntar a varias dimensiones de calidad:
Completitud: los campos obligatorios contienen valores.
Validez: los valores se ajustan a un formato o dominio aprobado.
Unicidad: los identificadores no se repiten donde se requiere unicidad.
Consistencia: los sistemas relacionados coinciden en los atributos compartidos.
Timeliness: los datos llegan dentro de la ventana operativa acordada.
Precisión: los valores coinciden con una fuente de confianza o una condición verificada.
Conformidad: los registros siguen el estándar estructural y comercial relevante.
No aplique el mismo rigor a todas las columnas. Priorice los elementos de datos críticos y las reglas críticas para el negocio, especialmente los campos utilizados en el procesamiento financiero, las comunicaciones con los clientes, los informes regulados, las decisiones operativas o los análisis de alto impacto. Un backlog de reglas puede clasificarse por costo de implementación, radio de impacto potencial, facilidad con la que se puede detectar una falla y qué tan reversible sería el error resultante.
Nivel de criticidad | Ejemplos | Tipos de comprobación requeridos | Cadencia | Ruta de escalada |
|---|---|---|---|---|
Alto | Campos regulatorios o financieros | Comprobaciones superpuestas estructurales, de dominio, de relación y de tendencias | En cada carga relevante | Propietario de datos y proceso de incidentes |
Medio | Campos operativos de cara al cliente | Comprobaciones de formato, completitud, rango y consistencia | Basado en carga o programado | Cola de equipo con asignación de propiedad |
Bajo | Atributos analíticos exploratorios | Comprobaciones básicas de esquema y anomalías | Apropiado para el uso | Revisión durante el mantenimiento del conjunto de datos |
Las plantillas parametrizadas reducen la lógica duplicada. Controle las versiones de las reglas con los cambios de esquema, registre al propietario del negocio y retire las comprobaciones cuando cambie el requisito subyacente. La investigación sobre reglas técnicas de calidad de datos mantenidas manualmente destaca por qué la mantenibilidad debe tratarse como parte del diseño del control y no como una idea de último momento.
Medición de los resultados de la validación
La validación resulta operativamente útil cuando los equipos miden algo más que una señal única de aprobado o fallado. Los indicadores principales incluyen la tasa de aprobación de la validación, la tasa de falla de la validación, el recuento de registros fallidos, el recuento de reglas fallidas, las tendencias de falla y la tasa de falla de reglas críticas.
El cálculo estándar es:
Tasa de aprobación de validación = registros que aprueban una regla / registros evaluados × 100
La vista de falla correspondiente puede usar el número de registros que fallaron la regla, dividido por los registros evaluados, y luego multiplicado por 100. Los equipos también pueden rastrear el tiempo medio de detección, el tiempo medio de resolución, la cobertura de reglas y un índice de puntuación compuesto de calidad de datos cuando esas medidas se definen de manera consistente.
Una tasa de aprobación del 99% no es automáticamente buena o mala. Si los registros fallidos afectan a un atributo analítico de bajo riesgo, el umbral puede ser tolerable. Si afectan a un identificador de facturación requerido, la misma tasa puede requerir una intervención inmediata. Los umbrales deben reflejar la criticidad comercial, el impacto posterior y la acción asociada a la regla.
Leer tendencias, no instantáneas aisladas
El seguimiento de tendencias muestra si las fallas están estables, mejorando o empeorando. Una regla que aprueba hoy puede estar degradándose gradualmente en cargas sucesivas. Las herramientas de datos maestros de SAP ilustran este enfoque a través de evaluaciones programadas, seguimiento de tendencias, monitoreo del estado actual y comparación con umbrales definidos (documentación de validación y monitoreo de SAP).
Las puntuaciones compuestas deben ponderarse por la criticidad del elemento de datos en lugar de promediarse de manera uniforme. Un cuadro de mando que combina reglas de bajo y alto impacto en una sola puntuación no ponderada puede hacer que las fallas graves parezcan insignificantes. La orientación detallada sobre métricas de calidad de datos puede ayudar a los equipos a definir un modelo de medición que conecte los resultados de las reglas con la propiedad y el uso comercial.
Data Validation Versus Data Quality and Observability
La Calidad de Datos es el concepto más amplio de si los datos son aptos para su uso. Incluye dimensiones como completitud, precisión, consistencia, oportunidad, unicidad y validez. La Data Validation es un mecanismo para probar los requisitos definidos de Calidad de Datos.
Una comprobación de validación pregunta: “¿Cumple este registro con esta regla?”. Una evaluación de calidad pregunta si se puede confiar en el atributo o conjunto de datos para el propósito previsto. La gestión más amplia de la Calidad de Datos también puede incluir perfiles, detección de anomalías, conciliación, monitoreo de la oportunidad, análisis histórico y remediación.
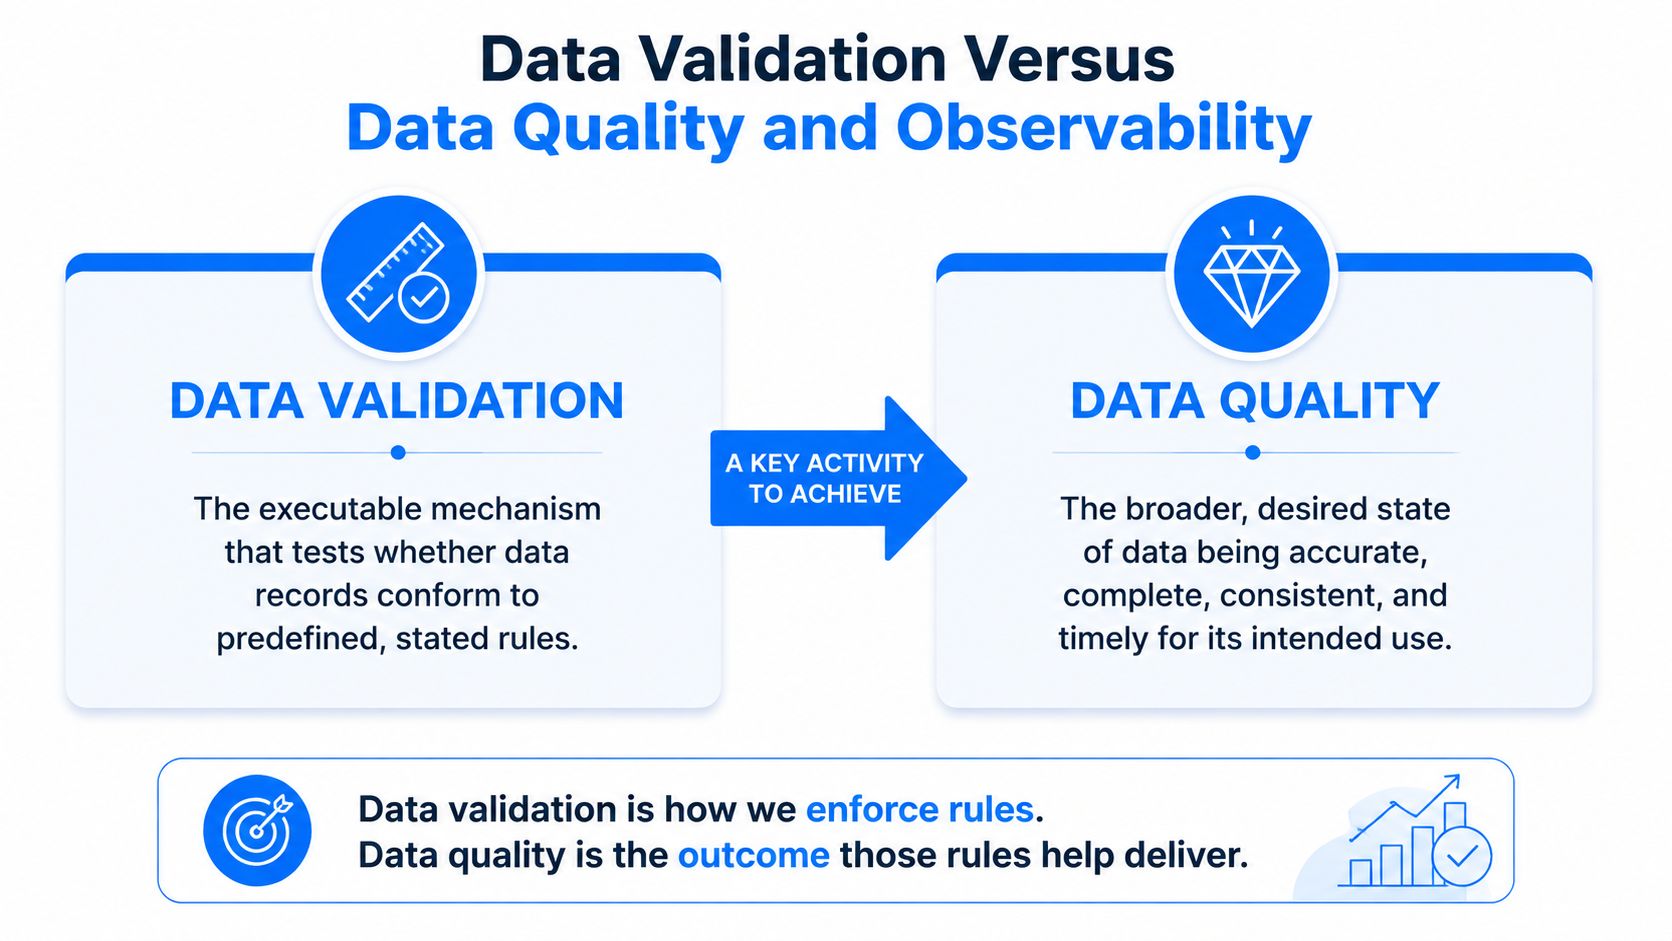
La validación y la observabilidad responden a preguntas diferentes
La Data Validation pregunta:
¿Cumplen estos datos con esta regla definida?
La Data Observability pregunta:
¿Qué está sucediendo con los datos y cómo ha cambiado su comportamiento?
La validación suele ser determinista y guiada por reglas. La observabilidad añade señales de comportamiento como tendencias, anomalías, contexto de linaje, frescura y detección de cambios estructurales. Se complementan mutuamente. Una regla de validación puede identificar un código postal no válido, mientras que el monitoreo de anomalías puede identificar un aumento repentino en las fallas de códigos postales.
Considere un flujo de trabajo de direcciones de clientes. La validación puede rechazar códigos postales malformados. La puntuación de calidad puede mostrar una disminución de la completitud en los campos de dirección. La observabilidad puede detectar que un cambio de esquema ascendente introdujo un campo no asignado. Cada capa responde a una pregunta operativa diferente, y juntas proporcionan un diagnóstico más sólido que cualquier capa por separado.
Automatización y monitoreo de Data Validation
La Data Validation automatizada debe ejecutarse como parte del ciclo de vida de los datos, no como un script aislado que alguien se acuerda de ejecutar. Los equipos pueden activar comprobaciones después de eventos de carga a través de Airflow, Dagster o Azure Data Factory, o programarlas para conjuntos de datos que no tienen señales de eventos confiables.
Ejecute comprobaciones en el almacén de datos o lakehouse donde sea práctico. La ejecución en la base de datos mantiene los datos en su lugar, respalda el linaje y evita movimientos innecesarios. Materialice los resultados en un esquema de control con el identificador de la regla, la marca de tiempo de ejecución, el alcance, el estado, el recuento de registros fallidos, la gravedad y el propietario.
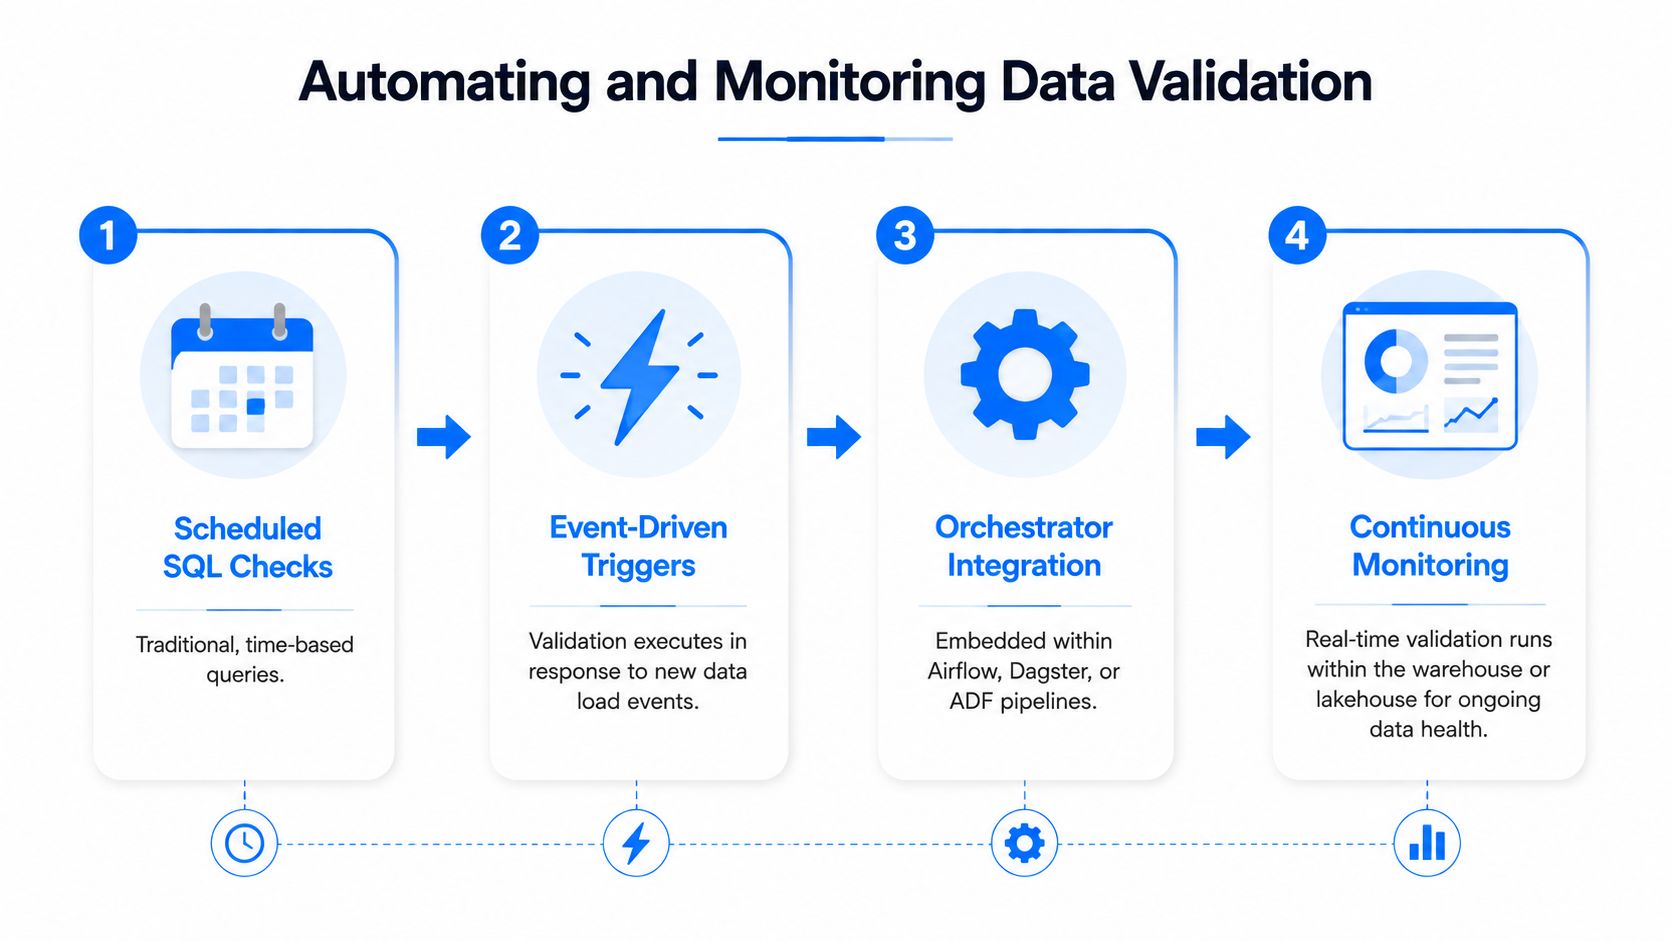
Construir la ruta de respuesta
Utilice alertas graduadas en lugar de tratar cada falla como una interrupción del servicio:
Advertencias: Registre un problema no bloqueante para su revisión.
Bloqueos: Detenga la publicación cuando falle una regla crítica.
Cuarentena: Aisle los registros no válidos para investigación o reproducción.
Escalada: Dirija las fallas urgentes a Slack, PagerDuty o flujos de trabajo de tickets.
Una cola de triaje debe asignar un propietario, vincular a un libro de ruta, identificar la regla fallida y capturar una categoría de causa raíz. La resolución debe retroalimentar el diseño del control. A veces la regla necesita refinamiento. A veces, el contrato ascendente o la transformación deben cambiar.
Las pruebas de dbt y Great Expectations proporcionan patrones ampliamente adoptados para expresar comprobaciones en código. Los equipos operativos también necesitan ejecuciones idempotentes, reejecuciones seguras, gestión de la desviación del esquema y expectativas de servicio claras para la frescura frente al retraso de la validación. Los equipos que construyen un modelo operativo también pueden consultar a Hire-a.dev sobre monitoreo para consideraciones más amplias sobre flujos de trabajo de monitoreo. El monitoreo continuo de la calidad de los datos funciona mejor cuando las señales técnicas se conectan directamente con la propiedad humana.
Flujo de trabajo de validación de extremo a extremo con un conjunto de datos de clientes
Tome un conjunto de datos de clientes con un campo country_code. El contrato de datos declara el formato ISO-3166 alpha-2 esperado y una lista blanca aprobada de 30 regiones gestionadas. El campo no debe ser nulo, debe pertenecer a ese dominio y debe seguir la estructura esperada.
Después de cada lote, las comprobaciones de SQL identifican valores nulos, códigos desconocidos y cambios en la distribución. Un monitor de anomalías compara los recuentos de países de hoy con la línea de base de los 30 días anteriores y detecta un aumento repentino en los marcadores de posición XX. Luego, la analítica muestra cuándo comenzó el deterioro, en lugar de solo informar que el último lote falló.
Paso | Acción | Herramienta o capa | Salida |
|---|---|---|---|
1 | Declarar el contrato del campo | Esquema y metadatos empresariales | Formato esperado y dominio aprobado |
2 | Ejecutar comprobaciones a nivel de registro | Capa de validación SQL | Fallas de nulos, de dominio y de formato |
3 | Comparar el comportamiento a lo largo del tiempo | Detección de anomalías | Aumento inusual de valores |
4 | Dirigir el incidente | Flujo de trabajo de alertas y propiedad | El equipo de ingesta investiga |
5 | Corregir y conciliar | Corrección de ETL y retrollenado | Registros afectados reparados |
6 | Volver a calcular el uso posterior | Analítica e informes | Vistas de ingresos regionales actualizadas |
El equipo de ingesta descubre que un proceso ETL ascendente utiliza por defecto XX cuando falla la geodistribución. Corrigen la transformación, retrollenan los registros afectados y vuelven a ejecutar la analítica de ingresos posteriores por región. La validación identifica los valores incorrectos, el monitoreo de anomalías revela el cambio inusual y la analítica establece la línea de tiempo. Las tres capas forman un ciclo de retroalimentación cerrado en lugar de una colección desconectada de comprobaciones.
digna proporciona Data Validation a nivel de registro para reglas explícitas que cubren campos obligatorios, formatos, dominios, rangos, condiciones de campos cruzados y restricciones referenciales o comerciales. Su función complementaria de Data Anomalies puede identificar cambios inusuales en los resultados de la validación o en el comportamiento de los datos, mientras que Data Analytics admite el análisis histórico de las métricas y tendencias de validación. Visite digna para evaluar cómo estas capacidades podrían integrarse en su flujo de trabajo de monitoreo de calidad de datos.
Preguntas frecuentes
¿Qué es la Data Validation?
La Data Validation es el proceso de aplicar reglas, restricciones, formatos, dominios y condiciones comerciales definidas para determinar si los datos cumplen con los requisitos especificados. Convierte las expectativas de Calidad de Datos en controles explícitos y comprobables.
¿Qué son las reglas de Data Validation?
Las reglas de Data Validation son condiciones lógicas aplicadas a un alcance definido, como un campo, registro, tabla o etapa de un flujo de trabajo. Pueden activar acciones que incluyen advertencia, rechazo, cuarentena o corrección cuando los datos fallan.
¿Cuáles son los principales tipos de Data Validation?
Los tipos comunes incluyen comprobaciones de formato, tipo de datos, dominio, rango, nulabilidad, campos cruzados, referencial, unicidad, esquema, reglas de negocio y comprobaciones estadísticas o de distribución. La combinación adecuada depende de cómo se utilizarán los datos.
¿Cómo se mide la Data Validation?
Mida la tasa de aprobación, la tasa de fallas, el recuento de registros fallidos, el recuento de reglas fallidas, las tendencias de fallas y la tasa de fallas de reglas críticas. Los umbrales deben reflejar la importancia del elemento de datos y la consecuencia de la falla.
¿Is Data Validation the same as Data Quality?
No. La Calidad de Datos es la evaluación más amplia de si los datos son aptos para su uso. La Data Validation es un mecanismo práctico para probar requisitos específicos de Calidad de Datos.
¿Cuál es la diferencia entre Data Validation y verificación de datos?
La Data Validation comprueba si los datos se ajustan a los requisitos definidos. La verificación de datos generalmente confirma que un valor o proceso coincide con una fuente o resultado esperado. La verificación puede respaldar la validación, pero los términos describen diferentes actividades de control.
¿Puede la Data Validation detectar datos inexactos?
Puede detectar inexactitudes cuando la organización cuenta con una referencia confiable, una regla de conciliación o una condición comercial para realizar la prueba. Un valor puede aprobar las comprobaciones de formato y dominio y, aun así, ser tácticamente incorrecto, por lo que la validación debe combinarse con el perfilado, la conciliación y la detección de anomalías.
¿Cómo se puede automatizar la Data Validation?
Ejecute reglas dentro de los flujos de trabajo de ingesta y transformación, conéctelas a orquestadores como Airflow, Dagster o Azure Data Factory, almacene los resultados en un esquema de control y dirija las fallas a través de flujos de trabajo de alertas y triaje. Las pruebas de dbt y Great Expectations son patrones de implementación comunes.
¿Cómo apoya digna Data Validation a la Calidad de Datos?
digna Data Validation aplica reglas explícitas a nivel de registro y registra los resultados para controles de calidad específicos. Utilizada junto con la detección de anomalías y la analítica histórica, ayuda a los equipos a conectar fallas individuales con comportamientos cambiantes de los datos y tendencias de calidad a más largo plazo.


