Qué es un archivo Parquet y por qué se usa
|
9
minuto de lectura
Parquet es un formato de archivo columnar de código abierto que guarda juntos los valores del mismo tipo y usa metadatos en el pie para que los motores de consulta lean solo las columnas que necesitan y se salten los datos irrelevantes. Nació como esfuerzo conjunto de Twitter y Cloudera, se publicó por primera vez en julio de 2013 y pasó a ser proyecto de primer nivel de la Apache Software Foundation el 27 de abril de 2015.
Si estás aquí, probablemente tengas uno de tres problemas. Tus consultas al almacén se volvieron más lentas al crecer un conjunto de datos. Tu lake está lleno de exportaciones CSV, fáciles de crear y penosas de escanear. O tu equipo ya usa Parquet, pero el rendimiento sigue oscilando entre «bastante rápido» y «¿por qué expira este panel?».
Esa confusión es normal. La mayoría de explicaciones responden a qué es un archivo Parquet con una línea: «un formato columnar comprimido». Es cierto, pero incompleto. En la práctica, Parquet tiene tanto que ver con metadatos, disciplina de esquema y decisiones de disposición de archivos como con la compresión.
Un conjunto de datos Parquet limpio puede parecer cosa fácil. Uno desordenado puede producir escaneos caros, trabajos posteriores frágiles y comportamientos raros cuando los esquemas divergen entre archivos. Por eso los ingenieros de datos suelen adorar Parquet y quejarse de él al mismo tiempo.
Tabla de contenidos
Introducción a Parquet para la analítica moderna
Una escena conocida: una ingeniera de analítica abre un modelo que antes terminaba rápido, añade dos meses más de datos y de pronto cada consulta se arrastra. Los datos en bruto están en almacenamiento de objetos. Algunos archivos son CSV, otros exportaciones JSON, otros Parquet. El equipo de BI quiere paneles más rápidos. El equipo de plataforma quiere menos coste de escaneo. Nadie quiere reescribir todas las pipelines.
Ahí es donde suele entrar Parquet en la conversación.
Apache Parquet se creó como formato de archivo orientado a columnas y de código abierto para almacenamiento y recuperación eficientes, con ideas de diseño influidas por la investigación Dremel de Google. Surgió de un esfuerzo conjunto de Twitter y Cloudera, se publicó por primera vez en julio de 2013 y pasó a ser proyecto de primer nivel de la Apache Software Foundation el 27 de abril de 2015, según la historia del proyecto Apache Parquet.
Para la analítica moderna, el atractivo es simple. Parquet organiza los datos de una forma que encaja con cómo los analistas consultan tablas grandes. La mayoría de cargas analíticas no leen cada campo de cada registro. Leen un subconjunto de columnas, aplican filtros y agregan.
Por qué los equipos pasan de archivos en bruto a Parquet
Una exportación basada en filas como CSV es fácil de inspeccionar, pero obliga a los motores a vadear datos que a menudo no hacen falta. Parquet está construido para otro trabajo.
Lecturas centradas en columnas: funciona bien cuando las consultas tocan pocas columnas en muchas filas.
Eficiencia de almacenamiento: los valores del mismo tipo se guardan juntos, lo que ayuda a que la compresión funcione mejor.
Metadatos amigables para el motor: los lectores pueden usar los metadatos del archivo para evitar escanear porciones irrelevantes de un conjunto de datos.
La pega es que Parquet no es un valor por defecto universal para todo. Es excelente para escaneos analíticos. No está diseñado como un motor de almacenamiento OLTP para búsquedas y actualizaciones frecuentes de una sola fila.
Parquet ayuda más cuando tu patrón de acceso es amplio y analítico, no transaccional y fila a fila.
Esta distinción importa aún más en entornos lakehouse, donde la elección de formato de archivo interactúa con el particionado, la evolución de esquema y la planificación de consultas. Si operas ese tipo de stack, conviene conectar las decisiones de formato con prácticas más amplias de mantenimiento de la calidad de datos en el lakehouse.
La pregunta detrás de la pregunta
Cuando alguien pregunta qué es un archivo Parquet, suele querer decir algo más práctico:
¿Hará más rápidas mis consultas?
¿Reducirá el almacenamiento?
¿Se romperá cuando evolucionen los esquemas?
¿Debería usarlo para todos los conjuntos de datos?
Esas son las preguntas útiles. Al final deberías poder responderlas con más precisión que «Parquet es comprimido y columnar».
Cómo funciona el almacenamiento columnar en lenguaje llano
Piensa en una hoja de cálculo con columnas como customer_id, country, signup_date y revenue. Un formato orientado a filas guarda cada registro junto. Un formato orientado a columnas guarda todos los valores de customer_id juntos, todos los de country juntos, y así.
Suena abstracto hasta que lo llevas a una consulta.
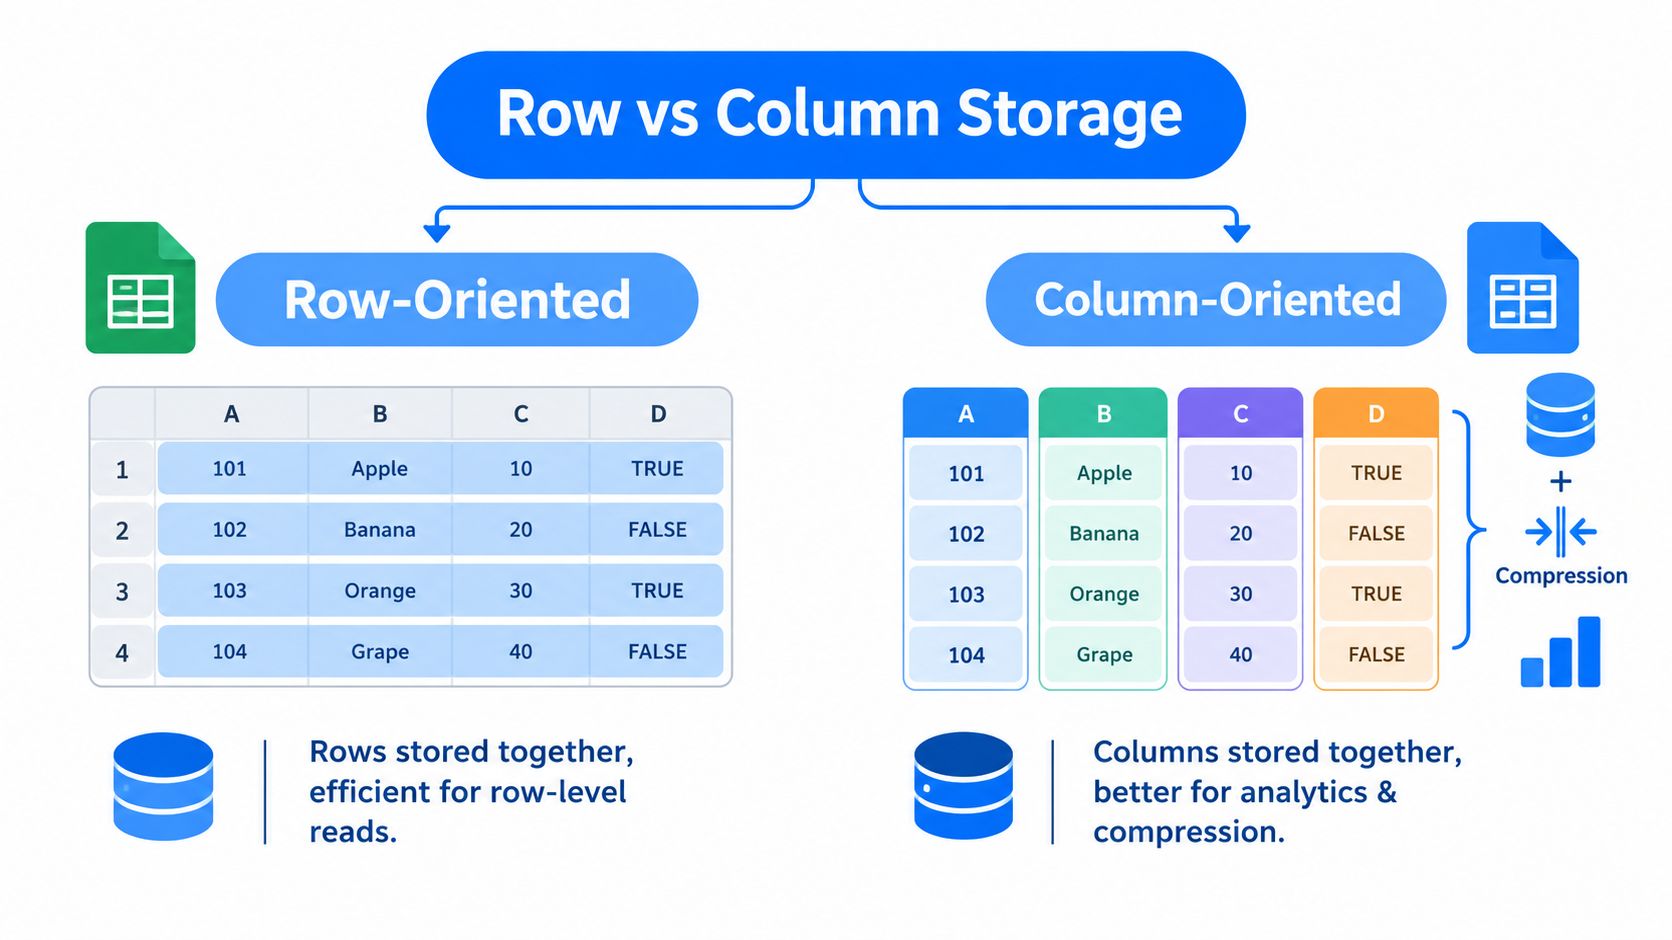
Almacenamiento por filas frente a almacenamiento por columnas
Supón que ejecutas:
select country, sum(revenue) from sales where signup_date >= ... group by country
Un archivo orientado a filas hace que el motor lea cada registro completo, incluidas las columnas que tu consulta no usa. Un archivo orientado a columnas deja que el motor se centre en country, revenue y signup_date.
Esa es la primera gran idea: el descarte de columnas. El lector se salta por completo las columnas no tocadas.
La segunda gran idea es la compresión. Cuando valores parecidos están juntos, la compresión suele funcionar mejor. Una columna llena de fechas se comporta distinto de una llena de texto, y una columna con categorías repetidas distinto de un campo de notas libres.
Por qué ayudan los valores del mismo tipo
Parquet admite codificaciones de columna y códecs de compresión integrados, y el formato documenta códecs como Snappy, Gzip, LZO y Zstandard. Como los valores del mismo tipo se guardan juntos, esa disposición mejora la eficiencia de almacenamiento y ofrece a los equipos un compromiso entre coste de CPU y tamaño de archivo para cargas analíticas, como describe la documentación de codificación de Parquet.
Esta es la versión práctica:
Los valores repetidos comprimen bien: códigos de país, campos de estado, booleanos.
Las secuencias numéricas se codifican con eficiencia: los identificadores y las marcas de tiempo suelen beneficiarse de codificaciones especializadas.
Las tablas anchas se benefician de la proyección: si tu panel necesita 5 de 80 columnas, el motor no tiene que pagar por las 80.
Regla práctica: si tus usuarios suelen escanear muchas filas pero solo una fracción de las columnas, el almacenamiento columnar trabaja a favor de tu carga en lugar de en contra.
Dónde se produce la confusión
Mucha gente oye «columnar» y da por hecho que Parquet es automáticamente más rápido para cualquier caso. No lo es.
Parquet está optimizado para escaneos analíticos, sobre todo cuando necesitas pocas columnas en muchos registros. Es menos natural para patrones de acceso fila a fila, actualizaciones de alta frecuencia o cargas que recuperan constantemente registros individuales por clave.
Un modelo mental útil es este:
CSV: fácil de producir, difícil de escanear con eficiencia a escala
Formatos binarios basados en filas: mejores para lecturas de registro completo
Parquet: mejor cuando la consulta es selectiva por columna y grande por número de filas
Si solo recuerdas una cosa de esta sección, que sea esta: Parquet acelera la analítica porque cambia lo que el motor tiene que leer, no solo porque encoge archivos.
Dentro de un archivo Parquet, de la cabecera al pie
Una vez entendida la idea columnar, el siguiente paso es la anatomía del archivo. Parquet pasa a ser más que «CSV pero comprimido».
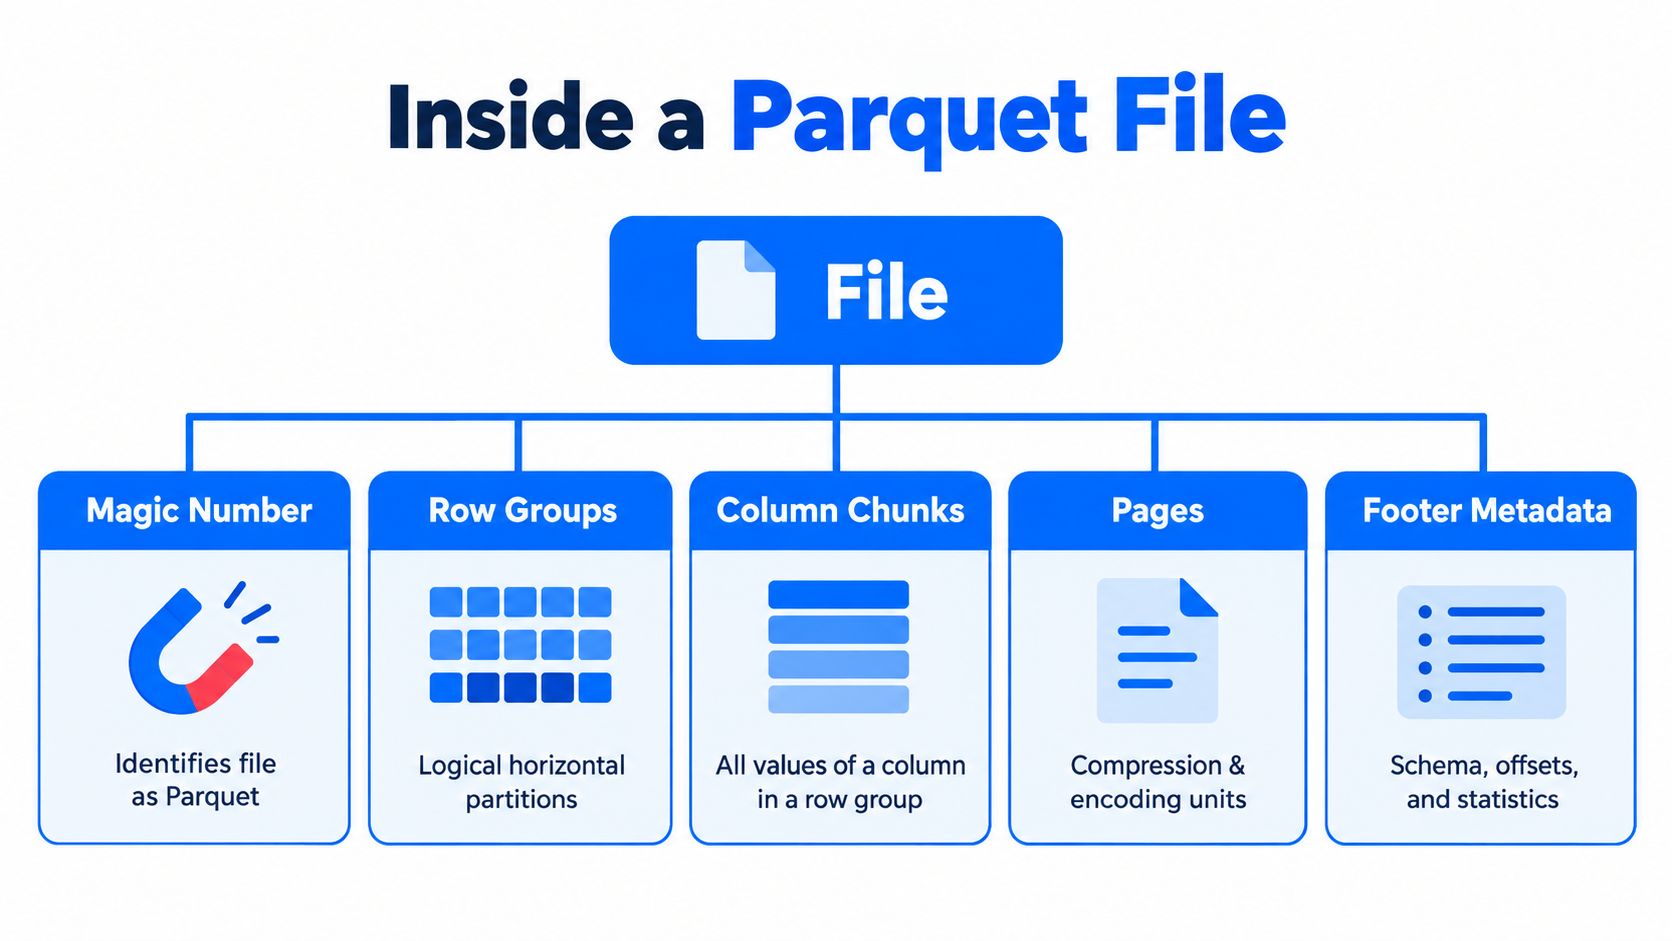
Un archivo Parquet empieza con un número mágico de 4 bytes, PAR1, e incluye metadatos de pie que registran el esquema, la ubicación de los fragmentos de columna, las codificaciones y las estadísticas. Ese diseño permite a los motores leer solo las columnas necesarias y saltarse grupos de filas irrelevantes durante los escaneos, según la documentación del formato de archivo Parquet.
El archivo tiene capas
Ayuda imaginar un archivo Parquet como un contenedor con partes anidadas.
Cabecera
Empieza con el número mágico
PAR1.Indica que el archivo sigue el formato Parquet.
Grupos de filas
Particiones horizontales dentro del archivo.
Cada grupo de filas contiene datos de un tramo de filas.
Fragmentos de columna
Dentro de cada grupo de filas, cada columna se guarda por separado.
Una consulta que lee tres columnas solo necesita los fragmentos de esas columnas.
Páginas
Unidades más pequeñas dentro de los fragmentos de columna.
Las codificaciones y la compresión se aplican en este nivel.
Pie
Guarda el esquema y el mapa estructural del archivo.
Incluye metadatos sobre dónde viven los fragmentos y cómo están codificados.
Por qué el pie importa tanto
El pie es la parte que muchas introducciones subestiman. Es donde Parquet se vuelve inteligente.
El verdadero poder de Parquet vive en los metadatos. El archivo no solo guarda valores. Guarda suficiente estructura para ayudar a los motores a evitar trabajo innecesario.
Esos metadatos pueden decirle a un lector dónde empieza un fragmento de columna, cómo se codificaron los valores y qué estadísticas hay disponibles para descartar. Dicho de otro modo, el motor no abre el archivo a ciegas y lee hasta encontrar lo que busca. Empieza con un mapa.
Para equipos que manejan muchos archivos en un lake, por eso importan tanto las prácticas de gestión de metadatos. La analítica rápida depende de una estructura de archivos organizada, esquemas coherentes y metadatos legibles, no de elegir Parquet una vez y seguir adelante.
Qué hacen los grupos de filas en la práctica
Los grupos de filas son un compromiso útil. Hacen un archivo lo bastante grande para escaneos eficientes y aun así divisible para trabajo en paralelo.
Supón que tu consulta filtra por una columna de fecha. Si los metadatos indican que un grupo de filas cae por completo fuera del rango del filtro, el motor puede saltárselo. Si la consulta solo selecciona un subconjunto de columnas, también puede ignorar los fragmentos de columna innecesarios dentro de los grupos que sí coinciden.
Esa combinación es donde Parquet suele ganar:
Saltar columnas que no necesitas
Saltar grupos de filas que no pueden coincidir
Decodificar páginas solo donde haga falta
Por qué la anatomía del archivo afecta a la operación
Cuando Parquet se porta mal, el problema rara vez es «Parquet es lento». Suele ser alguno de estos:
demasiados archivos diminutos
tamaños de grupo de filas mal elegidos
esquemas inconsistentes entre archivos parciales
estadísticas débiles o ausentes
descubrimiento de metadatos caro en tablas grandes
Por eso los ingenieros con experiencia tratan Parquet como formato de almacenamiento y sistema operativo a la vez. Las tripas del archivo son elegantes. En el comportamiento a nivel de conjunto de datos empiezan las partes duras.
Compresión, codificaciones y compromisos de rendimiento
Parquet obtiene buena parte de su eficiencia de algo sencillo: cuando los valores del mismo tipo están juntos, el formato puede codificarlos y comprimirlos con más inteligencia que un archivo de texto plano.
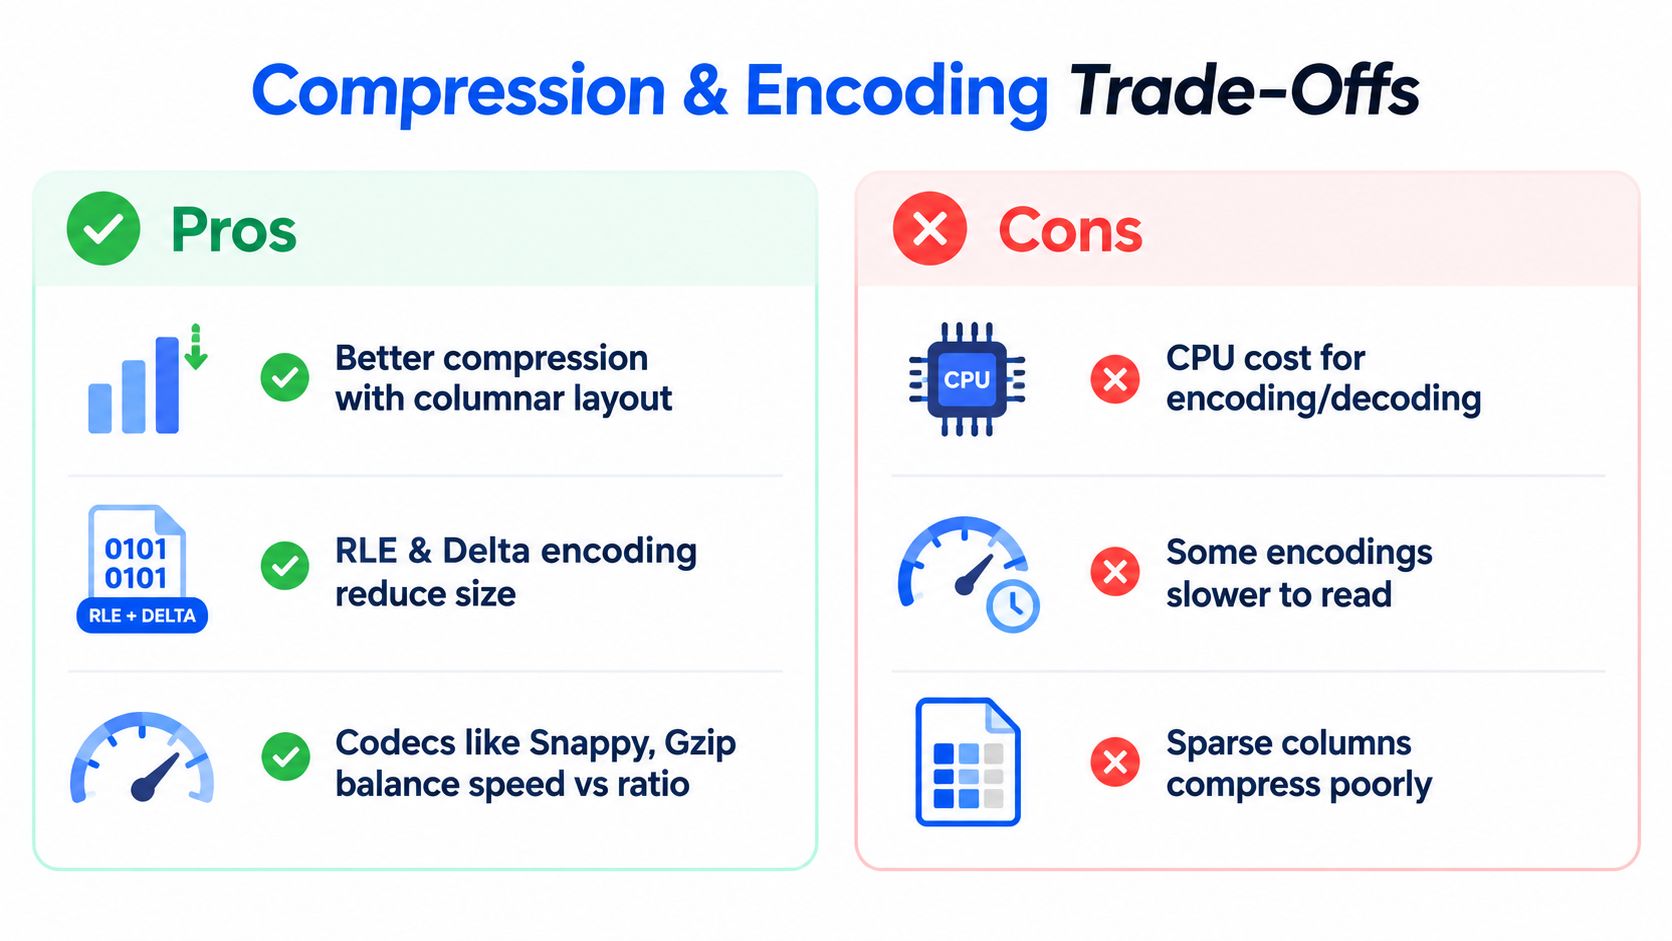
El detalle clave es dónde ocurre esto. Parquet admite varios mecanismos de codificación y compresión a nivel de página. El formato incluye codificaciones como PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY y BYTE_STREAM_SPLIT, además de códecs de compresión como SNAPPY, GZIP, BROTLI, ZSTD y LZ4_RAW, según resume la referencia del formato Parquet.
Primero la codificación, después la compresión
Una forma fácil de pensarlo:
La codificación cambia cómo se representan los valores.
La compresión encoge los bytes codificados.
Están relacionadas, pero no son la misma decisión.
Una columna de texto con baja cardinalidad puede beneficiarse de un tratamiento tipo diccionario. Una serie numérica puede encajar con una codificación orientada a deltas. Después, un códec como Snappy o ZSTD puede comprimir aún más las páginas.
Codificaciones y códecs de Parquet de un vistazo
Mecanismo | Ejemplos | Mejor para | Contrapartida |
|---|---|---|---|
Codificación | PLAIN | Datos simples, compatibilidad amplia | Menos compacto con valores repetitivos |
Codificación | RLE | Valores repetidos o de baja cardinalidad | Menos útil cuando los valores varían mucho |
Codificación | DELTA_BINARY_PACKED | Datos numéricos ordenados o de cambio gradual | Puede añadir trabajo de decodificación |
Codificación | RLE_DICTIONARY | Valores categóricos repetidos | La sobrecarga del diccionario no ayuda a toda columna |
Codificación | BYTE_STREAM_SPLIT | Ciertas disposiciones numéricas | Importan el soporte del lector y el encaje con la carga |
Códec | SNAPPY | Lecturas analíticas rápidas | Normalmente archivos mayores que con códecs más pesados |
Códec | GZIP | Mejor reducción de tamaño de archivo | Más CPU para comprimir y descomprimir |
Códec | BROTLI | Casos de uso con compresión agresiva | Puede aumentar el coste de cómputo |
Códec | ZSTD | Equilibrio entre tamaño y velocidad en muchas cargas | Los resultados dependen del soporte del motor y los ajustes |
Códec | LZ4_RAW | Escenarios de descompresión rápida | La tasa de compresión puede ser menos agresiva |
Más pequeño no siempre es más rápido
Los equipos suelen sobreoptimizar lo que no toca. El archivo más pequeño en disco no produce automáticamente la consulta más rápida.
Si un códec aprieta bytes de forma agresiva pero cuesta más CPU decodificar, el tiempo total puede subir. En cambio, si el almacenamiento o la transferencia por red es la mayor restricción, una compresión más densa puede compensar.
Para analítica, la elección ganadora suele ser la que reduce el trabajo total entre almacenamiento, E/S y CPU. No la que produce el archivo más diminuto.
Por eso importa probar. Motores como Spark, Trino, DuckDB y los tiempos de ejecución de los almacenes interactúan de forma distinta con los tamaños de archivo, la estructura de páginas y el coste de descompresión. El mismo juicio aparece en el ajuste de consultas en general, no solo en los formatos de archivo, y por eso los hábitos de optimización de SQL siguen importando después de adoptar Parquet.
Cómo se compara esto con otros formatos
La compresión también es un buen punto para separar Parquet de formatos cercanos:
CSV ofrece poca ayuda estructural para una compresión tipada eficiente.
Avro es orientado a filas, lo que cambia qué comprime bien y qué se lee con eficiencia.
ORC también es columnar y orientado a analítica.
Delta añade comportamiento de tabla sobre Parquet en lugar de sustituir su disposición de almacenamiento.
Así que sí, Parquet suele ser más pequeño y rápido que CSV para analítica. Pero su verdadera ventaja viene de la combinación de disposición, metadatos, codificaciones y lectura selectiva.
Parquet comparado con CSV, Avro, ORC y Delta
Las comparaciones de formatos se enredan cuando la gente pregunta «¿cuál es el mejor?». Suele ser la pregunta equivocada. La útil es: ¿qué formato encaja con el patrón de acceso y el modelo operativo de este conjunto de datos?
Empieza por la carga de trabajo, no por la lealtad
CSV sigue siendo común porque es universal. Puedes abrirlo casi en cualquier cosa. Pero la universalidad viene con tipado débil, metadatos pobres y escaneos caros.
Avro es mejor cuando te importa el intercambio orientado a filas, las pipelines de eventos o las lecturas de registro completo. ORC compite más directamente con Parquet en entornos analíticos, sobre todo en stacks que crecieron alrededor de la optimización estilo Hive. Delta es otra cosa: suele significar una capa de transacciones y gestión de tablas construida sobre archivos Parquet.
Cómo elegir entre Parquet, CSV, Avro, ORC y Delta
Formato | Disposición | Carga ideal | Limitación a vigilar |
|---|---|---|---|
Parquet | Columnar | Escaneos analíticos sobre grandes datos tabulares | Puede volverse operativamente penoso con deriva de esquema y mala disposición de archivos |
CSV | Texto plano tipo fila | Intercambio simple, exportaciones rápidas, inspección manual | Tipado débil, sin metadatos ricos, escaneos grandes ineficientes |
Avro | Binario orientado a filas | Pipelines de eventos, serialización, procesamiento de registro completo | Menos eficiente que los formatos columnares para analítica selectiva |
ORC | Columnar | Analítica en ecosistemas que favorecen las herramientas ORC | El encaje depende del soporte del motor y de los estándares del equipo |
Delta | Capa de tabla sobre Parquet | Cargas de lakehouse que necesitan semántica de tabla y gestión de datos | Añade conceptos operativos más allá del formato de archivo |
La pregunta sutil que la gente se salta
Muchos equipos preguntan qué es un archivo Parquet, lo adoptan y se quedan ahí. El mejor seguimiento es: ¿debería esta carga seguir usando Parquet por defecto?
Esa pregunta importa más ahora porque el formato sigue evolucionando. La documentación del proyecto Parquet de 2026 muestra cambios activos, incluido el soporte de Variant en vista previa y un tipo lógico File propuesto para cargas no estructuradas, lo que señala una expansión más allá de las tablas analíticas clásicas. Pero esas capacidades aún no están ampliamente maduras en el ecosistema, así que el encaje con la carga importa más que los valores por defecto de talla única, como se indica en la documentación de versiones del formato Parquet.
Eso tiene una implicación práctica en 2025 y 2026. Los equipos eligen cada vez más el formato por patrón de acceso:
escaneos analíticos sobre datos tabulares estables
transporte de eventos fila a fila
operaciones de lakehouse gestionadas por tabla
cargas semiestructuradas o con mucho acceso aleatorio
Para equipos de plataforma con stacks lakehouse estilo Databricks, la elección de formato también interactúa con decisiones de gobernanza y fiabilidad como la gestión de calidad de datos para entornos Databricks.
Una regla de decisión sencilla
Usa Parquet cuando tu patrón dominante sean lecturas analíticas sobre grandes conjuntos de datos y tu herramental lo soporte bien. Sé más cauto cuando la carga se incline hacia actualizaciones frecuentes de filas, cargas semiestructuradas en evolución constante o patrones de acceso que priorizan la recuperación aleatoria sobre los escaneos amplios.
Parquet suele ser un buen valor por defecto. Simplemente ya no es el único razonable.
Cómo inspeccionar y crear archivos Parquet en la práctica
La teoría ayuda, pero la mayoría de ingenieros acaba queriendo responder a tres preguntas concretas:
¿Qué esquema hay dentro de este archivo?
¿Cuántos grupos de filas tiene?
¿Qué opciones de compresión o codificación se usaron?
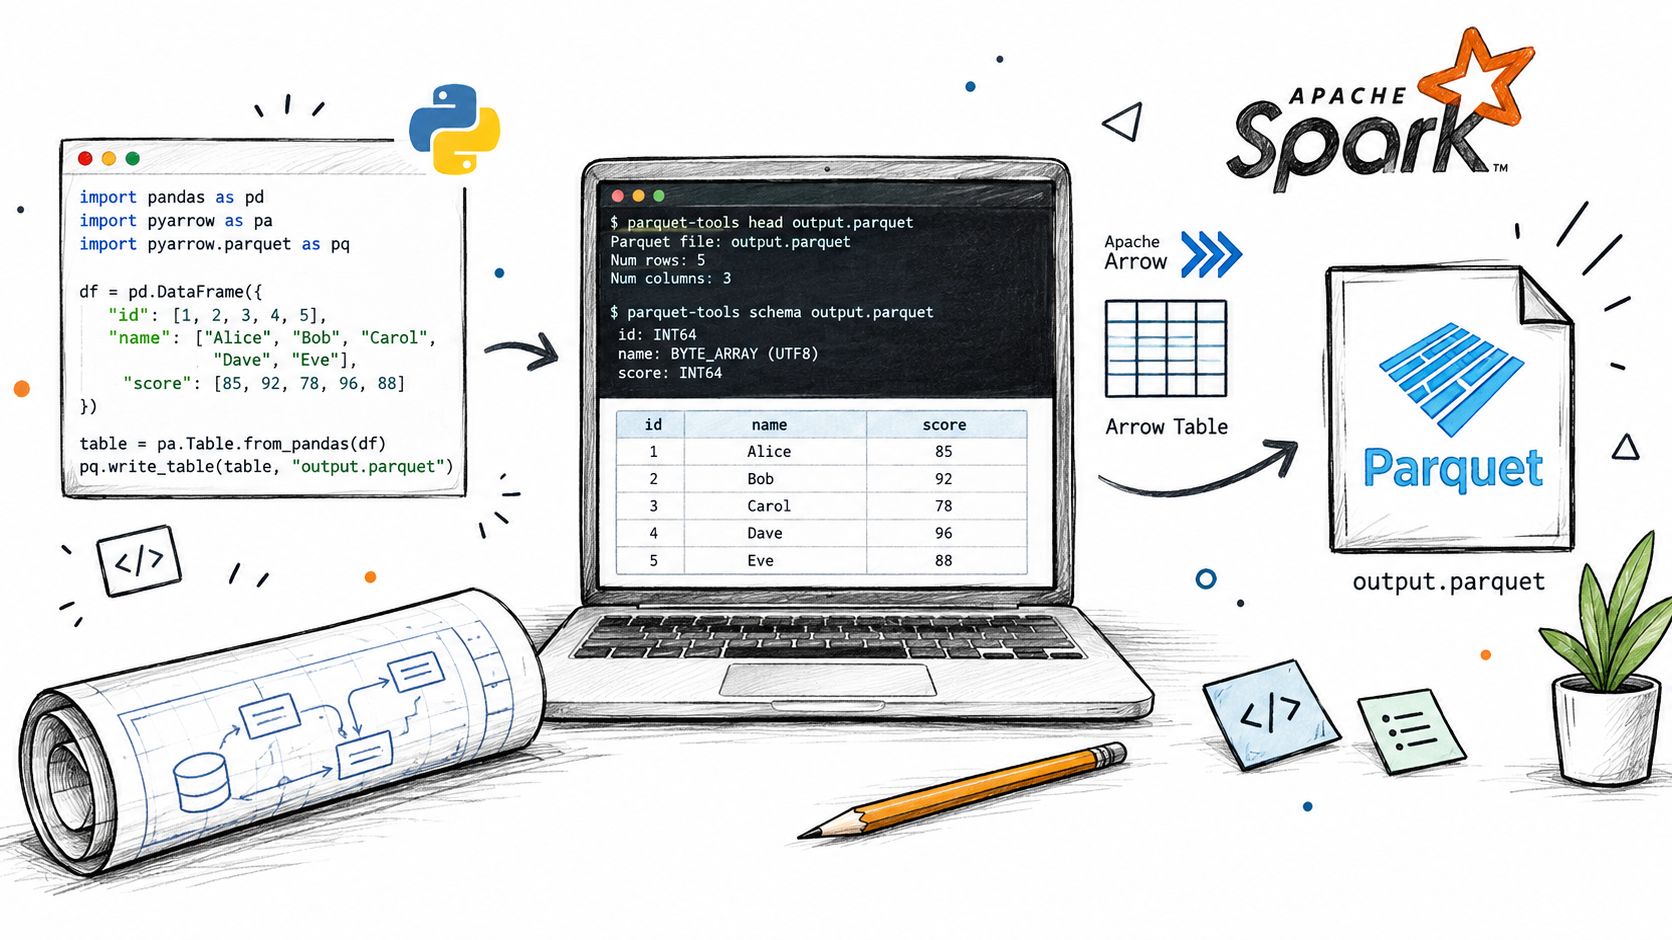
Inspeccionar un archivo
Un hábito ligero es inspeccionar Parquet antes de depurar el comportamiento de consultas posteriores.
Con parquet-tools, los ingenieros suelen mirar esquema y metadatos:
Con PyArrow en Python:
Con Spark:
¿Qué estás buscando?
Forma del esquema: ¿son los nombres y tipos de columna los que esperas?
Número de grupos de filas: demasiados pueden indicar fragmentación excesiva.
Detalles de compresión: útiles cuando el almacenamiento y el tiempo de ejecución no cuadran.
Nulabilidad y cambios de campo: a menudo la primera pista de una rotura posterior.
Escribir Parquet desde Python y Spark
Crear Parquet suele ser sencillo. Los detalles operativos importan más que la sintaxis.
Con pandas y PyArrow:
Con Spark:
Esas líneas son la parte fácil. Las preguntas más importantes son:
¿Estás escribiendo tamaños de archivo sensatos?
¿Están las particiones alineadas con los filtros reales?
¿Producen todos los escritores el mismo esquema?
¿Están los trabajos de anexado introduciendo deriva?
Las herramientas son solo la mitad del trabajo
Un conjunto de datos puede contener archivos Parquet válidos y aun así comportarse mal como tabla. Por eso los equipos suelen combinar la inspección de archivos con monitorización de cambios de esquema, frescura y comportamiento de los datos. En esa categoría entran la inspección de metadatos nativa del motor, las herramientas de catálogo y plataformas como digna, que monitoriza el comportamiento de los datos, valida registros, sigue la puntualidad y detecta cambios de esquema dentro del entorno del propio cliente.
Si tu plan de consulta parece razonable pero el rendimiento sigue oscilando, inspecciona los archivos y los metadatos del conjunto de datos antes de culpar al motor.
En la práctica, el mejor bucle de depuración es corto: inspecciona el archivo, inspecciona la disposición de la tabla, inspecciona el plan de consulta y después inspecciona la evolución del esquema entre particiones o lotes de anexado.
Buenas prácticas de particionado, evolución de esquema y velocidad
La mayoría de problemas de «rendimiento de Parquet» no vienen de Parquet. Vienen de cómo los equipos escriben, anexan, particionan y hacen evolucionar los conjuntos de datos con el tiempo.
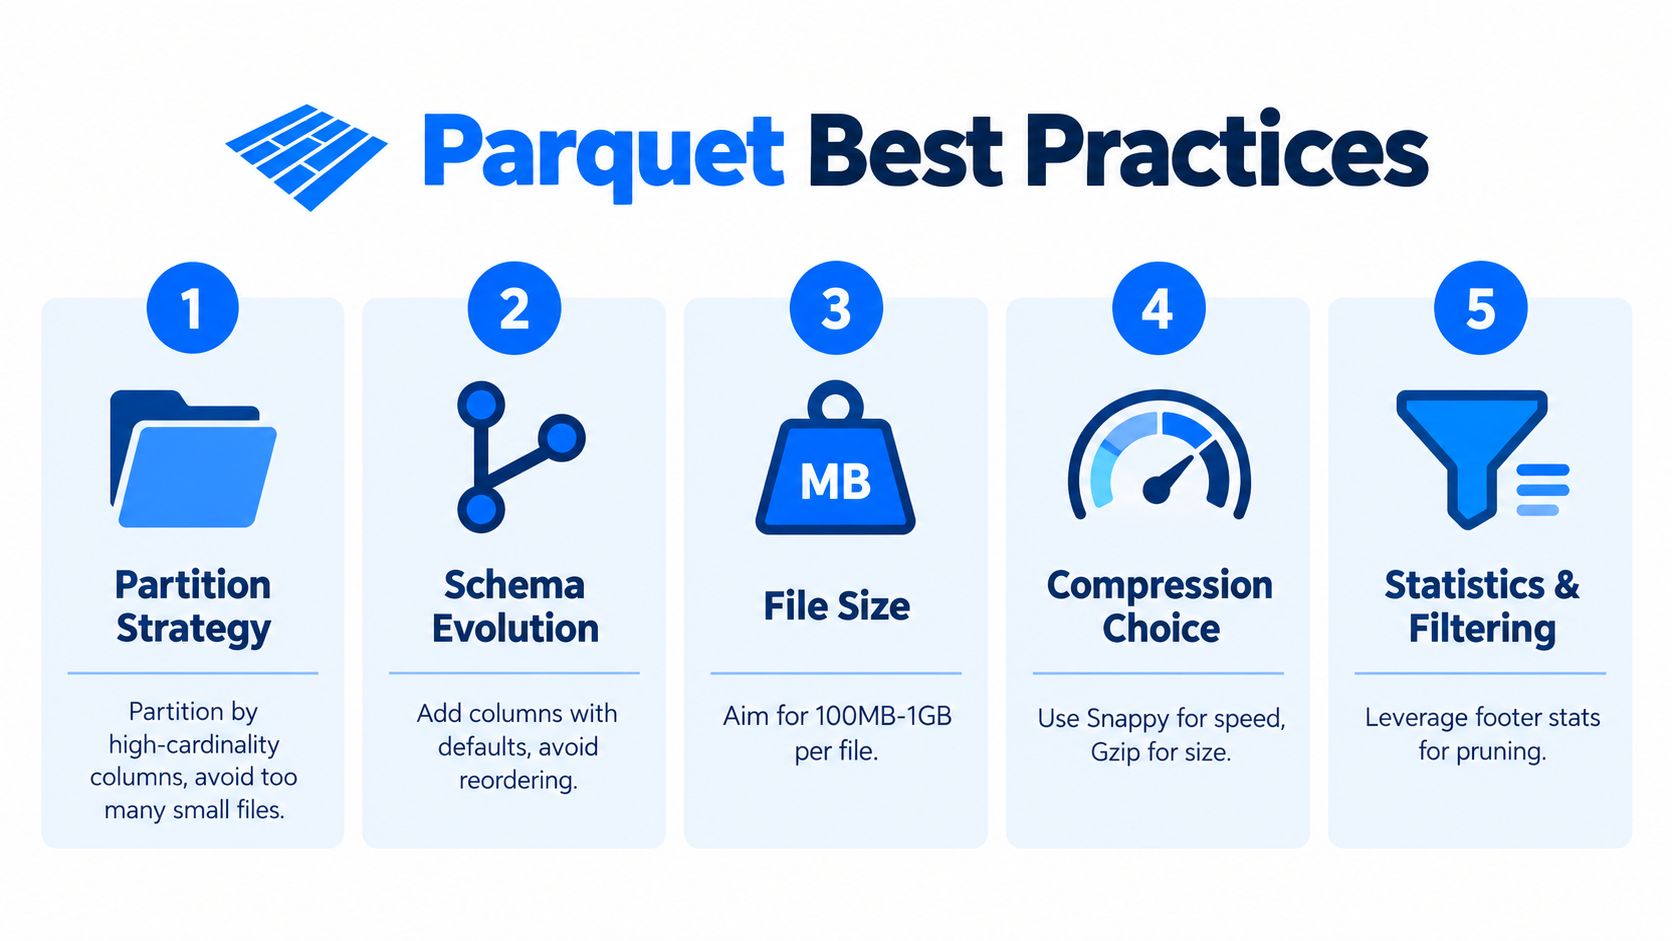
Trata la disposición como parte del modelo de datos
La especificación de Parquet recomienda grupos de filas grandes, de 512 MB a 1 GB, lo que ayuda a equilibrar eficiencia de escaneo y procesamiento paralelo para grandes conjuntos analíticos, según las indicaciones de configuración de Parquet.
Esa recomendación sorprende porque muchos conjuntos reales acaban fragmentados en piezas mucho más pequeñas. Los archivos pequeños y los grupos de filas diminutos crean sobrecarga de planificación, gestión de metadatos y programación de tareas.
Unos cuantos hábitos prácticos ayudan:
Particiona con moderación: particiona por campos por los que la gente filtra. Demasiadas particiones crean dispersión de archivos y dolor de metadatos.
Apunta a tamaños de archivo sanos: lo bastante grandes para escaneos eficientes, no tan fragmentados que domine la planificación.
Mantén escritores coherentes: ajustes de escritura mezclados entre trabajos suelen producir rendimiento desigual.
En la evolución de esquema se esconden los costes
Un ángulo que se pierde a menudo al hablar de qué es un archivo Parquet es que la parte difícil no suele ser el formato. Es leer con eficiencia conjuntos de datos con esquemas mezclados.
Apache Spark señala que Parquet admite evolución de esquema, pero fusionar esquemas entre archivos parciales es relativamente caro y está desactivado por defecto salvo que se habilite explícitamente. Eso significa que muchos problemas reales con Parquet son problemas de gestión de metadatos en data lakes, sobre todo en conjuntos de anexado continuo donde una deriva silenciosa de esquema puede desencadenar escaneos completos caros al leer, como describe la documentación del proyecto Parquet.
El formato de archivo puede estar bien. El conjunto de datos puede seguir siendo difícil de leer con eficiencia si cada lote escribe una forma ligeramente distinta.
Por eso importa la gobernanza de esquema. Los equipos necesitan un modelo claro de cambios permitidos, detección de deriva y visibilidad del impacto posterior. Un punto de partida práctico es tener una comprensión compartida de los tipos de esquema y patrones de cambio antes de que las pipelines empiecen a evolucionar por su cuenta.
Cómo se ve una buena operación
Los conjuntos de datos Parquet más sanos suelen compartir unos rasgos:
Disciplina de anexado: los datos nuevos aterrizan en una estructura previsible.
Revisión de esquema: las columnas añadidas son deliberadas, no accidentales.
Conciencia de metadatos: los ingenieros inspeccionan grupos de filas, particiones y comportamiento de escaneo.
Comprobaciones de Timeliness: las cargas retrasadas o parciales no corrompen las suposiciones posteriores.
Si recuerdas una cosa de este artículo, que sea esta: Parquet es potente porque permite a los motores evitar trabajo innecesario. Pero si tus archivos son demasiado pequeños, tus particiones demasiado ruidosas o tus esquemas demasiado inconsistentes, el motor pierde esa ventaja enseguida.
Si el rendimiento de Parquet en tu lake acaba convirtiéndose una y otra vez en un problema de deriva de esquema o de visibilidad de metadatos, digna puede ayudarte a monitorizar cambios estructurales, puntualidad, calidad a nivel de registro y comportamiento general de los datos sin sacar datos de tu propio entorno. Así es más fácil detectar los problemas operativos alrededor de los conjuntos Parquet antes de que se conviertan en paneles rotos o escaneos caros. Más información en digna.
Un archivo válido no es un conjunto de datos fiable: la observabilidad de datos vigila las señales de esquema, frescura y volumen sobre las que los metadatos de Parquet por sí solos no actúan.
Preguntas frecuentes
¿Qué es un archivo Parquet?
Un formato de archivo columnar de código abierto que guarda juntos los valores del mismo tipo y usa metadatos de pie para que los motores de consulta lean solo las columnas que necesitan y se salten los datos irrelevantes. Empezó como esfuerzo conjunto de Twitter y Cloudera, se publicó por primera vez en julio de 2013 y después pasó a ser proyecto de primer nivel de Apache.
¿En qué se diferencia el almacenamiento columnar del almacenamiento por filas?
El almacenamiento por filas mantiene juntos todos los campos de un registro; el columnar agrupa los valores de cada campo a lo largo de los registros. Como los valores del mismo tipo quedan uno junto a otro, se codifican y comprimen mucho mejor, y una consulta que toca tres columnas nunca tiene que leer el resto.
¿Por qué importa tanto el pie?
Contiene el esquema y el mapa de dónde viven los grupos de filas y los fragmentos de columna, así que el lector lo consulta antes de decidir qué abrir. Eso abarata la planificación de los escaneos analíticos, y hace que un pie dañado salga desproporcionadamente caro, porque las páginas de datos pueden estar intactas y aun así ser inalcanzables.
¿Un archivo Parquet más pequeño siempre es más rápido?
No. Más pequeño no siempre es más rápido: un códec agresivo recorta bytes en disco pero añade CPU en cada lectura, lo que puede subir la latencia del panel en vez de bajarla. Elige primero la codificación según el patrón de valores de la columna y después el códec según el compromiso entre almacenamiento y CPU.
¿Cuándo elegir Parquet frente a CSV, Avro, ORC o Delta?
Empieza por la carga de trabajo en lugar de por la lealtad al formato. Parquet encaja con escaneos analíticos repetidos sobre un subconjunto de columnas; Avro con escrituras fila a fila e intercambio de eventos; CSV sigue siendo útil para inspección y traspasos simples; Delta añade garantías transaccionales que Parquet por sí solo no da.



