Qué es Parquet: el formato columnar explicado
|
8
minuto de lectura

Es probable que se haya topado con Parquet sin darse cuenta. Una consulta de panel de control se ejecuta en archivos del almacenamiento de objetos, el código SQL parece inofensivo y, sin embargo, una agregación aparentemente simple pasa la mayor parte de su tiempo leyendo datos que la consulta nunca necesita. El mismo conjunto de datos podría funcionar perfectamente en DuckDB o Spark y, luego, comportarse de manera diferente en otro motor debido a que un tipo lógico, una estadística o una característica más nueva no se interpretan de la misma manera.
Entonces, ¿qué es Parquet? Apache Parquet es un formato de archivo de datos de código abierto orientado a columnas, diseñado para el almacenamiento y la recuperación eficientes, especialmente para cargas de trabajo analíticas. No es una base de datos y no reemplaza un formato de tabla como Iceberg o Delta Lake. Es la capa de archivo físico que subyace a muchos lagos de datos, almacenes, exportaciones analíticas y pipelines de aprendizaje automático.
Tabla de contenidos
Por qué existe Parquet y dónde encaja
Dónde encaja Parquet en una pila de datos moderna
Cómo surgió Parquet
Dentro de un archivo Parquet
Los grupos de filas son los pisos
Los fragmentos de columna son los estantes
Las páginas son la unidad de lectura práctica más pequeña
Codificación y compresión trabajando juntas
Resumen de codificaciones y códecs comunes de Parquet
Traspaso de predicados (Predicate Pushdown) y por qué las consultas se vuelven más rápidas
Qué comprueba el lector
Parquet frente a CSV, JSON y ORC
Parquet frente a CSV frente a JSON frente a ORC
Interoperabilidad, seguridad y compensaciones del mundo real
El soporte del motor es una cuestión de compatibilidad
Los costes detrás de la comodidad
Consejos prácticos para cargas de trabajo de análisis
Una lista de verificación práctica para el diseño
Consideraciones de gobernanza e IA
Por qué existe Parquet y dónde encaja
Un analista ejecuta:
En un CSV de gran tamaño, el motor de consultas normalmente analiza las filas de todo el archivo e inspecciona campos que el cálculo nunca utiliza. Las lecturas de almacenamiento y el tiempo de CPU se destinan a columnas no relacionadas. Parquet agrupa los valores por columna, lo que permite que el lector se concentre en region y revenue en su lugar.
La idea clave es la organización física. Un archivo orientado a filas mantiene juntos los campos de cada registro, mientras que un archivo orientado a columnas agrupa los valores de la misma columna. Por lo general, las columnas contienen tipos de datos similares y valores repetidos, lo que proporciona un patrón más predecible para los métodos de codificación y compresión. Apache describe a Parquet como un formato de archivo de datos de código abierto orientado a columnas para un almacenamiento y una recuperación eficientes en su documentación oficial.
Ese diseño se adapta a varias cargas de trabajo comunes:
Lagos de datos en la nube: Los archivos en Amazon S3 y almacenes de objetos similares se pueden consultar sin tener que cargar cada campo en una base de datos.
Tablas de hechos analíticas: Spark, Trino y Presto pueden escanear columnas seleccionadas de grandes conjuntos de datos de eventos o transacciones.
Exportaciones operativas: Los equipos pueden extraer datos de la aplicación y publicar una copia analítica sin retener un formato de intercambio con mucho texto.
Características de aprendizaje automático: Los pipelines de entrenamiento y los almacenes de características pueden intercambiar archivos tipados y comprimidos en lugar de analizar repetidamente CSV o JSON.
Parquet también tiene un lugar específico en una pila de lagos de datos. Un lago de datos contiene archivos y metadatos. Los formatos de tabla añaden transacciones, instantáneas, seguimiento de particiones y gestión de esquemas. Esta comparación de lagos de datos y data marts sitúa a Parquet dentro de esa arquitectura más amplia.
Dónde encaja Parquet en una pila de datos moderna
Capa | Rol típico | Ajuste de Parquet |
|---|---|---|
Sistemas de origen | Aplicaciones, APIs y bases de datos operativas | Normalmente es un destino de exportación, no el sistema de origen |
Ingesta | Mueve y deposita datos en bruto o transformados | Formato de destino eficiente para lotes analíticos |
Almacenamiento | Almacenamiento de objetos y archivos de lagos de datos | Formato de archivo físico principal |
Gestión de tablas | Transacciones, instantáneas y coordinación de esquemas | Capa de archivo físico debajo de formatos como Iceberg o Delta Lake |
Motor de consultas | Procesamiento de SQL y dataframes | Leído directamente por muchos motores analíticos |
BI y ML | Paneles de control, modelos y pipelines de características | Formato compacto de escaneo e intercambio |
Parquet se sitúa por debajo de los formatos de tabla como Iceberg y Delta Lake, proporcionando la capa de archivo físico en lugar de gestionar transacciones o instantáneas. Esa separación explica por qué un archivo Parquet puede funcionar en varios motores, mientras que el comportamiento a nivel de tabla sigue dependiendo del sistema de consultas y los metadatos circundantes.
El modelo mental práctico es simple: Parquet hace que los escaneos de archivos analíticos sean selectivos y económicos. Sus beneficios dependen de cómo estén organizados los archivos, cómo se muevan los valores a través de la codificación y la compresión, cómo lleguen los filtros al lector y si el motor elegido admite las características relevantes de manera uniforme.
Cómo surgió Parquet
Parquet surgió de un problema práctico de Hadoop: las consultas analíticas a menudo necesitaban unos pocos campos de registros muy amplios. Twitter y Cloudera lo desarrollaron como un proyecto de código abierto, influenciado por el trabajo de Dremel de Google sobre el procesamiento en columnas para datos anidados. El primer lanzamiento llegó el 13 de marzo de 2013, seguido de Parquet 1.0 en julio de 2013, tal como se registra en el historial de Apache Parquet.

El objetivo del diseño era la lectura selectiva. Si una consulta solicitaba customer_id y revenue de un registro de evento amplio, el lector podía evitar analizar campos no relacionados. La influencia de Dremel también orientó a Parquet hacia datos analíticos anidados, no solo a tablas planas similares a hojas de cálculo.
ORC se desarrolló en el ecosistema de Hive con objetivos similares, ofreciendo a los usuarios de Hadoop otra opción sólida en columnas. El papel de Parquet creció a medida que más herramientas adoptaron lectores y escritores compatibles. El formato también ha seguido evolucionando. Un ejemplo es BYTE_STREAM_SPLIT, aprobado en la línea de lanzamiento 2.8.0 en 2019, que añadió una capacidad estandarizada en lugar de dejar el formato sin cambios.
El proyecto se convirtió en un proyecto de primer nivel de la Apache Software Foundation el 27 de abril de 2015. Esa gobernanza (governance) respalda un ecosistema con muchas implementaciones independientes en lugar de un único lector controlado por un proveedor. Spark, Trino, Presto, Hive, ClickHouse, DuckDB, Polars, BigQuery, Snowflake, Athena y Redshift se encuentran entre los motores y servicios enumerados en la documentación del ecosistema del formato. La compatibilidad aún depende de qué características implemente cada motor y de cómo maneje los esquemas, las codificaciones y los metadatos.
Eso importa en el momento de la ingesta. Un pipeline de ingesta de datos puede escribir lotes analíticos como Parquet, mientras que un formato de tabla añade transacciones e instantáneas y un motor de consultas decide cómo escanear los archivos.
Lección histórica: Parquet tuvo éxito al adaptarse a un patrón de acceso analítico común y, luego, extenderse a motores que podían leer columnas seleccionadas de manera eficiente.
Su historia explica la división de responsabilidades: Parquet maneja las capas físicas de archivo, codificación y compresión, mientras que los sistemas circundantes proporcionan la gestión de tablas y el comportamiento de las consultas.
Dentro de un archivo Parquet
Una consulta necesita solo unos pocos campos de una tabla grande, pero un archivo orientado a filas puede hacer que lea cada campo. Parquet evita ese desperdicio mediante un diseño físico anidado. Una analogía útil es el edificio de una biblioteca: el archivo Parquet es el edificio, un grupo de filas es un piso, un fragmento de columna es un estante y una página es una pila de libros en ese estante. Cada nivel tiene una tarea específica.
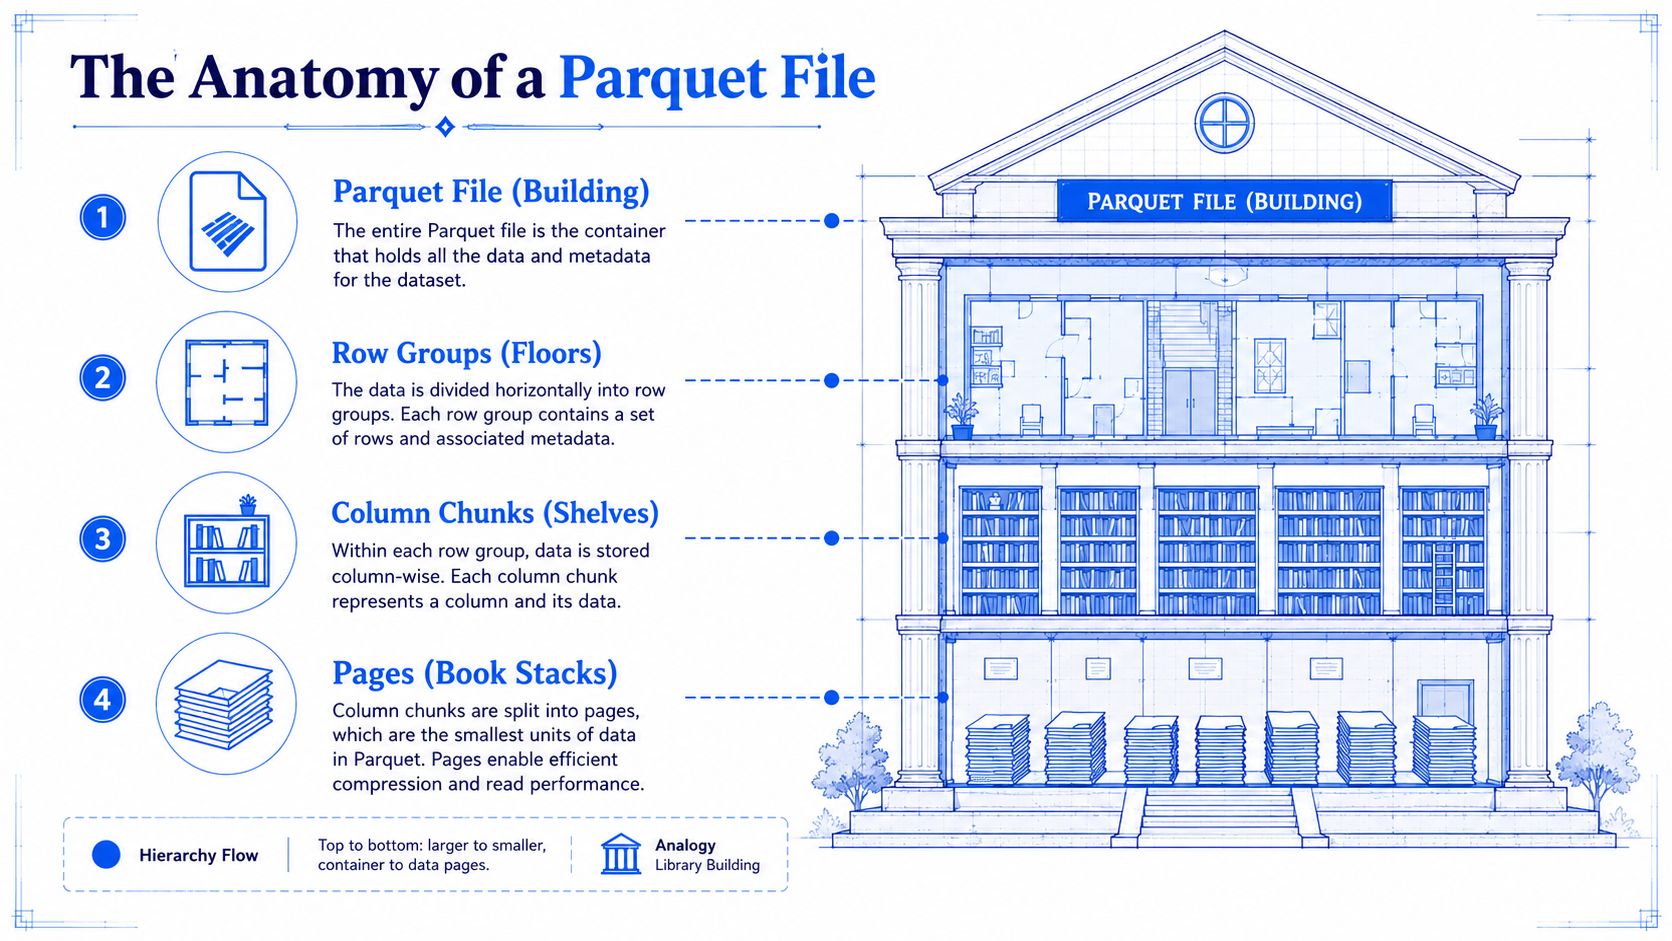
Un archivo Parquet comienza con un encabezado mágico de 4 bytes, PAR1. Sus datos se organizan en grupos de filas. Cada grupo de filas tiene exactamente un fragmento de columna por columna, y cada fragmento de columna contiene una o más páginas. Esta jerarquía proporciona a los lectores la estructura necesaria para seleccionar columnas y omitir datos irrelevantes, como se describe en la documentación de conceptos de Parquet de Apache.
Los grupos de filas son los pisos
Un grupo de filas contiene una porción horizontal de las filas de una tabla. Para columnas como event_date, region y revenue, un grupo de filas contiene una parte de las tres. Sus rangos de filas permanecen alineados, por lo que un motor puede evaluar los mismos registros mientras lee solo las columnas requeridas por una consulta.
Por lo general, los escritores apuntan a grupos de filas en el amplio rango de 128 MB a 1 GB. La configuración adecuada depende del motor, el sistema de almacenamiento, la carga de trabajo y el número de columnas. Los grupos más grandes pueden reducir la sobrecarga de metadatos, mientras que los grupos más pequeños proporcionan una omisión más detallada. Trate el tamaño del grupo de filas como una decisión de carga de trabajo más que como una constante universal.
Los fragmentos de columna son los estantes
Dentro de un grupo de filas, cada columna tiene su propio fragmento de columna. El fragmento region almacena valores de región codificados, mientras que el fragmento revenue almacena valores de ingresos codificados. Una consulta que necesita esos campos puede evitar la lectura de un fragmento customer_notes no relacionado.
El pie de página registra la ubicación y los metadatos de cada fragmento. También describe las rutas de los esquemas y los metadatos de las columnas, lo que permite al lector interpretar campos anidados y ubicar bytes relevantes sin tener que escanear desde el principio.
Las páginas son la unidad de lectura práctica más pequeña
Los fragmentos de columna se dividen en páginas que contienen valores codificados y metadatos de página. Un tamaño de página predeterminado común es 1 MB, aunque los escritores y los motores pueden elegir otras configuraciones. Las páginas proporcionan un límite más preciso para las estadísticas, la compresión y las lecturas selectivas.
El archivo termina con un pie de página que contiene la información necesaria para decodificar los datos, seguido de un marcador final PAR1. Un lector puede buscar hasta el final, leer el pie de página, identificar el esquema y las ubicaciones de los grupos de filas y, luego, realizar lecturas específicas para fragmentos y páginas seleccionados. Esta estructura hace que Parquet sea binario, autodescriptivo y divisible para el procesamiento distribuido.
Modelo mental del lector: Comience en el pie de página, identifique los grupos de filas y columnas útiles, luego lea los fragmentos y páginas específicos.
Parquet lleva la información estructural necesaria para leerse a sí mismo, por lo que no se requiere un catálogo separado. Un catálogo aún puede facilitar el descubrimiento. Una sólida gestión de metadatos ayuda a escala de tabla, especialmente cuando se deben rastrear muchos archivos y versiones de esquemas. La portabilidad de los archivos también depende de que los lectores admitan las características utilizadas por el escritor, no simplemente de que ambas herramientas se llamen compatibles con Parquet.
Codificación y compresión trabajando juntas
La gente suele utilizar "codificación" y "compresión" como si significaran lo mismo. En Parquet, son etapas separadas en un pipeline:
La codificación cambia la forma de los valores para exponer patrones.
La compresión reduce el flujo de bytes resultante.
Considere una columna country que contiene cadenas repetidas. La codificación por diccionario puede asignar a cada valor distinto un pequeño identificador entero y, luego, almacenar esos identificadores en lugar de repetir cadenas completas en toda la página. La codificación por longitud de ejecución (Run-length encoding) puede representar una secuencia de valores idénticos de forma compacta. La codificación delta almacena diferencias entre valores consecutivos, lo que puede ser eficaz cuando los números están ordenados o cambian gradualmente. El empaquetado de bits (Bit-packing) almacena enteros pequeños utilizando únicamente los bits que requieren.
Estas técnicas no se adaptan a todas las columnas. La codificación por diccionario se adapta de forma natural a los valores categóricos repetidos, mientras que la codificación delta necesita un patrón de secuencia útil. El escritor elige una codificación para la columna y la página, y los metadatos registran esa elección.
Solo después de este cambio de forma, un códec a nivel de página comprime los bytes. La documentación de Apache describe códecs como Snappy, GZIP, LZ4 y ZSTD, mientras que PyArrow también admite Brotli y salidas sin comprimir en su documentación de configuración de Parquet. La documentación del formato explica que el contenido de las páginas se comprime tal cual, sin marcos ni rellenos adicionales, lo que mantiene el comportamiento de descompresión directo.
Resumen de codificaciones y códecs comunes de Parquet
Técnica | Ideal para | Compensación |
|---|---|---|
Codificación por diccionario | Cadenas repetidas y valores categóricos | Menos útil cuando los valores son en su mayoría distintos |
Codificación por longitud de ejecución | Secuencias largas del mismo valor | Funciona mal cuando los valores cambian constantemente |
Codificación delta | Valores numéricos ordenados o que cambian gradualmente | Depende del orden y la forma de los datos |
Empaquetado de bits | Enteros pequeños e índices compactos | Requiere rangos de valores adecuados |
Snappy | Lecturas y escrituras rápidas | Normalmente prioriza la velocidad sobre la reducción máxima de tamaño |
ZSTD | Mayor reducción de almacenamiento | Puede requerir más CPU que los códecs más rápidos |
GZIP | Compatibilidad con herramientas más antiguas | A menudo más lento para cargas de trabajo interactivas |
LZ4 | Compresión y descompresión de baja latencia | La relación de compresión depende de los datos |
Los ajustes de codificación y códec se encuentran en diferentes partes de los metadatos del archivo. La elección de la codificación pertenece a la información de la página y de la columna, mientras que el códec de compresión se registra en los metadatos de la página correspondientes. Los escritores como Apache Spark, DuckDB y PyArrow pueden aplicar valores predeterminados diferentes, por lo que dos archivos Parquet válidos pueden tener perfiles de rendimiento distintos.
Un error común de ajuste es seleccionar un nivel de compresión agresivo sin medir la carga de trabajo. Una vez que una columna ya se ha hecho muy regular mediante la codificación, una configuración más lenta como el nivel 19 de ZSTD puede añadir coste de CPU sin producir una reducción útil de tamaño. La elección correcta depende de si el cuello de botella es el almacenamiento, la transferencia de red, la CPU o la latencia.
Traspaso de predicados (Predicate Pushdown) y por qué las consultas se vuelven más rápidas
Una consulta de panel de control filtra las ventas de enero, agrupa los resultados por región y suma los ingresos. Un lector de Parquet puede responderla sin decodificar la mayor parte del archivo. El mecanismo se denomina predicate pushdown, o de manera más precisa, filtrado y poda en la capa de almacenamiento.
El motor primero comprueba el valor mínimo y máximo de event_date registrado para cada grupo de filas. Si un grupo de filas se encuentra completamente fuera de enero, el lector puede omitirlo sin abrir sus páginas de datos. Para un grupo de filas que se solapa con el rango de fechas, las estadísticas a nivel de página pueden eliminar las páginas cuyos rangos no puedan coincidir.
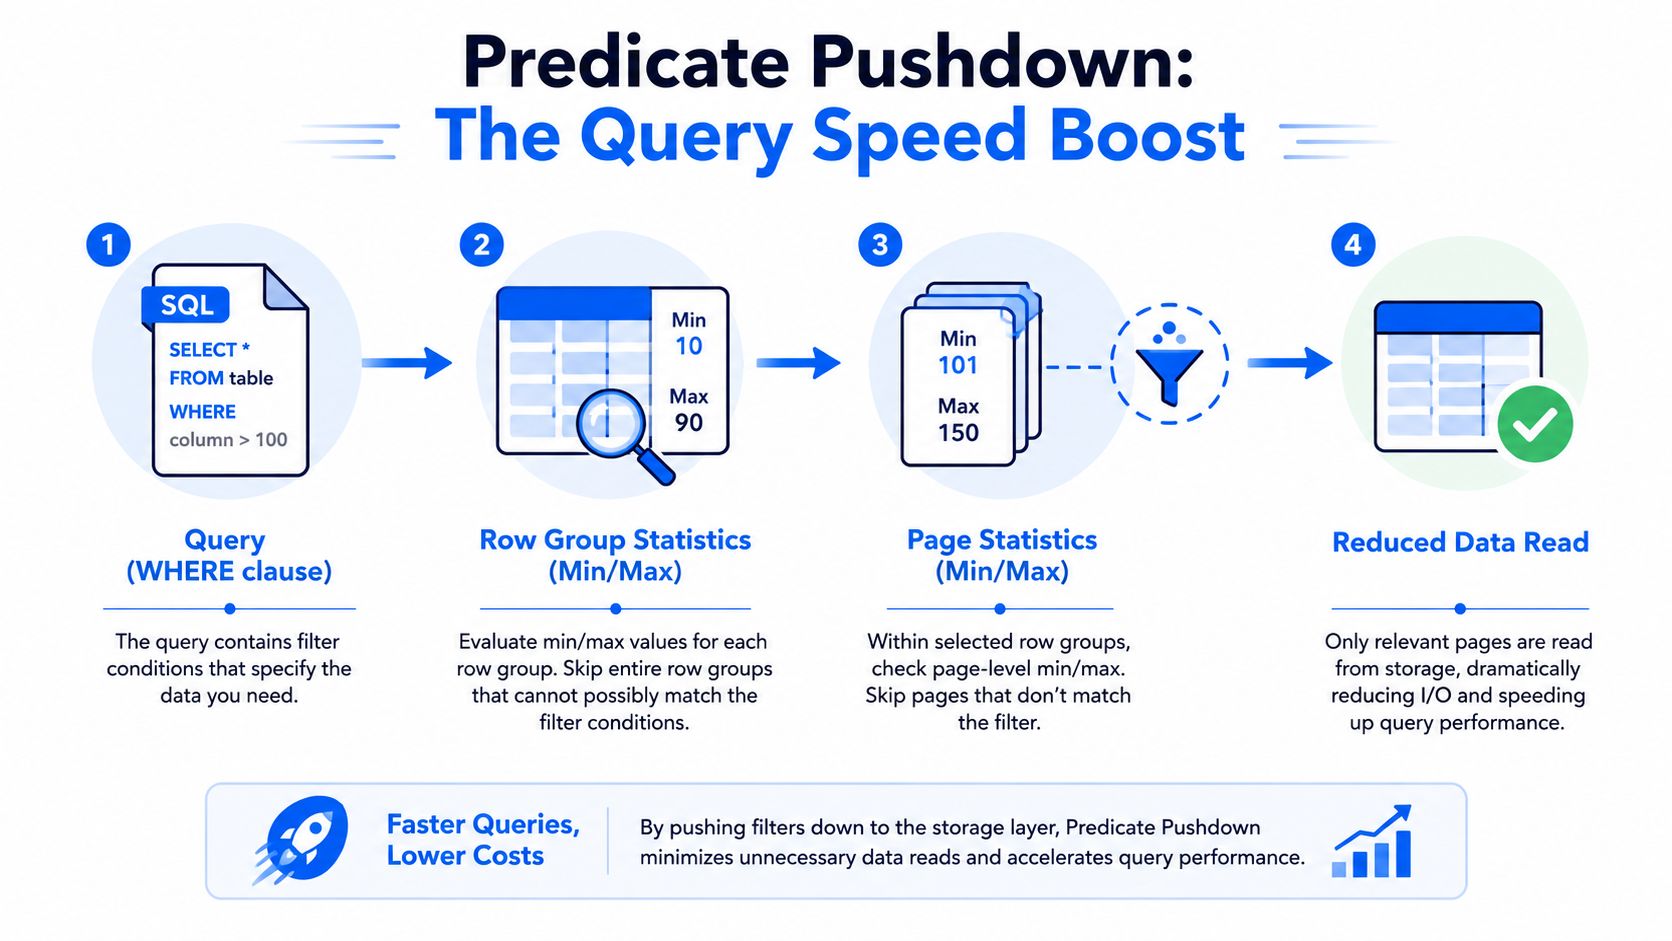
A continuación, el lector solicita únicamente las páginas de event_date, region y revenue necesarias para la consulta. Otras columnas comparten las mismas filas, pero no necesitan ser decodificadas. La estructura a nivel de archivo y columna de Parquet proporciona el diseño de metadatos que hace posible este acceso selectivo.
Qué comprueba el lector
Una secuencia típica de poda incluye:
Estadísticas del grupo de filas: Compare el filtro con el rango registrado de cada fragmento de columna.
Estadísticas de página: Inspeccione valores mínimos y máximos más detallados dentro de los grupos de filas candidatos.
Información del diccionario: Resuelva algunos filtros categóricos a partir de los valores de la página del diccionario.
Filtros Bloom: Compruebe la información probabilística de pertenencia cuando el archivo la contenga y el lector la admita.
Selección de columnas: Decodifique solo las columnas proyectadas requeridas para el resultado.
El diseño del archivo determina cuánto trabajo puede evitar la poda. Si los valores están dispersos en cada página, los rangos de mínimos/máximos se superponen y el motor tiene poco que omitir. Clasificar por una columna que se filtra con frecuencia puede agrupar valores similares, aunque la disposición útil depende del escritor y del diseño de la tabla.
El traspaso (pushdown) es también un comportamiento del motor, no una promesa de que cada predicado se maneje de forma idéntica. Los lectores pueden restringir la poda para tipos anidados o interpretar los tipos lógicos de manera diferente. El soporte para diccionarios y filtros Bloom también puede variar. Para obtener una guía más amplia sobre cómo optimizar consultas SQL, conecte el comportamiento del almacenamiento con el plan de consultas.
La regla operativa es sencilla: Parquet no hace que todas las consultas sean rápidas. Hace que las consultas selectivas sean más baratas cuando el diseño del archivo y los metadatos admiten la poda.
Parquet frente a CSV, JSON y ORC
El formato adecuado depende del trabajo. CSV y JSON funcionan bien como formatos de intercambio porque las personas pueden inspeccionarlos, las aplicaciones pueden producirlos fácilmente y las APIs los aceptan comúnmente. Los escaneos analíticos repetidos exponen sus límites: los valores se almacenan como texto y los lectores suelen analizar los registros uno por uno.
Parquet hace una compensación diferente. Almacena datos con tipo en un diseño binario, comprimido y orientado a columnas, de modo que un motor puede leer solo las columnas necesarias para una consulta. Eso lo convierte en una opción predeterminada sólida para el almacenamiento analítico, al tiempo que resulta incómodo para abrir en un editor de texto o enviarlo directamente a un consumidor que espera JSON.
El pipeline de codificación es importante aquí. Parquet puede codificar valores similares juntos, aplicar técnicas de diccionario o de longitud de ejecución donde sea apropiado y, luego, comprimir las páginas resultantes. CSV y JSON suelen dejar más análisis e inferencia de tipos al lector. ORC sigue un modelo de columnas similar y es la comparación más cercana, especialmente en entornos orientados a Hive.
Parquet cuenta con soporte directo en herramientas como Spark, Trino, Presto, Hive, ClickHouse, DuckDB, Polars, BigQuery, Snowflake, Athena y Redshift, tal como se describe en la documentación del formato Apache. El núcleo compartido mejora la portabilidad, aunque no garantiza un comportamiento idéntico para cada tipo lógico, estructura anidada o característica de metadatos.
Parquet frente a CSV frente a JSON frente a ORC
Formato | Almacenamiento | Velocidad de consulta | Evolución del esquema | Mejor opción |
|---|---|---|---|---|
Parquet | Binario compacto y orientado a columnas | Sólido para escaneos analíticos selectivos | Admite esquemas con tipos y cambios estructurales compatibles | Lagos de datos modernos y analítica |
CSV | Texto y orientado a filas | Costoso para escaneos amplios o repetidos | Informal y definido externamente | Exportaciones simples y zonas de aterrizaje |
JSON | Texto, anidado y flexible | El análisis puede ser costoso a gran escala | Flexible pero poco estricto en su aplicación | APIs, eventos e intercambio |
ORC | Binario compacto y orientado a columnas | Sólido, especialmente en cargas de trabajo orientadas a Hive | Soporte para esquemas con tipos | Entornos Hadoop centrados en Hive |
La evolución del esquema todavía requiere coordinación. Parquet registra la información del esquema en cada archivo, mientras que un sistema de tablas o catálogo suele reconciliar las versiones en una colección de archivos. Por lo general, añadir un campo que admita valores nulos es más fácil que cambiar el significado o la representación física de un campo existente. Los tipos lógicos también pueden producir resultados diferentes cuando los lectores los admiten de manera desigual.
Utilice CSV o JSON cuando los humanos, las APIs o las herramientas de ingesta sencillas necesiten la salida. Elija ORC cuando la compatibilidad con Hive y una pila centrada en ORC determinen el formato. Elija Parquet para lagos analíticos modernos e intercambio de datos entre motores, luego pruebe los lectores, escritores y tipos lógicos específicos en su entorno.
Interoperability, Security, and Real-World Trade-Offs
La adopción generalizada de Parquet puede crear la falsa impresión de que todos los motores leen todos los archivos de la misma manera. Spark, DuckDB, Trino, BigQuery, Athena y Polars suelen coincidir en el diseño central, pero pueden diferir en los tipos anidados, los tipos lógicos como UUID y JSON, la precisión decimal, los índices de página y el significado de las estadísticas en el pie de página.
Esto crea un modo de fallo práctico: un escritor produce un archivo válido, mientras que otro lector carece de soporte para la característica específica utilizada. Es posible que el archivo se abra con éxito en una herramienta y falle, degrade un tipo o ignore una optimización en otra. La página de estado de la implementación de Apache hace explícita esta falta de uniformidad. Muestra diferentes conjuntos de características en las distintas implementaciones, con Parquet Java alcanzando la versión 1.16.0 en septiembre de 2025, mientras que Arrow Rust, Hyparquet, DuckDB y Polars realizan un seguimiento de diferentes versiones de características.
El soporte del motor es una cuestión de compatibilidad
Motor | Tipos anidados | Uso de estadísticas | CVE-2025-30065 corregido |
|---|---|---|---|
Spark | Soporte amplio, depende de la característica | Utiliza rutas de poda y estadísticas compatibles | Verifique la dependencia de Parquet implementada |
DuckDB | Sólido soporte analítico, depende de la característica | Utiliza metadatos de archivo compatibles | Verifique la compilación y las dependencias implementadas |
Trino | Amplio soporte de conectores | El comportamiento depende de la versión del conector y del lector | Verifique la dependencia implementada |
BigQuery | Lee Parquet directamente | Comportamiento gestionado por el servicio | Confirme la guía de servicio actual |
Athena | Lee Parquet directamente | Admite funciones de poda compatibles en configuraciones de tablas aplicables | Confirme la guía de servicio actual |
Polars | Lee Parquet a través de su implementación | El soporte de características varía según la versión | Verifique la dependencia implementada |
La seguridad merece la misma atención que la interoperabilidad. En abril de 2025, la vulnerabilidad crítica de deserialización CVE-2025-30065 afectó a la biblioteca parquet-java. Las pautas de seguridad advirtieron a los equipos que se actualizaran a Parquet 1.15.1 y evitaran archivos no confiables, tal como se registra en la guía de seguridad e implementación de Apache.
Eso cambia la respuesta a "¿Puedo leer de forma segura cualquier archivo Parquet en cualquier herramienta?". No. Trate los archivos provenientes de cargas no confiables o de terceros externos como entradas hostiles. Aplique parches a la biblioteca correspondiente, aísle los lectores donde sea apropiado, evite aceptar esquemas remotos a ciegas y revise el comportamiento opcional de los metadatos y del índice de páginas antes de habilitar características agresivas. Un lector en un entorno aislado (sandbox) puede reducir el radio de impacto, pero no reemplaza la gestión de dependencias.
Los costes detrás de la comodidad
Parquet también presenta compensaciones no relacionadas con la seguridad:
Actualizaciones frecuentes: Los archivos analíticos inmutables pueden crear amplificación de escritura cuando los registros cambian a menudo.
Archivos pequeños: Muchos objetos diminutos aumentan la sobrecarga de listado, apertura y metadatos en el almacenamiento de objetos.
Esquemas amplios: Los metadatos del pie de página pueden crecer sustancialmente cuando los archivos contienen muchas columnas y grupos de filas.
Depuración: Los archivos binarios dañados son más difíciles de inspeccionar que un CSV mal formado.
Brechas en los motores: Una característica admitida por una implementación puede ser ignorada o rechazada por otra.
Los equipos también deben tener en cuenta los requisitos de residencia de datos al seleccionar las ubicaciones de almacenamiento, los lectores y las rutas de procesamiento. Parquet mejora el almacenamiento físico y los patrones de acceso, pero por sí solo no resuelve la gobernanza, el aislamiento ni el control regulatorio.
Consejos prácticos para cargas de trabajo de análisis
Una configuración confiable de Parquet comienza con el diseño del archivo en lugar del ajuste del códec. Para muchas cargas de trabajo de análisis en la nube, apunte a grupos de filas de alrededor de 128 MB a 256 MB y páginas cercanas a 1 MB, como se muestra en este manual de optimización de Parquet. Estos son puntos de partida, no garantías. Realice pruebas con el motor, el almacén de objetos y los tipos de consultas que utiliza su equipo.
Una lista de verificación práctica para el diseño
Elija los grupos de filas deliberadamente: Equilibre las lecturas específicas con la sobrecarga de metadatos y el comportamiento de las solicitudes del almacén de objetos.
Mantenga las páginas en un tamaño moderado: Un tamaño de página cercano a 1 MB es una base sensata para la compresión y el filtrado a nivel de página.
Ordene las columnas de filtrado útiles:
event_timeyuser_idpueden beneficiarse cuando las consultas filtran de forma selectiva y los valores se agrupan dentro de las páginas.Evite la ordenación indiscriminada: La ordenación añade trabajo de escritura, así que priorice las columnas que aparecen en predicados importantes.
Particione de forma gruesa: Las particiones por fecha o categoría suelen ser más fáciles de gestionar que las claves de alta cardinalidad que crean recuentos de directorios excesivos.
Compacte los archivos pequeños: Una tabla con muchos objetos Parquet diminutos puede tener un rendimiento deficiente, incluso cuando cada archivo está bien formado individualmente.
La compresión debe adaptarse a la carga de trabajo. Snappy es una opción razonable orientada a la velocidad. ZSTD es útil cuando la reducción del almacenamiento es importante y se dispone de capacidad de CPU. GZIP puede seguir siendo adecuado para la compatibilidad con sistemas heredados, pero rara vez es la primera opción para la analítica interactiva cuando se admiten códecs más rápidos.
Parquet no es una buena solución para todos los conjuntos de datos. Una pequeña tabla de referencia de menos de unos pocos megabytes puede ser más fácil de distribuir como CSV o de almacenar en una base de datos pequeña. El formato demuestra su valía cuando los escaneos analíticos repetidos, la selección de columnas, la compresión y el procesamiento distribuido compensan el coste de las herramientas binarias y la gestión de archivos.
Consideraciones de gobernanza e IA
Aplique los esquemas en el momento de la escritura, registre las versiones del escritor y del lector, y pruebe archivos representativos en los motores que utilizan sus consumidores. Utilice Iceberg o Delta Lake cuando necesite transacciones a nivel de tabla, instantáneas y evolución gestionada del esquema. Parquet sigue siendo una capa útil de intercambio físico entre los pipelines de entrenamiento y los almacenes de características, pero no debe confundirse con un sistema de gobernanza completo.
Para los equipos que operan muchos conjuntos de datos Parquet, la Observability debe cubrir algo más que la existencia de archivos. Supervise los cambios de esquema, los tiempos de entrega, la validación de registros y las métricas de negocio para que un archivo técnicamente legible no se vuelva analíticamente poco confiable. digna proporciona capacidades de calidad de datos en la base de datos, Timeliness, anomalías, validación, seguimiento de esquemas y Observability de la plataforma que se pueden aplicar mientras los datos permanecen en el entorno del cliente.
Regla de trabajo: Optimice el diseño del archivo para los filtros que ejecutan sus usuarios, luego valide el resultado en cada motor que sea importante.
Si su lago contiene archivos Parquet pero no puede realizar un seguimiento sencillo de la desviación del esquema, las llegadas tardías o el comportamiento cambiante de los datos, visite digna para ver cómo la Observability en la base de datos puede supervisar esos riesgos dentro de su propio entorno. Comience con el módulo que coincida con su problema de confiabilidad inmediato, luego expándalo a medida que crezcan sus cargas de trabajo de análisis e IA.
Preguntas frecuentes
¿Qué es Parquet?
Un formato de archivo columnar para datos analíticos. La idea clave es la organización física: los valores de una misma columna se guardan juntos, de modo que el motor de consulta puede leer solo las columnas que toca el cálculo en lugar de analizar filas enteras por todo el archivo.
¿Por qué Parquet es más rápido que CSV para analítica?
Por lo que puede saltarse. Una media agrupada sobre un CSV grande obliga al motor a analizar filas e inspeccionar campos que el cálculo nunca usa, mientras que el diseño columnar permite leer solo las columnas implicadas, y el almacenamiento tipado y comprimido reduce además los bytes movidos.
¿Dónde encaja Parquet en un stack moderno?
Como capa física de ficheros. Es un formato de aterrizaje eficiente durante la ingesta, el formato de archivo central en el almacenamiento de objetos y la capa bajo formatos de tabla como Iceberg o Delta Lake, y sigue siendo legible directamente por muchos motores analíticos.
¿Qué cargas de trabajo le sientan mejor?
Se repiten cuatro: lagos de datos en la nube donde se consultan ficheros en object storage sin cargar cada campo, tablas de hechos analíticas escaneadas por Spark, Trino o Presto, exportaciones operativas que publican una copia analítica, y características de machine learning intercambiadas como ficheros tipados y comprimidos en vez de CSV o JSON reanalizados una y otra vez.
¿Es Parquet un formato de sistema de origen?
No, suele ser un destino de exportación más que el lugar donde nacen los datos. Las aplicaciones, las API y las bases operativas siguen siendo los sistemas de origen, y Parquet se convierte en la copia analítica que esos sistemas publican para que la consuman motores de consulta, BI y ML.



