Data Observability para ingenieros de datos: Una guía práctica
|
7
minuto de lectura

Un pipeline por lotes (batch) puede terminar en verde mientras el panel de control que alimenta ya es incorrecto. La carga puede contener solo una parte de los datos esperados, un sistema ascendente puede haber agregado una columna que cambia una transformación, o la última partición puede tener horas de retraso. El monitoreo de infraestructura informa una ejecución exitosa, mientras que los analistas y los sistemas de aprendizaje automático consumen resultados obsoletos o corruptos.
Esa brecha es donde la Data Observability para ingenieros de datos se gana su lugar. Examina el comportamiento de los datos que se mueven a través de almacenes, lagos, flujos y transformaciones, y luego conecta las anomalías con la propiedad, el impacto y la respuesta. El desafío práctico no es recopilar cada señal posible. Es construir la cobertura suficiente para detectar fallas significativas sin mover datos sensibles fuera de su entorno ni sepultar a los ingenieros en alertas.
Tabla de contenidos
Por qué los ingenieros de datos necesitan Observability más allá del monitoreo de pipelines
Sistemas de monitoreo y datos de monitoreo
Los cinco pilares y su valor práctico
Instrumentación de los cuatro SLI principales que todo pipeline necesita
1. Tasa de éxito del trabajo
2. Latencia de frescura
3. Completitud y volumen
4. Conformidad del esquema
Resolviendo el problema de la fatiga por alertas que socava la Observability
Diseñar alertas en torno a decisiones
Medir la calidad de la detección, no el volumen de notificaciones
Implementación de Observability en entornos regulados y locales (On-Premises)
Una secuencia de despliegue que sobrevive a la revisión de seguridad
Los entornos heterogéneos necesitan un contrato común
Elección de la estrategia de alerta adecuada para su pila de datos
Cuando las reglas simples ganan
Cuando los métodos adaptativos ayudan
Integración de la Observability en su arquitectura de pipeline existente
Coloque controles donde respondan a una pregunta
Comenzar poco a poco y escalar su implementación de Observability
Por qué los ingenieros de datos necesitan Observability más allá del monitoreo de pipelines
A las 9:00 a.m., un panel de orquestación muestra un trabajo nocturno exitoso. La tarea del almacén se completó, los reintentos se mantuvieron en cero y el clúster de cómputo se mantuvo saludable. Hacia el final de la mañana, finanzas nota que a un panel de ingresos le faltan transacciones recientes. Un modelo entrenado en la misma tabla también ha comenzado a producir resultados inestables.
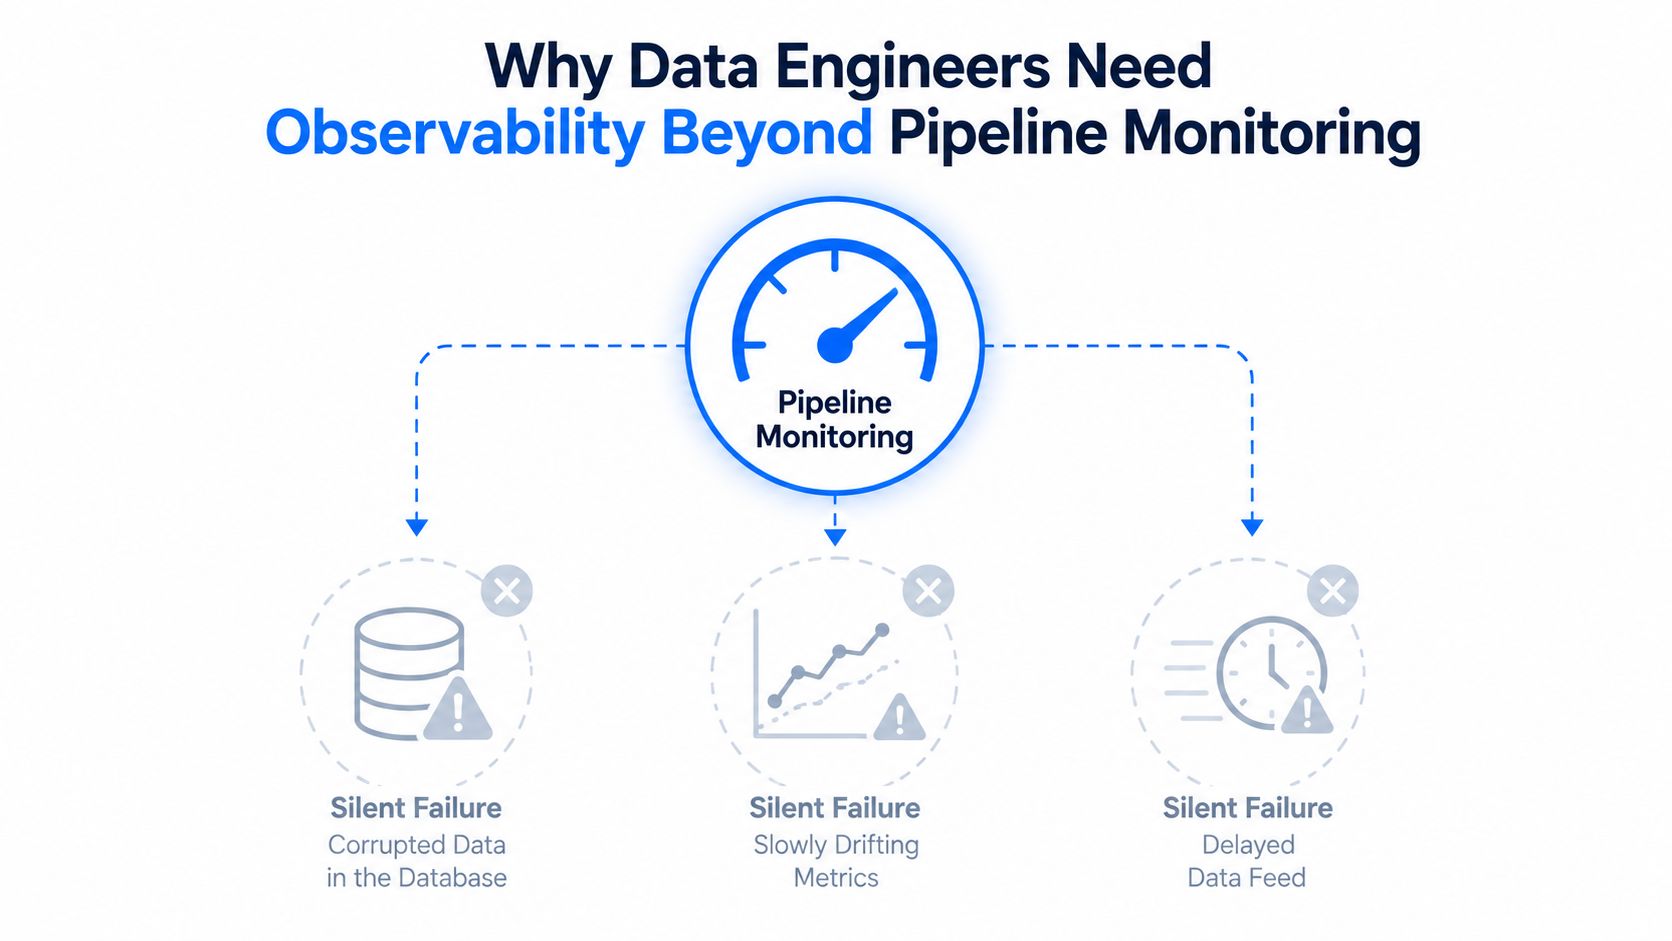
El pipeline no falló en el sentido convencional. Entregó una partición parcial y marcó el trabajo como completo. Una unión (join) aguas abajo excluyó registros, y la tabla resultante parecía lo suficientemente válida estructuralmente como para que los paneles de control se cargaran. El monitoreo tradicional vio un sistema disponible. No vio datos poco confiables.
Sistemas de monitoreo y datos de monitoreo
El monitoreo de pipelines sigue siendo importante. La tasa de éxito de los trabajos, el comportamiento de los reintentos, la duración de las tareas, la salud del ejecutor y la capacidad de la infraestructura ayudan a los ingenieros a identificar fallas operativas. Pero esas señales responden a si se ejecutó un proceso, no a si el resultado es completo, oportuno, estructuralmente consistente o se comporta normalmente.
La Data Observability agrega la inspección de los datos mismos. Combina señales técnicas con contexto como linaje, propietarios, dependencias aguas abajo y criticidad comercial. La distinción es similar a la diferencia entre verificar que un camión de reparto salió del almacén y verificar si el paquete contiene los artículos correctos y llegó antes de que el cliente lo necesitara.
Un punto de partida útil es la comparación digna de data observability y calidad de datos, porque las reglas de calidad y la observabilidad resuelven problemas relacionados pero diferentes. Las pruebas deterministas imponen expectativas conocidas. La observabilidad ayuda a exponer cambios inesperados que nadie pensó en codificar como una prueba.
Los cinco pilares y su valor práctico
La mayoría de los modelos de Data Observability utilizan cinco pilares, frescura, distribución, esquema, linaje y volumen, como se describe en la descripción general de data observability de Databricks.
Frescura muestra si los datos llegaron dentro de su cronograma esperado. Importa más para paneles operativos, informes regulatorios y procesos que dependen de registros actuales.
Volumen compara la cantidad de datos con el comportamiento normal. Puede exponer cargas incompletas, ingesta duplicada, filtros rotos e interrupciones aguas arriba.
Esquema realiza un seguimiento de las columnas, los tipos de datos y los cambios estructurales. Se vuelve crítico cuando los sistemas de origen evolucionan independientemente de los consumidores del almacén.
Distribución analiza el comportamiento de los valores, incluidos los patrones nulos, los rangos, la unicidad y otras características del conjunto de datos. Puede detectar un flujo semánticamente roto que todavía tiene las columnas y el recuento de filas correctos.
Linaje conecta un incidente con los activos y equipos afectados. Sin él, los ingenieros pasan el tiempo de respuesta buscando propietarios y dependencias aguas abajo.
Un almacén regulado puede priorizar el esquema y el linaje porque un cambio estructural no controlado puede afectar la evidencia de los informes. Una plataforma de streaming puede enfatizar la frescura y la distribución porque los eventos retrasados o anormales pueden distorsionar las decisiones operativas rápidamente. La implementación correcta no trata a cada pilar por igual. Brinda una cobertura más profunda a los productos de datos cuya falla conlleva un mayor impacto comercial o de Compliance.
Para un contexto industrial más amplio, la etiqueta de observabilidad en el comercio electrónico es útil para ver cómo aparecen los problemas de confiabilidad fuera de la ingeniería de la plataforma principal. La lección de producción es sencilla: mantenga el monitoreo de la infraestructura y luego agregue señales a nivel de datos donde un estado verde del pipeline aún pueda ocultar un mal resultado.
Instrumentación de los cuatro SLI principales que todo pipeline necesita
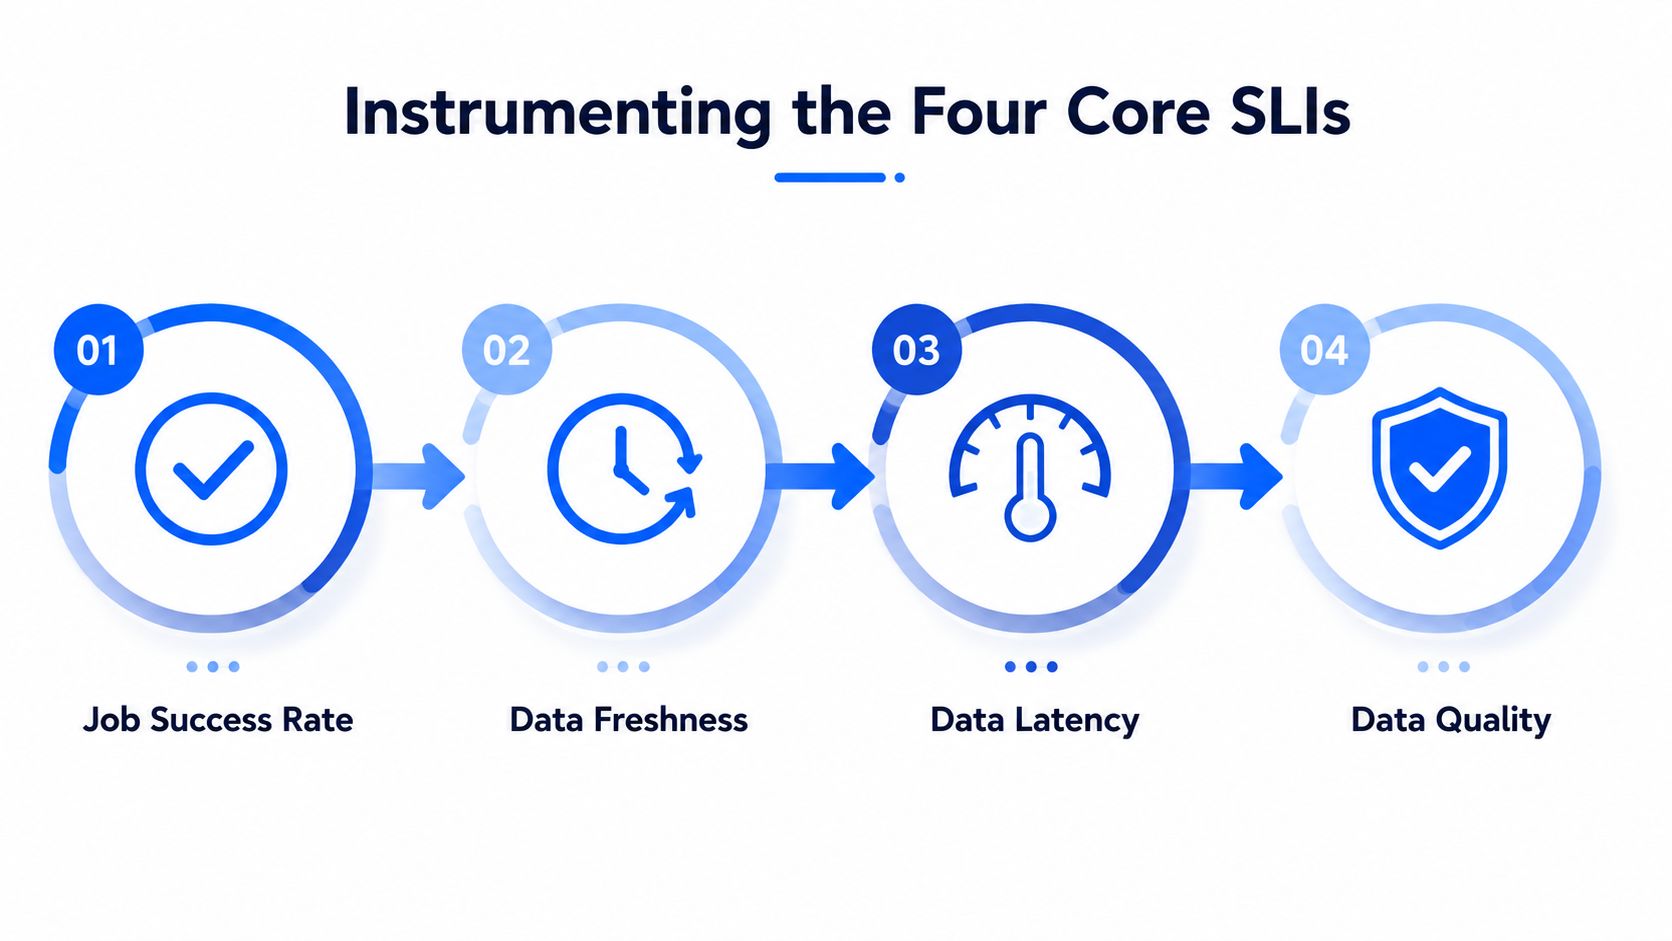
Un despliegue práctico de observabilidad puede comenzar con cuatro indicadores de nivel de servicio, o SLI, en cada pipeline crítico: tasa de éxito del trabajo, latencia de frescura, completitud o volumen, y conformidad del esquema. Estas señales cubren la ejecución, el tiempo, la cantidad y la estructura sin requerir un programa de monitoreo elaborado desde el primer día.
1. Tasa de éxito del trabajo
Realice un seguimiento de las ejecuciones completadas, fallidas, reintentadas, omitidas y con tiempo de espera agotado. Una proporción de éxito simple es útil, pero no se detenga en un estado binario. Registre la ruta de ejecución, la duración, el estado de la dependencia y si el trabajo produjo el resultado esperado.
Para sistemas por lotes, emita un evento de finalización solo después de que la partición de destino haya sido confirmada y validada. Para sistemas de streaming, distinga la actividad del proceso del progreso útil. Un consumidor puede permanecer conectado mientras el retraso (lag) crece o se acumulan registros malformados.
2. Latencia de frescura
La frescura mide el tiempo transcurrido desde la última actualización exitosa o el retraso entre la entrega esperada y la real. Para conjuntos de datos críticos, los equipos a menudo expresan la métrica como una latencia p95 o p99, lo que evita que un pequeño número de registros rápidos enmascare una larga cola de llegadas retrasadas. La guía de la industria sobre el monitoreo de la frescura también enmarca la verificación frente a la cadencia de ingesta esperada.
Los pipelines por lotes deben registrar el tiempo programado, el tiempo de llegada y el tiempo de disponibilidad exitosa. Los sistemas de streaming deben realizar un seguimiento del retraso del tiempo del evento y del retraso del tiempo de ingesta por separado, ya que un consumidor en vivo aún puede procesar eventos tardíos.
Utilice el comportamiento histórico como contexto en lugar de aplicar un umbral universal único. Una línea de base práctica compara la misma hora del día de las 2 a 4 semanas anteriores, como se describe en la guía de Streamkap para la observabilidad de streaming. Para una alerta crítica, el punto de partida estadístico recomendado es de 3 desviaciones estándar de la línea de base, mientras que una advertencia puede usar 2 desviaciones estándar. Esos valores pertenecen a una política que también considera los compromisos de entrega y las consecuencias aguas abajo.
3. Completitud y volumen
Compare los recuentos de registros esperados con los reales, particiones, archivos o ventanas de eventos. Un lote diario puede necesitar una partición esperada y un rango de registros mínimo. Un flujo puede necesitar mantener el rendimiento de eventos y evitar brechas inexplicables en las ventanas de tiempo.
Los recuentos por sí solos no son suficientes. Vincúlelos con verificaciones de duplicados, monitoreo de tasa de nulos y cobertura de particiones para que una carga duplicada no parezca completa. Las anomalías de volumen a menudo llegan antes de que un panel de control se rompa visiblemente, lo que las convierte en valiosos indicadores tempranos en lugar de meros diagnósticos posteriores al incidente.
4. Conformidad del esquema
Mida el porcentaje de filas que pasan la validación estructural, luego realice un seguimiento de los cambios en los nombres de las columnas, los tipos, la nulabilidad y el anidamiento. La deriva del esquema incluye columnas agregadas, columnas eliminadas y cambios de tipo de datos, como se documenta en la explicación de Ataccama sobre el seguimiento de esquemas.
Mantenga la verificación cerca del límite de origen y nuevamente antes de las capas de consumo de alto valor. Esa colocación ayuda a distinguir un cambio de contrato aguas arriba de un defecto de transformación. Almacene la versión del esquema observado con cada ejecución para que los encargados de responder puedan comparar el primer resultado incorrecto con el cambio que lo precedió.
Regla práctica: Primero la línea de base, segundo la alerta. Un umbral sin contexto histórico pasa por alto la deriva gradual o crea ruido durante los ciclos operativos normales.
Para los equipos que definen las métricas de entrega con precisión, esta guía sobre definiciones de puntualidad de datos y métricas de monitoreo proporciona un vocabulario útil para separar los retrasos de llegada, procesamiento y disponibilidad.
Resolviendo el problema de la fatiga por alertas que socava la Observability
Más controles pueden empeorar la confiabilidad cuando nadie confía en las notificaciones. Un informe de observabilidad empresarial de 2025 reveló que solo se utilizó el 13% de los datos de telemetría, lo que significa que el problema central no siempre es la falta de visibilidad. Puede ser un exceso de señales que nunca se convierten en decisiones operativas, como se informó en la cobertura reciente de observabilidad empresarial.
El error es tratar cada desviación como un incidente. Un pequeño cambio de distribución en una tabla exploratoria no debería alertar al mismo equipo, ni utilizar la misma ruta de escalada, que los datos obsoletos que alimentan los informes regulatorios. Los ingenieros necesitan una forma de clasificar las señales por impacto, confianza y propiedad.
Diseñar alertas en torno a decisiones
Cada alerta debe responder a cuatro preguntas:
¿Qué cambió? Identifique el conjunto de datos, campo, partición o pipeline.
¿Qué tan inusual es? Muestre la línea de base, el valor observado y la confianza.
¿Quién es el propietario de la respuesta? Dirija la notificación a un equipo designado o propietario del servicio.
¿Qué podría verse afectado? Incluya el linaje y el proceso comercial que depende del activo.
Una alerta útil podría indicar que una tabla crítica llegó fuera de su patrón de entrega normal, identificar la partición faltante, mostrar la dependencia de informes aguas abajo y señalar el trabajo de ingesta responsable. "Anomalía de volumen detectada" no es un flujo de trabajo de incidentes. Es una invitación a comenzar una investigación manual.
Los umbrales estadísticos ayudan a reducir el alertamiento arbitrario. Utilice 3 desviaciones estándar para alertas críticas y 2 para alertas de advertencia cuando el comportamiento histórico sea estable, luego suprima las notificaciones duplicadas mientras un incidente permanezca abierto. Para datos estacionales, escasos o que cambian rápidamente, una línea de base aprendida puede superar a una regla fija, pero aún necesita un propietario y una política de severidad consciente del negocio.
Medir la calidad de la detección, no el volumen de notificaciones
El tiempo medio de detección suele ser la medida de confiabilidad más reveladora porque los equipos solo pueden resolver un problema después de saber que existe. Un estudio de la industria de 2026 informó que los equipos de datos promediaron 67 incidentes por mes, con un 68% que necesitó más de 4 horas para detectar problemas y un promedio de 15 horas para resolverlos, según la cobertura de la encuesta de Integrate.io. La implicación operativa es clara: reducir el retraso en la detección puede crear más valor que agregar otro panel de control.
Realice un seguimiento de las alertas ruidosas que no requirieron ninguna acción, las alertas sin propietario asignado, las alertas repetidas para una sola causa raíz y los incidentes descubiertos primero por los usuarios comerciales. Luego, ajuste los umbrales, consolide las señales relacionadas y elimine los controles que no cambien una decisión.
Un panel de calidad de datos enfocado debería ayudar a quienes responden a ver tendencias e incidentes no resueltos, no simplemente mostrar un gran inventario de controles. El programa de observabilidad más sólido no es el que tiene más alertas. Es en el que los ingenieros confían lo suficiente como para actuar.
Implementación de Observability en entornos regulados y locales (On-Premises)
Un diseño que prioriza SaaS a menudo asume que los metadatos y las muestras pueden moverse libremente a un servicio externo. Esa suposición falla en los servicios financieros, la atención médica, las telecomunicaciones y los entornos del sector público donde la residencia de datos, la auditabilidad, el control de acceso y la revisión de seguridad dan forma a cada decisión arquitectónica.
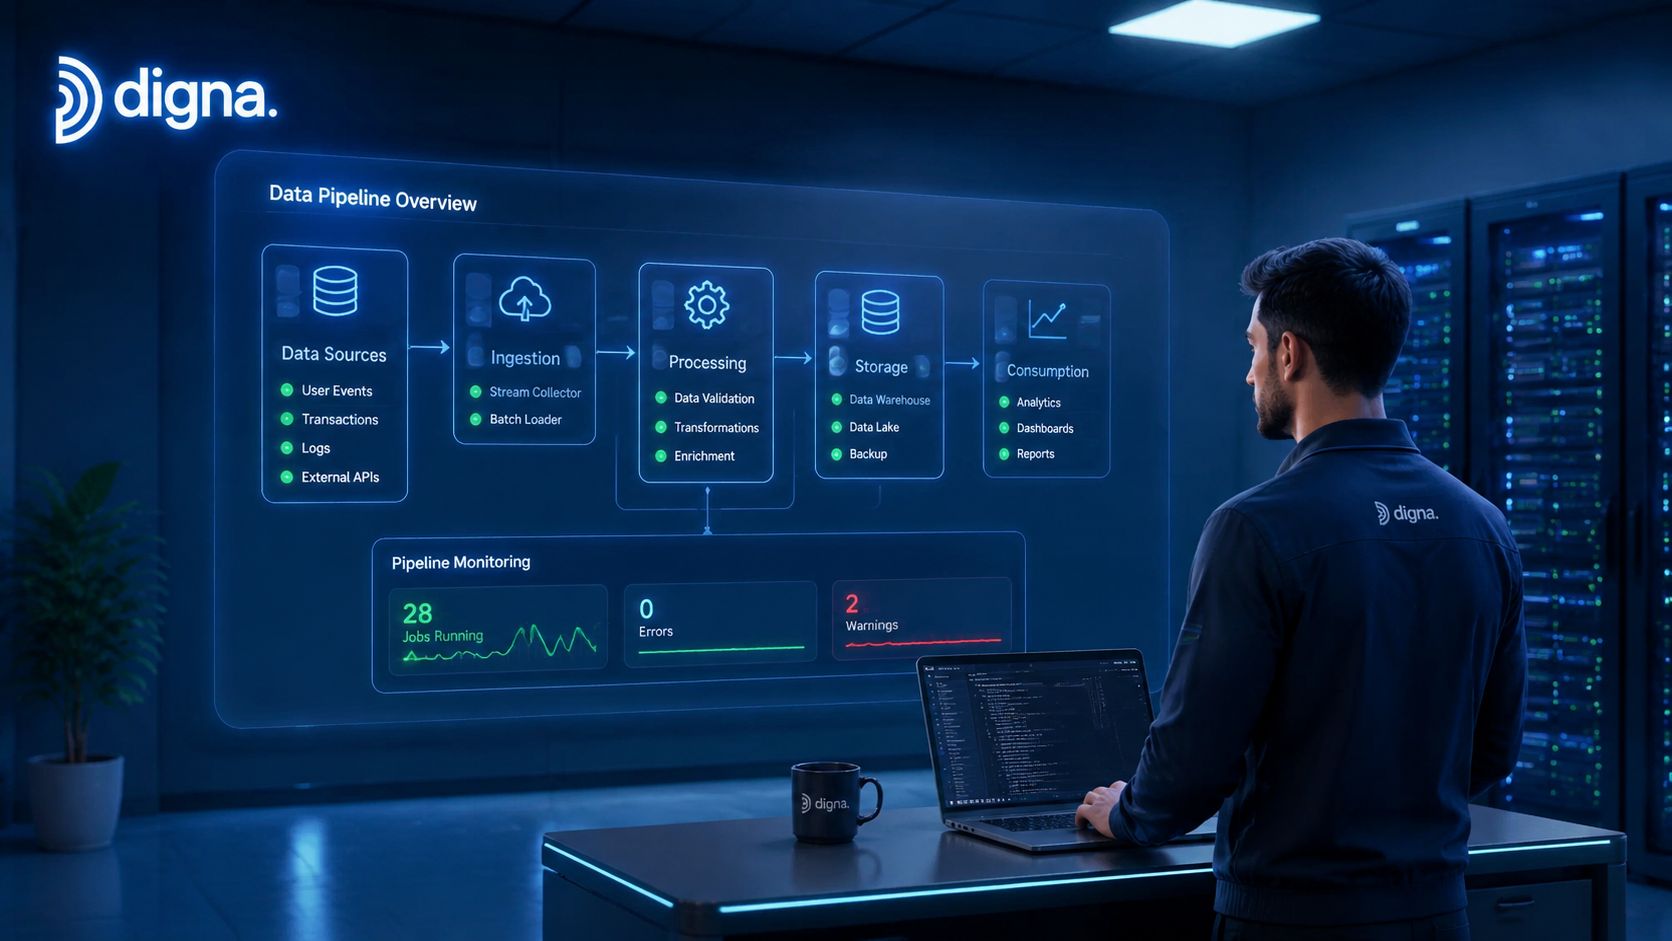
El patrón de implementación en el que confío en estos entornos mantiene los datos de producción dentro del límite del cliente. La ejecución en la base de datos calcula las métricas donde ya viven los datos, mientras que la capa de observabilidad recibe metadatos permitidos, resultados de métricas y contexto de incidentes en lugar de registros de producción sin restricciones.
Una secuencia de despliegue que sobrevive a la revisión de seguridad
Comience con el diagrama de flujo de datos. Documente dónde se ejecutan los controles, qué sale de la base de datos, qué cuenta de servicio los ejecuta y dónde se almacenan los resultados. Los equipos de seguridad pueden revisar un flujo específico de manera más efectiva que una promesa de que un producto es "seguro".
Separe el cálculo de métricas de los datos de investigación. Los recuentos de filas, las marcas de tiempo de frescura, las huellas digitales del esquema y las métricas de calidad agregadas pueden ser suficientes para la detección. Las muestras a nivel de registro deben ser opcionales, estar enmascaradas o prohibidas cuando la política lo requiera.
Utilice límites de despliegue privados. Una instalación de nube privada o local puede ejecutarse dentro de la VPC, la cuenta de la nube o el centro de datos del cliente. Mantenga los conectores, programadores, almacenes de metadatos e interfaces de usuario dentro de las zonas de red aprobadas.
Haga que la evidencia de auditoría sea parte del diseño. Almacene definiciones de controles, tiempos de ejecución, resultados observados, acuses de recibo, cambios de propiedad e historial de remediación. Los auditores generalmente necesitan establecer qué se controló, cuándo se ejecutó, qué sucedió y quién respondió.
Los equipos también deben documentar explícitamente las decisiones de residencia. La guía de requisitos de residencia de datos es una referencia útil al decidir qué metadatos pueden cruzar los límites regionales u organizativos.
Los entornos heterogéneos necesitan un contrato común
Las bases de datos heredadas, las plataformas de almacenamiento, el almacenamiento de lagos, los temas de Kafka y las herramientas de transformación rara vez exponen metadatos idénticos. Estandarice la salida de observabilidad en lugar de forzar a cada origen a utilizar el mismo método de instrumentación. Cada integración debe publicar la identidad del activo, el tiempo de actualización, el resultado de volumen o completitud, el estado del esquema, el estado del control, el propietario y las referencias de linaje.
Las cuentas de servicio con privilegios mínimos, el acceso de solo lectura siempre que sea posible, los identificadores enmascarados y las credenciales independientes por entorno reducen el radio de impacto del propio sistema de monitoreo. Pruebe la implementación frente a escenarios de respaldo, conmutación por error y red desconectada antes del despliegue en producción.
El equilibrio es real. Los controles en la base de datos pueden consumir recursos del almacén, mientras que el escaneo externo puede simplificar la incorporación pero crear fricciones de governance. Mida el costo de las consultas, programe los análisis costosos fuera de las horas pico de carga de trabajo y use controles de metadatos livianos de manera continua con una validación más profunda en los activos críticos.
Elección de la estrategia de alerta adecuada para su pila de datos
La estrategia de alerta debe seguir el comportamiento de los datos, no la moda de las herramientas. Los umbrales estáticos son fáciles de explicar y auditar. Las líneas de base estadísticas se adaptan a la variación normal. El aprendizaje automático puede reducir la creación manual de reglas, pero introduce un comportamiento del modelo que los equipos de cumplimiento y plataforma pueden querer inspeccionar. La validación determinista sigue siendo esencial siempre que se deba hacer cumplir exactamente una regla comercial.
Estrategia | Ideal para | Limitaciones | Complejidad de implementación |
|---|---|---|---|
Umbrales estáticos | Recuentos predecibles, límites estrictos, ventanas de entrega contractuales | Se rompen ante la estacionalidad, el crecimiento y la deriva gradual | Baja |
Líneas de base estadísticas | Comportamiento de volumen, frescura y distribución específico del conjunto de datos | Necesitan suficiente contexto histórico y un ajuste cuidadoso | Media |
Detección de anomalías por aprendizaje automático | Patrones complejos, comportamiento cambiante y amplia cobertura | Requiere explicabilidad, governance y revisión de falsos positivos | Media a alta |
Validación de registros determinista | Controles regulatorios, reglas comerciales y requisitos exactos a nivel de fila | No puede identificar patrones desconocidos sin reglas definidas | Media |
Cuando las reglas simples ganan
Utilice una regla estática cuando la condición de falla sea inequívoca. Una partición requerida que no ha llegado, un tipo de datos prohibido o un campo que debe cumplir con una restricción comercial definida deben producir un resultado determinista. Estas comprobaciones son más fáciles de probar, explicar a los auditores y reproducir durante la revisión de incidentes.
Los umbrales estáticos también funcionan bien para flujos estables de alto volumen con límites operativos claros. Se vuelven frágiles cuando el comportamiento normal cambia por hora, temporada, segmento de clientes o ciclo de vida del producto. Un único umbral global a menudo crea falsos positivos durante picos legítimos y pasa por alto la degradación lenta.
Cuando los métodos adaptativos ayudan
Las líneas de base estadísticas son útiles cuando cada conjunto de datos tiene su propio ritmo. Compare lo similar con lo similar, como la misma hora o ventana de entrega, y conserve el contexto histórico que llevó a la alerta. El aprendizaje automático puede extender este enfoque a muchos activos, pero los ingenieros aún deben exigir un código de motivo, una visualización de la línea de base y un proceso de anulación.
El diseño más defendible combina métodos. Utilice la detección de anomalías para una amplia cobertura de frescura, volumen y distribuciones. Agregue controles deterministas para campos regulatorios, requisitos contractuales y lógica de registros crítica para el negocio. Dirija ambos a través del mismo flujo de trabajo de incidentes para que quienes responden no tengan que conciliar sistemas de alerta separados.
Una capa de monitoreo e informes debe exponer no solo si un control falló, sino también su tendencia, propietario, gravedad y relevancia aguas abajo. Las capacidades de monitoreo e informes de digna representan un ejemplo de ese modelo operativo combinado, junto con herramientas creadas en torno a pruebas dbt, aserciones de almacén o controles de orquestación personalizados.
Integración de la Observability en su arquitectura de pipeline existente
La observabilidad no debería requerir una reconstrucción. El patrón más seguro agrega mediciones en los límites que ya existen, luego envía los resultados a un flujo de trabajo compartido de incidentes y metadatos sin bloquear cada tarea en cada control.

En Airflow, emita metadatos de ejecución y finalización de las tareas de DAG, luego ejecute controles de frescura y completitud después de que se confirme la partición de destino. En dbt, retenga los resultados de las pruebas y los tiempos de los modelos como eventos de observabilidad de primer nivel. Los trabajos de Spark pueden publicar recuentos de entrada y salida, recuentos de registros rechazados, huellas digitales de esquemas y detalles de partición. Los consumidores de Kafka deben exponer el retraso (lag), el retraso del tiempo del evento, las tasas de registros malformados y el comportamiento del volumen a nivel de tema.
Coloque controles donde respondan a una pregunta
Utilice controles síncronos cuando continuar crearía un riesgo inaceptable aguas abajo. Un control de conformidad de esquema antes de publicar un contrato compartido o un control de completitud antes de liberar un conjunto de datos regulatorio pueden bloquear razonablemente la siguiente etapa.
Utilice controles asíncronos para un perfilado más amplio y análisis de tendencias. Las métricas de distribución, las estadísticas de columnas y las comparaciones históricas pueden ejecutarse junto al camino crítico, siempre que la alerta resultante tenga un proceso de contención claro. Esto evita convertir cada control analítico en un cuello de botella del pipeline.
El manejo del esquema merece una política explícita. Clasifique las columnas agregadas, las columnas eliminadas y los cambios de tipo de datos como compatibles, que requieren revisión o de ruptura. No falle automáticamente cada cambio aditivo, pero no acepte una modificación del tipo de datos sin revisión, ya que puede cambiar la forma en que los consumidores aguas abajo interpretan los valores.
El linaje debe capturarse en los límites de transformación, no reconstruirse durante un incidente. Almacene las relaciones de origen a destino para tareas de Airflow, modelos dbt, transformaciones de Spark y temas de streaming, luego adjunte controles a los activos que describen.
Principio de diseño: La observabilidad debería hacer que el pipeline sea más fácil de operar, no convertirse en otra dependencia que pueda detenerlo innecesariamente.
Finalmente, utilice los resultados de la observabilidad para mejorar la arquitectura. Los retrasos repetidos en la frescura pueden exponer una ventana de extracción sobrecargada. Las anomalías de volumen persistentes pueden señalar contratos de origen débiles. Un patrón de incidentes de esquema puede justificar interfaces versionadas en lugar de más alertas.
Comenzar poco a poco y escalar su implementación de Observability
Monitorear todo el primer día crea un catálogo de controles antes de que el equipo sepa qué señales importan. Comience con un pipeline crítico, preferiblemente un activo que alimente informes ejecutivos, operaciones de clientes, trabajo regulatorio o un modelo de producción. Clasifique los candidatos por impacto comercial, historial de incidentes, profundidad de dependencia y la dificultad de detectar fallas manualmente.
Un despliegue por fases es más fácil de defender porque cada fase produce evidencia operativa.
Días 1–30: Mapee el pipeline seleccionado, identifique a los propietarios y consumidores aguas abajo, establezca SLI de frescura, éxito del trabajo, completitud y esquema, y registre la línea de base.
Días 31–60: Agregue validación a nivel de registro o distribución donde la primera fase revele riesgos. Ajuste los umbrales de advertencia y críticos, dirija las alertas a los equipos responsables y documente el flujo de trabajo de respuesta.
Días 61–90: Revise los incidentes y casi accidentes, elimine los controles ruidosos, agregue contexto de linaje, mida el tiempo medio de detección y seleccione el siguiente pipeline en función del riesgo demostrado en lugar del entusiasmo.
Mida los resultados que cambian las decisiones de ingeniería. El tiempo medio de detección muestra si el equipo se entera de las fallas antes. El volumen de incidentes y las causas raíces repetidas revelan si el monitoreo está reduciendo la carga operativa. Las fallas aguas abajo evitadas demuestran valor para los analistas, las partes interesadas de cumplimiento y los propietarios de negocios.
La adopción también depende de la propiedad. Asigne a cada conjunto de datos crítico un propietario técnico, defina quién puede reconocer o suprimir una alerta y exija un motivo cuando se deshabilite un control. Revise los falsos positivos después de los incidentes, no solo durante un ejercicio anual de herramientas.
digna puede respaldar este modelo por fases con ejecución en la base de datos, despliegue en la nube privada o local, detección de anomalías, monitoreo de puntualidad, validación a nivel de registro y seguimiento de esquemas. Si su entorno no puede mover datos de producción a una plataforma SaaS, evalúe si la arquitectura preserva ese límite al tiempo que brinda a los ingenieros un contexto de incidentes utilizable.
Utilice los primeros 90 días para instrumentar un pipeline crítico para el negocio, establecer líneas de base confiables y medir la calidad de la detección antes de expandir la cobertura. Para evaluar un enfoque dentro del entorno para sus almacenes, lagos y flujos de datos regulados, visite digna y explore cómo su plataforma de observabilidad modular puede adaptarse a su arquitectura existente.
Preguntas frecuentes
¿Qué añade la observabilidad a la monitorización de canalizaciones?
La inspección del dato en sí. La monitorización de canalizaciones sigue importando, porque dice si los trabajos se ejecutaron y la infraestructura aguantó, pero no puede decir que un lote acabó en verde mientras el panel que alimenta ya está equivocado.
¿Cuáles son los cinco pilares?
Frescura, distribución, esquema, linaje y volumen. La frescura muestra si el dato llegó dentro de su calendario previsto, el volumen compara la cantidad con el comportamiento normal, el esquema sigue columnas y tipos, la distribución observa patrones de nulos, rangos y unicidad, y el linaje conecta un incidente con los activos y equipos afectados.
¿En qué se diferencia de las reglas de calidad de datos?
Resuelven problemas emparentados pero distintos. Las reglas codifican condiciones que alguien ya supo escribir; la observabilidad describe comportamientos que nadie especificó de antemano, y por eso un equipo que solo tiene una de las dos se lleva sorpresas siempre en la misma dirección.
¿Cómo se ve una canalización que falla sin fallar?
Como un panel de orquestación que a las 9:00 muestra un trabajo nocturno correcto mientras los datos que produjo están mal. La canalización no falló en el sentido convencional, y justo por eso la monitorización de estado informó de éxito.
¿Por dónde debe empezar un ingeniero?
Por los conjuntos cuyo comportamiento sería más difícil de reconstruir a posteriori. Instrumentarlos primero aporta el linaje y el historial que convierten el próximo incidente en una investigación breve y no en un ejercicio de arqueología.