Archivo Parquet: arquitectura, rendimiento y uso
|
10
minuto de lectura

Probablemente estés en una de dos situaciones. O eliges formato de almacenamiento para un conjunto nuevo y todas las opciones suenan vagamente «optimizadas», o ya tienes Parquet en producción y tu problema no es leerlo, sino entender por qué un conjunto va rápido, otro va lento y un tercero de pronto no se abre.
Ahí es donde se queda corta la mayoría del contenido sobre Parquet. Explica el camino feliz. Dice que Parquet es columnar, comprimido y bueno para analítica, lo cual es cierto pero insuficiente cuando ajustas row groups, depuras subidas corruptas o decides si los nuevos tipos lógicos romperán la interoperabilidad entre motores.
Parquet importa porque está en el centro de las plataformas de datos modernas. Es el formato que muchos equipos usan como capa física bajo lagos de datos, lakehouses, feature stores, zonas de archivo e intercambio entre herramientas. Si entiendes la mecánica del archivo, tomas mejores decisiones sobre disposición, comportamiento de consulta, gobierno y gestión de fallos.
Índice de contenidos
Cómo el predicate pushdown y los page indexes aceleran las consultas
Compresión, codificación, particionado y evolución del esquema
Qué es un archivo Parquet y por qué importa
Un archivo Parquet es un formato de archivo columnar abierto creado para cargas analíticas. Empezó como un esfuerzo conjunto de código abierto entre Twitter y Cloudera, se publicó por primera vez como Parquet 1.0 en julio de 2013 y se convirtió en proyecto de primer nivel de la Apache Software Foundation el 27 de abril de 2015. Su diseño se apoyó en el troceado y ensamblado de registros al estilo Dremel, lo que lo hizo encajar de forma natural en la analítica a gran escala sobre lagos de datos en la nube, como se recoge en los antecedentes de Apache Parquet.
Ese origen importa porque las cargas analíticas no se comportan como los sistemas transaccionales. Los analistas rara vez recuperan un registro completo cada vez. Escanean muchas filas, tocan pocas columnas, filtran con dureza, agregan con más dureza y repiten ese patrón todo el día. Un formato orientado a filas como CSV obliga al motor a leer mucha información irrelevante solo para responder una pregunta sencilla.
Por qué el almacenamiento columnar cambia el perfil de coste
Supón que tu tabla tiene customer_id, event_date, country, device_type, revenue, campaign, browser y una docena de campos más. Si tu consulta solo necesita event_date y revenue, un formato por filas sigue arrastrando cada campo por la E/S y el parseo. Parquet no.
Esa es la victoria práctica. El almacenamiento columnar permite a los motores leer solo las columnas que necesitan, lo que recorta E/S y memoria desperdiciadas en trabajo analítico selectivo. Por eso Parquet se convirtió en la capa de intercambio por defecto entre herramientas que no comparten un mismo runtime.
Por qué los equipos confían en él en entornos con herramientas mixtas
Un archivo Parquet lleva su propio esquema y metadatos dentro de la estructura del archivo, así que viaja bien entre Spark, Hive, Pandas, DuckDB, Trino y motores cercanos al almacén. No siempre hace falta un catálogo externo solo para interpretar el contenido.
Regla práctica: si tu equipo espera que el mismo conjunto de datos pase entre motores de procesamiento, un formato autodescriptivo ahorra mucho código pegamento frágil.
Parquet se ha convertido en la práctica en el idioma común de almacenamiento del stack lakehouse. Si piensas en el diseño de plataforma de forma más amplia, esta es parte de la razón por la que importa tanto el cimiento de la plataforma de datos. El formato de archivo no es un detalle lateral. Determina cómo cada motor posterior lee, omite, valida y confía en tus datos.
Dentro de la arquitectura del archivo Parquet
La forma más limpia de entender un archivo Parquet es dejar de verlo como un bloque opaco y empezar a pensarlo como una pequeña biblioteca.
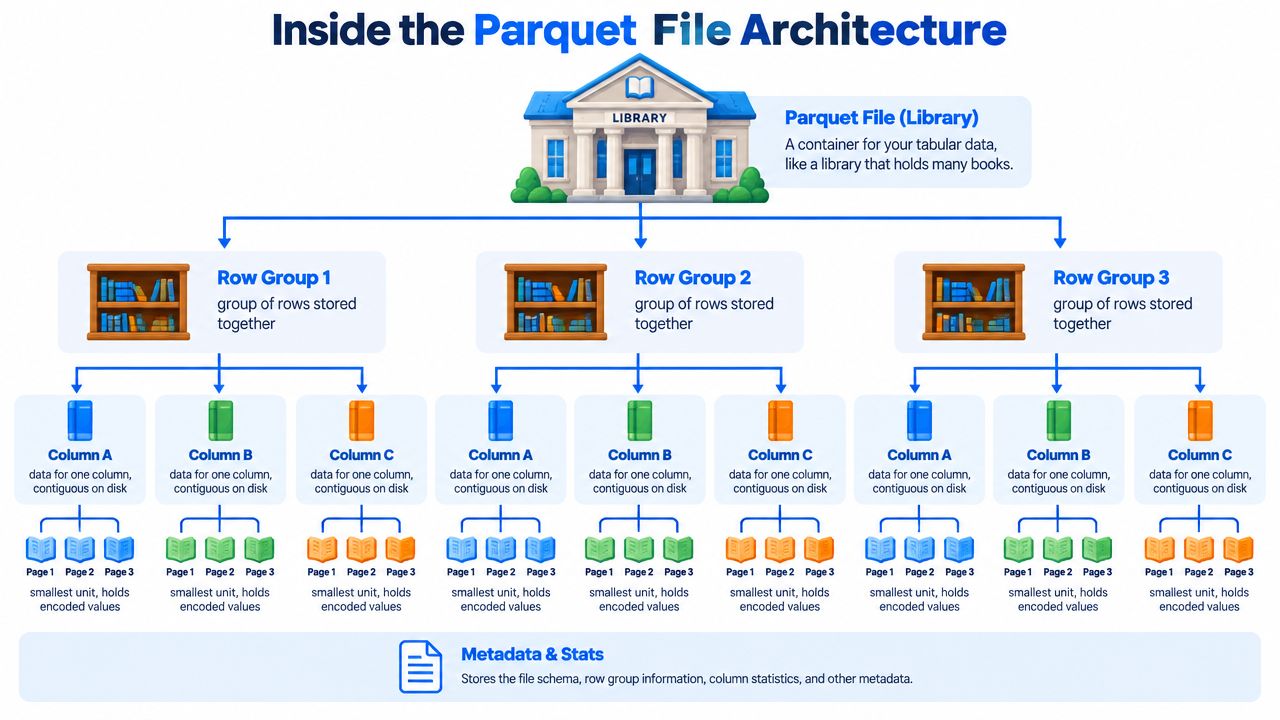
El archivo es el edificio. Dentro, los row groups son secciones de la biblioteca. Dentro de cada row group, cada column chunk es una estantería para una columna. Y cada column chunk contiene pages, las unidades menores que se leen secuencialmente del disco.
La documentación de conceptos de Apache lo expone directamente: un archivo contiene uno o más row groups, cada row group contiene exactamente un column chunk por columna, y cada column chunk contiene una o más pages. También señala que los column chunks son contiguos en el archivo, una de las razones por las que las lecturas columnares funcionan con eficiencia en la práctica, según la referencia de conceptos de Parquet.
La jerarquía que los lectores usan de verdad
Esa jerarquía no es académica. Los motores de consulta la usan constantemente.
El nivel de archivo da al lector un único objeto que abrir e inspeccionar.
El nivel de row group actúa como unidad práctica de escaneo paralelo.
El nivel de column chunk permite al motor extraer solo las columnas que pide la consulta.
El nivel de page es donde se almacenan y decodifican en secuencia los valores codificados.
Si has trabajado en arquitectura de sistemas de datos, esto te resultará familiar. Los sistemas eficientes suelen ser jerárquicos porque la jerarquía da puntos de parada a quien lee. Parquet ofrece esos puntos de parada en varias capas.
Qué hay en los extremos del archivo
Un archivo Parquet sano empieza y acaba con los bytes mágicos PAR1. Esa es una de las primeras comprobaciones de integridad que usan muchas herramientas. Si falta la marca final, el archivo puede estar truncado, incompleto o no ser Parquet en absoluto.
El pie, cerca del final del archivo, es donde vive buena parte de la inteligencia. Almacena el esquema, los metadatos de row group y los metadatos clave-valor. Por eso Parquet es autodescriptivo. Los lectores no tienen que adivinar la forma del conjunto.
Un archivo Parquet es fácil de leer cuando las páginas de datos están bien. Es fácil de diagnosticar cuando el pie está bien. Duele cuando el transporte rompió el archivo antes de que cualquiera de esas capas pudiera ayudar.
Cómo maneja Parquet los datos anidados
Parquet se diseñó en torno al troceado y ensamblado al estilo Dremel, que es como representa estructuras anidadas como structs, listas y mapas sin repetir nombres de campo en cada fila. El truco está en que el escritor descompone los registros anidados en piezas columnares y conserva suficiente información posicional para reconstruirlos después.
Esa información posicional se expresa habitualmente mediante definition levels y repetition levels. En términos llanos, esos niveles ayudan al lector a distinguir entre «este campo es nulo», «esta lista está vacía» y «este hijo anidado pertenece al mismo padre que el valor anterior». Si alguna vez has visto datos anidados releídos con nulos sorprendentes o formas que no cuadran, esta suele ser la maquinaria detrás.
Por debajo, las pages pueden usar codificaciones distintas según los datos y el comportamiento del escritor. En sistemas reales te encontrarás codificación plana, por diccionario, run-length, bit-packing, codificaciones tipo delta y byte stream split. Lo importante no es memorizar cada codificación. Es entender que Parquet guarda los valores en unidades de página compactas y codificadas, no como texto crudo fila a fila.
Cómo el predicate pushdown y los page indexes aceleran las consultas
Una consulta Parquet se vuelve rápida cuando el lector puede demostrar que gran parte del archivo es irrelevante antes de abrir las páginas de datos. Esa es la victoria. La compresión ayuda con los bytes en disco y en red. El predicate pushdown ayuda con algo más valioso en producción: menos lecturas, menos descompresiones y menos trabajo en el motor de ejecución.
El punto de partida son los metadatos del pie descritos en la documentación del formato de archivo Parquet. Junto al esquema y los detalles de disposición, Parquet puede guardar estadísticas por columna para cada row group, incluidos valores mínimos, máximos y recuentos de nulos. Los motores usan esas estadísticas para contrastar tu filtro con cada row group antes de escanear los datos de columna reales.
Un caso común lo hace concreto. Supón que tu consulta filtra por:
WHERE event_date BETWEEN '2026-01-01' AND '2026-01-31'
Si un row group tiene los límites de event_date enteramente en marzo, el motor puede descartarlo solo con los metadatos. Si otro row group cubre fechas de enero, ese grupo aún necesita más inspección. El resultado es simple:
Los row groups cuyos mínimo y máximo no pueden satisfacer el predicado se omiten.
Los row groups cuyo rango solapa el predicado siguen siendo candidatos.
Los grupos candidatos todavía requieren lecturas de página o comprobaciones de valor para confirmar coincidencias.
Suena directo, pero importan dos detalles de producción.
Primero, las estadísticas de row group solo son tan útiles como la disposición de los datos. Si los valores están agrupados por event_date, los rangos de mínimo y máximo son estrechos y la poda es afilada. Si el archivo se escribió a partir de datos muy barajados, cada row group puede abarcar un rango de fechas amplio y los metadatos pierden selectividad. El predicate pushdown sigue funcionando. Simplemente tiene menos con lo que trabajar.
Segundo, los row groups son una unidad gruesa. Funcionan como cajas en un almacén. Si la etiqueta dice que todo lo de la caja es de marzo, te saltas la caja entera. Si dice que la caja contiene de enero a marzo, tienes que abrirla aunque dentro solo puedan coincidir unos pocos registros de enero.
Ahí es donde importan los page indexes. Parquet admite metadatos opcionales a nivel de página mediante ColumnIndex y OffsetIndex, definidos en la especificación del page index de Parquet. ColumnIndex guarda los límites de página y la información de nulos de una columna. OffsetIndex mapea páginas a desplazamientos físicos y rangos de filas. Juntos dan al lector un mapa más fino dentro del row group.
El efecto práctico se pasa por alto fácilmente si solo lees tutoriales del camino feliz. Sin page indexes, un motor puede saber que un row group merece revisión y aun así leer muchas páginas dentro. Con page indexes, el motor puede omitir las páginas que no coinciden y acercarse a las que podrían satisfacer el filtro. En consultas selectivas sobre row groups grandes, eso recorta mucha E/S innecesaria.
Merece la pena tener clara la distinción:
Las estadísticas de row group deciden si leer un row group en absoluto.
Los page indexes deciden qué páginas dentro de ese row group merece la pena tocar.
Esto explica también por qué el ajuste de Parquet puede parecer inconsistente entre herramientas. El soporte de escritura de page indexes varía. El de lectura también. Un motor puede usarlos con agresividad. Otro puede ignorarlos y limitarse a la poda por row group. En 2026 esa brecha sigue apareciendo en pilas mixtas, sobre todo donde Spark, Trino, motores de almacén y lectores de Python tocan los mismos archivos.
Los filtros de Bloom pertenecen a la misma familia de funciones para ahorrar trabajo, pero resuelven un problema más estrecho. Pueden ayudar con pruebas de pertenencia en columnas de alta cardinalidad como user_id, suponiendo que el escritor los generara y el lector sepa usarlos. Cuando los equipos dicen «el pushdown de Parquet dejó de funcionar», la causa raíz no suele ser el formato. Es una de estas mecánicas: mala agrupación, estadísticas débiles, page indexes no soportados o un lector que cae en un escaneo completo.
Esa mentalidad diagnóstica importa más ahora porque los tipos lógicos nuevos, incluidos Variant, datos geoespaciales y el tipo FILE, amplían lo que los equipos meten en Parquet. A medida que los archivos llevan datos más complejos, la pregunta ya no es solo «¿puedo leer este archivo?». Es «¿qué partes de este archivo puede omitir mi motor con seguridad, y qué metadatos usa para decidirlo?».
Parquet frente a CSV, Avro y ORC
Elegir Parquet es más fácil cuando dejas de preguntar qué formato es «el mejor» y empiezas a preguntar qué patrón de acceso necesitas sostener.
CSV es universal y fácil de inspeccionar. También es flojo en esquema, tipado y lecturas selectivas. Avro está orientado a filas y suele encajar mejor cuando escribir y leer registros completos importa más que escanear unas pocas columnas. ORC es columnar como Parquet y sigue siendo fuerte en entornos muy orientados a Hive. Parquet queda en medio como el formato analítico más común entre motores.
Las concesiones de un vistazo
Formato | Disposición | Esquema | Compresión | Coste de escaneo | Coste de escritura | Mejor para |
|---|---|---|---|---|---|---|
Parquet | Columnar, organizado en row groups y column chunks | Embebido en el archivo | Fuerte, favorecida por la disposición columnar y la codificación | Bajo en consultas analíticas selectivas | Mayor que el texto plano y a menudo más trabajo que los formatos por filas simples | Analítica, lagos de datos, intercambio entre motores |
CSV | Texto plano orientado a filas | Ninguno integrado en el formato | Compresión externa posible, pero el archivo en sí es texto | Alto, porque los lectores deben parsear filas completas e inferir tipos | Muy bajo | Exportación sencilla e intercambio legible por personas |
Avro | Binario orientado a filas | Soporte fuerte de esquema | Codificación binaria compacta | Mejor para acceso por filas que para poda de columnas | Bueno para flujos con mucha escritura | Streaming, datos de eventos, lecturas a nivel de fila |
ORC | Columnar | Esquema y metadatos embebidos | Fuerte | Bajo en escaneos analíticos | Concesiones de diseño similares a Parquet | Analítica centrada en Hive y ecosistemas de tablas |
Cómo plantear la decisión
Usa CSV cuando la portabilidad y la inspección humana importen más que la eficiencia analítica. Sigue siendo la lengua franca del intercambio básico, pero los equipos pagan después esa comodidad con parseo, tipado débil y lecturas desperdiciadas.
Usa Avro cuando te importen la fidelidad de fila, la evolución del esquema en pipelines de eventos y los patrones con mucha escritura. Los sistemas conectados a Kafka acaban ahí por buenas razones.
Usa ORC cuando tu pila esté ligada al procesamiento estilo Hive y a comportamientos de tabla propios de ORC. Resuelve muchos de los mismos problemas que Parquet, pero el centro de gravedad es distinto.
Usa Parquet cuando la mayoría de cargas sean escaneos filtrados, proyecciones y agregación sobre grandes conjuntos. Es el formato que tiende a sobrevivir a los cambios de herramienta porque muchísimos lectores lo entienden.
Trabajar con Parquet en Spark, Hive y Pandas
Lo interesante de usar Parquet no es read_parquet() en sí. Es que distintos escritores dejan huellas distintas, y esas huellas afectan a las lecturas posteriores.
Spark, Hive y Pandas pueden trabajar con el mismo conjunto Parquet, pero no siempre lo escriben igual. Eso se nota en la disposición de row groups, el comportamiento de orden, la calidad de las estadísticas, la estructura de directorios de partición y la eficiencia con la que otro motor puede podar datos después.
Spark y los conjuntos particionados
En Spark el patrón habitual es directo: leer un DataFrame, transformarlo y escribir Parquet de vuelta al almacenamiento de objetos. Los equipos suelen combinarlo con partitionBy(...), que crea árboles de directorios estilo Hive como event_date=2026-01-01/. Esos directorios se convierten en columnas de partición virtuales al leer.
Es útil, pero también crea una trampa. A veces los equipos particionan de más y acaban con demasiados archivos pequeños. Cuando eso pasa, los metadatos del pie quedan fragmentados entre muchos objetos y la planificación de consultas se vuelve más ruidosa.
Si ya monitorizas la fiabilidad de Databricks o Spark, la monitorización de calidad de datos en Databricks se vuelve relevante, porque los errores de disposición suelen aflorar primero como comportamiento inconsistente en ejecución, no como errores claros de formato.
Hive y su camino maduro con Parquet
Hive lleva años soportando Parquet y en muchos entornos lo lee de forma nativa mediante las abstracciones de tabla habituales. El punto operativo importante es que una tabla Hive puede parecer «lógica», pero el rendimiento sigue viniendo de la disposición física de Parquet por debajo. Si los archivos están mal particionados o llevan estadísticas débiles, Hive no puede rescatar eso solo con metadatos.
Sorpresas con Pandas y PyArrow
Pandas suele llegar a Parquet mediante PyArrow o fastparquet. Con PyArrow, seleccionar columnas durante la lectura preserva el beneficio principal del acceso columnar. Es un buen hábito cuando los analistas solo necesitan una porción del conjunto.
El problema sutil está en la escritura. Un archivo Parquet generado en un notebook suele funcionar bien para análisis local pero rinde mal después, cuando otro motor intenta empujar filtros o paralelizar escaneos. Eso no significa que Pandas esté mal. Significa que los valores por defecto de un notebook no son lo mismo que un diseño de almacenamiento de producción.
Si un conjunto de datos nace en un notebook y acaba en un pipeline compartido, reescríbelo con ajustes de producción antes de darlo por terminado.
Un último punto que muchos equipos pasan por alto: un conjunto escrito por Spark y leído por DuckDB puede comportarse distinto de uno escrito por PyArrow y leído por Spark. Mismo formato, decisiones de escritor distintas.
Compresión, codificación, particionado y evolución del esquema
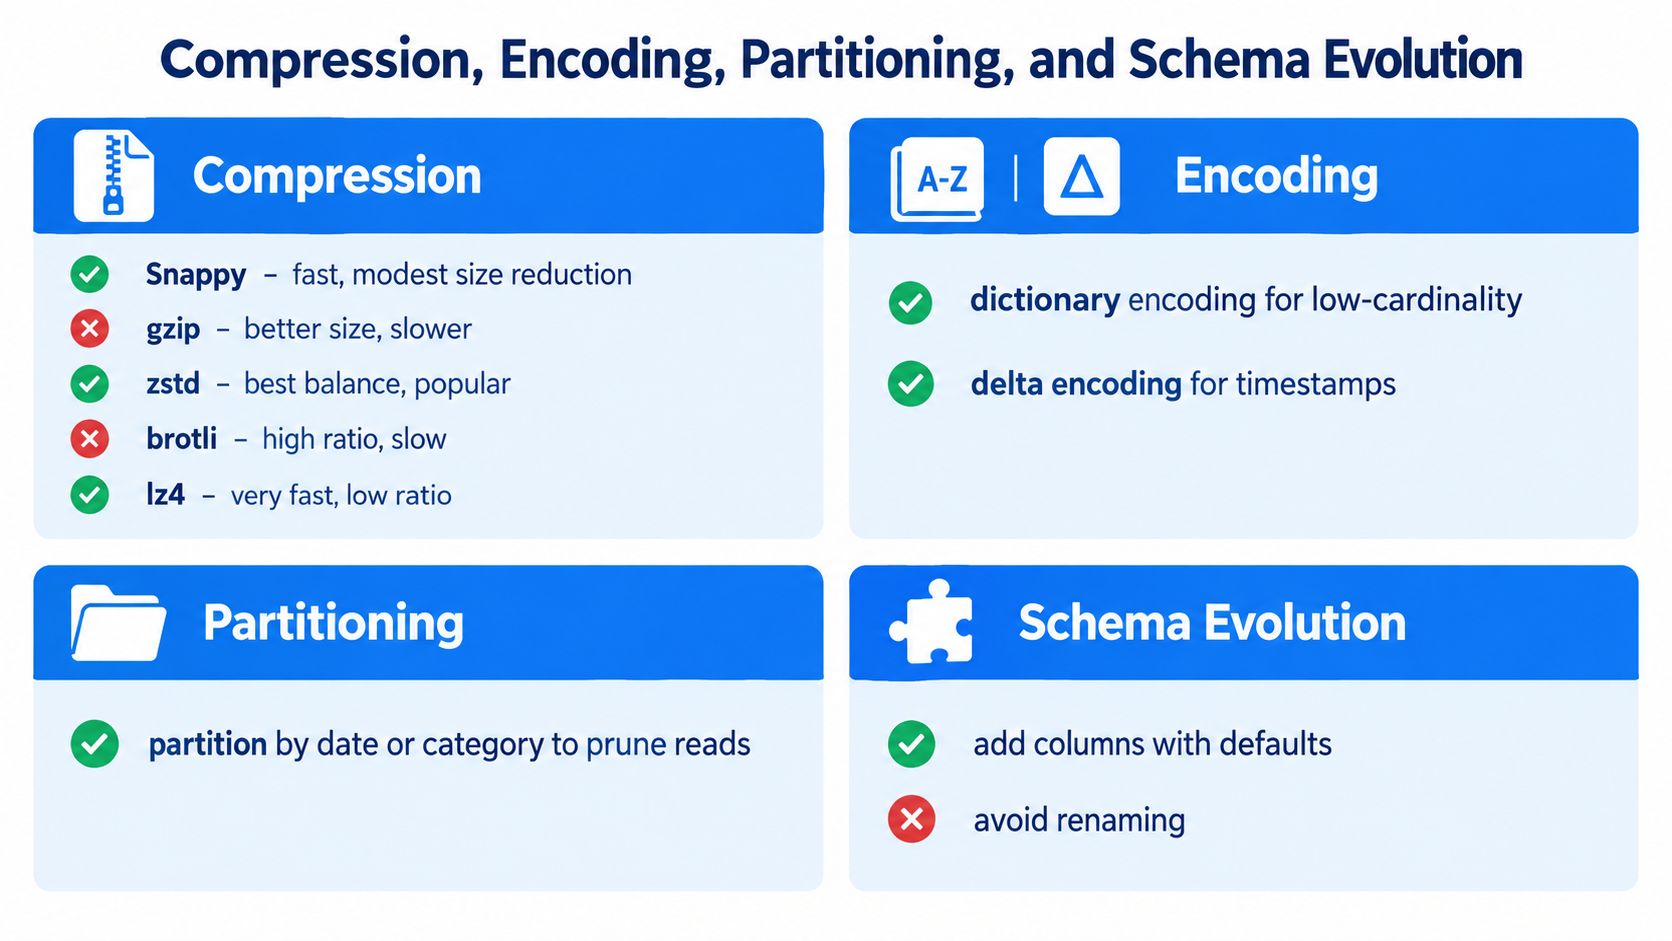
Un conjunto Parquet puede parecer sano por fuera y comportarse mal en producción. Los archivos se abren. Las consultas devuelven filas. Luego una tabla escanea mucho más de lo esperado, otra produce cientos de archivos diminutos y una tercera se rompe tras actualizar el escritor. Estos cuatro controles suelen explicarlo: compresión, codificación, particionado y evolución del esquema.
Compresión y codificación resuelven problemas distintos
La compresión decide cómo se aprietan los bytes para almacenarlos. La codificación decide cómo se disponen los valores antes de que la compresión los vea.
Esa distinción importa porque una codificación floja deja al compresor haciendo trabajo innecesario. Una codificación acertada puede hacer que una compresión corriente luzca mucho mejor.
En compresión, la concesión suele ser CPU contra tamaño:
Snappy es un valor por defecto habitual cuando leer y escribir rápido importa más que el tamaño mínimo.
gzip suele comprimir más, pero el coste de CPU es mayor.
zstd encaja bien en muchas cargas mixtas porque suele equilibrar ratio y velocidad.
brotli puede tener sentido cuando reducir almacenamiento importa más que el rendimiento de escritura.
lz4 prioriza la velocidad.
La codificación es más sensible a la forma de la columna. La codificación por diccionario va bien cuando una columna repite el mismo conjunto reducido de valores, como códigos de país o campos de estado. Las codificaciones delta encajan con enteros ordenados, marcas de tiempo y otros valores que cambian de forma gradual. El byte stream split puede ayudar a algunas columnas en coma flotante. Si la compresión es hacer la maleta, la codificación es cómo doblas la ropa antes.
El tamaño del row group marca el margen de rendimiento
Los row groups son uno de los ajustes menos glamurosos de Parquet y de los más caros de equivocar. Controlan cuántos datos se agrupan para escanear, omitir y trabajar en paralelo.
La guía de configuración de Parquet recomienda row groups grandes porque los grupos mayores suelen mejorar la eficiencia de escaneo y la compresión. En sistemas reales, los equipos eligen con frecuencia objetivos menores para equilibrar límites de memoria, tamaño de tareas y comportamiento de poda. Un row group mayor da a cada tarea de escaneo más trabajo útil. Uno menor da al motor más oportunidades de omitir datos irrelevantes.
Así que la pregunta no es si los row groups grandes son siempre mejores. La pregunta útil es: ¿tus cargas se benefician más de mayor rendimiento de escaneo o de una omisión más fina?
Si los analistas filtran mucho sobre un rango de fechas estrecho, unos row groups sobredimensionados pueden obligar a los lectores a traer más datos de los necesarios. Si la carga son sobre todo escaneos amplios de tabla, los grupos mayores suelen compensar.
El particionado debe reflejar cómo se leen realmente los datos
El particionado funciona mejor cuando sigue un filtro grueso y estable, como la fecha del evento, la región u otro campo que aparece en muchas consultas. Funciona mal cuando los equipos particionan por columnas de alta cardinalidad porque parecen selectivas sobre el papel.
Una buena regla es sencilla. Particiona para descubrir archivos, no para cada predicado posible.
Particionar de más crea un árbol de directorios caro de listar, caro de planificar y propenso a la proliferación de archivos diminutos. Particionar de menos empuja demasiado trabajo de filtrado dentro de los propios archivos. La disposición correcta suele ser aburrida. Eso es buena señal.
Ordenar dentro de las particiones es a menudo tan importante como el particionado en sí. Si las filas con valores parecidos quedan agrupadas, las estadísticas de Parquet y los page indexes tienen más opciones de ayudar al lector a omitir datos con limpieza.
En la evolución del esquema aflora la deuda de compatibilidad
Añadir una columna nullable suele ser fácil. Renombrar un campo entre motores, cambiar tipos lógicos o reescribir estructuras anidadas es donde empiezan los problemas.
Parquet es lo bastante permisivo como para que los cambios parezcan funcionar durante semanas antes de fallar en un lector posterior. Un motor puede interpretar un tipo lógico de una manera, otro puede ensancharlo y un tercero materializar nulos. Por eso la evolución del esquema debería tratarse como un proceso de compatibilidad, no como una casilla del formato.
La complejidad aumenta porque el ecosistema Parquet sigue cambiando. El blog del proyecto Apache Parquet sigue el trabajo en curso sobre funciones como Variant para datos semiestructurados, tipos geoespaciales y el tipo lógico FILE, junto con debates más amplios de formato y versionado que importan para la compatibilidad entre motores. Esas funciones son útiles, pero plantean a los equipos de producción una pregunta práctica: ¿qué lectores de tu pila pueden parsearlas correctamente hoy?
Ahí ayuda un seguimiento disciplinado del esquema. Una herramienta como el seguimiento de deriva de esquema para pipelines Parquet puede detectar cambios estructurales antes de que afloren como desacuerdos silenciosos entre lectores.
La mentalidad segura es conservadora. Usa funciones recientes de Parquet cuando resuelvan un problema real, pero protégelas con comprobaciones de compatibilidad de lectores, prueba archivos escritos por los motores reales de tu pila y trata las actualizaciones del escritor como cambios de comportamiento, no como parches rutinarios.
Diagnosticar fallos de archivos Parquet en producción
Cuando un archivo Parquet no se lee, los ingenieros suelen culpar primero al formato. Ese suele ser el instinto equivocado. La guía reciente de la comunidad muestra que los fallos reales más difíciles tienen que ver a menudo con la integridad del archivo y el transporte, no con el diseño de Parquet, y que el mismo síntoma puede venir de problemas de almacenamiento, escritor o lector más que de la estructura del archivo, como se recoge en las FAQ de diagnóstico de fallos de Parquet.
Un enfoque mejor es clasificar los fallos en arquetipos.
Cuatro clases de fallo que ahorran tiempo
Fallos de recuperación
El lector nunca recibió los bytes correctos. Piensa en listados de objetos obsoletos, entradas de manifiesto erróneas, descargas parciales o una página HTML de error guardada con extensión.parquet.Fallos de pie
El objeto existe, pero el pie falta, está corrupto o es ilegible. Las subidas truncadas y las escrituras multiparte incompletas suelen aparecer aquí.Fallos de vinculación de esquema
El archivo se abre, pero el lector mapea los tipos de forma distinta a la que pretendía el escritor. Obtienes nulos silenciosos, campos anidados rotos o desajustes de tipo lógico.Fallos de decodificación y materialización
Los metadatos parecen bien hasta que el motor empieza a decodificar páginas o a materializar valores en memoria. La compatibilidad de compresión, la corrupción de páginas y los límites propios del lector suelen caer aquí.
Un orden práctico de triaje
Usa una secuencia sencilla antes de empezar a cambiar código:
Verifica primero la recuperación. Confirma que el objeto está completo y que es un archivo Parquet, no contenido mal etiquetado.
Comprueba las marcas de los extremos y el pie. Si la cola está rota, nada por encima importa.
Inspecciona el esquema y los tipos lógicos. Compara la salida del escritor con las expectativas del lector.
Solo entonces depura el comportamiento de decodificación. No saltes a teorías sobre códecs antes de saber que el archivo está entero.
Los pipelines Parquet rotos suelen empezar fuera de Parquet. El almacenamiento, el transporte, los nombres y las políticas de ciclo de vida de objetos causan una parte sorprendente del dolor.
La monitorización de archivos y la observabilidad de pipelines ayudan más que el conocimiento del formato por sí solo. Si los equipos ya usan monitorización del data lake, a menudo pueden detectar particiones que faltan, llegadas tardías o cambios bruscos de esquema antes de que un lector lance un error de bajo nivel.
El cambio de mentalidad principal es simple. No preguntes «¿por qué está roto Parquet?». Pregunta «¿en qué etapa dejaron de ser fiables los bytes, los metadatos, la vinculación de esquema o la ruta de decodificación?».
Lista operativa para archivos Parquet en pipelines
Un Parquet sano no ocurre porque el formato sea bueno. Ocurre porque los equipos aplican las mismas reglas cada vez que escriben, validan y publican archivos.

La lista que merece pegarse en un runbook
Fija las versiones del escritor. Mantén estables las versiones de librería entre trabajos que escriben el mismo conjunto. Los escritores mezclados suelen producir comportamientos mezclados.
Verifica las estadísticas del pie. Asegúrate de que los metadatos de row group existen y son lo bastante plausibles para que los lectores poden con eficacia.
Elige objetivos de row group a propósito. Muchos equipos acaban cerca de 128 MB en la práctica, mientras que la guía del proyecto recomienda de 512 MB a 1 GB para row groups grandes según la carga y el comportamiento del motor, conforme a la guía de Parquet enlazada antes.
Audita la disposición de particiones. La estructura de directorios debería reflejar cómo consulta la gente los datos.
Prueba la evolución del esquema antes del merge. Añadir columnas es una cosa. La deriva de tipos lógicos es otra.
Revisa las decisiones de compresión y codificación. No heredes los valores por defecto de un notebook dando por hecho que encajan en producción.
Valida la integridad del transporte. Un escritor correcto no te protege de subidas rotas ni de sorpresas del almacén de objetos.
La observabilidad y el gobierno lo hacen sostenible
Esta lista gana utilidad cuando se ata a comprobaciones automatizadas. Great Expectations puede validar reglas de esquema y contenido. Apache Griffin puede apoyar flujos de calidad de datos. Datafold puede ayudar a comparar cambios entre entornos. digna es otra opción en esta categoría. Se ejecuta dentro del propio entorno del cliente y monitoriza el comportamiento de los datos, la Timeliness, las validaciones y los cambios de esquema en los pipelines, lo que encaja con el tipo de regresiones silenciosas de Parquet que las comprobaciones básicas de archivo no ven.
El gobierno también pertenece aquí. Los metadatos de columna pueden llevar etiquetas de PII. Los formatos de tabla y las capas de catálogo pueden hacer cumplir retención y políticas de acceso. Los permisos del almacén de objetos siguen importando, porque el archivo Parquet más limpio del mundo no sirve de nada si el trabajo equivocado puede sobrescribirlo.
Hábito operativo: trata cada conjunto Parquet como un problema de formato de archivo y a la vez como un problema de contrato. El rendimiento viene del formato. La fiabilidad viene del contrato.
Un archivo Parquet es sencillo de usar cuando otra persona tomó las decisiones correctas por ti. En producción, ese alguien es tu equipo.
Si Parquet sostiene cargas críticas de analítica o IA en tu entorno, digna puede ayudarte a monitorizar las partes que suelen fallar: deriva de esquema, datos ausentes o tardíos, problemas de calidad a nivel de registro y comportamiento inusual entre pipelines. Resulta especialmente útil cuando un problema de Parquet no es un problema de formato en absoluto, sino de entrega, metadatos o contrato aguas arriba. Echa un vistazo a digna si quieres esa visibilidad dentro de tu propio entorno.
La versión de esta lista a nivel de conjunto de datos, aplicada de forma continua en lugar de archivo a archivo, se ve en cómo funciona en la práctica la gestión de la calidad de los datos.
Preguntas frecuentes
¿Cuándo se creó Parquet?
Parquet empezó como un esfuerzo conjunto de código abierto entre Twitter y Cloudera, con Parquet 1.0 publicado en julio de 2013, y se convirtió en proyecto de primer nivel de la Apache Software Foundation el 27 de abril de 2015. Su diseño se apoyó en el troceado de registros al estilo Dremel, que es como representa estructuras anidadas sin repetir nombres de campo en cada fila.
¿Cómo almacena Parquet datos anidados como structs, listas y mapas?
Mediante troceado y ensamblado al estilo Dremel. El escritor descompone los registros anidados en piezas columnares y conserva suficiente información posicional para reconstruirlos al leer, de modo que los nombres de campo no se repiten por fila. Por eso los esquemas muy anidados se mantienen compactos en lugar de inflarse como el JSON anidado.
¿Por qué falla la lectura de un archivo Parquet?
Los problemas de integridad y transporte causan más fallos reales que el propio formato. Un archivo sano empieza y acaba con los bytes mágicos PAR1, así que la falta de la marca final apunta a truncamiento, una descarga parcial o una página HTML de error guardada con extensión .parquet. Comprueba la recuperación antes de empezar a cambiar código.
¿Qué tamaño de row group debería usar?
Los row groups controlan cuántos datos se agrupan para escanear, omitir y trabajar en paralelo, y están entre los ajustes más caros de equivocar. Los grupos mayores mejoran la eficiencia de escaneo pero amplían el radio del daño cuando las estadísticas son pobres; los menores dan a los lectores más oportunidades de omitir. Ajústalos contra patrones de escaneo reales.
¿Cómo se mantienen fiables los conjuntos Parquet en producción?
Aplica las mismas reglas en cada escritura. Fija las versiones del escritor para que los trabajos que escriben un conjunto no produzcan comportamientos mezclados, particiona por filtros gruesos y estables, y valida con los motores lectores en lugar de solo con el escritor. Herramientas como Great Expectations, Apache Griffin, Datafold y digna automatizan esas comprobaciones.



