Gobernanza de la calidad de datos: principios y práctica
|
7
minuto de lectura

Lunes por la mañana, el panel parece tranquilo. Los ingresos están en verde, el trimestre da la sensación de ir bien y nadie hace preguntas incómodas. Entonces finanzas descubre que el pipeline de origen truncó los valores nulos, que la previsión se construyó sobre las cifras equivocadas y que ese panel impecable resulta ser una ilusión muy cara.
Ahí es donde la gobernanza de la calidad de datos deja de sonar abstracta. Es la disciplina que habría detectado la desviación, lanzado una alerta, asignado un responsable y evitado que un problema pequeño aguas arriba se convirtiera en una corrección de toda la empresa. En términos prácticos, conecta los pipelines en bruto con decisiones fiables, para que un panel no solo parezca correcto, sino que siga siéndolo.
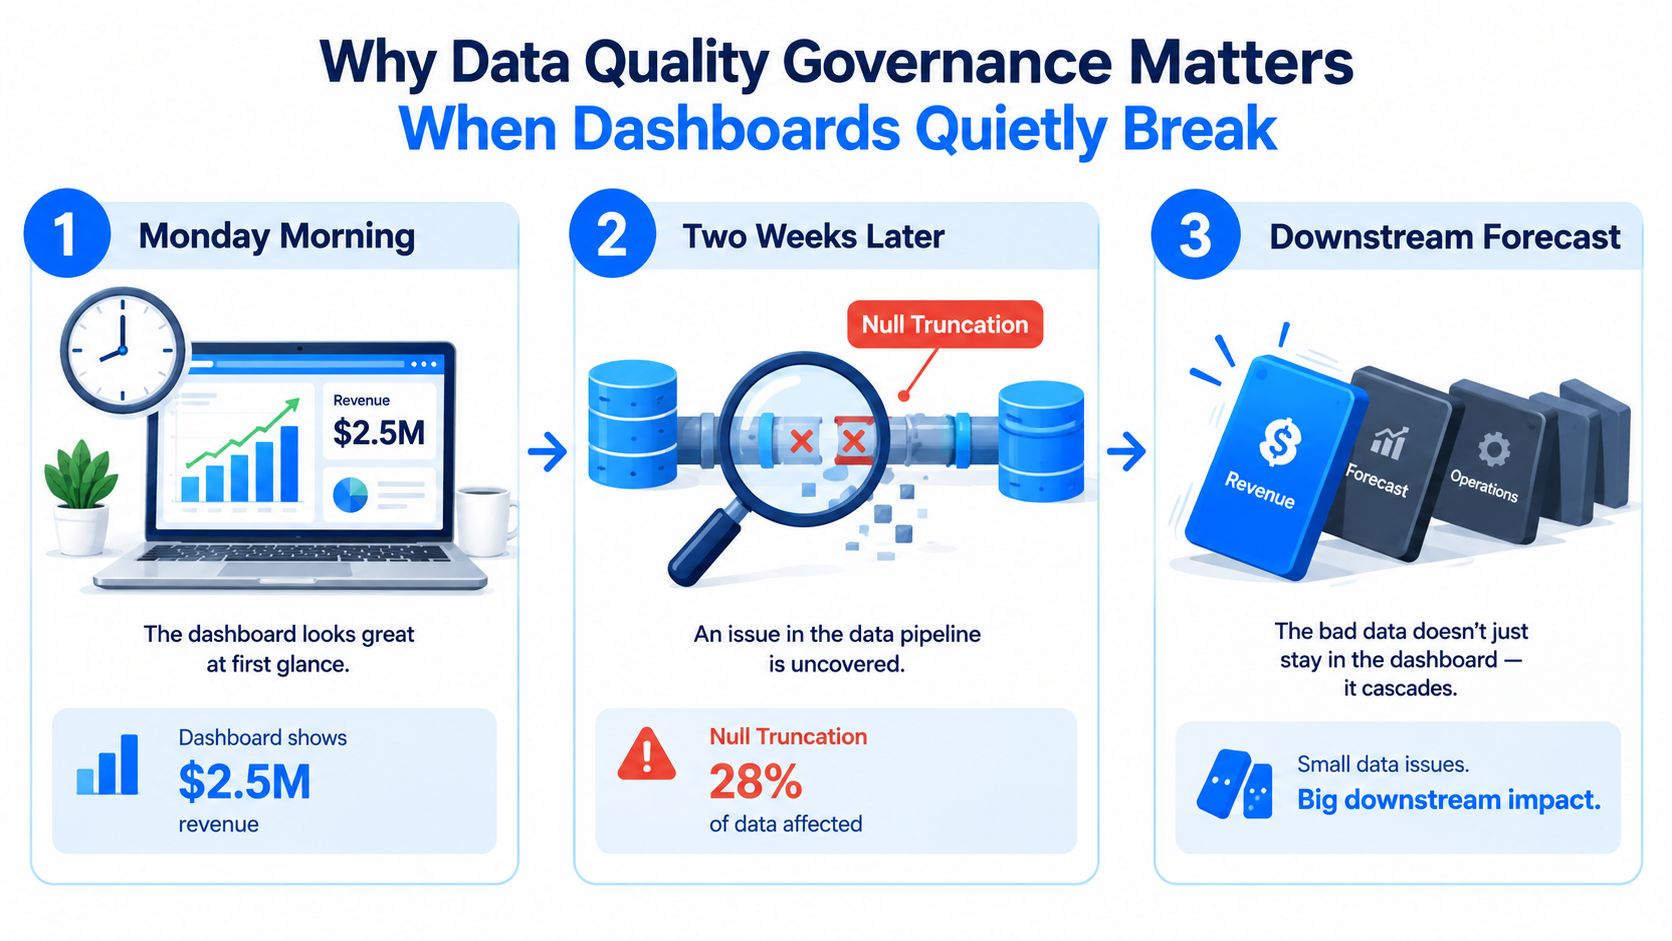
El resto de la guía sigue el orden en que una organización real debe pensar esto: primero principios, luego roles, políticas, controles, ciclo de vida y observabilidad. Si ya lidia con informes rotos, feeds obsoletos o datos de entrenamiento de IA que no terminan de cuadrar, la pregunta práctica no es si la gobernanza importa. Es cómo hacerla visible lo bastante pronto para hacer algo útil.
Índice de contenidos
Por qué importa la gobernanza de la calidad de datos cuando los paneles se rompen en silencio
Los principios esenciales que definen la gobernanza de la calidad de datos
Qué cuesta la mala calidad de datos y por qué existe la gobernanza
Roles y responsabilidades en un programa de gobernanza de la calidad de datos
Cómo la observabilidad convierte la gobernanza en práctica medible
Por qué importa la gobernanza de la calidad de datos cuando los paneles se rompen en silencio
Un panel roto rara vez se anuncia. Suele llegar primero como confianza mal puesta y después como confusión. El lunes las cifras parecen bien. Dos semanas más tarde alguien nota que el sistema de origen descartaba valores nulos y que toda previsión aguas abajo se construyó sobre ficción.
Por eso la gobernanza no puede vivir solo en la documentación. La gobernanza de la calidad de datos es la capa de control que vigila la desviación, ata un problema a un responsable y lo encamina antes de que el daño se extienda. En un entorno gobernado, el pipeline se trata como un proceso de negocio monitorizado, y las herramientas modernas de observabilidad dan a esa disciplina una forma de operar dentro del flujo de datos, no solo sobre el papel.
Qué se rompe primero
El primer fallo suele ser la confianza. Los analistas revisan informes, los equipos discuten qué versión es la buena y la toma de decisiones se ralentiza porque la gente deja de creer las cifras que tiene delante. Ese esfuerzo desperdiciado es una razón de que la mala calidad de datos se haya vuelto tan cara a escala: el resumen de IBM de un informe de 2025 señala que más de una cuarta parte de las organizaciones pierde más de 5 millones de USD al año y que un 7 % reporta pérdidas de 25 millones de USD o más.
El segundo fallo es operativo. Una previsión de ventas construida sobre datos truncados puede llevar a comprometerse de más, un plan de reposición puede excederse con el inventario y un modelo puede heredar la misma señal defectuosa que el panel. El problema crece porque nadie detecta la incidencia en el origen.
Un programa de gobernanza vale exactamente lo que valga su capacidad de detectar el problema mientras aún hay tiempo de actuar.
La observabilidad cambia la historia. Un pico en la tasa de nulos, un cambio inesperado de esquema, un feed que llega tarde o un registro ausente no tienen que esperar a que finanzas se dé cuenta. La detección de anomalías guiada por IA, la monitorización de Timeliness, el seguimiento de esquema y la validación a nivel de registro pueden sacar el problema a la luz dentro del pipeline, con la evidencia ya adjunta y el responsable ya claro.
Para los equipos que quieren conectar datos gobernados con reporting en vivo, esta panorámica de los paneles de calidad de datos muestra cómo pasan del reporting estático al control activo. Esa diferencia importa. Un panel que solo refleja el pasado puede esconder la desviación. Uno atado a monitorización y validación puede señalarla a tiempo de corregirla.
Los principios esenciales que definen la gobernanza de la calidad de datos
En lo más simple, la gobernanza de la calidad de datos es el conjunto de principios, roles y controles que mantienen los datos aptos para su uso previsto. Los principios suenan directos, pero cada uno debe probarse en un proceso real, contra un conjunto real, por un responsable real. Si alguna capa queda vaga, el conjunto se vuelve blando enseguida.
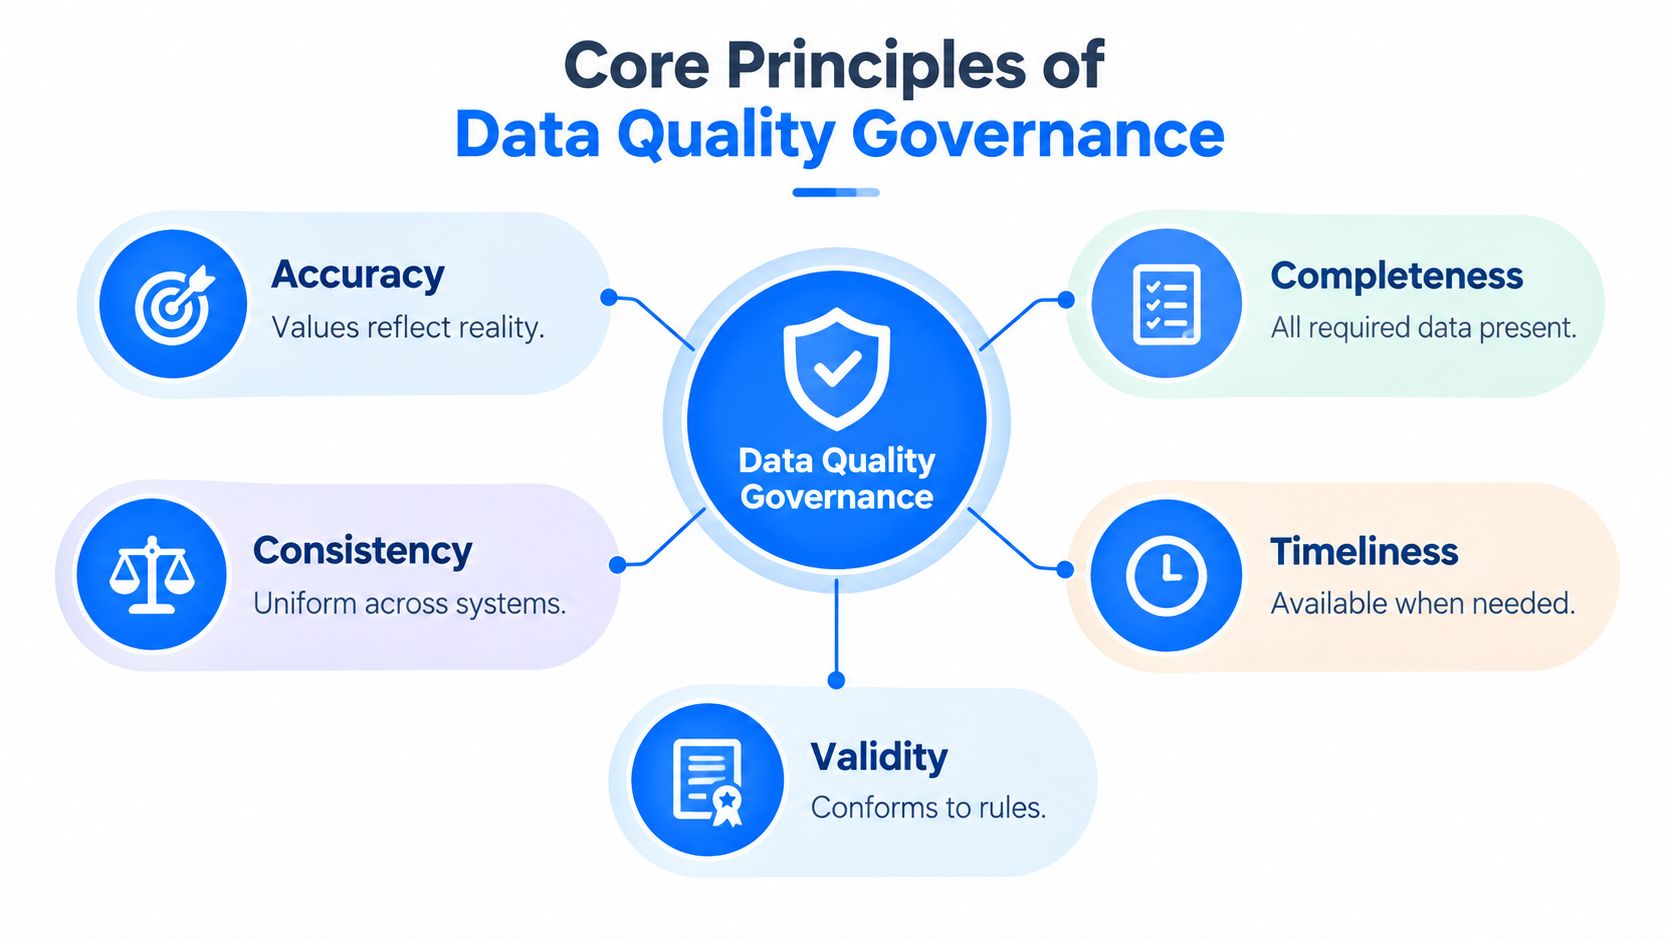
Las cinco dimensiones que importan en la práctica
Exactitud significa que los valores reflejan la realidad. Una dirección de cliente que aún apunta a un piso antiguo puede pasar una comprobación de formato y seguir estando mal si el mensajero no puede entregar allí.
Completitud significa que están los datos requeridos. Un registro de alta sin correo electrónico o sin marca de consentimiento puede parecer estructuralmente correcto y ser inservible para el proceso de negocio.
Consistencia significa que lo mismo significa lo mismo en todas partes. Si la divisa se guarda de una forma en finanzas y de otra en operaciones, la conciliación se convierte en un trabajo manual de detective.
Timeliness significa que los datos llegan a tiempo de sostener la decisión. Un feed de inventario obsoleto puede ser técnicamente correcto y aun así inútil si el almacén ya siguió adelante.
Validez significa que los datos cumplen las reglas que usted fijó. Una dirección de correo que no encaja en un patrón válido debe fallar pronto, no descubrirse cuando una campaña rebota.
Debajo de esas cinco hay dos atributos de apoyo. La fiabilidad dice a la gente que puede contar con que los datos se comporten como se espera, y la disponibilidad significa que los datos están al alcance cuando se necesitan. Juntas convierten un principio de bonito sonido en un modelo operativo que funciona.
Si busca un encuadre afín desde otro ámbito, el artículo sobre garantizar la exactitud de los fondos de una iglesia muestra cuánto importa un manejo cuidadoso de los registros cuando lo que está en juego es la confianza pública y un reporte del que hay que responder. La lección se traslada limpiamente, aunque cambie el contexto.
Para los equipos que incorporan esto a un modelo operativo más amplio, la panorámica de DMBOK de digna es un punto de referencia práctico. Ayuda a situar los controles de calidad dentro de la estructura de gobernanza más amplia en vez de tratarlos como comprobaciones aisladas.
Qué cuesta la mala calidad de datos y por qué existe la gobernanza
La mala calidad de datos no genera un único gasto. Empieza con tiempo de analista desperdiciado, porque la gente repite consultas, concilia informes y persigue el mismo descuadre al no fiarse nadie de la primera respuesta.
Después alcanza al negocio. Un equipo que almacena inventario de más porque un feed venía mal paga ese error en operaciones, no solo en el backlog del equipo de datos. La gobernanza existe para detener los errores antes de que se propaguen.
La escalera de costes y el control que corresponde a cada peldaño
Abajo del todo, las reglas de validación atrapan pronto los problemas evidentes. Un campo obligatorio ausente, un correo mal formado o un valor imposible deberían fallar antes de que el registro se convierta en la limpieza de otra persona.
Un escalón más arriba, la detección de anomalías y los SLA de frescura capturan cambios técnicamente válidos pero operativamente erróneos. Un feed que llega tarde cada día, o una métrica que salta fuera de su rango normal, requiere atención aunque el esquema siga pareciendo correcto. Ese es el puente entre política y observabilidad: la regla se escribe una vez y luego el pipeline la comprueba de forma continua.
Más arriba, los rastros de auditoría y los flujos de aprobación importan cuando el problema afecta a divulgaciones, a reporting regulado o a cualquier proceso que necesite prueba de quién aprobó qué. Si un cambio hay que explicarlo después, el registro de esa decisión tiene que existir ahora.
En la cima, el linaje de extremo a extremo y la propiedad de la remediación conectan el registro defectuoso con los paneles, informes o modelos que tocó. Sin ese rastro, los equipos arreglan el síntoma y pierden el origen, como parchear una fuga sin encontrar la tubería.
Prevenir es más barato que corregir porque cada consumidor aguas abajo multiplica el coste de la limpieza.
Esa lógica económica no es abstracta. Una revisión de literatura citó 23 ejemplos de costes por datos deficientes, entre ellos mantenimiento, exceso de mano de obra, reintroducción, pérdida de ingresos, pérdida de clientes y retrabajo, razón por la que la gobernanza es más que metadatos ordenados. La misma revisión recogía un modelo de Dun & Bradstreet que estima que arreglar una incidencia de datos cuesta alrededor de 1 USD por registro antes de que entre en el sistema, 10 USD por registro tras la entrada y 100 USD por registro después de un evento, de modo que el momento cambia la economía. Vea la revisión sobre categorías de coste y economía por registro.
Para un equipo de gobernanza, ese es el argumento práctico en lenguaje llano. Detecte el problema pronto y se queda local. Detéctelo tarde y cada equipo del recorrido ayuda a pagarlo.
Roles y responsabilidades en un programa de gobernanza de la calidad de datos
Un programa de gobernanza fracasa más rápido cuando nadie sabe de quién es el registro defectuoso. La solución es un modelo sencillo de responsabilidad, normalmente al estilo RACI, donde un grupo responde del resultado, otros ejecutan y nadie puede suponer que el problema es de otro.
Quién posee qué
El consejo de gobernanza de datos o el patrocinador ejecutivo responde del resultado y de la postura de riesgo. Si la calidad se rompe repetidamente en un dominio, eso no es solo una molestia técnica, es un asunto de liderazgo.
Los propietarios de datos suelen ser responsables de negocio sénior. Deciden qué aspecto tiene una calidad aceptable en su dominio y luego aprueban las prioridades de remediación cuando distintas correcciones compiten por atención.
Los data stewards traducen esas reglas a la práctica diaria. Escriben definiciones de negocio, revisan anomalías, coordinan arreglos y se aseguran de que las reglas signifiquen lo mismo para quienes las usan.
Los ingenieros de datos implementan las comprobaciones en los pipelines y poseen la infraestructura que las aplica. Si el control no se ejecuta donde se mueven los datos, no protegerá nada.
Los ingenieros de plataforma y analítica mantienen las herramientas, la integración del flujo y las rutas de entrega lo bastante estables para que los controles funcionen sin fricción. Los socios de cumplimiento intervienen cuando la evidencia debe sostenerse ante una auditoría o una norma.
Rol | Responsabilidad principal | Responde de |
|---|---|---|
Patrocinador ejecutivo o consejo de gobernanza | Fijar el rumbo y resolver los grandes compromisos de riesgo | Resultados del programa y postura de riesgo |
Propietario de datos | Definir la calidad aceptable en el dominio de negocio | Decisiones de dominio y prioridad de remediación |
Data steward | Mantener definiciones y coordinar arreglos | Gestión diaria de la calidad |
Ingeniero de datos | Construir y ejecutar la validación en los pipelines | Aplicación técnica de los controles |
Ingeniero de plataforma o analítica | Mantener operativas las rutas de monitorización y entrega | Fiabilidad operativa de la pila de control |
Socio de cumplimiento | Revisar evidencia y alineación con la política | Preparación para auditoría y defensa regulatoria |
Para un desglose más completo de esos traspasos, esta guía de roles y responsabilidades en calidad de datos es una referencia útil. Lo principal que vigilar es el modo de fallo clásico, en el que todos creen que otro está mirando el mismo problema.
Políticas, estándares y conformidad comprobable por máquina
Las políticas son la intención escrita. Los estándares son la versión medible de esa intención. La conformidad es la parte en la que el sistema demuestra que los datos cumplieron el estándar, no solo el memorando de política.
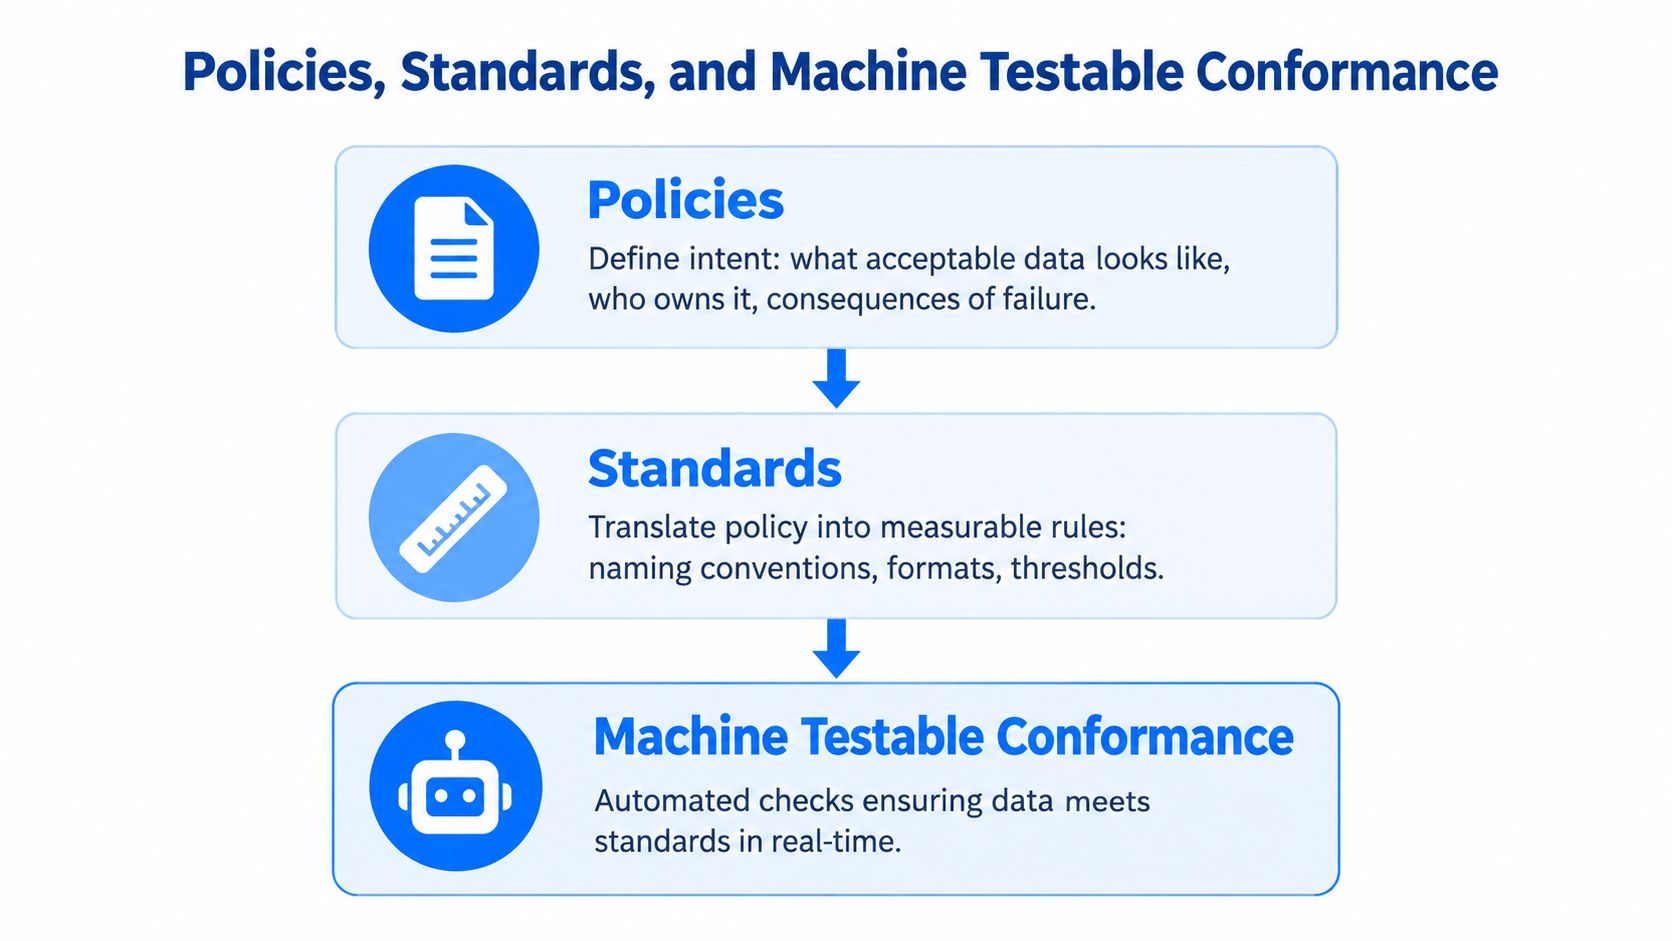
Convertir la intención en algo que un pipeline pueda exigir
Una política puede decir que los datos maestros de cliente deben ser lo bastante fiables para el uso operativo. Un estándar lo concreta, por ejemplo exigiendo que la tabla de clientes aterrice dentro de una ventana de frescura fijada, o que los campos críticos se mantengan por debajo de un umbral de nulos definido.
Esa es la diferencia entre una regla y una esperanza. Una política sin prueba es solo aspiración. Una prueba sin política es solo una comprobación técnica sin significado de gobernanza.
ISO 8000-51:2023 hace esta idea muy concreta. Especifica requisitos para intercambiar declaraciones de política de gobernanza de datos y para la comprobación automatizada de conformidad de conjuntos de datos frente a las especificaciones nombradas en esas declaraciones, lo que enlaza la capa escrita directamente con una aplicación verificada por máquina ISO 8000-51:2023.
Qué aspecto tiene la conformidad comprobable por máquina
En la práctica aparece como aserciones, comprobaciones de esquema, pruebas de contrato y validadores a nivel de pipeline. Un equipo puede imponer una convención de nombres en la ingesta, otro puede comprobar los campos obligatorios antes de que se entrene un modelo, y otro puede bloquear la publicación si el esquema cambia de forma inesperada.
El marco del Gobierno del Reino Unido resulta útil aquí porque empuja a las organizaciones hacia una gobernanza formal, principios acordados y estándares que hacen los datos reutilizables e interoperables Government Data Quality Framework. Es la misma lógica que necesitan los equipos del sector privado cuando quieren evidencia y no solo intención.
Para un modelo operativo más detallado, la página de estándares de calidad de datos de digna es un lugar práctico donde anclar la conversación. Evita que política, estándar y aplicación colapsen en un único documento vago.
Validación y remediación como ciclo de vida continuo
El trabajo de calidad no es una limpieza puntual. Es un bucle. El bucle empieza cuando aparece algo inusual y solo termina después de verificar el arreglo contra el mismo control que detectó el problema.
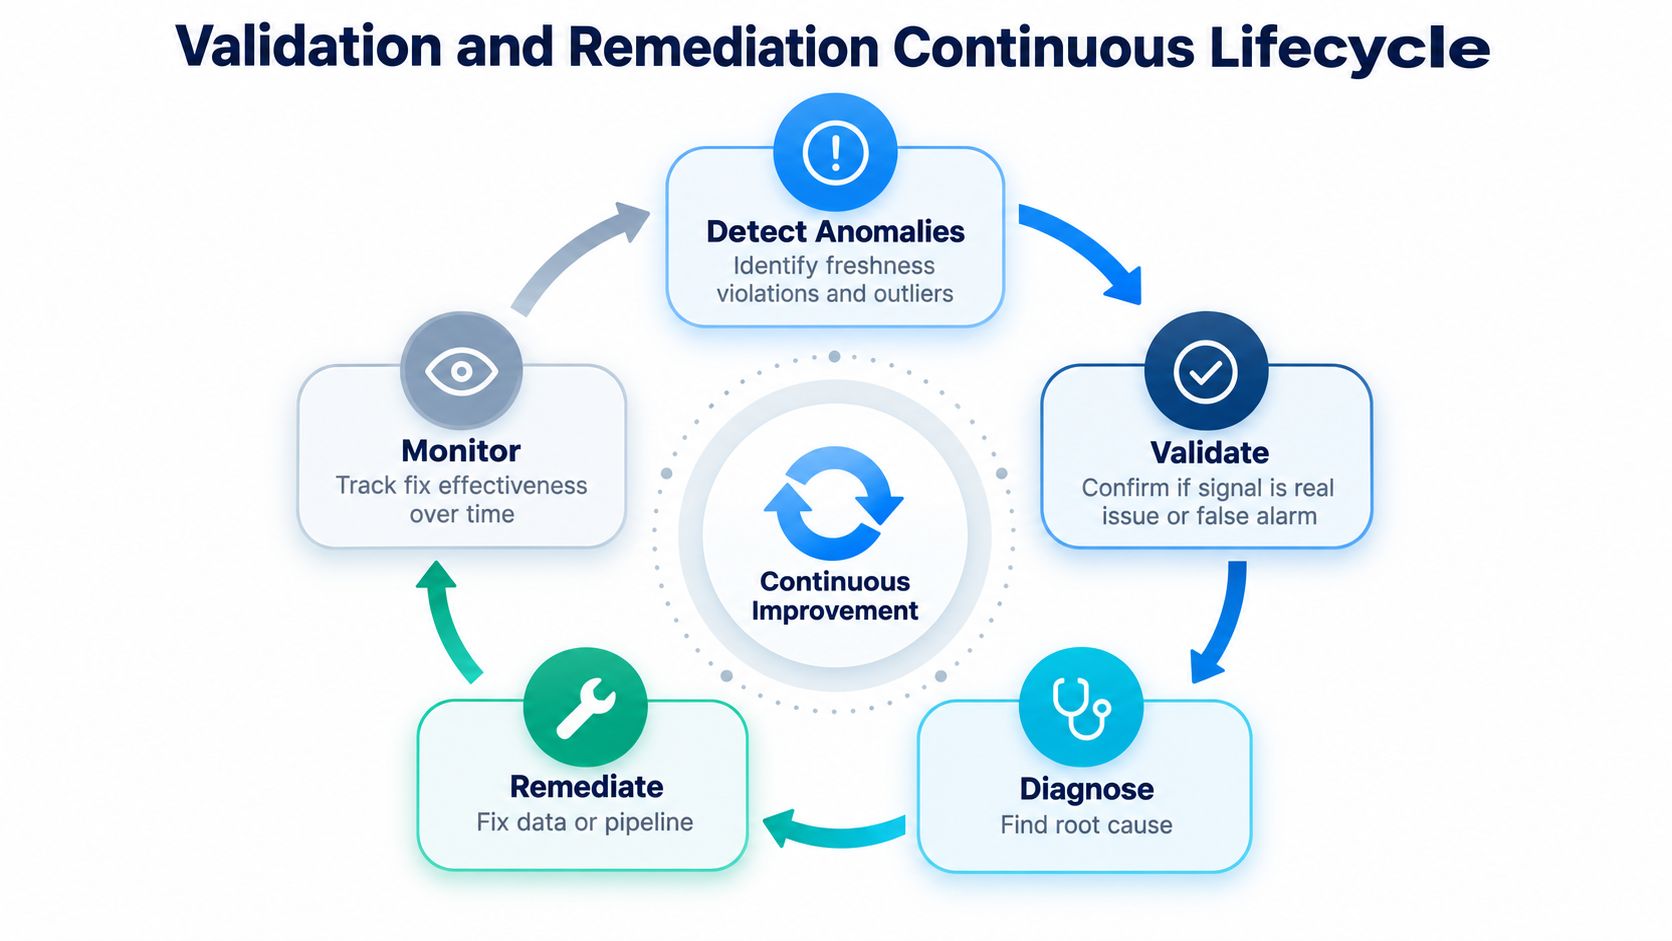
El bucle de cinco etapas
Primero, detectar. La detección de anomalías guiada por IA puede sacar a la luz valores atípicos, la monitorización de Timeliness puede señalar cargas tardías y el seguimiento de esquema puede capturar atributos añadidos, eliminados o con tipo cambiado antes de que los usuarios aguas abajo noten la rotura.
Segundo, validar. No toda alerta es un defecto. Algunas son desviación esperada, cambio estacional o un evento de negocio que necesita contexto antes de que nadie toque el pipeline.
Tercero, priorizar. La pregunta correcta no es solo «¿está roto?». Es «¿cuál es el impacto y qué más depende de esto?». El linaje importa aquí porque una sola tabla defectuosa puede afectar a un largo rastro de informes y modelos.
Cuarto, remediar. Arregle el origen si puede. Si no puede, documente la lógica compensatoria y asegúrese de que el apaño tenga dueño, sea visible y sea temporal.
Quinto, verificar. La corrección debe restaurar la conformidad sin romper a los consumidores. Ahí importa la validación a nivel de registro, porque los recuentos de filas, la integridad referencial y las distribuciones de valores pueden probar que el arreglo funcionó.
Una buena remediación cierra el bucle. Una mala remediación solo mueve el problema a otra tabla.
Vale la pena comparar plataformas operativas como el área de integraciones de Donely si está viendo cómo la monitorización se conecta con las herramientas y flujos existentes. La cuestión no es la marca, es el patrón de diseño: los controles deben vivir cerca del flujo de datos, no a varios sistemas de distancia.
Cómo la observabilidad convierte la gobernanza en práctica medible
La observabilidad hace real la gobernanza porque convierte los principios en evidencia. En vez de esperar a una revisión mensual, los equipos pueden vigilar frescura, volumen, distribución, esquema, linaje y validez de registro mientras los datos se mueven.
Qué muestra un panel de gobernanza útil
Un panel serio debe mostrar la conformidad actual, las tendencias en el tiempo, las comprobaciones fallidas, las excepciones sin resolver y la velocidad de detección y remediación. También debe hacer legible la alerta en su contexto, con el conjunto afectado, el proceso de negocio, la ejecución del pipeline, el rango esperado, la severidad y el steward encargado de actuar.
Ese contexto importa porque una alerta sin linaje es solo ruido. Con linaje, la misma alerta le dice qué informe, modelo o proceso operativo sentirá el problema si nadie actúa.
Por qué importa el análisis de tendencias
Un incidente aislado puede ser puntual. Una deriva de esquema recurrente o fallos repetidos de frescura suelen apuntar a una debilidad de control, no a un suceso aleatorio. El análisis de tendencias ayuda a los equipos de gobernanza a separar errores aislados de fallos estructurales que exigen un cambio de política o de proceso.
Los resultados de comprobación inmutables también importan. Dan evidencia a los auditores, historia a los stewards y a la dirección algo más útil que la vaga garantía de que «ahora las cifras pintan mejor».
Para los equipos que llevan esto a producción, la visión de observabilidad de datos de digna encaja bien con el patrón operativo porque combina detección de anomalías, validación, monitorización de Timeliness y seguimiento de esquema dentro del flujo donde aparece el problema. Esa es la distancia entre política sobre el papel y control en movimiento.
Empiece por los elementos de datos críticos y luego escalone las alertas por riesgo de negocio. Si todo grita a la vez, nadie oye lo que importa.
El cambio mayor es cultural. La observabilidad no sustituye a la gobernanza, le da hechos con la rapidez suficiente para que la gente actúe sobre ellos.
Gobernar la calidad de datos para IA y sus próximos pasos
La IA eleva lo que está en juego porque un modelo puede amplificar defectos pequeños hasta convertirlos en muchas decisiones. Rasgos obsoletos, cambios de esquema sin documentar, etiquetas inconsistentes y muestras incompletas no se quedan locales una vez entran en el entrenamiento o la inferencia.
Un programa práctico empieza por los conjuntos que alimentan modelos importantes. Asigne propietario y steward, defina umbrales de aptitud para el propósito y pruebe los datos antes de que lleguen al entrenamiento o al scoring en producción. La misma lógica vale para procedencia, distribuciones de rasgos, calidad de etiquetas, completitud, Timeliness y comportamiento por subgrupos a lo largo del ciclo de vida del modelo.
Una lista de comprobación inicial viable
Inventaríe los productos de datos que más importan: Identifique qué tablas, feeds y conjuntos de rasgos afectan a ingresos, riesgo, servicio o reporting regulado.
Fije primero unos pocos controles medibles: Céntrese en las comprobaciones que habrían capturado los fallos que ya ha visto, no en todo problema teórico.
Nombre la vía de escalado: Decida a quién se avisa, quién decide y quién puede aprobar una excepción cuando los datos son imperfectos pero aún utilizables.
Documente las excepciones: Si un equipo acepta un apaño temporal, escríbalo para que ese atajo no se convierta en la nueva normalidad.
Revise los defectos recurrentes: Use el historial de fallos, el tiempo de remediación y la conformidad con la política para decidir dónde corresponde la siguiente inversión.
La revisión humana sigue importando cuando la automatización no puede decir si los datos son semánticamente correctos, justos o apropiados para el caso de uso. Eso es especialmente cierto en IA, donde un esquema limpio puede ocultar igualmente un mal conjunto de etiquetas o una muestra sesgada.
Una visión sectorial más amplia de los puntos de presión de la IA aparece en este resumen de encuesta de 2026 sobre gobernanza de datos e IA, que subraya con qué frecuencia las organizaciones se pelean con la calidad de los datos de entrenamiento y la dependencia de la gobernanza. La lección es simple: la IA no reduce la necesidad de gobernanza, expone dónde la gobernanza ya era delgada.
Si quiere convertir esa idea en un programa que funcione, digna aporta capacidades empresariales de calidad de datos y observabilidad que vigilan anomalías, validación, Timeliness y cambios de esquema dentro del propio entorno del cliente. Visite digna para ver cómo encajan esos controles en sus pipelines, su modelo de gobernanza y los flujos de IA de los que usted responde.
Las políticas solo se vuelven medibles cuando se traducen en cifras que alguien sigue cada semana: empieza por un conjunto funcional de métricas de calidad de datos.
Preguntas frecuentes
¿Por qué no puede vivir la gobernanza de calidad solo en la documentación?
Porque un panel roto rara vez se anuncia. Una gobernanza que existe como política escrita no tiene forma de notar el fallo silencioso, que es justo el modo de fallo que fue creada para evitar.
¿Qué se rompe primero cuando la gobernanza está solo en papel?
La confianza. El primer fallo es que la gente deja de creerse las cifras, y el segundo es operativo, porque el esfuerzo se desplaza a volver a comprobar un trabajo que ya debería haber sido fiable.
¿Cuánto cuesta ese esfuerzo desperdiciado?
El resumen de IBM de un informe de 2025 señala que más de una cuarta parte de las organizaciones pierde más de 5 millones de USD al año por mala calidad de datos, y que un 7 % reporta pérdidas de 25 millones o más.
¿Qué hace realmente útil a un programa de gobernanza?
Su capacidad de detectar el problema mientras aún hay tiempo de actuar. Un programa que produce un relato exacto de lo que salió mal el trimestre pasado es una auditoría, y las auditorías llegan después de la decisión que habrían cambiado.
¿En qué orden debe construirse?
Principios primero, después roles, políticas, controles, ciclo de vida y observabilidad. Empezar por los controles antes que por los roles produce comprobaciones sin dueño, y empezar por las políticas antes que por los principios produce reglas que nadie puede arbitrar.



