Métricas de calidad de datos: una guía completa para 2026
|
7
minuto de lectura
Un dashboard se veía bien a las 8:00 a.m. Para las 9:15, el equipo de finanzas cuestionaba la cifra de ingresos, operaciones andaba detrás de un problema de envío y el equipo de datos intentaba resolver si el problema comenzó en la ingesta, la transformación o en un sistema de origen que cambió de forma de la noche a la mañana.
Ahí es donde suelen encontrarse las organizaciones cuando empiezan a tomarse en serio la calidad de los datos. No en el momento de la teoría, sino en el de la falla. Un campo de dirección faltante bloquea el cumplimiento de un pedido. Un registro de cliente duplicado infla un KPI. Una tabla desactualizada alimenta un modelo que era preciso ayer y hoy ya no es confiable.
Las métricas de calidad de datos son la forma de dejar de discutir por instinto y empezar a operar con base en evidencia. Convierten el "algo se siente mal" en señales medibles, verificaciones repetibles y flujos de trabajo de incidentes en los que la gente puede confiar.
Tabla de contenidos
Por qué las métricas de calidad de datos son innegociables en 2026
Explicación de las seis dimensiones principales de la calidad de datos
Operacionalización de la calidad de datos: un ejemplo de dashboard de KPI
Cómo las plataformas de Data Observability automatizan las métricas de calidad
Por qué las métricas de calidad de datos son innegociables en 2026
Los equipos suelen descubrir la necesidad de métricas de calidad de datos después de un incidente evitable. Un reporte para la junta directiva está mal. Una tabla de características de machine learning está desactualizada. Un cambio de esquema se implementa sin previo aviso y la lógica descendente sigue ejecutándose como si nada hubiera pasado.
El problema no son solo los datos erróneos. El problema son los datos erróneos sin instrumentación.
Según el resumen de estadísticas de calidad de datos de Monte Carlo, Gartner predice que el 30% de las organizaciones no logrará llevar a cabo con éxito iniciativas impulsadas por datos debido a una mala calidad de los mismos, mientras que el 41% de las organizaciones lucha por gestionar más de 1,000 fuentes de datos. A esa escala, la verificación manual deja de ser una disciplina y se convierte en una expresión de deseos.
Qué métricas cambian en la práctica
Un equipo maduro no se pregunta: "¿Es bueno este conjunto de datos?". Se hace preguntas operativas más acotadas:
¿Están los datos lo suficientemente frescos (fresh enough) para la decisión que respaldan?
¿Llegaron los campos obligatorios para la carga actual?
¿Cumplen los registros con las reglas de negocio y de formato?
¿Cambió de forma un origen sin un Release coordinado?
¿El problema es local o sistémico en todos los dominios y pipelines?
Esas preguntas son las que transforman la calidad de los datos de un lenguaje de governance a un trabajo de ingeniería.
Regla práctica: si no puede asociar una métrica a un modo de falla, aún no tiene una estrategia de monitoreo. Tiene una política.
Esta es también la razón por la que el trabajo de calidad de datos comienza a superponerse con la telemetría operativa. Los equipos que ya dominan la gestión centralizada de registros suelen adaptarse más rápido, porque ya entienden de líneas base, ruido de alertas, correlación de eventos y propiedad de incidentes. Las métricas de datos necesitan el mismo modelo operativo.
Un buen sistema no busca la perfección. Mide lo que importa, en la capa adecuada, con umbrales vinculados a las consecuencias comerciales.
Explicación de las seis dimensiones principales de la calidad de datos
El vocabulario estándar sigue importando. La precisión, integridad, consistencia, Timeliness, validez y unicidad son las seis dimensiones más utilizadas en la práctica y se alinean con el marco ISO/IEC 25012:2008 resumido en esta encuesta.
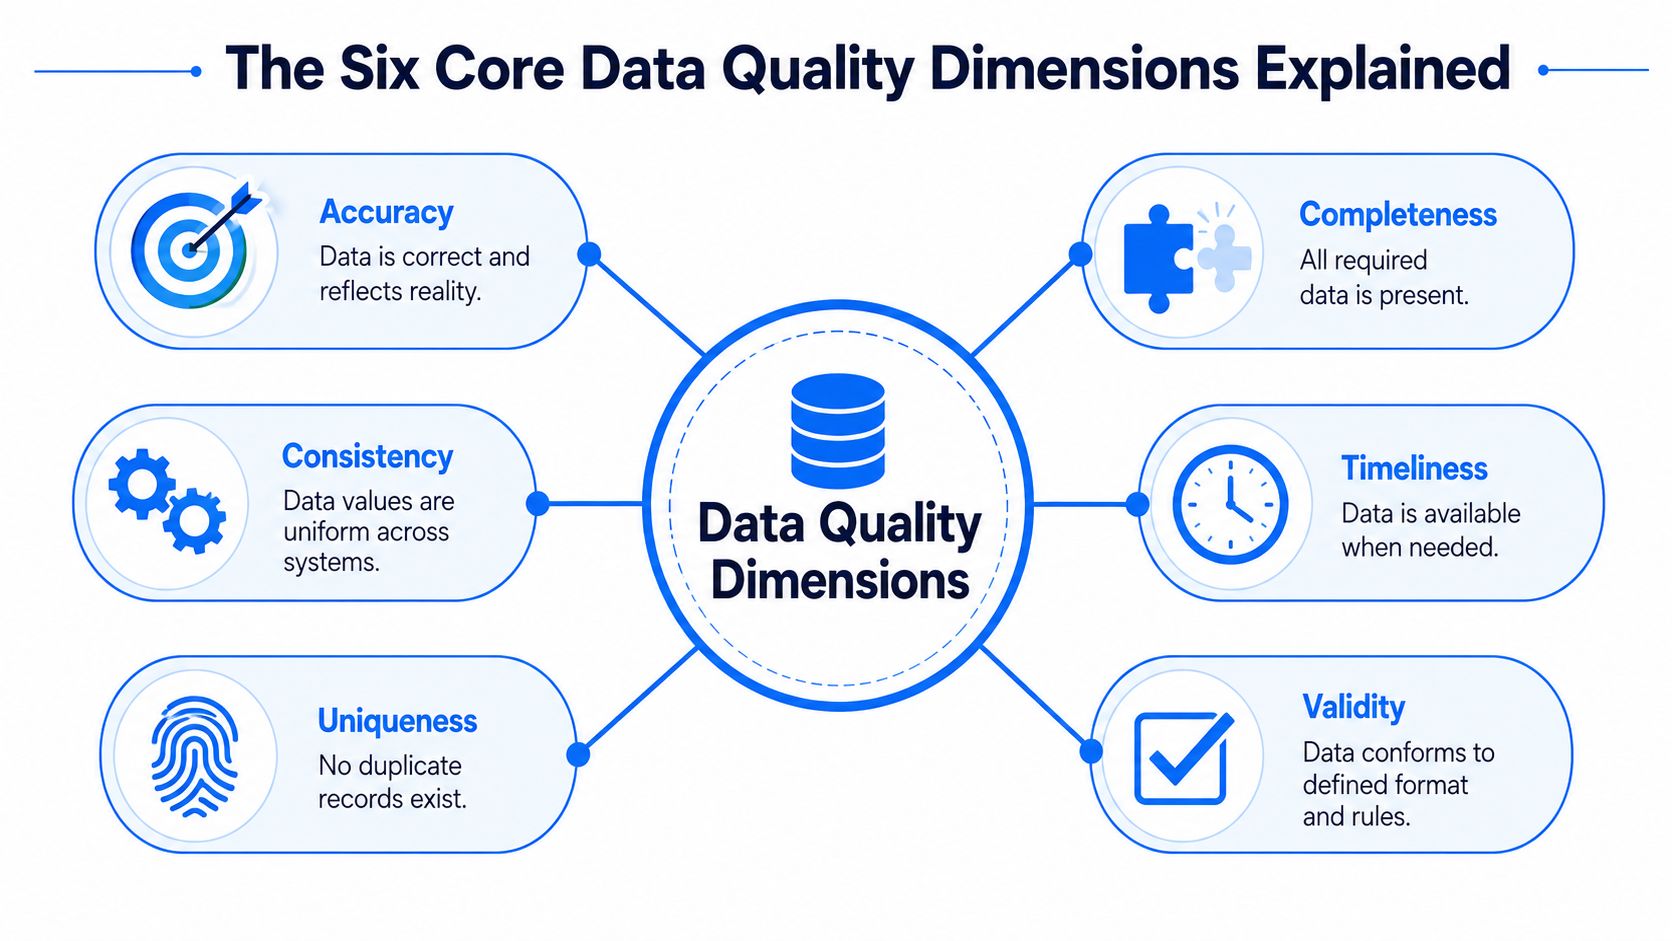
Si desea una referencia complementaria sobre los detalles de implementación, esta guía sobre las dimensiones de la calidad de datos y cómo medirlas a escala es útil. Sin embargo, lo importante es asociar cada dimensión a una pregunta de negocio.
Precisión
La precisión plantea si los datos reflejan la realidad de lo que pretenden describir.
La dirección de un cliente puede estar completa, tener un formato válido y, aun así, ser incorrecta. El precio de un producto puede estar presente en todas las tablas descendentes y, aun así, no coincidir con la fuente aprobada. Las fallas de precisión son costosas porque a menudo parecen estructuralmente sanas.
Pregunta de negocio: ¿Podemos confiar en que este valor representa la realidad?
Integridad
La integridad mide si los datos requeridos están presentes.
Esta es la dimensión con la que los equipos se topan primero porque los valores nulos son fáciles de contar y de explicar. Si un pedido no tiene dirección de envío, el almacén no puede despacharlo. Si a la historia clínica de un paciente le falta un atributo obligatorio, los flujos de trabajo de atención y las pistas de auditoría se rompen rápidamente.
Pregunta de negocio: ¿Tenemos todos los campos necesarios para ejecutar el proceso?
Consistencia
La consistencia verifica si un mismo hecho se mantiene alineado en todos los sistemas y transformaciones.
Muchos problemas empresariales se ocultan en situaciones como esta. Una plataforma de facturación dice que un cliente está activo. El CRM dice que está inactivo. El almacén de datos une ambos y expone el valor que llegó de último. Ninguno de esos registros es técnicamente nulo o inválido, pero la empresa no puede actuar con confianza ante estados contradictorios.
Pregunta de negocio: ¿Significa lo mismo la misma entidad en todas partes?
Mucha de la "confusión analítica" es en realidad un problema de consistencia disfrazado de semántica.
Timeliness
La Timeliness se refiere a si los datos llegan cuando se necesitan para su uso.
Una tabla de ingresos diarios que llega al mediodía puede ser adecuada para la planificación mensual, pero inaceptable para una reunión operativa a las 8:30. La Timeliness siempre es contextual. Los datos tardíos se convierten en datos malos cuando no llegan a tiempo para la toma de decisiones.
Pregunta de negocio: ¿Estuvieron los datos disponibles dentro del margen de tiempo que requiere el proceso?
Validez
La validez comprueba si los valores se ajustan a las reglas, dominios y formatos establecidos.
Una columna de fecha podría contener texto. Una columna de estado podría incluir valores fuera del conjunto aprobado. Un registro puede cumplir con el tipo de esquema y, aun así, violar la lógica de negocio, como una fecha de finalización anterior a la fecha de inicio.
Pregunta de negocio: ¿Cumple este registro con las reglas que acordamos?
Unicidad
La unicidad plantea si los registros aparecen una sola vez allí donde deberían aparecer una sola vez.
Los clientes, facturas o transacciones duplicados generan problemas visibles rápidamente. Los conteos se inflan, las uniones multiplican las filas y los equipos terminan debatiendo si el problema está en el origen o en el modelo. Las verificaciones de unicidad deben existir tanto a nivel de clave técnica como de entidad de negocio, porque no todos los duplicados comparten el mismo identificador.
Pregunta de negocio: ¿Estamos contando algo una sola vez o varias veces?
Este es el atajo operativo que utilizo:
Dimensión | Principal modo de falla | Síntoma de negocio típico |
|---|---|---|
Precisión | Valor incorrecto | Mala decisión o acción incorrecta |
Integridad | Valor faltante | Flujo de trabajo roto o brecha de auditoría |
Consistencia | Valor en conflicto | Disputas de KPI entre equipos |
Timeliness | Valor tardío | Dashboards desactualizados y acción retrasada |
Validez | Valor que rompe las reglas | Falla del proceso o registro rechazado |
Unicidad | Valor duplicado | Conteos inflados y uniones ruidosas |
Cómo calcular las métricas principales de calidad de datos
Las definiciones solo ayudan si se pueden transformar en verificaciones repetibles. El punto de partida más confiable es calcular un conjunto pequeño de métricas en el almacén de datos, almacenar los resultados en una tabla de métricas y analizar su tendencia a lo largo del tiempo.
Comience con un contrato de métricas
Antes de escribir en SQL, defina cuatro cosas para cada métrica:
Alcance del conjunto de datos. ¿Qué tabla, partición o dominio de negocio está midiendo?
Lógica. ¿Qué cuenta exactamente como aprobado o fallido?
Responsable. ¿Quién clasifica la alerta cuando la métrica cambia?
Impacto de negocio. ¿Qué se rompe si esta métrica cae fuera de la tolerancia?
Sin ese contrato, los equipos terminan discutiendo después de la alerta, no antes de ella.
Una tabla de métricas simple suele verse así:
column_name | purpose |
|---|---|
metric_date | fecha en que se ejecutó la verificación |
dataset_name | tabla o modelo medido |
metric_name | completeness, duplicate_rate, freshness_lag |
metric_value | resultado numérico |
threshold_status | aprobado, advertencia, fallo |
dimension | completeness, validity, timeliness, etc. |
Fórmulas SQL que los equipos realmente usan
La integridad es el punto de partida más claro. En el material de origen de Alation, la integridad se define como el porcentaje de valores no nulos en campos obligatorios frente al recuento total de filas, y los datos de referencia en salud y finanzas muestran que los conjuntos de datos con menos del 97% de integridad generan un 40% más de hallazgos de cumplimiento normativo en esos sectores, según el artículo de Alation sobre métricas de calidad de datos.
Una fórmula básica es:
Integridad = (valores obligatorios no nulos / filas totales) * 100
Ejemplo:
Para múltiples columnas requeridas, no haga un promedio a ciegas. Calcule cada campo por separado y calcule también un puntaje de integridad a nivel de registro si el flujo de trabajo depende de que todos los campos estén presentes.
La unicidad suele medirse como la proporción de filas que no violan una clave esperada.
Unicidad = 1 - (filas duplicadas / filas totales)
Si la entidad de negocio puede duplicarse bajo diferentes identificadores técnicos, agregue más adelante una coincidencia difusa o basada en reglas. Comience primero con los duplicados estrictos.
La validez necesita reglas explícitas. No confíe únicamente en los tipos de esquema.
Para modelos de investigación o de salud, los equipos suelen necesitar librerías de reglas específicas para su dominio. En ese entorno, OMOPHub para la validación de datos OMOP es una referencia relevante porque se centra en flujos de trabajo de validación estructurados en lugar de consejos genéricos de calidad.
La Timeliness a menudo se expresa mejor como desfase (lag) que como un porcentaje.
Si necesita un patrón de diseño de reglas de validez más allá de los fragmentos de SQL, esta guía introductoria sobre qué significa la Data Validation en los sistemas operativos es un buen complemento.
Los umbrales pertenecen a los casos de uso, no a las tablas
El error común es definir un solo umbral por dimensión y aplicarlo en todas partes. Eso falla rápidamente.
Una tabla de identidad de clientes merece reglas de integridad más estrictas que un archivo histórico de clics. El conjunto de características de un modelo de riesgo puede tolerar algunos datos de enriquecimiento tardíos, pero no cambios de esquema. Un extracto financiero puede aceptar una pequeña variación en el recuento de filas, pero ni un solo código de entidad legal inválido.
Mida la misma dimensión de manera diferente cuando el costo de una falla sea distinto. Eso no es inconsistencia. Es diseño responsable.
El almacén de datos debe calcular la métrica. El proceso de negocio debe determinar el umbral.
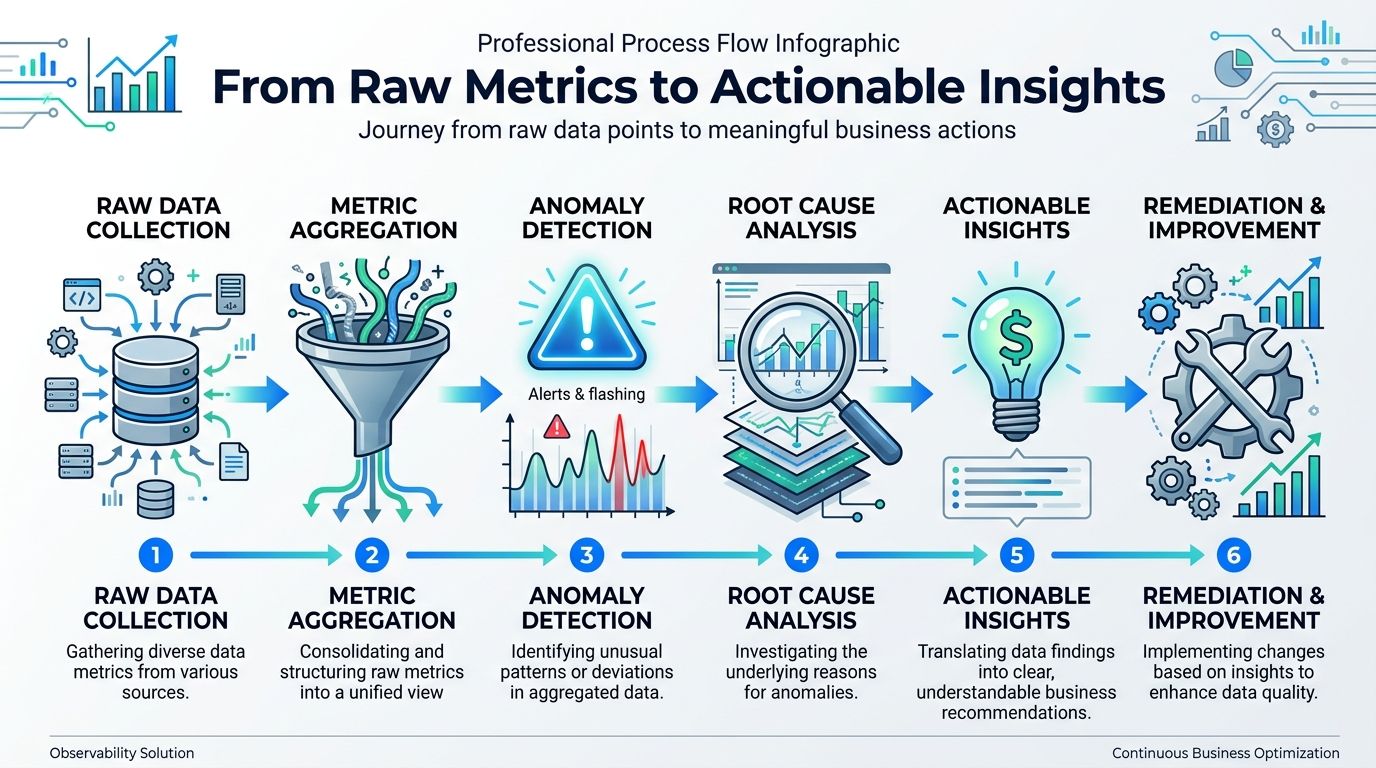
De métricas brutas a información accionable
Una métrica por sí sola es solo un número en una tabla. Los equipos necesitan una lógica de interpretación a su alrededor. Eso significa umbrales, detección de anomalías, enrutamiento y suficiente contexto para decidir si el problema es estético u operativo.
Umbrales en los que la gente confiará
Los umbrales estáticos funcionan bien cuando la regla es clara y absoluta. Los campos obligatorios, las enumeraciones aceptadas y las verificaciones de unicidad de claves suelen encajar en este modelo.
Los umbrales dinámicos ayudan cuando la métrica varía de forma natural. El número de filas cambia con la estacionalidad. Los patrones de actualización varían según la programación. Los cambios en la distribución pueden ser normales algunos días y sospechosos otros.
Una división práctica se ve así:
Use umbrales estáticos para reglas de negocio y campos sensibles para Compliance.
Use líneas base aprendidas para volumen, frescura y anomalías de comportamiento.
Use verificaciones de tendencias cuando el deterioro progresivo importe más que una sola ejecución fallida.
Alertas que no entrenan a los equipos para ignorar alertas
El sistema de alertas falla cuando cada pequeña desviación notifica a alguien.
Las buenas alertas de calidad de datos incluyen contexto desde la primera vez que se activan. Quien responda debería ver el conjunto de datos, la métrica que falla, la tendencia reciente, el posible cambio ascendente sospechoso y qué dashboards, modelos o procesos operativos dependen de ese recurso. Si la alerta solo dice "cayó la integridad", el encargado de resolverlo aún debe realizar una clasificación básica de forma manual.
He visto que una regla simple funciona muy bien en equipos maduros:
Tipo de alerta | Cuándo usarla | Respuesta esperada |
|---|---|---|
Fallo crítico | Violación de reglas con impacto comercial inmediato | Abrir un incidente y detener el uso descendente si es necesario |
Advertencia | Degradación sin un riesgo claro para la toma de decisiones todavía | Investigar durante el horario laboral |
Seguimiento de tendencia | Deterioro lento | Agregar al backlog y revisar con el responsable |
La forma más rápida de perder la confianza en un sistema de monitoreo es enviar alertas técnicas sin contexto operativo.
Muestreo y establecimiento de líneas base en entornos desordenados
No todas las tablas merecen el mismo nivel de monitoreo. Algunas son críticas, otras intermedias y otras desechables.
Para una cobertura amplia, comience con señales de bajo costo. Los recuentos de filas, la frescura, los patrones de nulos, los cambios de esquema y las comprobaciones de duplicados revelan una gran parte de las fallas reales. Agregue Data Validation a nivel de registro allí donde la lógica de negocio sea estricta. Tome muestras cuando el costo sea un factor importante, pero hágalo de manera intencionada. Por ejemplo, valide cargas completas en conjuntos de datos de nivel "gold" y analice perfiles de muestras representativas en modelos de menor nivel.
El establecimiento de líneas base asistido por IA ayuda principalmente cuando el entorno es demasiado ruidoso para límites ajustados manualmente. Esto es especialmente útil en organizaciones con muchas fuentes y patrones de actualización desiguales. El objetivo no es eliminar el juicio humano, sino reservar la atención de las personas para las desviaciones que se vean sustancialmente distintas al comportamiento normal del sistema.
Operacionalización de la calidad de datos: un ejemplo de dashboard de KPI
Un buen dashboard no es solo una galería de gráficos. Es una superficie de trabajo para la respuesta a incidentes, la revisión de tendencias y la asignación de responsabilidades.
Comience la página con un resumen de salud que responda de inmediato a tres preguntas: qué está fallando ahora, qué está empeorando y qué necesita un responsable hoy.
Qué muestra el dashboard de un vistazo
La primera fila suele presentar la vista operativa:
Incidentes abiertos por gravedad para que los ingenieros de guardia sepan por dónde empezar
Estado de frescura de conjuntos de datos críticos para visibilizar cargas tardías o faltantes
Flujo de cambios de esquema para identificar columnas agregadas, eliminadas o con tipos de datos modificados
Principales métricas en deterioro en un periodo de revisión reciente
Luego, agregue la vista del analista. Las líneas de tendencia de integridad, tasa de duplicados, fallas de validez y retraso de frescura ayudan a los equipos a distinguir el ruido de un evento único frente a un declive constante. Las tablas de clasificación también son útiles; una vista de las "tablas más inestables" a menudo genera una mejor priorización que un historial interminable de problemas.
Una métrica merece un trato especial: el tiempo de inactividad de los datos (data downtime). Según el análisis de Monte Carlo sobre métricas de calidad de datos, las organizaciones que realizan un seguimiento de este tiempo descubren que el 68% de los incidentes se originan por una deriva silenciosa de esquemas o violaciones de frescura, y estos incidentes pueden causar una reducción del 15% al 25% en la precisión del modelo descendente en un plazo de 48 horas. Por eso, el dashboard debe mostrar no solo si falló una verificación, sino también cuánto tiempo ha dejado de ser confiable el conjunto de datos afectado.
Qué hace cada equipo con él
Los ingenieros de datos necesitan una sección técnica. Les interesan las verificaciones fallidas, la duración del incidente, el linaje y las probables causas en el flujo ascendente.
Los ingenieros de analítica y desarrolladores de BI necesitan una sección semántica. Quieren saber si un modelo confiable sigue cumpliendo con las expectativas de las reglas de negocio y si los dashboards deben anotarse, pausarse o reconstruirse.
Los responsables de negocio y de governance necesitan una sección de riesgos. Quieren saber qué dominios fallan repetidamente, qué controles son débiles y si los problemas se resuelven dentro de los plazos acordados.
Un breve recorrido por el producto ayuda a consolidar ese modelo operativo:
Los mejores dashboards de KPI no se limitan a mostrar indicadores en rojo y verde. Muestran la tendencia, el radio de impacto y el responsable. Eso es lo que transforma el monitoreo en un sistema que la gente realmente utiliza en la práctica bajo presión, y no solo durante las demostraciones.
Desafíos avanzados sin respuesta en las métricas estándar
La mayoría de las guías se detienen en las seis dimensiones. En producción, es ahí donde comienzan las preguntas más difíciles.
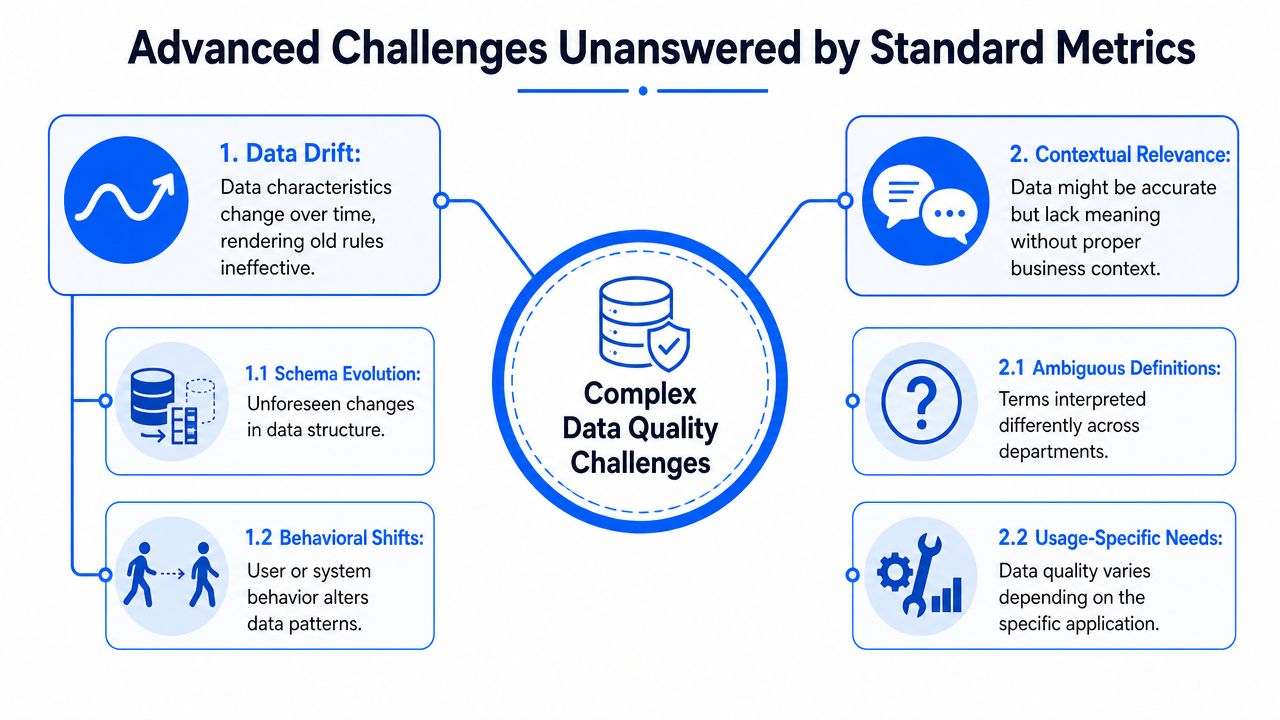
Microerrores que se ocultan dentro de promedios buenos
Las métricas agregadas pueden parecer saludables mientras un defecto minúsculo causa un daño desproporcionado.
Unas pocas filas incorrectas en una tabla de clientes pueden desviar pedidos de alto valor. Un pequeño grupo de registros mal formados puede romper una sola característica descendente utilizada por un modelo. La integridad, validez y unicidad globales aún pueden parecer aceptables porque el puntaje agregado diluye el impacto.
Ese problema también aparece en los debates de los profesionales del sector. Un hilo de ingeniería de datos sobre errores de microimpacto describe lo difícil que es cuantificar el impacto de fallas que afectan solo a unas pocas filas pero que, aun así, desencadenan problemas graves en los procesos descendentes.
La solución no es otro promedio. Son las verificaciones segmentadas y conscientes del impacto.
Utilice patrones como estos:
Monitoreo de campos críticos para columnas cuya falla bloquea un flujo de trabajo, incluso si solo involucra a un puñado de filas
Métricas basadas en segmentos por región, canal, línea de producto o nivel de cliente para que una falla local no desaparezca dentro de una tasa de aprobación global
Validación sensible a la ruta que evalúa los registros con mayor probabilidad de afectar rutas reguladas, financieras o críticas para los modelos
Métricas de síntomas de negocio, como transacciones rechazadas, registros imposibles de unir o registros bloqueados para su despacho
Una métrica debe reflejar el costo de estar equivocado, no solo el conteo de filas erróneas.
Por qué un puntaje único es más difícil de lo que parece
Los líderes a menudo piden un número único. Es una solicitud razonable. Quieren ver la tendencia, comparar y priorizar sin tener que leer diez gráficos.
La dificultad radica en la ponderación.
Una tabla de marketing retrasada y una fila de pago duplicada no deberían aportar lo mismo a un puntaje único. Un problema de integridad en un archivo de referencia no conlleva el mismo riesgo que un problema de validez en un dominio de identidad de clientes. Además, las ponderaciones estáticas envejecen mal. Los procesos de negocio cambian, las entradas de los modelos evolucionan y lo que antes era una advertencia puede convertirse en un bloqueo crítico.
Por lo tanto, un puntaje de calidad de datos útil debe ser contextual. Requiere ponderaciones adaptadas al dominio, multiplicadores de impacto comercial y recalibraciones periódicas. También debería separar la salud descriptiva del riesgo predictivo. De lo contrario, se obtiene un número vistoso muy amigable para ejecutivos que dice muy poco a los operadores.
Un modelo práctico consiste en calificar en tres niveles:
Capa | Qué responde |
|---|---|
Puntaje de métrica | Si esta comprobación específica se aprobó, se degradó o falló |
Puntaje del conjunto de datos | Si este recurso es seguro para el uso previsto |
Puntaje de riesgo de dominio | Qué área de negocio presenta la mayor exposición operativa |
Esto no resolverá todos los casos, pero evita el peor error: pretender que un puntaje único universal represente igual de bien cada caso de uso.
Cómo las plataformas de Data Observability automatizan las métricas de calidad
Las comprobaciones manuales de SQL son un excelente punto de partida. Sin embargo, no bastan cuando se trabaja con numerosas fuentes, esquemas en constante evolución y equipos que necesitan un monitoreo continuo en lugar de una revisión semanal.
Ahí es donde las plataformas de Data Observability ganan su lugar. Automatizan la recolección de métricas, establecen líneas base del comportamiento normal, detectan anomalías, realizan un seguimiento de la frescura y enrutan los problemas con el contexto suficiente para una rápida clasificación. También reducen la carga de mantenimiento derivada de conjuntos de reglas creados manualmente y dispersos en tareas de Airflow, pruebas de dbt, procedimientos del almacén de datos y parches en la capa de BI.
Las plataformas más sólidas combinan múltiples modalidades de control:
Validación basada en reglas para la lógica de negocio esencial
Detección de anomalías para desviaciones que nadie modeló explícitamente
Monitoreo de Timeliness para llegadas tardías o faltantes
Seguimiento de esquemas para cambios estructurales que rompen de manera inesperada las premisas de los procesos descendentes
Analítica histórica para identificar el deterioro progresivo
Si está evaluando esta categoría, un punto de partida de utilidad es esta explicación sobre por qué la Data Observability es crucial para la gestión de datos moderna. Un ejemplo en este espacio es digna, que combina el cálculo de métricas en la base de datos, la detección de anomalías, el monitoreo de la frescura, la validación a nivel de registro y el seguimiento de esquemas en entornos controlados por el cliente.
La meta práctica no es tener más dashboards. Es tener menos sorpresas, análisis de causa raíz más rápidos y una asignación de responsabilidades más clara cuando los datos dejan de ser confiables.
Si su equipo está intentando pasar de verificaciones ad hoc a una práctica operativa y monitoreada de calidad de datos, vale la pena evaluar digna. Está diseñada para equipos que necesitan detección de anomalías, validación, monitoreo de frescura y seguimiento de esquemas sin trasladar los datos de producción fuera de su propio entorno.


