Framework de Data Observability: Una guía práctica para 2026
|
6
minuto de lectura
El consejo más popular sobre un marco de Data Observability es también el más incompleto: desplegar los cinco pilares, conectar las alertas y decir que la plataforma es observable. La frescura, el volumen, la distribución, el esquema y el linaje son señales necesarias, pero no le dicen a quien debe actuar qué tan rápido hacerlo, o si una anomalía es importante para el negocio.
Un panel de control puede mostrar un pipeline roto mientras los ejecutivos siguen recibiendo cifras incorrectas. Un marco real conecta la detección con la propiedad, el Data Governance, la respuesta a incidentes y el control de costos. Esa distinción importa a medida que la Data Observability se mueve hacia la planificación empresarial general. Un estudio de mercado de 2026 estima que la categoría crecerá de USD 3.51 mil millones en 2026 a USD 6.03 mil millones para 2031, mientras que otro proyecta un crecimiento de USD 2.90 mil millones en 2025 a USD 8.79 mil millones para 2035. Ambas estimaciones sitúan al mercado en aproximadamente un 11% CAGR, evidencia de que la Observability se ha convertido en una categoría de software sostenida en lugar de una práctica experimental de ingeniería de datos (análisis de mercado de SNS Insider).
Índice de contenidos
Por qué la mayoría de los programas de Data Observability se detienen en las cinco señales
La detección no es lo mismo que la respuesta
La capa de governance es el sistema que falta
Qué es en realidad un marco de Data Observability
Cuatro capas hacen que el marco sea utilizable
Las cinco señales principales y qué detecta cada una
Roles y Governance dentro del marco
Poner la responsabilidad en el activo
Puntos de integración en pipelines, almacenes y BI
Llevar el contexto al almacén y a la capa de BI
Un modelo de madurez de cuatro etapas para autoevaluarse
Cuatro etapas de madurez operativa
Un mapa de ruta inicial de 90 días para 2026
Días 1 al 30, establecer la responsabilidad
Días 31 al 60, añadir detección ligera
Días 61 al 90, cerrar el ciclo
Preguntas comunes que los compradores y arquitectos aún se hacen
¿Cuánto debería costar desarrollar versus comprar?
¿Qué capacidades del proveedor importan?
¿Cuánto tiempo toma lograr una cobertura significativa?
Por qué la mayoría de los programas de Data Observability se detienen en las cinco señales
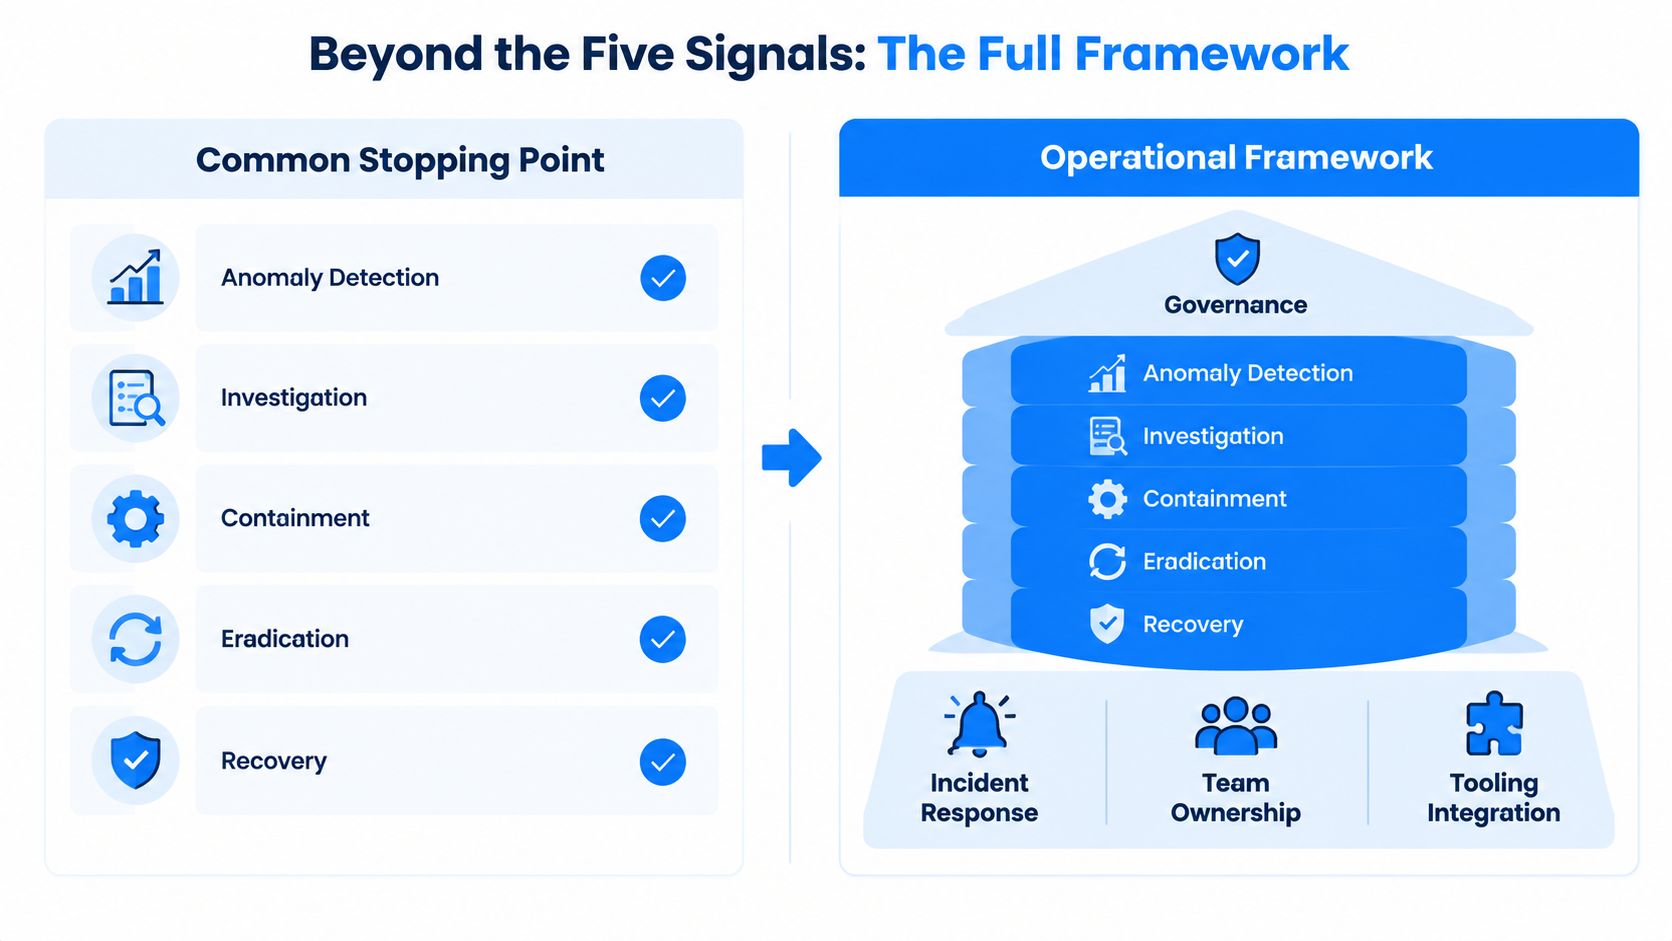
Las cinco señales a menudo se confunden con un marco terminado. Son únicamente la capa de telemetría. Sin disciplina operativa, la telemetría produce un fallo bien instrumentado.
La frescura, el volumen, la distribución, el esquema y el linaje pueden aparecer en verde o rojo en un panel de control mientras la organización aún carece de un propietario asignado, ruta de escalada, regla de supresión o guía de resolución. Sigue un patrón de fallo familiar: llega una alerta a Slack, nadie tiene una expectativa de triaje definida, el propietario del producto de datos asume que la ingeniería se está encargando y el incidente permanece abierto hasta que una parte interesada detecta un número incorrecto.
La detección no es lo mismo que la respuesta
Una señal responde a una sola pregunta estrecha. ¿Llegó la tabla a tiempo? ¿Cambió el volumen de filas? ¿Se desvió el esquema? No responde a las preguntas operativas que establecen el impacto en el negocio:
¿Quién es el propietario del activo?
¿Quién realiza el triaje de la alerta?
¿Qué consumidores se ven afectados?
¿Qué tiempo de respuesta se aplica?
¿Debe el pipeline ponerse en cuarentena, reintentar o continuar?
¿Qué causa raíz recurrente necesita una solución arquitectónica?
Esa brecha permite que un entorno rico en señales continúe enviando números incorrectos a los ejecutivos. La organización tiene visibilidad, pero no un acuerdo sobre la acción que esa visibilidad debería desencadenar.
Una infraestructura de monitoreo más pequeña puede funcionar mejor cuando la propiedad es explícita. Un conjunto de datos crítico con un responsable documentado, una expectativa de nivel de servicio, un canal de escalada y una guía de resolución probada es más útil que cientos de monitores sin propietario. El marco gana su lugar al acortar el camino desde la anomalía hasta la acción responsable.
Regla práctica: Una alerta sin propietario, gravedad ni ruta de respuesta es una notificación, no un control operativo.
La capa de governance es el sistema que falta
El governance determina qué desviaciones interrumpen el trabajo y cuáles pertenecen a un informe de tendencias. Define la criticidad, la variación aceptable, las ventanas de mantenimiento, las reglas de supresión, la retención de pruebas y los niveles de escalada. También registra si un incidente recurrente refleja un problema temporal de origen o un defecto de diseño en el pipeline.
La evolución de la categoría refleja este cambio de responsabilidad. Gartner publicó su primera Guía de Mercado para Herramientas de Data Observability el 23 de febrero de 2026, reconociendo la Data Observability como una categoría de software empresarial distinta que cubre flujos de trabajo de detección de anomalías, alertas, linaje y respuesta a incidentes (discusión de Monte Carlo sobre la guía de Gartner). El cambio importante es práctico: las empresas pueden tratar la Observability como una capacidad de arquitectura y governance, en lugar de una colección de scripts de monitoreo.
Qué es en realidad un marco de Data Observability
Una definición práctica comienza con el propósito operativo. Gartner describe las herramientas de Data Observability como una ayuda para que las organizaciones comprendan el estado y la salud de los datos, los pipelines, la infraestructura y el costo operativo financiero en entornos distribuidos a través del monitoreo continuo, el seguimiento, el envío de alertas, el análisis y la resolución de problemas (definición de herramientas de Data Observability de Gartner).
Traducido a términos de ingeniería, un marco de Data Observability es un sistema en capas que convierte la telemetría de datos en acción humana gobernada. Combina señales de detección, metadatos contextuales, propiedad asignada, procesos de respuesta y políticas que determinan qué anomalías importan y qué sucede después. El marco se sitúa entre la telemetría bruta y las decisiones operativas, de manera similar a como un sistema operativo coordina las señales de hardware, las aplicaciones, los permisos y las acciones del usuario.

Cuatro capas hacen que el marco sea utilizable
Cada implementación neutral respecto al proveedor necesita cuatro capas:
Capa de señal: Timeliness, volumen, distribución, esquema, linaje y cualquier métrica de calidad o plataforma específica del dominio.
Capa de contexto: Criticidad del conjunto de datos, Data Contracts, propiedad, dependencias descendentes, cambios recientes, sensibilidad y uso comercial.
Capa de respuesta: Enrutamiento de alertas, creación de incidentes, triaje, cuarentena, remediación, revisión posterior al incidente y captura de evidencia.
Capa de governance: Políticas para SLAs, gravedad, supresión, acceso, retención, escalada y gestión de riesgos recurrentes.
Las cinco señales pertenecen a la primera capa. Se vuelven operativas solo cuando las otras tres capas proporcionan significado y consecuencias. Para una introducción concisa sobre cómo reducir el riesgo con Data Observability, la conclusión útil es que la detección es valiosa porque respalda una intervención más temprana y mejor informada, no porque agregue otro panel de control.
La arquitectura también debe coincidir con el entorno. En entornos regulados, los equipos necesitan controles que operen en sistemas en la nube, híbridos y locales, que preserven la evidencia de auditoría y que eviten el movimiento innecesario de datos sensibles. Se puede armar un marco a partir de los orquestadores existentes, las capacidades del almacén, los catálogos y los sistemas de incidentes, o bien entregarse a través de una plataforma dedicada. El diseño importa más que el nombre del proveedor.
Los equipos que evalúan una plataforma pueden utilizar las capacidades de Data Observability de digna como un ejemplo de enfoque modular que combina detección de anomalías, Timeliness, validación y seguimiento de esquemas con ejecución en la base de datos.
Las cinco señales principales y qué detecta cada una
Las cinco señales siguen siendo la base técnica correcta, siempre que cada una esté vinculada a un modo de fallo y a una política de respuesta. Un marco maduro no recopila métricas solo porque están disponibles. Elige mediciones que puedan detectar cambios significativos cerca de los datos.
La frescura mide el tiempo de llegada con respecto a un cronograma esperado o SLA. Una marca de tiempo de límite superior puede exponer trabajos estancados, particiones eliminadas o limitaciones de API que congelan la ingesta. Utilice percentiles en lugar de promedios cuando el retraso varíe, ya que un promedio puede ocultar eventos en la cola tardía que afectan a los consumidores. Una guía práctica de Timeliness debe distinguir entregas tardías, faltantes e inesperadamente tempranas, tal como se explica en métricas y monitoreo de la Timeliness de los datos.
El volumen compara los recuentos de filas, tamaños de bytes o tamaños de particiones con los rangos esperados. Detecta cargas truncadas, escrituras duplicadas causadas por reintentos y bucles de relleno silenciosos. Un rango debe tener en cuenta el crecimiento normal y la estacionalidad, de lo contrario, el monitor convierte el cambio comercial de rutina en ruido.
La distribución examina el comportamiento estadístico en campos numéricos y las frecuencias de categoría en las dimensiones. Las estadísticas de ventana móvil y las puntuaciones Z pueden revelar desviaciones que el volumen total pasa por alto, incluidos errores de mapeo ascendentes o cambios en la calibración del sensor. Las comprobaciones de distribución necesitan líneas base específicas del conjunto de datos porque las métricas de producción pueden ser estacionales, volátiles, multivariadas y verse afectadas por cambios de régimen. El punto de referencia BOOM de Datadog ilustra este desafío de modelado con 350 millones de observaciones en 2,807 series temporales de producción del mundo real, evaluadas en múltiples horizontes de pronóstico (discusión sobre el benchmark BOOM de Datadog).
El esquema valida la estructura frente a un contrato esperado. Las columnas agregadas o eliminadas, los tipos de datos modificados y la anulabilidad alterada pueden romper las transformaciones sin detener la ingesta. La desviación del esquema es particularmente peligrosa cuando un equipo de origen cambia un campo de anulable a no anulable o elimina una columna que el SQL descendente todavía espera.
El linaje representa el gráfico de dependencias desde el origen hasta el consumo. Expone conjuntos de datos huérfanos, uniones rotas después de refactorizaciones y depreciaciones ascendentes no reportadas. El linaje a nivel de columna es especialmente útil cuando un campo modificado alimenta a un pequeño número de métricas críticas dentro de una tabla mucho más grande.
Señal | Modo de fallo detectado | Mecánica de detección |
|---|---|---|
Frescura | Llegadas tardías, faltantes, estancadas o inesperadamente tempranas | Retraso de marca de tiempo frente a un SLA, cronograma o línea base aprendida |
Volumen | Cargas truncadas, escrituras duplicadas y bucles de relleno | Comparación de recuento de filas, tamaño de bytes y tamaño de partición |
Distribución | Desviación estadística, errores de mapeo y cambios de categoría | Estadísticas de ventana móvil, análisis de frecuencia y puntuaciones Z |
Esquema | Campos agregados, eliminados, con cambio de tipo o que rompen el contrato | Comparación estructural frente a las expectativas registradas |
Linaje | Dependencias rotas, activos huérfanos y radio de impacto oculto | Continuidad del gráfico de dependencias y análisis de impacto |
Estas señales son relativamente sencillas de desplegar. Son más difíciles de mantener cuando cada tabla recibe expectativas idénticas. Clasifique los activos críticos por niveles, defina diferentes políticas de gravedad y deje que las anomalías de bajo valor se agrupen en informes en lugar de interrumpir a un ingeniero de guardia. El Data Governance, no la detección, es la parte costosa de hacer que la Observability sea útil.
Roles y Governance dentro del marco
Un marco sin propiedad es un panel de control al que nadie responde. El modelo operativo más limpio separa la detección, el triaje y la remediación, y luego hace que el traspaso sea explícito.
Los ingenieros de plataformas de datos o los ingenieros de confiabilidad del sitio (SRE) generalmente operan la infraestructura de monitoreo y detectan anomalías técnicas. Los propietarios de productos de datos realizan el triaje de esas anomalías porque comprenden el significado comercial del activo, los consumidores y el comportamiento aceptable. La remediación a menudo requiere tanto de ingenieros de datos, que corrigen los pipelines de ingesta o transformación, como de ingenieros de analítica, que corrigen la lógica métrica o los modelos semánticos.
Poner la responsabilidad en el activo
Las matrices RACI ayudan durante el lanzamiento, pero a menudo se deterioran después de las reorganizaciones. La propiedad debe residir en el Data Contract o en los metadatos del catálogo adjuntos al activo. Como mínimo, cada conjunto de datos crítico debe declarar:
Responsable de los datos: La persona o equipo responsable del producto de datos.
Expectativa de servicio: El comportamiento de frescura, integridad y disponibilidad en el que los consumidores pueden confiar.
Ruta de guardia: El canal o servicio de incidentes que recibe alertas accionables.
Criticidad: El nivel de negocio que determina la gravedad y la escalada.
Guía de resolución: Los primeros pasos de diagnóstico y remediación.
Un incidente P1 que afecte a un panel de control ejecutivo debe omitir la cola estándar y llegar a una persona de guardia definida en un plazo de 15 minutos. Esa expectativa de respuesta es una política operativa, no una propiedad de la herramienta de detección. La política también debe especificar quién puede poner en cuarentena los datos, quién aprueba un relleno y quién se comunica con los consumidores.
Módulo | Propietario de detección | Propietario de triaje | Propietario de remediación |
|---|---|---|---|
Frescura de ingesta | Plataforma de datos o SRE | Propietario del producto de datos | Ingeniero de datos y propietario del origen |
Contrato de esquema | Equipo de ingesta o plataforma | Propietario del producto de datos | Ingeniero de origen e ingeniero de datos |
Distribución métrica | Operador de Observability | Ingeniero de analítica | Ingeniero de analítica e ingeniero de datos |
Impacto del linaje | Equipo de catálogo o plataforma | Responsable y propietarios afectados | Equipos de ingeniería propietarios |
Flujo de incidentes | SRE u operaciones de datos | Comandante de incidentes | Solucionador técnico asignado |
Los fallos comunes son predecibles. Las capas de ingesta a menudo no tienen un propietario duradero, las reorganizaciones dejan activos huérfanos y el traspaso entre la ingeniería de datos y la ingeniería de analítica permite que la desviación semántica persista porque cada grupo asume que el otro es el propietario de la métrica. Un modelo claro de roles de gobierno de datos ayuda, pero el contrato y la ruta de escalada deben aplicarse en las operaciones diarias.
Puntos de integración en pipelines, almacenes y BI
La Observability solo funciona donde se conecta la telemetría. Un marco que monitorea el almacén pero ignora la ingesta, la orquestación, los modelos semánticos o las rutas de ETL inverso tiene puntos ciegos que se confunden con la confiabilidad.
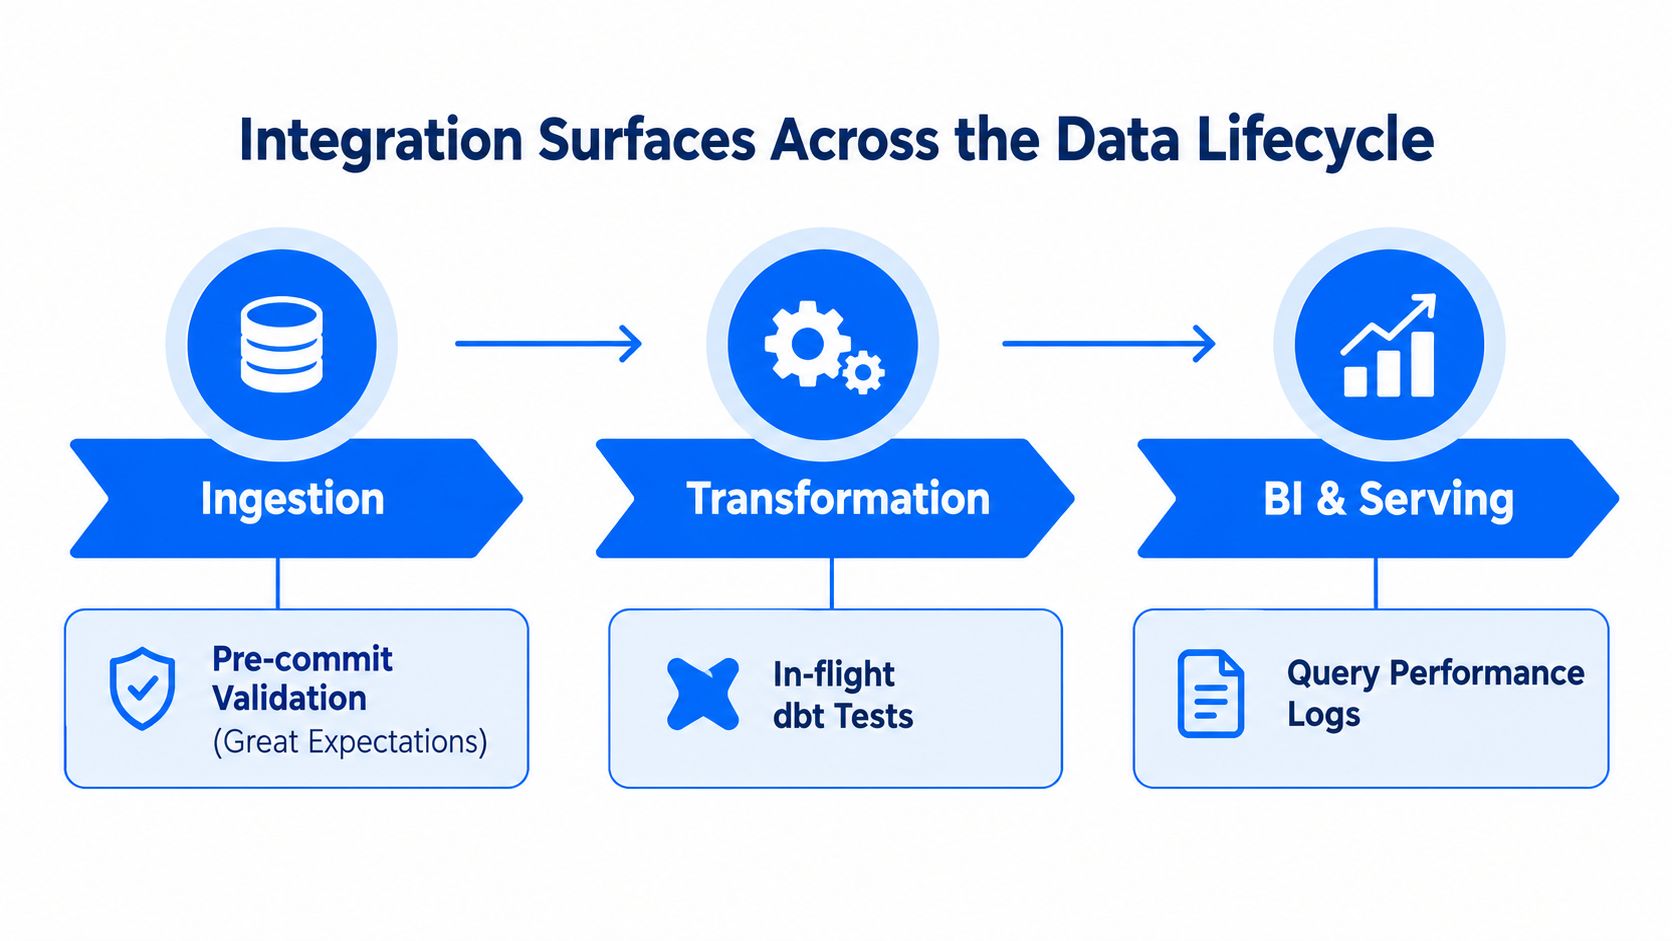
En la ingesta, adjunte la validación de esquema previa a la confirmación (pre-commit) a los adaptadores de origen y a las comprobaciones de despliegue. Great Expectations puede validar expectativas explícitas, mientras que la comparación de esquemas puede comparar las estructuras entrantes con los contratos registrados. Emita el resultado como un evento de validación que contenga el activo, la versión, los campos modificados y el contexto del despliegue. La alerta de consumo debe enrutar los cambios disruptivos al origen y a los propietarios descendentes antes de que la nueva estructura llegue a producción.
Durante la transformación, use pruebas dbt, sensores Airflow, comprobaciones de activos Dagster o tiempos de espera Prefect en el punto donde el pipeline sabe si una tarea se completó y si su salida es utilizable. Emita el estado de ejecución, la duración, la marca de tiempo de salida, el recuento de filas y el contexto del fallo en un almacén de telemetría compartido. Un fallo de orquestación debería crear un único incidente con contexto de dependencia, en lugar de alertas separadas para cada tarea descendente.
Llevar el contexto al almacén y a la capa de BI
El historial de consultas del almacén puede revelar cambios de distribución, consumo inusual, escaneos costosos y cargas de trabajo que omiten la ruta de transformación esperada. Estas métricas deben ubicarse junto a las señales de salud de los datos para que los equipos de la plataforma puedan relacionar una anomalía de datos con una consulta, despliegue o cambio de carga de trabajo reciente.
La capa de BI necesita reconciliación, no solo el estado de los pipelines. Compare los resultados de los modelos semánticos con las tablas de fuente de verdad, valide las definiciones métricas y monitoree si el estado de actualización de un panel coincide con su expectativa publicada. La lógica empresarial a menudo se desvía después de que las transformaciones brutas permanecen técnicamente sanas.
Las integraciones de linaje con DataHub, Atlan o Unity Catalog permiten calcular el radio de impacto rápidamente. Incluya scripts de SQL no administrados, flujos de ETL inverso en sistemas operativos y definiciones de capa semántica en el gráfico siempre que sea posible. Un enfoque de integración de almacén de datos debe preservar el flujo de métricas desde las comprobaciones de origen a través de los eventos de transformación y la reconciliación de BI.
El objetivo es una línea de tiempo de incidentes unificada. Un cambio de esquema, una tarea fallida, una anomalía de volumen, un panel de control afectado, el propietario y el evento de remediación deben aparecer como un único registro conectado en lugar de fragmentos repartidos en herramientas de monitoreo, catálogo, orquestación y chat.
Un modelo de madurez de cuatro etapas para autoevaluarse
Los modelos de madurez se convierten en ejercicios de vanidad cuando miden la instalación de herramientas en lugar del comportamiento operativo. La pregunta útil en cada etapa no es si existe una característica, sino si el equipo puede demostrar que las personas responden de manera consistente.
Cuatro etapas de madurez operativa
Etapa 1, Reactiva. Las partes interesadas descubren los problemas quejándose de los paneles de control o informes. Pregunte si el equipo mide el tiempo de resolución de incidentes en absoluto. Si nadie puede identificar cuándo comenzó un incidente, quién era el propietario o cuándo se cerró, el programa es reactivo independientemente de cuántas comprobaciones existan.
Etapa 2, Proactiva. El monitoreo automatizado de frescura y esquema cubre los pipelines críticos, pero la cobertura sigue siendo parcial y la propiedad es informal. Pregunte qué proporción de activos de nivel uno tiene un SLA declarado y un responsable asignado. Si la respuesta requiere una investigación manual, la organización tiene detección pero no una responsabilidad confiable.
Etapa 3, Operativa. Las señales, el linaje y la respuesta a incidentes están estandarizados. Las alertas hacen referencia a los Data Contracts, reglas de gravedad y propietarios, mientras que el equipo realiza un seguimiento del costo de la Observability y de los fallos recurrentes. Pregunte si los fallos de activos no críticos siguen creando tormentas de alertas. Si lo hacen, el programa no ha establecido un governance basado en la criticidad.
Etapa 4, Integrada. La Observability forma parte del SDLC de datos. Las pruebas de contratos, la política como código, las comprobaciones de esquema y las puertas de despliegue evitan regresiones antes de la producción. Pregunte si los equipos lanzan cambios de manera rutinaria sin regresiones de Observability. Los equipos maduros hacen que ese comportamiento sea difícil porque los contratos y las comprobaciones se ejecutan como parte de la entrega.
Etapa | Pregunta de diagnóstico | Marcador operativo |
|---|---|---|
Reactiva | ¿Se mide el tiempo de resolución de incidentes? | Las partes interesadas reportan fallos después del impacto |
Proactiva | ¿Qué activos de nivel uno tienen SLAs declarados? | Existen comprobaciones automatizadas en pipelines críticos |
Operativa | ¿Los fallos de baja criticidad siguen desencadenando tormentas de alertas? | Señales, linaje, propiedad y respuesta estandarizados |
Integrada | ¿Pueden los equipos realizar entregas sin regresiones de Observability? | Los contratos y las puertas de políticas se ejecutan en el SDLC |
Los equipos a menudo se quedan estancados entre la adopción y la disciplina. Compran una herramienta antes de clasificar los activos, crean umbrales generales y celebran el número de monitores mientras la propiedad sigue siendo ambigua. Un modelo de madurez de calidad de datos estructurado es útil solo cuando cada etapa requiere evidencia de incidentes, contratos y comportamiento de respuesta.
Un mapa de ruta inicial de 90 días para 2026
Un equipo con pocos recursos no necesita instrumentar cada conjunto de datos el primer día. Necesita un ciclo de control estrecho que demuestre la propiedad, produzca señales útiles y cree un registro de incidentes repetible.
Días 1 al 30, establecer la responsabilidad
Comience con los 20 conjuntos de datos que impactan en los ingresos de los que dependen el liderazgo, las finanzas, los clientes o las operaciones principales. Asigne un propietario responsable a cada uno, registre su criticidad y comportamiento de entrega esperado, y establezca un canal de Slack como superficie para incidentes. El canal no es el sistema de incidentes, pero le da al equipo una ruta común mientras madura el flujo de trabajo.
Para cada activo, capture los modos de fallo actuales, los consumidores descendentes, el contacto de escalada y la guía de resolución mínima. No agregue un monitoreo amplio todavía. Primero asegúrese de que cada alerta futura tenga un destino a dónde ir.
Días 31 al 60, añadir detección ligera
Conecte comprobaciones de frescura y volumen en el orquestador existente. Añada comparación de esquemas en la ingesta y envíe los fallos con el activo, propietario, comportamiento esperado, comportamiento observado y contexto probable de dependencia. Lleve a cabo una revisión semanal de la salud de los datos que examine las alertas no resueltas, las causas repetidas y los monitores sobre los que nadie actuó.
Evite umbrales generales. Una regla fija aplicada a cada tabla produce ruido porque las tablas tienen diferentes cronogramas, patrones de crecimiento y consecuencias comerciales. Comience con expectativas explícitas para conjuntos de datos críticos y use líneas base históricas donde el comportamiento sea variable.
Días 61 al 90, cerrar el ciclo
Añada linaje para columnas críticas y defina SLOs a nivel de conjunto de datos. Documente la diferencia entre la cuarentena automática y la escalada humana. Un lote mal formado se puede poner en cuarentena de forma segura, mientras que un flujo regulatorio retrasado puede requerir una notificación inmediata al propietario y una comunicación comercial.
Las dos trampas del despliegue son las tormentas de alertas y los conjuntos de datos huérfanos. Suprima o agrupe las anomalías de baja gravedad y niéguese a incorporar un activo sin un responsable asignado. El resultado debe ser un marco pequeño pero completo: detección conectada con la propiedad, respuesta, evidencia y revisión.
Preguntas comunes que los compradores y arquitectos aún se hacen
¿Cuánto debería costar desarrollar versus comprar?
La decisión depende de la capacidad de ingeniería, la profundidad de integración, la cobertura y las expectativas de servicio. Una infraestructura de código abierto que utiliza herramientas como Great Expectations, OpenLineage y Marquez puede reducir los gastos de licencia, pero el equipo sigue siendo el propietario del despliegue, las actualizaciones, los conectores, la calidad de los metadatos, el enrutamiento de alertas y los flujos de trabajo de incidentes.
Las plataformas comerciales intercambian parte de esa carga de trabajo interna por gastos de licencia y dependencia del proveedor. Compare la carga operativa total en lugar de solo el precio de suscripción. Incluya el tiempo de ingeniería, la infraestructura, el movimiento de datos, la revisión de seguridad, el soporte y el costo operativo de alertas ruidosas o incompletas.
La evidencia de las encuestas disponibles de 2026 muestra por qué este balance merece un análisis detallado. El 38% de los encuestados mencionó la complejidad y la sobrecarga como su mayor preocupación sobre la Observability, mientras que el 30% identificó la fatiga por alertas como la principal barrera para una respuesta más rápida a los incidentes, según la cobertura de la encuesta de Grafana Labs (encuesta de Observability de Grafana Labs). Trate esas cifras como señales de planificación, no como un argumento automático para construir o comprar.
El marco también debe tener en cuenta controles que una demostración del producto podría ocultar. Pregunte quién mantiene las reglas, quién es el propietario de las comprobaciones fallidas, cómo se conserva la evidencia y si el modelo operativo sigue funcionando cuando la plataforma no está disponible.
¿Qué capacidades del proveedor importan?
Evalúe la ruta de detección y respuesta antes de juzgar el diseño del panel de control:
Detección basada en registros versus detección basada en consultas: Los registros proporcionan contexto de eventos de pipeline, mientras que las consultas inspeccionan el comportamiento real del almacén. Muchos entornos requieren ambos.
Linaje a nivel de columna: Es posible que los gráficos a nivel de tabla no admitan el análisis de impacto para métricas reguladas.
Soporte nativo de almacén: Confirme que las comprobaciones se ejecutan de manera eficiente en los sistemas que contienen los datos.
Aplicación de la propiedad: Verifique si la plataforma enruta y escala incidentes o solo muestra anomalías.
Economía: Compruebe si el precio depende de los escaneos, alertas, llamadas de API, tablas, módulos o volumen de uso.
Control de despliegue: Las opciones de nube privada y locales importan cuando los datos de producción no pueden salir del entorno del cliente.
Un panel de control no es un modelo operativo. Un marco necesita detección, propiedad, escalada, evidencia y revisión conectados a través de estas capacidades.
¿Cuánto tiempo toma lograr una cobertura significativa?
La cobertura significativa de un entorno de tamaño mediano toma de six a nueve meses, no seis semanas. El trabajo inicial puede proteger activos seleccionados rápidamente, pero una cobertura duradera requiere clasificación, contratos, linaje, limpieza de propiedad, práctica de respuesta e integración en las capas de ingesta, transformación, almacén y BI.
Dimensión | Infraestructura de código abierto | Plataforma comercial |
|---|---|---|
Licencia inicial | A menudo baja o nula | Tarifas de suscripción o de plataforma |
Propiedad de ingeniería | Alta, incluyendo operaciones y mantenimiento | Compartida con el proveedor, según el servicio |
Personalización | Amplio control a través de código y APIs | Gobernado por capacidades del producto y extensiones |
Carga de integración | El equipo desarrolla y mantiene conectores | El proveedor puede proporcionar integraciones nativas |
Flujo de governance | Generalmente ensamblado a partir de componentes separados | Puede estar incluido, pero debe verificarse |
Control de despliegue | Control total en la infraestructura del cliente | Depende del modelo de alojamiento y despliegue |
Un marco personalizado se adapta a entornos con requisitos de auditoría inusuales, una inversión profunda en Dagster o Airflow, o límites de malla de datos que hacen que el linaje del proveedor sea demasiado superficial para confiar en él. Una plataforma comercial se adapta a equipos que necesitan una integración más rápida, soporte constante y una capa operativa mantenida. Tome la decisión considerando los controles requeridos, la propiedad y los flujos de trabajo de respuesta, no el atractivo del panel de control.
digna proporciona una plataforma modular de calidad de datos y Observability que se ejecuta dentro de la nube, VPC o centro de datos de un cliente, con ejecución en la base de datos para detección de anomalías, monitoreo de Timeliness, validación a nivel de registro, seguimiento de esquemas y métricas de plataforma. Los equipos que diseñan una Observability gobernada para pipelines regulados o cargas de trabajo de IA pueden revisar digna frente a su arquitectura existente.
Preguntas frecuentes
¿Qué es un marco de observabilidad de datos?
Un sistema por capas que convierte la telemetría de datos en acción humana gobernada. Cuatro capas lo hacen utilizable: la capa de señales, la de contexto con criticidad y responsabilidad, la de respuesta con triaje y remediación, y la de gobernanza con SLA, severidad, supresión y escalada.
¿Por qué la mayoría de programas se queda en las cinco señales?
Porque detectar no es responder. Frescura, volumen, distribución, esquema y linaje pueden aparecer en verde o en rojo mientras nadie ha nombrado responsable, vía de escalada, regla de supresión ni runbook de remediación. Una alerta sin responsable, severidad y ruta de respuesta es una notificación, no un control operativo.
¿Es la observabilidad de datos una categoría de software reconocida?
Sí. Gartner publicó su primera Market Guide for Data Observability Tools el 23 de febrero de 2026, cubriendo detección de anomalías, alertas, linaje y flujos de respuesta a incidentes. Un estudio de mercado de 2026 estima un crecimiento desde 3.510 millones de USD en 2026 hasta 6.030 millones en 2031.
¿Qué detecta cada una de las cinco señales?
La frescura mide el momento de llegada frente a un calendario o SLA, el volumen compara recuentos de filas y tamaños de partición con rangos esperados, la distribución examina comportamiento estadístico y frecuencias de categoría, el esquema valida la estructura frente a un contrato y el linaje representa el grafo de dependencias de origen a consumo.
¿Más monitorización significa más fiabilidad?
No por sí sola. Un despliegue más pequeño puede rendir mejor cuando la responsabilidad es explícita, porque la restricción suele ser la gobernanza y no la cobertura. Ate cada señal a un modo de fallo y a una política de respuesta antes de añadir la siguiente.



