Detección de anomalías en datos de sensores: una guía práctica
|
8
minuto de lectura

Un panel de vibración se pone en rojo durante el turno de la tarde. El operador revisa la máquina y no encuentra nada evidente. La alarma provino de un canal de temperatura que reaccionó a una sala más cálida, mientras que un canal de vibración independiente ha estado derivando hacia la falla sin cruzar su límite fijo. Para cuando alguien conecta las señales, el detector ya ha dado una falsa alarma con demasiada frecuencia o ha permanecido en silencio durante demasiado tiempo.
Esa es la realidad del despliegue de la detección de anomalías en datos de sensores. Las corrientes industriales son ruidosas, multimodales, dependientes del tiempo y cambian constantemente. Un detector que funciona bien en un banco de pruebas limpio puede fallar cuando los sensores derivan, las marcas de tiempo se desalinean, los canales se mueven juntos o la planta cambia de régimen operativo. La pregunta práctica no es solo qué modelo tiene la puntuación más alta. Es si el sistema puede identificar desviaciones significativas lo suficientemente rápido como para que un operador o ingeniero actúe.
Tabla de contenidos
Por qué la detección de anomalías en sensores es más difícil de lo que parece
Las restricciones de producción que importan
Ingeniería de características para corrientes de sensores
Alinear el tiempo antes de calcular las características
Hacer coincidir las características con el patrón de falla
Un menú práctico de características
Elegir el modelo de detección adecuado
Líneas base estadísticas
Aprendizaje automático clásico
Aprendizaje profundo
Manejo de estacionalidad, deriva y canales correlacionados
Volver a anclar la línea base con cuidado
Tener en cuenta los canales acoplados
Evaluar el rendimiento de detección con honestidad
Utilizar una evaluación consciente de eventos
Arquitecturas de despliegue para monitoreo en tiempo real
Hacer coincidir el patrón con la decisión
No pasar por alto la puntuación dentro de la base de datos
Puesta en marcha con confianza
Ejecutar la lista de verificación previa al lanzamiento
Hacer explícita la escalación
Por qué la detección de anomalías en sensores es más difícil de lo que parece
Un sensor de vibración de una turbina puede permanecer casi plano durante horas después de que un soporte de montaje se afloje. La condición mecánica ha cambiado, pero la señal puede derivar lentamente y permanecer por debajo de un umbral estático. Una regla que alerta por encima de cierto valor ve una operación normal. Un ingeniero que revise la tendencia, el contexto rotacional y los canales relacionados puede ver una falla emergente.
Esa brecha define el problema de producción. Los sistemas industriales combinan vibración, temperatura, presión, corriente, señales de control, imágenes y otras modalidades, cada una con un comportamiento de muestreo y modos de falla diferentes. Las muestras faltantes crean brechas, las lecturas ruidosas crean picos y los canales correlacionados pueden hacer que un cambio operativo legítimo parezca anómalo. El detector debe aprender el comportamiento normal para un activo específico, estado operativo y período de tiempo en lugar de memorizar un rango global único.
Regla práctica: Trate lo “normal” como un contexto operativo aprendido, no como un número permanente.
La investigación en el campo refleja la misma progresión. Los métodos de detección de anomalías anteriores dependían en gran medida de las estadísticas y del procesamiento de señales. Los trabajos posteriores se expandieron hacia el aprendizaje automático y el aprendizaje profundo. Una encuesta de 2020 sobre la detección inteligente de anomalías en sistemas de sensores describe la larga historia de los métodos estadísticos y de procesamiento de señales y distingue las técnicas convencionales de los enfoques basados en datos. Una revisión independiente de la detección de anomalías en maquinaria industrial evaluó 84 estudios que abarcan desde 2016 hasta 2023, lo que ilustra el rápido crecimiento de la investigación industrial moderna.
Las restricciones de producción que importan
Una canalización de detección debe abordar varias restricciones antes de poder producir una puntuación útil:
Cambios en el régimen operativo: La carga, la velocidad, la temperatura ambiente, las recetas de producción y los patrones de turno cambian la señal esperada.
Deriva del sensor: Los cambios de calibración y el envejecimiento pueden desplazar la línea base mientras la máquina se mantiene en buen estado.
Canales correlacionados: La temperatura, la vibración y la corriente pueden responder a la misma condición mecánica o eléctrica.
Muestreo desigual: Un canal puede llegar rápidamente mientras otro informa esporádicamente, por lo que las uniones ingenuas fila por fila pueden distorsionar las relaciones.
Etiquetas retrasadas: Los equipos de mantenimiento rara vez registran el momento exacto en que comenzó una anomalía, lo que deja inciertas las ventanas de entrenamiento y evaluación.
Latencia y localidad: Una decisión de seguridad puede requerir ocurrir cerca de la máquina, mientras que un análisis más profundo puede ejecutarse en una plataforma central.
Estas condiciones explican por qué la precisión de referencia en conjuntos de datos limpios suele funcionar mal en producción. Los bancos de pruebas tienden a proporcionar marcas de tiempo ordenadas, distribuciones estables y etiquetas explícitas. Las plantas proporcionan pérdidas de sensores, intervenciones de mantenimiento, cargas de trabajo cambiantes y anomalías que se desarrollan con el tiempo. Un modelo puede obtener una buena puntuación y, al mismo tiempo, producir alertas demasiado tarde, con demasiada frecuencia o sin el contexto suficiente para que un operador actúe.
Para los equipos responsables de las canalizaciones circundantes, la Data Observability para la confiabilidad operativa proporciona controles para separar una anomalía de la máquina de una fuente de datos retrasada, faltante, malformada o estructuralmente cambiada. El detector no puede razonar de manera confiable sobre una señal que nunca llegó o que llegó con la forma incorrecta. Por lo tanto, el monitoreo operativo debe cubrir tanto el equipo como la ruta de datos que lo representa.
Ingeniería de características para corrientes de sensores
Los valores crudos de los sensores son entradas de modelo débiles sin contexto operativo. Una temperatura de 70 puede ser normal con una carga y sospechosa con otra. Una lectura de vibración que parece inofensiva por sí sola puede importar después de una rampa sostenida. Las características útiles capturan el contexto local, el cambio a lo largo del tiempo y las relaciones entre canales.
Alinear el tiempo antes de calcular las características
Elija una cadencia de análisis que coincida con el presupuesto de latencia del detector, luego vuelva a muestrear cada canal deliberadamente. No propague hacia adelante una corriente de vibración de alta frecuencia a lo largo de una interrupción prolongada, ni interpole a través de un período en el que el equipo estuvo fuera de línea. Mantenga un indicador de imputación y de datos faltantes para que el detector pueda separar un valor medido de una reconstrucción.
La alineación también depende de la calidad del reloj. El desfase horario entre dispositivos o pasarelas puede crear relaciones de retraso falsas cuando un canal explica a otro. Verifique el orden de las marcas de tiempo, los duplicados, las brechas de muestreo y la consistencia de las unidades antes de unir las corrientes. Una característica bien diseñada construida a partir de señales alineadas incorrectamente seguirá siendo errónea.
Para equipos multimodales, conserve las marcas de tiempo de los canales originales o los indicadores de calidad cuando sea posible. Una cadencia común facilita el cálculo de características, pero puede ocultar brechas cortas y hacer que un canal lento parezca más preciso de lo que es. La elección correcta depende del modo de falla y de la ventana de acción, no solo de una tabla ordenada.
Hacer coincidir las características con el patrón de falla
Un z-score móvil mide qué tan alejada está la lectura actual de una media reciente en relación con la variación reciente. Una ventana corta, como de cinco minutos, puede exponer un salto repentino de amplitud. Una ventana más larga, como de 30 minutos, puede revelar una deriva más lenta que una ventana corta podría absorber como normal. El método familiar calcula la media y la desviación estándar sobre una ventana deslizante, luego marca los valores que superan un umbral seleccionado. Una implementación de referencia utiliza un umbral de 3, que corresponde aproximadamente a 3 de cada 1,000 puntos bajo una distribución normal, como se describe en el ejemplo de detección de anomalías por z-score de Ericsson.
La diferenciación responde a una pregunta distinta. Las diferencias de primer orden exponen saltos entre observaciones adyacentes. Las diferencias de segundo orden exponen cambios en la tasa de movimiento, lo que ayuda a identificar una deriva acelerada o una inestabilidad emergente. Ambas operaciones pueden amplificar el ruido, así que suavice o agregue primero las señales altamente volátiles. Ese preprocesamiento añade retraso, el cual debe ajustarse al presupuesto de monitoreo.
Las características de retraso de uno a diez pasos ofrecen a los modelos clásicos una vista compacta de la historia reciente. Se adaptan a procesos donde la siguiente lectura depende de los valores recientes, pero aumentan la dimensionalidad y se vuelven redundantes cuando el muestreo es denso. Los percentiles móviles describen la dispersión local sin asumir una distribución simétrica, lo que los hace útiles para valores atípicos y comportamientos operativos asimétricos.
Un menú práctico de características
Técnica | Qué captura | Mejor uso para |
|---|---|---|
Z-score móvil | Desviación local de la media y variación recientes | Deriva de amplitud y desviaciones de corta duración |
Diferencia de primer orden | Cambio entre lecturas adyacentes | Saltos repentinos y discontinuidades |
Diferencia de segundo orden | Cambio en la tasa de movimiento | Rampas aceleradas e inestabilidad emergente |
Características de retraso | Contexto autorregresivo reciente | Dependencias temporales cortas en modelos clásicos |
Percentiles móviles | Límites de distribución local | Señales ruidosas y variación no gaussiana |
Residuos entre canales | Desviación tras considerar una señal relacionada | Comportamiento acoplado de temperatura, corriente, velocidad y vibración |
Los residuos entre canales a menudo aportan más valor que otra transformación de la misma señal. Estime el comportamiento esperado de un canal a partir de un canal relacionado, luego monitoree el residuo. Vuelva a verificar esa relación a medida que cambien las cargas de trabajo y la calibración, porque la correlación puede derivar incluso mientras ambos sensores permanecen en buen estado.
Para un examen más detallado de la construcción de características, consulte la guía de detección de anomalías en series temporales de sensores junto con el conocimiento de los activos. La selección de características importa más que el volumen de las mismas. Cada transformación debe responder a una pregunta de monitoreo, mantener la trazabilidad en una alerta y evitar consumir más latencia o cómputo de lo que permite la decisión operativa.
Elegir el modelo de detección adecuado
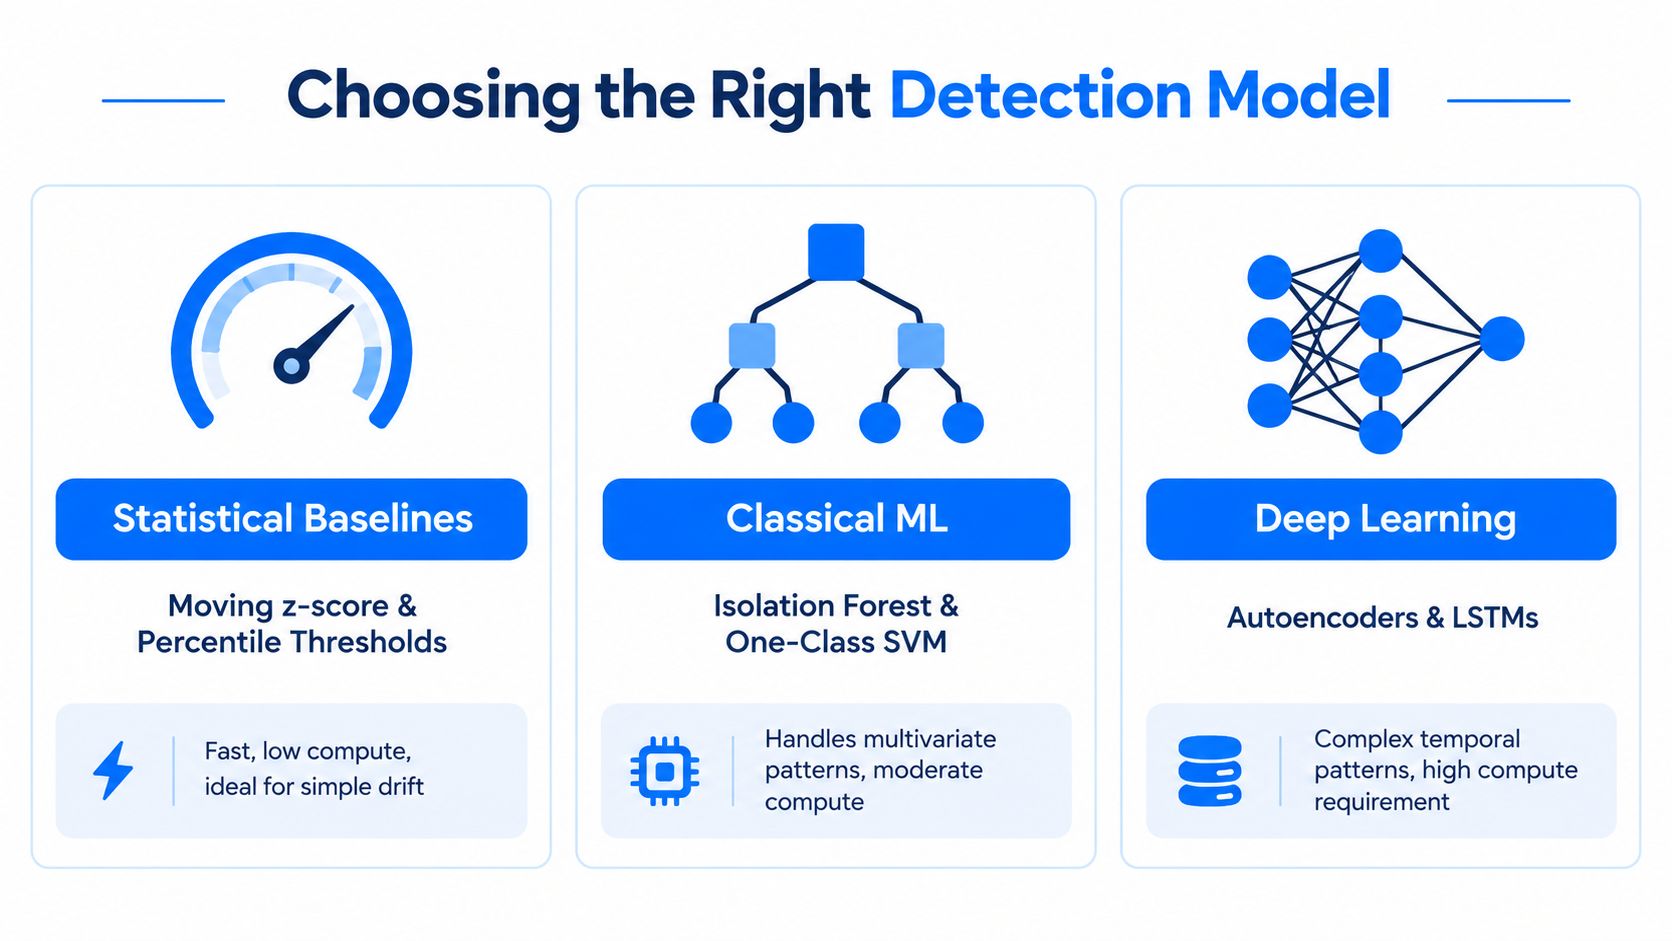
Ningún detector único gana en todos los regímenes de sensores. Los métodos estadísticos son económicos y explicables, el aprendizaje automático clásico maneja espacios multivariados compactos y el aprendizaje profundo puede modelar relaciones temporales complejas. El diseño de producción correcto generalmente asigna una tarea a cada enfoque en lugar de forzar a un solo modelo a procesar cada alerta.
Líneas base estadísticas
Los z-scores móviles, los percentiles móviles y los umbrales de residuos son excelentes detectores de primera línea. Son rápidos, fáciles de inspeccionar y adecuados para derivas simples o cambios abruptos. Su debilidad es el contexto. Un umbral fijo se rompe cuando cambia el régimen operativo, y una ventana móvil corta puede tratar una falla sostenida como la nueva normalidad.
Las líneas base adaptativas pueden eliminar parte de la configuración manual. Una implementación documentada aprende una línea base a partir de los siete días anteriores de lecturas, la actualiza una vez por hora y requiere al menos 100 lecturas antes de establecerla, como se describe en la documentación de línea base de anomalías de sensores. Estos mecanismos son patrones útiles, pero aún necesitan salvaguardas contra el aprendizaje durante un período contaminado.
Aprendizaje automático clásico
Isolation Forest y SVM de una clase son útiles cuando las anomalías ocupan regiones inusuales de un espacio de características multivariado. Pueden combinar estadísticas móviles, retrasos, residuos y contexto operativo sin requerir un gran archivo de fallas etiquetadas. A menudo son más fáciles de desplegar que un modelo de secuencia, pero su rendimiento puede degradarse cuando las distribuciones de características cambian o cuando las fallas raras están mal representadas.
La advertencia es sustancial. En un banco de pruebas de anomalías industriales, Isolation Forest con o sin escalado alcanzó solo 0.171 de F1 medio, mientras que LOF alcanzó 0.100 de F1 medio, según los resultados reportados de detección de anomalías industriales. Esos resultados no hacen que los algoritmos sean inútiles. Muestran por qué una línea base no supervisada debe ganarse la confianza en el equipo objetivo en lugar de heredarla de un ejemplo de libro de texto.
Aprendizaje profundo
Los autoencoders LSTM y los detectores basados en transformers pueden representar dependencias temporales largas y relaciones entre canales. Se adaptan mejor cuando la firma de la falla depende de una secuencia más que de un punto aislado, pero exigen más cómputo, un diseño cuidadoso de la ventana y datos confiables de operación saludable.
Los resultados aplicados muestran tanto el potencial como la trampa. Un autoencoder LSTM combinado con Isolation Forest logró un 95.7% de precisión y una puntuación F1 de 0.93 en una evaluación de anomalías de sensores, según se informa en este estudio de identificación de anomalías en sensores. Un autoencoder para sistemas de control industrial independiente reportó una precisión de 0.993 y un 96% de exactitud, pero la sensibilidad (recall) fue de solo 0.673 y el F1 fue de 0.771, documentado en el estudio de autoencoders en sistemas de control industrial. Una alta precisión puede coexistir con demasiadas fallas no detectadas.
Una arquitectura por niveles suele ser más efectiva. Permita que las reglas estadísticas manejen las desviaciones obvias, use modelos clásicos para los residuos multivariados y envíe los casos ambiguos o temporalmente complejos a un modelo más profundo. Para detalles de implementación sobre flujos de trabajo de anomalías basados en Python, las prácticas de detección de anomalías de datos en Python pueden consultarse junto con la documentación específica de su modelo.
Manejo de estacionalidad, deriva y canales correlacionados
Una línea de producción puede operar en diferentes turnos, calentarse a lo largo del día y desarrollar desgaste en los rodamientos mientras cambia su perfil de carga. Un umbral fijo trata cada cambio como una falla. El detector debe separar el movimiento esperado de la evidencia de que el proceso o la relación del sensor han cambiado.
Volver a anclar la línea base con cuidado
Un z-score móvil puede absorber un ciclo operativo diario mientras preserva las desviaciones del patrón reciente. También crea un punto ciego: una falla que se desarrolla gradualmente a lo largo de la ventana puede convertirse en parte de la línea base. Defina la ventana a partir del ciclo del proceso y la latencia de alerta, no de un valor predeterminado por conveniencia.
La descomposición STL separa la tendencia, el comportamiento estacional y la variación residual, para luego puntuar el residuo en lugar del valor crudo. Utilícela cuando un canal tenga un patrón repetible. Los umbrales de percentiles hacen menos suposiciones al recalcular los límites locales a partir de observaciones recientes, aunque todavía requieren protección contra períodos de entrenamiento contaminados.
Un diseño de umbral adaptativo recalcula su línea base diariamente a partir de los siete días anteriores, utiliza datos a nivel de minuto para estimar el percentil 99 y agrega un término de fluctuación basado en el rango intercuartílico entre los percentiles 25 y 75, de acuerdo con el método de umbral autoadaptativo de Dynatrace. La implementación ilustra una regla más amplia: el comportamiento reciente puede definir el comportamiento esperado solo cuando se excluyen o se reduce el peso de los períodos anormales.
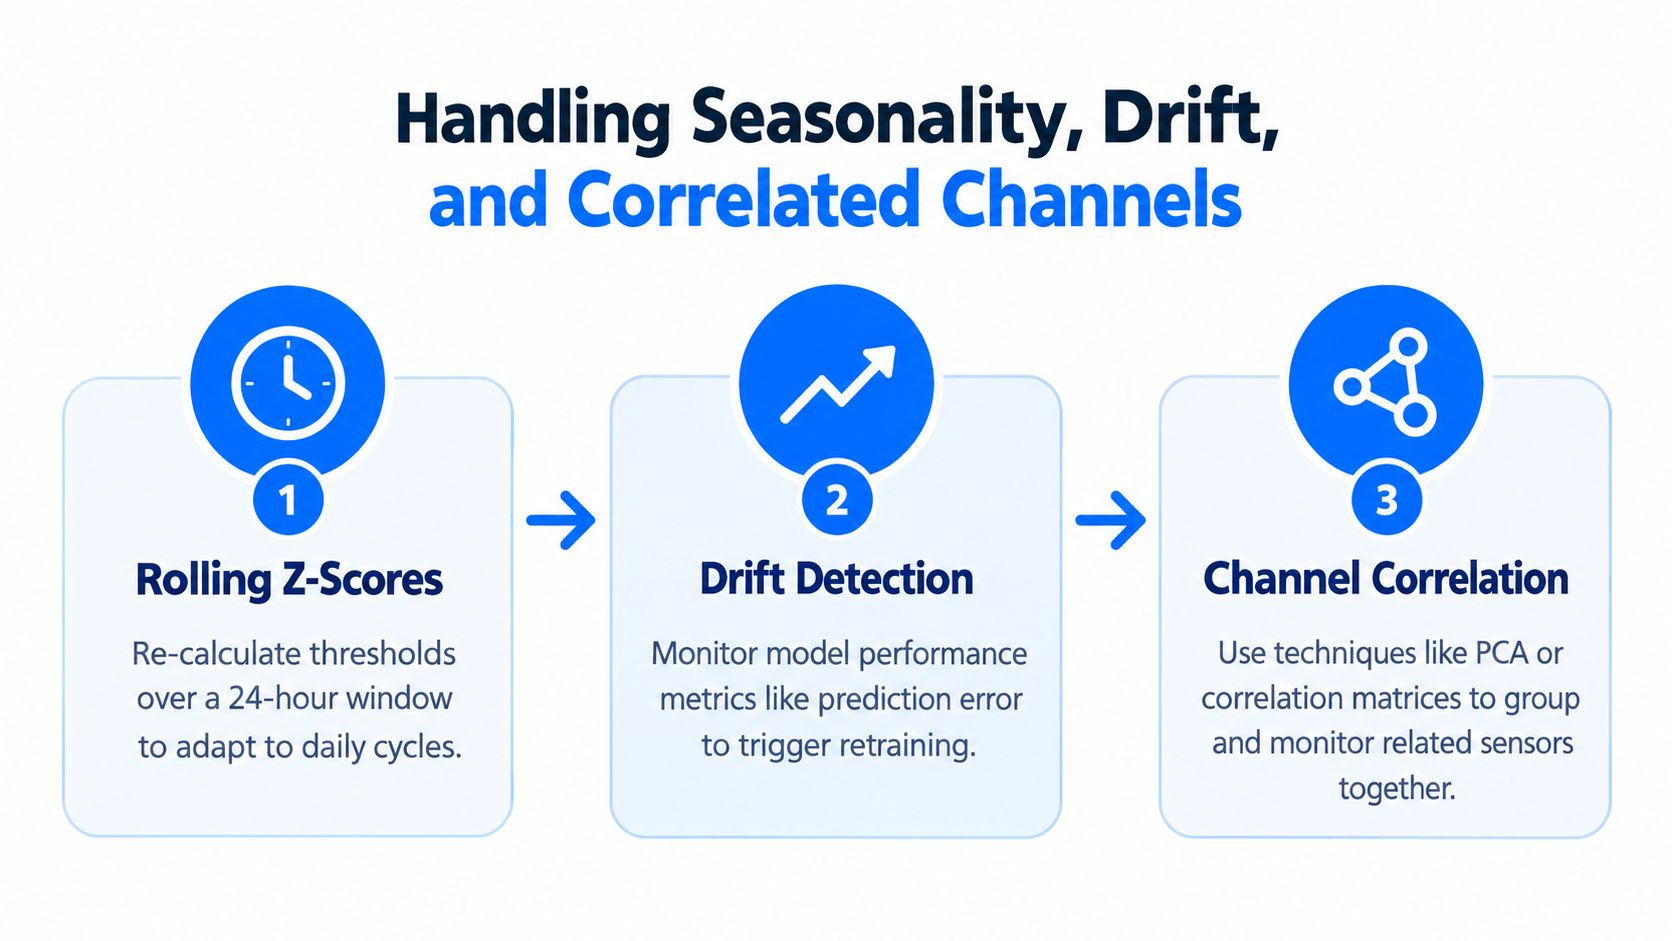
Realice el seguimiento de la detección de deriva de modelos para líneas base de sensores con la detección de deriva de modelos para líneas base de sensores. Revise las distribuciones de características, los residuos y los resultados de las alertas por separado. Una línea base puede parecer saludable incluso después de que haya cambiado la relación entre un sensor y sus condiciones operativas.
Tener en cuenta los canales acoplados
La temperatura, la vibración y la corriente a menudo se mueven juntas porque la velocidad o la carga afectan a las tres. La puntuación independiente produce entonces alertas para cambios operativos legítimos. Los canales correlacionados deben evaluarse frente al contexto operativo y entre sí.
La residualización es un primer paso práctico. Si las RPM explican gran parte de la amplitud de la vibración, realice una regresión de la vibración frente a las RPM y puntúe el residuo. El PCA puede comprimir canales correlacionados en patrones operativos latentes, mientras que las matrices de correlación pueden identificar grupos que pertenecen a la misma regla de monitoreo. La investigación sobre flujos industriales de alto ruido también examina métodos híbridos como el PCA combinado con autoencoders, como se discute en esta investigación sobre detección de anomalías en sensores con alto ruido.
Regla de decisión: Use una ventana adaptativa cuando el proceso se mantenga estable pero su línea base se mueva. Vuelva a entrenar cuando la relación entre las entradas y el comportamiento esperado haya cambiado sustancialmente, o cuando incidentes validados muestren fallas sistemáticas en la detección.
Mantenga la latencia en la decisión. Un modelo multicanal que no cumple con el tiempo de respuesta requerido es menos útil que una regla residual más simple que se ejecuta continuamente. Combine las relaciones de canales con comprobaciones de deriva, y luego dirija los casos dudosos para su revisión en lugar de permitir que la línea base los absorba.
Evaluar el rendimiento de detección con honestidad
La exactitud (accuracy) suele ser la métrica menos útil en un sistema de anomalías. Si las fallas son raras, un detector puede obtener una buena puntuación prediciendo que todo es normal en casi cada observación sin capturar nada que realmente importe. Incluso sin asignar una prevalencia artificial, la lección operativa es clara: evalúe los eventos que les importan a los operadores, no solo las filas individuales.
La precisión le indica cuántas alertas fueron significativas. La sensibilidad (recall) le indica cuántas anomalías etiquetadas encontró el detector. Ninguna de las dos captura si el sistema reaccionó lo suficientemente temprano. Mida el retraso de la detección desde el inicio de la anomalía, no simplemente desde el final de una ventana de puntuación, porque una alerta tardía puede ser técnicamente correcta pero operativamente inútil.
Utilizar una evaluación consciente de eventos
Un conjunto de evaluación práctico debería incluir:
Precisión y sensibilidad (recall): Calcule ambas en ventanas etiquetadas, con etiquetas revisadas contra los registros de mantenimiento y el contexto operativo.
Retraso de detección: Mida el tiempo transcurrido desde el inicio defendible más temprano de la anomalía hasta la primera alerta accionable.
Volumen de alertas: Realice un seguimiento de las alertas por turno y por activo, no solo de las métricas agregadas del modelo.
Carga de falsas alarmas: Registre las falsas alarmas por hora de operador para que el resultado refleje la carga de trabajo humana.
Revisión de eventos no detectados: Examine las anomalías que el detector nunca mostró, especialmente la deriva gradual y las fallas entre canales.
Un estudio de referencia sobre la detección de anomalías funcionales encontró que el rendimiento depende en gran medida del tipo de anomalía y que la evaluación basada en simulación es necesaria porque ningún detector único es confiable en todos los patrones. Ese hallazgo respalda un conjunto de pruebas que contenga picos abruptos, rampas graduales, cambios de nivel, datos faltantes, cambios correlacionados e intervalos ruidosos, como se describe en el banco de pruebas de detección de anomalías funcionales.
Métrica | Qué mide | Trampa en datos de sensores |
|---|---|---|
Exactitud (Accuracy) | Clasificaciones correctas globales | Puede ocultar fallas raras no detectadas |
Precisión | Proporción de alertas que corresponden a anomalías | Una precisión alta puede deberse a alertar con demasiada rareza |
Sensibilidad (Recall) | Proporción de anomalías etiquetadas detectadas | Puede recompensar alertas ruidosas y excesivas sin contexto de tiempo |
Puntuación F1 | Equilibrio entre precisión y sensibilidad | Trata cada muestra por igual, incluso cuando un evento abarca muchas muestras |
Retraso de detección | Tiempo desde el inicio hasta la primera alerta | Las etiquetas pueden marcar el tiempo de mantenimiento en lugar del inicio físico |
Volumen de alertas | Carga de trabajo operativa creada por el modelo | Los totales agregados pueden ocultar un activo o turno ruidoso |
La literatura proporciona una advertencia útil. El contexto temporal mejoró la detección en un conjunto de datos industrial de OPC UA en un 2.27% de F1, 2.33% de precisión y 3.02% de sensibilidad (recall) cuando se agregó memoria secuencial de segundo orden, según el estudio de memoria secuencial en IoT industrial. Ese tipo de mejora solo importa si sobrevive a una evaluación en la sombra específica de la planta.
Ejecute el modelo candidato junto con las reglas existentes en modo sombra. Mantenga a los operadores ajenos a sus alertas durante la evaluación inicial, compare los tiempos de sus eventos y la carga de trabajo con incidentes conocidos, e investigue cada discrepancia antes de promoverlo.
Para el análisis de incertidumbre en escenarios de eventos raros, la simulación de Monte Carlo para pruebas operativas puede ayudar a los equipos a explorar cómo se comportan las políticas de alerta bajo diversas condiciones de señal sin tratar un resultado sintético como prueba del rendimiento en producción.
Arquitecturas de despliegue para monitoreo en tiempo real
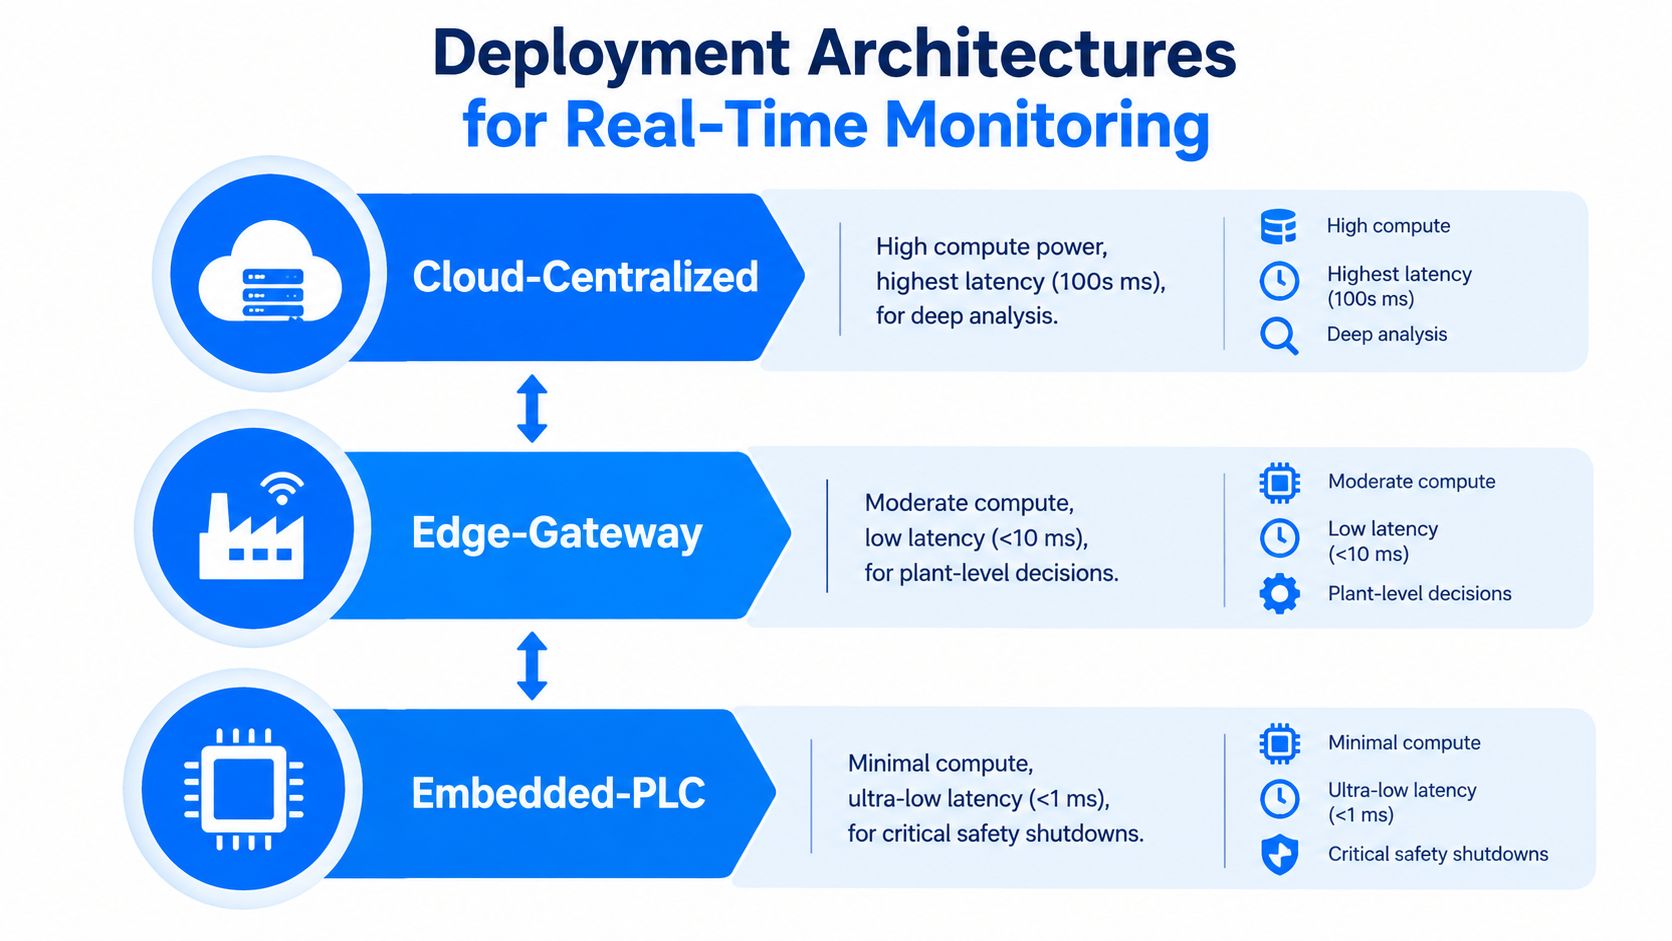
La arquitectura sigue a las restricciones. Si una decisión debe ocurrir cerca de la máquina, enviar cada muestra cruda a una nube lejana agrega latencia y crea una dependencia de la disponibilidad de la red. Si el requisito es un análisis de tendencias para toda la flota, integrar un modelo grande en cada controlador crea una carga operativa innecesaria.
Hacer coincidir el patrón con la decisión
Inferencia integrada en PLC o en el sensor se adapta a acciones locales críticas. Un detector compacto puede ejecutarse donde la señal ingresa al sistema de control, evitando un viaje de ida y vuelta por la red. La contrapartida es una severa limitación de recursos, actualizaciones de modelos difíciles y requisitos de prueba estrictos. Utilícelo para decisiones simples y críticas para la seguridad, no de manera automática para cada carga de trabajo analítica.
Inferencia en pasarela periférica (edge-gateway) proporciona más espacio para la ingeniería de características y modelos multicanal, al tiempo que mantiene los datos dentro de la planta. Una pasarela puede consumir mensajes de los sistemas locales, calcular ventanas y enviar solo puntuaciones o características seleccionadas hacia arriba. Este patrón funciona bien cuando la privacidad y la resiliencia importan más que la simplicidad centralizada.
Inferencia en la nube o central ofrece mayor capacidad de cómputo y un reentrenamiento más sencillo para toda la flota. Se adapta al análisis profundo, comparaciones entre sitios y desarrollo de modelos a largo plazo, pero depende de una conectividad confiable y aumenta el movimiento de datos crudos sensibles.
No pasar por alto la puntuación dentro de la base de datos
Para resúmenes de flota y monitoreo histórico, la puntuación dentro de una base de datos de series temporales como TimescaleDB o Influx puede reducir el envío innecesario de cada punto a la nube. También mantiene los cálculos de características cerca de los datos almacenados y facilita la investigación para los ingenieros de datos que ya trabajan en SQL. La limitación es que la ejecución en la base de datos puede no cumplir con los requisitos estrictos de control en tiempo real.
La colaboración nube-borde es cada vez más práctica para las redes de sensores industriales porque separa la detección local del análisis centralizado. La investigación sobre la detección de anomalías colaborativa nube-borde describe esta división como una respuesta a las restricciones de latencia y escalabilidad, mientras que los trabajos más recientes orientados al borde se centran en la detección en tiempo real y eficiente en recursos.
Mantenga las versiones de los artefactos del modelo consistentes en todos los sitios. Registre la configuración del sensor, las definiciones de características, el estado de calibración y la versión del modelo con cada alerta. Conserve suficiente contexto crudo alrededor de un incidente para la depuración posterior, pero defina la retención deliberadamente porque las ventanas crudas de alta frecuencia pueden crecer rápidamente.
Elija basándose en tres preguntas: qué tan rápido debe llegar la decisión, si las señales crudas pueden salir de la instalación y cuánto cómputo puede soportar el dispositivo local. La respuesta suele conducir a un despliegue híbrido: puntuación local con reentrenamiento e investigación centralizados.
Puesta en marcha con confianza
Un modelo no compensa un flujo de trabajo de alertas que no inspira confianza. Los operadores juzgan el sistema en función de si las alertas llegan en momentos útiles, contienen suficiente contexto y distinguen un evento digno de acción de la variación ordinaria del proceso. El realismo operativo debería decidir si un detector se pone en marcha, no la novedad arquitectónica.
Ejecutar la lista de verificación previa al lanzamiento
Comience con una ejecución en la sombra junto con las reglas heredadas durante dos a cuatro semanas, utilizando el intervalo especificado en el plan de lanzamiento en lugar de tratarlo como una garantía universal. No actúe todavía sobre las nuevas alertas. Compárelas con los registros de mantenimiento, notas del operador, intervenciones conocidas y el flujo de alertas existente.

Luego, ajuste la sensibilidad utilizando el comportamiento observado:
Ejecución en la sombra: Identifique qué alertas habrían llegado a los operadores y si corresponden a eventos reconocibles.
Ajuste de umbrales: Equilibre los eventos no detectados frente a la carga de alertas utilizando períodos operativos reales, no solo archivos de referencia reproducidos.
Plan de contingencia: Defina la reversión, la anulación manual y el comportamiento seguro cuando falle el modelo, la canalización de características, la pasarela o la alimentación de datos ascendente.
Monitoreo continuo: Realice un seguimiento de la deriva de entrada, disponibilidad de características, distribuciones de puntuación, resultados de alertas y rendimiento del modelo después del lanzamiento.
El monitoreo de modelos necesita un bucle de retroalimentación de incidentes. El reentrenamiento debe seguir a incidentes validados y etiquetados y a cambios significativos en el comportamiento operativo, no a una fecha del calendario elegida por conveniencia. Si se reemplaza un sensor, cambia un proceso o una acción de mantenimiento restablece el comportamiento de la máquina, registre ese contexto para que el modelo no aprenda la intervención como una anomalía inexplicada.
Hacer explícita la escalación
Las anomalías críticas deben dirigirse a los ingenieros de guardia dentro de un objetivo de latencia definido. Los eventos de menor gravedad pueden ingresar a una cola de revisión semanal, donde los ingenieros examinan patrones, confirman etiquetas y deciden si la línea base o el conjunto de características necesitan ajustes. Cada alerta debe incluir el activo, la marca de tiempo, los canales contribuyentes, los valores de las características, la versión del modelo y un enlace a la ventana de datos crudos correspondiente.
La verdadera métrica de éxito es la confianza del operador. Un detector gana el estado de producción cuando las personas actúan sobre sus alertas sin cuestionar cada una de ellas.
Un sistema que minimiza los falsos positivos en un banco de pruebas pero abruma a un equipo de turno ha fallado. Un detector más simple que captura los eventos correctos, explica su puntuación y se degrada de manera segura puede crear más valor que un modelo complejo que nadie puede mantener. El propósito de la detección de anomalías en datos de sensores no es producir métricas impresionantes de forma aislada. Es dar a las personas responsables del equipo suficiente evidencia oportuna para tomar una mejor decisión.
digna ayuda a los equipos a monitorear el comportamiento anormal de los datos, la Timeliness, las reglas de validación y los cambios estructurales dentro de su propio entorno, lo que complementa las canalizaciones de anomalías de sensores que dependen de entradas confiables. Visite digna para ver cómo su enfoque de Observability dentro de la base de datos puede ayudarle a detectar brechas de datos y movimientos inesperados antes de que afecten al monitoreo industrial.
Preguntas frecuentes
¿Por qué la detección de anomalías en sensores es más difícil de lo que parece?
Porque lo normal es un contexto operativo aprendido, no un número permanente. Un sensor de vibración de turbina puede permanecer casi plano durante horas después de que se afloje un soporte, de modo que un umbral fijo informa de buena salud mientras la condición mecánica ya cambió.
¿Qué restricciones de producción rompen un modelo de sensores?
Se repiten seis: cambios de régimen por carga, velocidad y turnos; deriva del sensor por calibración y envejecimiento; canales correlacionados que responden a la misma condición; muestreo desigual que vuelve engañosas las uniones fila a fila; etiquetas tardías procedentes de mantenimiento; y límites de latencia cuando una decisión de seguridad debe tomarse junto a la máquina.
¿Cómo se preparan las características de sensores?
Alinee el tiempo antes de calcular nada. Elija una cadencia de análisis acorde al presupuesto de latencia del detector, remuestree cada canal de forma deliberada y conserve las marcas de tiempo o banderas de calidad originales en equipos multimodales. Los valores brutos son entradas débiles sin contexto operativo.
¿Qué características captan qué fallos?
Ajuste la característica al patrón. Un z-score móvil mide la distancia a una media reciente en relación con la variación reciente, una ventana más larga como 30 minutos revela derivas lentas que una ventana corta asimila como normales, la diferenciación responde a otra pregunta y las variables de retardo dan a los modelos clásicos una historia reciente compacta.
¿Por qué la precisión de los benchmarks no sobrevive a producción?
Porque los conjuntos limpios omiten justo las condiciones que provocan el fallo: cambios de régimen, deriva, canales correlacionados, muestreo desigual y etiquetas inciertas. También cuentan los controles de la canalización que rodea al modelo, porque separan una anomalía real de máquina de un feed tardío, ausente, malformado o alterado estructuralmente.



