Cómo ejecutar una consulta de forma eficiente en 2026
|
6
minuto de lectura

Es posible poner en producción una consulta que devuelve filas, supera las pruebas y aun así causa problemas. El fallo suele aparecer más tarde, cuando un dashboard va lento, una cifra de conciliación no cuadra o un proceso posterior consume datos con la granularidad equivocada sin que nadie lo note. Si ejecuta consultas con suficiente frecuencia, aprenderá que «ha terminado» es el listón más bajo, no el que mantiene fiable un data warehouse.
Índice
Optimizar consultas analíticas con estadísticas y diseño de predicados
Más allá de la sintaxis La brecha de validación semántica en la monitorización de consultas
Cómo gestionar datos tardíos, cambiantes o parciales en las operaciones de consulta
Conclusiones prácticas para una ejecución fiable de consultas
Por qué ejecutar una consulta es mucho más que lanzar SQL
Antes, una consulta se trataba como una línea de texto enviada a una base de datos. Esa visión se queda corta para los sistemas modernos, porque la base de datos elige rutas de acceso, orden de los joins y uso de recursos mientras trabaja para obtener el resultado. El modelo relacional de Edgar F. Codd en 1970 desplazó la idea hacia las peticiones declarativas, en las que el usuario indica el resultado deseado y el sistema decide cómo obtenerlo, y System R de IBM convirtió esa idea en un sistema práctico con un optimizador de consultas basado en costes que comparaba planes alternativos antes de la ejecución (historia de IBM sobre Patricia Selinger).
Ese cambio sigue importando cada vez que un equipo ejecuta una consulta en un data warehouse, una base de datos operativa o un flujo de observabilidad. El resultado depende del volumen de datos, de los resultados intermedios, del volumen de escaneo y de los recursos disponibles en ese momento, no solo de si el SQL se analiza correctamente. Para los equipos que trabajan con observabilidad y calidad de datos, la consulta es la operación que se mide, no solo el texto que se revisa. Por eso las plataformas construidas en torno al comportamiento de ejecución, como la data observability de digna, se centran en lo que hace la consulta dentro de la base de datos y no solo en la sintaxis.
Regla práctica: trate el plan de ejecución como parte de la consulta, porque es ahí donde primero aparecen el coste, la presión sobre los recursos y la deriva del plan.
Por qué las comprobaciones de sintaxis no bastan
Una comprobación de sintaxis indica que la sentencia es válida. No indica si leyó demasiados datos, si unió las tablas en el orden equivocado o si produjo un resultado lo bastante plausible como para pasar la revisión. Esa es la brecha con la que los equipos de producción tropiezan una y otra vez, sobre todo cuando el éxito de una consulta se juzga solo por el hecho de que haya terminado.
El otro punto ciego es el comportamiento histórico. El mismo SQL puede comportarse de forma distinta cuando los datos crecen, cambian las estadísticas o una ruta de join se vuelve menos selectiva. La historia de la estandarización también explica por qué los equipos no pueden confiar para siempre en el comportamiento de un único proveedor: SQL ha evolucionado durante décadas a través de revisiones de ANSI e ISO sin dejar de ser el lenguaje común de los sistemas relacionales (historia del estándar SQL de ANSI).
El flujo de trabajo estándar para ejecutar una consulta
El flujo de producción más fiable empieza antes de que la base de datos haga el trabajo pesado. Defina primero la salida necesaria y solicite después solo las columnas mínimas para obtenerla. Así la consulta se mantiene enfocada y se evita arrastrar datos innecesarios por joins y agregaciones posteriores.
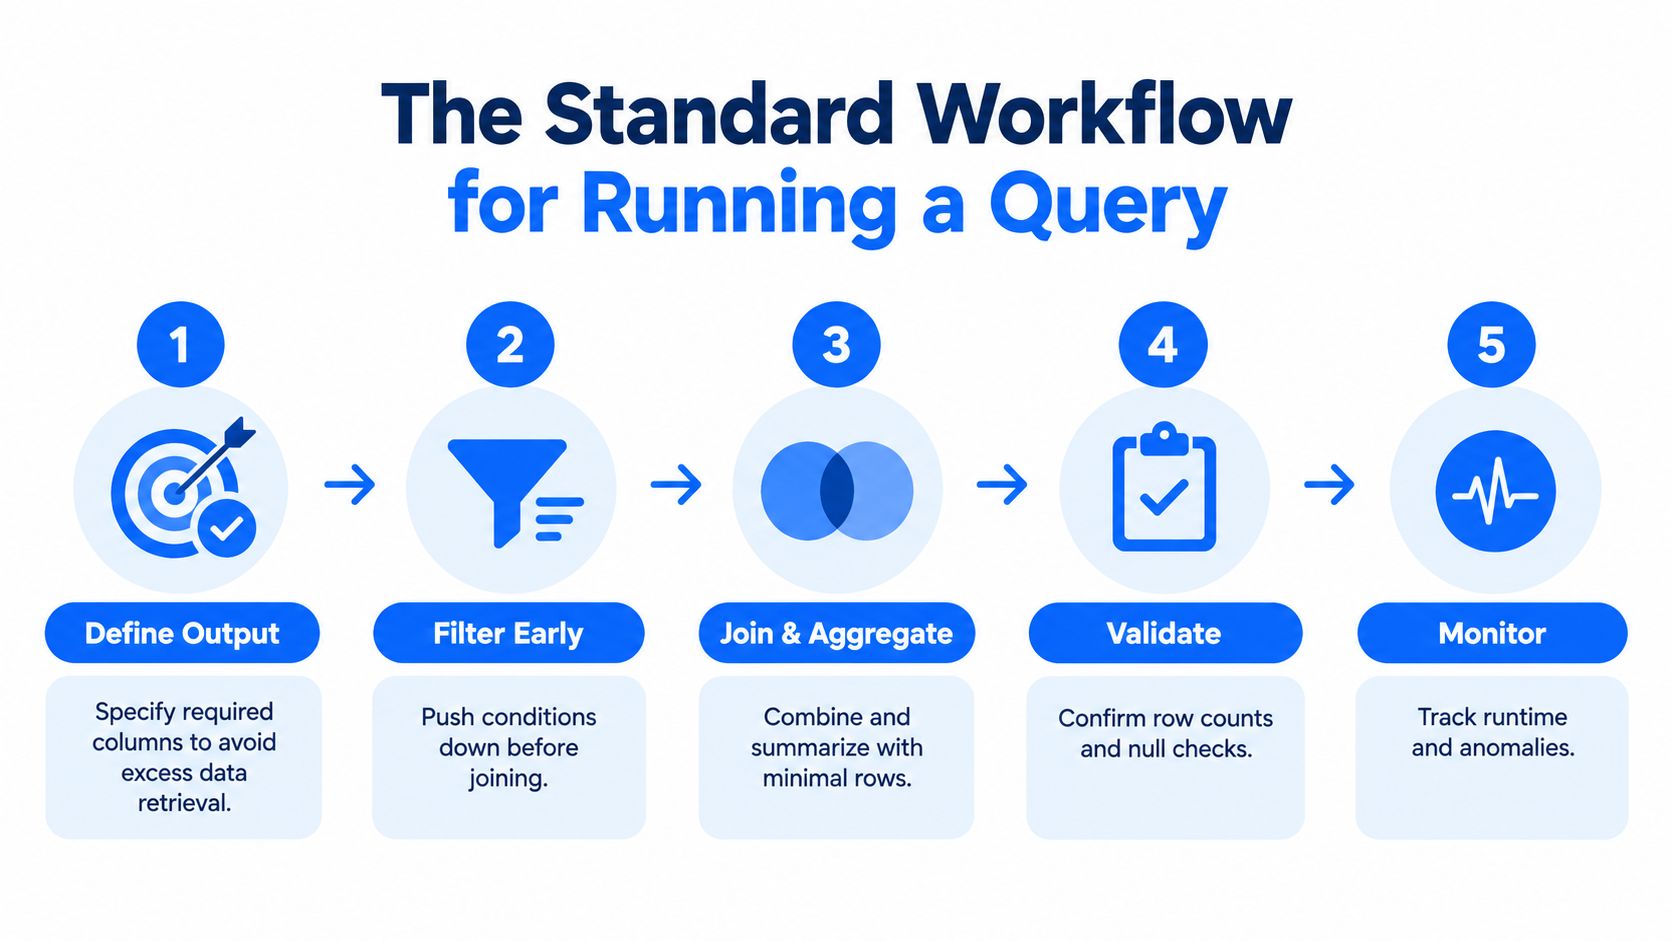
Paso 1 Definir la salida
La definición de la salida debe incluir la granularidad deseada, la población de filas esperada y las columnas necesarias. Si la pregunta de negocio es la actividad diaria de los clientes, no consulte con granularidad cuenta-mes esperando que las cifras cuadren después. Una consulta que pide menos es más fácil de razonar, más barata de ejecutar y mucho menos propensa a dar sorpresas.
Paso 2 Filtrar antes del join
Aplique las condiciones lo antes posible para que la base de datos trabaje con menos filas. Este patrón coincide con la recomendación de Microsoft de consultar solo las columnas necesarias y reducir los datos antes de las operaciones JOIN, y es aún más importante cuando las tablas de origen son grandes o están sesgadas (buenas prácticas de rendimiento de Google BigQuery).
Paso 3 Revisar el plan de ejecución
La revisión del plan debe cubrir el orden de los joins, el volumen de escaneo, las estimaciones de cardinalidad y cualquier fase de ordenación o agregación que pueda convertirse en un cuello de botella. No se fíe de un «parece correcto» en el editor SQL. Compruebe lo que el optimizador cree que ocurrirá y compárelo con la carga de trabajo que espera.
Paso 4 Medir con datos representativos
Ejecute la consulta revisada sobre particiones realistas, no sobre muestras de juguete. Una consulta rápida en un fragmento estrecho puede venirse abajo con el mes en curso, con el cliente más grande o con la caché en frío. Mida el resultado frente al presupuesto de latencia y de recursos que fijó de antemano.
Mantenga la consulta aburrida en producción. Aburrida significa acotada, medible y estable en las particiones que su equipo consulta realmente.
Paso 5 Validar el comportamiento en tiempo de ejecución
Utilice los metadatos del plan y del job para diagnosticar dónde se va el tiempo y vuelva a ejecutar tras cada cambio relevante. En la práctica, una consulta solo está «terminada» cuando devuelve el resultado correcto, se mantiene dentro del presupuesto y se comporta de forma coherente con datos representativos.
Para los equipos que buscan un modelo operativo más profundo, la orquestación de pipelines para cargas de consultas ayuda a conectar la consulta con el resto del flujo de datos en lugar de tratarla como un comando aislado.
Optimizar consultas analíticas con estadísticas y diseño de predicados
Las cargas analíticas suelen pasar desapercibidas hasta que fallan de forma estrepitosa. El SQL es válido, pero el optimizador recibe una señal errónea porque las claves de join no encajan bien, las estadísticas del catálogo están desactualizadas o un predicado fuerza un escaneo más amplio de lo necesario. La guía de ajuste de IBM señala como riesgos recurrentes los tipos de datos que no coinciden, las expresiones en los predicados de join, los joins sin igualdad, los outer joins innecesarios, las restricciones redundantes y las estadísticas de catálogo imprecisas, y esa lista coincide con lo que los equipos ven en sistemas reales (guía de ajuste de consultas de IBM DB2).
Qué perjudica el rendimiento analítico
Las expresiones sobre columnas indexadas o de particionado son una trampa habitual. En cuanto envuelve la columna en una función, el predicado puede dejar de ser sargable, lo que significa que la base de datos no puede usar la ruta de acceso esperada y acaba escaneando más datos de los necesarios. La validación de los tipos de datos importa igual, porque una clave de join que no coincide puede empujar al optimizador hacia un plan menos eficiente.
Aquí también ayudan los recursos de aprendizaje prácticos. Si está desarrollando sus propias habilidades con bases de datos y quiere afinar la parte de ajuste, build database projects without a degree es una lectura externa útil porque orienta el crecimiento profesional hacia el trabajo real y no hacia la teoría.
Un ciclo de validación disciplinado
Ejecute la consulta una vez para comprobar que es correcta y compare después las filas estimadas con las reales en cada fase. A continuación, pruebe el comportamiento con caché en frío y en caliente, mida el tiempo transcurrido y el uso de recursos, y cambie una sola cosa cada vez. Esta secuencia es más lenta que retocar el SQL a ciegas, pero es la única forma de saber si un cambio mejoró el plan o solo trasladó el coste a otro sitio.
Una buena rutina debería incluir:
Validar primero las claves de join. Asegúrese de que los tipos de datos coinciden antes de tocar índices o hints.
Revisar los errores de estimación. Si las estimaciones de filas del plan no son correctas, ajuste las estadísticas o la forma del predicado antes de culpar al hardware.
Medir el consumo de recursos. CPU, memoria, bytes escaneados y volumen de spill o shuffle indican si la consulta está sana.
Repetir tras cada cambio. Varias modificaciones a la vez ocultan la causa de la mejora o de la regresión.
Para los equipos que estandarizan el ajuste de consultas, la guía de optimización de consultas SQL resulta útil porque vincula el diseño de predicados con la ruta de ejecución real en lugar de tratar la optimización como un ejercicio de formato.
Más allá de la sintaxis La brecha de validación semántica en la monitorización de consultas
Una consulta puede ejecutarse con éxito y aun así ser incorrecta de formas que importan. Puede duplicar filas a través de un join, perder registros que llegan tarde, desplazar por accidente un límite de fechas o agregar con la granularidad equivocada mientras devuelve un conjunto de resultados perfectamente limpio. Por eso la sintaxis y el estado de ejecución son, por sí solos, señales débiles.
La investigación independiente sobre bases de datos muestra que los errores de estimación de cardinalidad están muy extendidos y suelen ser la causa principal de los malos planes de consulta (investigación de VLDB sobre el comportamiento de las consultas y la estimación de cardinalidad). Esto es importante porque las suposiciones del optimizador dan forma al plan, y el plan determina el rendimiento y, a veces, la calidad del resultado que usted cree estar obteniendo.
Éxito de ejecución frente a éxito semántico
El éxito de ejecución significa que el motor terminó la sentencia. El éxito semántico significa que la consulta devolvió la población correcta, con la granularidad correcta y con el significado de negocio correcto. Son pruebas distintas, y los equipos de producción necesitan ambas.
Una monitorización de consultas que se detiene en el tiempo de ejecución pasa por alto los fallos más peligrosos. La consulta puede ser rápida, barata y aun así incorrecta. En entornos financieros, sanitarios, de telecomunicaciones y del sector público, ese tipo de error puede contaminar informes, decisiones operativas o entradas de modelos sin desencadenar un incidente evidente.
Un patrón de producción más sólido consiste en asociar expectativas a cada consulta crítica:
Granularidad esperada. Sepa si la salida debe ser cliente-día, cuenta-mes u otra cosa.
Totales de conciliación. Compare los totales de la salida con un total de control fiable cuando exista.
Casos límite representativos. Compruebe de forma explícita las llegadas tardías, las claves duplicadas y las fechas límite.
Línea base de comportamiento. Compare la forma actual del resultado con ejecuciones anteriores y vigile la deriva.
El enfoque in-database de digna encaja con este modelo porque las comprobaciones se ejecutan donde residen los datos, de modo que los equipos pueden validar el comportamiento sin sacar registros sensibles del data warehouse o del almacén operativo. Es una ventaja práctica cuando el objetivo es la observabilidad y no otra copia de los datos.
Cómo gestionar datos tardíos, cambiantes o parciales en las operaciones de consulta
Una consulta puede terminar sin errores y aun así no servir para producción. Un archivo puede llegar después de la hora de corte, una fuente puede recargar filas con carácter retroactivo o un productor puede cambiar la estructura sin previo aviso. El SQL sigue ejecutándose, pero el resultado puede dejar de corresponder al segmento de negocio que se pretendía. Los equipos que solo confían en comprobaciones de aprobado o fallo suelen darse cuenta cuando un dashboard cambia o un proceso posterior consume la salida errónea.
La guía de calidad de datos de la Comisión Europea trata la calidad como algo dependiente del propósito y enumera exactitud, completitud, coherencia, unicidad, integridad, puntualidad, procedencia y métodos de recogida de datos como atributos de calidad. Ese enfoque encaja mejor con el trabajo operativo con consultas que un indicador binario de éxito.
La monitorización necesita un modelo de severidad
Las comprobaciones de frescura, cobertura de periodos, cambios de esquema y completitud no deberían desencadenar todas la misma respuesta. Una carga tardía pero válida puede merecer un aviso. Un archivo de origen ausente debería bloquear el uso posterior. Si todos los problemas son fatales, los equipos dejan de confiar en las alertas. Si todos son informativos, nadie reacciona a tiempo.
Un control sólido nace de umbrales que tienen en cuenta el contexto, no de una única regla de aprobado o fallo para cada conjunto de datos.
Lo más difícil es distinguir los datos tardíos pero válidos de los datos que faltan. Los patrones históricos de llegada ayudan. Las líneas base estacionales también. Y un responsable claro para cada comprobación. Conserve las evidencias para la revisión, porque las preguntas tras un incidente suelen ser sencillas: qué cambió, cuándo cambió y si el resultado seguía siendo seguro de usar.
Donde el contexto supera a la rigidez
Si una fuente suele llegar temprano pero se retrasa una vez por semana, la política debería reflejar ese patrón. Si un conjunto de datos se corrige más tarde ese mismo día, la monitorización debe permitir inconsistencias provisionales sin ocultar fallos reales. Esa es la línea entre un control duradero y una automatización frágil.
Para los equipos que necesitan una definición concreta de frescura, métricas y monitorización de la puntualidad de los datos ofrece una forma práctica de definir el conjunto de reglas y el modelo de severidad de las alertas.
Las entradas tardías y cambiantes también necesitan comprobaciones semánticas. La granularidad, la población y el significado de negocio pueden derivar aunque la frescura parezca aceptable. Ahí ayuda un enfoque in-database, porque permite a los equipos validar esas condiciones donde residen los datos en lugar de copiar registros solo para inspeccionarlos.
Conclusiones prácticas para una ejecución fiable de consultas
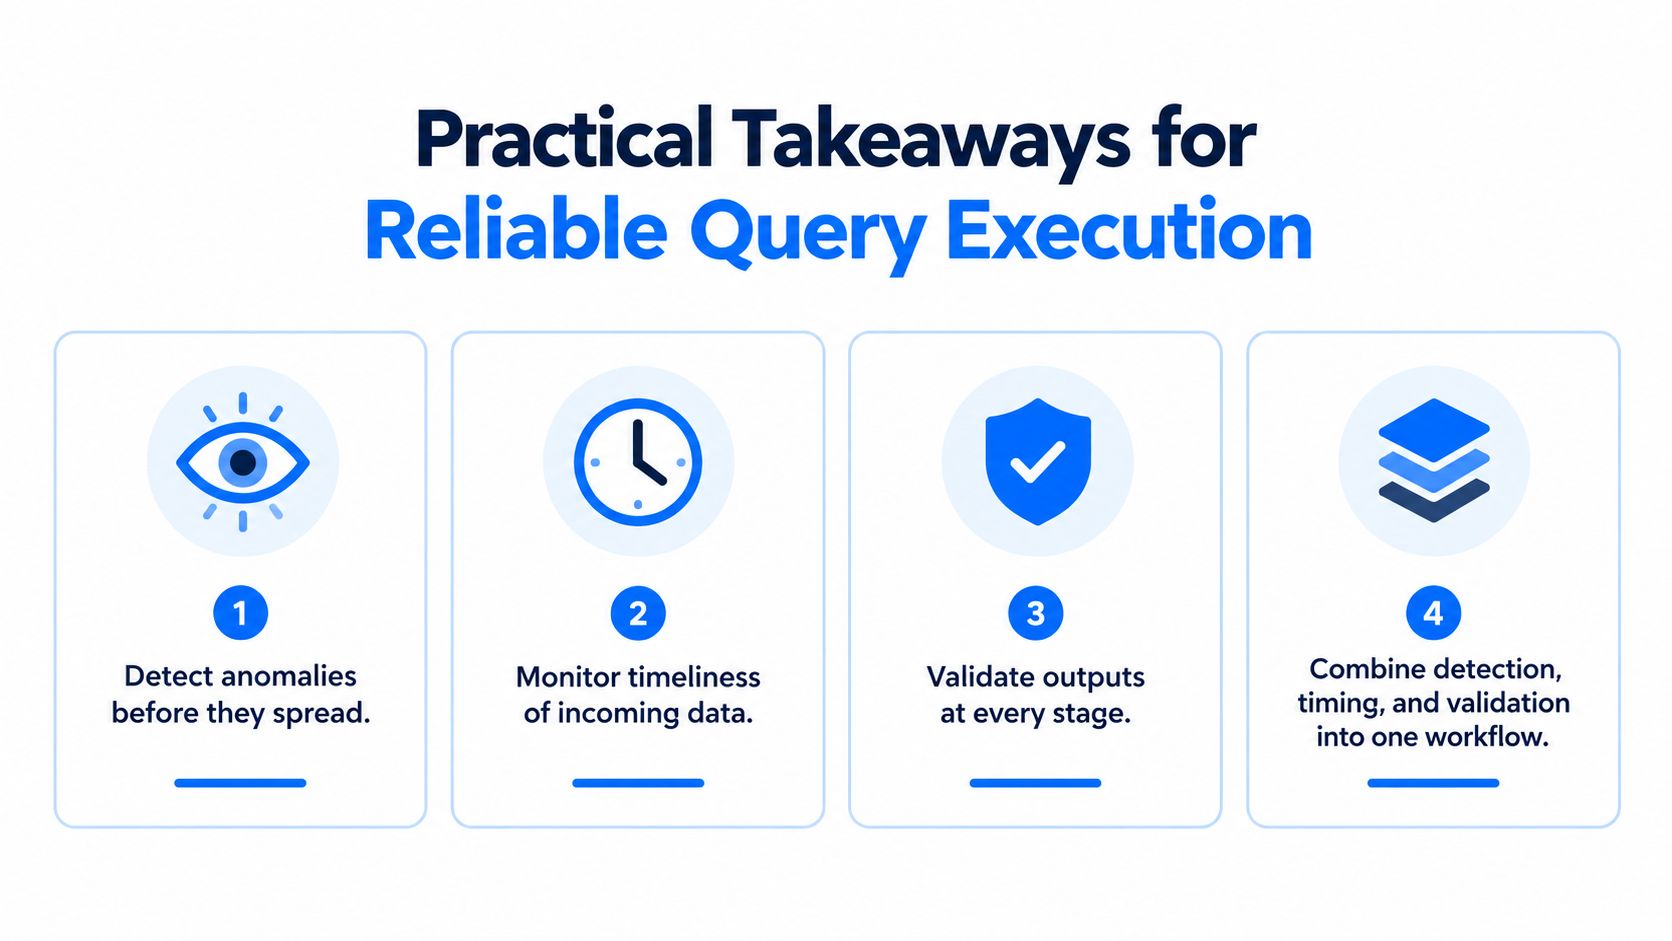
Una consulta que devuelve resultados sin errores puede seguir siendo incorrecta. En producción, una ejecución fiable depende de que el control del rendimiento, el control de la puntualidad y la validación semántica funcionen juntos, porque un resultado rápido con la granularidad o la población equivocadas sigue siendo un fracaso.
Qué estandarizar
Empiece por la granularidad esperada y la ventana de latencia aceptable para cada consulta importante. Registre una línea base de tiempo de ejecución, filas escaneadas y forma de la salida, para que las regresiones sean visibles cuando cambie el comportamiento. Si solo comprueba si la sentencia terminó, se le escapará la deriva que importa.
Mantenga la política lo bastante sencilla para que los operadores puedan aplicarla bajo presión. Defina qué fallos bloquean el uso, cuáles desencadenan una revisión y cuáles son tolerables durante un periodo breve. Ese enfoque alinea detección, validación y gobierno sin convertir cada alerta en una crisis.
Qué funciona en producción
Utilice la detección de anomalías para la deriva, las comprobaciones de puntualidad para las llegadas y la validación para las reglas de negocio. Mantenga esas comprobaciones dentro de la base de datos siempre que pueda, porque copiar datos a otro lugar solo para inspeccionarlos añade coste y riesgo. Si el data warehouse puede probar el comportamiento donde ya residen los datos, el diagnóstico es más rápido y es más fácil confiar en las alertas.
En cuanto al rendimiento de las consultas, mantenga la revisión del plan y la comparación con la línea base en el mismo ciclo. Si el plan cambia, revíselo. Si las estimaciones de filas derivan, compárelas con los valores reales. Si el tiempo de ejecución sigue dentro del presupuesto pero la forma de la salida no es la esperada, trátelo como un problema de datos y no como una ejecución correcta.
Para los equipos que comparan enfoques, el ajuste del rendimiento de bases de datos para consultas fiables es un complemento práctico porque relaciona el comportamiento de las consultas con la estabilidad de la carga de trabajo en lugar de con correcciones aisladas.
Si necesita monitorizar el comportamiento de las consultas, detectar la deriva a tiempo y validar resultados sin mover datos sensibles, visite digna. digna ejecuta las comprobaciones dentro de su data warehouse, de modo que valida granularidad, puntualidad y deriva sin mover ni un solo registro.
Para entender mejor por qué las comprobaciones que se ejecutan donde residen los datos son más seguras y rápidas que exportar registros a una herramienta externa, consulte la ejecución in-database de la calidad de datos.
Preguntas frecuentes
¿Qué significa ejecutar una consulta de forma eficiente?
Ejecutar una consulta de forma eficiente significa que devuelve el resultado correcto, respeta su presupuesto de latencia y recursos y se comporta de forma coherente con datos representativos. Terminar sin errores es solo el listón más bajo. Una consulta puede ser rápida y barata y aun así incorrecta si agrega con la granularidad equivocada o pierde filas tardías.
¿Por qué conviene filtrar antes de hacer un join en SQL?
Filtrar antes del join permite que la base de datos trabaje con menos filas, lo que reduce el volumen de escaneo y el tamaño de los resultados intermedios. Aplique las condiciones pronto y seleccione solo las columnas necesarias. El efecto es mayor con tablas de origen grandes o sesgadas, como también recomienda la guía de rendimiento de BigQuery.
¿Qué hay que revisar en un plan de ejecución?
Conviene revisar el orden de los joins, el volumen de escaneo, las estimaciones de cardinalidad y cualquier fase de ordenación o agregación que pueda convertirse en un cuello de botella. Después, compare las filas estimadas con las reales en cada fase, ya que la investigación señala los errores de cardinalidad como una causa principal de malos planes.
¿Por qué una consulta que se ejecuta con éxito puede devolver resultados erróneos?
El éxito de ejecución solo indica que el motor terminó la sentencia. El resultado puede duplicar filas a través de un join, omitir registros tardíos, desplazar un límite de fechas o agregar con la granularidad equivocada. Asociar expectativas como la granularidad, los totales de conciliación y una línea base de comportamiento detecta estos fallos semánticos.
¿Cómo deben influir los datos tardíos o parciales en la monitorización de consultas?
Los datos tardíos o parciales requieren un modelo de severidad en lugar de una única regla de aprobado o fallo. Una carga tardía pero válida puede merecer solo un aviso, mientras que un archivo de origen ausente debería bloquear el uso posterior. Los patrones históricos de llegada y las líneas base estacionales ayudan a distinguir ambos casos.


