Beneficios de la calidad de datos para las empresas modernas
|
8
minuto de lectura

La mala calidad de los datos sigue siendo una de las formas más rápidas de desangrar el valor de una plataforma de datos. El informe de 2025 de IBM afirma que el 43% de los directores de operaciones clasifican ahora la calidad de los datos como su prioridad de datos más importante, y más de una cuarta parte de las organizaciones estiman pérdidas anuales de más de 5 millones de USD debido a la mala calidad de los datos, con un 7% que reporta pérdidas de 25 millones de USD o más (IBM Institute for Business Value). Eso ya no es un problema de limpieza, es un problema del modelo operativo.
Los equipos con los que he trabajado suelen sentir el dolor primero en el reprocesamiento, no en los titulares. Los analistas dejan de confiar en los paneles, los ingenieros persiguen recuentos que no coinciden y los usuarios de negocio crean hojas de cálculo en la sombra porque los números oficiales siguen cambiando. El coste no son solo los malos informes. Son decisiones más lentas, más validación manual y una menor confianza en cada iniciativa de IA o analítica construida sobre los mismos datos.
Tabla de contenidos
El coste real de la mala calidad de los datos
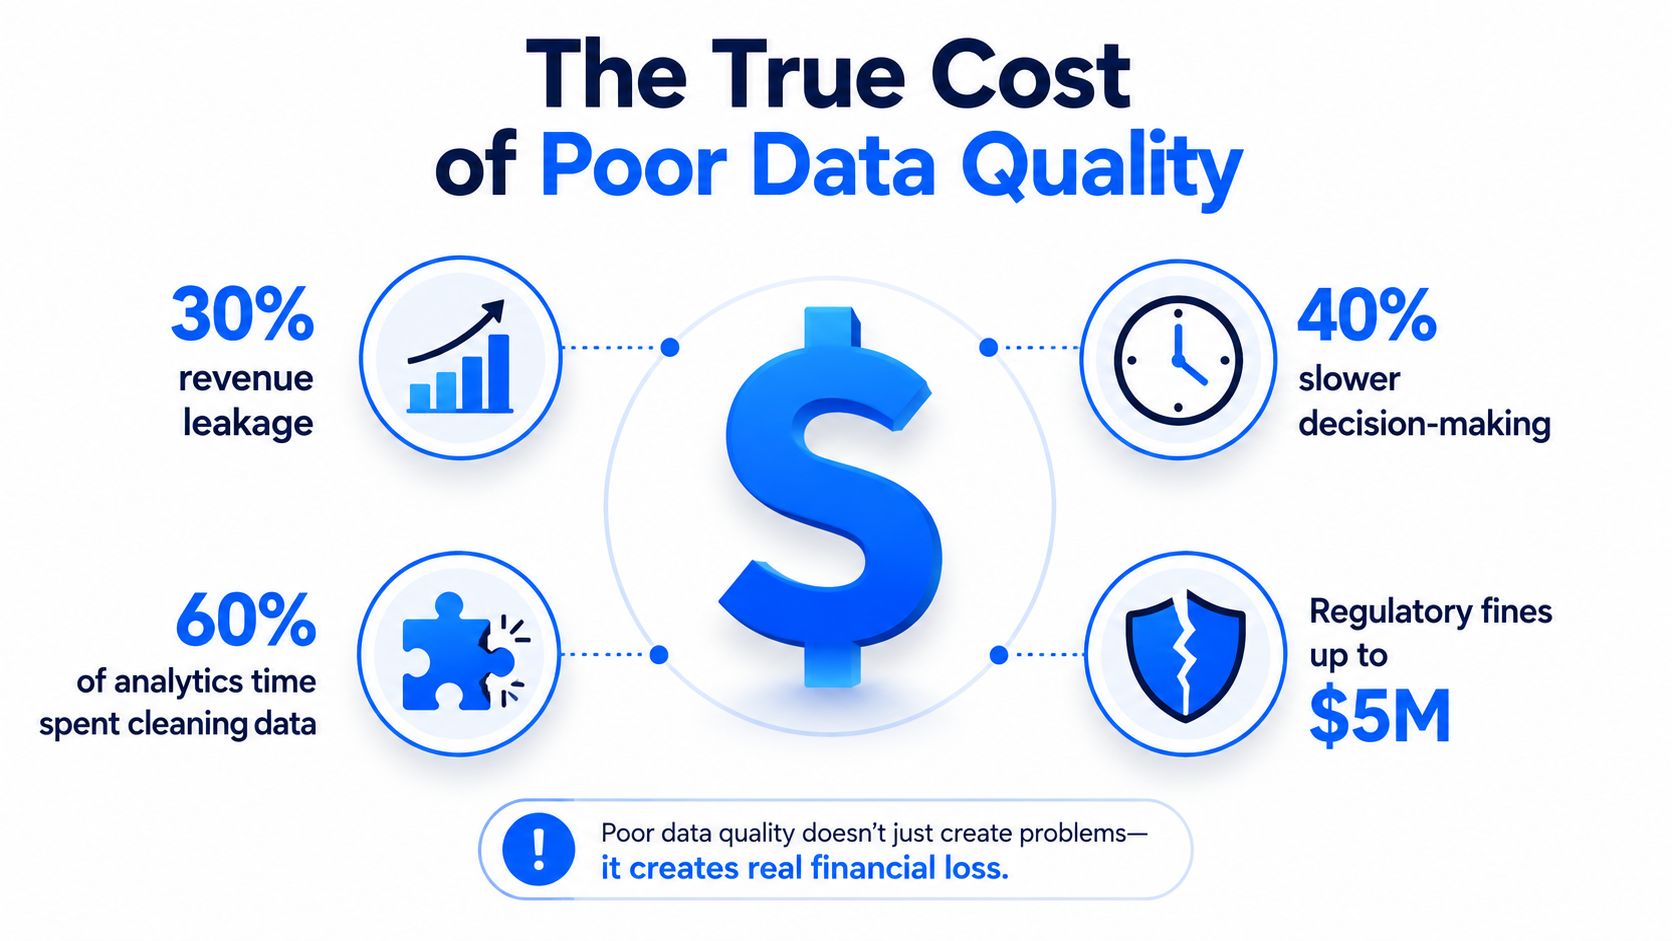
La forma más rápida de perder la confianza en una plataforma de datos es llamar a la calidad de los datos una tarea de mantenimiento. El coste se manifiesta en el incumplimiento de los plazos de los SLA, el reprocesamiento y las decisiones tomadas con entradas obsoletas o inconsistentes. El tema de calidad de datos de Gartner sitúa la pérdida anual media por mala calidad de los datos en 12,9 millones de USD por organización (Gartner data quality topic). Trabajos anteriores del sector también vincularon la mala calidad de los datos con aproximadamente 600.000 millones de USD al año en costes comerciales en EE. UU., razón por la cual el problema siempre ha sido operativo, no estético (IBM Institute for Business Value, Gartner study PDF).
A dónde va realmente el dinero
La pérdida suele acabar en tres lugares. Los equipos queman horas conciliando números en conflicto en lugar de enviar el trabajo. Las malas entradas aumentan los costes operativos porque cada corrección posterior es más cara que detectar el problema antes. Las decisiones también se desvían cuando los datos están incompletos, desactualizados o son inconsistentes.
Regla práctica: si un problema de datos llega a un analista, a un responsable de finanzas y a un ingeniero, el problema ya es costoso.
Ese coste se manifiesta en finanzas, operaciones, Compliance y programas de IA al mismo tiempo. Una forma rápida de hacerlo visible es la calculadora de costes del tiempo de inactividad de los datos, que convierte la frustración vaga en coste de incidencias, tiempo perdido y reprocesamiento.
El caso de negocio es más grande que unos paneles más limpios
El caso de valor no es abstracto. El trabajo de valor de negocio basado en investigación vinculó un incremento del 1,9% en la productividad laboral de TI con unos 21,7 millones de USD para la empresa media, lo que demuestra cómo pequeños aumentos en los procesos pueden generar grandes retornos financieros cuando se escalan en toda la organización. Esa misma lógica se aplica a los controles de calidad de los datos, porque cada ciclo de remediación evitado preserva el tiempo de los analistas, el de ingeniería y la velocidad de toma de decisiones.
Las comprobaciones manuales también crean una deuda de documentación oculta. Los equipos que confían en el conocimiento tribal pasan más tiempo explicando por qué falló una tubería que arreglando la propia tubería. Esa es una de las razones por las que los flujos de trabajo de documentación automatizados para desarrolladores importan en la misma conversación sobre confiabilidad, porque los sistemas más claros son más fáciles de gobernar y tienen menos probabilidades de fallar (automated documentation workflows for developers).
La conclusión práctica es simple. Los datos de mala calidad no solo crean malos informes. Agotan la productividad, aumentan los costes operativos y debilitan la confianza en cada número que aprueban los líderes.
Beneficios técnicos de la Observability automatizada
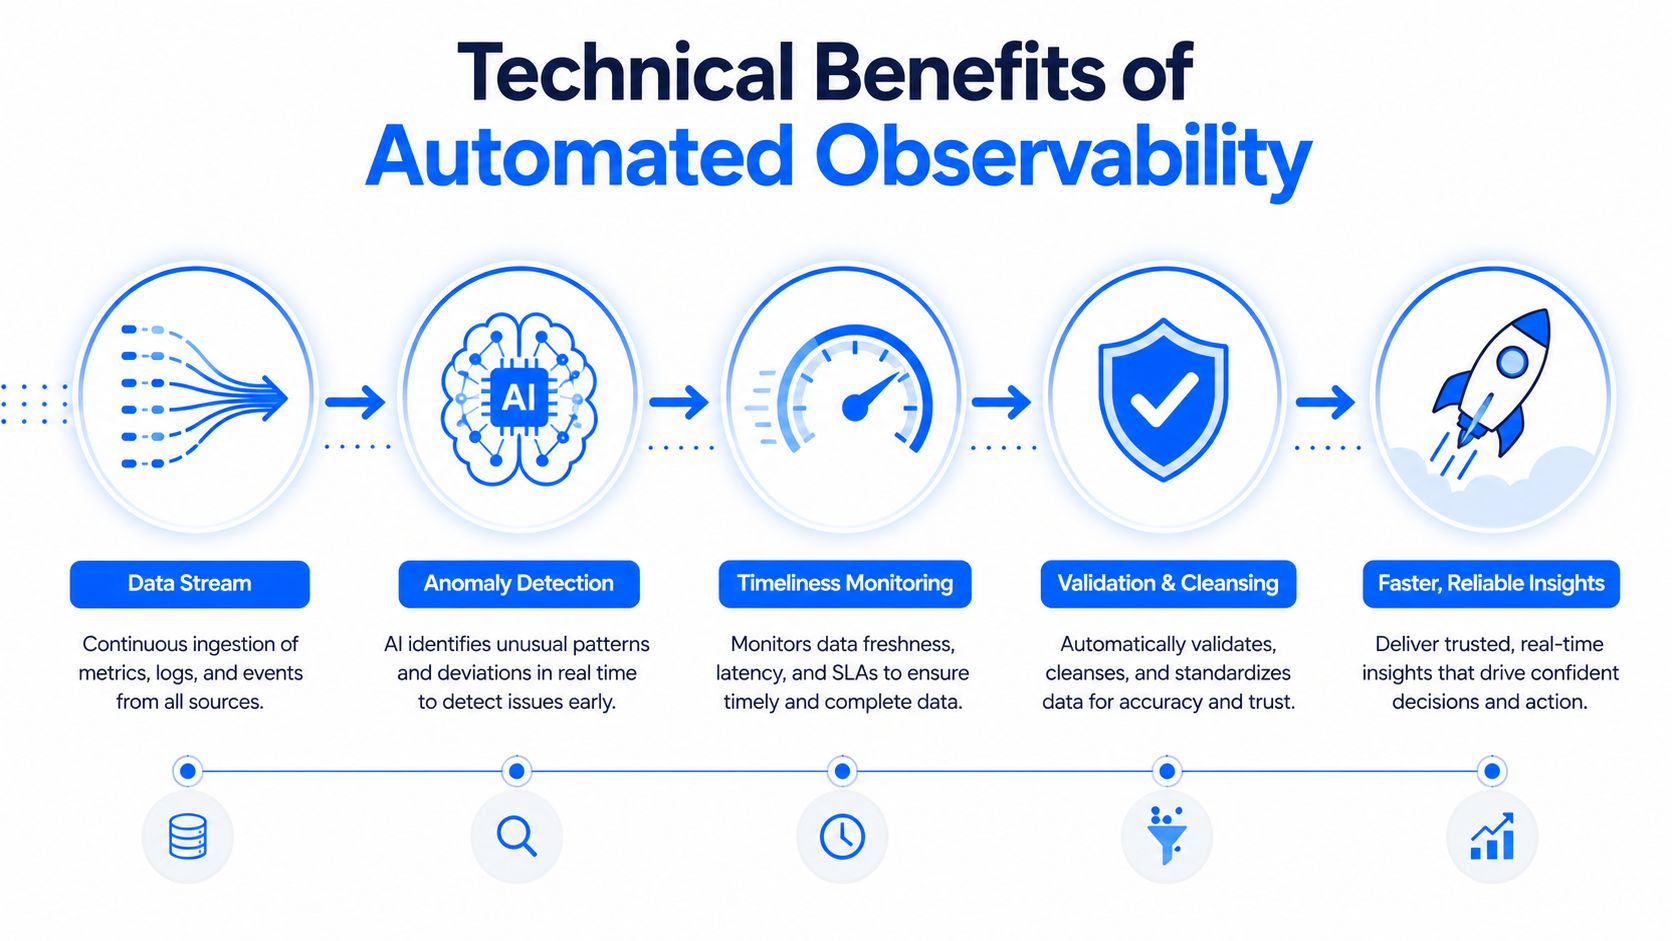
Los conjuntos de reglas manuales fallan rápidamente una vez que las tuberías cambian todos los días. Un pequeño conjunto de comprobaciones diseñadas a mano puede detectar errores conocidos, pero pasa por alto anomalías desconocidas, cambios de esquema silenciosos y llegadas tardías que no rompen una regla estática. La Observability automatizada cierra esa brecha al aprender el comportamiento normal, vigilar la deriva y marcar problemas antes de que los consumidores intermedios los conviertan en informes rotos o modelos inestables.
La detección de anomalías se trata de incógnitas, no solo de umbrales
Las comprobaciones tradicionales funcionan bien para modos de fallo conocidos, pero son ineficaces cuando un conjunto de datos cambia de forma. La detección de anomalías impulsada por IA aprende el comportamiento esperado a lo largo del tiempo y, a continuación, genera una alerta cuando el volumen, la distribución o las relaciones se mueven fuera de la línea base. Eso importa porque muchos incidentes costosos comienzan como cambios sutiles, no como roturas obvias.
La investigación de Google sobre la calidad de los datos para el aprendizaje automático enfatiza que una IA confiable depende de la precisión, exhaustividad y consistencia en los datos de entrenamiento y de prueba, porque las entradas inestables debilitan el comportamiento del modelo y pueden distorsionar los KPI de negocio incluso cuando las tuberías siguen funcionando (Google research). En la práctica, la detección tiene que ocurrir antes de que los registros defectuosos lleguen a los paneles o a los trabajos de reentrenamiento.
El monitoreo de Timeliness y el seguimiento de esquemas protegen la tubería
Los datos tardíos y las estructuras cambiantes son dos de las razones más comunes por las que los equipos pierden la confianza en sus tuberías. Un estudio publicado informó que el monitoreo de esquemas redujo los fallos de integración de datos en un 67,9% y redujo el tiempo de detección de 19,7 horas a 1,3 horas (Google research). Ese es un cambio operativo significativo, porque ventanas de detección más cortas significan que menos usuarios ven métricas obsoletas y menos ingenieros se ven arrastrados a simulacros de incendio.
El monitoreo continuo es más barato que la respuesta a incidentes. Cada hora que detecte antes es una hora menos que pasará explicando por qué el panel estaba mal.
El coste de esperar se muestra aún más claramente en entornos con mucha deriva. Un análisis afirma que la deriva del esquema representa el 70% de los fallos de las tuberías, y que las organizaciones gastan alrededor del 40% de los ciclos de desarrollo en reprocesamiento relacionado con los datos cuando la deriva se encuentra tarde (DataGaps). Incluso si esas cifras no son constantes universales, la tendencia es difícil de pasar por alto. Las comprobaciones manuales hacen muy poco, demasiado tarde.
La ejecución en base de datos importa
Una capa de Observability moderna debería funcionar donde ya viven los datos. La ejecución en base de datos limita el movimiento, mantiene intactos los límites de seguridad y reduce la sobrecarga de llevar tablas grandes a una capa de validación separada. Esa es una de las razones por las que los equipos evalúan plataformas como la de Data Observability de digna, porque su capa comprueba los datos in situ en lugar de duplicarlos.
La victoria técnica se traduce en valor de negocio. Una mejor detección de anomalías reduce el reprocesamiento. El monitoreo de Timeliness acorta las ventanas de incidentes. El seguimiento de esquemas evita fallos silenciosos que de otro modo contaminarían la analítica y las funciones de IA. Esos son controles técnicos, pero el liderazgo siente el resultado en menos paneles rotos, menos escaladas y menos tiempo perdido en limpieza.
La calidad de los datos como base para la preparación para la IA
Los sistemas de IA son tan confiables como los datos que consumen. Eso suena obvio, pero muchos equipos todavía lo aprenden de la manera difícil. Construyen modelos primero, luego descubren que los campos que faltan, los valores obsoletos o las definiciones inconsistentes hacen que los resultados no sean confiables. Una vez que eso sucede, la IA se vuelve más difícil de confiar, más difícil de gobernar y más difícil de escalar.

La preparación para la IA comienza con entradas fiables
La calidad de los datos es la capa de control para la preparación para la IA. Si los conjuntos de entrenamiento están incompletos o son inconsistentes, el modelo hereda esas debilidades. Si los datos de producción se desvían, los resultados se degradan incluso cuando el código sigue siendo el mismo. El fallo a menudo parece un problema del modelo, pero la causa raíz es la inestabilidad de los datos.
El informe de soluciones de calidad de datos de Forrester de 2025 afirma que estas herramientas ayudan a “convertir la confiabilidad y la confianza de los datos en una ventaja competitiva” y “acelerar la preparación y adopción de la IA” (Forrester). Eso coincide con lo que los equipos ven en producción. La calidad de los datos está pasando de ser un trabajo de limpieza a una función de preparación siempre activa.
La governance en tiempo real se está convirtiendo en la norma
Board.org descubrió que el 39% de los líderes de datos tienen dificultades para demostrar el impacto de la gobernanza ante el liderazgo, lo que explica por qué este trabajo todavía carece de puntos de prueba claros en muchas organizaciones (Board.org). La respuesta es la evidencia operativa. El monitoreo en tiempo real, el linaje y el seguimiento de esquemas brindan a los líderes algo concreto que inspeccionar cuando necesitan justificar el gasto o explicar un incidente.
Un avance de la evaluación comparativa de gobernanza también informó que el 69% de los líderes de datos y analítica utilizan el monitoreo de datos en tiempo real como una práctica de Data Governance y calidad de datos (Forrester). Eso coincide con el cambio de modelo operativo que veo con más frecuencia. Los equipos federados no pueden esperar a las auditorías mensuales cuando los modelos, los informes y las decisiones de productos siguen cambiando.
La conclusión práctica es simple. Si la IA depende de la capa de datos, entonces la calidad de los datos tiene que ser tratada como infraestructura de ejecución, no como un elemento de revisión trimestral. Los equipos necesitan disciplina de datos que mantenga los modelos de IA basados en entradas confiables, porque el punto no son unos paneles más bonitos. Se trata de proteger el límite de confianza entre las entradas sin procesar y las decisiones automatizadas.
Casos de uso y soluciones específicos del sector
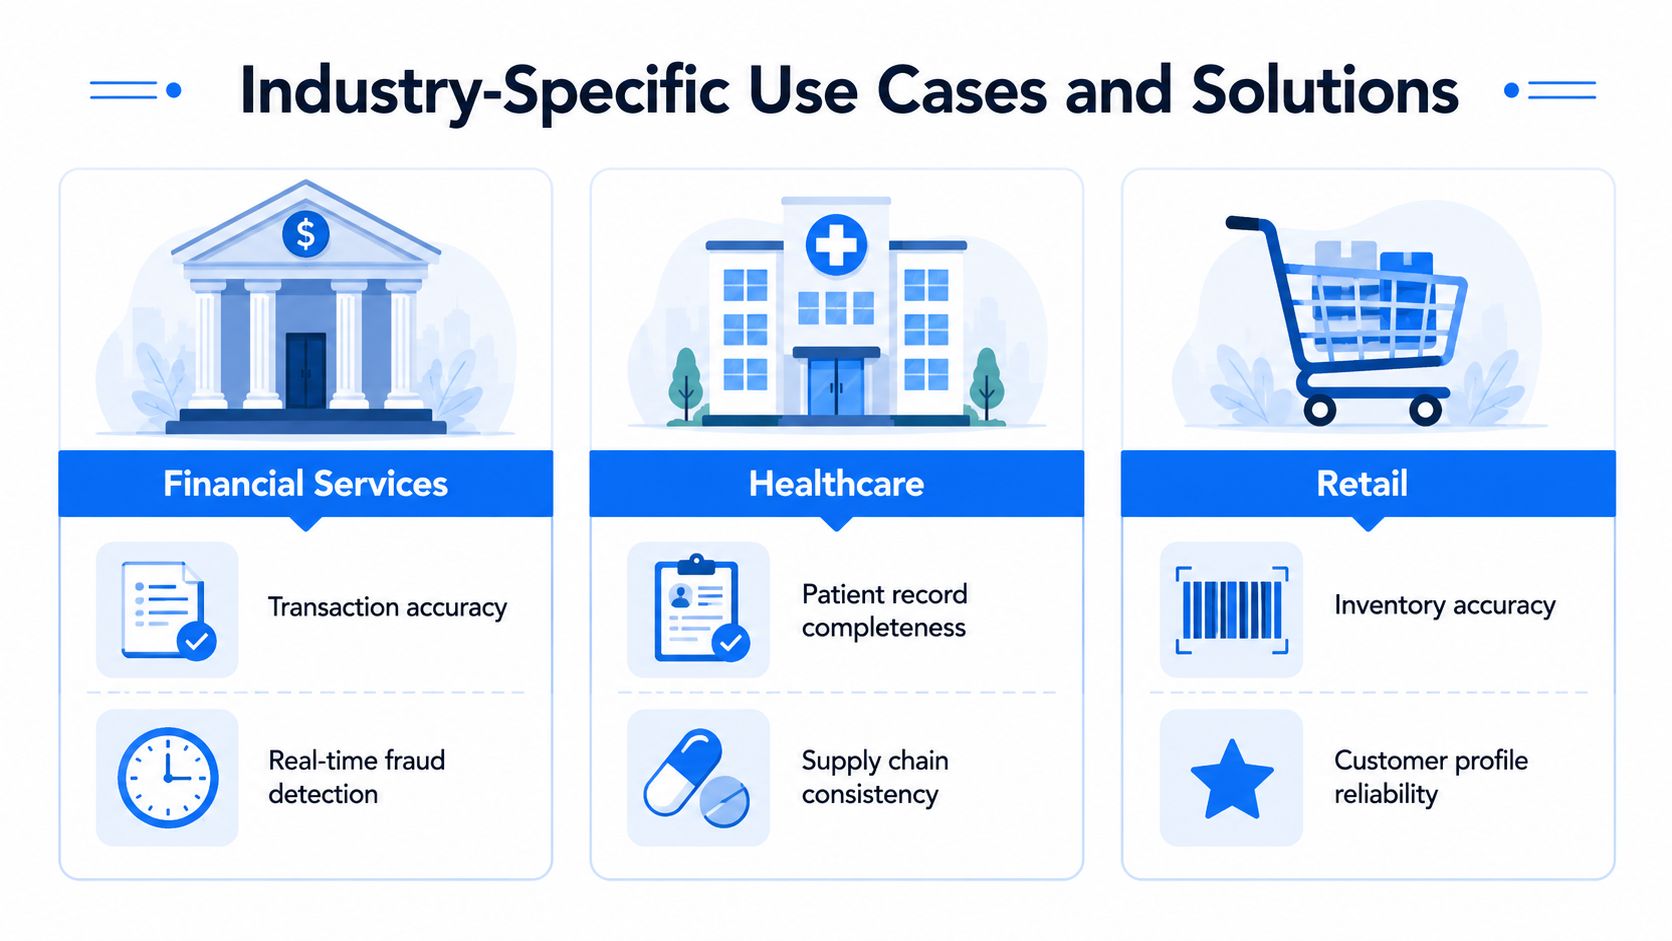
La calidad de los datos se vuelve real cuando se vincula al riesgo del sector. Las finanzas, la atención médica y las telecomunicaciones tienen diferentes modos de fallo, pero comparten el mismo requisito: los números tienen que ser correctos cuando la empresa actúa en consecuencia. Una plataforma tiene que manejar esas diferencias sin obligar a cada equipo a usar el mismo conjunto de reglas frágiles.
Las finanzas necesitan trazabilidad y una rápida gestión de excepciones
En los servicios financieros, el primer requisito suele ser la confianza en los datos transaccionales y regulatorios. Una sola excepción omitida puede distorsionar los informes de riesgo o ralentizar una respuesta de auditoría. Ahí es donde la validación a nivel de registro, el monitoreo de Timeliness y el seguimiento de esquemas importan juntos, porque una transacción que llega tarde o cambia de forma en el momento equivocado crea un problema de informes antes de que nadie se dé cuenta.
Una plataforma modular como digna puede encajar en ese entorno porque monitorea datos financieros, de riesgo, regulatorios y transaccionales a través de la validación, la detección de anomalías, el seguimiento de entregas y el monitoreo de cambios de esquema. El valor no es solo menos errores. Es una mejor trazabilidad cuando el propietario de un negocio pregunta por qué cambió una cifra.
La atención médica depende de la exhaustividad y la coherencia
Los equipos de atención médica se preocupan por la confiabilidad clínica de una manera diferente. Los campos que faltan en los registros de los pacientes, el uso inconsistente de códigos o la llegada tardía de datos operativos pueden complicar la coordinación de la atención y los informes. El monitoreo automatizado ayuda a los equipos a detectar esos problemas a tiempo, antes de que los paneles posteriores o los flujos de trabajo operativos dependan de malas entradas.
In regulated settings, the real cost often comes from delay. A late correction can be more expensive than a preventive check.
El mismo principio se aplica a los datos de la cadena de suministro en la atención médica, donde la coherencia importa tanto como la precisión. Si los registros de productos o inventarios cambian inesperadamente, el problema puede extenderse rápidamente a las operaciones. Los controles continuos de calidad reducen la posibilidad de tener que buscar correcciones a posteriori.
Las telecomunicaciones necesitan escala y registros de clientes estables
Los equipos de telecomunicaciones manejan un alto volumen de datos operativos y de clientes, lo que significa que las pequeñas inconsistencias pueden extenderse rápidamente. Un perfil de cliente duplicado, un evento que falta o un esquema roto pueden afectar a los informes y a los flujos de trabajo de servicio a escala. La respuesta práctica es la validación dirigida, la detección de anomalías y las comprobaciones de disponibilidad que vigilan la degradación a medida que ocurre.
Ahí es también donde Webclaw's duplicate detection guide es un recurso complementario útil, porque el manejo de duplicados es uno de esos problemas que parece menor hasta que comienza a afectar la precisión de las cuentas y la analítica posterior. El punto más importante es que los controles de calidad específicos del sector funcionan mejor cuando son lo suficientemente modulares como para coincidir con el perfil de riesgo real de cada dominio.
Medición del ROI y el impacto de la gobernanza
Muchos equipos pueden describir el trabajo de calidad de los datos. Menos pueden demostrarlo. Esa brecha es la razón por la que se cuestionan los presupuestos de gobernanza. El liderazgo no quiere una filosofía de confianza. Quiere pruebas de que el programa previno incidentes, redujo el reprocesamiento o aceleró las operaciones.
Categoría de métrica | KPI de ejemplo | Impacto comercial |
|---|---|---|
Reducción de incidentes | Menos incidentes de datos al mes | Menos interrupciones de analistas y menos escaladas |
Velocidad de detección | Menor tiempo para detectar anomalías o cambios de esquema | Menor radio de impacto y remediación más rápida |
Timeliness | Menor tasa de llegadas de datos retrasadas | Informes más confiables y decisiones más frescas |
Cobertura de validación | Mayor porcentaje de tablas críticas con comprobaciones automatizadas | Menos revisión manual y menos problemas omitidos |
Reprocesamiento | Menor esfuerzo de reconstrucción o conciliación de informes | Menor coste de mano de obra y ciclos de cierre más rápidos |
Prueba de gobernanza | Pistas de auditoría y evidencia de linaje más visibles | Mayor confianza del liderazgo y apoyo al cumplimiento |
Comience con KPI operativos, no con puntuaciones abstractas
Los cuadros de mando más sólidos comienzan con métricas de incidentes. Cuente con qué frecuencia llegan datos defectuosos a los usuarios, cuánto tiempo se tarda en encontrar el problema y cuánto se tarda en resolverlo. Esas no son métricas de vanidad. Se asignan directamente al tiempo del analista, al tiempo de ingeniería y al retraso comercial.
Una segunda capa debería medir la calidad de la detección. Si el seguimiento de esquemas detecta un cambio de ruptura antes de que llegue a los consumidores intermedios, esa es una victoria de gobernanza con un resultado operativo claro. Si la detección de anomalías acorta la brecha entre el inicio del problema y la alerta, el equipo reduce el radio de impacto. Estos son los controles que muestran si la plataforma está protegiendo el negocio.
Vincule las métricas al reprocesamiento y a la latencia de las decisiones
Una vez que las métricas de incidentes sean visibles, conéctelas con el trabajo que eliminan. Menos cargas defectuosas significan menos paneles corregidos. Una mejor Timeliness significa menos espera para números actualizados. Una validación más sólida significa menos muestreo manual y menos debate sobre si un informe es seguro de usar.
Un lugar práctico para fundamentar la narrativa es el caso de negocio de calidad de datos, porque los líderes de finanzas y operaciones suelen querer lo mismo: una línea creíble desde el control hasta el resultado. Esa línea es más fuerte cuando se muestra qué controles eliminaron qué clase de fallo.
Construya un cuadro de mando que el liderazgo realmente lea
Mantenga pequeño el cuadro de mando. Incluya solo las métricas que reflejen el impacto comercial, no cada señal interna que emita la plataforma. Si un KPI no cambia una decisión, no reduce un riesgo o no ahorra tiempo, no pertenece a la vista ejecutiva.
Regla de oro: si una métrica de calidad de datos no se puede vincular a un incidente, a un retraso de proceso o a un grupo de costes, probablemente sea demasiado abstracta para los informes de liderazgo.
Es por eso que los programas más creíbles combinan métricas técnicas con métricas comerciales. No solo dicen que los datos mejoraron. Demuestran que los incidentes disminuyeron, el reprocesamiento bajó y la gobernanza se volvió más fácil de probar.
Modos de fallo comunes y conceptos erróneos
Los peores programas de calidad de datos suelen fallar por razones predecibles. La primera es la dependencia excesiva de reglas creadas a mano. Los ingenieros escriben comprobaciones para lo que saben hoy, luego la fuente cambia mañana y el conjunto de reglas deja de cubrir el problema. La segunda es asumir que la calidad de los datos es un proyecto en lugar de una disciplina operativa.
Un análisis ampliamente citado de la deriva de esquemas afirma que la deriva representa el 70% de los fallos de las tuberías y que los equipos gastan alrededor del 40% de los ciclos de desarrollo en reprocesamiento relacionado con los datos cuando se detecta tarde (DataGaps). Esa es exactamente la razón por la que las comprobaciones manuales periódicas se quedan cortas. Pueden confirmar el último estado conocido, pero no protegen contra nuevas estructuras, nuevos valores o nuevos patrones de tiempo.
Por qué las reglas manuales fallan bajo cargas de trabajo reales
Las comprobaciones manuales son frágiles porque dependen de que alguien anticipe el próximo fallo. Cuantas más tuberías tenga, menos realista se vuelve eso. Si cada nueva fuente requiere un nuevo conjunto de validaciones personalizadas, el equipo termina manteniendo comprobaciones en lugar de mejorar la plataforma.
Un mejor enfoque es utilizar el monitoreo continuo para las incógnitas y la validación dirigida para las reglas de negocio conocidas. Ese equilibrio es lo que mantiene el sistema flexible y auditable.
Por qué la limpieza de duplicados no es la respuesta completa
La detección de duplicados importa, pero es solo una parte de la calidad. Si los equipos se centran exclusivamente en los duplicados, pueden pasar por alto problemas de Timeliness, cambios estructurales y definiciones de negocio inconsistentes. Es por eso que el manejo de duplicados debe ubicarse dentro de un modelo de calidad más amplio, no actuar como todo el modelo.
Cuando los equipos tratan la limpieza como un proyecto único, la plataforma retrocede tan pronto como cambia el próximo feed. El mejor patrón es asumir que la deriva ocurrirá y monitorearla continuamente. Esa es la única manera de reducir el fallo silencioso.
Implementación de una estrategia de Modern Data Quality
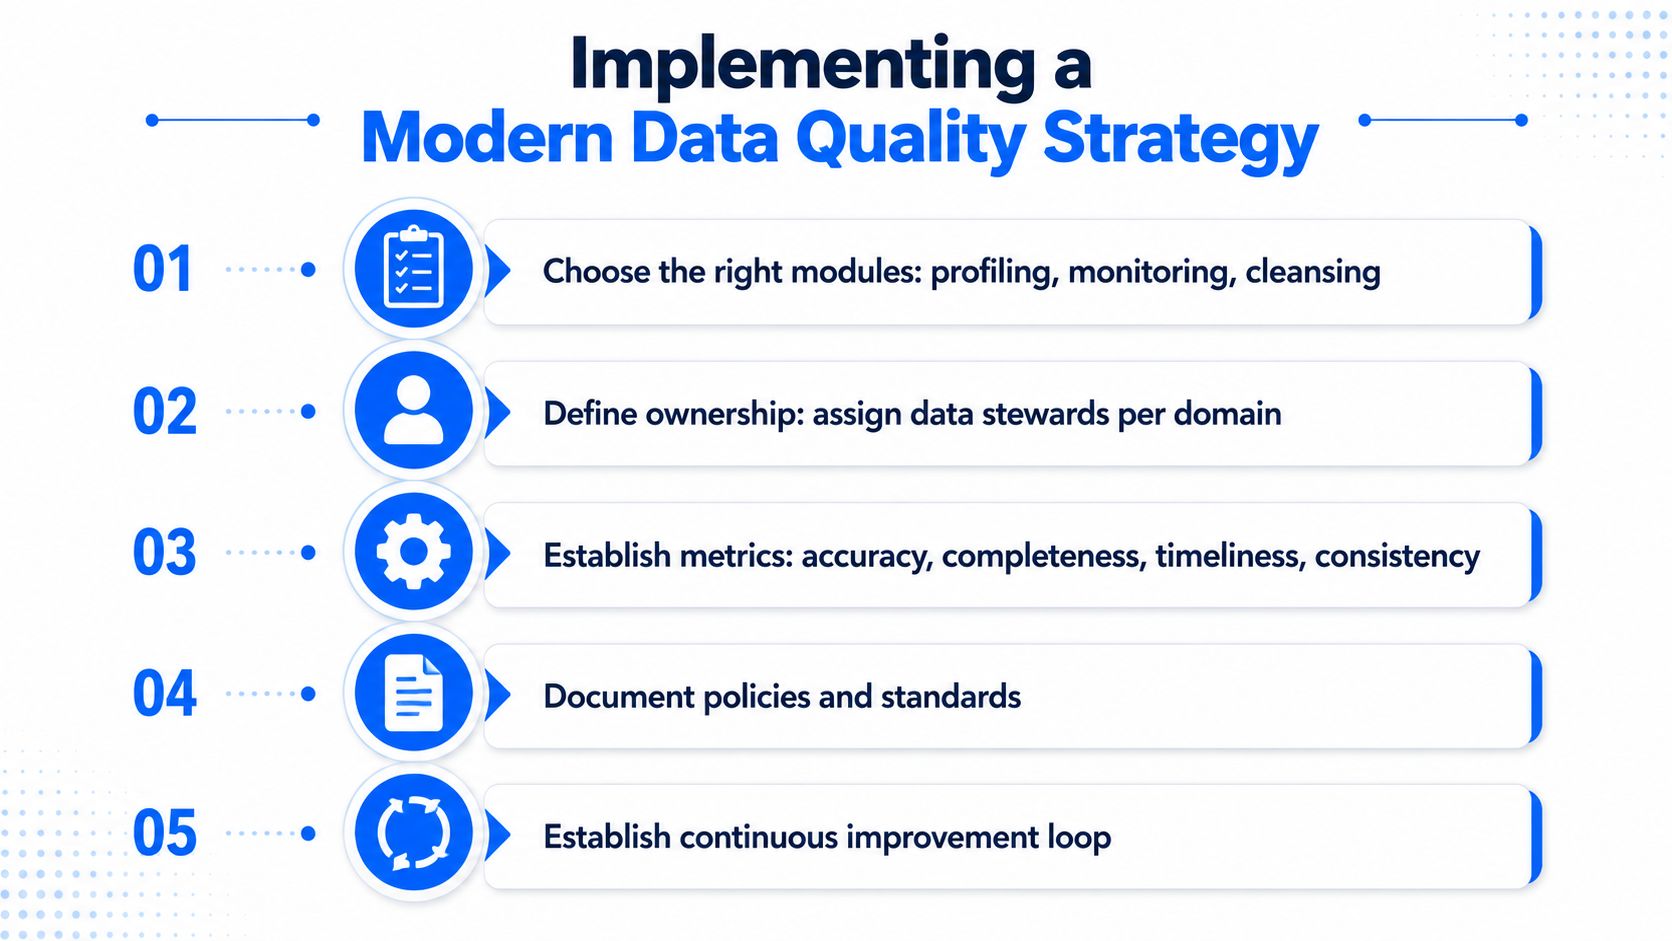
Una estrategia moderna comienza con la propiedad. Alguien tiene que ser el propietario de cada conjunto de datos crítico, cada regla de negocio y cada ruta de alerta. Sin eso, los problemas se reconocen pero nunca se resuelven. Las empresas que hacen esto bien no confían en un lenguaje de administración vago. Asignan la responsabilidad a nivel de dominio y la hacen visible.
Elija los controles que coincidan con el riesgo
Comience con el perfilado, la detección de anomalías, el monitoreo de Timeliness, el seguimiento de esquemas y la validación. Esos cinco controles cubren la mayoría de los patrones de fallo que afectan a la producción. Una plataforma debería permitirle comenzar con un módulo y expandirse a medida que crece la huella, en lugar de forzar una implementación de todo a la vez.
El recurso data governance for reliable data es un complemento útil aquí porque la gobernanza solo funciona cuando las reglas, la propiedad y los bucles de retroalimentación son lo suficientemente prácticos como para ejecutarse todos los días. Ese es el filtro clave: si los controles se adaptan al ritmo operativo.
Mantenga los datos en su lugar y el bucle de retroalimentación estrecho
La ejecución en base de datos importa porque reduce el movimiento innecesario y mantiene la capa de control cerca de la fuente de verdad. Eso simplifica la seguridad y hace que el proceso sea más fácil de escalar a través de almacenes, lagos y tuberías. También acorta el camino desde la detección hasta la acción, que es donde las organizaciones suelen perder tiempo.
Un plan de implementación sólido debería incluir:
Definir la propiedad claramente. Asignar responsables para dominios críticos para que las alertas no caigan en una bandeja de entrada compartida y desaparezcan.
Documentar políticas y estándares. Escribir las reglas que importan, especialmente para campos regulados o críticos para el negocio.
Automatizar los bucles de retroalimentación. Dirigir los incidentes de vuelta a los propietarios que puedan solucionar las causas previas, no solo los síntomas.
Medir lo que siente el liderazgo. Realizar un seguimiento del número de incidentes, la velocidad de detección, el reprocesamiento y la frescura, y luego informar de esos números de manera constante.
Comenzar poco a poco y luego expandirse. Demostrar el modelo en un conjunto de datos crítico antes de ampliar la cobertura.
Construya para la adopción a largo plazo
Los mejores programas de calidad de datos se sienten menos como una carga de cumplimiento y más como una infraestructura compartida. Los ingenieros confían en ellos porque reducen los simulacros de incendio. Los analistas confían en ellos porque los números dejan de cambiar sin explicación. El liderazgo confía en ellos porque la historia de gobernanza está respaldada por métricas visibles.
También está disponible una guía práctica de implementación en data quality implementation, especialmente si está intentando pasar de las comprobaciones manuales a la Observability automatizada sin perder el control sobre la propiedad y la auditabilidad. Ese es el punto de una estrategia moderna: menos limpieza, más confianza y una capa de calidad que escala con el negocio.
Si está listo para convertir la calidad de los datos en una capa de control medible en lugar de una tarea de limpieza recurrente, visite digna y vea cómo su monitoreo en base de datos, validación, Timeliness y seguimiento de esquemas pueden encajar en su propia pila. Las ganancias más rápidas suelen provenir de un conjunto de datos crítico, un propietario claro y un bucle automatizado que evita que los datos defectuosos vuelvan a llegar al negocio.


