La arquitectura de Data Observability explicada de forma sencilla
|
8
minuto de lectura

Un panel puede estar en verde mientras que la decisión detrás de él ya es incorrecta. El pipeline se completó, el warehouse está disponible y cada trabajo programado reporta éxito; sin embargo, un sistema de origen entregó datos atrasados, un equipo de upstream cambió un tipo de columna o una carga parcial eliminó registros. El equipo de finanzas ve los ingresos de ayer, un equipo de operaciones pasa por alto un problema en desarrollo y una función de IA consume entradas que ya no coinciden con las suposiciones utilizadas durante el entrenamiento.
Los equipos suelen empezar agregando más alertas. Este enfoque ayuda hasta que se activa una alerta sin propiedad, contexto o una visión clara del impacto downstream. El problema más profundo es arquitectónico: ¿dónde se ejecuta el cómputo de la Observability, dónde residen los metadatos y cómo conecta el sistema una señal técnica con las personas y los procesos de negocio afectados por ella?
La arquitectura de Data Observability responde a esas preguntas. Extiende el monitoreo de infraestructura tradicional con una visibilidad continua a través de pipelines de datos, warehouses, lakes, paneles y entradas de aprendizaje automático. La categoría comercial se ha expandido rápidamente. Una estimación de la industria para 2026 valora el mercado de la Data Observability en 3.51 mil millones de USD y proyecta 6.03 mil millones de USD para 2031, con una tasa de crecimiento anual compuesto (CAGR) del 11.42% entre 2026 y 2031 (estimación de mercado de Mordor Intelligence). Otro informe de 2026 valora el mercado en 3.4 mil millones de USD en 2026, frente a los 2.94 mil millones de USD en 2025 (informe de mercado de Spherical Insights).
La lección práctica es simple. Una arquitectura confiable no solo debería decirle que una tabla cambió. Debería mostrar qué cambió, si el cambio es el esperado, qué activos downstream dependen de él y si la señal afecta a los informes, las operaciones, la governance o la IA. Los equipos que deseen una forma estructurada de pensar en la confiabilidad también pueden usar esta guía para medir la confiabilidad de los datos.
Tabla de contenidos
Introducción: Por qué la arquitectura de Data Observability importa ahora
Qué significa realmente la arquitectura de Data Observability
Su hoja de ruta para implementar la arquitectura de Data Observability
Introducción: Por qué la arquitectura de Data Observability importa ahora
Un incidente típico comienza de manera sutil. Un trabajo de ingesta recibe menos registros de lo habitual, pero finaliza con éxito. Una transformación continúa ejecutándose porque el esquema es técnicamente válido. El panel se actualiza según lo programado, por lo que su indicador de estado permanece en verde. Nadie lo nota hasta que un líder pregunta por qué una métrica comercial se ha movido inesperadamente.
El monitoreo tradicional es bueno para responder preguntas operativas como si un servidor está disponible, si un trabajo finalizó o si un proceso devolvió un error. Los sistemas de datos necesitan más contexto. Los datos cambian de forma, volumen, distribución, sincronización y significado mientras se mueven a través de la ingesta, la transformación, el almacenamiento y el consumo. Un pipeline puede estar operativamente sano mientras produce datos incompletos, obsoletos o estructuralmente incompatibles con el uso downstream.
El punto ciego suele ser arquitectónico
La arquitectura moderna de Data Observability surgió porque las métricas básicas de infraestructura y el monitoreo del rendimiento de las aplicaciones no podían explicar estas fallas. A medida que los pipelines se volvieron más distribuidos, los equipos agregaron verificaciones para la calidad de los datos, el linaje, las anomalías y el comportamiento en tiempo real. La disciplina ahora funciona como una capa arquitectónica para la confiabilidad y la governance, no meramente como un panel de respuesta a incidentes.
Esa distinción importa a varios grupos:
Los ingenieros de datos necesitan encontrar la fuente de una falla sin tener que buscar en herramientas desconectadas.
Los ingenieros de analítica y desarrolladores de BI necesitan la confianza de que las transformaciones y los paneles reflejan entradas actuales y estructuralmente válidas.
Los líderes de governance necesitan evidencia de que los controles se aplican de manera continua en warehouses, lakes y pipelines.
Los equipos de IA necesitan trazabilidad desde los registros de origen a través de las funciones, los datos de entrenamiento y las entradas del modelo.
La arquitectura determina si esos grupos comparten un mismo contexto o lo arman manualmente durante un incidente. Una capa central de metadatos puede conectar la propiedad, el linaje, el comportamiento histórico y el uso. La ejecución distribuida puede mantener las verificaciones cerca de los sistemas que contienen los datos. El sistema de alertas puede entonces dirigir un evento significativo en lugar de enviar una métrica aislada a un canal genérico de operaciones.
Lo que permite una buena arquitectura
Un sistema bien diseñado detecta modos de falla tanto conocidos como inesperados. Las comprobaciones deterministas pueden hacer cumplir reglas explícitas, mientras que los métodos estadísticos pueden identificar comportamientos inusuales sin requerir que alguien prediga cada problema posible. El resultado no son datos perfectos por definición. Es un sistema de retroalimentación que brinda a los equipos evidencia más temprana, un mejor diagnóstico y una base más clara para priorizar la remediación.
La arquitectura también afecta la governance, la portabilidad y el control de facturación. Mover datos a un servicio externo puede simplificar algunos análisis, pero puede introducir inquietudes adicionales de acceso, movimiento e infraestructura. Ejecutar verificaciones dentro de un entorno existente de warehouse o lake puede preservar la localidad de los datos, aunque requiere una planificación cuidadosa en torno a los permisos, las cargas de trabajo y los motores compatibles. Esos compromisos merecen tanta atención como la lista de métricas que se están monitoreando.
Qué significa realmente la arquitectura de Data Observability
Una analogía útil es el tablero de un automóvil. El monitoreo tradicional podría indicarle si el motor está en marcha y si el vehículo tiene energía. La Observability le brinda una vista más rica: velocidad, nivel de combustible, temperatura, indicadores de advertencia y suficiente contexto para comprender por qué el automóvil no se comporta como se espera.

Aplique esa analogía a una plataforma de datos. El plano de datos es donde los datos se generan, mueven, transforman y almacenan. El plano de control define programas, políticas, umbrales, flujos de trabajo y respuestas. La capa de metadatos explica qué es cada activo, quién lo posee, cómo se conecta con otros activos y cómo se ha comportado a lo largo del tiempo.
Construya la definición en tres pasos
Primero, identifique el sistema observable. Incluye aplicaciones de origen, trabajos de ingesta, herramientas de transformación, warehouses, lakes, paneles y entradas de modelos. La Observability debe seguir los datos a lo largo de ese camino, no detenerse en el primer trabajo exitoso.
Segundo, identifique las señales. Las métricas describen comportamientos medibles como el tiempo de llegada, el volumen o la distribución. Los logs registran eventos y errores. Las señales predictivas destacan desviaciones de los patrones esperados. El linaje y los metadatos agregan el contexto que convierte una advertencia en una ruta de investigación.
Terc, identifique el bucle de decisión. La plataforma recopila o calcula señales, las evalúa frente a reglas o líneas base aprendidas, enriquece los eventos con contexto y dirige las acciones a los propietarios o flujos de trabajo de incidentes. Ese bucle es lo que separa la Observability de un informe estático de calidad.
Por qué las herramientas de calidad por sí solas no son suficientes
Una herramienta de calidad de datos puede validar que los valores se ajusten a las reglas conocidas. Eso es valioso, pero no explica automáticamente si una tabla retrasada afecta a un informe regulatorio, qué equipo es dueño de la fuente upstream o si ese mismo comportamiento es normal para un cronograma de entrega en particular. La Observability combina la validación con la Timeliness, la detección de anomalías, el linaje y el contexto operativo.
La arquitectura también debe permanecer independiente de los pipelines que observa. Las pautas prácticas separan la plataforma de Observability del sistema de datos observable, lo que permite a la plataforma monitorear entornos nuevos y heredados sin forzar reescrituras arquitectónicas (guía de arquitectura académica). Esta independencia permite a los equipos agregar cobertura de manera incremental en lugar de rediseñar primero cada warehouse, lake o flujo de trabajo de orquestación.
En lenguaje sencillo, la arquitectura de Data Observability es la disposición de la ejecución, recopilación, metadatos, análisis y acción que permite a un equipo comprender el estado actual y esperado de los datos a lo largo de todo su ciclo de vida.
Capas y componentes principales de una arquitectura moderna
Una arquitectura moderna funciona mejor como un conjunto de capas especializadas. Cada capa asume una responsabilidad diferente, pero todas comparten suficientes metadatos y contexto de eventos para respaldar el diagnóstico.

Sistemas de origen y el plano de datos
Los datos comerciales se originan y las transformaciones se ejecutan dentro de este plano. Puede incluir bases de datos operativas, aplicaciones SaaS, sistemas de transmisión (streaming), almacenamiento en la nube, warehouses y lakes. El plano de datos debe seguir siendo responsable del trabajo de mover y procesar los datos.
Una elección de diseño importante es si los cálculos de Observability se ejecutan aquí. La ejecución en la base de datos puede calcular métricas y realizar comprobaciones dentro de fuentes de datos compatibles, mientras que un diseño externo extrae información para su análisis en otro lugar. Mantener la ejecución cerca de los datos puede reducir el movimiento innecesario y preservar los límites de seguridad existentes, pero los equipos aún necesitan gestionar los permisos y el aislamiento de las cargas de trabajo.
Recolección e ingesta
La capa de recopilación reúne telemetría y metadatos del plano de datos. Puede capturar estadísticas de tablas, eventos de pipelines, cambios de esquema, comportamiento de consultas, tiempos de entrega, resultados de validación y actualizaciones de linaje. El propósito no es copiar cada registro en el sistema de Observability. Es recopilar las señales y referencias necesarias para comprender el comportamiento.
Una capa de recopilación sólida admite tanto patrones programados como basados en eventos. Las comprobaciones programadas son útiles para ventanas de entrega conocidas. Los eventos son útiles cuando cambia un esquema, se completa un pipeline o una fuente emite una transición de estado relevante.
Orquestación centralizada y metadatos
La capa de control programa las comprobaciones, aplica políticas, almacena la configuración y coordina las alertas. La capa de metadatos enriquece cada señal con la propiedad, definiciones, linaje, uso, entorno y contexto histórico. Juntos, responden a las preguntas que las métricas en bruto no pueden responder.
Esta capa también debe admitir entornos heredados y heterogéneos. Una plataforma que solo entiende un warehouse deja puntos ciegos en torno a los sistemas locales (on-premises), nubes múltiples o herramientas de orquestación más antiguas. El objetivo arquitectónico es un modelo de contexto compartido, no una uniformidad forzada en cada sistema subyacente.
Observability y acción
La capa superior presenta el estado de salud, tendencias, anomalías, incidentes e impacto. Debería ayudar a quien responde a pasar de una señal a una decisión:
Detección: ¿Qué comportamiento cambió?
Diagnóstico: ¿Qué evento o transformación upstream puede explicarlo?
Impacto: ¿Qué conjuntos de datos, paneles, modelos o procesos dependen de ello?
Acción: ¿Quién es el propietario de la solución y cómo se debe realizar el seguimiento del evento?
Esta estructura se alinea con una guía más amplia de arquitectura de sistemas de datos, donde los límites entre procesamiento, orquestación, metadatos y consumo deben permanecer explícitos.
Regla de arquitectura: Mantenga la ejecución cerca de los datos cuando la governance y el costo exijan localidad, pero mantenga el contexto lo suficientemente centralizado para que quienes responden puedan comprender el impacto en toda la plataforma.
Los cinco pilares que detectan fallas silenciosas de datos
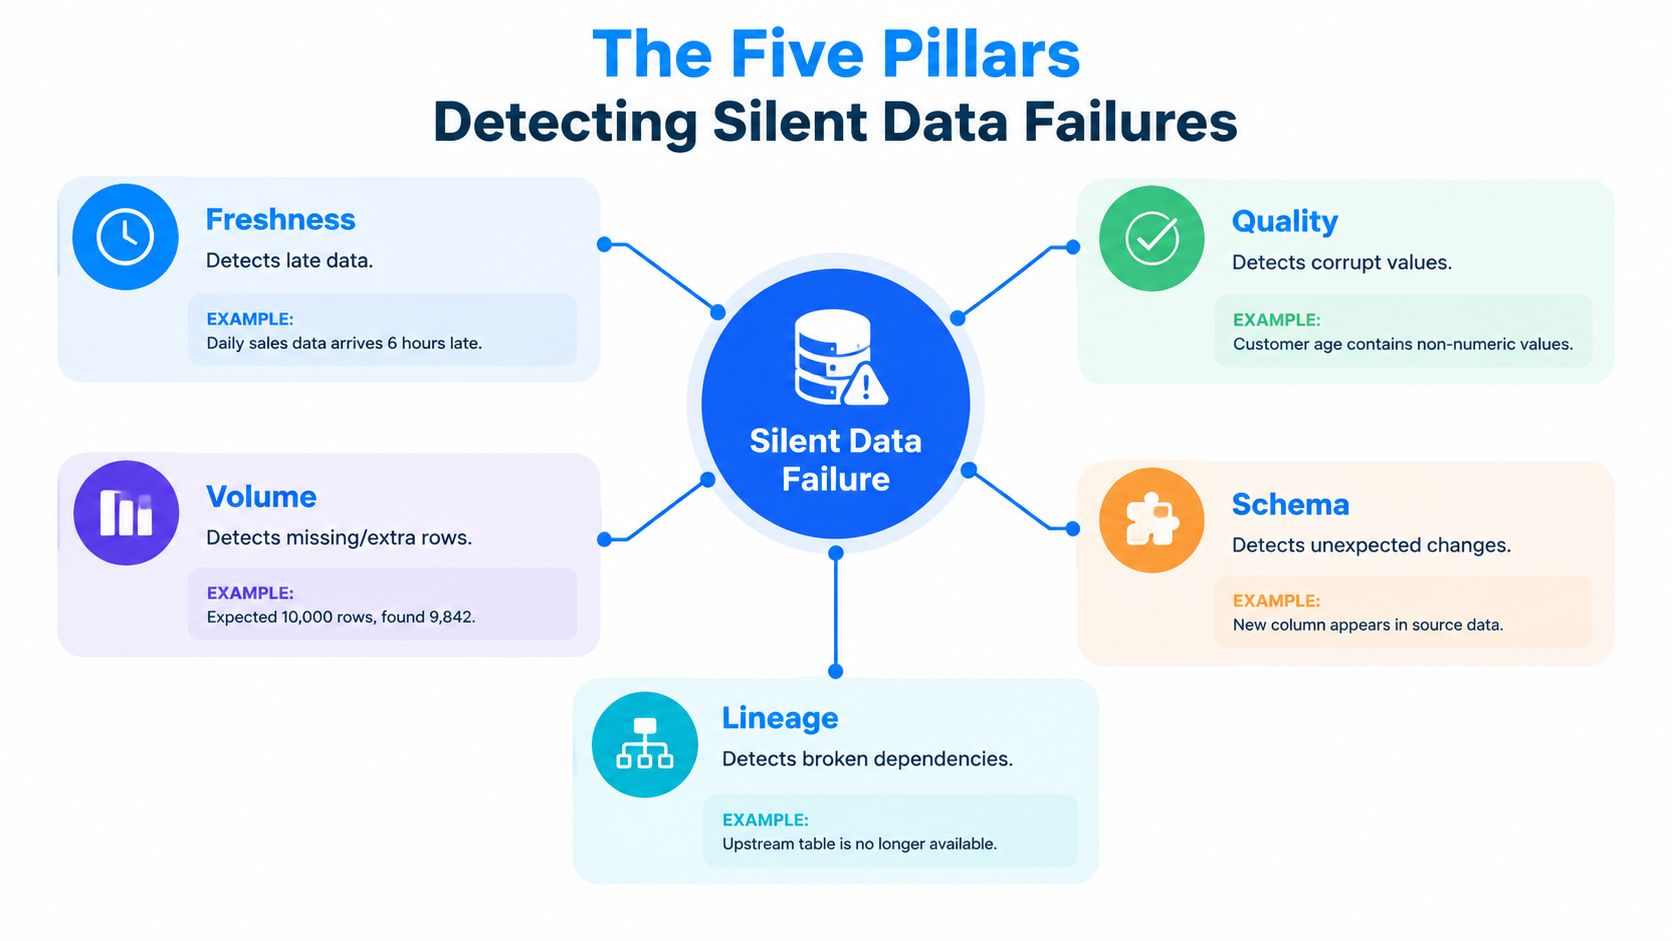
El modelo de cinco pilares ofrece a los equipos un punto de partida práctico: Freshness, Calidad, Volumen, Esquema y Linaje. Cada pilar aborda un modo de falla diferente. Las implementaciones maduras combinan la validación determinista con la detección de anomalías estadísticas porque las reglas explícitas detectan infracciones conocidas, mientras que el análisis de comportamiento puede revelar cambios inesperados.
Freshness
La Freshness pregunta si los datos están lo suficientemente actualizados para el uso previsto. No se limita a verificar si un trabajo se ejecutó. Un trabajo exitoso aún puede entregar datos con retraso, omitir una partición o publicar una extracción incompleta.
Freshness significa Timeliness. Monitoree la llegada y el procesamiento frente al comportamiento histórico o una expectativa de servicio explícita, y luego trate los retrasos como posibles fallas de origen o de ingesta.
Una comprobación útil compara la hora de llegada real con el programa esperado. El sistema también debe distinguir la entrega tardía de la entrega anticipada cuando esa distinción sea importante. Un archivo anticipado puede indicar que un proceso de origen cambió, incluso si los datos parecen disponibles.
Calidad
Las comprobaciones de calidad validan registros y valores frente a expectativas comerciales o técnicas. Los ejemplos incluyen campos obligatorios, rangos válidos, relaciones referenciales, categorías permitidas y coherencia entre conjuntos de datos relacionados. Estas reglas son especialmente importantes para los informes regulados y los flujos de trabajo operativos críticos.
La calidad no es una puntuación única. Los equipos deben definir qué dimensiones importan para cada caso de uso y luego conectar las comprobaciones fallidas con el activo afectado y su propietario. Una regla para una tabla de transacciones financieras puede diferir de una para un conjunto de datos exploratorio. Aparecen más detalles sobre la organización de estas dimensiones en la guía de digna sobre las dimensiones de la calidad de los datos.
Volumen
Las comprobaciones de volumen buscan datos faltantes, duplicados o expandidos inesperadamente. Un cambio en el recuento de filas puede indicar una carga incompleta, una interrupción en el origen, un problema de combinación (join) o un evento comercial legítimo. La comprobación resulta más útil cuando considera patrones históricos y dependencias downstream en lugar de aplicar un único umbral universal.
Esquema
El monitoreo del esquema rastrea cambios estructurales como columnas añadidas o eliminadas, campos renombrados y tipos de datos modificados. A menudo proporciona una advertencia temprana porque los cambios estructurales pueden romper transformaciones, paneles, contratos o funciones de modelos antes de que alguien note un error visible en los informes.
Los equipos deben clasificar los cambios esperados e inesperados. Una migración controlada puede agregar una columna intencionalmente, mientras que una API upstream puede alterar un tipo sin previo aviso. El mismo evento necesita un enrutamiento diferente según la propiedad, el entorno y el uso downstream.
Linaje
El linaje muestra cómo se mueven los datos desde el origen hasta la transformación y el consumo. Convierte una alerta aislada en un mapa de impacto. Si una tabla de origen cambia, el linaje puede revelar qué tablas derivadas, informes, métricas o entradas de IA dependen del campo afectado.
La Observability de extremo a extremo conecta los eventos de origen con el impacto downstream a través de la ingesta, la transformación, el almacenamiento y el consumo (investigación sobre la Observability de pipelines). Sin linaje, los equipos pueden detectar un problema rápidamente, pero aun así pasar demasiado tiempo decidiendo por dónde empezar.
Dónde debe ejecutarse la Observability y cómo implementarla
Un pipeline puede detectar una comprobación de calidad fallida y, aun así, crear problemas de governance, costo o portabilidad. La decisión de arquitectura más trascendental se refiere a dónde deben residir el cómputo, los metadatos y las alertas, más que a qué comprobaciones habilitar. Los diseños en la base de datos calculan comprobaciones compatibles dentro del warehouse o de la plataforma de datos. Los diseños externos extraen datos o métricas a un servicio independiente para su procesamiento.
La ejecución en la base de datos puede ejecutar trabajos dentro de sistemas como Databricks, SAP HANA o Snowflake, manteniendo el procesamiento dentro del warehouse SQL en lugar de extraer los datos para su análisis (guía de Observability pushdown). Este enfoque se asemeja a inspeccionar los productos en la fábrica: los datos permanecen cerca de su origen, mientras que la plataforma absorbe la carga de trabajo. La ejecución externa crea un modelo operativo centralizado, pero puede requerir permisos más amplios, conectores y movimiento de datos. Los equipos que construyen su práctica de ingeniería de plataformas de datos deben tratar esta decisión de ubicación como parte del diseño de la plataforma.
Criterio | Ejecución en la base de datos | Ejecución externa |
|---|---|---|
governance | Las comprobaciones funcionan dentro de los límites y políticas de acceso a datos existentes. | Un servicio independiente puede necesitar permisos para extraer o inspeccionar datos. |
Movimiento de datos | Las métricas y la validación se pueden calcular donde residen los datos. | Los datos o los resultados del perfilado se mueven a una capa de procesamiento externa. |
Control de costos | Utiliza el cómputo del warehouse o de la plataforma, por lo que la governance de la carga de trabajo importa. | Añade costos de infraestructura o servicios independientes, al tiempo que reduce parte del trabajo dentro de la plataforma. |
Portabilidad | Funciona bien cuando los motores compatibles y los patrones SQL son coherentes. | Puede centralizar la lógica a través de sistemas heterogéneos, pero puede crear dependencia del servicio. |
Seguridad | Respalda la localidad de los datos y minimiza la exposición de los registros de producción. | Requiere controles cuidadosos para la extracción, almacenamiento, cifrado y retención. |
Rendimiento | Se beneficia del acceso a datos locales y de la optimización del motor. | Puede introducir sobrecostos de transferencia, programación o serialización. |
Operaciones | Los equipos gestionan el impacto de la carga de trabajo dentro de cada plataforma. | Los equipos gestionan los conectores, la confiabilidad de la extracción y la capacidad externa. |
Hacer coincidir la implementación con el entorno
Las opciones de nube privada, VPC y locales (on-premises) importan cuando la residencia de datos, la red o las reglas de acceso restringen la implementación. Una organización regulada puede instalar el sistema de Observability dentro de su propia cuenta de nube, VPC o centro de datos, manteniendo los datos de producción dentro de un límite aprobado.
La portabilidad merece la misma atención. Los enfoques abiertos e interoperables, incluyendo la adopción de OpenTelemetry, la Observability como código y la consolidación de herramientas, aparecen como prioridades en la cobertura reciente de tendencias de Observability (tendencias de Observability de IBM). Para los equipos de datos, la portabilidad significa retener metadatos, políticas, linaje e historial operativo cuando cambian las plataformas. Exportar únicamente los paneles no preserva ese contexto operativo.
Antes de elegir, haga tres preguntas:
¿Puede la plataforma observar cada entorno crítico sin forzar la reubicación de datos?
¿Quién paga por el cómputo utilizado por el perfilado y la detección de anomalías?
¿Pueden los equipos de governance auditar las comprobaciones, los permisos, los resultados y el modelo de retención?
Una alerta técnicamente precisa es insuficiente si la arquitectura aumenta el riesgo de acceso o genera una factura impredecible. Elija el diseño que equilibre la calidad de la detección con la localidad de los datos, la portabilidad y el control operativo.
De señales técnicas a impacto comercial con ejemplos reales
Una alerta de Freshness se vuelve más útil cuando se conecta a un proceso de negocio. Una alerta de esquema se vuelve urgente cuando identifica un campo utilizado por un informe regulatorio o una función de IA. Una señal de carga de trabajo de la plataforma se vuelve accionable cuando explica qué equipo, patrón de consulta o producto de datos está consumiendo recursos.
Esa conexión proviene de combinar el linaje, los metadatos de uso, la propiedad, las definiciones comerciales y las señales de Observability en un gráfico de dependencia contextual. El gráfico no reemplaza las comprobaciones técnicas. Le da a cada comprobación un lugar en el modelo operativo.

Servicios financieros
Un conjunto de datos de transacciones puede superar una comprobación básica de finalización de pipeline mientras falla en una regla de negocio o llega después de una ventana de informe. La gestión de calidad de datos combina validación, detección de anomalías, seguimiento de la Timeliness y monitoreo de esquemas para identificar el problema. El linaje muestra luego si los registros afectados alimentan cálculos de riesgo, informes regulatorios o conciliaciones downstream.
La prioridad de respuesta debe reflejar ese impacto. Una desviación en una tabla analítica no utilizada no es equivalente a un cambio estructural en un conjunto de datos utilizado por un proceso financiero crítico.
Atención médica
Los equipos de atención médica a menudo necesitan datos clínicos, operativos y regulatorios confiables en sistemas con diferentes patrones de propiedad y entrega. Una extracción tardía puede retrasar una vista operativa, mientras que un tipo de campo modificado puede romper una integración downstream. La Freshness, la validación, el seguimiento de esquemas y el linaje brindan diferentes evidencias para la misma investigación.
La arquitectura debe mantener los datos sensibles dentro de entornos aprobados mientras expone suficientes metadatos para que los equipos autorizados comprendan el estado y la responsabilidad.
Telecomunicaciones y sector público
Una plataforma de telecomunicaciones puede monitorear los datos de los clientes y operativos para detectar comportamientos inusuales de volumen, disponibilidad o distribución. Una organización del sector público puede priorizar la trazabilidad, la coherencia y la evidencia lista para auditorías en procesos de datos de larga duración. En ambos escenarios, la elección de diseño importante es conectar los eventos técnicos con las obligaciones de servicio y los propietarios responsables.
El monitoreo de negocio también puede evaluar KPIs directamente sobre los datos subyacentes. La Observability de plataformas de datos añade una vista relacionada de las cargas de trabajo, el consumo, la disponibilidad y el comportamiento de la plataforma. La Observability forma parte cada vez más de la gestión de costos y de la estrategia de estándares abiertos, no es solo una capa de paneles de control.
Preparación para la IA
Los equipos de IA necesitan más que una tabla limpia al momento del entrenamiento. Necesitan linaje desde los datos de origen a través de transformaciones, funciones, entradas de entrenamiento y resultados del modelo. Si un esquema de origen cambia o un retraso en la Freshness afecta a un pipeline de funciones, el gráfico de dependencia debe revelar qué entradas del modelo pueden estar desactualizadas o ser estructuralmente incompatibles.
La pregunta útil ya no es únicamente: "¿Superó la comprobación?" Es: "¿Qué resultado comercial, proceso operativo o entrada de IA depende de esta señal y quién puede actuar al respecto?"
Su hoja de ruta para implementar la arquitectura de Data Observability
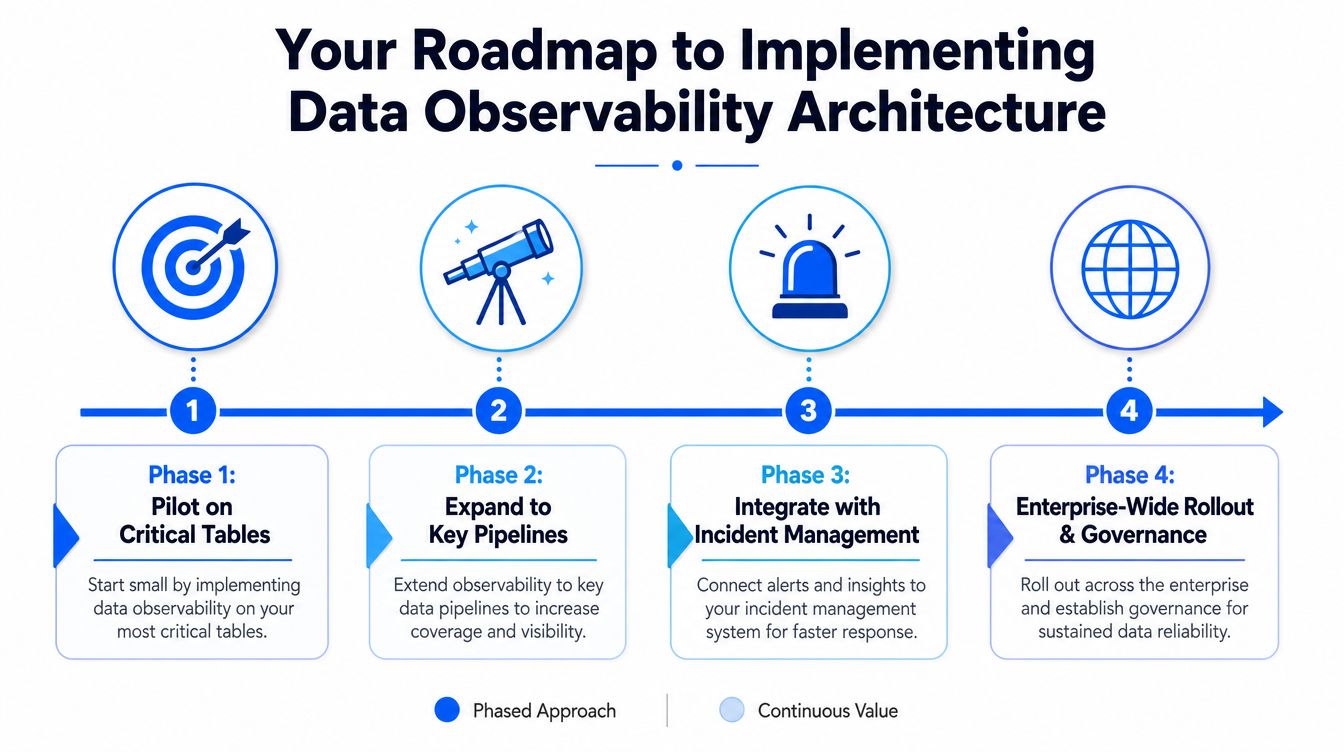
Comience con un alcance estrecho y un propietario claro. Un despliegue amplio sin prioridades produce ruido antes de que el equipo comprenda cómo responder.
Fase uno: Pilotar tablas críticas
Elija conjuntos de datos que respalden informes importantes, operaciones, governance o flujos de trabajo de IA. Establezca el comportamiento de entrega esperado, patrones de volumen básicos, expectativas de esquema y un pequeño conjunto de validaciones comerciales. Asigne un propietario para cada alerta antes de habilitar las notificaciones.
Fase dos: Expandir a pipelines clave
Agregue cobertura upstream y downstream para que el equipo pueda rastrear fallas en lugar de ver síntomas de tablas aisladas. Incluya linaje, uso y metadatos de propiedad, y luego compare la ejecución en la base de datos y la ejecución externa para los entornos dentro del alcance.
Fase tres: Conectar la gestión de incidentes
Dirija las alertas a los equipos responsables de la remediación. Registre los activos afectados, la causa sospechada, el impacto comercial, el estado y la resolución. Revise los incidentes recurrentes para identificar soluciones arquitectónicas en lugar de repetir la recuperación manual.
Fase cuatro: Establecer la governance empresarial
Estandarice las políticas de Freshness, cambios de esquema, validación, acceso, retención y escalación. Expándase a través de warehouses, lakes, pipelines y entornos locales (on-premises) mientras revisa la portabilidad y el consumo de cómputo. Una implementación modular puede comenzar con una sola capacidad y crecer a través de un modelo de tarifa base más un pago por tabla activa por módulo, en lugar de requerir cada caso de uso desde el principio.
Un panel centrado en el usuario debe servir a ingenieros, analistas y partes interesadas de la governance con diferentes vistas del mismo contexto subyacente. Los equipos que buscan orientación práctica pueden usar este marco de implementación de calidad de datos para definir la propiedad, los controles y las prioridades de despliegue.
La arquitectura más sólida trata la calidad de la detección, la governance, la portabilidad y el control de facturación como un único problema de diseño. Comience con un producto de datos crítico, mida qué tan bien el equipo puede detectar y explicar las fallas, y luego expándase solo cuando el modelo operativo esté listo.
digna proporciona una plataforma empresarial de calidad de datos y Observability con ejecución en la base de datos, detección de anomalías, monitoreo de Timeliness, validación, seguimiento de esquemas y monitoreo empresarial y de plataformas. Visite digna para ver cómo una arquitectura que mantiene los datos en su lugar puede respaldar analíticas confiables, governance e IA en todo su entorno de datos.
Preguntas frecuentes
¿Qué es la arquitectura de observabilidad de datos?
La disposición de ejecución, recolección, metadatos, análisis y acción que permite a un equipo entender el estado actual y esperado de los datos a lo largo de todo su ciclo de vida. La analogía útil es el cuadro de mandos de un coche: no más indicadores, sino la disposición que lleva a actuar bien.
¿Por qué no basta la monitorización tradicional?
Porque responde preguntas operativas como si un servidor está disponible, si un trabajo terminó o si un proceso devolvió error. Ninguna explica una tabla que llegó a tiempo, se completó con éxito y aun así lleva valores erróneos, que es justo el fallo que alcanza la decisión.
¿Dónde deben ejecutarse los cálculos de observabilidad?
Esa es la decisión de diseño clave en el plano de datos. Ejecutar las comprobaciones donde ya se originan los datos de negocio mantiene el contexto cerca del fallo, evita movimientos innecesarios y pesa sobre todo donde la privacidad y la carga operativa limitan lo que puede salir del entorno.
¿Quién se beneficia de una buena arquitectura de observabilidad?
Cuatro grupos con necesidades distintas: ingenieros de datos que localizan un fallo sin rastrear herramientas desconectadas, analytics engineers que necesitan confianza en entradas estructuralmente válidas, responsables de gobernanza que necesitan evidencia de controles continuos y equipos de IA que necesitan trazabilidad desde el registro de origen hasta las entradas del modelo.
¿Qué tamaño tiene el mercado de observabilidad de datos?
Una estimación sectorial de 2026 lo valora en 3.510 millones de USD y proyecta 6.030 millones para 2031, con una CAGR del 11,42 % entre 2026 y 2031. El crecimiento refleja que gobernanza, fiabilidad y responsabilidad operativa se solapan cada vez más, no una moda pasajera de herramientas.



