Wie validieren Sie Daten? Ein Leitfaden für moderne Pipelines
|
8
min. Lesezeit

Wahrscheinlich stellen Sie diese Frage, weil bereits etwas kaputtgegangen ist. Eine Zahl im Dashboard ist über Nacht gesprungen, ein Modell liefert seltsame Ergebnisse, oder ein Abgleich ist fehlgeschlagen, und niemand vertraut der Pipeline, bis jemand die Logs durchforstet hat. Das ist der eigentliche Kontext hinter der Frage, wie Sie Daten validieren. Sie ist nicht akademisch. Sie ist operativ.
Gute Validierung bedeutet nicht, ein paar Null-Prüfungen hinzuzufügen und es dabei zu belassen. Es bedeutet zu entscheiden, was auf Datensatzebene zwingend gelten muss, was über die gesamte Pipeline stabil bleiben muss, was gefahrlos abweichen darf und was die Verarbeitung sofort stoppen sollte. In modernen Stacks bedeutet das auch, sich gegen Probleme abzusichern, die einfache Leitfäden ignorieren, insbesondere stillen Schema-Drift und die Kosten einer übermäßigen Durchsetzung von Regeln, die für das Geschäft keine Rolle spielen.
Inhaltsverzeichnis
Warum Datenvalidierung mehr ist als das Abhaken von Kästchen
Ein Umsatz-Dashboard fällt selten aus, weil ein Engineer eine Prüfung vergessen hat. Es fällt aus, weil Teams Validierung als einmaligen Bereinigungsschritt behandeln statt als Teil des Pipeline-Designs. Bis jemand bemerkt, dass die Zahlen falsch sind, haben fehlerhafte Daten bereits Transformationen, Joins, BI-Modelle und nachgelagerte Berichte durchlaufen.
Deshalb gehört Datenvalidierung an mehrere Kontrollpunkte und nicht nur an das Endergebnis. Das stärkste Muster lautet: zuerst vorbeugen. Validierungsregeln sollten Probleme dort abfangen, wo Daten ins System gelangen, und danach erneut nach Transformationsschritten, in denen die Logik neue Fehler einführen kann. Der Überblick von Great Expectations zur Pipeline-Validierung macht diesen Punkt deutlich, indem er die Validierung bei der Aufnahme und nach jeder Transformation sowie eine wiederholbare Dokumentation für die Prüfbarkeit betont.
Vertrauen ist das eigentliche Ergebnis
Unternehmen sagen, sie wollen saubere Daten. Was sie wirklich wollen, sind vertrauenswürdige Entscheidungen. Wenn die Finanzabteilung jeden Bericht hinterfragen muss, wenn Analysten jede Aktualisierung manuell prüfen müssen oder wenn ML-Engineers den Trainingsdaten nicht vertrauen, läuft die Plattform zwar technisch, scheitert aber operativ.
Validierung schützt das Vertrauen auf einige konkrete Arten:
Sie blockiert bekannte fehlerhafte Eingaben: Pflichtfelder, gültige Formate und Geschäftsregeln stoppen offensichtliche Mängel frühzeitig.
Sie grenzt den Umfang von Incidents ein: Wenn Prüfungen an jedem Brennpunkt laufen, wissen Teams, wo das Problem entstanden ist.
Sie macht Fehler handhabbar: Eine fehlgeschlagene Regel ist nützlicher als eine vage Beschwerde wie „Das Dashboard sieht falsch aus“.
Sie unterstützt die Compliance: Wiederholbare Validierung und veröffentlichte Metadaten geben Teams einen prüfbaren Prozess.
Praxisregel: Validieren Sie Daten nicht nur anhand dessen, was Sie bisher gesehen haben. Validieren Sie sie anhand dessen, was laut Fachbereich zwingend gelten muss.
Reaktive Bereinigung kommt zu spät
Viele Teams verlassen sich nach wie vor auf eine nachgelagerte Bereinigung. Das klingt pragmatisch, bis ein fehlerhaftes Feld bereits in Berichte aggregiert oder in kundennahe Systeme übertragen wurde. Nachträgliches Bereinigen ist langsamer, teurer und schwerer zu prüfen.
Ein besseres Betriebsmodell sieht so aus:
Definieren Sie die fachlichen Erwartungen vor dem Code.
Setzen Sie sie bei der Aufnahme durch.
Prüfen Sie sie nach jeder relevanten Transformation erneut.
Protokollieren Sie die Ergebnisse, damit Fehler nachvollziehbar und reproduzierbar sind.
Validierung ist keine Bürokratie. Sie ist die technische Kontrolle, die verhindert, dass fehlerhafte Datensätze, veraltete Daten und defekte Schemas zu Geschäftsentscheidungen werden.
Die zentralen Dimensionen der Datenvalidierung
Eine Pipeline kann jede grundlegende Prüfung bestehen und trotzdem das Vertrauen beschädigen. Der typische Fehler ist kein Nullwert in einem Pflichtfeld. Es sind Daten, die akzeptabel aussehen, den Stack durchlaufen und unbemerkt nicht mehr der geschäftlichen Realität entsprechen, etwa nach einer Änderung in der Quelle, einer verspäteten Ladung oder einem neuen Codepfad weiter vorne in der Kette.
Deshalb braucht Validierung mehr Struktur als ein einfaches Bestanden-oder-nicht-bestanden-Tor. Teams brauchen eine Methode, um zu entscheiden, was durchgesetzt werden muss, was überwacht werden sollte und was kurzzeitig toleriert werden kann, weil die Kosten einer Blockade höher sind als die Kosten einer Überprüfung. Ein guter Ausgangspunkt sind sechs Qualitätsdimensionen. Sie geben Teams ein gemeinsames Vokabular, um zu entscheiden, wo das Risiko liegt und wie streng jede Kontrolle sein sollte.
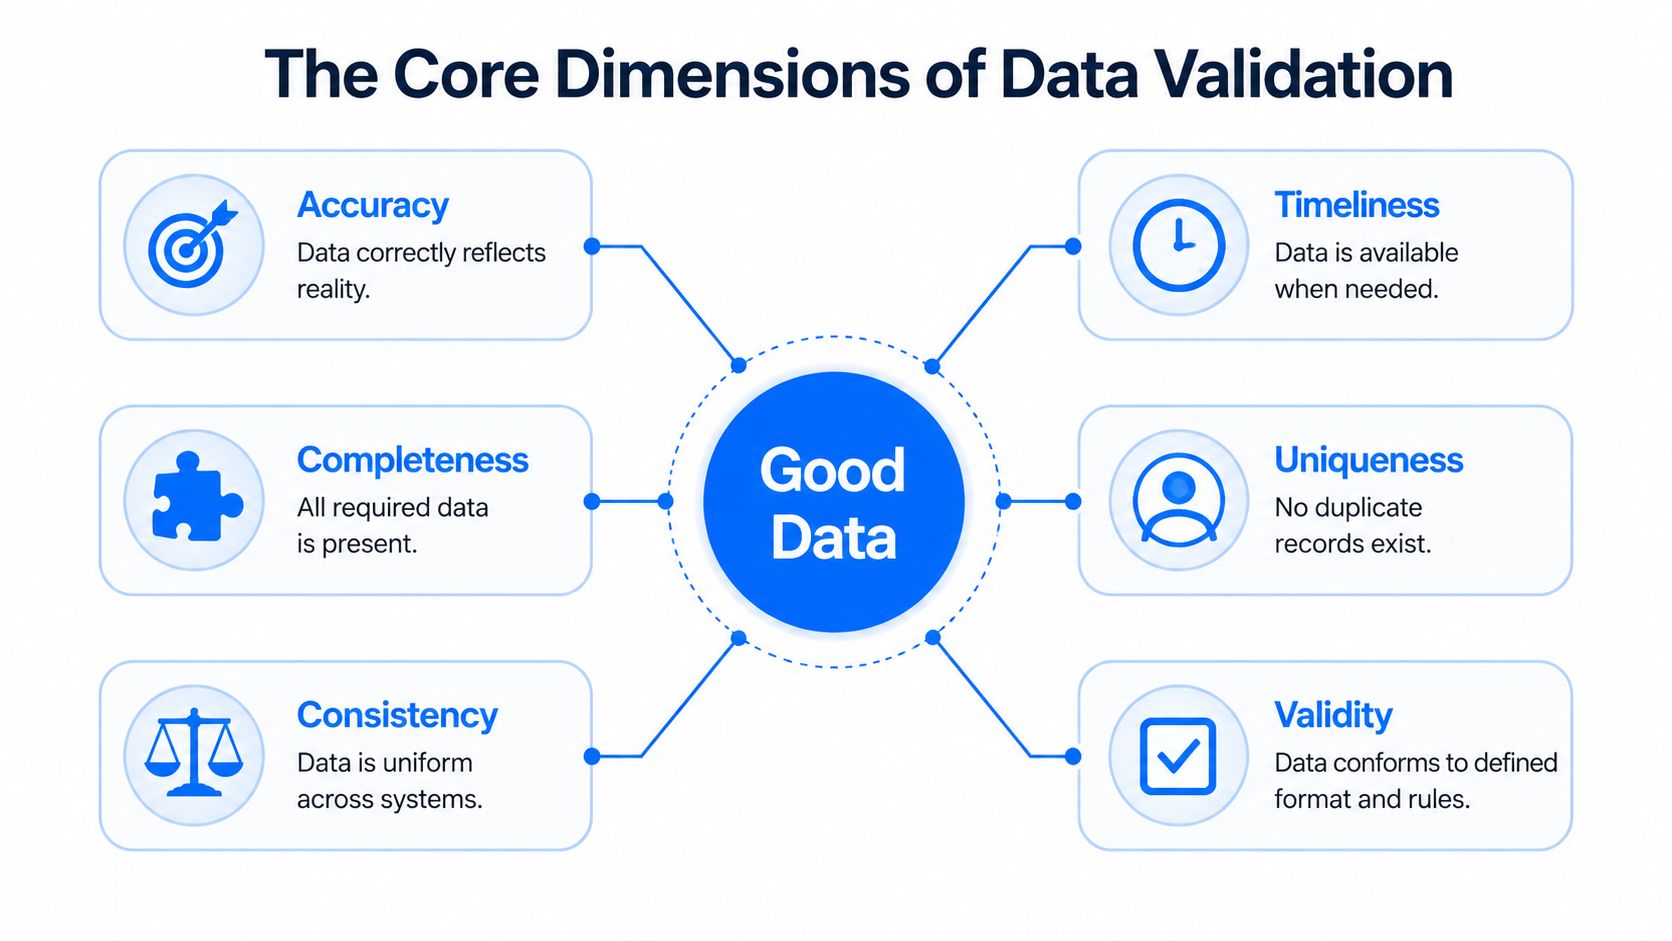
Gute Daten haben sechs Dimensionen
Diese Dimensionen klingen vertraut, weil sie es sind. Der Fehler besteht darin, sie als Checkliste zu behandeln statt als eigenständige Fehlerklassen mit unterschiedlichen geschäftlichen Kosten.
Dimension | Was sie in der Praxis bedeutet | Typische Auswirkung bei einem Fehler |
|---|---|---|
Genauigkeit | Der Wert spiegelt das reale Ereignis oder die reale Entität wider | Falsche Preise, falsche Salden, falscher Kundenstatus |
Vollständigkeit | Benötigte Daten sind dort vorhanden, wo der Prozess auf sie angewiesen ist | Fehlerhafte Joins, unbrauchbare Berichte, fehlende Modell-Features |
Konsistenz | Dasselbe Konzept wird systemübergreifend auf dieselbe Weise dargestellt | Abgleichprobleme, doppelte Logik, Streit über Berichte |
Aktualität | Daten treffen innerhalb des vom Geschäft erwarteten Zeitfensters ein | Veraltete Dashboards, verzögerte Abläufe, verfehlte SLAs |
Eindeutigkeit | Ein Datensatz oder eine Entität erscheint genau einmal, wenn dies erforderlich ist | Doppelte Kunden, doppelte Abbuchungen, überhöhte Zählungen |
Gültigkeit | Werte entsprechen zulässigen Formaten, Wertebereichen und Regeln | Parsing-Fehler, abgewiesene Events, ungültige Transaktionen |
Die Aktualität verdient mehr Aufmerksamkeit, als sie üblicherweise erhält. Ich habe Teams erlebt, die einen Datensatz freigegeben haben, weil jedes Feld die Typ- und Bereichsprüfungen bestanden hatte, während der operative Betrieb mit den Daten von gestern arbeitete. Die Tabelle war gültig. Die Entscheidung war trotzdem falsch.
Dasselbe gilt für Eindeutigkeit und Konsistenz. Eine doppelte Transaktion kann teurer sein als ein fehlendes optionales Feld. Ein Statuscode, der im Quellsystem etwas anderes bedeutet als im Warehouse, kann die Schemavalidierung bestehen und dennoch das Finanzreporting unbrauchbar machen. Validierung funktioniert besser, wenn sich die Schwere nach den geschäftlichen Auswirkungen richtet und nicht nach technischer Ordnung.
Unterschiedliche Validierungsarten erfassen unterschiedliche Risikoklassen
Jede Dimension erfordert eine andere Art von Kontrolle. Wenn Teams nur die Struktur validieren, übersehen sie die Bedeutung. Wenn sie nur Verteilungen beobachten, übersehen sie harte Regelverstöße. Gute Abdeckung entsteht, indem mehrere Prüfungsarten kombiniert und jeder ein Durchsetzungsmodus zugewiesen wird.
Verwenden Sie diese Zuordnung:
Schemavalidierung prüft die Struktur. Vorhandensein von Spalten, Datentyp, Nullbarkeit und Vertragsänderungen.
Syntaktische Validierung prüft das Format. Datumsangaben, Währungscodes, Identifikatoren, Boolesche Werte und standardisierte Textmuster.
Semantische Validierung prüft die fachliche Bedeutung. Enddatum nach Startdatum, Statusübergänge, die dem Workflow entsprechen, Preise, die mit den Produktregeln übereinstimmen.
Relationale Validierung prüft die tabellenübergreifende Integrität. Fremdschlüssel, verwaiste Datensätze und Vollständigkeit von Eltern-Kind-Beziehungen.
Statistische Validierung prüft Verhaltensdrift. Volumenverschiebungen, Änderungen der Nullrate, Änderungen der Kardinalität und Verteilungsanomalien.
Stiller Schema-Drift liegt zwischen diesen Kategorien und verursacht einige der am schwersten zu diagnostizierenden Incidents. Ein Quellteam kann ein Feld verbreitern, ein Enum umfunktionieren, die Zeitzonenbehandlung ändern oder eine neue optionale Spalte senden, die nachgelagerter Code ignoriert. Nichts stürzt ab. Die Zahlen passen einfach nicht mehr zusammen. In solchen Situationen machen sich automatisierte Vertragsprüfungen und profilbasierte Monitore bezahlt. Teams, die kostenlose Tools zur Datenvalidierung für Schemaprüfungen und Drift-Monitoring evaluieren, sollten sowohl auf die Durchsetzung harter Regeln als auch auf trendbasierte Alerts achten, denn das eine ohne das andere hinterlässt blinde Flecken.
Ein Feld kann vom Typ her gültig und dennoch für die Entscheidung, die es unterstützt, ungültig sein.
Genau diese Lücke übersehen einfache Leitfäden häufig.
Ein praxistauglicher Prozess für das Regeldesign beginnt in Klartext. Definieren Sie, was zwingend gelten muss, wer davon abhängt, was bei einem Fehler passiert und ob die Pipeline das Ereignis blockieren, in Quarantäne verschieben, warnen oder zur Überprüfung protokollieren soll. IBMs Überblick über die zentralen Dimensionen der Datenqualität ist hier hilfreich, weil er Qualität als Eignung für den Verwendungszweck versteht, und genau so sollte Validierung in Produktivsystemen priorisiert werden.
Die letzte Designentscheidung ist eine wirtschaftliche. Jede Anomalie zu blockieren klingt diszipliniert, kann aber umsatzrelevante Abläufe stoppen, nachgelagerte Konsumenten verzögern und Teams mit wenig nützlichen Alerts überfluten. Alles durchzulassen ist schlimmer. Starke Validierungsprogramme trennen Fehler mit hohem Risiko von tolerierbaren Schwankungen, setzen Erstere automatisch durch und überwachen Letztere mit klaren Zuständigkeiten. So verbessert Validierung die Zuverlässigkeit, ohne die Pipeline in einen permanenten Incident-Generator zu verwandeln.
Validierung auf Datensatz- und Pipeline-Ebene umsetzen
Validierung funktioniert am besten, wenn Sie sie gleichzeitig auf zwei Ebenen anwenden. Prüfen Sie zunächst jeden Datensatz auf Regelverstöße. Prüfen Sie dann die Pipeline als System auf Verluste, Abweichungen und strukturelle Brüche. Wenn Sie nur eines davon tun, bleiben Lücken offen.
Mit Regeln auf Zeilenebene beginnen
Auf Datensatzebene ist die Grundlage einfach. Bewährte Branchenpraktiken schreiben eine Validierung auf Zeilenebene vor, bei der acht konkrete Regeln, nämlich Pflichtfelder, Typprüfung, Formatvalidierung, Bereichsbeschränkungen, Eindeutigkeit, referenzielle Integrität, Geschäftslogik und feldübergreifende Validierung, auf jeden Datensatz angewendet werden, kombiniert mit einem Audit-Logging, das die Anzahl bestandener und fehlgeschlagener Prüfungen pro Lauf für Compliance und Debugging erfasst, wie in Flatfiles Leitfaden zur Datenvalidierung beschrieben.
Ein praxistaugliches SQL-Muster sieht so aus:
Das ist nicht glamourös, aber wirksam. Es geht darum, jeden Fehler explizit und klassifizierbar zu machen.
In der Regel brauchen Sie eine Kombination von Prüfungen:
Pflichtfelder: Blockieren Sie Nullwerte in Schlüsseln, Datumsfeldern und betriebskritischen Attributen.
Typ- und Formatprüfungen: Erzwingen Sie Datumsangaben als Datumsangaben, Boolesche Werte als Boolesche Werte und Codes gemäß Referenzformaten.
Bereichsbeschränkungen: Fangen Sie unmögliche oder unsichere Werte ab, bevor sie die nachgelagerte Logik verfälschen.
Feldübergreifende Regeln: Validieren Sie Beziehungen wie Start- und Enddatum, Vorzeichen von Soll und Haben oder Kombinationen aus Land und Postleitzahlformat.
Dann die Pipeline als System validieren
Zeilenprüfungen erfassen nicht alles. Eine Pipeline kann die Regeln auf Datensatzebene bestehen und trotzdem defekt sein, wenn die Hälfte der Daten nie angekommen ist, wenn ein Join doppelte Zeilen vervielfacht hat oder wenn sich Quell- und Zielzählungen nicht mehr abgleichen lassen.
Hier kommt es auf Prüfungen auf Pipeline-Ebene an:
Vergleich der Zeilenanzahl: Vergleichen Sie Quell- und Zielzählungen nach Ladevorgängen und Transformationen.
Überwachung von Duplikaten: Prüfen Sie, ob erwartete eindeutige Schlüssel nach Joins oder Unions eindeutig bleiben.
Referenzielle Integrität: Stellen Sie sicher, dass Fremdschlüsselwerte in den referenzierten Tabellen existieren.
Plausibilitätsprüfungen für Aggregate: Vergleichen Sie Summen, Verteilungen und Nullmuster über die Stufen hinweg.
Paritätsprüfungen bei Migrationen: Validieren Sie bei kritischen Feldern während Migrationen jede Zeile, wenn das Geschäft keinen stillen Verlust tolerieren kann.
Die Empfehlungen von digna zur Validierung bei Migrationen sind hier besonders hilfreich. Sie halten fest, dass bei kritischen Feldern während Datenmigrationen eine 100-prozentige Validierung auf Zeilenebene erforderlich ist, um zu bestätigen, dass die Datensatzanzahlen zwischen Quelle und Ziel übereinstimmen, und gleichzeitig zu prüfen, dass keine Duplikate entstanden sind, keine Datensätze unbemerkt verloren gingen und keine unvollständigen Datensätze existieren, während bei großen Datensätzen statistisch signifikante Stichproben mit Anomalieerkennung eingesetzt werden können, wenn eine vollständige manuelle Prüfung nicht praktikabel ist.
Aufwendige Prüfungen im Warehouse belassen
Die Validierung großer Tabellen scheitert oft, weil Teams zu viele Daten aus dem Warehouse ziehen und sie im Anwendungscode prüfen. Das ist langsam, teuer und schwer skalierbar. Verlagern Sie die aufwendige Arbeit wann immer möglich in die Datenbank.
Validierung innerhalb der Datenbank eignet sich besser für:
Eindeutigkeitsprüfungen für zusammengesetzte fachliche Schlüssel
referenzielle Integrität über Datensätze hinweg
Schwellenwert- und Bereichsprüfungen bei großen Tabellen
Profilvergleiche von Nullraten oder Kategorienverteilungen
Wenn Sie einen schlanken Einstieg suchen, bevor Sie Ihr eigenes Framework aufbauen, lohnt es sich, diese kostenlosen Tools zur Datenvalidierung von digna zusammen mit Optionen wie dbt-Tests, Great Expectations und Warehouse-nativen SQL-Prüfungen anzusehen.
Das Warehouse ist bereits darauf optimiert, Daten zu scannen, zu vergleichen, zu aggregieren und zu joinen. Lassen Sie die Validierung dort stattfinden, statt das Problem anderswohin zu exportieren.
Validierung automatisieren und Fehler managen
Manuelle Stichproben sind für das Debugging in Ordnung. Ein Betriebsmodell sind sie nicht. Wenn die Validierung nicht automatisch bei jeder Datenänderung läuft, verlässt sich Ihr Team auf Glück und Neugier.
Prüfungen dort automatisieren, wo sich Daten ändern
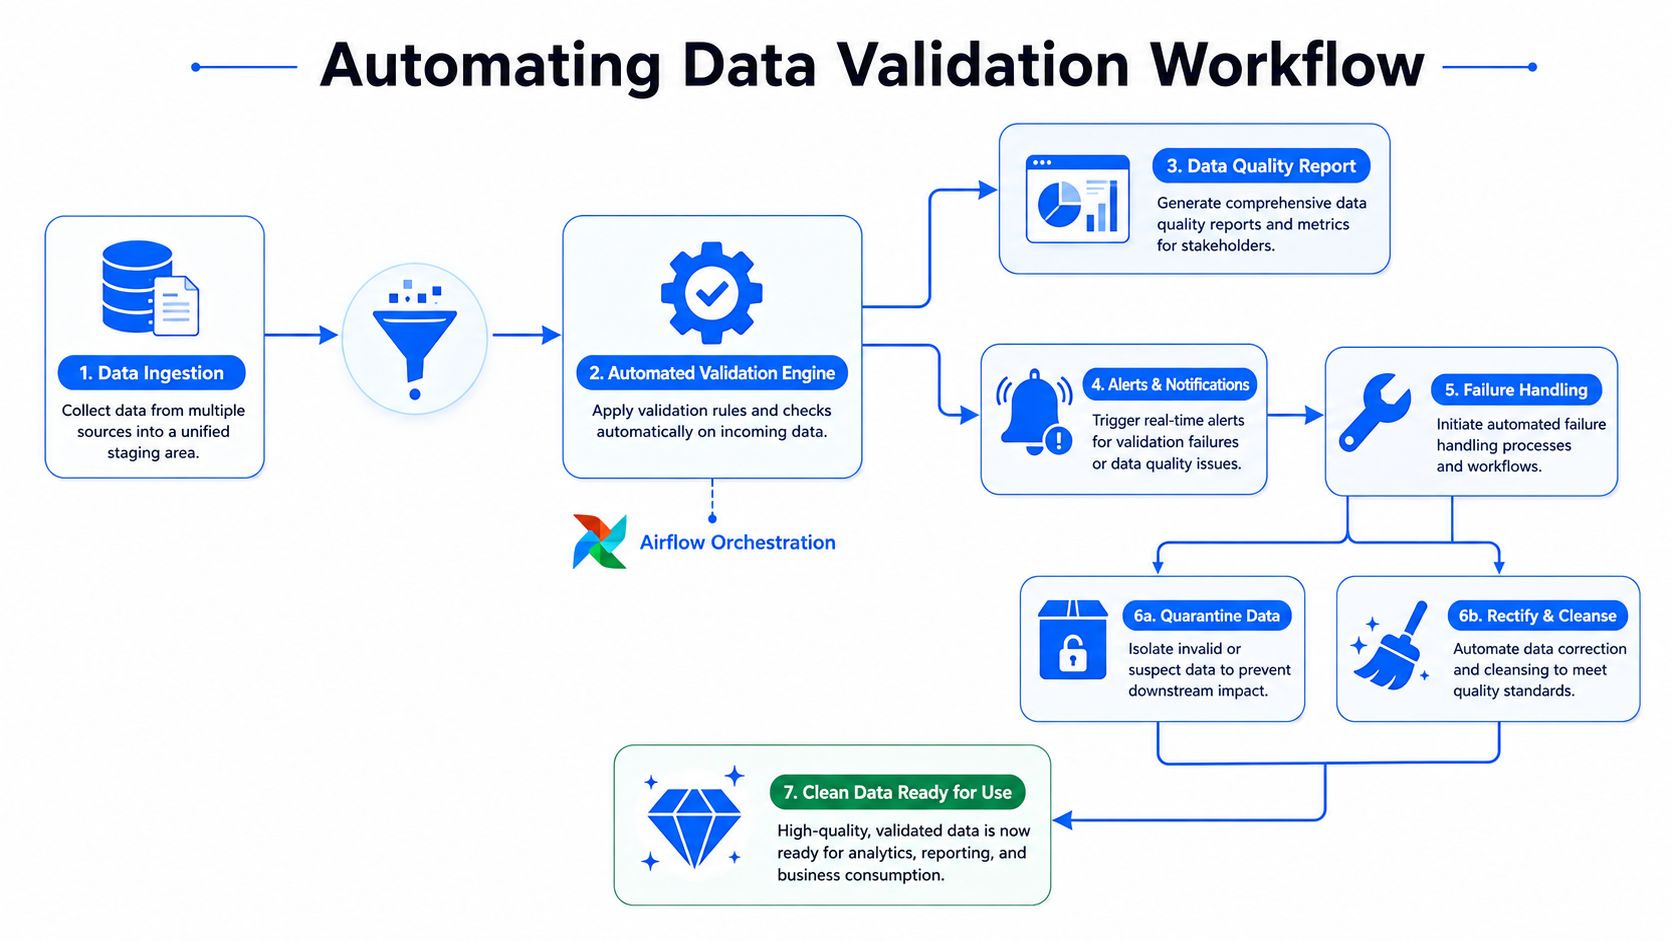
Das sauberste Automatisierungsmuster ist ereignis- oder orchestrierungsgesteuert. Führen Sie Prüfungen nach der Aufnahme, nach wichtigen Transformationen und vor der Veröffentlichung der Daten in Serving-Schichten aus. Airflow, dbt und Warehouse-Tasks unterstützen dieses Muster.
Eine belastbare Abfolge sieht so aus:
Daten aufnehmen und das Schema sofort validieren.
Regeln auf Datensatzebene auf Landing-Tabellen ausführen.
Aggregat- und Paritätsprüfungen nach Transformationen ausführen.
Ergebnisse (bestanden/fehlgeschlagen) in eine Audit-Tabelle schreiben.
Die passende Reaktion auf den Fehler auslösen.
Observability und Validierung beginnen zu verschmelzen. Validierung sagt Ihnen, ob eine Regel bestanden wurde. Observability hilft Ihnen, Trendänderungen, Lücken bei der Aktualität und die Frage zu verstehen, ob derselbe Fehler über mehrere Läufe hinweg wiederkehrt. Eine hilfreiche Einführung ist dieser Überblick über Konzepte der Data Observability und Workflow-Design.
Eine kurze Demo kann helfen, das Orchestrierungsmuster greifbar zu machen:
Reaktionen auf Fehler nach Geschäftsrisiko wählen
Nicht jede fehlgeschlagene Prüfung verdient dieselbe Reaktion. An diesem Punkt reagieren Teams oft entweder über oder unter.
Ein hilfreiches Entscheidungsmodell teilt Fehler in drei Kategorien ein:
Fehlertyp | Beispiel | Beste Reaktion |
|---|---|---|
Harter Stopp | Fehlender Primärschlüssel, ungültige Finanzperiode, referenzieller Bruch in einer kritischen Faktentabelle | Pipeline anhalten |
Quarantäne | Ein Teil der Zeilen verstößt gegen Format oder Geschäftslogik | Fehlerhafte Datensätze zur Überprüfung weiterleiten |
Warnen und fortfahren | Geringfügiger Drift in einem unkritischen beschreibenden Feld | Alarmieren und überwachen |
Der Zielkonflikt ist wirtschaftlicher und nicht nur technischer Natur. Branchendaten zeigen, dass Probleme mit der Datenqualität im Finanz- und Gesundheitswesen 20 bis 30 % der Umsatzverluste verursachen, es jedoch kein Standard-Framework gibt, um den Punkt zu berechnen, an dem der Validierungsaufwand die zusätzliche Risikominderung übersteigt, wie Twilio in seiner Betrachtung von Validierungstechniken und ihren geschäftlichen Auswirkungen darlegt. Diese Lücke ist relevant. Teams müssen entscheiden, wo sich eine strikte Durchsetzung auszahlt und wo sie Reibung erzeugt, ohne das Risiko nennenswert zu senken.
Wenn Ihr Stack auch generative Systeme speist, beginnen sich Datenqualität und Modell-Monitoring zu überschneiden. Bei der Bewertung nachgelagerter Kontrollen hilft es, die richtige Plattform für LLM-Monitoring zu finden, damit Sie sehen, wie Zuverlässigkeit der Eingaben, Prompt-Verhalten und Produktions-Monitoring zusammenpassen.
Alert-Müdigkeit vermeiden
Zu viele Teams überfluten Slack und E-Mail mit wenig nützlichen Alerts, bis niemand sie mehr liest. Gute Automatisierung erzeugt Signale, kein Rauschen.
Einige Gewohnheiten haben sich bewährt:
Nach Schweregrad weiterleiten: Paging sollte selten sein. Die meisten Probleme gehören in Dashboards oder Ticket-Queues.
Zusammenhängende Fehler bündeln: Wenn zehn Tabellen fehlschlagen, weil sich ein vorgelagertes Schema geändert hat, senden Sie einen einzigen Incident.
Kontext mitliefern: Jeder Alert sollte angeben, was fehlgeschlagen ist, wo, wann und was das System als Nächstes getan hat.
Muster regelmäßig überprüfen: Der Leitfaden von Cube zu Best Practices der Validierung beschreibt einen bewährten Rhythmus in Unternehmensumgebungen, bei dem Teams Fehlermuster vierteljährlich überprüfen und Regeln jährlich aktualisieren, statt veraltete Schwellenwerte bestehen zu lassen.
Alerts sollten einem Engineer sagen, was passiert ist und was als Nächstes zu tun ist. Wenn sie nur „Validierung fehlgeschlagen“ melden, ist die Arbeit unvollendet.
Fortgeschrittene Strategien für den Unternehmensmaßstab
Im Unternehmensmaßstab sind statische Regeln weiterhin wichtig, reichen aber nicht mehr aus. Sie brauchen Kontrollen für Änderungen, für die niemand explizit Code geschrieben hat, insbesondere wenn sich BI-Tools, ETL-Services und Quellanwendungen unter Ihnen ständig weiterentwickeln.
Stiller Schema-Drift ist das Unternehmensproblem, das einfache Leitfäden übersehen
Viele Fehler entstehen nicht durch einen Nullwert oder einen Wert außerhalb des zulässigen Bereichs. Sie entstehen durch eine subtile strukturelle Änderung. Eine Spalte wird umbenannt, ein Typ ändert sich von Integer zu String, oder ein vorgelagertes Tool passt ein Schema automatisch so an, dass die Aufnahme weiterläuft, die nachgelagerte Logik aber bricht.
Deshalb sollte das Tracking von Schemas als Validierung behandelt werden und nicht nur als Metadatenpflege. Das Risiko ist größer, als viele Teams annehmen. Aktuelle Branchenberichte aus den Jahren 2025 und 2026 zeigen, dass 65 % der Ausfälle von ML-Pipelines auf unerkannte Schemaänderungen und nicht auf Fehler in den Datenwerten zurückgehen, dennoch umfassen Standard-Validierungsprotokolle selten ein Tracking von Schemaversionen, wie in dieser Diskussion über Schema-Drift und Pipeline-Ausfälle angeführt.
Eine ausgereifte Praxis der Schemavalidierung umfasst:
Versions-Tracking: Erfassen Sie strukturelle Änderungen im Zeitverlauf.
Kompatibilitätsprüfungen: Legen Sie fest, welche Änderungen abwärtskompatibel sind und welche die Veröffentlichung blockieren sollten.
Zuständigkeit: Machen Sie ein Team für die Freigabe von Schemaänderungen verantwortlich.
Prüfung nachgelagerter Auswirkungen: Verknüpfen Sie Alerts zu Schemaänderungen mit den betroffenen Modellen, Dashboards oder APIs.
Anomalieerkennung und Aktualität ergänzen
Fest codierte Regeln erfassen nur das, wonach Sie bereits zu suchen wissen. Unternehmenssysteme brauchen eine weitere Ebene, die unerwartete Änderungen bei Verteilungen, Nullmustern, Kategorienzusammensetzungen und Lieferzeiten erkennt.
Hier hilft Plattformunterstützung. Tools wie dbt-Tests und Great Expectations bewältigen regelbasierte Validierung gut. Für das Monitoring von Anomalien, Aktualität, Regeln auf Datensatzebene und Schemaänderungen direkt in der Datenbank ist digna eine Option: Es führt Analysen innerhalb der Kundenumgebung aus und macht Trends, Verzögerungen und strukturelle Verschiebungen sichtbar, ohne Produktionsdaten zu exportieren.
Die Aktualität verdient dieselbe Beachtung wie inhaltliche Prüfungen. Verspätete Daten können Dashboards entwerten, obwohl jede Zeile die Typ- und Formatregeln besteht. Überwachen Sie die erwarteten Ankunftsfenster und melden Sie verzögerte Ladevorgänge, bevor Stakeholder selbst auf veraltete Berichte stoßen.
Teams, die KI-gestützte Support-Workflows aufbauen, stoßen auf der Anwendungsebene auf ein ähnliches Problem. Daten können strukturell gültig sein und dennoch zu unzuverlässigen Ergebnissen führen, wenn Eingaben und Anweisungen nicht kontrolliert werden. Deshalb sind Empfehlungen zum Prompt-Design für zuverlässige Support-KI parallel zur Datenvalidierung hilfreich. Sie behandeln eine andere Ausprägung derselben Disziplin: akzeptable Eingaben definieren und stille Fehlermodi reduzieren.
Governance verhindert, dass Regeln veralten
Validierungsregeln altern schlecht, wenn niemand für sie verantwortlich ist. Ein Team schreibt sie, ein anderes Team ändert den Quellprozess, und sechs Monate später sind die Prüfungen entweder zu laut oder irrelevant.
Ein nachhaltiges Modell umfasst:
Regeldefinitionen in Klartext: Fachliche Stakeholder sollten sie prüfen können, ohne SQL lesen zu müssen.
Zugewiesene Verantwortliche: Ein Data Owner, ein Data Steward oder ein Governance-Team sollte jede Regel pflegen.
Audit-Logging: Bewahren Sie die Anzahl bestandener und fehlgeschlagener Prüfungen sowie die Metadaten der Läufe auf.
Geplante Überprüfung: Überprüfen Sie Schwellenwerte, Annahmen und Ausnahmen regelmäßig.
Diese Governance-Ebene macht aus einer Sammlung von Skripten ein operatives Kontrollsystem.
Ein pragmatisches Framework für die Datenvalidierung
Ein praxistaugliches Validierungsprogramm beginnt beim Risiko, nicht bei der Abdeckung. Teams geraten in Schwierigkeiten, wenn sie Dutzende Prüfungen für Daten mit geringer Bedeutung schreiben und dann die wenigen Fehlermodi übersehen, die das Umsatzreporting verfälschen, Kunden-Workflows unterbrechen oder fehlerhafte Features in Modelle einspeisen können. Ein besseres Framework stellt zuerst zwei Fragen: Was kann unbemerkt fehlschlagen, und welche geschäftlichen Kosten entstehen, wenn es passiert?

Ein funktionierendes Modell für Teams, die Ergebnisse brauchen
Beginnen Sie mit den Datenbeständen, die das höchste operative oder regulatorische Risiko tragen. In der Praxis umfasst das meist Finanzkennzahlen, Kundenidentifikatoren, Compliance-Felder und Modelleingaben. Definieren Sie für jeden davon einen kleinen Regelsatz und verknüpfen Sie dann jede Regel mit einer Reaktion. Wenn eine Prüfung fehlschlägt, entscheiden Sie, ob die Pipeline anhalten, die betroffenen Daten in Quarantäne verschieben oder mit einem Alert fortfahren soll.
Verwenden Sie ein gemischtes Durchsetzungsmodell, denn nicht jeder Mangel sollte gleich behandelt werden:
Strikte Regeln auf Invarianten anwenden: Primärschlüssel, Pflichtfelder, referenzielle Integrität und feste Formate.
Anomalieerkennung für Änderungen nutzen, die sich schwer im Voraus aufzählen lassen: Verteilungsverschiebungen, Spitzen bei Nullwerten, Volumenänderungen und verspätete Lieferungen.
Schema-Drift explizit nachverfolgen: Stille Spalten- und Typänderungen brechen die nachgelagerte Logik oft, bevor es jemand bemerkt.
Jeder Regel einen Verantwortlichen zuweisen: Jemand muss Rauschen prüfen, Ausnahmen genehmigen und veraltete Prüfungen ausmustern.
Viele einfache Leitfäden greifen in dieser Hinsicht zu kurz. Sie behandeln Validierung als Bestanden-oder-nicht-bestanden-Tor. Produktivsysteme brauchen stattdessen ein risikobasiertes Modell. Ein fehlender Primärschlüssel in einer Finanztabelle rechtfertigt einen harten Stopp. Eine geringfügige Verschiebung bei einem Attribut mit niedriger Priorität erfordert vielleicht nur eine Warnung und ein Ticket. Es geht nicht um maximale Durchsetzung. Es geht um zuverlässige Daten zu Kosten, die das Team dauerhaft tragen kann.
Was Sie diese Woche als Erstes tun sollten
Beginnen Sie mit einer umstrittenen Pipeline. Wählen Sie diejenige, die in Meetings bereits in Frage gestellt wird, denn sie hat schon sichtbare geschäftliche Auswirkungen und eine natürliche Feedbackschleife.
Gehen Sie dann fünf Schritte:
Benennen Sie die fünf fachlichen Bedingungen, die zwingend erfüllt sein müssen.
Ordnen Sie jeder Bedingung eine technische Prüfung auf Datensatz- oder Pipeline-Ebene zu.
Stufen Sie jeden Fehler nach seinen Auswirkungen ein: stoppen, in Quarantäne verschieben, warnen oder nur protokollieren.
Ergänzen Sie eine Laufhistorie, damit das Team wiederholte Fehler und Drift im Zeitverlauf sehen kann.
Überprüfen Sie nach der ersten Woche die Fehlalarme und schärfen Sie die zu lauten Regeln nach.
Diese Abfolge funktioniert, weil sie frühzeitig Abwägungen erzwingt. Teams lernen, welche Kontrollen das Vertrauen schützen und welche nur Alert-Müdigkeit erzeugen. Außerdem legt sie die tatsächlichen Fehlermodi offen, bevor jemand in einen großen Regelkatalog investiert, dessen Pflege teuer wird.
Datenvalidierung funktioniert am besten als Betriebssystem für Zuverlässigkeit. Sie vereint deterministische Regeln, Drift-Erkennung, Schema-Bewusstsein, Zuständigkeiten und Fehlerbehandlung in einem Prozess, der sich ändernde Quellen und wachsende Pipeline-Komplexität übersteht.
Wenn Sie eine praxistaugliche Möglichkeit suchen, Validierung in der Datenbank, Anomalieerkennung, Aktualitäts-Monitoring und Schema-Tracking in einem Workflow zu vereinen, sehen Sie sich digna an. Es wurde für Teams entwickelt, die Datensätze validieren, Drift erkennen und die Zuverlässigkeit ihrer Pipelines überwachen müssen, ohne Produktionsdaten aus der eigenen Umgebung zu bewegen.
Da stiller Schema-Drift an Regeln auf Datensatzebene vorbeigeht, deckt der digna Schema Tracker die Versionsverfolgung als Teil der Validierung ab, indem er hinzugefügte, entfernte und im Typ geänderte Spalten erkennt, bevor die nachgelagerte Logik bricht.
Häufig gestellte Fragen
Wie validieren Sie Daten in einer Pipeline?
Validieren Sie an mehreren Kontrollpunkten statt nur am Ergebnis. Die im Artikel beschriebene Abfolge lautet: Schema bei der Aufnahme validieren, Regeln auf Datensatzebene auf Landing-Tabellen ausführen, Aggregat- und Paritätsprüfungen nach Transformationen ausführen, Ergebnisse in eine Audit-Tabelle schreiben und dann die Reaktion auslösen, die dem Geschäftsrisiko entspricht.
Was sind die sechs Dimensionen der Datenqualität?
Die sechs Dimensionen sind Genauigkeit, Vollständigkeit, Konsistenz, Aktualität, Eindeutigkeit und Gültigkeit. Der Artikel behandelt sie als eigenständige Fehlerklassen mit unterschiedlichen geschäftlichen Kosten: Eine doppelte Transaktion kann mehr kosten als ein fehlendes optionales Feld, und eine Tabelle kann jede Typprüfung bestehen, während der Betrieb noch mit den Daten von gestern arbeitet.
Welche Validierungsregeln auf Zeilenebene sollte jeder Datensatz bestehen?
Der im Artikel zitierte Leitfaden von Flatfile nennt acht: Pflichtfelder, Typprüfung, Formatvalidierung, Bereichsbeschränkungen, Eindeutigkeit, referenzielle Integrität, Geschäftslogik und feldübergreifende Validierung. Kombinieren Sie sie mit einem Audit-Logging der bestandenen und fehlgeschlagenen Prüfungen pro Lauf. Ein einfaches SQL-CASE-Muster kann fehlende Bestell-IDs, negative Beträge oder in der Zukunft liegende Bestelldaten markieren.
Was sollte passieren, wenn eine Prüfung der Datenvalidierung fehlschlägt?
Richten Sie die Reaktion am Geschäftsrisiko aus. Ein harter Stopp hält die Pipeline bei Problemen wie einem fehlenden Primärschlüssel oder einer ungültigen Finanzperiode an. Eine Quarantäne leitet einen Teil der fehlerhaften Zeilen zur Überprüfung weiter. Warnen und fortfahren eignet sich für geringfügigen Drift in einem unkritischen beschreibenden Feld, der einen Alert und Monitoring statt einer Blockade auslöst.
Warum ist Schema-Drift ein Problem der Datenvalidierung?
Strukturelle Änderungen gehen oft an Wertprüfungen vorbei: Eine umbenannte Spalte oder eine Typänderung von Integer zu String kann die Aufnahme weiterlaufen lassen und gleichzeitig die nachgelagerte Logik brechen. Im Artikel zitierte Berichte führen 65 % der Ausfälle von ML-Pipelines auf unerkannte Schemaänderungen zurück, deshalb gehören Versions-Tracking, Kompatibilitätsprüfungen und Zuständigkeiten zur Validierung.


