Was ist eine Parquet-Datei und warum sie moderne Analytics trägt
|
8
min. Lesezeit

Apache Parquet ist ein quelloffenes, spaltenorientiertes Dateiformat für analytische Daten. Sein Aufbau beginnt mit einer 4-Byte-Magic-Number PAR1 und endet mit einem Footer, der Schema, Row-Group-Positionen und Statistiken speichert. Die Daten liegen spaltenweise in Row Groups, Column Chunks und Data Pages, weshalb Query-Engines Spalten ausschließen und irrelevante Row Groups überspringen können, bevor sie große Lesevorgänge starten.
Bei der Frage Was ist eine Parquet-Datei stecken Sie vermutlich in einer von zwei Situationen. Entweder scannen Ihre Warehouse-Abfragen weit mehr Daten als nötig, oder Ihr Data Lake ist zu einem unübersichtlichen Gemisch aus CSV, JSON und halb dokumentierten Exporten geworden, dem niemand ganz traut. In beiden Fällen ist das Dateiformat kein nebensächliches Implementierungsdetail. Es prägt Kosten, Geschwindigkeit und die Frage, wie sicher nachgelagerte Teams darauf aufbauen können.
Denken Sie an einen typischen Analytics-Ablauf. Eine BI-Entwicklerin braucht den Umsatz nach Region und Monat. Der Rohdatensatz enthält Dutzende zusätzlicher Felder, verschachtelte Attribute und historische Partitionen. Liegen diese Daten in zeilenbasierten Textdateien, muss die Engine oft alles durchpflügen, nur um eine eng gefasste Frage zu beantworten. Parquet hat dieses Betriebsmodell verändert, indem es zu einem praktikablen Austauschformat für analytische Systeme wurde, besonders in Data Lakes und modernen Warehouses, weil es auf selektives Lesen statt auf vollständige Dateiscans ausgelegt ist.
Das wirkt über die Performance hinaus. Formatentscheidungen beeinflussen auch die Verlässlichkeit. Wenn Schemaänderungen eintreffen, Partitionsordner von den Erwartungen abweichen oder Statistiken der Engine nicht mehr helfen, veraltete Bereiche zu überspringen, merken Teams das als kaputte Dashboards, teure Jobs und schwer zu debuggende Vorfälle. Deshalb behandeln Datenplattform-Teams Parquet häufig zugleich als Speicherformat und als operativen Standard.
Inhaltsverzeichnis
Wie spaltenorientierte Speicherung funktioniert und warum sie zählt
Encoding, Komprimierung und Metadaten als Performance-Treiber
Verlässliche Parquet-Daten durch Observability und Qualitätsprüfungen
Einführung: Was eine Parquet-Datei wirklich ist
Eine Parquet-Datei ist ein Speicherformat für analytische Arbeit, besonders dann, wenn Teams große Datensätze abfragen, aber jedes Mal nur eine Handvoll Felder benötigen.
Beginnen wir mit einem vertrauten Warehouse-Problem. Eine BI-Entwicklerin öffnet eine Dashboard-Abfrage für Umsatz nach Kanal und Monat. Die Quelldaten enthalten Kampagneneinstellungen, Gerätedetails, Nutzermerkmale, Event-Payloads und etliche Spalten, die für diese Frage niemand braucht. Liegen diese Datensätze in CSV oder JSON, muss die Engine dieses Material meist trotzdem vollständig lesen, weil jede Zeile alle Felder zusammen hält.
Parquet ändert dieses Betriebsmodell. Es speichert Daten spaltenweise, sodass Query-Engines sich auf die Felder konzentrieren können, die eine Abfrage referenziert, statt jedes Attribut durch den Lesepfad zu schleifen. Die Apache-Parquet-Dokumentation beschreibt es als quelloffenes, spaltenorientiertes Format für analytische Daten; die Dateistruktur umfasst die Magic Number PAR1 sowie Footer-Metadaten wie Schemainformationen und Row-Group-Positionen (Dokumentation zum Apache-Parquet-Dateiformat).
Diese Layout-Entscheidung wirkt sich auf mehr als nur die Geschwindigkeit aus.
In einem echten Data Lake zeigen sich Formatentscheidungen in der Monatsrechnung, in der Dashboard-Latenz und in der Störungsbehebung. Ein Format, das selektives Lesen unterstützt, hilft, Scankosten zu senken. Ein Format mit Schema und Metadaten in der Datei gibt Plattformen mehr zum Validieren, Überwachen und Analysieren. Fügt ein Produzent Spalten hinzu, ändert Typen oder schreibt Partitionen uneinheitlich, lassen sich solche Probleme leichter erkennen, wenn das Format stärkere Strukturinformationen trägt als reiner Text.
Aus genau diesem Grund wurde Parquet in Lakes und Warehouses zum Standard. Es gibt Spark, Trino, Hive, Pandas, DuckDB und Cloud-Warehouse-Engines ein gemeinsames Format, das zu analytischen Zugriffsmustern passt. Für Analytics Engineers bedeutet das weniger Kompromisse zwischen Interoperabilität und Performance. Für Datenplattform-Teams heißt es, dass Parquet nicht nur eine Dateiendung ist. Es ist eine operative Entscheidung über Kostenkontrolle, Query-Pruning, Schemastabilität und darüber, wie verlässlich nachgelagerte Teams dem Gelesenen trauen können.
Wie spaltenorientierte Speicherung funktioniert und warum sie zählt
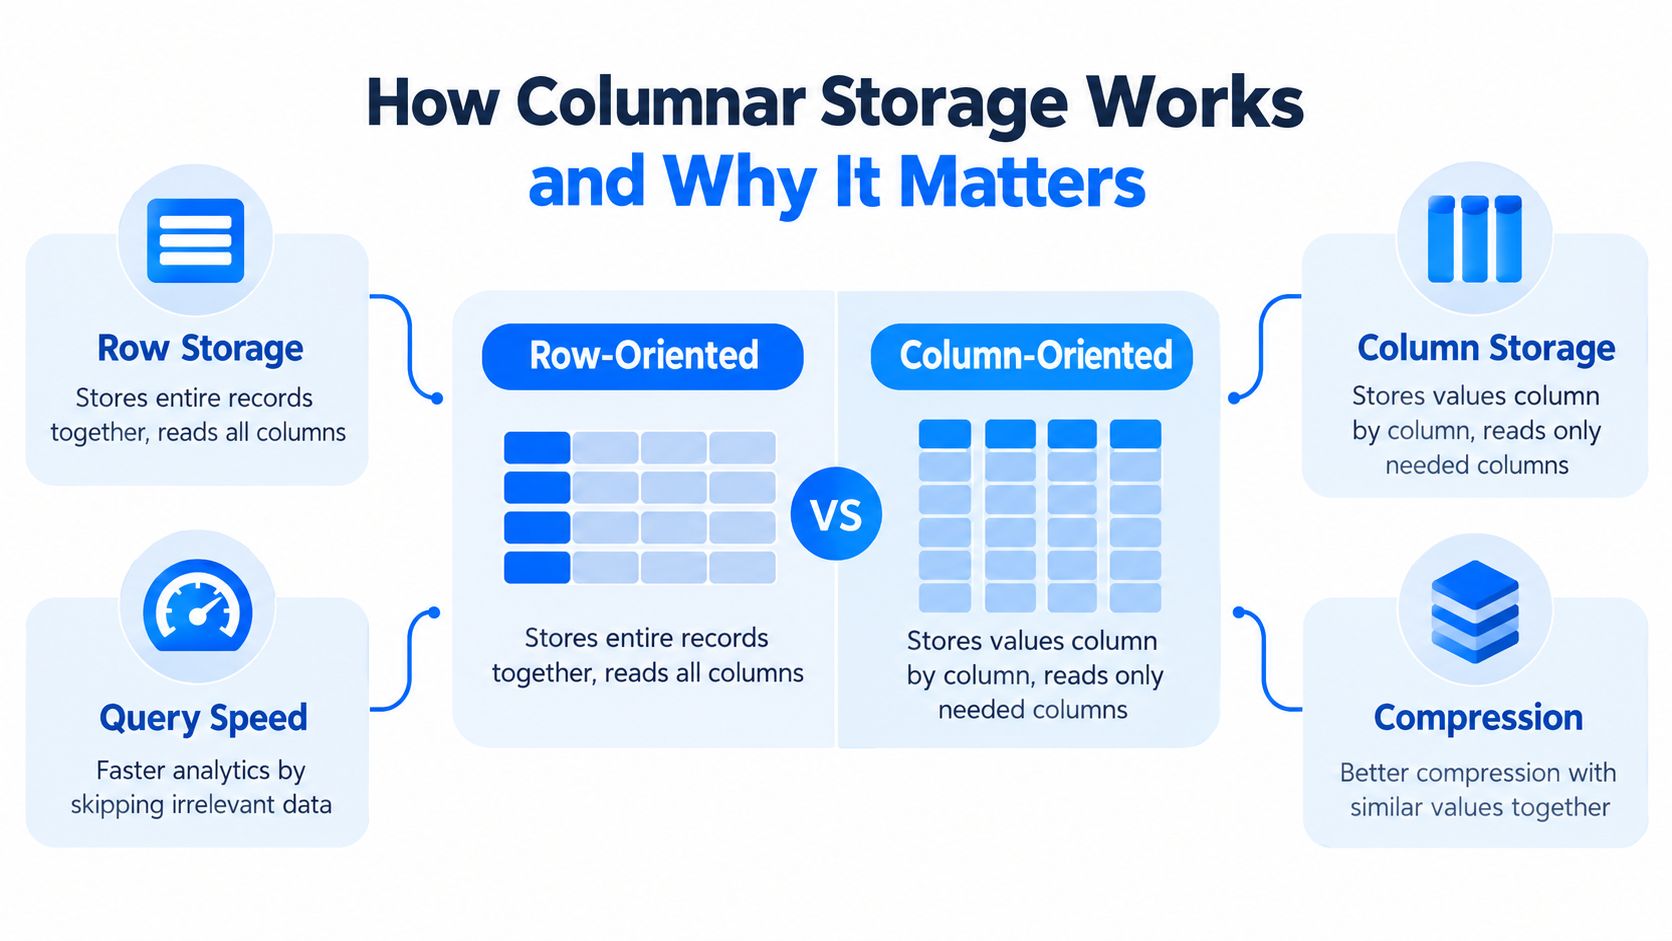
Die meisten Missverständnisse rund um Parquet beginnen hier. Menschen hören spaltenorientiert und nehmen an, das bedeute nur „besser komprimiert“. Komprimierung gehört dazu, doch der größere Gedanke ist die physische Anordnung der Daten.
Zeilen sind für Datensätze, Spalten für Fragen
Stellen Sie sich eine Tabelle mit den Spalten order_id, country, order_date und amount vor.
In einem zeilenorientierten Format sieht die Speicherung wie gepackte Datensätze aus:
Bestellung 1: alle Felder zusammen
Bestellung 2: alle Felder zusammen
Bestellung 3: alle Felder zusammen
In einem spaltenorientierten Format gruppiert die Speicherung Werte nach Feld:
alle
order_id-Werte zusammenalle
country-Werte zusammenalle
order_date-Werte zusammenalle
amount-Werte zusammen
Das klingt abstrakt, bis Sie eine Abfrage anwenden. Fragt Ihr BI-Werkzeug nach dem Gesamtbetrag je Land, braucht es nicht jedes Feld jedes Datensatzes. Bei spaltenorientierter Speicherung kann sich die Engine auf die relevanten Spalten beschränken.
Warum Analytics-Engines profitieren
Analytische Abfragen scannen oft viele Zeilen, referenzieren aber vergleichsweise wenige Spalten. Genau dieses Zugriffsmuster begünstigt Parquet.
Ein praktisches Denkmodell:
Der Query-Planner prüft die angeforderten Spalten.
Die Engine liest nur diese Spaltensegmente.
Irrelevante Felder bleiben auf Disk oder im Object Storage.
Dieses selektive Lesen ist ein Grund, warum Teams früh Zeit in Entscheidungen zur Datensystemarchitektur investieren. Speicherlayout und Query-Engine müssen zusammenspielen, sonst zahlen Sie für Scans, die Sie nie ausführen wollten.
Wenn Menschen sagen, Parquet sei schnell, meinen sie meist, dass die Engine Arbeit vermeidet, bevor sie den Großteil der Datei liest.
Warum ähnliche Werte auch der Komprimierung helfen
Spaltenorientierte Speicherung gruppiert außerdem ähnliche Datentypen und wiederholte Werte. Eine country-Spalte mit vielen wiederkehrenden Codes komprimiert sich anders als eine gemischte Zeile, in der Zeitstempel, Dezimalzahlen, Boolesche Werte und Zeichenketten ineinander verschachtelt liegen.
Das zählt, weil analytische Systeme sich nicht nur für die Größe auf der Platte interessieren. Kleinere, einheitlichere Spaltensegmente können die I/O senken und Scans für Engines leichter verarbeitbar machen. Der Vorteil ist also nicht eine einzelne Sache. Er entsteht aus der Kombination von selektivem Lesen und Daten, die von Natur aus freundlicher zur Speicheroptimierung sind.
Nutzen Sie diese Faustregel:
Wählen Sie zeilenorientierte Formate, wenn Sie häufig ganze Datensätze lesen oder schreiben müssen.
Wählen Sie spaltenorientierte Formate, wenn Sie wenige Felder über viele Datensätze hinweg aggregieren, filtern und scannen.
Deshalb taucht Parquet so häufig in Data Marts, kuratierten Lake-Schichten und warehouse-nahen Pipelines auf.
In einer Parquet-Datei: von Row Groups bis Pages
Viele wissen, dass Parquet spaltenorientiert ist, können sich den Dateiinhalt aber nicht vorstellen. Genau dort wird Performance-Tuning unscharf. Ohne Verständnis der Hierarchie lässt sich schwer erklären, warum ein Datensatz gut pruned und ein anderer zu viel scannt.
Auf Dateiebene beginnen
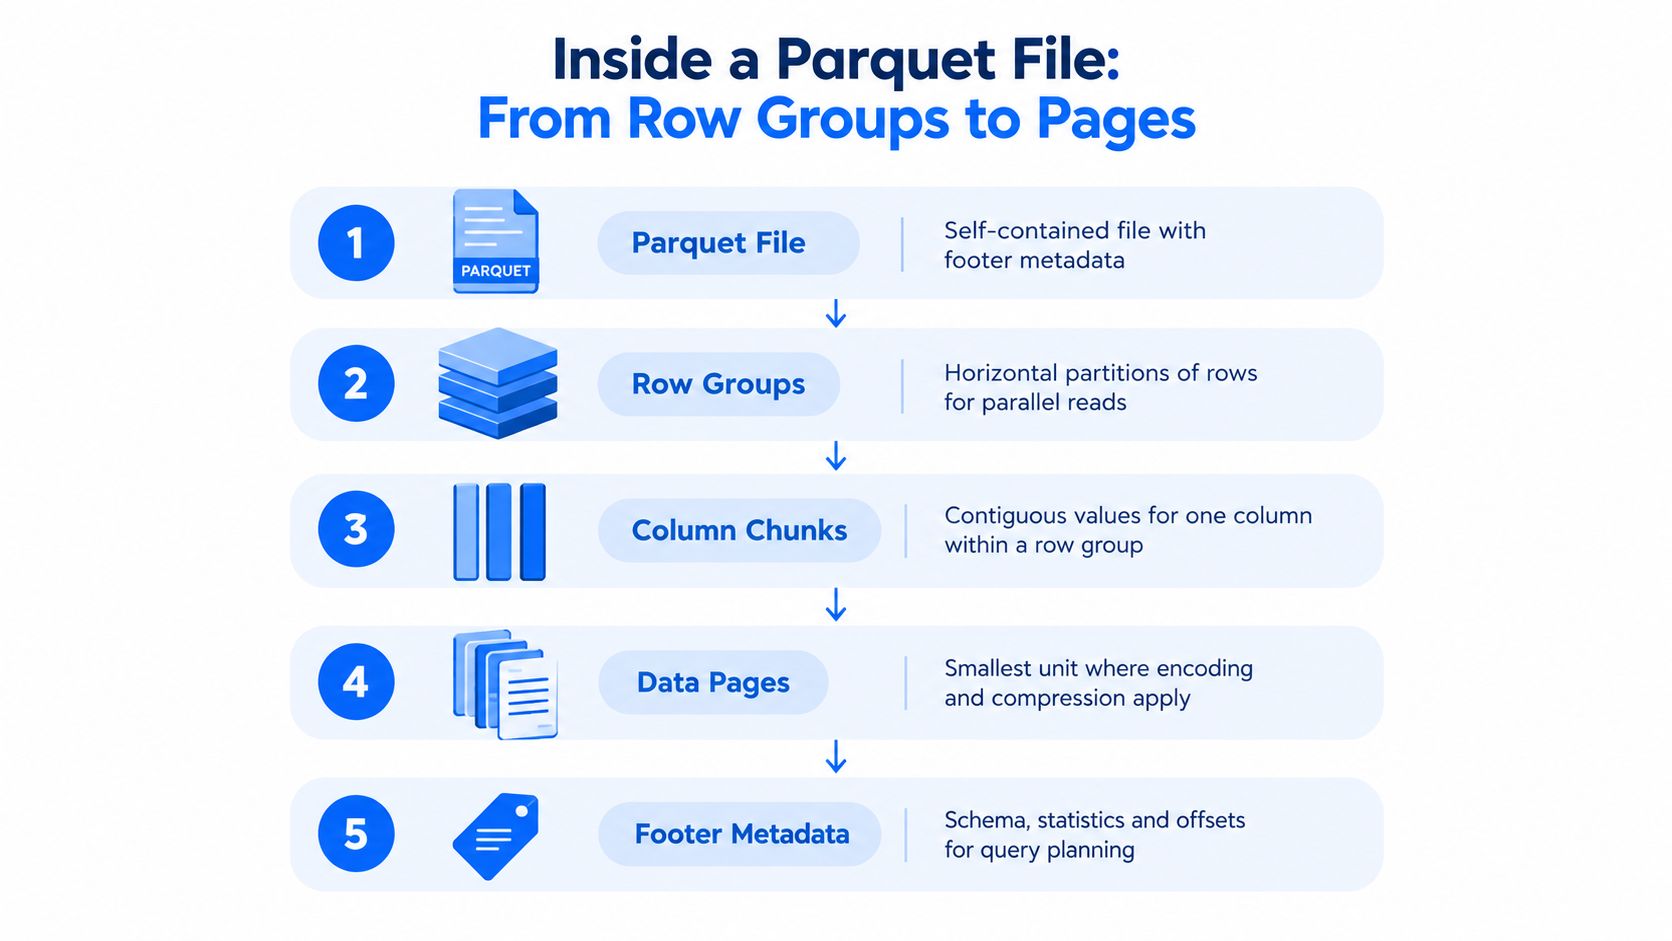
Eine Parquet-Datei ist in sich geschlossen. Das Apache-Projekt weist darauf hin, dass das Format offen ist und dass Dateiformat-Spezifikation und Thrift-Definition zusammen gelesen werden sollten, um die Struktur zu verstehen (Apache-Parquet-Dokumentation).
Auf hoher Ebene enthält die Datei:
Datenabschnitte, die die tatsächlichen Spaltenwerte halten
Einen Footer, der beschreibt, was enthalten ist
Offsets und Metadaten, die Lesern helfen, die richtigen Teile schnell zu finden
Dieser Footer ist die Schaltzentrale. Er nennt der Engine das Schema, den Ort der Row Groups und die für die Leseplanung verfügbaren Statistiken.
Die interne Hierarchie
Parquets Struktur ist auf sehr bestimmte Weise geschichtet:
Row Groups
Das sind horizontale Zeilenpartitionen innerhalb der Datei. Eine Row Group enthält denselben Zeilenbereich über alle Spalten hinweg.Column Chunks
Innerhalb jeder Row Group erhält jede Spalte ihren eigenen zusammenhängenden Datenblock.Data Pages
Innerhalb jedes Column Chunk liegen die Werte in kleineren Einheiten namens Pages.
In metadatenlastigen Lake-Umgebungen hängt diese Hierarchie eng mit dem Metadatenmanagement zusammen. Je klarer Teams Schemata, Partitionen und Dateistruktur nachhalten, desto einfacher lassen sich Scanverhalten und schemabedingte Brüche diagnostizieren.
Warum Row Groups operativ zählen
Row Groups sind mehr als ein Speicherdetail. Sie beeinflussen, wie viele Daten eine Query-Engine überspringen kann und wie sich Arbeit parallelisieren lässt.
Angenommen, eine Abfrage filtert auf einen engen Datumsbereich. Zeigen die Row-Group-Statistiken, dass bestimmte Gruppen nur ältere Daten enthalten, kann die Engine diese Gruppen überspringen, statt sie zu scannen. Das ist der praktische Wert eingebetteter Metadaten: Sie verkürzen Lesevorgänge, bevor die Dekodierung beginnt.
Ein gesunder Parquet-Datensatz ist nicht nur gültig. Er ist so organisiert, dass Engines schnell „Nein“ zu unnötigen Lesevorgängen sagen können.
Was der Footer der Engine mitteilt
Der Footer speichert Metadaten wie:
Schemainformationen
Row-Group-Positionen
Statistiken einschließlich Min/Max und Null-Anzahl
Diese Statistiken sind operativ wichtig, weil sie Engines erlauben, irrelevante Daten vor dem Scannen auszuschließen. Das ist einer der Gründe, warum Parquet zum De-facto-Austauschformat für Analytics wurde, wie in der zuvor verlinkten Dokumentation zum Apache-Parquet-Dateiformat beschrieben.
Wenn Sie sich je gefragt haben, warum sich eine Tabelle in Trino oder Spark „flott“ anfühlt und eine andere nicht, liegt die Antwort oft hier verborgen. Beide Dateien mögen Parquet sein, doch internes Layout, Row-Group-Grenzen und Metadatenqualität können zu sehr unterschiedlichem Laufzeitverhalten führen.
Encoding, Komprimierung und Metadaten als Performance-Treiber
Eine Parquet-Datei spart aus drei verschiedenen Gründen Geld und beschleunigt Abfragen. Die Datei speichert Werte effizient durch Encoding, verkleinert die codierten Bytes durch Komprimierung und gibt Query-Engines Metadaten an die Hand, mit denen sie irrelevante Daten von vornherein nicht lesen müssen.
Encoding kommt zuerst
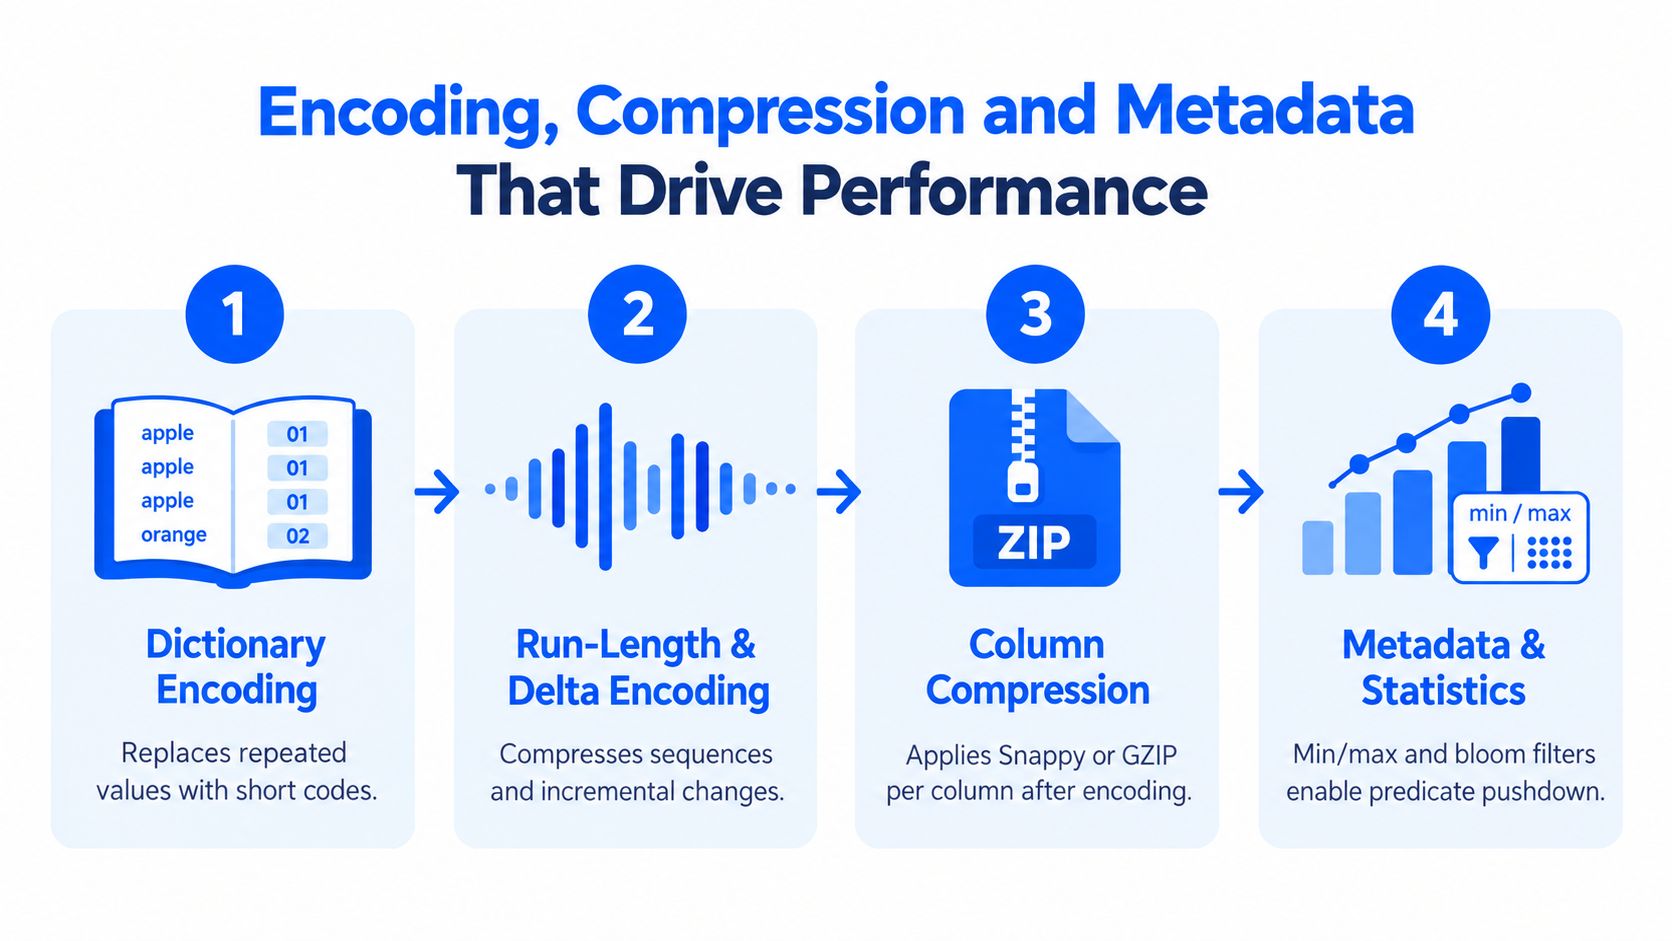
Encoding verändert die Darstellung von Werten, bevor irgendein Komprimierungs-Codec läuft. Die Parquet-Formatdokumentation führt Encodings wie Dictionary, Run-Length und Delta als Teil des Dateidesigns auf (Parquet-Encoding-Spezifikation).
Einfach gelesen heißt das:
Dictionary-Encoding speichert wiederholte Werte als kurze Referenzen, statt den vollen Wert jedes Mal zu wiederholen.
Run-Length-Encoding speichert lange Folgen desselben Werts kompakt.
Delta-Encoding speichert Änderungen zwischen benachbarten Werten, was bei allmählich steigenden oder fallenden Reihen gut funktioniert.
Eine BI-Entwicklerin spürt diesen Unterschied, ohne die Bytes direkt zu sehen. Eine Länderspalte mit vielen Wiederholungen oder eine Zeitstempelspalte mit vorhersehbaren Schritten liefert Parquet Muster, die es weit effizienter speichern kann als Rohtext.
Komprimierung verkleinert die codierten Bytes
Sind die Werte codiert, kann Parquet die Daten jeder Spalte separat komprimieren. Das zählt, weil eine einzelne Spalte meist einen Datentyp und ein Muster enthält. Eine Statusspalte verhält sich anders als eine Preisspalte, und Parquet lässt jede zu ihren eigenen Bedingungen komprimieren.
Deshalb ist „Parquet ist komprimiert“ nur ein Teil der Geschichte. Komprimierung senkt Speicher- und Netzwerk-I/O, doch oft erzeugt erst das Encoding jene Wiederholungen, die die Komprimierung ausnutzen kann. In Cloud-Datenplattformen bedeutet das geringere Speicherkosten und weniger übertragene Bytes beim Scannen.
Metadaten treiben die größten Performance-Entscheidungen
Bei den Metadaten wird Parquet vom Speicherformat zur operativen Entscheidung.
Filtert eine Analystin auf order_date >= '2026-01-01', kann die Engine große Teile der Datei überspringen, bevor sie einen einzigen Wert dekodiert. Möglich wird das, weil Parquet Statistiken und Strukturdetails speichert, mit denen die Engine Row Groups und Pages ausschließen kann, die den Filter nicht erfüllen können. Weniger Lesen bedeutet schnellere Dashboards, geringere Abfragekosten und vorhersehbarere Performance bei geteilten Workloads.
Dieselben Metadaten wirken auch auf die Verlässlichkeit. Driften Schemadetails, fehlen Statistiken oder passen Partitionswerte nicht zum Dateiinhalt, verlieren Teams Geschwindigkeit und Vertrauen zugleich. Query-Pruning wird schwächer. Fehlersuche wird langsamer. Datenverträge lassen sich schwerer durchsetzen.
Deshalb gehört Metadatenarbeit in Gespräche über Datenqualität und nicht nur über Speicherung. Teams, die in Metadatenpraktiken zur Verbesserung von Datenqualität und Effizienz investieren, erhalten meist zwei Vorteile zugleich: besseres Scanverhalten und frühere Erkennung von Schema- oder Partitionsproblemen.
In Unternehmens-Lakes liegen gut geschriebene Parquet-Dateien nicht einfach günstig im Object Storage. Sie helfen Engines, Arbeit zu sparen, helfen Teams, Drift zu erkennen, und helfen Plattformverantwortlichen, Performance und Verlässlichkeit über die Zeit stabil zu halten.
Parquet gegenüber CSV, JSON und ORC: Abwägungen erklärt
Parquet ist beliebt, aber nicht die Antwort auf jede Speicherfrage. Teams entscheiden besser, wenn sie Formate nach Workload vergleichen, statt anzunehmen, ein Format müsse überall gewinnen.
Mit der einfachen Unterscheidung beginnen
CSV und JSON sind an Ingestion-Grenzen oft einfacher. Sie sind lesbar, portabel und nahezu allen vertraut. Diese Bequemlichkeit kann jedoch teuer werden, wenn dieselben Dateien wiederholte analytische Abfragen tragen.
Parquet ist stärker, wenn Leser selektiven Zugriff, typisiertes Schema und effiziente Scans brauchen. ORC ist ebenfalls spaltenorientiert und kommt in warehouse-lastigen Umgebungen häufig ins Spiel. Die praktische Wahl hängt von Ihren Werkzeugen, Ihren Schreibmustern und davon ab, wer die Daten direkt einsehen muss.
Zwischen zeilen- und spaltenorientierten Formaten wählen
Format | Am besten für | Speichereffizienz | Abfragemuster |
|---|---|---|---|
CSV | Einfache Exporte, manuelle Sichtprüfung, leichtgewichtiger Austausch | Geringer bei analytischen Workloads | Lesevorgänge betreffen meist den vollständigen Zeileninhalt |
JSON | Flexibler halbstrukturierter Austausch und API-Payloads | Für Analytics oft geringer, weil sich die Struktur in der Datei wiederholt | Gut für den Anwendungsaustausch, weniger effizient bei wiederholten analytischen Scans |
Parquet | Analytische Datensätze, kuratierte Lake-Schichten, BI-freundliche Speicherung | Hoch für analytische Daten, weil Spalten getrennt gespeichert und einzeln optimiert werden | Am besten, wenn Abfragen eine Teilmenge von Spalten über viele Zeilen lesen |
ORC | Spaltenorientierte Analytics in Ökosystemen, die bereits darauf standardisiert sind | Hoch bei analytischen Workloads | Gute Passung für analytische Lesevorgänge, besonders wo ORC-Unterstützung bereits etabliert ist |
Wie Sie in der Praxis entscheiden
Nutzen Sie Parquet, wenn diese Bedingungen zutreffen:
Ihre Abfragen sind selektiv: Analystinnen und Analysten fragen wiederholt wenige Spalten über große Zeiträume ab.
Sie brauchen stärkeres Schemaverhalten: Typisierte Speicherung hilft, wenn nachgelagerte Modelle und Dashboards auf konsistente Felder angewiesen sind.
Speicherkosten zählen: Kleinere analytische Footprints können den Scan-Overhead senken.
Bleiben Sie bei CSV oder JSON, wenn diese Bedingungen überwiegen:
Menschen müssen Dateien direkt einsehen: Für den schnellen Blick gewinnt Text weiterhin.
Vorgelagerte Systeme liefern zuerst Rohdatensätze: Landing Zones bleiben vor der Kuratierung oft zeilenorientiert.
Einfaches Schreiben zählt mehr als Leseoptimierung: Manche Pipelines wollen am Rand das denkbar einfachste Exportformat.
ORC kommt ins Spiel, wenn Ihr Stack ohnehin in diese Richtung tendiert. Begünstigen Ihre Engines, Governance-Standards oder Plattformkonventionen ORC, kann es die bessere organisatorische Wahl sein. Der Punkt ist nicht, dass Parquet alles schlägt. Es ist, dass Parquet oft gewinnt, wenn Analytics-Teams auf wiederholte Lesevorgänge, vorhersehbare Schemabehandlung und breite Ökosystem-Kompatibilität optimieren.
Parquet in Spark, Presto, Pandas und partitionierten Lakes
Ein Format wird nützlich, wenn es zu den Werkzeugen passt, die Menschen bereits nutzen. Parquet tut das. Das Apache-Parquet-Ökosystem und die Library of Congress beschreiben es als breit unterstützt über viele Programmiersprachen und Analysewerkzeuge hinweg; das Projekt pflegt eine formale Versionshistorie im parquet-format-Repository (Apache-parquet-format-Repository).
Wie das in echten Pipelines aussieht
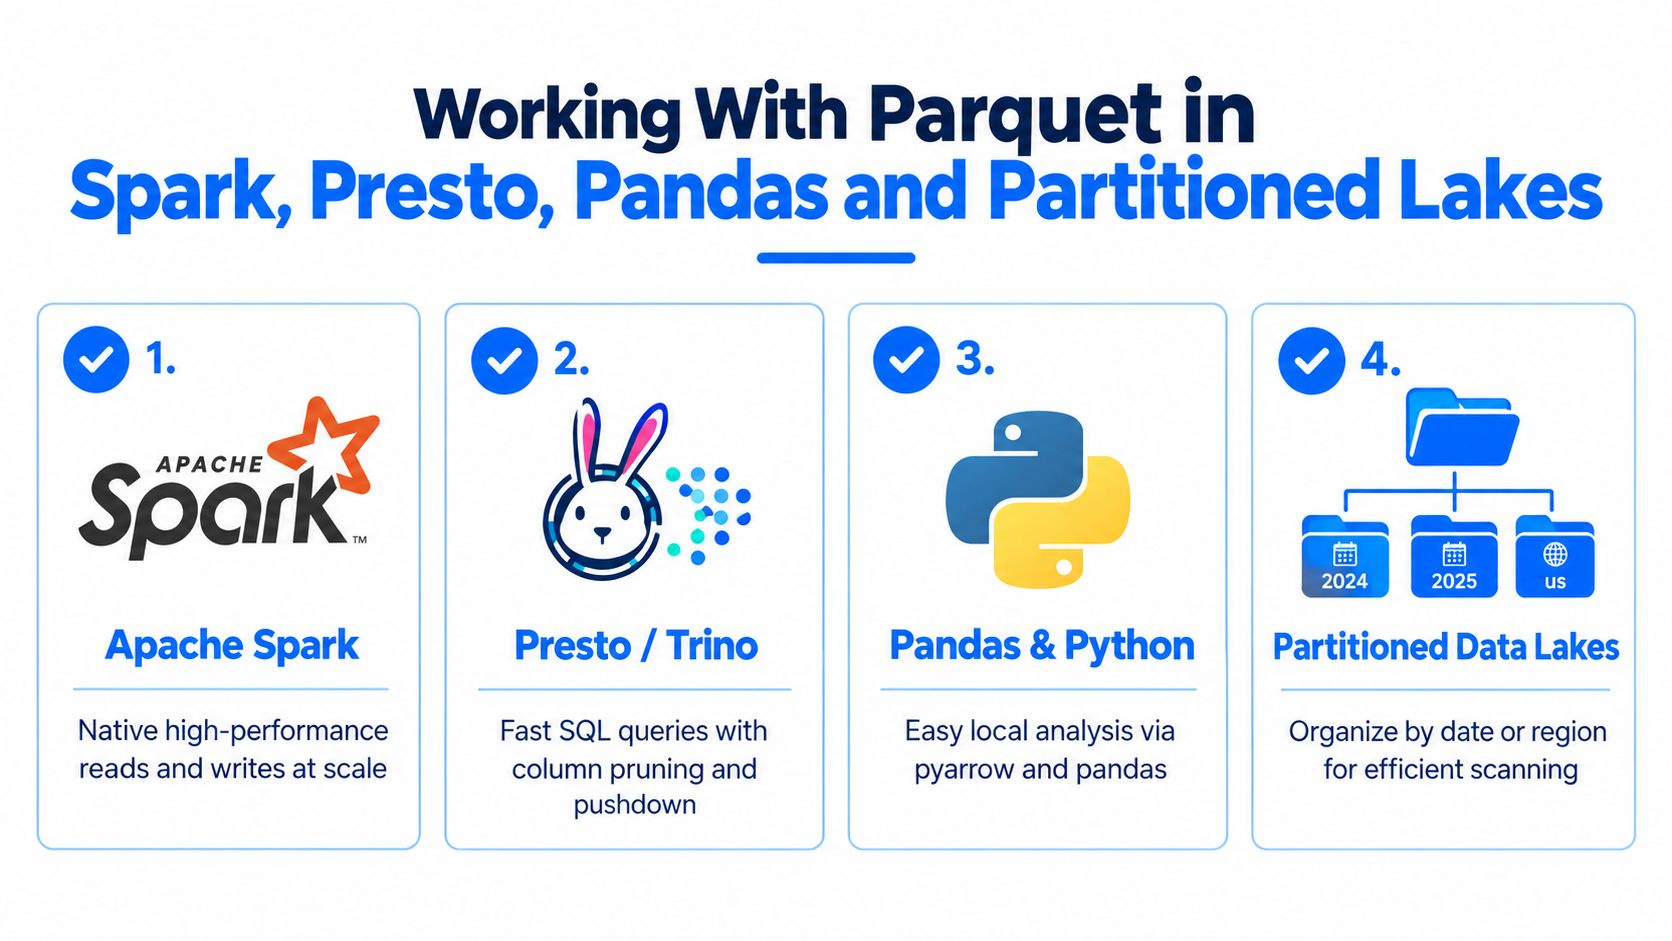
In Spark passt Parquet natürlich zu großen verteilten Lese- und Schreibvorgängen. In Presto oder Trino stehen Column Pruning und Predicate Pushdown im Zentrum schneller SQL-Abfragen über Lake-Daten. In Pandas lesen Teams Parquet häufig über Arrow-basierte Werkzeuge für lokale Analysen und Entwicklungsabläufe.
Diese breite Unterstützung ist ein Grund, warum Parquet zur Standardwahl für geteilte Datensätze wurde. Werkzeuge brauchen keine speziellen Einzeladapter, um mitzuspielen.
Für Teams mit Lakehouse-Pipelines auf Databricks wird Data Platform Observability für Databricks-Umgebungen relevant, sobald Datensatzzahl und Jobvolumen wachsen. Layoutprobleme, verspätete Partitionen und Schemaabweichungen zeigen sich zuerst als operatives Rauschen, nicht als offensichtliche Formatfehler.
Die praktische Checkliste
Parquet funktioniert am besten, wenn Teams den Datensatz verwalten und nicht nur die einzelne Datei.
Partitionieren Sie zurückhaltend: Ordnen Sie Daten nach Feldern, die zu gängigen Filtern passen, etwa Datum oder Region, aber zersplittern Sie den Verzeichnisbaum nicht in winzige Fragmente.
Vermeiden Sie kleine Dateien: Zu viele winzige Parquet-Dateien können die Vorteile eines guten Formats untergraben, weil Engines Zeit mit dem Öffnen und Planen vieler Objekte verbringen.
Behandeln Sie Schemaevolution sorgfältig: Spalten hinzuzufügen ist oft beherrschbar. Inkompatible Typänderungen sind der Punkt, an dem Pipelines und Dashboards brechen.
Vereinheitlichen Sie Schreibmuster: Gemischte Konventionen zwischen Produzenten erzeugen vermeidbare Reibung für nachgelagerte Leser.
Das Dateiformat kann korrekt sein, während der Datensatz trotzdem schwer zu betreiben ist. Der meiste Parquet-Schmerz kommt von Fehlern bei Layout, Partitionierung oder Schemaverwaltung.
Eine operative Gewohnheit, die sich auszahlt
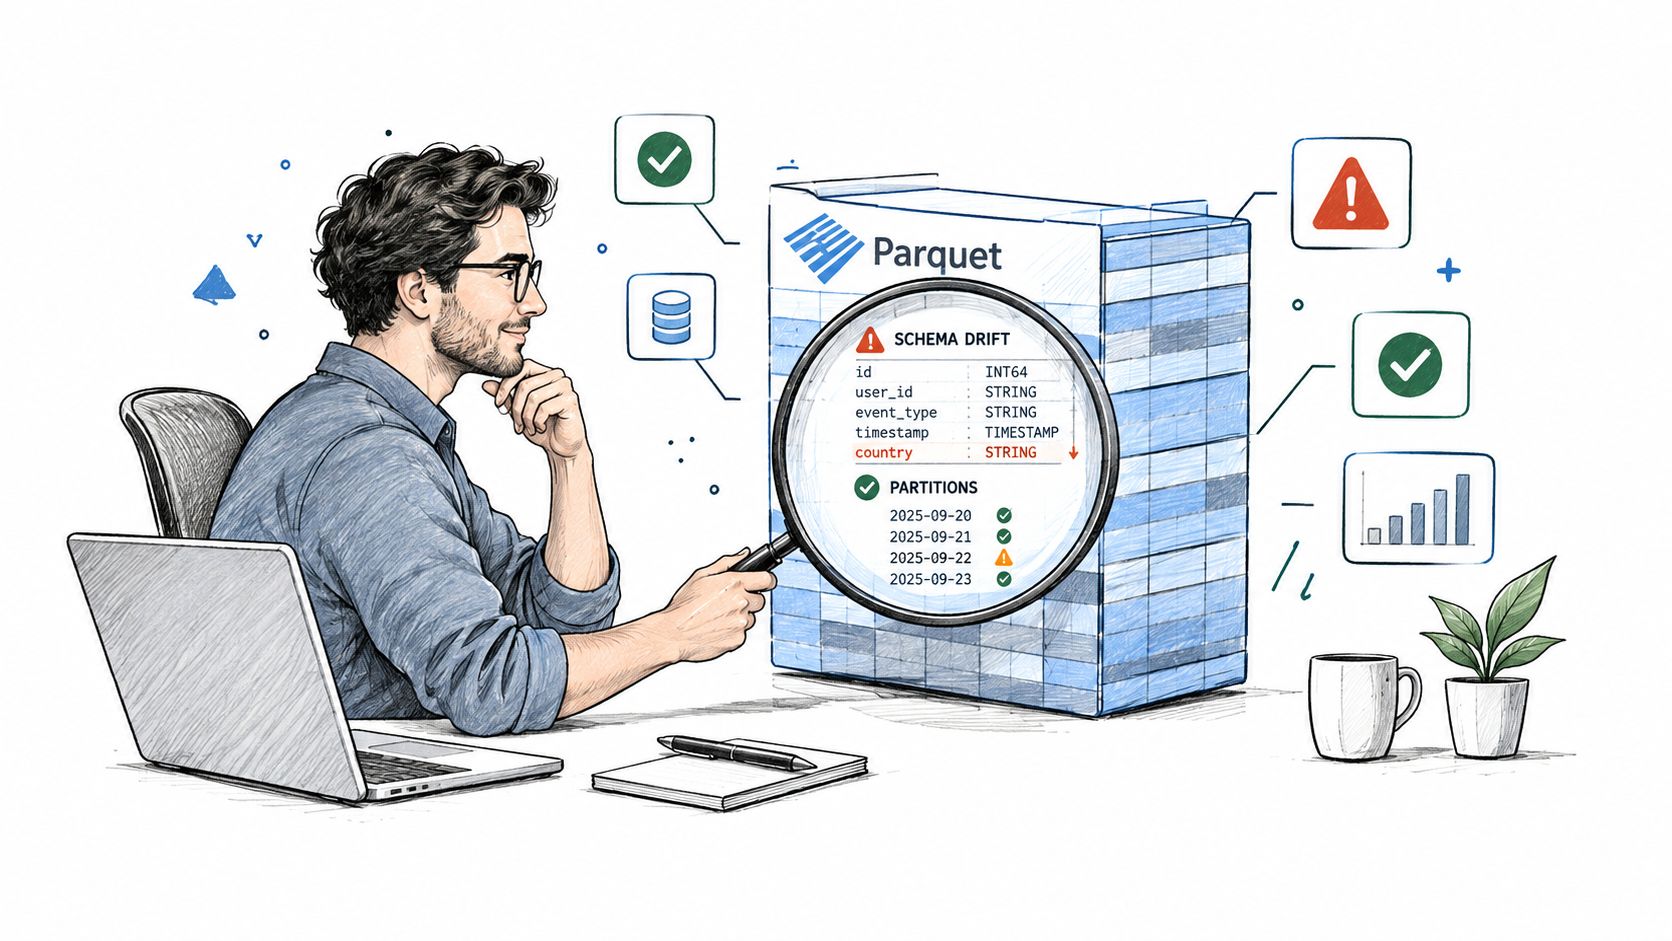
Verfolgen Sie Schema-Drift bewusst. Schreibt ein Produzent customer_id als String und ein anderer anders, zeigt sich das nicht immer als fehlgeschlagener Schreibvorgang. Manchmal taucht es später als verwirrende Nullwerte, übersprungene Partitionen oder ein BI-Modell auf, das nicht mehr kompiliert.
Hier trifft Observability auf Dateiformat-Kompetenz. Eine Option, die Teams nutzen, ist digna, das in der Umgebung der Kundin oder des Kunden läuft und Schemaänderungen, Timeliness, Anomalien und Validierungsprüfungen über Lake- und Warehouse-Datensätze hinweg überwachen kann. In parquet-lastigen Plattformen helfen diese Kontrollen, jene Fälle zu erkennen, in denen Dateien technisch lesbar, operativ aber unsicher bleiben.
Verlässliche Parquet-Daten durch Observability und Qualitätsprüfungen
Eine Parquet-Datei kann vollkommen gültig sein und montagmorgens trotzdem ein kaputtes Dashboard verursachen. Das ist der Teil, den viele Teams auf die harte Tour lernen.
Wo Verlässlichkeitsprobleme wirklich auftauchen
Die häufigen Fehlerbilder sind nicht exotisch:
Ein Produzent fügt Spalten hinzu oder entfernt sie, und nachgelagerte Transformationen passen sich nicht sauber an.
Eine Partition trifft verspätet ein, sodass das gestrige Dashboard vollständig aussieht, es aber nicht ist.
Datenwerte verschieben sich, obwohl die Dateistruktur weiterhin in Ordnung wirkt.
Die Dateianzahl explodiert, und Engines verbringen mehr Zeit mit der Objektverwaltung als mit dem Lesen nützlicher Daten.
Keines dieser Probleme löst sich dadurch, dass man sagt „wir nutzen Parquet“. Das Format liefert effiziente Speicherung und nützliche Metadaten. Es garantiert nicht, dass Produzenten konsistente Schemata schreiben oder Jobs Daten pünktlich liefern.
Was Sie rund um Parquet-Datensätze überwachen sollten
Verlässlicher Parquet-Betrieb umfasst meist Prüfungen in einigen Kategorien:
Schema-Tracking: Erkennen Sie hinzugefügte, entfernte oder geänderte Felder, bevor nachgelagerte Leser scheitern.
Timeliness-Prüfungen: Beobachten Sie, ob erwartete Partitionen oder Ladevorgänge eintreffen, wenn sie sollen.
Datenvalidierung: Bestätigen Sie, dass Geschäftsregeln nach Transformationen und Neuschreibungen weiterhin gelten.
Anomalieerkennung: Bemerken Sie ungewöhnliche Verschiebungen bei Zeilenzahlen, Null-Mustern oder Geschäftskennzahlen.
Teams, die Data-Observability-Praktiken rund um Lake-Datensätze umsetzen, erkennen diese Probleme früher, besonders wenn die Prüfungen nah an den Daten laufen statt erst, nachdem Berichte gebrochen sind.
Ein gültiges Dateiformat bedeutet keinen verlässlichen Datensatz. Verlässlichkeit entsteht aus der Überwachung von Verhalten, Struktur und Lieferung über die Zeit.
Wenn Sie anderen erklären, was eine Parquet-Datei ist, ist das die reife Antwort, die Sie ihnen mitgeben sollten. Parquet ist ein leistungsfähiges spaltenorientiertes Format für Analytics. Seine Row Groups, Column Chunks, Pages und Metadaten machen selektives Lesen möglich. Doch im Unternehmensmaßstab ist die Erfolgskennzahl nicht nur, ob Abfragen schnell laufen. Sie ist, ob Teams den Daten trauen können, die diese Abfragen zurückgeben.
digna gibt Teams eine Möglichkeit, das Verhalten rund um Parquet-Datensätze in der eigenen Umgebung zu überwachen, einschließlich Schemaänderungen, Timeliness, Anomalien und Validierungsprüfungen über Lakes, Warehouses und Pipelines hinweg. Wenn Sie auf Parquet standardisieren und die Effizienz des Formats ohne blinde Flecken bei der Verlässlichkeit wollen, besuchen Sie digna.
Diese Prüfungen fortlaufend auszuführen, statt sie erst nach einem kaputten Dashboard stichprobenartig vorzunehmen, ist der Zweck von Data Platform Observability.
Häufig gestellte Fragen
Was ist eine Parquet-Datei?
Apache Parquet ist ein quelloffenes, spaltenorientiertes Dateiformat für analytische Workloads. Jede Datei beginnt mit einer 4-Byte-Magic-Number PAR1 und endet mit einem Footer, der Schema, Row-Group-Positionen und Spaltenstatistiken enthält. Genau das erlaubt Query-Engines, Daten zu überspringen, die sie nie lesen müssen.
Worin unterscheidet sich eine Parquet-Datei von einer CSV-Datei?
CSV speichert Werte Zeile für Zeile, sodass eine Engine jedes Feld jeder Zeile parst, selbst wenn eine Abfrage nur drei Spalten betrifft. Parquet gruppiert die Werte jeder Spalte, sodass Engines nur das Angeforderte lesen. CSV bleibt an Ingestion-Grenzen einfacher; Parquet zahlt sich bei wiederholten analytischen Abfragen aus.
Was sind Row Groups, Column Chunks und Pages in Parquet?
Es sind drei verschachtelte Ebenen in der Datei. Eine Row Group ist eine horizontale Scheibe der Tabelle; darin liegen die Werte jeder Spalte in einem Column Chunk; jeder Chunk teilt sich in Pages, die Einheiten, die Parquet tatsächlich codiert und komprimiert. Die Größe der Row Group bestimmt, wie viel eine Abfrage überspringen kann.
Beruht Parquets Geschwindigkeitsvorteil nur auf Komprimierung?
Komprimierung ist nur einer von drei Gründen. Encoding — Dictionary, Run-Length, Delta — strukturiert Werte um, bevor ein Codec läuft, die Komprimierung verkleinert diese codierten Bytes je Spalte, und Footer-Metadaten erlauben der Engine, irrelevante Row Groups gar nicht erst zu öffnen. Die Metadaten sparen meist mehr Zeit als die auf der Platte gesparten Bytes.
Welche Werkzeuge können Parquet-Dateien lesen?
Parquet wird von Spark, Presto und Trino, von Pandas über Arrow-basierte Werkzeuge sowie von den meisten warehouse-nahen Engines unterstützt. Spark passt zu großen verteilten Lese- und Schreibvorgängen, Presto und Trino setzen auf Column Pruning und Predicate Pushdown, Pandas eignet sich für lokale Analysen. Verfolgen Sie Schema-Drift über Produzenten hinweg, da abweichende Typen später als verwirrende Nullwerte auftauchen.



