Was ist eine Datenpipeline und warum sie wichtig ist
|
5
min. Lesezeit

Eine Datenpipeline ist ein End-to-End-System, das das Erfassen, Transformieren, Validieren und Laden von Daten automatisiert, damit sie zuverlässig für Analysen, KI und betriebliche Entscheidungen genutzt werden können. In der modernen Produktion bedeutet das meist, dass eine Pipeline Daten über Speicher- oder Konsumschichten hinweg bewegen muss, ohne an Aktualität, Struktur oder Vertrauen zu verlieren.
Sie haben wahrscheinlich schon das Gegenteil erlebt: Ein Dashboard wird grün, ein Team geht davon aus, dass die Zahlen stimmen, und dann stellt jemand fest, dass der zugrunde liegende Feed stundenlang veraltet war, weil sich ein vorgelagertes System ohne Warnung geändert hat.
Inhaltsverzeichnis
Was eine Datenpipeline in der Produktion tatsächlich tut
Warum die Lehrbuchdefinition nicht ausreicht
Die vier Kernkomponenten jeder Pipeline
Ingestion und Transformation
Speicherung und Konsum
Wahl zwischen ETL-, ELT- und Streaming-Architekturen
Wo welches Muster passt
Wie man die Entscheidung trifft
Stille Fehlermodi, die Pipelines beschädigen
Schema Drift und verspätet eintreffende Daten
Qualitätsregressionen und blindes Monitoring
Die geschäftlichen Kosten unzuverlässiger Pipelines
Wie sich der Schaden ausbreitet
Warum dies ein geschäftliches Risiko und kein technisches Ärgernis ist
Woran Sie erkennen, ob Ihre Pipeline produktionsbereit ist
Eine praktische Betriebsbereitschaftsprüfung
Fragen, die jede Überprüfung beantworten sollte
Pipelines bauen, denen Sie vertrauen können
Was eine Datenpipeline in der Produktion tatsächlich tut
Ein Umsatz-Dashboard kann perfekt aussehen, während die dahinter liegenden Daten bereits alt genug sind, um das Unternehmen in die Irre zu führen. Eine Quell-API ändert ihr Antwortformat, ein geplanter Job wird dennoch erfolgreich abgeschlossen, und die Berichtsebene rendert munter weiter. So bemerkt niemand, dass die Zahlen 18 Stunden veraltet sind, bis sie jemand mit dem Transaktionssystem vergleicht.
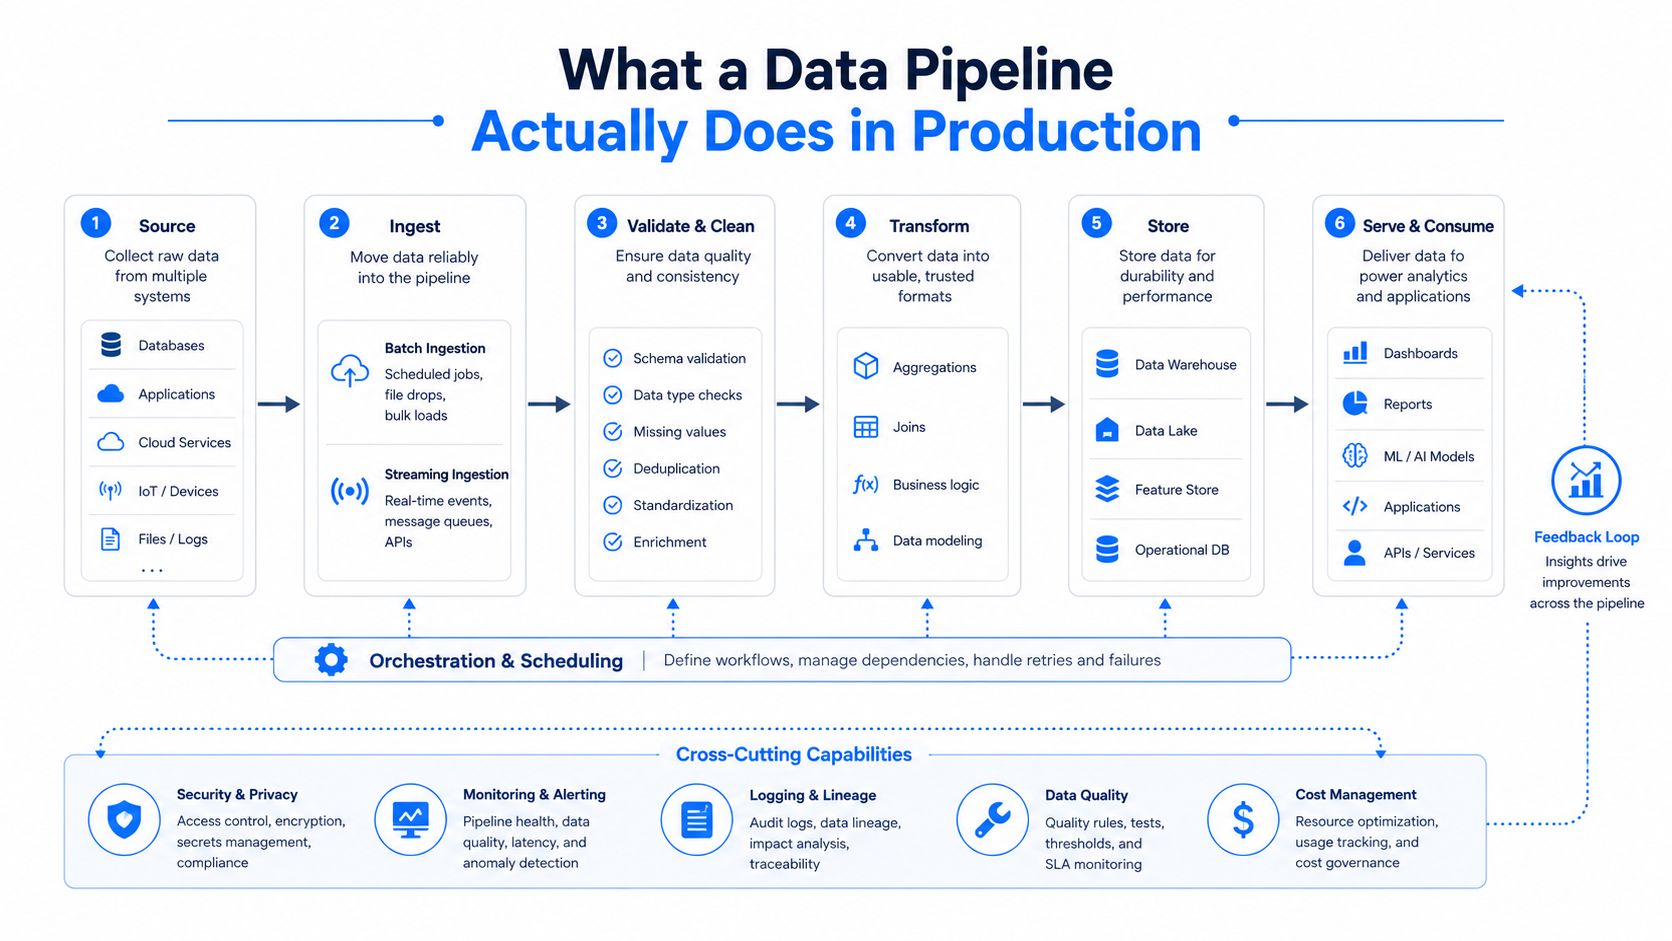
Deshalb ist eine Datenpipeline mehr als nur Boxen und Pfeile. Sie ist das betriebliche Rückgrat, das das Erfassen, Transformieren, Validieren und Laden von Daten aus Quellsystemen in Speicher- oder Konsumschichten automatisiert, damit sich Analysten, Modelle und Geschäftsanwender auf das verlassen können, was sie sehen. Historische Berichte zeigen, dass sich das Feld von manuellen Batch-Skripten in den 1970er und 1980er Jahren zu formelleren ETL-Systemen um 1992 und schließlich zu Cloud-nativen ELT-, Streaming- und Echtzeit-Architekturen in den 2010er und 2020er Jahren entwickelt hat (BytePlus).
Warum die Lehrbuchdefinition nicht ausreicht
Die einfache Definition klingt ordentlich, aber Produktionssysteme sind es selten. Vorgelagerte APIs ändern sich ohne Ankündigung, Datenbanken entwickeln sich weiter, Dateien kommen zu spät an und nachgelagerte Teams erwarten dennoch frische Daten nach einem vorhersehbaren Zeitplan. Die Pipeline muss diese Änderungen abfangen, ohne dass jede kleine Abweichung zu einem fehlerhaften Dashboard oder einem verärgerten Slack-Thread führt.
Praktische Regel: Wenn eine Pipeline nur dann erfolgreich ist, wenn sich nichts ändert, ist sie nicht produktionsbereit, sondern hat einfach nur Glück.
Aus diesem Grund betrachten moderne Teams Observability, Retry-Logik, Dependency-Management und Fehlertoleranz als Teil der Pipeline selbst und nicht als nachträgliche Ergänzungen. Eine Produktionspipeline muss das Unternehmen vor unsichtbaren Fehlern schützen und nicht nur Bytes von einem System in ein anderes verschieben.
Die vier Kernkomponenten jeder Pipeline
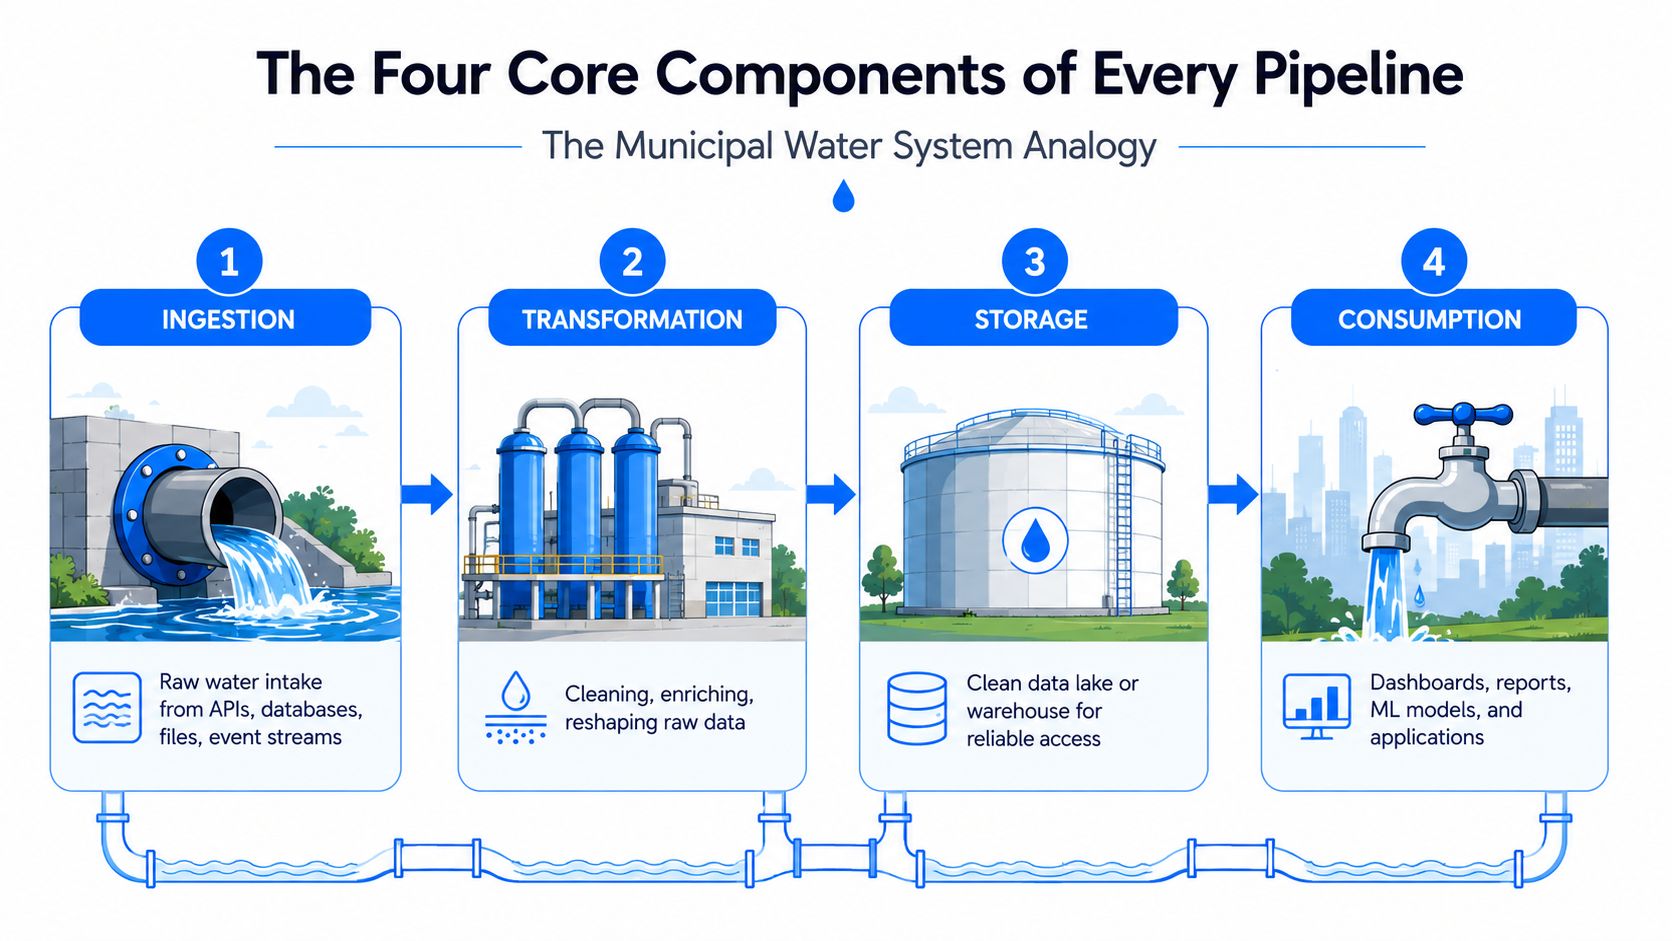
Eine nützliche Metapher zum Verständnis des Pipeline-Designs ist der Vergleich mit einem städtischen Wassersystem. Rohwasser kommt an, wird gereinigt, gespeichert und dann an die Haushalte geliefert. Eine Datenpipeline folgt dem gleichen Grundmuster, nur eben mit APIs, Datenbanken, Dateien, Event-Streams, Warehouses und Dashboards anstelle von Rohren und Tanks.
Ingestion und Transformation
Ingestion (Erfassung) ist der Rohwasserzulauf. Teams rufen Daten aus APIs, SQL-Datenbanken, SaaS-Apps, Dateien und Event-Streams ab, oft über Tools wie CDC-Connectors, Webhook-Listener oder geplante Datei-Uploads. Diese Phase bricht zuerst ab, wenn Ratenbegrenzungen greifen, die Pagination falsch gehandhabt wird oder ein vorgelagertes System plötzlich Felder in einem anderen Format zurückgibt.
Transformation ist die Filteranlage. Ingenieure bereinigen Datensätze, standardisieren Formate, reichern Ereignisse an und aggregieren Fakten zu geschäftsfertigen Ausgaben. Der Kompromiss ist einfach, aber unerbittlich: Mehr Transformation kann die Qualität verbessern, verbraucht aber auch Rechenleistung und schafft mehr Stellen, an denen die Logik asynchron zur Quelle werden kann.
Speicherung und Konsum
Speicherung ist das Reservoir. Das kann ein Warehouse, ein Lake oder ein Lakehouse sein, und die Entscheidung hängt meist davon ab, wie Teams Formate, Partitionen und die nachgelagerte Wiederverwendung organisieren wollen. Wenn die Speicherung schlecht modelliert ist, zahlen Teams am Ende für wiederholte Scans, langsame Abfragen und mühsame Wiederaufbereitungen.
Konsum ist der Wasserhahn am Ende der Leitung. BI-Tools, ML-Modelle und betriebliche Apps hängen alle von dieser Phase ab, und jede hat eine andere Erwartung an die Aktualität. Ein Dashboard, das nächtlich aktualisiert wird, kann Verzögerungen tolerieren, eine kundenorientierte Anwendung oder ein Betrugserkennungs-Workflow hingegen nicht.
Für eine detailliertere architektonische Sicht ist der digna-Leitfaden für Datenpipeline-Architekturen nützlich, wenn Sie diese Phasen in ein breiteres Betriebsmodell einordnen möchten.
Die Phase, die im Diagramm am einfachsten aussieht, ist meistens die, in der die Probleme in der Produktion beginnen, da Speicher- und Konsumentscheidungen darüber bestimmen, ob der Rest der Pipeline nützlich bleibt.
Wahl zwischen ETL-, ELT- und Streaming-Architekturen
ETL, ELT und Streaming sind keine konkurrierenden Modewörter. Sie sind unterschiedliche Antworten auf dieselbe Frage: Wie schnell müssen sich die Daten bewegen und wie viel Kontrolle benötigen Sie, bevor jemand sie sieht?
Wo welches Muster passt
ETL transformiert Daten vor dem Laden. Das funktioniert gut in regulierten Umgebungen, in denen das Team strenge Qualitätsprüfungen wünscht, bevor die Daten im Zielsystem landen, und in denen die Rechenleistung des Warehouses begrenzt oder teuer ist.
ELT lädt zuerst Rohdaten und transformiert sie innerhalb des Warehouses. Das passt besser zu Cloud-nativen Stacks, da sich Speicher und Rechenleistung einfacher unabhängig voneinander skalieren lassen und dieselben Rohdaten für mehrere Modelle oder Berichtsebenen wiederverwendet werden können.
Streaming verarbeitet Ereignisse kontinuierlich, sobald sie eintreffen. Es ist die richtige Wahl für ereignisgesteuerte Systeme, Echtzeit-Betrugserkennung und Personalisierung, bei denen veraltete Informationen ein geschäftliches Problem und kein kleines Ärgernis darstellen.
Faktor | ETL | ELT | Streaming |
|---|---|---|---|
Transformations-Timing | Vor dem Laden | Nach dem Laden | Kontinuierlich beim Eintreffen der Ereignisse |
Beste Eignung | Regulierte, batch-intensive Umgebungen | Cloud-native Analyse-Stacks | Betriebliche Anwendungsfälle mit geringer Latenz |
Betriebliche Komplexität | Moderat | Moderat | Hoch |
Aktualitätsprofil | Geplant | Schneller als klassischer Batch-Betrieb, dennoch geplant | Nahezu Echtzeit |
Governance-Ausrichtung | Starke Kontrolle vor dem Laden | Starke Kontrolle auf Warehouse-Seite | Erfordert sorgfältiges Monitoring und Event-Disziplin |
Wie man die Entscheidung trifft
Nutzen Sie ETL, wenn Qualitätskontrollen wichtiger sind als Flexibilität. Nutzen Sie ELT, wenn das Unternehmen Wiederverwendbarkeit, Skalierbarkeit und schnellere Iterationen innerhalb des Warehouses wünscht. Nutzen Sie Streaming, wenn Latenz den Umsatz, das Risiko oder das Kundenerlebnis direkt beeinflusst.
Wenn Sie einen praktischen Vergleich aus Implementierungssicht suchen, ist die digna-ETL-Datenpipeline-Übersicht ein guter Referenzpunkt für die ETL-Seite der Entscheidung.
Entscheidungsregel: Optimieren Sie für die langsamste akzeptable Aktualität, nicht für die schnellste verfügbare Technologie.
Das klingt offensichtlich, bis Teams Streaming für alles wählen und dann monatelang für eine Komplexität bezahlen, die sie gar nicht benötigt hätten. Die beste Architektur ist diejenige, die zur Latenz, zum Reifegrad der Governance, zu den Kostenbeschränkungen und zur Fähigkeit des Teams passt, sie zu betreiben.
Stille Fehlermodi, die Pipelines beschädigen
Die gefährlichsten Pipeline-Fehler lösen keine rot leuchtende Fehlermeldung aus. Sie lassen den Job erfolgreich durchlaufen, halten das Dashboard am Leben und verfälschen die Zahlen, auf die sich Führungskräfte verlassen.
Schema Drift und verspätet eintreffende Daten
Schema Drift tritt auf, wenn eine vorgelagerte Quelle Felder hinzufügt, entfernt oder umbenennt, ohne das Datenteam zu informieren. Eine gängige Quelle definiert dies als eine unangekündigte strukturelle Änderung im Vergleich zu dem Schema, für das die Pipeline gebaut wurde, und eine andere stellt fest, dass dies eine der häufigsten Fehlerursachen ist, wenn sich Anwendungsdatenbanken ändern, ohne das Datenteam zu benachrichtigen (DataThere). Das Ergebnis können Nullwerte sein, wo eigentlich Werte stehen sollten, oder Aggregationen, bei denen Felder fehlen, von denen niemand bemerkt hat, dass sie verschwunden sind.
Verspätet eintreffende Daten verursachen ein anderes Problem. Ein Batch-Fenster schließt sich, bevor alle Datensätze eingegangen sind, sodass die tägliche Metrik vollständig aussieht, obwohl sie die tatsächliche Aktivität untererfasst. Eine Studie zur Batch-Verarbeitung beschreibt dies als Daten, die nach dem Schließen des erwarteten Zeitfensters, aber noch innerhalb einer vordefinierten Toleranzperiode eintreffen (IJSAT).
Ein Zahlungsdienstleister, der Zeitstempelformate ändert, oder ein CRM-Export, bei dem benutzerdefinierte Felder wegfallen, können die nachgelagerte Logik stören, ohne den Job selbst abzubrechen. Der Bericht wird weiterhin gerendert, was genau der Grund ist, warum die Leute ihm zu früh vertrauen.
Qualitätsregressionen und blindes Monitoring
Qualitätsregressionen verlaufen langsamer und sind schwerer zu erkennen. Doppelte Datensätze schleichen sich ein, Formatinkonsistenzen breiten sich aus und grundlegende Validierungen sind immer noch erfolgreich, weil die Daten technisch vorhanden sind – nur eben weniger vertrauenswürdig als zuvor. Traditionelles Monitoring auf Job-Ebene übersieht das völlig, weil es nur fragt, ob die Pipeline lief, und nicht, ob das Ergebnis noch Sinn ergibt.
Für Teams, die über die reine Aktualität hinausdenken wollen, ist IamVera.AIs Anmerkung zur Datenaktualität und KI-Antworten eine nützliche Erinnerung daran, dass veraltete Eingaben nicht nur Berichte beeinträchtigen, sondern auch die nachgelagerte Entscheidungsfindung.
Die produktive Antwort darauf ist das gemeinsame Monitoring von Struktur, Timing und Ergebnisverhalten. Das ist der Unterschied zwischen dem Wissen, dass ein Job abgeschlossen wurde, und dem Wissen, dass das Unternehmen dem Ergebnis vertrauen kann.
Für einen tieferen Einblick in Vorfallsmuster zeigt der digna-Leitfaden, warum Datenpipelines in der Produktion fehlschlagen, wie man diese Fehlermodi an praktischen Erkennungspunkten festmacht.
Die geschäftlichen Kosten unzuverlässiger Pipelines
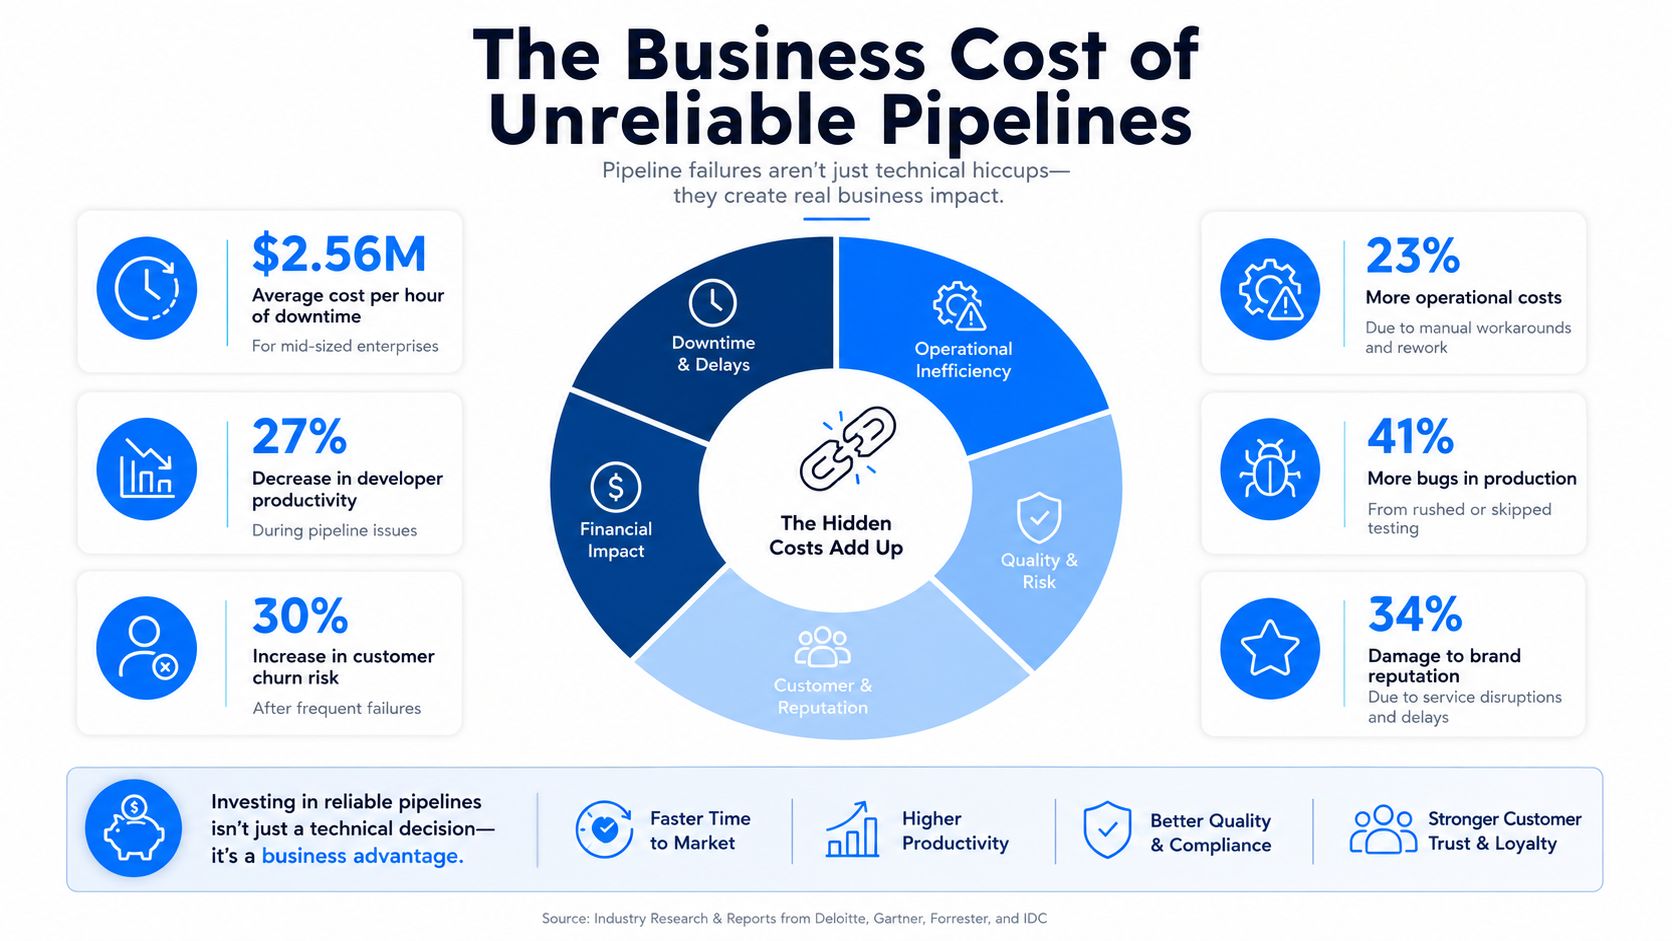
Unzuverlässige Pipelines bleiben nicht auf die Technik beschränkt. Sie wirken sich auf Kampagnenentscheidungen, Prognosen, kundenorientierte Produkte und das Modellverhalten aus.
Wie sich der Schaden ausbreitet
Eine fehlerhafte Ingestion-Schicht führt zu veralteten Dashboards. Marketingteams optimieren dann auf Basis veralteter Conversion-Daten, Finanzteams erstellen Prognosen anhand unvollständiger Ergebnisse und Analysten verbringen ihre Zeit mit dem Abgleich von Zahlen, anstatt Fragen zu beantworten. Wenn kundenorientierte Apps auf dieselbe unzuverlässige Pipeline zugreifen, leidet der Ruf des Unternehmens sofort.
Auch KI- und ML-Systeme spüren das Problem. Wenn Trainings- oder Feature-Pipelines degradieren, scheitert das Modell nicht immer offensichtlich; es kann driften und weiterhin schwächere Vorhersagen oder Empfehlungen treffen, während alle davon ausgehen, dass es einwandfrei funktioniert.
Warum dies ein geschäftliches Risiko und kein technisches Ärgernis ist
IBM berichtet, dass laut einer IBV-Studie aus dem Jahr 2025 43 % der Chief Operations Officers Datenqualitätsprobleme als ihre wichtigste Datenpriorität nannten, und mehr als ein Viertel der Unternehmen schätzte die jährlichen Verluste auf über 5 Millionen USD, wobei 7 % sogar 25 Millionen USD oder mehr verloren (IBM). Das deckt sich mit dem, was viele Teams bereits in der Praxis spüren: Schlechte Daten sind kein abstraktes Governance-Problem, sondern direkte Betriebskosten.
Das Behebungsmuster ist ebenfalls hart. Eine zitierte ROI-Studie zur Datenqualität beziffert die Prävention auf etwa 1 USD pro Datensatz, das Finden und Beheben schlechter Daten nach deren Erscheinen auf etwa 10 USD pro Datensatz und die Korrektur eines Fehlers nach einem Vorfall auf etwa 100 USD pro Datensatz (LightsonData). Je länger das Problem unentdeckt bleibt, desto teurer wird es.
Wenn Sie das Problem gegenüber der Führungsebene einfach formulieren wollen, hilft der digna-Rechner für Daten-Ausfallzeiten, Pipeline-Ausfälle mit geschäftlichen Auswirkungen zu verknüpfen, ohne die Diskussion in Mutmaßungen ausarten zu lassen.
Eine Pipeline, die gut aussieht, während sie falsche Ergebnisse liefert, ist teurer als eine Pipeline, die schnell fehlschlägt, weil sich falsches Vertrauen skaliert.
Woran Sie erkennen, ob Ihre Pipeline produktionsbereit ist
Eine Pipeline ist produktionsbereit, wenn das Team erklären kann, wie sie sich bei Änderungen, Verzögerungen und teilweisen Ausfällen verhält. „Im Staging lief es durch“ reicht nicht aus, da das Staging selten unordentliches Quellverhalten, verspätete Datensätze oder Konsumenten simuliert, die zu einer festen Zeit auf frische Daten angewiesen sind.
Eine praktische Betriebsbereitschaftsprüfung
Observability: Jede Phase sollte strukturierte Logs ausgeben, die Lineage sollte nachvollziehbar sein und Alarme sollten bei Überschreitung von Aktualitätsschwellenwerten ausgelöst werden, nicht nur beim Job-Abschluss. Wenn die Pipeline verspätet, aber „grün“ ist, ist das Alarmierungsmodell zu oberflächlich.
Data Validation: Erzeuger und Verbraucher benötigen Schema-Verträge, Qualitätsprüfungen auf Zeilenebene und Anomalieerkennung bei Zeilenanzahlen oder Werteverteilungen. Das gibt Ihnen die Chance, fehlerhafte Ausgaben abzufangen, bevor sie Dashboards oder Features erreichen.
Aktualität und Replay (Wiederholung): Definieren Sie ein echtes Aktualitäts-SLA für jeden nachgelagerten Anwendungsfall und testen Sie, ob die Pipeline historische Daten wiederholen kann, ohne Duplikate zu erzeugen. Wenn sie sich nach einem Quellausfall nicht selbst erholen kann, ist sie nicht widerstandsfähig genug für die Produktion.
Eine nützliche interne Referenz für diese Art der Bewertung ist der digna-Leitfaden zur Zuverlässigkeitsmessung, insbesondere wenn Ihr Team Zuverlässigkeit in messbare statt in anekdotische Werte übersetzen muss.
Fragen, die jede Überprüfung beantworten sollte
Können wir den Datenzustand sehen, nicht nur den Job-Status? Wenn nicht, ist die Observability unvollständig.
Wissen wir, was sich geändert hat, als sich die Quelle änderte? Wenn nicht, wird Sie der Schema Drift überraschen.
Können wir Daten sicher neu verarbeiten? Wenn nicht, führt die Wiederherstellung zu Duplikaten oder Lücken.
Kennen die nachgelagerten Nutzer die Erwartungen an die Aktualität? Wenn nicht, basiert das Vertrauen auf Gewohnheit, nicht auf Belegen.
Guter Standard: Eine produktionsbereite Pipeline funktioniert auch dann weiter, wenn Eingaben verspätet, unordentlich oder teilweise fehlerhaft sind, und sie teilt Ihnen genau mit, wann das passiert.
Dieser Standard sollte von Engineering, Analytics und den Business-Ownern geteilt werden. Andernfalls definiert das Team den Erfolg als „der DAG lief durch“, während das Business davon ausgeht, dass Erfolg bedeutet „die Zahlen stimmen“.
Pipelines bauen, denen Sie vertrauen können
Die moderne Pipeline ist nicht nur ein Rohrleitungssystem zwischen Systemen. Sie ist eine Zuverlässigkeitsschicht für Datenprodukte, was bedeutet, dass Vertrauen durch Designentscheidungen entsteht und nicht durch Orchestrierung allein.
Teams, die sich Vertrauen erarbeiten, tun einige Dinge konsequent: Sie definieren Aktualitäts- und Qualitäts-SLAs, behandeln Schemaänderungen als kritische Ereignisse, überwachen den Datenzustand unabhängig vom Ausführungsstatus und passen die Architektur an die Bedürfnisse der nachgelagerten Konsumenten an. Sie regeln auch die Verantwortlichkeiten explizit, denn niemand vertraut einer kritischen Pipeline, wenn niemand weiß, wer morgens um 7 Uhr bei Problemen reagiert.
Für Teams, die nach einem praktischen Entwurf suchen, ist der DataTeams-Leitfaden zum Erstellen einer Datenpipeline ein hilfreicher Begleiter zu den hier vorgestellten Ideen, insbesondere wenn Sie die Architektur in tägliche Implementierungsentscheidungen übersetzen.
Der Lohn zeigt sich später: in saubereren Analysen, robusteren Modellen und weniger Diskussionen darüber, ob eine Metrik korrekt ist. Zuverlässige Pipelines werden zur Basisschicht für Echtzeit-Analysen, Machine-Learning-Feature-Stores und automatisierte Entscheidungssysteme, die auf konsistente, qualitativ hochwertige Daten angewiesen sind.
digna hilft Teams, Schemaänderungen, Timeliness, Data Validation und Anomalien innerhalb ihrer eigenen Umgebung zu überwachen – genau die Art von Kontrolle, die Produktionspipelines benötigen. Wenn Sie die Pipeline-Zuverlässigkeit erhöhen oder das Datenvertrauen für das Unternehmen sichtbar machen wollen, besuchen Sie digna und sehen Sie, wie sich die Observability-Module in Ihren Stack integrieren lassen.
Häufig gestellte Fragen
Was ist eine Datenpipeline?
Ein durchgängiges System, das Aufnehmen, Transformieren, Validieren und Laden von Daten automatisiert, damit sie verlässlich für Analytics, KI und operative Entscheidungen nutzbar sind. Die Automatisierung ist der Kern: eine Folge manueller Schritte, die zufällig in Reihenfolge läuft, ist keine Pipeline.
Was sind die vier Kernbausteine?
Ingestion, Transformation, Speicherung und Konsum, die sich sauber auf ein städtisches Wassersystem abbilden lassen: Rohwasserentnahme, Filteranlage, Reservoir und Wasserhahn. Die Stufe, die im Diagramm am einfachsten aussieht, ist meist die, an der der Produktionsschmerz beginnt.
Warum genügt die Lehrbuchdefinition nicht?
Weil sich Produktionssysteme selten ordentlich verhalten. Eine Quell-API ändert ihr Antwortformat, der geplante Job läuft trotzdem durch, die Reporting-Schicht rendert weiter, und niemand bemerkt, dass die Zahlen 18 Stunden alt sind, bis jemand sie mit dem Transaktionssystem vergleicht.
Wann wählt man ETL, ELT oder Streaming?
Es sind keine konkurrierenden Schlagworte, sondern unterschiedliche Platzierungen des Transformationsschritts. ETL transformiert vor dem Laden, ELT lädt Rohdaten zuerst und transformiert im Warehouse, Streaming verarbeitet fortlaufend. Die richtige Wahl folgt der benötigten Latenz und der Frage, wo die Rechenlast hingehört.
Wie lange gibt es Datenpipelines schon?
Länger als den Begriff. Historische Darstellungen führen das Feld von manuellen Batch-Skripten der 1970er und 1980er Jahre über formalere ETL-Systeme um 1992 bis zu cloud-nativem ELT, Streaming und Echtzeitarchitekturen in den 2010er und 2020er Jahren.


