Warum Datenqualität für ein Unternehmen wichtig ist
|
8
min. Lesezeit

Ein Führungsteam beginnt den Morgen mit einer vertrauten Routine. Die Finanzabteilung prüft das Umsatz-Dashboard, der Betrieb kontrolliert die Auftragsvolumina, der Vertrieb studiert die Pipeline, und der Kundenservice bereitet sich auf die Nachfrage des Tages vor. Am Nachmittag stellt jemand fest, dass eine Quelle verspätet geliefert hat, eine andere einen Feldnamen geändert hat und eine dritte doppelte Kundendatensätze enthält. Das Dashboard wirkte präzise, doch das Unternehmen traf seine Entscheidungen auf Basis eines unvollständigen Bildes.
Das Problem ist selten ein spektakulärer Datenbankausfall. Es ist ein fehlendes Feld, ein veralteter Extrakt, eine uneinheitliche Definition oder eine Schemaänderung, die niemand bemerkt hat. Diese Defekte wandern in Prognosen, regulatorische Berichte, Kundenprozesse und KI-Systeme, bevor irgendjemand sie mit der ursprünglichen Quelle in Verbindung bringt.
Deshalb ist die Frage, warum Datenqualität für ein Unternehmen wichtig ist, eine geschäftliche und nicht nur eine technische Frage. Verlässliche Daten helfen Menschen, sicher zu entscheiden, zu handeln, zu erklären und Vorgaben einzuhalten. Schlechte Daten zwingen Teams, Berichte zu hinterfragen, Arbeit zu wiederholen, Initiativen zu verschieben und Zahlen zu verteidigen, die sie nicht vollständig nachvollziehen können. Dieser Leitfaden zeigt, wie Datenqualität organisatorische Kontrolle über Entscheidungen, Compliance und KI-Risiken schafft und wie Führungskräfte daraus eine dauerhafte operative Fähigkeit machen. Einen praxisnahen Überblick über den geschäftlichen Nutzen gibt der organisatorische Nutzen von Datenqualität.
Inhaltsverzeichnis
Einführung: Warum Datenqualität den Unternehmenserfolg prägt
Wie schlechte Datenqualität Entscheidungen, Vertrauen und KI untergräbt
Wie Unternehmen verlässliche Datenqualität und Observability aufbauen
Praxisbeispiele für die Wirkung von Datenqualität in verschiedenen Branchen
Einführung: Warum Datenqualität den Unternehmenserfolg prägt
Eine Prognose kann scheitern, selbst wenn die Berechnung korrekt ist. Angenommen, ein Planungsteam erwartet steigende Auftragszahlen und plant Bestand, Personal und Transport entsprechend. Die Prognose nutzt ein valides Modell, doch ein regionales System liefert die Transaktionen des Vortags zu spät und ein anderes erfasst Retouren unter einer geänderten Kategorie. Das Planungsteam sieht keinen Unsinn. Es sieht Daten, die das Unternehmen als Ganzes nicht mehr abbilden.
Dieser Unterschied ist wichtig. Die meisten unternehmerischen Entscheidungen hängen davon ab, dass mehrere Systeme zusammenspielen: Kundendaten, Aufträge, Zahlungen, Bestände, Serviceinteraktionen, Personaldaten und externe Informationen. Ein Defekt in einem Strom kann die Bedeutung eines kombinierten Ergebnisses verändern. Die Finanzabteilung sieht dann Umsätze, die sich nicht abstimmen lassen, der Kundenservice kontaktiert die falsche Person, und die Geschäftsführung diskutiert eine Sitzung lang, wessen Tabelle stimmt, statt zu entscheiden, was zu tun ist.
Qualitätsprobleme überschreiten Abteilungsgrenzen
Datenqualität betrifft jedes Team, das Informationen nutzt:
Die Finanzabteilung nutzt sie für Abschlussprozesse, Planung, Kontrollen und Berichte.
Der Betrieb ist auf aktuelle und vollständige Datensätze angewiesen, um Arbeit zu koordinieren.
Vertrieb und Marketing brauchen konsistente Kunden- und Accountdaten, um Chancen zu priorisieren.
Der Kundenservice ist auf korrekte Identitäten, Historien und Vorgangsdetails angewiesen.
Risiko und Compliance benötigen nachvollziehbare Nachweise für formale Pflichten.
Daten- und KI-Teams brauchen verlässliche Eingaben für Dashboards, Modelle und automatisierte Workflows.
Das Datenteam entdeckt den Defekt vielleicht, die Folgen trägt jedoch häufig das Geschäft. Aus einer verspäteten Lieferung wird eine verpasste operative Entscheidung. Aus einem doppelten Konto wird eine widersprüchliche Kundenbehandlung. Eine umbenannte Spalte kann dazu führen, dass ein nachgelagerter Bericht eine leere oder irreführende Kennzahl anzeigt, ohne einen erkennbaren Fehler zu erzeugen.
Praxisregel: Behandeln Sie jeden kritischen Datensatz als Teil eines operativen Prozesses und nicht als passives technisches Asset.
Unternehmen beginnen Qualitätsarbeit oft erst nach einem sichtbaren Vorfall. Ein Bericht bricht ab, eine Aufsichtsbehörde verlangt Nachweise, oder ein Modell liefert ein unplausibles Ergebnis. Diese Reaktion ist verständlich, aber sie bedeutet, dass Führungskräfte Entdeckung, Untersuchung, Korrektur und Kommunikation an der teuersten Stelle des Lebenszyklus bezahlen.
Ein stärkerer Ansatz stellt die Fragen früher. Wem gehören die Daten? Was bedeutet „vollständig“ für diesen Anwendungsfall? Wie aktuell müssen sie sein? Welche Änderungen sollten eine Pipeline stoppen und welche nur eine Warnung auslösen? Sobald diese Antworten feststehen, wird Datenqualität etwas, das das Unternehmen steuern kann, statt etwas, worüber es nur diskutiert.
Was Datenqualität im Unternehmen bedeutet
Stellen Sie sich Unternehmensdaten wie ein Wasserversorgungssystem vor. Informationen entspringen vielen Quellen, durchlaufen Aufbereitungs- und Verteilungspunkte und erreichen schließlich einen Hahn, an dem jemand sie nutzt. Ein sauber aussehendes Glas beweist nicht, dass die gesamte Versorgungskette gesund ist. Das Unternehmen muss auch wissen, ob das Wasser pünktlich ankam, ob weiter oben Verunreinigungen eingetreten sind und ob der Druck für den vorgesehenen Zweck ausreicht.
Mit Datenqualität verhält es sich genauso. Ein Datensatz ist zweckgeeignet, wenn er die Eigenschaften aufweist, die eine bestimmte Entscheidung oder ein bestimmter Prozess verlangt. Ein monatlicher Strategiebericht verträgt vielleicht eine kurze Verzögerung, ein Betrugsprozess oder ein operativer Alarm nicht. Ein KI-Trainingsdatensatz benötigt zusätzlich zu den Eigenschaften eines Dashboards eine belastbare Herkunft und konsistente Labels.
Sechs Prüfungen machen Qualität praktikabel
Beginnen Sie mit den Dimensionen, die beschreiben, ob Daten einen Einsatzzweck sicher tragen können:
Genauigkeit bedeutet, dass der Wert das abbildet, wofür er in der realen Welt steht. Die aktuelle Adresse einer Kundin oder eines Kunden sollte angeben, wo diese Person erreichbar ist.
Vollständigkeit bedeutet, dass keine kritischen Informationen fehlen. Ein Auftrag ohne Produktkennung kann im System existieren, trägt aber keine verlässliche Produktanalyse.
Konsistenz bedeutet, dass zusammenhängende Systeme kompatible Werte und Definitionen verwenden. Wenn ein Team eine Kundin als aktiv kennzeichnet und ein anderes einen widersprüchlichen Status führt, lässt sich der kombinierte Datensatz nicht zuverlässig interpretieren.
Aktualität bedeutet, dass Informationen dann eintreffen und aktuell bleiben, wenn der Prozess sie braucht. Ein korrekter Wert, der nach dem Entscheidungsfenster geliefert wird, kann operativ trotzdem wertlos sein.
Validität bedeutet, dass Daten den geforderten Formaten, Wertebereichen und Geschäftsregeln folgen. Ein Datum, eine Kennung oder eine Kategorie kann vorhanden sein und dennoch die Regeln verletzen, die für die Verarbeitung nötig sind.
Eindeutigkeit bedeutet, dass das Unternehmen dieselbe reale Entität nicht mehrfach zählt. Doppelte Kunden- oder Transaktionsdatensätze können Menge, Wert und Priorisierung verzerren.

Eignung zählt mehr als Perfektion
Kein Unternehmen muss jedes Feld perfekt haben, bevor es arbeiten kann. Die nützliche Frage lautet, ob die Daten für ihren vorgesehenen Zweck zuverlässig genug sind – mit bekannten Einschränkungen und verantwortlichen Eigentümern. Ein Kundenservice-Workflow priorisiert vielleicht Identitätsgenauigkeit und Vollständigkeit, ein Management-Trendbericht dagegen Konsistenz und historische Vergleichbarkeit.
Deshalb sollten Qualitätsanforderungen gemeinsam mit den Fachbereichen definiert werden. Fragen Sie, welche Entscheidung die Daten stützen, was ein Fehler kosten würde, wie schnell ein Problem erkannt werden muss und welche Nachweise Nutzerinnen und Nutzer brauchen, um dem Ergebnis zu vertrauen. Die Bedeutung von Datenqualität wird klarer, wenn Teams jede Dimension mit einem tatsächlichen Prozess verbinden, statt sie als abstrakte Kennzahl zu behandeln.
Die wahren Kosten schlechter Datenqualität für Unternehmen
Schlechte Datenqualität erzeugt sichtbare Verluste, etwa falsche Zahlungen oder fehlgeschlagene Berichte. Ihr größerer Kostenblock zeigt sich jedoch als angehäufte Reibung. Analystinnen und Analysten gleichen Dateien manuell ab, Engineers untersuchen unerklärliche Pipeline-Änderungen, und Führungskräfte verschieben Entscheidungen, während Teams Zahlen überprüfen. Kommerzielle Teams verlieren das Vertrauen in Datensätze, die ihr Handeln eigentlich leiten sollten.
IBM zitiert eine Gartner-Untersuchung, nach der Unternehmen durchschnittlich 12,9 Millionen USD pro Jahr durch schlechte Datenqualität verlieren, nachzulesen in IBMs Analyse der Kosten schlechter Datenqualität. Dieselbe Analyse nennt 43 % der Chief Operations Officers, die Datenqualitätsprobleme als ihre wichtigste Datenpriorität einstufen. Mehr als ein Viertel der Unternehmen schätzt die jährlichen Verluste auf über 5 Millionen USD, während 7 % Verluste von 25 Millionen USD oder mehr angeben.
Diese Zahlen beschreiben Risiken auf Konzernebene, doch der Mechanismus ist in Unternehmen jeder Größe bekannt. Ein fehlerhafter Datensatz erzeugt Nacharbeit. Nacharbeit bindet Kapazität, und fehlende Kapazität verzögert Initiativen, die Wert schaffen sollen. Teams können ihr Risiko auch mit diesem Kostenrechner für Data Downtime abschätzen.
Die Rechnung geht über die Behebung hinaus
Anomalos Executive Brief 2024 berichtet, dass 95 % der Führungskräfte ein Datenqualitätsproblem mit direkter Auswirkung auf Geschäftsergebnisse erlebt haben, laut dem State of Enterprise Data Quality Report. Die Auswirkungen können mehrere Formen annehmen:
Manueller Aufwand: Teams vergleichen Extrakte, reparieren Datensätze und erklären Abweichungen, statt Produkte oder Services zu verbessern.
Umsatzverluste: Falsche Kunden-, Produkt- oder Kontoinformationen können verhindern, dass das richtige Angebot, die richtige Rechnung oder die richtige Nachfassaktion die richtige Stelle erreicht.
Entscheidungsverzögerung: Führungskräfte warten auf die Abstimmung, bevor sie Maßnahmen, Launches oder Investitionen freigeben.
Bremse für die Transformation: Modernisierungsprogramme stocken, wenn alte Definitionen und neue Plattformen widersprüchliche Ergebnisse liefern.
Kontrollkosten: Compliance- und Audit-Teams verbringen mehr Zeit damit, Nachweise zusammenzustellen und Ausnahmen zu untersuchen.
Ein Bericht zum CRM-Datenmanagement 2025 ergab, dass 76 % der Unternehmen angaben, weniger als die Hälfte ihrer CRM-Daten sei korrekt und vollständig. Derselbe Bericht nennt 37 %, die schlechte Datenqualität als direkte Ursache für Umsatzverluste sehen, und 37 %, bei denen sie wichtige umsatzrelevante Initiativen verzögert hat, wie Validitys Mitteilung zum State of CRM Data Management 2025 berichtet.
Warum sich Kosten aufsummieren
Datendefekte bleiben selten in dem System, in dem sie entstehen. Eine fehlende Kennung kann einen Join zerstören, eine Kennzahl verzerren, eine Prognose verändern und eine Personal- oder Investitionsentscheidung beeinflussen. Jedes nachgelagerte Team führt dann womöglich seine eigene Korrektur durch und vervielfacht den ursprünglichen Aufwand.
Unabhängige Forschung, die in aktueller Literatur zitiert wird, nennt durchschnittliche Jahresverluste von rund 12,9 Millionen US-Dollar pro Unternehmen. Andere Studien schätzen, dass schlechte Daten in vielen Unternehmen 15 % bis 25 % des Umsatzes aufzehren – durch Nacharbeit, Fehlerkorrektur, entgangene Chancen und fehlerhafte Entscheidungen, wie in der veröffentlichten Forschung zu den Kosten von Datenqualität dargestellt.
Die Investitionsfrage ist deshalb weiter gefasst als die Kosten einer Qualitätsplattform. Unternehmen finanzieren zusätzlich wiederkehrende Korrekturarbeit, verzögerte Entscheidungen, Kontrollaktivitäten und Risiken, die entstehen, wenn Eigentümerschaft, Aktualität oder Schemaänderungen unbemerkt bleiben.
Wie schlechte Datenqualität Entscheidungen, Vertrauen und KI untergräbt
Ein Finanz-Dashboard zeigt steigende Umsätze, also genehmigt die Führung neue Einstellungen. Später stellt das Team fest, dass eine Quelltabelle verspätet eintraf und aktuelle Transaktionen ausließ. Auf dem Bildschirm sah nichts kaputt aus. Die Entscheidung beruhte dennoch auf unvollständigen Belegen.
Ein Bericht kann normal aussehen, während sich seine Bedeutung geändert hat. Ein umbenanntes Feld, ein geändertes Schema oder eine überarbeitete Geschäftsdefinition kann die Pipeline ohne erkennbaren Fehler durchlaufen. Das Ergebnis ist gefährlicher als ein leerer Bericht, weil vertraute Zahlen zum Handeln verleiten, bevor jemand nachprüft.
Anschließend schwindet das Vertrauen im gesamten Unternehmen. Führungskräfte hinterfragen offizielle Kennzahlen, Analystinnen und Analysten verteidigen Zahlen, die sie nicht erstellt haben, und Teams pflegen eigene Tabellen oder mündliche Erklärungen, um Lücken zu füllen. Datenqualität ist damit zu einer Frage der Unternehmenssteuerung geworden, nicht bloß zu einem Dashboard-Thema.
Stille Fehler beschädigen Vertrauen
Mehrere Fehlerpfade verdienen Aufmerksamkeit:
Veraltete Daten lassen aktuelle Verhältnisse historisch erscheinen.
Schema-Drift verändert Felder, Typen oder Strukturen, die nachgelagerte Nutzer falsch interpretieren können.
Unvollständige Lieferung entfernt einen Teil einer Grundgesamtheit oder eines Berichtszeitraums aus einer Kennzahl.
Unbemerkte Verteilungsverschiebungen führen dazu, dass sich Daten anders verhalten als die Baseline, die ein Bericht oder Modell nutzt.
Uneinheitliche Definitionen lassen zwei glaubwürdige Teams unterschiedliche Antworten auf dieselbe geschäftliche Frage geben.
Forschung und Fachliteratur verbinden schlechte Daten mit geringerer Entscheidungsgenauigkeit, weniger Vertrauen in Berichte und langsameren Reaktionen. Eine umfragebasierte Quelle nennt Datenqualität als zweithäufigste Hürde auf dem Weg zu Wert aus Daten und Analytik. Eine andere berichtet, dass 91 % der Führungskräfte angaben, Investitionen in Datenqualität hätten das Geschäftswachstum positiv beeinflusst, zusammengefasst in O’Reillys Diskussion zur Datenqualität.
Diese Fehler erzeugen außerdem Kontrolllücken. Wenn niemand eine Definition verantwortet, die Aktualität überwacht oder Schemaänderungen prüft, kann das Unternehmen womöglich nicht erklären, warum sich eine Zahl geändert hat, oder belegen, welche Daten eine Entscheidung gestützt haben.
KI erhöht den Maßstab
KI-Systeme nutzen Daten in hoher Geschwindigkeit und Menge erneut. Ein Modell lernt vielleicht aus unvollständigen Datensätzen, ein Agent fragt eine umbenannte Spalte ab, und ein automatisierter Workflow handelt auf Basis eines veralteten Status. Die Ausgabe kann souverän klingen, während ihre Grundlage falsch ist. Eine praxisnahe Erklärung dieser Abhängigkeit finden Sie unter warum KI-Modelle von der Datenqualität abhängen.
ISO/IEC 5259-5:2025 beschreibt Datenqualitäts-Governance als organisatorischen Rahmen über den gesamten Datenlebenszyklus für Analytik und maschinelles Lernen, wie in der Übersicht zur Norm ISO/IEC 5259-5:2025 dargestellt. Die Frage für die Führungsebene reicht damit über die Richtigkeit von Dashboards hinaus: Wer hat die Daten verantwortet, welche Kontrollen galten, und blieben sie für Training, Inferenz und regulatorische Nachweise geeignet?
Governance-Erkenntnis: KI-Risiko beginnt weiter oben – dort, wo Teams die Daten definieren, erheben, transformieren, beschreiben und freigeben, die ein automatisiertes System nutzen wird.
Qualität wirkt als Steuerungsebene, die operative Richtigkeit, Entscheidungsvertrauen, Compliance-Nachweise und KI-Verantwortung verbindet. Wer nur Modellausgaben oder die Verfügbarkeit von Dashboards überwacht, beobachtet die letzte Stufe, nachdem frühere Fehler möglicherweise längst unbemerkt passiert sind.
Wie Unternehmen verlässliche Datenqualität und Observability aufbauen
Reaktive Bereinigung und proaktive Observability lösen unterschiedliche Probleme. Bereinigung repariert bekannte Defekte, nachdem sie einen Konsumenten erreicht haben. Observability hilft Teams zu verstehen, was sich geändert hat, wann es sich geändert hat, welche Assets betroffen sind und ob das Verhalten von einer erwarteten Baseline abweicht.
Ein tragfähiges Programm nutzt beides, verlagert Prävention und Früherkennung jedoch näher an die Quelle. Ziel ist nicht, endlose Regeln zu schaffen. Ziel ist, wichtige Erwartungen explizit zu machen, sie fortlaufend zu überwachen und Fehler an die Menschen zu leiten, die sie beheben können.
Mit Verantwortung und Zweck beginnen
Bestimmen Sie für jede kritische Datendomäne eine verantwortliche Person. Sie sollte gemeinsam mit Data Engineers, Analystinnen und Analysten, Risikoteams und operativen Nutzern festlegen, welche Qualität für die abhängigen Prozesse akzeptabel ist.
Ein nützlicher Verantwortungsnachweis umfasst:
Geschäftlicher Zweck: Welche Entscheidung, Kundeninteraktion, Kontrolle oder welches Modell nutzt den Datensatz?
Qualitätserwartungen: Welche Felder müssen vollständig, valide, konsistent, eindeutig, genau oder aktuell sein?
Auswirkungsgrad: Was passiert, wenn der Datensatz falsch oder verspätet ist?
Reaktionsweg: Wer untersucht, wer genehmigt eine Übergangslösung, und wer bestätigt die Behebung?
Nachweise: Welche Prüfungen, Lineage-Angaben und Vorfallsaufzeichnungen belegen die Kontrolle?
Ohne Verantwortlichkeit wird Monitoring zum Benachrichtigungsdienst. Alarme treffen ein, aber niemand hat Befugnis oder Kontext, um zu entscheiden, ob das Problem relevant ist.
Reaktive Bereinigung mit kontinuierlicher Kontrolle vergleichen
Reaktive Bereinigung | Proaktive Qualität und Observability |
|---|---|
Findet Defekte, nachdem ein Bericht oder eine Person sie bemerkt hat | Erkennt ungewöhnliches Verhalten vor der nachgelagerten Nutzung |
Konzentriert sich auf einzelne Datensätze oder bekannte Regeln | Verbindet Validierung mit Signalen zu Aktualität, Volumen, Lineage und Schema |
Repariert Symptome weiter unten | Hilft Teams, Probleme an der Quelle zu beheben |
Erzeugt einmalige Erklärungen | Baut wiederholbare Nachweise für Governance und Audit auf |
Misst Vorfälle nach der Störung | Verfolgt Muster und Verschlechterung über die Zeit |
Kontinuierliche Prüfungen sollten Geschäftsregeln auf Datensatzebene, Lieferzeitpunkte, Volumenverhalten und strukturelle Änderungen abdecken. Eine Ausführung in der Datenbank kann die Daten zudem in der Umgebung des Kunden belassen, während Metriken und Analysen dort laufen, wo die Daten ohnehin liegen.
Observability als gemeinsame Betriebsebene nutzen
digna bietet eine modulare Plattform für Datenqualität und Observability, die in der eigenen Umgebung des Kunden läuft. Zu den Funktionen zählen Anomalieerkennung, historische Metrikanalyse, Timeliness-Überwachung, Validierung auf Datensatzebene, Nachverfolgung von Schemaänderungen, Ausführung in der Datenbank, Private- oder On-Premises-Betrieb sowie ein gemeinsames Dashboard für Data Engineers, Analystinnen und Analysten sowie Stakeholder. Teams können mehr über Data Observability als operative Disziplin erfahren und dann prüfen, welche Kontrollen zu ihrer Architektur und ihrem Risikoprofil passen.
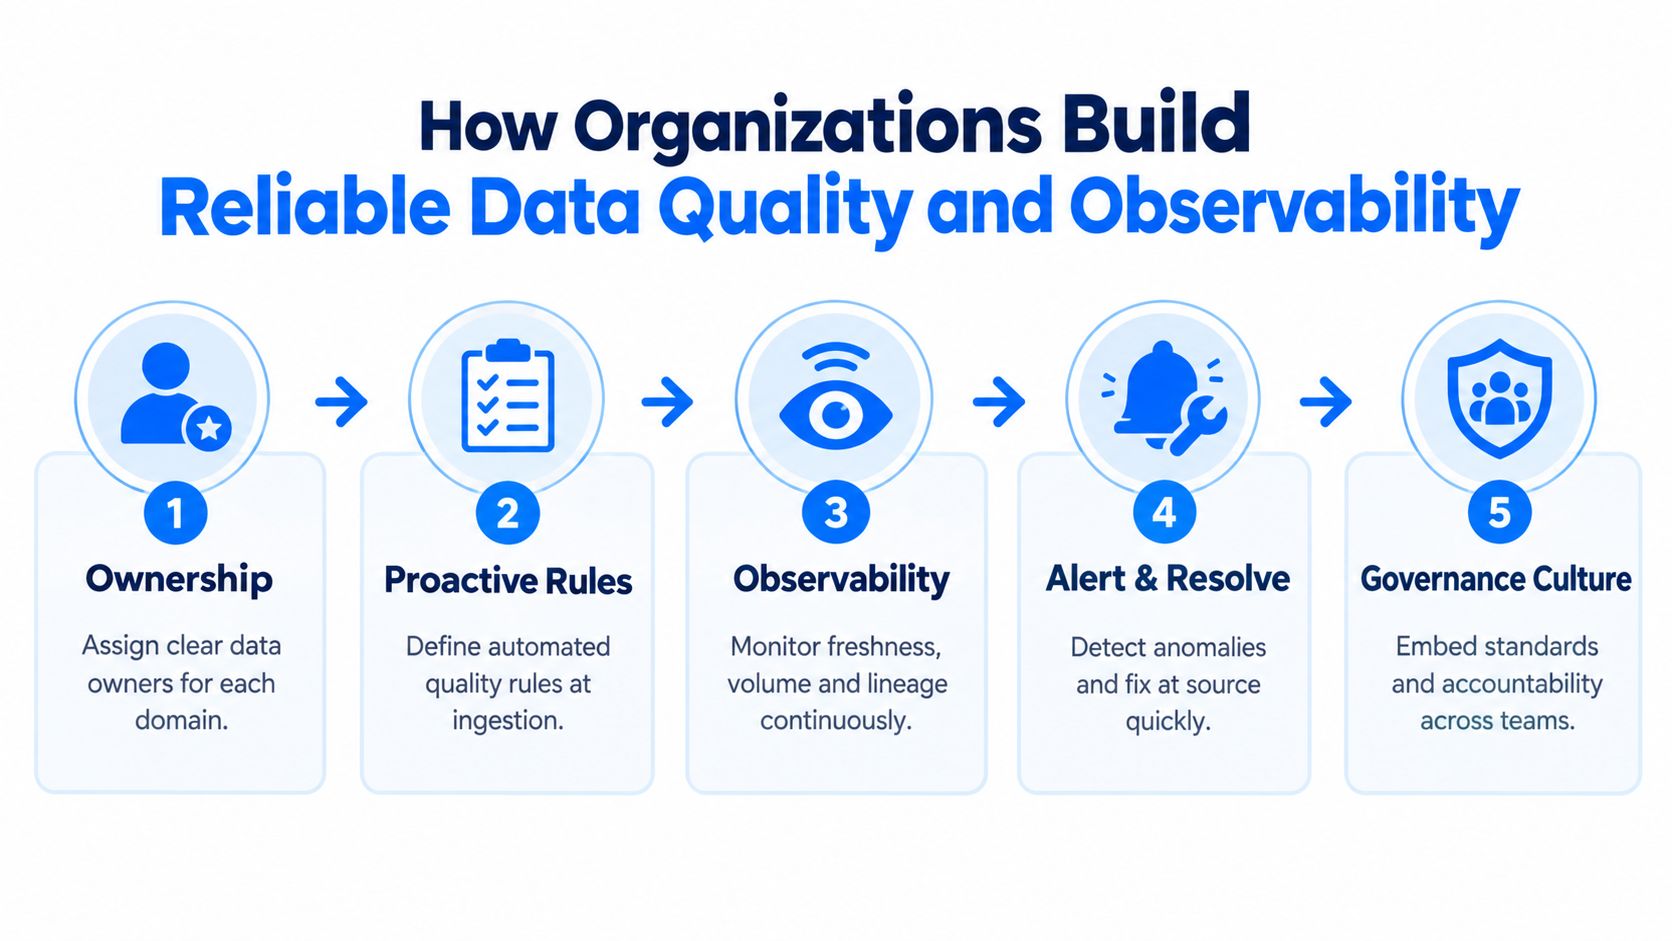
Die Plattform ist nur ein Teil des Programms. Führungskräfte brauchen weiterhin klare Definitionen, Reaktionsvereinbarungen und Anreize, die Prävention belohnen statt stiller Reparatur weiter unten. Observability schafft Sichtbarkeit. Governance schafft Befugnis und Verantwortung.
Praxisbeispiele für die Wirkung von Datenqualität in verschiedenen Branchen
Dieselben Qualitätsdimensionen erzeugen je nach Branche unterschiedliche Risiken. Ein verspäteter Transaktionsfeed kann im Finanzwesen die Risikoberichterstattung beeinträchtigen, während ein fehlender klinischer Wert im Gesundheitswesen die Versorgungskoordination stört. Das Kontrollmuster bleibt erkennbar, doch geschäftliche Folge und erforderliche Nachweise ändern sich.
Finanzdienstleistungen
Eine Bank hängt womöglich von Transaktions-, Kunden-, Risiko- und Regulierungsdaten ab, die mehrere Plattformen durchlaufen. Ändert eine Schemaänderung einen Feldtyp oder trifft ein Feed zu spät ein, gleichen Berichtsteams Zahlen manuell ab, während Risikoteams hinterfragen, ob sie dieselbe Grundgesamtheit verwenden. Qualitätskontrollen müssen Geschäftsregeln validieren, Lieferungen verfolgen, ungewöhnliche Muster erkennen und Nachweise sichern, die zeigen, was sich geändert hat und wie das Unternehmen reagiert hat.
Gesundheitswesen
Organisationen im Gesundheitswesen kombinieren klinische, administrative, abrechnungsbezogene und operative Datensätze. Uneinheitliche Kennungen können zusammengehörige Ereignisse trennen, während unvollständige oder verspätete Informationen es erschweren, eine Patientin, einen Patienten oder eine Leistungsepisode zu verstehen. Hier stützen Vollständigkeit und Konsistenz eine sichere Koordination, während Aktualität und Nachvollziehbarkeit operative und regulatorische Prozesse tragen.
Telekommunikation
Telekommunikationsteams arbeiten mit großen Mengen an Kunden-, Netz-, Abrechnungs- und Nutzungsdaten. Eine plötzliche Änderung des Datensatzvolumens kann auf ein Pipeline-Problem, eine Änderung im Quellsystem oder eine echte Verschiebung der Aktivität hindeuten. Die Überwachung erwarteter Lieferungen, ungewöhnlichen Verhaltens und struktureller Änderungen hilft Teams, geschäftliche Bewegung von Datenfehlern zu unterscheiden, bevor Berichte oder operative Workflows falsch reagieren.
Öffentlicher Sektor
Organisationen im öffentlichen Sektor müssen oft Datensätze über Abteilungen hinweg zusammenführen und dabei Prüfbarkeit und einheitliche Definitionen bewahren. Eine Lücke in der Lineage kann es schwer machen zu erklären, wie eine Zahl zustande kam. Validierung, Verantwortlichkeit und Nachweise zählen, weil Entscheidungsträger nicht nur das Ergebnis, sondern auch den Weg dorthin begründen müssen.
Branchenprinzip: Die richtige Qualitätskontrolle ist die, die an eine reale Entscheidung, Pflicht oder Serviceleistung gebunden ist.
Diese Beispiele zeigen auch, warum ein einzelner unternehmensweiter Score selten die ganze Geschichte erzählt. Ein Datensatz kann für eine grobe Trendanalyse tauglich und für eine regulatorische Berechnung ungeeignet sein. Qualitätsprogramme sollten Daten deshalb nach Nutzung, Risiko und erforderlicher Reaktion einordnen, statt einen universellen Schwellenwert anzuwenden.
Eine dauerhafte Haltung zur Datenqualität aufbauen
Ein dauerhaftes Datenqualitätsprogramm ruht auf drei Gewohnheiten: Verantwortung, kontinuierliche Sichtbarkeit und geschäftliche Rechenschaft.
Verantwortung heißt, dass jeder kritische Datensatz eine benannte Person oder ein benanntes Team hat, das für Definition, akzeptablen Zustand und Lösungsweg zuständig ist. Diese Zuständigkeit darf nicht verschwinden, wenn Daten aus einem operativen System in ein Warehouse, einen Lake, ein Dashboard, ein Modell oder einen KI-Workflow wandern.
Kontinuierliche Sichtbarkeit heißt, dass Teams mehr überwachen als Bestanden-oder-nicht-Regeln. Sie beobachten Aktualität, Volumen, Vollständigkeit, Validität, ungewöhnliches Verhalten und strukturelle Veränderungen. Außerdem bewahren sie genug Lineage und Vorfallskontext, um zu erklären, welche Konsumenten betroffen sein könnten.
Geschäftliche Rechenschaft heißt, dass Qualitätsmaße mit Ergebnissen verknüpft sind. Statt nur zu melden, dass eine Prüfung fehlgeschlagen ist, sollten Teams erklären, ob der Fehler einen Kundenprozess, eine Finanzkontrolle, eine regulatorische Meldung, eine Prognose oder einen KI-Anwendungsfall gefährdet.
Eine praktische Startliste sieht so aus:
Kritische Assets wählen: Identifizieren Sie die Datensätze, die wichtige Entscheidungen und Pflichten stützen.
Eignung definieren: Einigen Sie sich darauf, was genau, vollständig, konsistent, valide, eindeutig und aktuell für den jeweiligen Zweck bedeuten.
Reaktion zuweisen: Legen Sie fest, wer Alarme erhält und wer Probleme an der Quelle beheben darf.
Kontinuierlich überwachen: Erkennen Sie Verschlechterung, bevor sie Berichte, Modelle oder automatisierte Aktionen erreicht.
Nutzen prüfen: Verfolgen Sie weniger Nacharbeit, schnellere Problemlösung, bessere Nachweise und mehr Vertrauen in die Analytik.
Die zentrale Lehre ist einfach. Datenqualität ist kein letzter Schliff vor dem Reporting. Sie ist die Kontrollebene, die einem Unternehmen hilft, verantwortlich zu entscheiden, Compliance zu belegen und KI zu nutzen, ohne das Urteil unzuverlässigen Eingaben zu überlassen.
digna hilft Unternehmen, Datenverhalten zu überwachen, Datensätze zu validieren, Timeliness zu verfolgen, Schemaänderungen zu erkennen sowie Geschäfts- und Plattformmetriken in der eigenen Umgebung zu beobachten. Besuchen Sie digna, um zu sehen, wie die modulare Plattform für Datenqualität und Observability eine verlässlichere Grundlage für Analytik und KI schaffen kann.
Für das Betriebsmodell, das diese Erwartungen in kontinuierliche Kontrollen statt periodischer Bereinigungen überführt, siehe Datenqualitätsmanagement.
Häufig gestellte Fragen
Was kostet schlechte Datenqualität ein Unternehmen?
IBM zitiert Gartner mit einem durchschnittlichen Verlust von 12,9 Millionen USD pro Jahr. Mehr als ein Viertel der Unternehmen schätzt die jährlichen Verluste auf über 5 Millionen USD, 7 % nennen 25 Millionen USD oder mehr, und 43 % der Chief Operations Officers stufen Datenqualität als ihre größte Datenpriorität ein.
Warum richten kleine Defekte so großen Schaden an?
Weil sie wandern. Ein fehlendes Feld, ein veralteter Extrakt, eine uneinheitliche Definition oder eine unbemerkte Schemaänderung erreicht Prognosen, regulatorische Berichte, Kundenprozesse und KI-Systeme, bevor jemand den Bezug zur Quelle herstellt. Der sichtbare Verlust ist Nacharbeit; der größere sind angehäufte Reibung und verzögerte Entscheidungen.
Ist Datenqualität dasselbe wie Data Observability?
Sie beantworten verschiedene Fragen. Bereinigung repariert bekannte Defekte, nachdem ein Konsument sie gesehen hat, während Observability erklärt, was sich wann geändert hat, welche Assets betroffen sind und ob das Verhalten von einer erwarteten Baseline abweicht. Ein tragfähiges Programm nutzt beides, verlagert Prävention und Erkennung aber näher an die Quelle.
Womit sollte ein Unternehmen anfangen?
Mit Verantwortung, nicht mit Regeln. Bestimmen Sie für jede kritische Datendomäne eine verantwortliche Stelle und halten Sie dann den geschäftlichen Zweck fest, die Qualitätserwartungen je Feld, den Auswirkungsgrad bei falschen oder verspäteten Daten sowie den Reaktionsweg mit Zuständigkeiten für Untersuchung, Übergangslösung und Bestätigung der Behebung.
Unterscheidet sich das Risiko je nach Branche?
Die Qualitätsdimensionen bleiben gleich, die Folgen nicht. Im Finanzwesen erzwingt ein verspäteter Feed oder ein geänderter Feldtyp manuelle Abstimmung in der Risikoberichterstattung. Im Gesundheitswesen trennen uneinheitliche Kennungen zusammengehörige Ereignisse und verzögern die Versorgungskoordination. Welche Nachweise nötig sind, bestimmt die Aufsicht, nicht die Pipeline.



