TSQL-Abfrageoptimierung: Ein praktischer Leitfaden zur Leistungssteigerung
|
7
min. Lesezeit

Eine langsame SQL Server-Abfrage zeigt sich normalerweise nicht mit einer einfachen Erklärung. Sie landet in der Produktion als Dashboard mit Timeout, als gespeicherte Prozedur, die früher einwandfrei lief, oder als Bericht, der nur fehlschlägt, wenn der richtige Kunde oder Datumsbereich getroffen wird. Deshalb funktioniert die tsql query optimization am besten, wenn sie mit Beweisen beginnt, nicht mit einer Neuschreibung.
Inhaltsverzeichnis
Ausführungspläne lesen und das Verhalten des Optimizers verstehen
Umschreiben von Abfragen mit mengenbasierten Mustern und früher Filterung
Herausforderungen beim Parameter Sniffing und beim Erzwingen von Plänen lösen
Umgang mit Speicherengpässen und Plattform-Ressourcenbeschränkungen
Implementierung kontinuierlicher Überwachung mit In-Database Observability
Mit der Diagnose beginnen, bevor man irgendetwas umschreibt
Der schnellste Weg, Zeit zu verschwenden, besteht darin, das SQL zu ändern, bevor man weiß, was langsam ist. In der Produktion kann eine Abfrage schuldig aussehen, obwohl das Problem an gemeinsam genutzten Konflikten (Contention), veralteten Statistiken oder einem schlechten Plan liegt, der mit einem anderen Parameterwert im Cache abgelegt wurde. Ein disziplinierter Optimierungsprozess beginnt mit der Erfassung des genauen Workloads, einschließlich der tatsächlichen Parameter, und der Messung der Abfrage, bevor sich irgendetwas ändert.
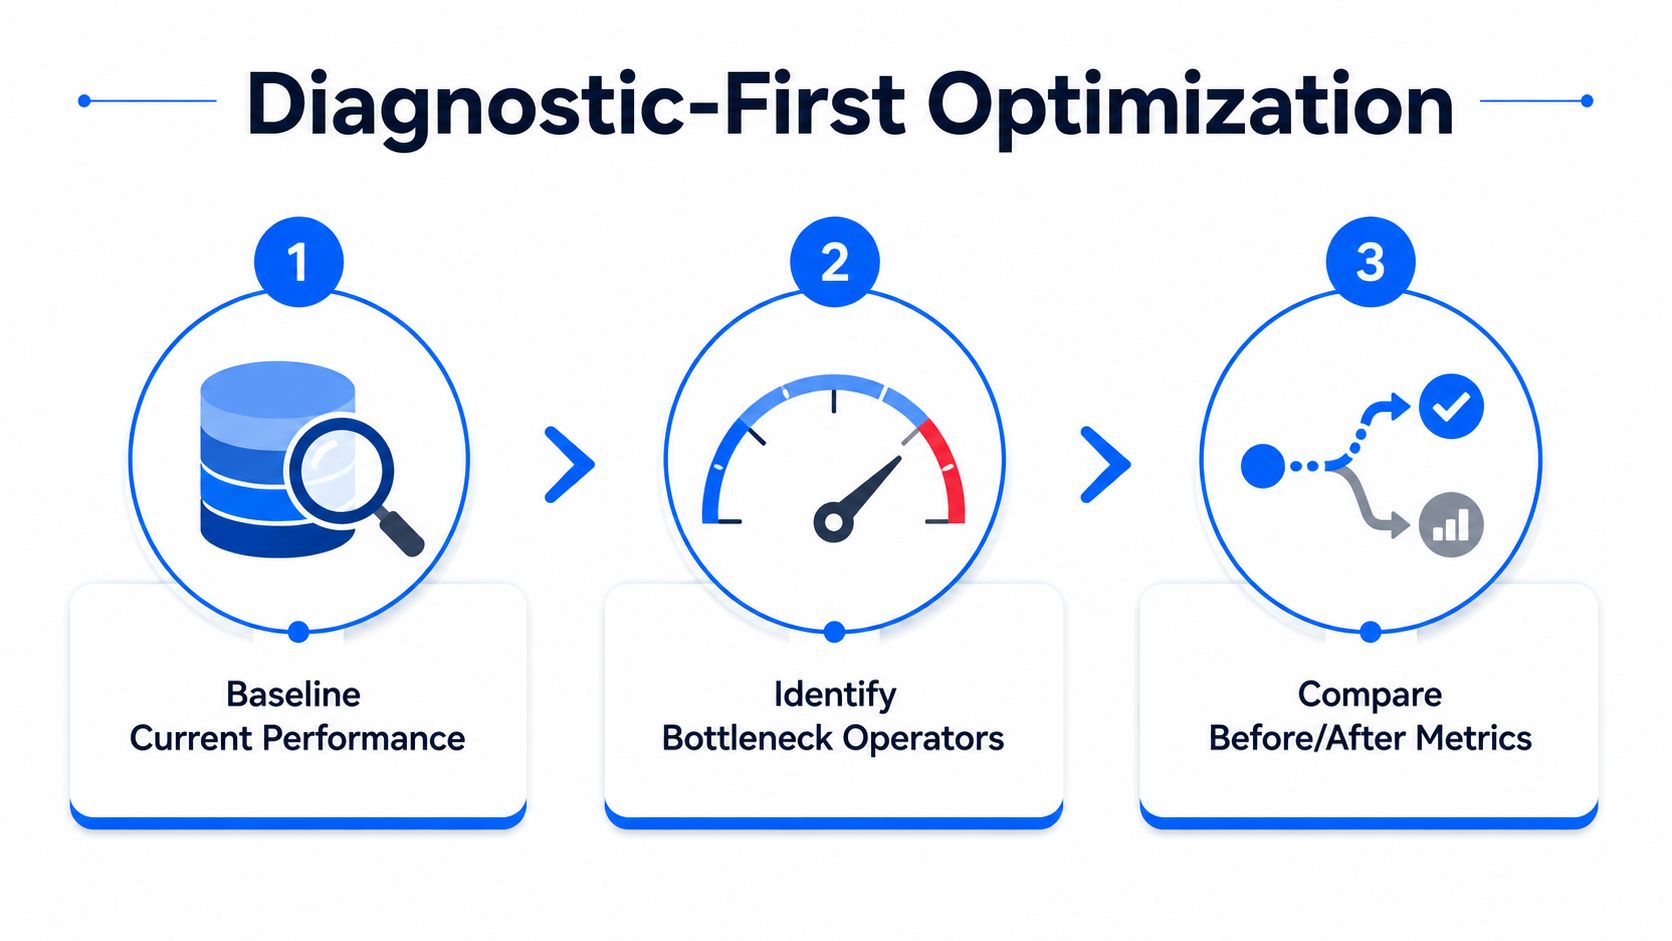
Zuerst eine Baseline erstellen, dann das SQL anpassen
Die Baseline ist nicht optional. Ein praktischer Tuning-Kreislauf beginnt mit der Ausführungszeit, den logischen Lesevorgängen und der CPU, erfasst dann den Plan und den umgebenden Workload, damit Sie feststellen können, ob eine Änderung geholfen oder die Kosten nur an eine andere Stelle verlagert hat. Dies ist derselbe Arbeitsablauf, der in SQL Server-Tuning-Handbüchern empfohlen wird, da er Ursache und Wirkung sichtbar hält (tuning workflow guidance).
Praktische Regel: Wenn Sie den Engpass-Operator vor dem Umschreiben nicht erklären können, verstehen Sie das Problem wahrscheinlich noch nicht.
Das gilt besonders dann, wenn das Symptom eine langsame Antwortzeit ist, die Ursache jedoch außerhalb des Anweisungstextes liegt. Eine Analyse der Wartezustände auf Serverebene, die Korrelation von Warteschlangen und anschließend die Überprüfung auf Datenbank- oder Abfrageebene ist die Reihenfolge, mit der vermieden wird, das Falsche zu jagen. Denn der Workload kann durch E/A-, Speicher- oder Parallelitätsengpässe blockiert sein, bevor er überhaupt Ihren Kandidaten für das Umschreiben erreicht (instance-to-query tuning sequence).
Immer nur eine Sache auf einmal ändern
Das Tuning mit jeweils nur einer Variablen klingt langsam, ist aber der einzige Weg, dem Ergebnis zu vertrauen. Wenn Sie im selben Durchgang den Abfragetext, den Index und die Aktualisierung der Statistiken ändern, wissen Sie nicht, welcher Hebel entscheidend war. Schlimmer noch: Ein Umschreiben kann die logischen Lesevorgänge verbessern, während es die CPU erhöht oder den Plan unter einem anderen Parametersatz anfälliger macht.
Ein guter Arbeitsablauf sieht so aus:
Erfassen Sie den genauen Abfragetext und die Parameter. Dieselbe gespeicherte Prozedur kann sich bei unterschiedlichen Eingaben sehr verschieden verhalten.
Finden Sie den Engpass-Operator. Sortierungen, Scans und Key-Lookups sind oft die Stellen, an denen sich die Kosten summieren.
Wenden Sie eine gezielte Änderung an. Führen Sie dann denselben Workload unter denselben Bedingungen erneut aus.
Vergleichen Sie mit der Baseline. Überprüfen Sie Lesevorgänge, CPU und verstrichene Zeit erneut, bevor Sie fortfahren.
Diese Methode klingt einfach, weil sie es ist. Der schwierige Teil besteht darin, dem Drang zu widerstehen, alles auf einmal zu „beheben“. Wenn die Abfrage wirklich unter gemeinsam genutzten Ressourcenkonflikten leidet, liegt die erste sinnvolle Behebung möglicherweise außerhalb der Abfrage selbst. Erfahrene DBAs betrachten den SQL-Text daher nicht als den einzigen Ort, an dem man suchen muss.
Ausführungspläne lesen und das Verhalten des Optimizers verstehen
Eine schlechte Abfrage sieht im Texteditor oft gut aus und bricht zur Laufzeit dennoch in sich zusammen. SQL Server führt Anweisungen nicht in der Reihenfolge aus, in der sie geschrieben sind. Der Optimizer arbeitet kostenbasiert und statistikgesteuert. Er bewertet also mögliche Pläne, schätzt Zeilenanzahlen und wählt den Pfad, von dem er glaubt, dass er am wenigsten kostet (cost-based optimizer overview). Bei der tsql query optimization macht dies das Lesen von Plänen zur ersten echten Diagnosekompetenz und nicht zu einem nachträglichen Gedanken.
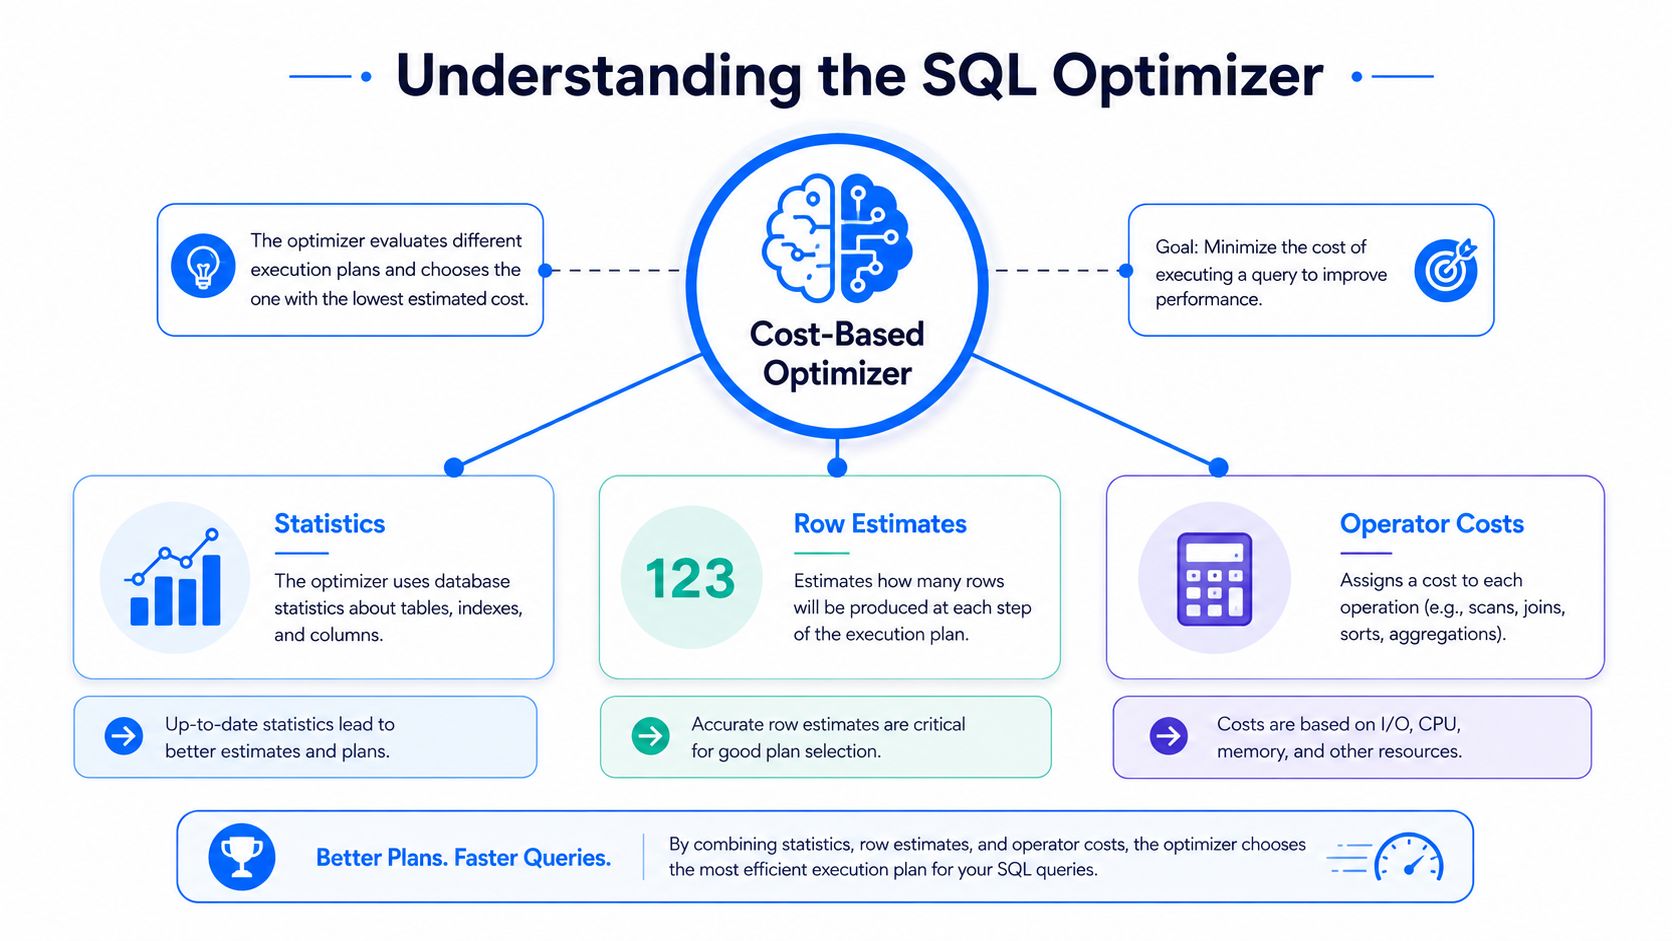
Den Plan von den Blättern (Leaves) nach oben lesen
Beginnen Sie bei den Blättern (Leaves), nicht an der Wurzel. Die Blatt-Operatoren zeigen, wo Zeilen in den Plan eintreten, und das teuerste Blatt – oft dasjenige mit den höchsten Kosten aus Schleifen mal Zeit – weist in der Regel auf die erste Stelle hin, an der der Plan schiefgeht. Wenn ein Scan in einen Join und dann in eine Sortierung einfließt, ist der Scan oft das Hauptproblem, selbst wenn die Sortierung die verstrichene Zeit dominiert.
Diese Gewohnheit beim Lesen wird noch nützlicher, wenn Sie sie mit den Eingaben des Optimizers verknüpfen. DBCC SHOW_STATISTICS zeigt die Statistiken an, die SQL Server für eine Tabelle oder eine indizierte Sicht verwendet, einschließlich STAT_HEADER, DENSITY_VECTOR und HISTOGRAM (Microsoft documentation). Diese Objekte sind wichtig, da der Optimizer seine Kardinalitätsschätzung vornimmt, bevor er sich für einen Plan entscheidet. Die Dichteinformationen sind besonders nützlich für Spaltenfilter auf derselben Tabelle, bei denen eine einfache Intuition bezüglich der Zeilenanzahl oft versagt.
Wenn der Plan verdächtig aussieht, vergleiche ich ihn mit einer praktischen Tuning-Checkliste wie how to optimize SQL queries with execution plan analysis. Diese Art von Schritt sorgt dafür, dass die Überprüfung auf den tatsächlichen Operatoren basiert und nicht nur auf Vermutungen über den Abfragetext.
Geschätzte Zeilen versus tatsächliche Zeilen
Das Erste, was ich bei einem schlechten Plan überprüfe, ist die Lücke zwischen geschätzten und tatsächlichen Zeilen. Wenn diese Zahlen stark voneinander abweichen, arbeitet der Optimizer mit einem verzerrten Bild, und der Rest des Plans baut meist auf diesem Fehler auf. Eine VLDB-Arbeit aus dem Jahr 2025 stellte fest, dass Fehler bei der Kardinalitätsschätzung weit verbreitet und oft der dominierende Faktor für schlechte Pläne sind (VLDB 2025 paper). Dies deckt sich mit dem, was in der Produktion zu sehen ist, wenn schiefe Verteilungen oder korrelierte Prädikate die Engine zum falschen Join oder zur falschen Zugriffsmethode drängen.
Wenn der Optimizer denkt, dass 10 Zeilen kommen, und tatsächlich 10.000 ankommen, liegt der Plan nicht nur leicht daneben, er löst das falsche Problem.
Das ist auch der Grund, warum veraltete Statistiken frühzeitig Aufmerksamkeit verdienen. Frische Statistiken garantieren keinen perfekten Plan, aber veraltete machen eine schlechte Schätzung viel wahrscheinlicher. Für speicheroptimierte Tabellen stellt Microsoft fest, dass der Optimizer weiterhin Statistiken für Indexschlüsselspalten pflegt und bei Bedarf zusätzliche Statistiken für Nicht-Schlüsselspalten erstellen kann, sodass diese Workloads immer noch vom selben Kardinalitätsbild abhängen.
Umschreiben von Abfragen mit mengenbasierten Mustern und früher Filterung
Sobald der Engpass real und sichtbar ist, schreiben Sie das SQL mit einem klaren Ziel um. Die wertvollsten Änderungen sind in der Regel diejenigen, die die Datenmenge reduzieren, die die Engine berühren muss, und nicht diejenigen, die die Abfrage besonders clever aussehen lassen. Frühes Filtern, das Projizieren weniger Spalten und das SARG-fähig Halten von Prädikaten helfen dem Optimizer, Indizes effektiver zu nutzen, und senken den E/A- und Speicherbedarf (optimization techniques guide).
Sorgen Sie dafür, dass die Engine weniger Daten berührt
Die einfachsten Erfolge sind oft die, die Teams überspringen, weil sie ihnen zu simpel erscheinen. Vermeiden Sie SELECT *, wenn die Abfrage nicht jede Spalte benötigt, da zusätzliche projizierte Spalten die Zeilen verbreitern und die E/A erhöhen. Setzen Sie selektive Filter in der WHERE-Klausel nach Möglichkeit vor Joins ein, da dies das Join-Volumen verringert, das die Engine durch den Rest des Plans tragen muss.
Einige Muster sind durchgehend von Bedeutung:
Verwenden Sie SARG-fähige (sargable) Prädikate. Wenn das Prädikat nicht effizient mit einem Index abgeglichen werden kann, hat der Optimizer weniger Spielraum.
Bevorzugen Sie
UNION ALL, wenn Duplikate nicht entfernt werden müssen.UNIONverursacht zusätzliche Sortier- oder Deduplizierungsarbeiten.Kürzen Sie Unterabfragen, die Daten nur neu formatieren. Verschachtelte Logik, die keine Zeilen reduziert, verursacht oft Overhead, ohne dem Plan zu helfen.
Stimmen Sie Indizes auf reale Filter ab. Ein gezielter Index hilft, wenn er auf den von der Abfrage genutzten Zugriffspfad ausgerichtet ist.
Ein gutes Umschreiben reduziert die Arbeit, die der Optimizer berücksichtigen muss, nicht nur die Zeilen an SQL, die Sie lesen mussten.
Zeilenziele (Row Goals) und Hinweise (Hints) mit Zurückhaltung einsetzen
Microsoft dokumentiert Abfragehinweise (Query Hints), die das Ausführungsverhalten ändern können, einschließlich des Verhaltens von Zeilenzielen (Row Goals). Hierbei läuft die Abfrage nach der Rückgabe der ersten angegebenen Anzahl von Zeilen weiter, um die vollständige Ergebnismenge zu erzeugen (query hints documentation). Dies kann nützlich sein, wenn eine schnelle anfängliche Ausgabe wichtiger ist als der Gesamtdurchsatz, aber es verändert die Abwägung des Optimizers. Ein Plan, der für eine winzige Ergebnismenge großartig ist, kann für eine große Menge eine schlechte Wahl sein.
Deshalb betrachte ich Hints als Korrektur für die letzte Meile, nicht als erste Reaktion. Wenn sich die Abfrage nach früher Filterung und mengenbereinigtem Aufräumen immer noch hinzieht, ist die nächste Frage meist, ob der Zugriffspfad gegen die Datenform oder die dahinterstehenden Statistiken ankämpft.
Indexdesign und Strategien zur Pflege von Statistiken
Indizes sind keine magischen Leistungsschalter. Sie sind Eingaben für das Kostenmodell des Optimizers und helfen nur, wenn sie zum Abfragemuster und zur Datenverteilung passen. Wenn der Zugriffspfad nicht dazu passt, wie die Abfrage filtert, verknüpft oder Spalten projiziert, kann die Engine dennoch einen Scan, einen Plan mit vielen Lookups oder eine zu Spills neigende Sortierung wählen.
Entwickeln Sie für die Abfrage, die Sie tatsächlich ausführen
Der beste Index in der Theorie und der beste Index in der Praxis sind selten dasselbe. In der Realität möchten Sie Indizes, die zu den teuersten und am häufigsten wiederholten Zugriffsmustern passen, insbesondere zu den Filtern, die in Ihren langsamsten Abfragen vorkommen. Ein abdeckender Index (Covering Index) kann Key-Lookups überflüssig machen, wenn die Abfrage einen kleinen, stabilen Satz von Spalten benötigt. Er kann jedoch auch Schreib-Overhead und Speicherkosten verursachen, weshalb das Design auf einem realen Workload basieren muss, nicht auf einer Vermutung.
Das Statistikmodell von Microsoft ist hier wichtig, da der Optimizer die Kardinalität anhand dieser Objekte schätzt, bevor er einen Plan auswählt (DBCC SHOW_STATISTICS). Wenn die Statistiken veraltet sind, kann selbst ein gut erstellter Index ignoriert oder falsch verwendet werden. Deshalb gehören gutes Indexdesign und eine gute Pflege der Statistiken zusammen.
Statistiken aktuell genug halten, um ihnen zu vertrauen
Die Pflege von Statistiken ist keine reine Routineaufgabe, sie ist Teil der Planqualität. Wenn sich Zeilenverteilungen verschieben, denkt der Optimizer möglicherweise immer noch, die Tabelle sehe so aus wie gestern oder letzten Monat. Dieses veraltete Bild kann zu schlechten Join-Entscheidungen, ungeeigneten Zugriffsmethoden und unerwarteter Speichernutzung führen. Für speicheroptimierte Tabellen pflegt Microsoft weiterhin Statistiken für Indexschlüsselspalten und fügt bei Bedarf weitere für Nicht-Schlüsselspalten hinzu. Dies zeigt, wie zentral Statistiken über verschiedene Speichermodelle hinweg bleiben.
Eine praktische Wartungsstrategie ist einfach:
Aktualisieren Sie Statistiken, wenn Pläne degradieren. Warten Sie nicht, bis das Problem systematisch wird.
Achten Sie auf wiederkehrende Key-Lookup-Muster. Sie zeigen oft, wo ein abdeckender Index helfen würde.
Nutzen Sie Rebuilds und Reorganisationen gezielt. Wartung sollte den Workload unterstützen und nicht blind nach Plan ablaufen.
Überprüfen Sie die Indexnutzung regelmäßig. Ein Index, der vor sechs Monaten sinnvoll aussah, kann heute Ballast sein.
Vorschläge für fehlende Indizes können Ihnen helfen, offensichtliche Lücken zu finden, sind aber für sich genommen keine Designstrategie. Ich betrachte sie als Hinweise und vergleiche sie dann mit dem Workload und den Wartungskosten. Der Optimizer kann nur aus den Formen wählen, die Sie ihm zur Verfügung stellen, und veraltete Statistiken können selbst eine gute Form schlecht aussehen lassen.
Solving Parameter Sniffing and Plan Forcing Challenges
Einige der schlimmsten Überraschungen in der Produktion haben überhaupt nichts mit dem Abfragetext zu tun. Sie entstehen, weil dieselbe gespeicherte Prozedur je nach dem ersten Parameterwert, den der Optimizer sieht, sehr unterschiedliche Pläne erhält. Dieser Plan wird dann für spätere Aufrufe wiederverwendet, die nicht der ursprünglichen Form entsprechen. Deshalb gehört das parameter-sensitive plan behavior ganz nach oben in jedem seriösen Leitfaden zur tsql query optimization.
Wenn der zwischengespeicherte Plan das Problem ist
Die Azure SQL-Richtlinien von Microsoft weisen ausdrücklich auf RECOMPILE, OPTIMIZE FOR, OPTIMIZE FOR UNKNOWN, das Erzwingen von Plänen (Plan Forcing) und das Aufteilen von Prozeduren als gezielte Abhilfemaßnahmen hin, wenn eine Abfrage bei einigen Parameterwerten gut und bei anderen schlecht abschneidet (Microsoft training guidance). Das ist wichtig, da der Abfragetext in Ordnung sein kann, aber der zwischengespeicherte Plan für den aktuellen Workload ungeeignet sein kann.
Das praktische Symptom ist bekannt: Die Prozedur läuft bei einem Kunden blitzschnell, schleicht bei einem anderen dahin und wechselt nach Cache-Änderungen oder Neustarts ständig hin und her. In diesem Fall geht es beim Optimierungsproblem in Wirklichkeit darum, die Planvariabilität zu kontrollieren, und nicht darum, eine perfekt lesbare Abfrage in etwas Unwartbares umzuschreiben.
Wählen Sie die Abhilfe, die zum Fehlermodus passt
RECOMPILE ist nützlich, wenn die Abfrage einen an die aktuellen Parameter angepassten Plan benötigt und der Overhead akzeptabel ist. OPTIMIZE FOR ist besser, wenn Sie einen repräsentativen Wert kennen und den Plan darauf ausrichten möchten. OPTIMIZE FOR UNKNOWN kann ein sicherer Mittelweg sein, wenn kein einzelner Parameterwert den Workload gut widerspiegelt. Das Erzwingen von Plänen (Plan Forcing) hilft, wenn Sie bereits eine Planform identifiziert haben, die sich zuverlässig verhält.
Die richtige Lösung für Parameter Sniffing ist nicht immer ein besserer Index. Manchmal ist es eine ehrlichere Planwahl.
Neuere betriebliche Steuerungsmöglichkeiten spielen ebenfalls eine Rolle. Die modernen Richtlinien von Microsoft enthalten DISABLE_RESULT_SET_CACHE, was zeigt, dass die Abfrageoptimierung heute sowohl das Cache-Verhalten als auch die Indizierung und das Umschreiben berücksichtigen muss. Dies ist eine nützliche Erinnerung daran, dass unbeständige Leistung oft auf das Zusammenspiel von Daten, Cache und Parameterwerten zurückzuführen ist und nicht nur auf das SQL selbst.
Umgang mit Speicherengpässen und Plattform-Ressourcenbeschränkungen
Eine Abfrage kann gut geschrieben, korrekt indiziert und trotzdem langsam sein. Wenn das passiert, liegt der Engpass oft an Speicherengpässen, Spill-to-Disk-Verhalten oder allgemeineren Plattformbeschränkungen und nicht am Abfragetext selbst. Viele Tuning-Anleitungen übergehen diese Realität, obwohl sie oft der Grund dafür ist, dass eine „optimierte“ Abfrage immer noch enttäuscht.
Lokale Abfragekosten von gemeinsam genutztem Ressourcendruck trennen
Beginnen Sie mit einer Analyse der Wartezustände (Wait Analysis) und der Ressourcenüberwachung, bevor Sie eine einzelne Anweisung beschuldigen. Eine Abfrage, die auf die Festplatte auslagert (spill to disk), um Speicherfreigaben (Memory Grants) konkurriert oder in tempdb-Konflikte gerät, kann wie ein schlechter Kandidat für ein Umschreiben aussehen, obwohl das eigentliche Problem Systemdruck ist. Die Richtlinien von Microsoft zur Abfrageverarbeitung und Azure SQL-Observability weisen auf Tools wie Ressourcenüberwachung, Database Watcher, Query Performance Insights und Fabric-Kapazitätsmetriken hin, um festzustellen, ob der Workload durch die Plattform selbst eingeschränkt wird (platform observability guidance).
Wenn die gesamte Instanz unter Druck steht, kann sich ein lokales SQL-Umschreiben als wirkungslos erweisen, selbst wenn es genau das tut, was es tun soll.
Deshalb sind Wartezeit-Typen (Wait Types) wichtig. Sie zeigen, ob der Engpass auf CPU-Sättigung, E/A-Verzögerung, Parallelitätsblocker oder etwas ganz anderes zurückzuführen ist. Eine Abfrage, die logische Lesevorgänge reduziert, aber immer noch auslagert, kann zwar eine Zahl verbessern, lässt das Benutzererlebnis aber fast unverändert.
Eskalation zur Kapazitätsplanung, wenn der Workload es verlangt
Ab einem gewissen Punkt ist die Abfrageoptimierung nicht mehr der richtige Hebel. Wenn der Workload ständig gegen Speicher-, Speicherplatz- oder Parallelitätsgrenzen ankämpft, liegt die Lösung eher in der Kapazitätsplanung, der Workload-Isolierung oder dem Plattform-Redesign als in einem weiteren Umschreiben. Das ist der praktische Unterschied zwischen der Lösung eines Problems auf Anweisungsebene und der Lösung eines Problems auf Systemebene.
Für Teams, die in verwalteten Umgebungen arbeiten, ist diese Unterscheidung umso wichtiger, da die Plattform einen Teil des zugrunde liegenden Drucks verbergen kann, bis der Workload intensiv wird. Wenn Ihre Optimierungen den Abfragekosten immer nur ein wenig abbringen, die Benutzer aber immer noch die Verlangsamung spüren, ist die nächste Frage nicht, welches SQL Sie anpassen müssen, sondern welche gemeinsam genutzte Ressource weiterhin ausgelastet ist. Hier hilft auch ein Ansatz des Database Reliability Engineering, da er das Abfrageverhalten mit wiederholbaren betrieblichen Prüfungen verknüpft und verhindert, dass speicherbezogene Regressionen als einmalige Überraschungen behandelt werden. Siehe database reliability engineering practices für das umfassendere Betriebsmodell hinter dieser Art von Arbeit.
Implementierung kontinuierlicher Überwachung mit In-Database Observability
Einmaliges Tuning ist nützlich, verhindert aber nicht die nächste Regression. Daten wachsen, Verteilungen verschieben sich, Workloads verändern sich, und der Plan, der im letzten Quartal noch funktioniert hat, kann ohne Vorwarnung schlecht altern. Deshalb ist eine kontinuierliche Überwachung der einzige vernünftige Weg, um zu verhindern, dass die Abfrageleistung zu einer wiederkehrenden Notfallübung wird.
Auf Abweichungen achten, bevor die Benutzer es tun
Der sinnvolle Schritt führt von der Reaktion zur Erkennung. In-Database-Observability-Plattformen können Abfrageleistungsmetriken, Änderungen der Ausführungsmuster und Aktualitätssignale überwachen, ohne Daten aus der Umgebung zu bewegen. Dies ist wichtig, wenn Sicherheits- oder governance-Regeln Datenbewegungen teuer oder unerwünscht machen. dignas Data Platform Observability ist ein Beispiel für dieses Modell, mit einer Überwachung, die innerhalb der Umgebung des Kunden bleibt und den Zustand des Workloads, Verbrauchsmuster und leistungsbezogene Metriken in der gesamten Datenumgebung verfolgt (digna data observability).
Diese Art der auf Baselines basierenden Überwachung ist wertvoll, da sie anormales Verhalten erkennt, bevor das Dashboard ausfällt oder die SLA verletzt wird. Das Ziel ist nicht, das Tuning zu ersetzen. Es geht darum, das Tuning proaktiv statt reaktiv zu gestalten.
Observability nutzen, um den Kreislauf zu schließen
Kontinuierliche Überwachung sorgt dafür, dass der frühere Diagnose-Arbeitsablauf dauerhaft greift. Anstatt eine Verlangsamung einmal zu diagnostizieren und dann zu vergessen, können Teams neues Verhalten mit dem alten Plan vergleichen, Regressionen frühzeitig erkennen und den Workload nahe an der Baseline halten, die sich in der Produktion bewährt hat. digna veröffentlicht außerdem einen Leitfaden zur SQL query optimisation, der sich an diesem Muster orientiert und den Fokus auf reale Parameter, Ausführungspläne, Engpassknoten, Statistikaktualisierungen und Planvergleiche legt.
Das ist der Teil, der mir operativ gefällt. Fehlerbehebungen auf Abfrageebene sind real, verfallen aber, wenn niemand den Workload nach der Bereitstellung der Änderung weiter beobachtet. Observability macht dies zu einer Routine und nicht zu einer Rettungsmission.
Wenn Sie es mit einer langsamen gespeicherten Prozedur zu tun haben, einem Plan, der sich ständig ändert, oder einer Abfrage, die optimiert aussah, bis sich die Daten wieder verschoben haben, besuchen Sie digna und prüfen Sie, ob In-Database Observability Ihnen die Baseline, die Anomalieerkennung und die Workload-Überwachung bieten kann, die Sie für eine stabile Leistung benötigen. Der richtige Tuning-Prozess endet nicht mit dem Umschreiben, er beobachtet das System weiter, damit die nächste Regression Ihr Team nicht überrascht.
Häufig gestellte Fragen
Was tut man vor dem Umschreiben einer langsamen Abfrage?
Messen. Der schnellste Weg, Zeit zu verschwenden, ist SQL zu ändern, bevor man weiß, was langsam ist, und die Baseline ist nicht optional, denn ohne sie lässt sich nicht sagen, ob die Umschreibung half oder das Problem nur verschob.
Wann versteht man das Problem wirklich?
Wenn man den Engpass-Operator vor der Umschreibung erklären kann. Wer nicht benennen kann, welcher Operator den Plan dominiert und warum, macht eine Vermutung, die sich als Optimierung verkleidet.
Warum kann eine langsame Abfrage nichts mit ihrem Text zu tun haben?
Weil das Symptom Antwortzeit ist, während die Ursache außerhalb der Anweisung liegen kann. Blockaden, Parameter Sniffing, veraltete Statistiken oder Ressourcenkonkurrenz zeigen sich alle als eine langsame Abfrage, obwohl das SQL selbst in Ordnung ist.
Was sagt der Ausführungsplan, was die Zeitmessung nicht sagt?
Wo die Arbeit anfällt. Eine Gesamtdauer sagt, dass die Abfrage langsam war, der Plan zeigt, welcher Operator den Aufwand verbrauchte, und das ist der Unterschied zwischen wissen, dass etwas falsch ist, und wissen, was zu ändern ist.
Behebt ein zusätzlicher Index eine langsame Abfrage?
Nur wenn der Plan den Zugriffspfad als Engpass ausweist. Ohne diesen Beleg hinzugefügte Indizes tragen Schreibkosten und Pflege für immer und lassen den eigentlichen Engpass unberührt.



