REST-API-Datenvalidierung: Ein praktischer Leitfaden für die Implementierung
|
8
min. Lesezeit

Wenn etwas schiefgeht, blickt man meistens nicht auf eine saubere Validierungsebene. Man starrt auf ein Dashboard voller seltsamer Zeilen, eine defekte Webhook-Wiederholungsschleife oder einen Bericht, der „fast richtig“ ist, bis jemand bemerkt, dass die Zahlen nicht übereinstimmen. Das sind die tatsächlichen Kosten einer fehlerhaften REST API Data Validation – fehlerhafte Anfragen scheitern nicht einfach am Edge, sie können in Pipelines einsickern, nachgelagerte Analysen verzerren und eine einfache Vertragsabweichung in eine teure Bereinigungsaktion verwandeln.
Der pragmatische Schritt besteht darin, die Validierung als Teil des API-Vertrags zu behandeln und nicht als höfliche Vorabprüfung. Dieser Wandel verändert die Art und Weise, wie Sie Schemas entwerfen, wo Sie Anfragen ablehnen, was Sie protokollieren und wie viele Details Sie im Fehlerfall offenlegen. Er verändert auch die Denkweise von Teams über Zuverlässigkeit, denn eine fehlerhafte Anfrage ist selten nur eine fehlerhafte Eingabe – sie ist oft das erste Signal dafür, dass ein maschinenlesbarer Vertrag nicht mehr mit den Systemen synchronisiert ist, die von ihm abhängen.
Inhaltsverzeichnis
Warum REST-API-Validierung ein Vertragsproblem ist
Eine fehlerhafte Anfrage scheitert nicht immer am Edge. In Unternehmenssystemen kann sie einen Controller passieren, in einer Warteschlange landen und später als irreführender Dashboard-Trend oder als Betriebsbericht auftauchen, dem niemand vertraut. Aus diesem Grund geht es bei der REST API Data Validation wirklich darum, den Vertrag durchzusetzen, von dem nachgelagerte Systeme abhängen, und nicht nur darum, unordentliche Eingaben auszusortieren.
Der REST-Validator von AWS API Gateway macht diese Vertragsdenkweise konkret. Er prüft, ob erforderliche URI-, Query-String- und Header-Parameter vorhanden und nicht leer sind, und er kann einen Payload gegen ein konfiguriertes JSON-Schema validieren. Wenn kein passender Inhaltstyp vorhanden ist, wird die Validierung übersprungen – eine nützliche Erinnerung daran, dass eine Validierung nur funktioniert, wenn der Vertrag explizit genug ist, damit die Plattform ihn durchsetzen kann. Details zur AWS API Gateway-Anfragevalidierung
Das ist wichtig, da Validierungsfehler in Unternehmensumgebungen nicht lokal bleiben. Eine einzige ungültige Anfrage kann Analyse-, Monitoring- und Reporting-Workflows kontaminieren, wenn das System sie zu spät oder gar nicht abfängt. Die REST-API-Richtlinien von Eurostat beschreiben Anfragen als strukturiertes URL-Muster, das sich aus Host, Service, Version, Antworttyp, Datensatzcode, Format, Sprache und Filtern zusammensetzt. Eurostat REST-API-Richtlinien
Praktische Regel: Wenn nachgelagerte Systeme nicht sicher von der Form und Bedeutung einer Anfrage ausgehen können, haben Sie noch keinen Vertrag, sondern nur einen Vorschlag.
Die Validierung begann als einfache Eingabeprüfung und entwickelte sich dann zur Vertragsdurchsetzung, Sicherheitshygiene und Performance-Kontrolle für große APIs. Dieser Wandel zeigt sich in Richtlinien, die Fail-Fast-Verhalten, klare Fehler und die Vermeidung von technischem Datenabfluss betonen. Leitfaden zur REST-API-Validierung
Für Teams, die Datenpipelines verwalten, ist das Modell noch strenger. Die Validierung ist eine Ebene der Zuverlässigkeitsstrategie, und Data Contracts sind die umfassendere Disziplin, die den Vertrag zwischen Produzenten und Konsumenten explizit macht.
Das Zwei-Ebenen-Validierungsmuster
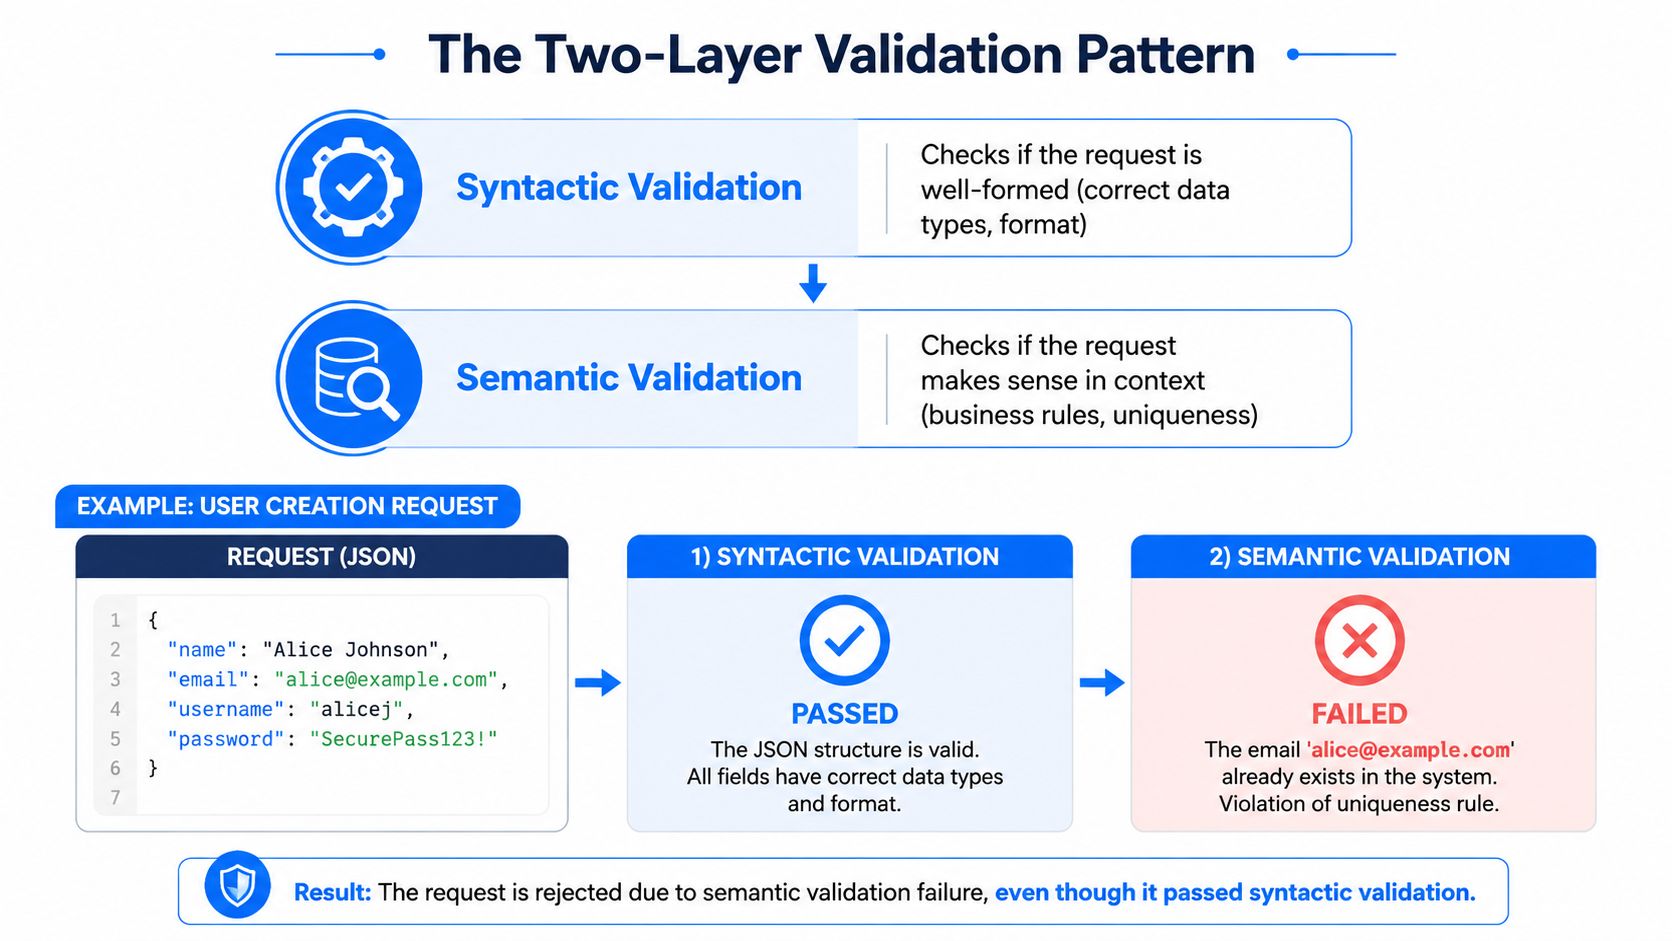
Der sauberste Weg, eine REST-API-Validierung zu entwerfen, besteht darin, die syntaktische Validierung von der semantischen Validierung zu trennen. Syntaktische Prüfungen beantworten eine Frage: Ist diese Anfrage formal korrekt? Semantische Prüfungen beantworten die schwierigere Frage: Ist diese Anfrage für diese Ressource und diese Geschäftsdomäne sinnvoll?
Was in die syntaktische Validierung gehört
Die syntaktische Validierung fängt fehlerhaftes JSON, fehlende Pflichtfelder, falsche Datentypen, Parse-Fehler, leere Zeichenfolgen und Werte ab, die deklarierte Grenzen verletzen. Der Zweck besteht darin, offensichtlich fehlerhafte Anfragen abzulehnen, bevor sie die teure Geschäftslogik erreichen. Das ist die Ebene, auf der OpenAPI-Schemas, JSON-Schema-Validatoren und Guards auf Controller-Ebene ihren Wert beweisen.
Der Workflow ist unkompliziert. Validieren Sie am Gateway oder Controller, setzen Sie ein strenges Schema durch, weisen Sie Typkonflikte und Werte außerhalb des zulässigen Bereichs ab und führen Sie Negativtests für fehlerhaftes JSON, Nullwerte, leere Zeichenfolgen und übergroße Payloads durch, bevor die nachgelagerte Verarbeitung beginnt. Richtlinien im OWASP-Stil empfehlen außerdem eine starke Typisierung, Regex-Einschränkungen, die Ablehnung illegaler Inhalte und Beschränkungen der Anfragegröße, die bei Überschreitung ein HTTP 413 zurückgeben. Praktiken zur Validierung und Eingabebehandlung
Was in die semantische Validierung gehört
Die semantische Validierung prüft die geschäftliche Bedeutung. Eine Benutzer-ID kann syntaktisch gültig sein und dennoch nicht existieren. Ein Enum-Wert kann strukturell gültig sein und dennoch für den aktuellen Ressourcenstatus falsch sein. Hier überprüfen Sie die referenzielle Integrität, Eindeutigkeit, den Workflow-Status, die Inhaberschaft oder jede Regel, die von Live-Domänendaten abhängt.
Ein nützlicher Entscheidungsbaum ist einfach:
Kann der Parser es lesen? Packen Sie das in die Syntax.
Ist der Typ, das Pflichtfeld oder der Bereich falsch? Packen Sie das in die Syntax.
Bezieht sich der Wert auf eine reale Entität oder einen gültigen Status? Packen Sie das in die Semantik.
Hängt die Regel vom Geschäftskontext, Berechtigungen oder dem aktuellen Datenbankstatus ab? Packen Sie das in die Semantik.
Beginnen Sie mit den kostengünstigen Prüfungen. Wenn eine Anfrage die grundlegende Formprüfung nicht besteht, sollten Sie keine Datenbank-Lesezugriffe aufwenden, um eine Geschäftsregel für eine Payload zu beweisen, die bereits zwei Millisekunden zuvor hätte abgelehnt werden müssen.
Diese Abfolge ist es, was man unter progressiver Validierung versteht. Prüfen Sie kritische Felder zuerst, lehnen Sie frühzeitig ab und reservieren Sie teure Prüfungen für Anfragen, die die strukturelle Hürde bereits genommen haben. Praxisleitfäden trennen die beiden Ebenen genau aus diesem Grund: Syntax bringt Geschwindigkeit und Sicherheit, Semantik bringt Korrektheit. Syntaktische versus semantische Validierung
Entwurf von Schemas, die in der Produktion funktionieren
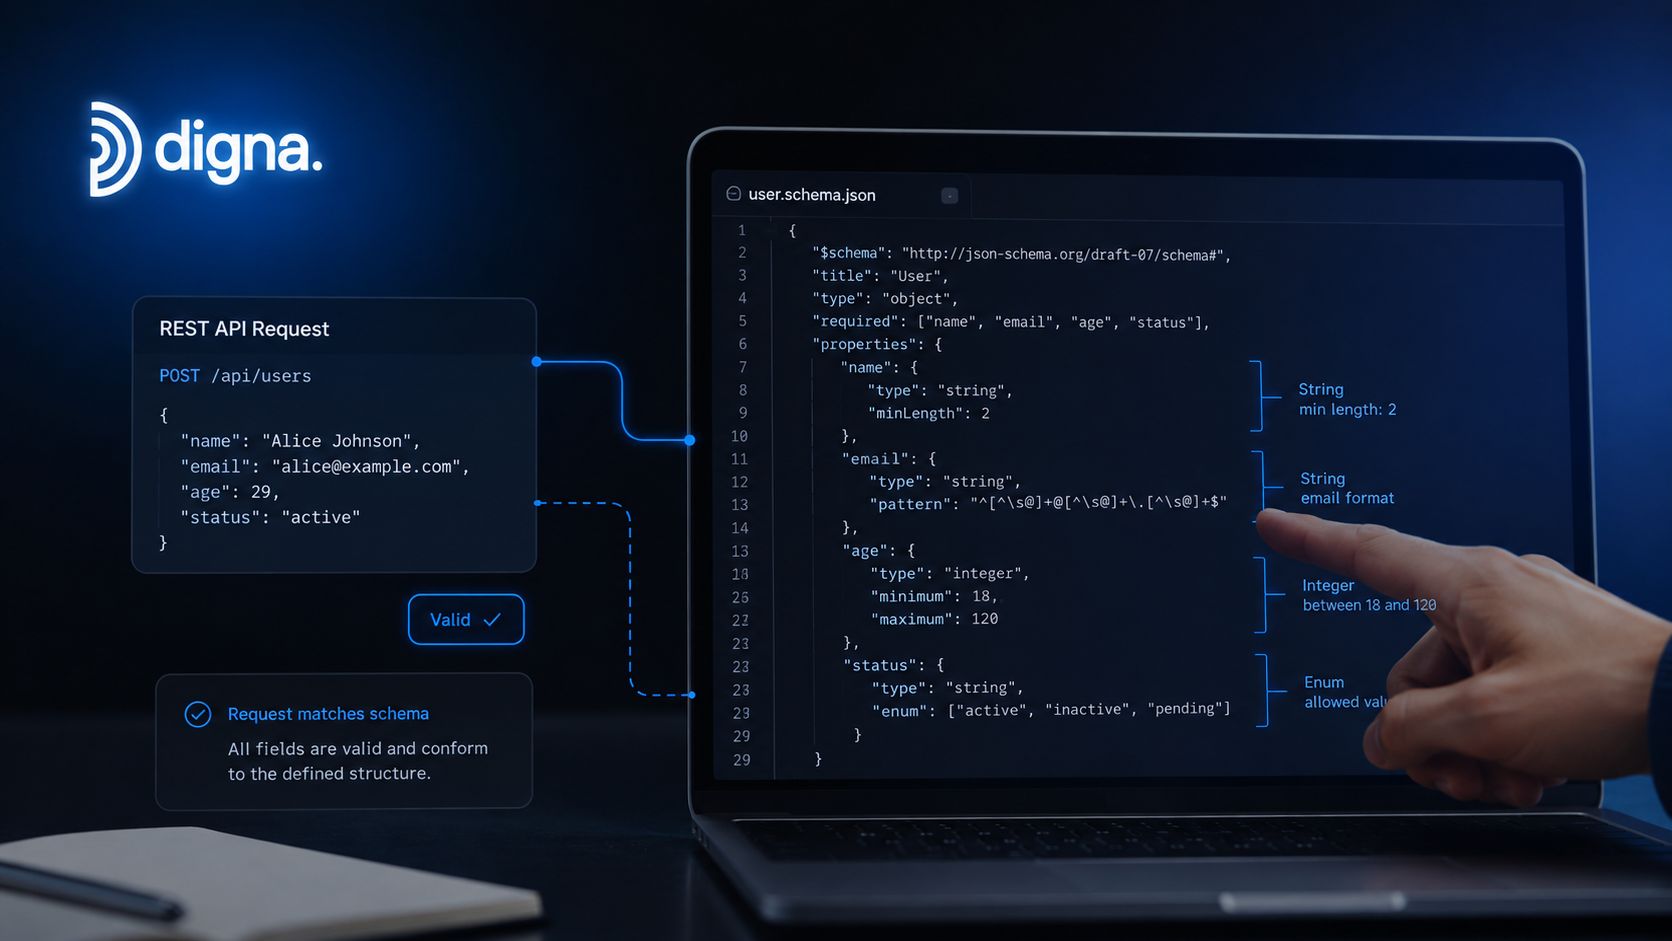
Ein Schema, das alles akzeptiert, ist nicht flexibel, sondern nutzlos. Gutes Schemadesign beginnt mit den Feldern, die Clients senden müssen, und verschärft dann den Vertrag mit Typen, Mustern, Bereichen und Enums, die dem Geschäftsobjekt entsprechen, das die API akzeptieren soll. In der Praxis arbeiten JSON Schema und OpenAPI gut zusammen, da das Schema die Form der Anfrage beschreibt, während die API-Spezifikation beschreibt, wo und wie diese Form verwendet wird.
Schemaregeln, die in der Produktion standhalten
Definieren Sie Pflichtfelder explizit und schränken Sie dann jede Eigenschaft mit dem engsten praktischen Typ ein. Verwenden Sie bei Zeichenfolgen Regex-Muster, wenn das Format wichtiger ist als Freitext. Deklarieren Sie bei Zahlen Bereiche, anstatt sich darauf zu verlassen, dass nachgelagerter Code Grenzfälle abfängt. Verwenden Sie für geschlossene Mengen Enums, damit Clients nicht versehentlich neue Werte erfinden.
Diese Disziplin verhindert die Fehlermodi, die in der Produktion auftreten. Teams überspringen oft Formatprüfungen für E-Mails und Daten oder schreiben Schemas, die nicht die tatsächlichen Geschäftsregeln des Endpunkts widerspiegeln. Das Ergebnis ist ein Vertrag, der fehlerhafte Daten in spätere Phasen durchlässt und die Anwendungsebene zwingt, fehlende Strukturen auszugleichen. Die Verwendung von Schemabeschreibungen, die mit den gespeicherten Datenstrukturen synchronisiert bleiben, hilft dabei, die Anfragevalidierung nah am Datenmodell zu halten, das sie schützen soll.
Ein praktisches Schemadesign-Muster sieht so aus:
Gemeinsame Basisobjekte für Felder, die über mehrere Endpunkte hinweg wiederverwendet werden.
Endpunktspezifische Overlays für aktionsspezifische Anforderungen.
Explizite Enums und Regexes für eingeschränkte Werte.
Versionierte Schemadateien, wenn eine Vertragsänderung andernfalls Konsumenten beeinträchtigen würde.
Performance- und Drift-Kontrolle
Das Kompilieren von Schemas ist wichtig, wenn das Anfragevolumen hoch ist. Wiederholtes Parsen erzeugt Rauschen, das man in kritischen Pfaden vermeiden möchte, und kompilierte Validatoren reduzieren diese Kosten. Die Schema-Versionierung ist aus demselben Grund wichtig, da sich Geschäftsanforderungen ändern und alte Clients nicht einfach sofort verschwinden.
Der zu vermeidende Fehlermodus ist ein schleichender, unbemerkter Schema-Drift, bei dem der Code, das OpenAPI-Dokument und die tatsächliche Form der Payload nicht mehr übereinstimmen.
An diesem Punkt wird strukturelles Monitoring nützlich. Der Schema Tracker von digna wurde entwickelt, um strukturelle Änderungen in der Produktion zu überwachen, damit Teams einen Drift erkennen können, bevor er die Validierung beeinträchtigt. Dies ist das richtige Problem, das es zu lösen gilt, wenn Ihr API-Vertrag nur ein Teil einer größeren Datenpipeline ist. Halten Sie das Schema nah am Service, halten Sie die Versionierung explizit und lassen Sie nicht zu, dass „das aktualisieren wir später“ zur Standard-Release-Strategie wird.
Auswahl von Validierungsbibliotheken und Middleware
Die Wahl der Bibliothek ist meist ein Abwägen zwischen Geschwindigkeit, Ausdrucksstärke und Wartungsaufwand. JSON-Schema-Validatoren wie Ajv sind stark, wenn Sie kompilierte Schemas und eine vorhersehbare Durchsetzung wünschen. OpenAPI-basierte Tools sind besser, wenn Ihre Validierung eng an einen API-Vertrag gekoppelt bleiben soll, der bereits für die Dokumentation und Client-Generierung existiert. Typsysteme wie TypeScript helfen zur Build-Zeit, ersetzen jedoch keine Runtime-Validierung, da externen Anfragen egal ist, woran Ihr Compiler glaubt.
Framework-Middleware ist der Bereich, in dem Teams oft die falsche Optimierung wählen. Express-Middleware lässt sich leicht integrieren, FastAPI bietet standardmäßig ein starkes Parsing von Anfragen, und eine Validierung auf Gateway-Ebene kann fehlerhaften Datenverkehr stoppen, bevor er den Anwendungscode erreicht. Die richtige Aufteilung hängt davon ab, wo der Fehler auftreten soll und wer für die Fehlerschnittstelle verantwortlich sein soll.
Ansatz | Performance | Fehlerqualität | Lernkurve | Am besten geeignet für |
|---|---|---|---|---|
JSON-Schema-Validator | Stark im kompilierten Zustand | Gut bei passendem Mapping | Mittelmäßig | Strikte Anfrageverträge |
OpenAPI-basierte Tools | Solide | Gut, am Vertrag ausgerichtet | Mittelmäßig | API-First-Teams |
TypeScript plus Runtime-Prüfungen | Gemischt, hängt von der Runtime-Ebene ab | Variiert | Geringer für TS-Teams | Gemeinsame Codebasen |
Framework-Middleware | Gut für einfache Fälle | Oft Framework-spezifisch | Niedrig | Schnelle Integration |
Validierung auf Gateway-Ebene | Stark am Edge | Meist standardisiert | Mittel bis hoch | APIs mit hohem Traffic |
Kompilierte Schemas und progressive Validierung sollten in hochfrequentierten Systemen obligatorisch sein. Prüfen Sie die kostengünstigsten Felder zuerst, brechen Sie frühzeitig ab (fail fast) und rufen Sie tiefere Validatoren nur dann auf, wenn eine Anfrage diese CPU-Zeit bereits verdient hat. Dieses Muster ist wichtiger als der Markenname der Bibliothek.
Es gibt auch eine Wartungsfrage, die von Teams oft unterschätzt wird. Eigene Validatoren fühlen sich beim ersten ausgelieferten Endpunkt einfach an, werden aber instabil, wenn zehn weitere Endpunkte dieselben Regeln mit leicht abweichenden Ausnahmen benötigen. Etablierte Bibliotheken reduzieren diesen Drift, insbesondere wenn sie wiederverwendbare Schemas, Fehlermeldungen auf Feldebene und eine Ausweichmöglichkeit für domänenspezifische Prüfungen bieten, die nicht in die Bibliothek selbst gehören.
Fehlerbehandlung, die Entwickler nutzen
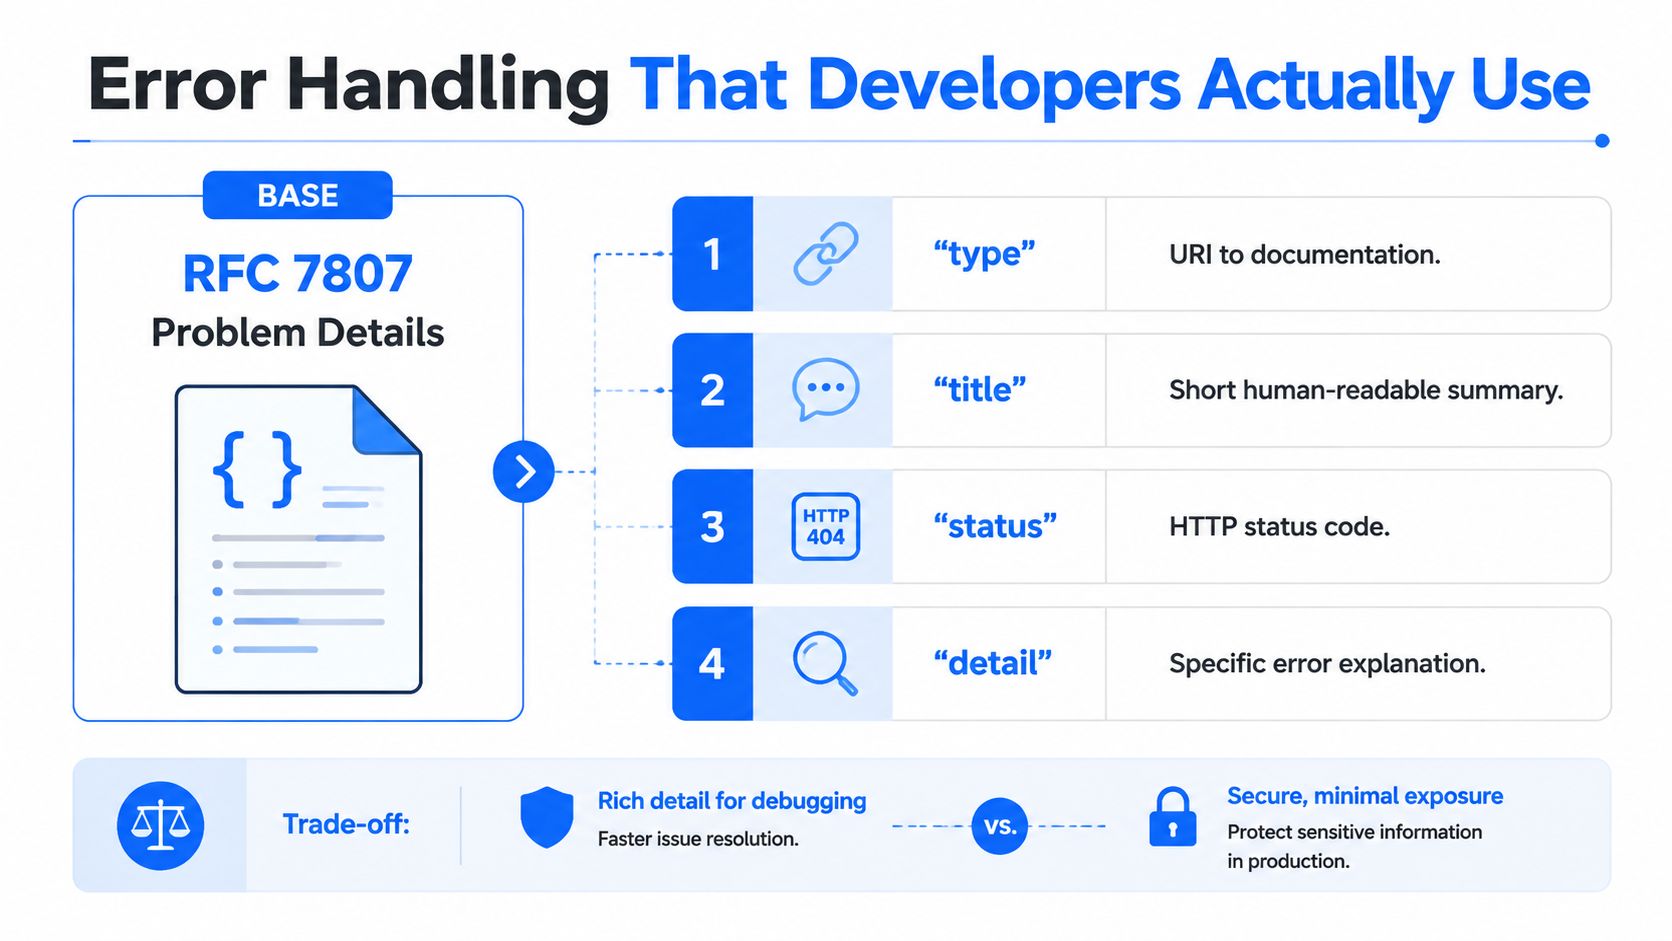
Eine Validierung hilft nur, wenn die Antwort den Clients eine Grundlage bietet, auf der sie reagieren können. RFC 7807 eignet sich gut als Ausgangsbasis, da es API-Konsumenten eine maschinenlesbare Struktur für Parsing-Fehler bietet, ohne dass sie ein benutzerdefiniertes Format rückentwickeln müssen. Die entscheidenden Felder sind type, title, status und detail sowie Informationen auf Feldebene, wenn eine Payload die Validierung nicht besteht. Validierungsantworten im RFC 7807-Stil
Was zurückgegeben und was verborgen werden sollte
Verwenden Sie HTTP 400 Bad Request, wenn die Payload die Schema- oder Feldvalidierung nicht besteht. Halten Sie den Response-Body sicher, spezifisch und konsistent. Geben Sie den Feldnamen, den Grund und das erwartete Format an, damit Frontend-Entwickler und automatisierte Clients die Anfrage ohne Rätselraten korrigieren können.
Eine gute Antwort ist beschreibend, ohne geschwätzig zu sein. Feldspezifische Fehler funktionieren besser als eine allgemeine Meldung wie „ungültige Eingabe“, da sie direkt der fehlerhaften Eigenschaft zugeordnet werden können. Aggregierte Fehler sind noch besser, wenn mehrere Felder gleichzeitig fehlerhaft sind, da Clients so alles in einem einzigen Durchlauf korrigieren können. Öffentliche Richtlinien empfehlen außerdem, interne Implementierungsdetails zu vermeiden. Dies schützt Sie davor, Stack-Traces, Feld-Interna oder Backend-Strukturen preiszugeben. Leitfaden zur Behandlung von API-Validierungsfehlern
Wo Statuscodes hingehören
Es gibt einen echten Kompromiss zwischen der Semantik von 400 und 422, und in öffentlich zugänglichen Materialien ist die Grenze noch nicht vollständig geklärt. Die praktische Regel lautet: Bleiben Sie innerhalb Ihrer eigenen API konsistent und dokumentieren Sie dies klar für die Konsumenten. Wenn Ihr Team 400 für alle Fehler bei der Form der Anfrage verwendet, behalten Sie dies bei und gestalten Sie den Response-Body präzise genug, um dies auszugleichen.
Das serverseitige Logging sollte wesentlich detaillierter sein als die Client-Antworten. Protokollieren Sie den Validierungskontext, die Request-ID und die fehlgeschlagene interne Regel, aber protokollieren Sie niemals Passwörter, Token oder andere sensible Payload-Felder. Diese Trennung ermöglicht Support-Teams ein schnelles Debugging, während die Antworten in der Produktionsumgebung vor potenziell schädlichen Clients geschützt bleiben. In einer echten API ist diese Balance wichtiger als perfekte theoretische Reinheit.
Die beste Fehlerantwort ist eine, die der Client beheben kann und aus der ein Angreifer keine zusätzlichen Informationen gewinnen kann.
Verbindung von Validierung mit Datenqualität und Observability
Validierungsfehler sind nicht nur API-Probleme, sie sind Signale für den Zustand des Datensystems rund um die API. Ein sprunghafter Anstieg abgelehnter Anfragen kann auf Änderungen an der vorgelagerten Quelle, einen Schema-Drift oder eine Geschäftsregel hinweisen, die sich schneller geändert hat als die Clients. Wenn Sie die Validierung nur als Eingabefilter behandeln, verpassen Sie eine der frühesten Warnungen, dass sich die Pipeline zu verschieben beginnt.
Was nach der Ablehnung einer Anfrage zu überwachen ist
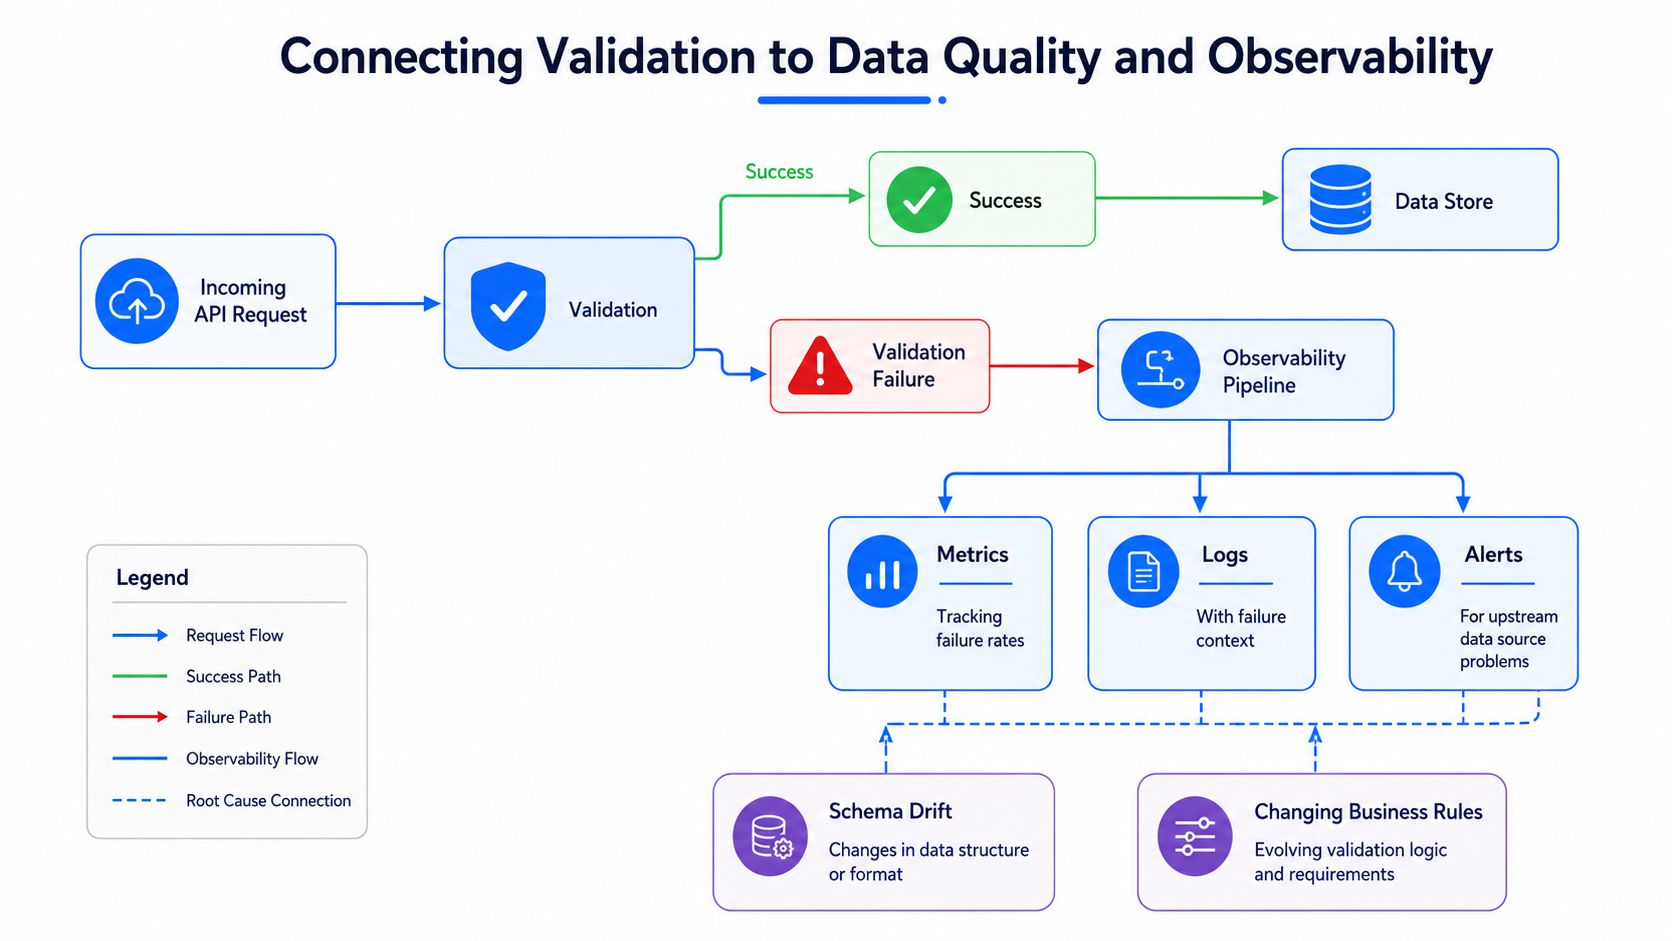
Validierungsfehler sollten in die Observability einfließen, genau wie erfolgreiche Schreibvorgänge in den Speicher fließen. Verfolgen Sie Fehlermuster, bewahren Sie Kontextprotokolle auf und schlagen Sie Alarm, wenn ein bestimmter Endpunkt plötzlich eine neue Klasse von Payloads ablehnt. So können Teams ein fehlerhaftes Client-Rollout von einem tiefer liegenden Kompatibilitätsproblem unterscheiden.
Dieser Punkt gilt auch für nachgelagerte Prozesse. Wenn die API das Eingangstor zu einem Warehouse, Lake oder operativen Datenspeicher ist, sollten sich die Anfragevalidierung und die Datenqualitätsprüfungen nach dem Laden gegenseitig ergänzen, anstatt sich blind zu wiederholen. Die Validierung auf API-Ebene fängt fehlerhafte Anfragen vor dem Ingestieren ab, während nachgelagerte Prüfungen Anomalien erkennen, die erst sichtbar werden, wenn Daten kombiniert, transformiert oder mit anderen Systemen verglichen werden.
Wie Plattformen in den Kreislauf passen
Die Module für Data Validation und Schema Tracker von digna fügen sich natürlich in diese Ebene ein, da sie es Teams ermöglichen, Geschäftsregeln und strukturelle Änderungen über die gesamte Pipeline hinweg zu überwachen, nicht nur am Eingangspunkt. Das ist nützlich, wenn der API-Vertrag stabil ist, das Verhalten der Quelle jedoch nicht, oder wenn mehrere Produzenten dieselben nachgelagerten Tabellen speisen. digna Data Observability
Ein praktischer Observability-Kreislauf sieht so aus:
Validierungsmetriken zur Kennzeichnung neuer Fehlermuster.
Protokolle zur Erfassung des abgelehnten Feldes und des Grundes.
Warnmeldungen zur Benachrichtigung der Verantwortlichen bei Problemen mit der vorgelagerten Quelle.
Überwachung von Schemaänderungen, um einen Drift abzufangen, bevor er sich ausbreitet.
Prüfung von Geschäftsregeln, um zu bestätigen, dass die Daten nach dem Ingestion-Prozess noch Sinn ergeben.
Behandeln Sie Validierungsfehler als operative Telemetriedaten, nicht nur als Rauschen der Anwendung.
Diese Denkweise hält die API-Ebene mit der Datenzuverlässigkeit verbunden. Wenn Validierung, Observability und nachgelagerte Qualitätsprüfungen aufeinander abgestimmt sind, diskutieren Teams nicht mehr darüber, ob ein Fehler beim API-Team oder beim Datenteam liegt. Sie sehen dasselbe Signal, interpretieren es im Kontext und können die richtige Ebene schneller korrigieren.
Wenn Sie Anfrageverträge verschärfen, fehlerhafte Payloads reduzieren oder verhindern möchten, dass ein Schema-Drift Ihre Pipeline beschädigt, bietet digna Datenteams eine Möglichkeit, Validierung, Schemaänderungen und das Datenverhalten innerhalb ihrer eigenen Umgebung zu überwachen. Besuchen Sie digna, um zu sehen, wie sich die Data-Observability- und Validierungsmodule in dieselbe Zuverlässigkeitsebene einfügen, von der Ihre APIs bereits abhängen.
Häufig gestellte Fragen
Warum ist REST-API-Validierung ein Vertragsproblem?
Ein API-Endpunkt ist ein Versprechen darüber, was ein Payload enthält und bedeutet. Validierung setzt dieses Versprechen durch. Fehlt sie oder ist sie unvollständig, bricht der Vertrag lautlos, und der Schaden zeigt sich später als seltsame Zeilen, Retry-Schleifen und fast stimmige Berichte.
Was ist das zweischichtige Validierungsmuster?
Syntaktische Validierung prüft die Struktur: Pflichtfelder, Typen, Formate und Wertebereiche, und kann ein Payload ohne fachlichen Kontext ablehnen. Semantische Validierung prüft die Bedeutung: dass das referenzierte Konto existiert, Daten in richtiger Reihenfolge stehen, Summen stimmen. Beide Schichten sind nötig.
Was sollte eine API bei fehlgeschlagener Validierung zurückgeben?
Einen Statuscode, der eine fehlerhaft geformte Anfrage von einer abgelehnten, aber wohlgeformten unterscheidet, plus eine maschinenlesbare Liste der fehlgeschlagenen Felder mit Begründung. Interne Kennungen, Stacktraces oder Schemainterna gehören nicht in den Fehlerkörper.
Wie verhindert man Drift bei API-Schemas?
Versionieren Sie das Schema gemeinsam mit dem ausliefernden Code, behandeln Sie Ergänzungen als abwärtskompatibel und Entfernungen als Breaking Change, und überwachen Sie die Ablehnungsrate je Feld. Ein plötzlicher Anstieg bei einem Feld ist meist eine unangekündigte Produzentenänderung.
Wie hängt API-Validierung mit Datenqualitätsmonitoring zusammen?
Ein abgelehntes Payload schützt den Speicher, verbirgt aber das Problem. Abgelehntes Volumen, die am häufigsten fehlschlagenden Felder und die verantwortlichen Clients sind eigenständige Qualitätssignale und gehören in dieselbe Observability-Sicht wie Warehouse-Prüfungen.


