Offenes Tabellenformat: Iceberg, Delta und Hudi im Vergleich
|
8
min. Lesezeit

Der verbreitetste Rat zu einem offenen Tabellenformat lautet, eines zu wählen, das Anbieterbindung verhindert. Dieser Rat ist unvollständig. Dateiportabilität zählt, doch die tiefere Veränderung ist, dass Tabellenbedeutung, Transaktionshistorie, Schemaabsicht und Metadaten zur Abfrageplanung in eine gemeinsame Schicht über den Objekten im Cloud-Speicher wandern.
Diese Verschiebung macht aus einem Verzeichnis voller Parquet- oder ORC-Dateien eine Tabelle, die mehrere Engines entdecken, lesen, aktualisieren und weiterentwickeln können. Sie schafft zugleich eine neue Verantwortung: Metadaten müssen gesteuert werden. Iceberg, Delta Lake und Hudi können Speicher datenbankähnlicher verhalten lassen, doch sie entscheiden nicht, ob ein verspäteter Snapshot ein SLA verletzt, ob eine neue Spalte ein nachgelagertes Modell bricht oder ob ein valide wirkender Datensatz ein anomales Geschäftsmuster enthält.
Dieser Leitfaden beginnt mit dem konzeptionellen Modell, vergleicht die drei großen Formate und verfolgt die Metadaten dann in den Produktionsbetrieb. Die zentrale Frage ist schlicht: Welche Steuerungsebene hält eine offene Tabelle vertrauenswürdig, nachdem der Commit gelungen ist?
Inhaltsverzeichnis
Warum offene Tabellenformate das Lakehouse verändern
Ein offenes Tabellenformat ist nicht bloß ein gemeinsamer Weg, Parquet zu lesen, ohne von einem Anbieter abzuhängen. Es legt Tabellensemantik in Metadaten ab, die neben den Daten im Object Storage liegen können. Diese Semantik umfasst atomare Commits, versionierte Snapshots, Schemaevolution, Partitionsinformationen und Statistiken auf Dateiebene.
Ohne diese Schicht gibt Ihnen Object Storage im Wesentlichen Dateien und Ordner. Eine Query-Engine kann aus einem Verzeichnis eine Tabelle erschließen, doch die Verzeichnisstruktur liefert keine verlässliche Antwort auf grundlegende Fragen: welche Dateien zur aktuellen Version gehören, welcher Schreibvorgang abgeschlossen wurde, welches Schema gestern aktiv war oder welche Dateien sich für einen Filter gefahrlos überspringen lassen.
Offene Tabellenformate beantworten diese Fragen über gemeinsame Metadaten. Apache Hudi entstand 2016 bei Uber, Delta Lake wurde 2017–2018 von Databricks eingeführt und 2019 quelloffen veröffentlicht, und Apache Iceberg entstand 2018 bei Netflix und ging 2019 an die Apache Software Foundation. Diese getrennten Bemühungen liefen auf dasselbe Problem zu: Data Lakes datenbankähnlicher verhalten zu lassen, ohne Daten aus dem Object Storage zu bewegen (historischer Überblick zu offenen Tabellenformaten).
Von Verzeichnissen zu vollwertigen Tabellen
Das praktische Ergebnis ist eine Tabelle, die Batch-Lesevorgänge, Streaming-Schreibvorgänge, Updates und Deletes auf demselben Speicher trägt. Engines müssen nicht jede Datei als eigene Quelle der Wahrheit behandeln. Sie können einen konsistenten Snapshot auflösen, Metadaten prüfen und die Arbeit gegen die relevante Teilmenge der Dateien planen.
Das verändert den Entwurf in mehrfacher Hinsicht:
Nebenläufige Schreibvorgänge werden beherrschbar: Ein Commit kann als vollständige Metadatenänderung gelingen oder scheitern, ohne einen teilweisen Tabellenzustand offenzulegen.
Mehrere Engines können zusammenarbeiten: Spark, Trino, Flink, Warehouses und andere Reader können den Metadatenvertrag der Tabelle nutzen, statt sich allein auf physische Pfade zu stützen.
Pipelines werden weniger engine-spezifisch: Teams können Speichersemantik von der Compute-Engine trennen, die eine Transformation ausführt.
Tabellen werden zu Katalogobjekten: Eigentum, Auffindbarkeit, Zugriff und Lineage lassen sich um eine Tabelle statt um einen Ordner organisieren.
Eine Delta-Tabelle etwa enthält Datendateien und ein Transaktionslog. Regelmäßige Checkpoints verdichten dieses Log, sodass Engines den aktiven Snapshot und die relevanten Partitionen erkennen, ohne jedes Objekt aufzuzählen, selbst in sehr großem Maßstab (technische Beschreibung des Transaktionsentwurfs von Delta Lake).
Architekturregel: Ein offenes Tabellenformat gibt Ihnen eine dauerhafte Beschreibung des Tabellenzustands. Es gibt Ihnen nicht automatisch eine dauerhafte Steuerung dessen, was dieser Zustand fachlich bedeutet.
Diese Unterscheidung zählt für den Lakehouse-Entwurf. Ein brauchbares Modell für Datenqualität im Lakehouse muss über den Speicher-Commits sitzen und strukturelle Änderungen mit Eigentum, Validierung, Frische und nachgelagerter Wirkung verbinden.
Die Kernbausteine ohne Fachjargon erklärt
Denken Sie an Object Storage als große Poststelle. Auf dem Boden stehen Kisten mit rohen Parquet- oder ORC-Dateien. Die Kisten sind haltbar, doch der Boden allein sagt dem Sachbearbeiter nicht, welche Kisten zur heutigen Lieferung gehören oder ob eine neu eingetroffene Kiste dem vereinbarten Umschlagformat folgt.
Ein offenes Tabellenformat ergänzt die Aufzeichnungen des Sachbearbeiters. Jede Aufzeichnung beschreibt den aktuellen Zustand der Tabelle und hilft einer Query-Engine, die richtigen Kisten zu finden, ohne jede zu öffnen.
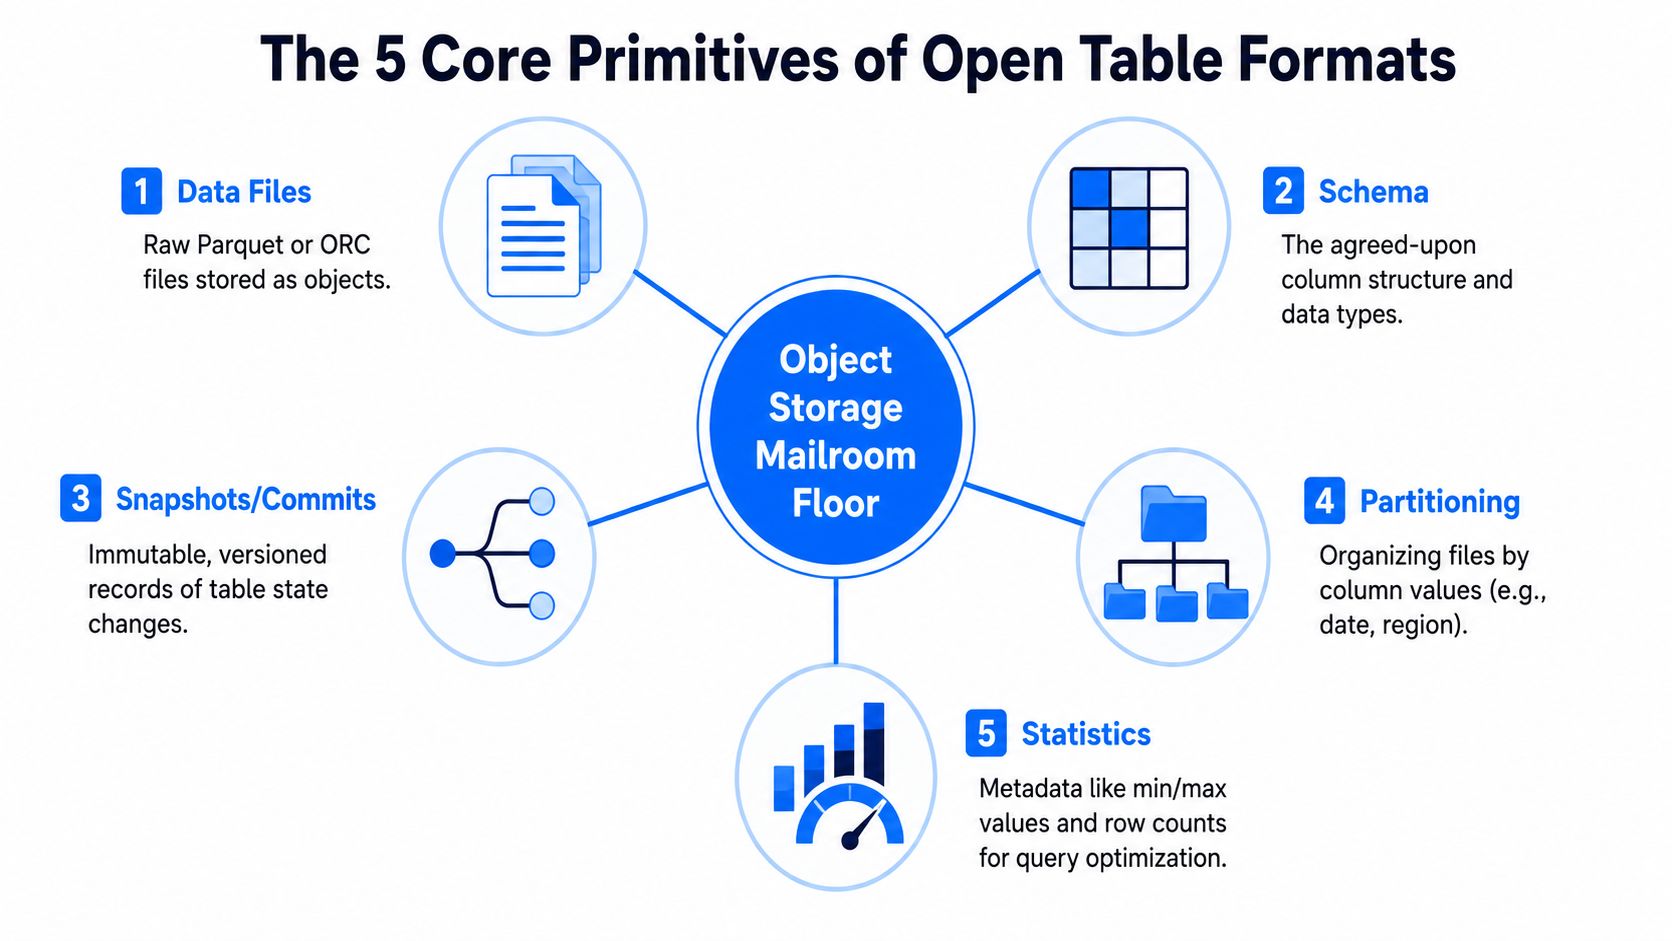
Die fünf Aufzeichnungen, die der Sachbearbeiter braucht
Datendateien sind die Kisten auf dem Boden der Poststelle. Sie enthalten die eigentlichen Zeilen, meist in spaltenorientierten Formaten wie Parquet oder ORC. Die Rolle von Parquet in der analytischen Speicherung ist vom Tabellenmanagement getrennt. Parquet speichert Daten effizient, während das offene Tabellenformat erklärt, wie diese Dateien eine sich entwickelnde Tabelle bilden.
Das Schema ist das Regelwerk für die Umschlagform. Es definiert Spaltennamen, Datentypen und strukturelle Erwartungen. Schemaevolution lässt eine Tabelle sich über die Zeit ändern, ohne jede historische Datei sofort neu schreiben zu müssen, doch die erlaubte Änderung braucht weiterhin Governance.
Manifeste sind detaillierte Inventare. Ein Manifesteintrag kann den Pfad einer Datendatei, ihre Partitionswerte und Spaltenstatistiken benennen. In Iceberg definieren Metadatendateien die Tabelle, Manifestlisten definieren Snapshots, und Manifestdateien listen Datendateien mit Statistiken für das Pruning (architektonischer Vergleich zu Iceberg).
Snapshots sind Momentaufnahmen der Aufzeichnungen. Ein Reader kann die Tabelle so anfragen, wie sie bei einem früheren Snapshot bestand, und erhält eine konsistente Antwort, selbst während neue Dateien eintreffen. Iceberg nutzt unveränderliche Metadatendateien und Snapshot-Historie, wobei jeder Commit eine neue Metadatenversion erzeugt (Iceberg-Spezifikation).
ACID-Transaktionen sind die Commit-Regeln des Sachbearbeiters. Eine Metadatenaktualisierung wird entweder als vollständige Operation sichtbar oder wird nicht zum aktuellen Tabellenzustand. Das schützt Reader davor, die Hälfte eines Schreibvorgangs zu sehen, und gibt Writern einen Weg, Änderungen zu koordinieren.
Warum Partitionierung und Statistiken die Leistung beeinflussen
Partitionierung ist die Regalordnung. Sind Zeilen nach einem Wert gruppiert, der häufig in Filtern auftaucht, kann eine Engine ganze Regale überspringen. Statistiken geben feinere Hinweise, etwa Minimal- und Maximalwerte einer Spalte in einer Datei, sodass der Planer Dateien meiden kann, deren Wertebereiche nicht zur Abfrage passen.
Deshalb hängt die Leistung von der Metadatenplanung ab und nicht nur von der reinen Dateigeschwindigkeit. Eine gut organisierte Tabelle lässt die Engine die I/O senken, bevor sie die Daten scannt. Eine schlecht organisierte Tabelle kann technisch korrekt bleiben und dennoch breite Scans erzwingen.
Schemaevolution verdient dieselbe Vorsicht. Eine Spalte hinzuzufügen mag mit bestehenden Readern verträglich sein, doch das Entfernen oder Ändern eines Typs kann Dashboards, Modelle und Datenverträge betreffen. Das Format erfasst den strukturellen Zustand. Ihre Plattform muss weiterhin entscheiden, ob eine vorgeschlagene Änderung akzeptabel ist.
Wie Iceberg, Delta Lake und Hudi entstanden
Iceberg, Delta Lake und Hudi wuchsen aus getrennten Teams, die derselben architektonischen Lücke begegneten: Dateien im Object Storage sind keine Tabellen. Jedes Projekt ergänzte Metadaten und Commit-Verhalten und priorisierte dabei andere Workloads und Betriebsumgebungen. Ihre Geschichte ist deshalb eine Geschichte der Metadaten-Governance, nicht des Dateilayouts.
Apache Hudi entstand 2016 bei Uber, als Teams Lake-Speicher für inkrementelle Verarbeitung und veränderliche Daten brauchten. Sein Entwurf dreht sich um Upserts, Deletes, Indizierung auf Satzebene und eine Commit-Zeitachse. Diese Entscheidungen passen zu Pipelines, die wiederholt Änderungen aus operativen Systemen anwenden.
Databricks führte Delta Lake 2017–2018 ein und veröffentlichte es 2019 quelloffen. Delta speichert die Transaktionshistorie in einem Log neben den Datendateien. Sequenzielle JSON- oder Parquet-Einträge unter _delta_log erfassen Operationen und erlauben Engines, den Tabellenzustand zu rekonstruieren und frühere Versionen abzufragen. Dieser Architekturvergleich von Iceberg, Delta Lake und Hudi bietet einen knappen Blick auf ihre Entwürfe.
Netflix entwickelte Iceberg 2018 und spendete es 2019 an die Apache Software Foundation. Iceberg konzentrierte sich auf unveränderliche Metadaten, Snapshot-Isolation, Hidden Partitioning und engine-neutralen Tabellenzugriff. Seine Metadatenstruktur trennt Tabellendefinitionen, Snapshot-Verweise und Manifeste auf Dateiebene und trägt Partitionsevolution sowie Query-Pruning. Unsere Übersicht zum offenen Tabellenformat Apache Iceberg liefert mehr Kontext.
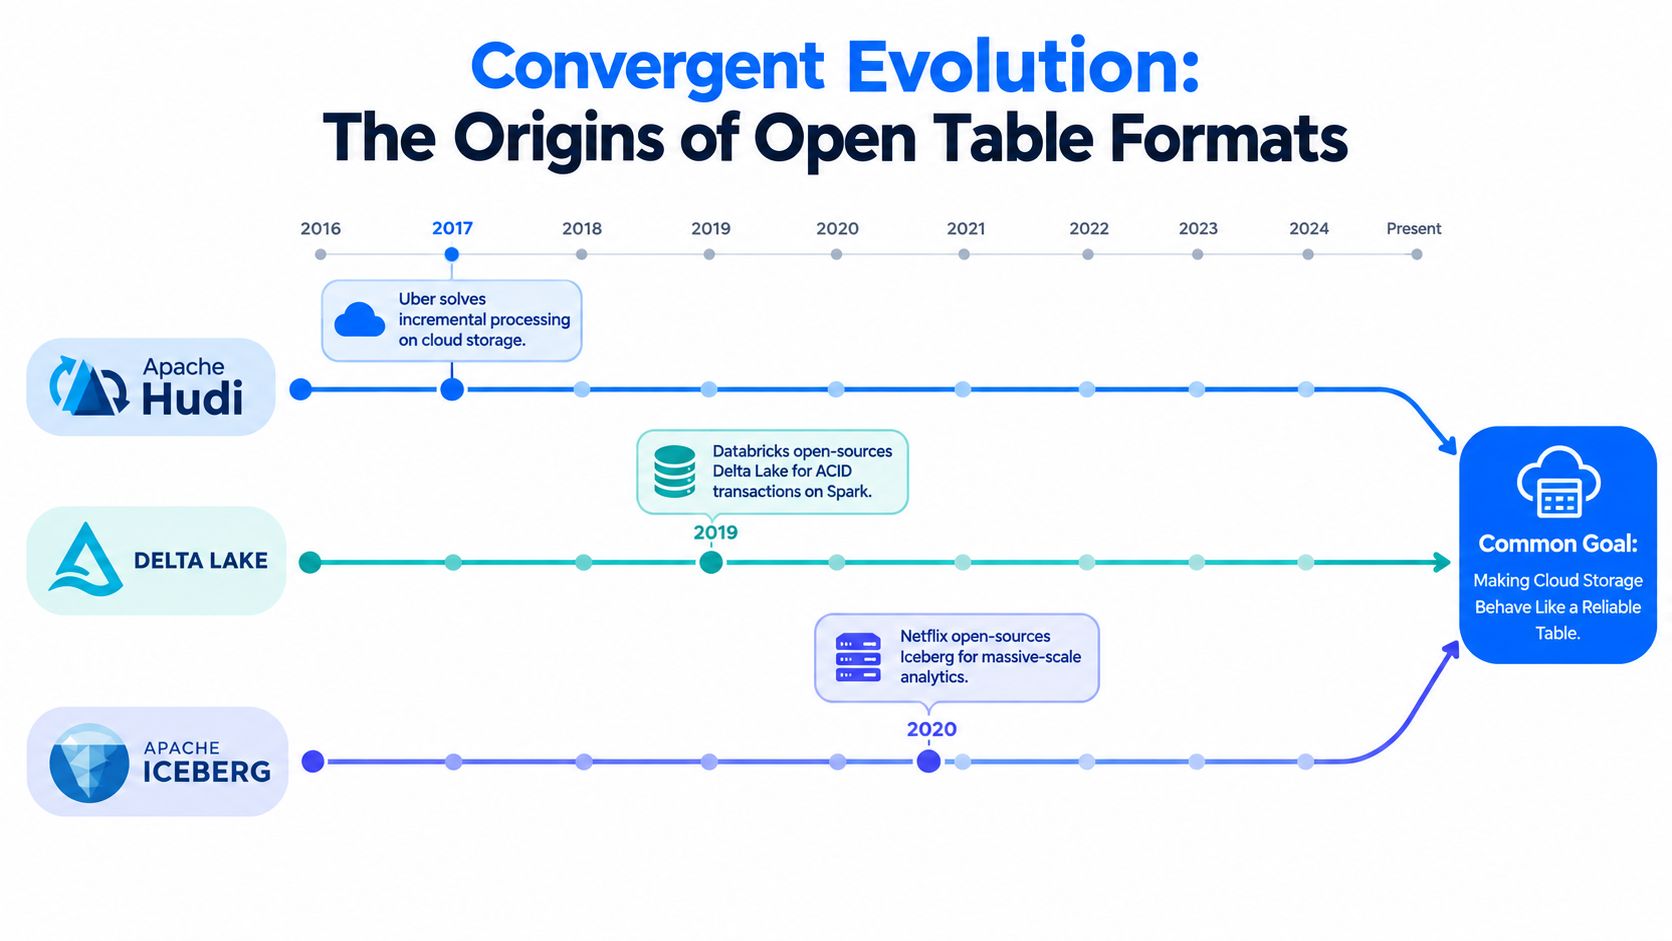
Diese Formate liefen zusammen, weil sie dasselbe Fundament über unterschiedliche Metadatenmodelle angehen. Die Entscheidung betrifft, wie Workloads Daten schreiben, welche Engines zusammenspielen müssen, wie Kataloge den Zugriff koordinieren und welches Team die Tabellenwartung verantwortet.
Diese Geschichte klärt auch die verbleibende operative Lücke. Hudis satzorientierte Stärken, Deltas Ansatz über das Transaktionslog und Icebergs manifestbasiertes Modell liefern nützliche Tabellenbausteine. Keines definiert für sich genommen unternehmensweite Lineage, fachliche Definitionen, Zugriffsrichtlinien, Reaktion auf Anomalien oder Änderungsfreigaben. Eine Observability-Schicht in der Datenbank wie digna kann diese Kontrollen mit Schemaänderungen, Timeliness und auffälligem Verhalten verbinden.
Iceberg, Delta Lake und Hudi nebeneinander vergleichen
Plattformarchitektinnen sollten Formate nach Workload-Form und Engine-Mix vergleichen, nicht nach isolierten Funktionsversprechen. Alle drei können transaktionales Tabellenverhalten, Schemabehandlung, Versionshistorie und metadatengetriebene Abfrageplanung liefern. Ihre Unterschiede werden klarer darin, wie sie Zustand darstellen und Schreibvorgänge optimieren.
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Metadatenmodell | Unveränderliche Metadatendateien, Manifestlisten, Manifeste und Snapshot-Historie | Flaches Transaktionslog unter | Zeitachsenbasierte Commits mit Metadaten und Indexstrukturen für Satzänderungen |
Partitionierungsstil | Hidden Partitioning und Partitionstransformationen, wobei Partitionsevolution als Metadatenänderung behandelt wird | Partitionsspalten plus ökosystemspezifisches Layout und Optimierungsfunktionen | Partitionsspalten, Indizes auf Satzebene und engine-gestützte Organisation für veränderliche Workloads |
Schemaevolution | Explizite Schema- und Partitionsmetadaten, mit Evolution, die Abfragen nicht an physische Partitionsspalten bindet | Schema- und Transaktionsmetadaten, gesteuert über das Delta-Protokoll und umgebende Plattformkontrollen | Schema und Commit-Zeitachse tragen Änderungen für Ingestion- und update-lastige Pipelines |
Nebenläufigkeitsgarantien | Snapshot-basierte Commits und Isolation über unveränderliche Metadatenversionen | Commits über das Transaktionslog und optimistische Koordination um den Tabellenzustand | Zeitachsen-Commits, entworfen für Inserts, Updates und Deletes |
Ökosystem-Passung | Starke Option für heterogene Engine-Umgebungen und katalogorientierte Architekturen | Natürliche Passung für Databricks- und Spark-zentrierte Plattformen, mit breiterer Interoperabilität je nach Protokollunterstützung | Starke Option für upsert-lastige Ingestion, inkrementelle Verarbeitung und Workloads, die von Indizierung auf Satzebene profitieren |
Apache Iceberg
Iceberg ist oft attraktiv, wenn viele Engines Tabellen teilen müssen und physische Partitionsspalten nicht in die Abfragelogik durchschlagen sollen. Hidden Partitioning lässt das Format Transformationen verwalten, während Abfragen sich auf logische Spalten beziehen. Seine Spezifikation trägt außerdem Partitionsevolution als reine Metadatenänderung, die bestehende Datendateien nicht sofort neu schreibt (Iceberg-Dokumentation).
Der Kompromiss ist die Metadatenpflege. Manifestdateien und Snapshot-Strukturen liefern reiche Planungsinformationen, doch kleine oder häufig veränderte Tabellen können Metadaten anhäufen, die bewusste Wartung erfordern. Iceberg passt gut, wenn Interoperabilität, Partitionsevolution und snapshot-orientierte Governance schwerer wiegen als die Einfachheit eines Ein-Anbieter-Stacks.
Delta Lake
Deltas Transaktionslog ist für Teams, die bereits Spark und Databricks betreiben, leicht nachvollziehbar. Das Log erfasst Tabellenaktionen, und Checkpoints machen die Rekonstruktion des Zustands im großen Maßstab effizienter. Diese Integration kann den Weg von bestehenden Spark-Pipelines zu transaktionalen Lakehouse-Tabellen verkürzen.
Die offene Einschränkung ist die Kopplung. Delta funktioniert im breiteren Ökosystem, doch die reibungsloseste Erfahrung hängt oft an Databricks-Protokollen, Laufzeiten, Katalogen und Optimierungspraktiken. Eine Plattform, die erwartet, dass unabhängige Engines dieselben Tabellen schreiben und steuern, sollte diese Pfade prüfen, statt Kompatibilität allein aus dem Dateilayout abzuleiten.
Apache Hudi
Hudi überzeugt bei Change-Data-Capture-Pipelines und veränderlichen Tabellen. Sein Ansatz der Indizierung auf Satzebene kann Updates und Deletes auf die passenden Dateigruppen lenken und so die Notwendigkeit breiter Suche nach Zieldatensätzen verringern. Diese Stärke bringt mehr formatspezifische Betriebskonzepte mit, darunter Indizierung, Kompaktierung und Commit-Zeitachsen.
Wählen Sie Hudi, wenn Upsert-Verhalten zentral für den Workload ist und das Team bereit ist, sein Schreib- und Wartungsmodell zu betreiben. Wählen Sie Delta, wenn Spark und Databricks der Schwerpunkt sind. Wählen Sie Iceberg, wenn Engine-Neutralität, Katalogkoordination und sich entwickelnde Partitionsstrategien die primären Anforderungen sind.
Entscheidungstest: Listen Sie die Engines auf, die dieselbe Tabelle lesen und schreiben müssen, und dann die Mutationen, Governance-Kontrollen und Rollback-Verhalten, die diese Engines brauchen. Das Format, das zu dieser Schnittmenge passt, ist wichtiger als ein allgemeines Portabilitätsversprechen.
Wo offene Tabellenformate das Problem nicht mehr lösen
Ein offenes Tabellenformat kann Ihnen sagen, dass ein Commit gelungen ist. Es kann Ihnen nicht sagen, ob die committeten Datensätze eine Geschäftsregel erfüllen.
Diese Grenze ist gewollt. Die Formatschicht verwaltet Tabellenstruktur und -zustand, nicht die Bedeutung jedes Datensatzes oder die Service-Level-Erwartungen an die Lieferung. Sie validiert nicht automatisch, dass eine Transaktion einen zulässigen Status hat, meldet keinen verspäteten Snapshot, erkennt keine unerwartete Verteilungsänderung und gleicht eine Schemaänderung nicht mit jedem nachgelagerten Vertrag ab.
Die Governance-Lücke über der Tabelle
Die Schemaevolution zeigt das Problem deutlich. Ein Tabellenformat mag eine additive Änderung erlauben, ohne bestehende Abfragen zu brechen, doch ein Produktionsteam muss weiterhin fragen, wer sie genehmigt hat, welche Konsumenten von der betroffenen Spalte abhängen, ob eine Typerweiterung das Modellverhalten ändert und ob ein Prüfpfad existiert.
Eine Databricks-Erläuterung von 2026 hebt hervor, dass leichte Schemaänderungen direkte Eingriffe in die Produktion ohne ausreichende Tests begünstigen können, während Kataloge für maßgebliche Snapshots und Zugriffskontrolle an Bedeutung gewinnen (Databricks-Diskussion zu offenen Tabellenformaten). Unabhängige Berichte aus 2026 beschreiben ebenfalls eine Lücke zwischen Struktur auf Tabellenebene und katalogweiter Lineage, Glossaren, Klassifizierung und engine-übergreifender Richtlinienverwaltung (Analyse moderner Datenarchitektur).
Teams füllen diese Lücke oft mit unverbundenen Werkzeugen:
Katalogabläufe: Auffindbarkeit von Assets und Eigentum leben in einem System.
Validierungsjobs: Fachliche Prüfungen laufen in Notebooks oder Orchestrierungsaufgaben.
Frischemonitore: Ankunftswarnungen hängen an Zeitplänen und Pipeline-Metadaten.
Vorfallsbearbeitung: Analystinnen und Engineers nutzen getrennte Dashboards, um Auswirkungen zu untersuchen.
Diese Zersplitterung macht einen Metadatenvorfall schwerer nachvollziehbar. Eine neue Spalte erscheint in einem Iceberg-Manifest, ein nachgelagertes Modell läuft weiter, ein Dashboard verändert sich, und keine einzelne Sicht verbindet das strukturelle Ereignis mit dem entstehenden Geschäftsrisiko.
Governance kann nach oben wandern, nicht verschwinden
Offene Formate senken die Bindung an den Speicher, doch Organisationen können oberhalb der Dateien weiterhin Bindung erzeugen, über Kataloge, Zugriffskontrollsysteme, Lineage-Konventionen und Betriebspraktiken. Die Herausforderung verschärft sich in Finanzwesen, Gesundheitswesen, Telekommunikation und öffentlicher Verwaltung, wo Teams einheitliche Kontrollen über Engines hinweg und Nachweise für wichtige Änderungen brauchen.
Eine Steuerungsebene muss deshalb mehr beobachten als den Dateizustand. Sie sollte Schema, Timeliness, Satzgültigkeit, Anomalien, Eigentum und nachgelagerte Abhängigkeiten verbinden und die Daten dort belassen, wo die Organisation sie ohnehin steuert.
Ein Ansatz für Data-Lake-Monitoring sollte an der Tabellengrenze beginnen und dann Metadaten und Datenverhalten nach außen in Pipelines, Konsumenten und Geschäftskontrollen verfolgen.
Wie digna die operative Lücke schließt
digna kann über Iceberg, Delta Lake und Hudi als Observability-Schicht in der Datenbank sitzen. Das nützliche Denkmodell ist kein weiteres Tabellenformat. Es ist ein Satz operativer Prüfungen, der Tabellenmetadaten und Snapshot-Verhalten in Signale für Engineers, Datenverantwortliche und Governance-Teams verwandelt.
Mit struktureller Veränderung beginnen
Schema Tracker beobachtet strukturelle Metadaten und erkennt hinzugefügte Spalten, entfernte Spalten und Datentypänderungen. Für eine offene Tabelle heißt das, Änderungen in Iceberg-Metadatendateien, Delta-Transaktionslogeinträgen oder Hudi-Commit-Informationen mit den Verantwortlichen und Konsumenten in Beziehung zu setzen, die von der Tabelle abhängen.
Ein Schemaereignis sollte nicht automatisch zum Vorfall werden. Die wichtige Frage ist, ob die Änderung mit den Verträgen der Tabelle vereinbar ist. Ein neues, nullable Attribut mag akzeptabel sein, während ein entfernter Identifikator oder eine inkompatible Typänderung Freigabe und nachgelagerte Tests erfordern kann.
Liefer- und Satzverhalten ergänzen
Timeliness vergleicht die tatsächliche Snapshot-Ankunft mit erwarteten Liefermustern und Service-Level-Erwartungen. Sie kann verspätete Partitionen, fehlende Ladevorgänge und verfrühte Lieferungen melden, was Teams hilft, einen erfolgreichen Commit von einer erfolgreichen Lieferung des Datenprodukts zu unterscheiden.
Data Anomalies profiliert neue Snapshots, um ungewöhnliche Volumenänderungen, Null-Verhalten und Verteilungsverschiebungen sichtbar zu machen. Das ergänzt Statistiken auf Dateiebene. Metadaten können einer Query-Engine beim Pruning helfen, doch Observability fragt, ob die frisch committeten Daten für ihren fachlichen Kontext normal aussehen.
Data Validation wendet Regeln auf Satzebene und Schemaverträge an. Diese Prüfungen können Bedingungen wie gültige Beziehungen, zulässige Werte oder Prüfanforderungen durchsetzen, bevor Konsumenten einen Snapshot als bereit behandeln.
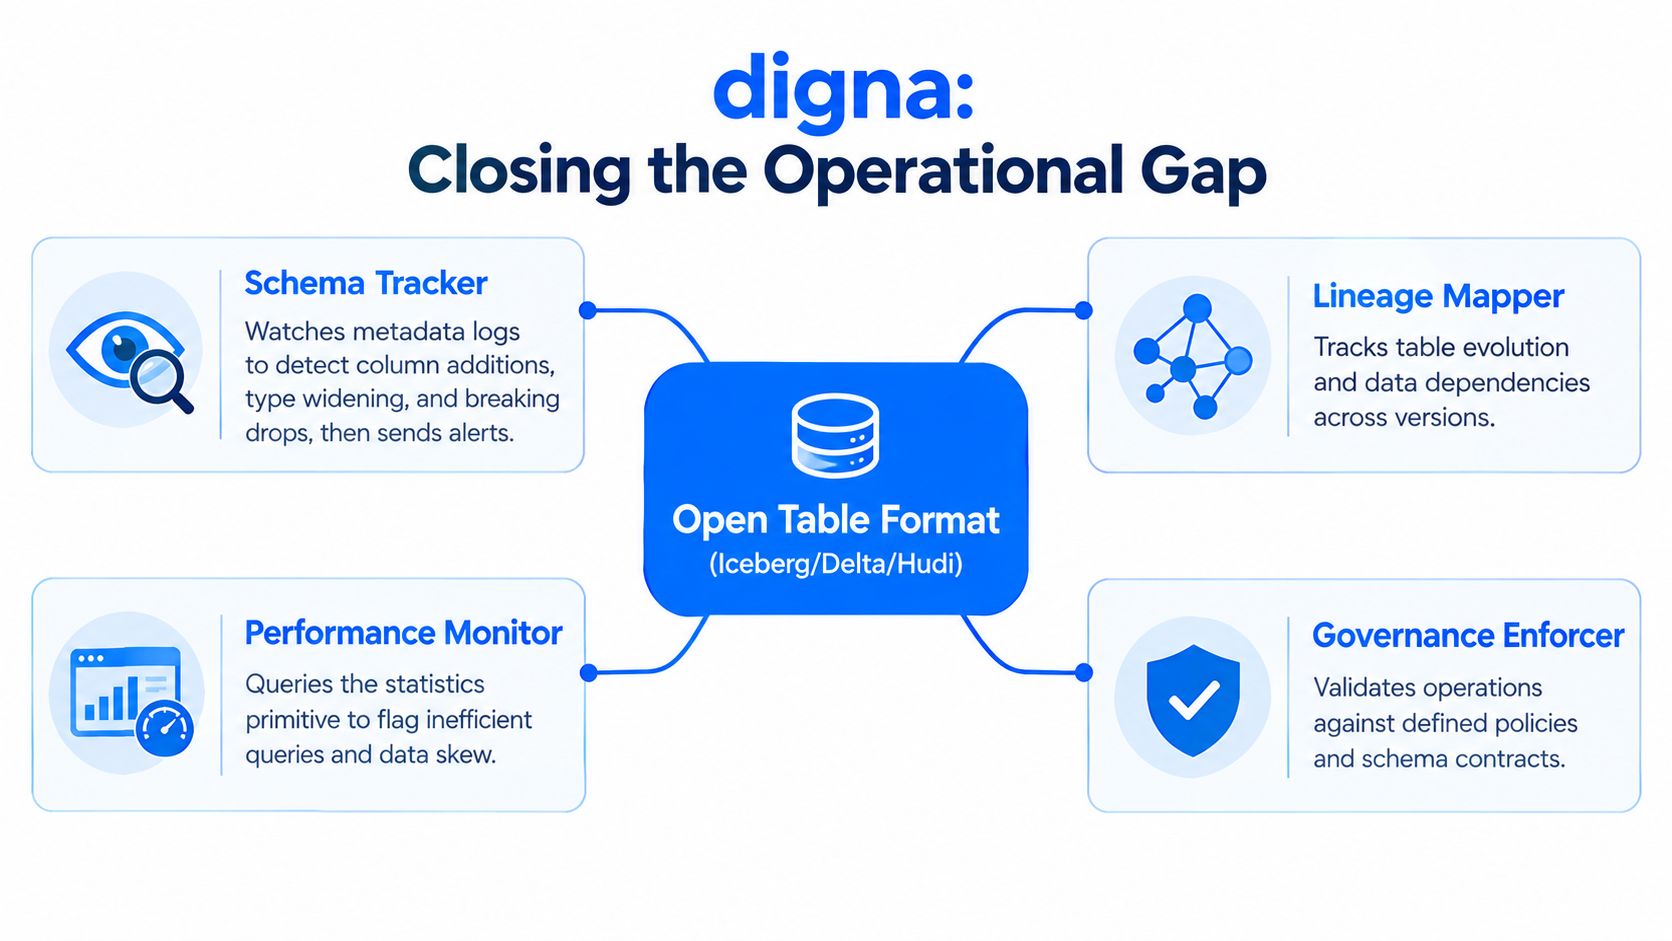
Vorfälle mit der Plattformgesundheit verbinden
Data Platform Observability bringt Pipeline-Gesundheit, Lineage, Frische, Nutzung und Plattformverhalten in eine operative Sicht. Ändert eine vorgelagerte Iceberg-Tabelle ihr Schema, kann das Team dieses Ereignis zu betroffenen Dashboards oder Modellen verfolgen, statt getrennt Speicherprotokolle, Orchestrierungshistorie und BI-Warnungen zu durchsuchen.
dignas Ausführungsmodell in der Datenbank hält Kennzahlenberechnung und Analyse innerhalb der Datenbanken der Kundin oder des Kunden. Das Bereitstellungsmodell unterstützt Private-Cloud- und On-Premises-Umgebungen, was zählen kann, wenn regulierte Daten nicht in einen externen Monitoring-Dienst kopiert werden dürfen.
Die architektonische Grenze bleibt klar. Iceberg, Delta oder Hudi besitzt Tabellenzustand und Metadaten. digna überwacht, ob dieser Zustand strukturell sicher, pünktlich, gültig und erwartungsgemäß ist.
Ein praktischer Weg zu Einführung und Migration
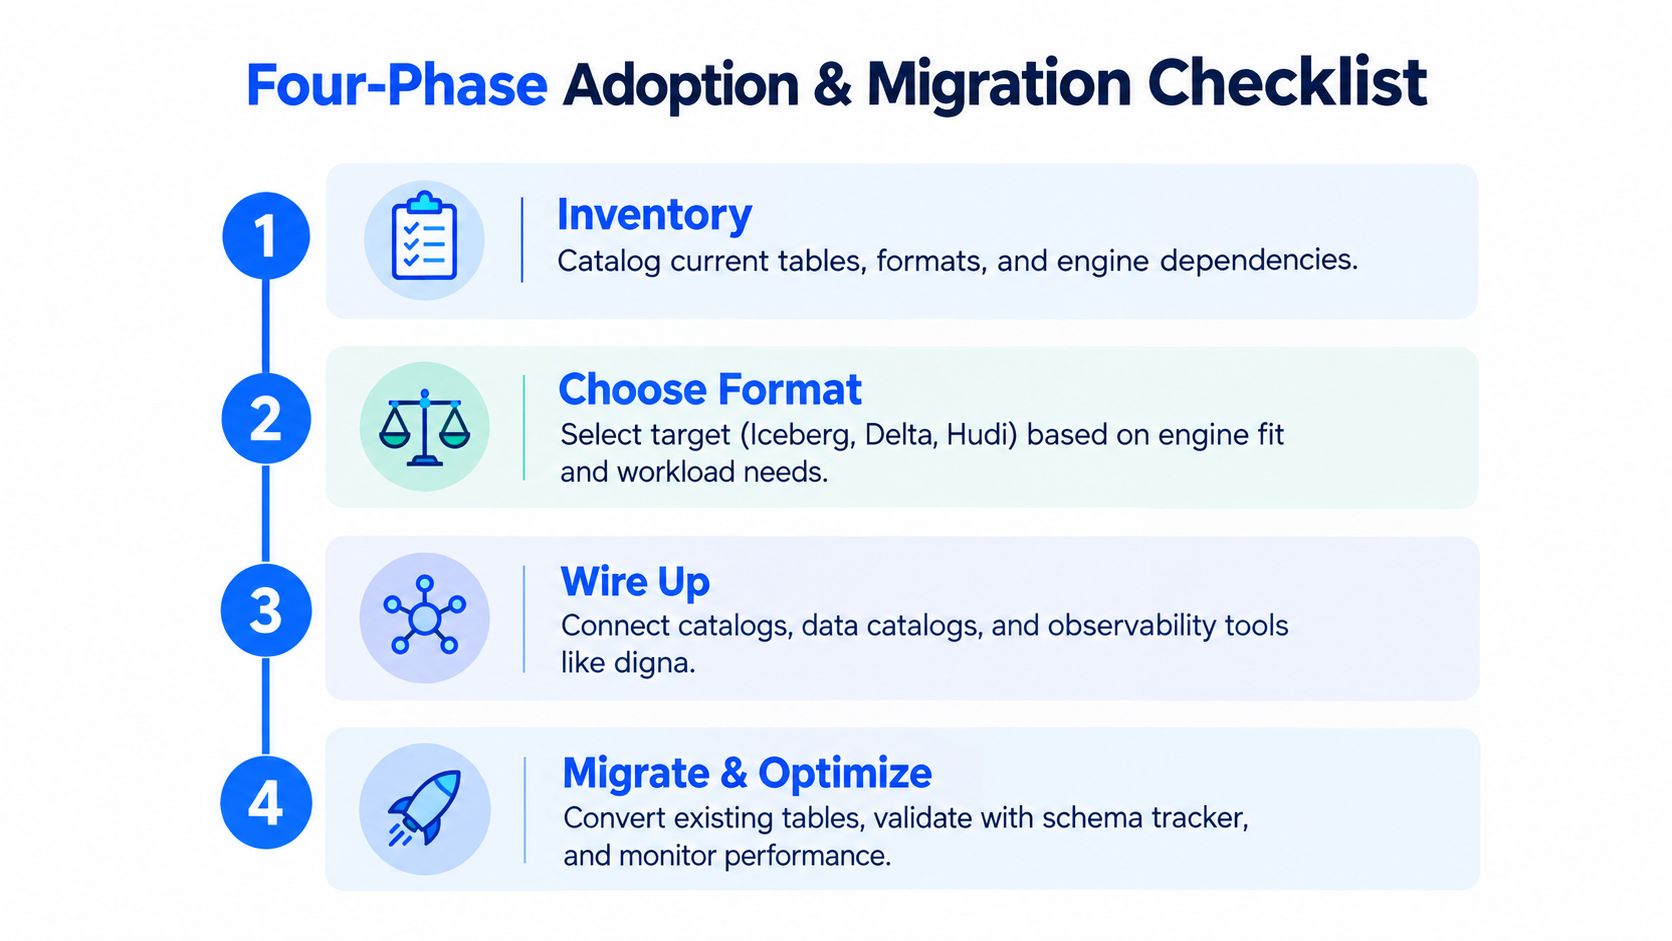
Migration gelingt am besten als kontrollierte Abfolge, nicht als Massenkonvertierung. Behandeln Sie jede Tabelle als Produkt mit einem Speicherformat, einer Katalogidentität, einer Menge an Konsumenten und operativen Erwartungen.
Phase eins: die Landschaft inventarisieren
Listen Sie aktuelle Tabellen, Dateiformate, Schreibmuster, Partitionsschemata, Engine-Abhängigkeiten und nachgelagerte Konsumenten auf. Bestimmen Sie, welche Tabellen nur angehängte Daten erhalten, welche Updates oder Deletes brauchen und welche von mehr als einer Engine gelesen werden.
Dieses Inventar legt die tatsächlichen Entscheidungskriterien offen. Eine Tabelle, die nur Spark nutzt, hat einen anderen Migrationspfad als eine, die von Flink geschrieben, von Trino abgefragt und von einem Warehouse konsumiert wird.
Phase zwei: das Ziel wählen
Wählen Sie Iceberg, Delta Lake oder Hudi nach Engine-Passung, Mutationsmustern, Partitionsbedarf, Katalogverhalten und den Betriebsfähigkeiten des Teams. Finanzteams priorisieren womöglich transaktionale Konsistenz und Schemadurchsetzung. Handels-Pipelines bevorzugen womöglich Hidden Partitioning und Upserts aus Streaming-CDC. SaaS-Analytics-Plattformen gewichten womöglich Lesevorgänge über mehrere Engines stärker.
Das Format ist nur eine Entscheidung. Legen Sie fest, welcher Katalog die Tabellenidentität definiert, wie Engines Tabellen finden, wer Schemaänderungen genehmigt und wie Rollback funktioniert.
Phase drei: Kontrollen vor der Umstellung verdrahten
Verbinden Sie Katalog, Validierungsabläufe, Eigentumsnachweise und Observability, bevor Produktionsverkehr umzieht. Führen Sie parallele Lesevorgänge aus der Altsystem-Tabelle und dem Iceberg-, Delta- oder Hudi-Ziel aus. Vergleichen Sie Schema und Ergebnisse auf Zeilenebene mit Data Validation und setzen Sie dann Schranken für Frische und Anomalieverhalten.
Ein Rahmenwerk für die Planung von Datenmigrationen sollte Rollback-Kriterien, Dauer der Schattenlesevorgänge, Freigabe durch Konsumenten und Aufbewahrung von Nachweisen enthalten. Warten Sie nicht auf das erste kaputte Dashboard, um festzustellen, dass niemand die neue Tabelle verantwortet.
Phase vier: Tabelle für Tabelle migrieren
Konvertieren Sie eine begrenzte Tabelle, validieren Sie Lese- und Schreibvorgänge, beobachten Sie das Metadatenwachstum und das Abfrageverhalten. Halten Sie den alten Pfad verfügbar, bis Gleichstand und operative Schwellen erreicht sind, und ziehen Sie Konsumenten dann stufenweise um.
Die Formatwahl zählt, doch Metadatendisziplin zählt mehr. Eine gut gesteuerte Hudi-Tabelle kann für ihren Workload ein schlecht gepflegtes Iceberg-Deployment übertreffen, so wie eine sorgfältig betriebene Delta-Landschaft schlecht zu einer Organisation passen kann, die unabhängige Engines und Kataloge braucht.
Wählen Sie das Format, das zu Ihrem Workload passt, aber entwerfen Sie die Governance-Schicht zugleich. Genau das macht aus offenem Speicher eine verlässliche Lakehouse-Tabelle.
digna überwacht Schemaänderungen, Snapshot-Timeliness, Satzgültigkeit und auffälliges Datenverhalten in Ihrer eigenen Umgebung und gibt Teams eine operative Schicht über Iceberg, Delta Lake und Hudi. Besuchen Sie digna, um zu bewerten, wie die modularen Observability- und Validierungsfähigkeiten Ihre Migration auf offene Tabellen unterstützen können.
Wo das Format aufhört, beginnen Prüfungen auf Geschäftsebene — Business Monitoring beobachtet, ob die Zahlen, die eine Tabelle erzeugt, sich weiterhin erwartungsgemäß verhalten.
Häufig gestellte Fragen
Ist die Vermeidung von Anbieterbindung der Hauptgrund für ein offenes Tabellenformat?
Dieser Grund ist unvollständig. Dateiportabilität zählt, doch die größere Verschiebung ist, dass die Bedeutung der Tabelle — Transaktionshistorie, Schemaabsicht und Metadaten zur Abfrageplanung — aus einer einzelnen Engine in Dateien wandert, die jeder lesen kann. Bindung ist das Symptom; wo die Definition der Tabelle liegt, ist die eigentliche Veränderung.
Welche Bausteine teilen Iceberg, Delta Lake und Hudi?
Alle drei führen ein unveränderliches Commit-Log, ein Manifest, das beschreibt, welche Dateien zu welcher Version gehören, Statistiken je Datei für das Pruning und einen Schemaeintrag, der sich unabhängig von den Datendateien entwickelt. Die Unterschiede liegen darin, wie jedes diese Struktur schreibt und verdichtet, nicht im zugrunde liegenden Konzept.
Wie unterscheiden sich die drei Formate in der Praxis?
Iceberg hat die breiteste Engine-Unterstützung und den engine-neutralsten Entwurf. Delta Lake läuft am tiefsten in Spark- und Databricks-Landschaften. Hudi optimiert auf häufige Upserts und inkrementellen Konsum. Der ehrliche Vergleich dreht sich darum, um welches Schreibmuster jedes gebaut wurde, nicht darum, welches mehr Funktionen auflistet.
Wo hören offene Tabellenformate auf, das Problem zu lösen?
An der Grenze zwischen Struktur und Bedeutung. Das Format kann garantieren, dass jede Engine dieselben committeten Zeilen unter demselben Schema liest; es kann Ihnen nicht sagen, dass diese Zeilen vollständig sind, pünktlich ankamen oder sinnvolle Werte enthalten. Diese Lücke ist der Ort für Qualitätsüberwachung.
Wie sieht ein realistischer Einführungsweg aus?
Wählen Sie eine Tabelle mit klarer Verantwortung und bekanntem Abfragemuster, konvertieren Sie sie, während das Original weiterläuft, und vergleichen Sie Ergebnisse über einen vollen Geschäftszyklus, bevor Sie Konsumenten umziehen. Weisen Sie Wartung — Kompaktierung, Snapshot-Ablauf, Katalog-Upgrades — vor dem Ende des Piloten zu, sonst wird sie niemandes Aufgabe.



