Offenes Tabellenformat: der vollständige Leitfaden 2026
|
8
min. Lesezeit

Apache Iceberg wird von 58 % der Organisationen für geschäftskritische Analytik genutzt, während 95 % es für KI- und Machine-Learning-Workloads einsetzen oder das planen. Ein offenes Tabellenformat ist eine Spezifikationsschicht über spaltenorientierten Dateien, die Engines eine einheitliche, versionierte Sicht auf Dateien, Schema und Partitionen einer Tabelle gibt, sodass verschiedene Werkzeuge dieselben Daten mit transaktionalen Garantien lesen und schreiben können.
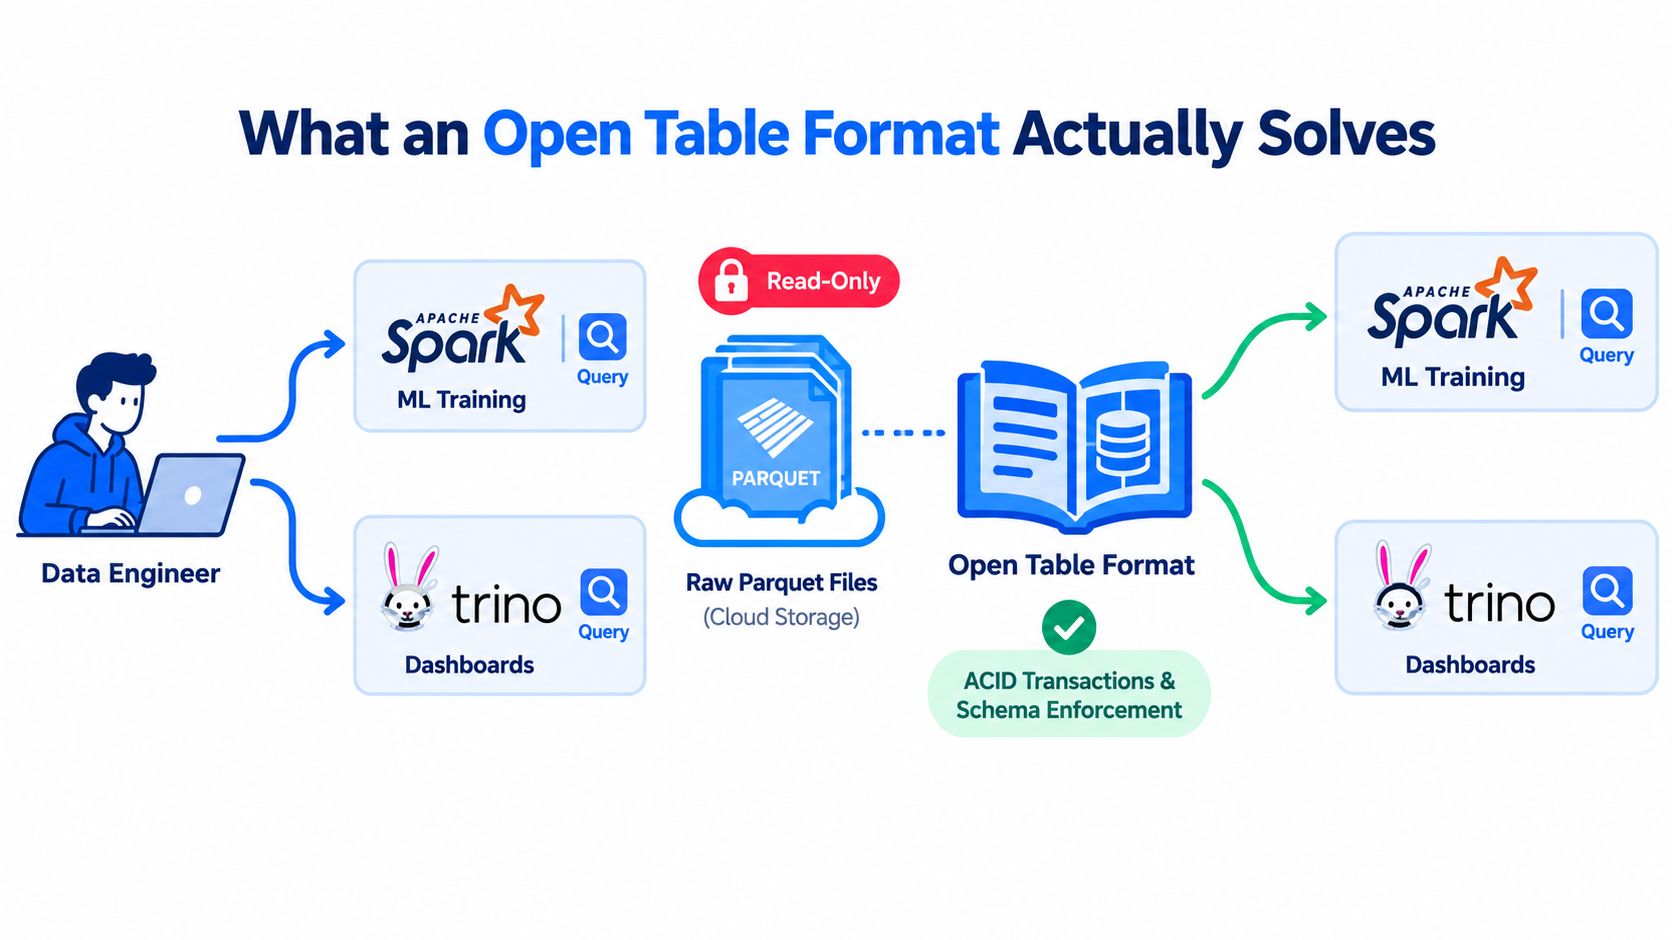
Vielleicht stecken Sie schon mitten in diesem Problem. Ein Vertriebsdatensatz liegt als Parquet-Dateien im Cloud-Objektspeicher. Spark braucht ihn für das Training von Machine-Learning-Modellen, Trino für Dashboards, und eine Pipeline schreibt noch neue Partitionen, während Analystinnen die Daten von gestern abfragen. Die Dateien sind günstig und lesbar, doch die Tabelle selbst hat keinen verlässlichen gemeinsamen Vertrag, solange Sie keinen hinzufügen.
Dieser Vertrag ist das offene Tabellenformat. Es ersetzt weder Parquet noch Ihre Query-Engines. Es ergänzt die Metadaten, die Transaktionsverwaltung, die Schemaregeln und die Tabellenhistorie, die nötig sind, damit dateibasierter analytischer Speicher sich wie eine verwaltete Tabelle verhält.
Inhaltsverzeichnis
Was ein offenes Tabellenformat tatsächlich löst
Der fehlende Vertrag
Was es nicht löst
Die Kernkonzepte hinter der Spezifikation
Transaktionale Metadaten als Hauptindex
Partitionierung als Gruppierungsregel des Katalogs
Schemaevolution als Kataloghistorie
Snapshots als Ausgaben zu einem Zeitpunkt
Wie Iceberg, Delta Lake und Hudi dasselbe Problem angehen
Nutzen, Kompromisse und workload-getriebene Auswahl
Wo sich der Nutzen zeigt
Wo die Kompromisse bleiben
Bewährte Praktiken für den Betrieb offener Tabellenformate im Unternehmensmaßstab
Den Katalog als Produktionsinfrastruktur behandeln
Partitionierung soll echte Fragen beantworten
Snapshots begrenzen
Betriebssignale beim Schreiben erzeugen
Observability- und Integrationsmuster für produktive Lakehouses
Vier Signale, die zusammengehören
Details zu Integration und Bereitstellung
Bereitstellung und Betrieb in regulierten Umgebungen
Kontrollen, die vor der Produktion geklärt sein müssen
Eine praktische Checkliste, bevor Sie sich auf ein Format festlegen
Was ein offenes Tabellenformat tatsächlich löst
Ein Data Engineer kann partitionierte Vertriebsdaten in den Objektspeicher legen und Spark auf das Verzeichnis richten. Trino kann dieselben Parquet-Dateien oft ebenfalls lesen. Die erste Abfrage mag funktionieren, doch das Betriebsmodell wird brüchig, sobald mehrere Writer, wechselnde Schemata und nebenläufige Reader ins Spiel kommen.
Rohdateien sagen nicht jeder Engine, welche Dateien zur logischen Tabelle gehören. Ein Verzeichnisname mag eine Tabellenidentität nahelegen, doch er hält nicht verlässlich fest, ob eine Datei aktuell, ersetzt, unvollständig oder von einem fremden Prozess erzeugt ist. Partitionsordner liefern zudem keine allgemeingültige Historie darüber, wie sich das Layout der Tabelle verändert hat.
Der fehlende Vertrag
Ein offenes Tabellenformat liegt neben den Datendateien und hält die Informationen fest, über die Engines sich einig sein müssen:
Tabellenidentität: Die logische Tabelle hat eine stabile Definition, unabhängig von einer einzelnen Engine oder einem Verzeichnisscan.
Dateiinventar: Metadaten benennen die Datendateien, die zur Tabelle gehören, und jene, die nicht mehr gelesen werden sollen.
Partitionslayout: Die Tabelle hält fest, wie Zeilen organisiert sind, sodass Engines irrelevante Daten überspringen können.
Schemahistorie: Hinzugefügte, entfernte, umbenannte und verträgliche Spaltenänderungen werden Teil der verwalteten Tabellendefinition.
Atomare Snapshots: Reader können eine konsistente Version wählen, während ein Writer eine neue Version committet.
Das Ergebnis ist eine gemeinsame Spezifikation. Spark kann die Tabelle für die ML-Aufbereitung nutzen, Trino kann interaktives SQL bedienen, und beide lösen denselben logischen Zustand auf, statt ihn unabhängig aus einer Ordnerstruktur zu erraten.
Was es nicht löst
Ein offenes Tabellenformat erzeugt nicht automatisch gute Datenmodelle, sinnvolle Partitionen, schnelle Abfragen oder vertrauenswürdige Geschäftswerte. Es kann Konsistenz auf Tabellenebene schützen, doch Teams müssen weiterhin entscheiden, wie Daten geschrieben, validiert, kompaktiert, gesteuert und überwacht werden.
Diese Unterscheidung verhindert einen verbreiteten Architekturfehler. Das Format ist das Fundament unter dem Betriebsmodell, nicht das Betriebsmodell selbst.
Die Kernkonzepte hinter der Spezifikation
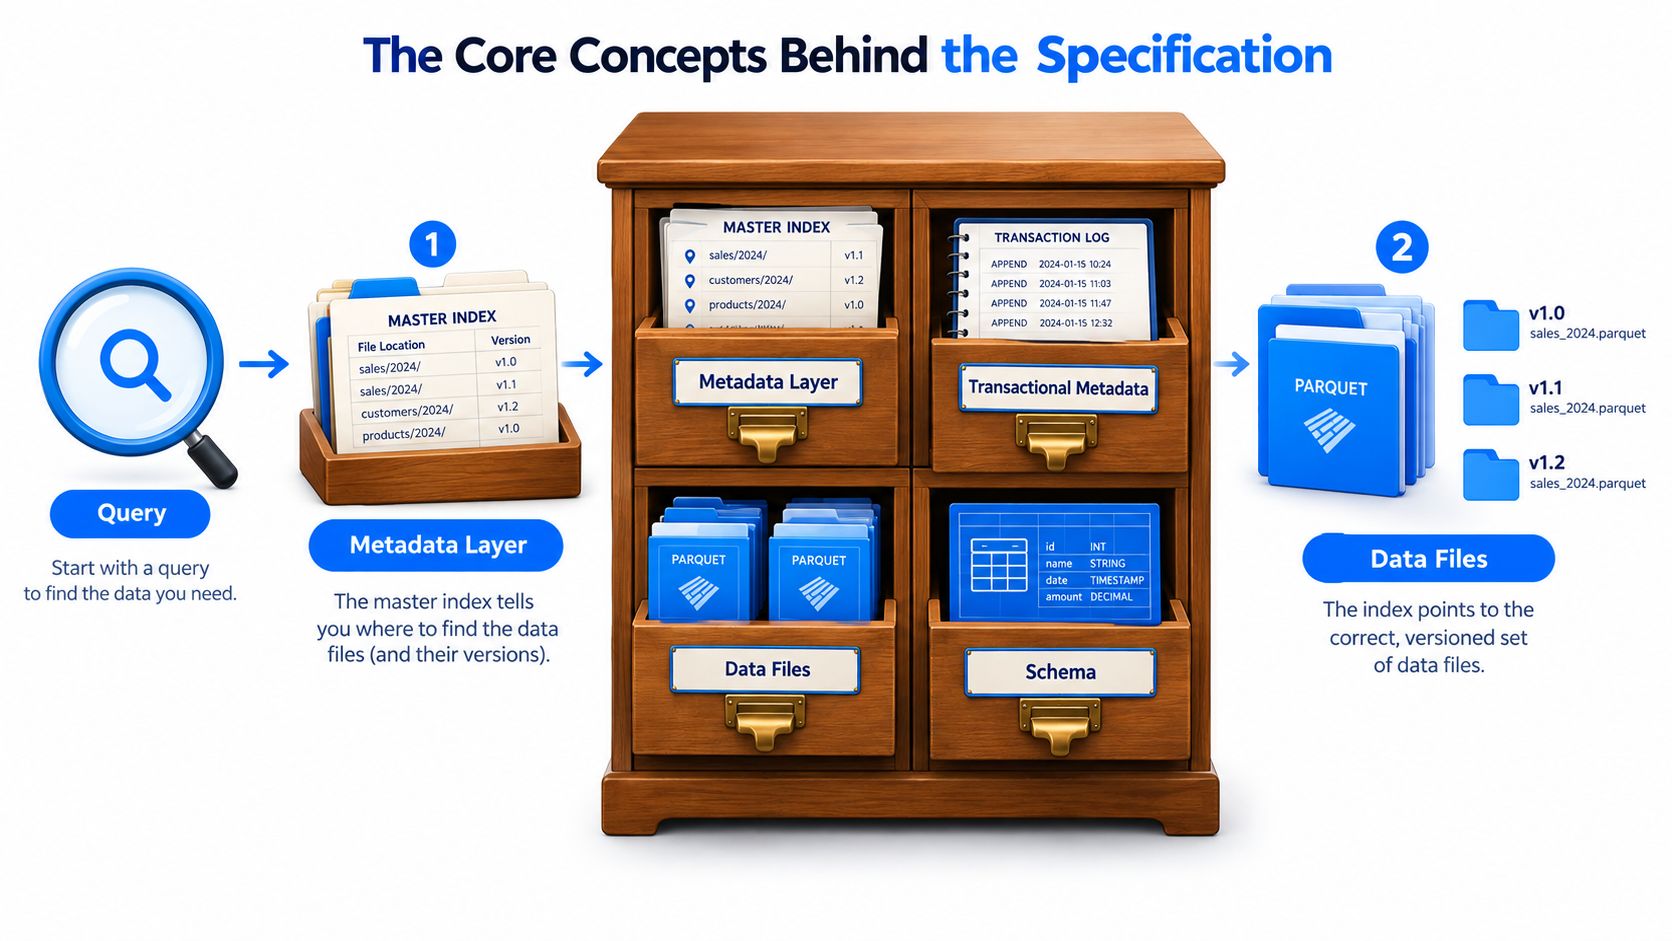
Ein Bibliothekskatalog macht die Metadatenschicht anschaulicher. Die Bücher sind Ihre Parquet-Datendateien. Der Katalog ist die Tabellenspezifikation. Wer etwas sucht, sieht zuerst in den Karten nach und geht dann zu den Regalen mit den gewünschten Büchern.
Transaktionale Metadaten als Hauptindex
Die Metadatenschicht hält fest, welche Dateien zur Tabelle gehören und wie diese Dateien zu einem Tabellen-Snapshot stehen. Statt Spark oder Trino jeden Pfad im Objektspeicher prüfen zu lassen, folgt die Engine dem verwalteten Index der Tabelle.
Denken Sie an eine Katalogkarte mit dem Hinweis: „Diese Regale enthalten die aktuelle Ausgabe der Vertriebssammlung.“ Ersetzt ein Writer ältere Dateien durch frisch kompaktierte, ändert der Katalog das aktive Inventar als einen einzigen Commit. Reader müssen nicht erschließen, ob sie eine vollständige Aktualisierung gesehen haben.
Das ist der praktische Zweck von Metadatenmanagement. Metadaten sind keine schmückende Dokumentation. Sie steuern die Planung, tragen konsistente Lesevorgänge und geben Betreiberinnen eine Aufzeichnung darüber, wie sich die Tabelle verändert hat.
Partitionierung als Gruppierungsregel des Katalogs
Eine Partitionsregel gruppiert zusammengehörende Daten, damit eine Engine das Scannen unbeteiligter Dateien vermeiden kann. Sind Vertriebsdaten entlang eines zeitlichen oder regionalen Zugriffsmusters organisiert, kann eine Abfrage mit passendem Filter ihren Scanbereich verengen.
Die Regel muss zu echten Workloads passen. Ein Partitionsentwurf, der abbildet, wie Dashboards filtern, kann unnötige Lesevorgänge senken, während ein Entwurf auf Basis eines ungeeigneten oder zu feinkörnigen Attributs Betriebsaufwand und viele kleine Dateien erzeugen kann.
Schemaevolution als Kataloghistorie
Ein Schema ist die Beschreibung des Katalogs, was in jedem Buch steht. Fügt eine Pipeline eine Spalte hinzu, benennt eine um oder ändert einen Typ, kann das Tabellenformat diese Änderung festhalten, statt jede Engine sie eigenständig entdecken zu lassen.
Diese Historie zählt, wenn alte und neue Dateien nebeneinander bestehen. Ein Reader braucht Regeln, um beide Versionen zu deuten, und eine Pipeline braucht ein klares Fehlerverhalten, wenn eine Änderung unverträglich ist. Schemaevolution verringert stilles Auseinanderlaufen, entscheidet aber nicht, ob eine neue Spalte fachlich korrekt ist.
Snapshots als Ausgaben zu einem Zeitpunkt
Ein Snapshot ist eine konsistente Version der Tabelle. Er verbindet die Tabellenmetadaten mit der Menge an Datendateien, die Reader zu diesem Zeitpunkt nutzen sollen. Die Dokumentation von Apache Iceberg beschreibt Time Travel als Weg, reproduzierbare Abfragen gegen einen bestimmten Snapshot auszuführen, während die Spezifikation Snapshots im Tabellenmetadaten-JSON ablegt und nicht als eigene serialisierte Objekte. Siehe die Apache-Iceberg-Dokumentation und die Iceberg-Spezifikation für das zugrunde liegende Modell.
Zusammen lassen diese vier Konzepte Spark und Trino aus derselben katalogisierten Sammlung arbeiten. Eine Engine kann eine neue Ausgabe schreiben, während eine andere eine stabile frühere Ausgabe liest, abhängig vom Transaktionsverhalten des Formats und der Katalogimplementierung.
Wie Iceberg, Delta Lake und Hudi dasselbe Problem angehen
Apache Iceberg, Delta Lake und Apache Hudi ergänzen dateibasierten analytischen Speicher allesamt um Tabellenverwaltung, doch ihre Entstehungsgeschichten prägen, wie Teams sie einsetzen. Iceberg begann 2017 bei Netflix, wurde 2018 an die Apache Software Foundation gespendet und im Mai 2020 zum Top-Level-Projekt. Sein Entwurf betont engine-neutrale Tabellenmetadaten und breite Interoperabilität über Systeme wie Spark, Trino, Flink, Hive und Impala hinweg, wie das Apache-Iceberg-Projekt beschreibt.
Delta Lake nutzt Parquet-Datendateien zusammen mit einem Transaktionslog im Verzeichnis _delta_log. Das Log enthält geordnete JSON-Einträge und regelmäßige Parquet-Checkpoints, und ein Tabellen-Snapshot entsteht, indem das Log bis zu einer gewählten Version gelesen wird, so das Forschungspapier zu Delta Lake. Dieses Modell macht das Transaktionslog zur zentralen Instanz für den Tabellenzustand.
Hudi wird besonders mit inkrementeller Ingestion, Upserts, Deletes und nahezu echtzeitfähigen Datenpipelines verbunden. Seine Ansätze Copy-on-Write und Merge-on-Read stehen für unterschiedliche Kompromisse zwischen Leseeinfachheit und Schreib- oder Ingestionsverhalten. Hudi legt außerdem mehr Gewicht auf Indizierungsmuster auf Satzebene, um Updates zu lenken.
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Entwurfsschwerpunkt | Engine-neutrale analytische Tabellen und portable Metadaten | Transaktionale Parquet-Tabellen rund um ein geordnetes Log | Inkrementelle Schreibvorgänge, Upserts, Deletes und Streaming-Ingestion |
Tabellenzustand | Metadaten verweisen auf Snapshots, Manifeste und Datendateien |
| Zeitachse und Metadatenstrukturen verfolgen Tabellen-Commits und Dateigruppen |
Partitionierung | Unterstützt die Evolution des Partitionslayouts, wenn sich Abfragemuster ändern | Nutzt partitionierte Daten mit engine-spezifischen Optimierungsoptionen | Nutzt Partitionierung zusammen mit Indizierung und der Wahl des Schreibmodus |
Schemaevolution | Verwaltet über Tabellenmetadaten und Schema-IDs | Verwaltet über Tabellen- und Transaktionslogregeln | Verwaltet über Tabellenmetadaten und Writer-Konfiguration |
Snapshot-Isolation | Reader lösen einen konsistenten Metadaten-Snapshot auf | Reader lösen eine Tabellenversion aus dem Transaktionslog auf | Reader nutzen die Hudi-Zeitachse und den gewählten Commit-Zustand |
Typische Stärke | Analytischer Zugriff über gemischte Engines | Databricks-zentrierte transaktionale Lakehouse-Abläufe | Häufige inkrementelle Änderungen und Ingestion auf Satzebene |
Operativer Schwerpunkt | Katalog, Manifeste, Planung und Metadatenpflege | Log-Aufbewahrung, Checkpoints, Kompaktierung und Plattformintegration | Kompaktierung, Indizierung, Clustering und Verwaltung der Schreibmodi |
Der Vergleich ist keine Funktionsliste. Er ist ein Hinweis auf den Betriebsstil. Iceberg passt oft zu einer Plattform, auf der mehrere Engines Tabellen teilen müssen. Delta kann eine natürliche Wahl sein, wenn Databricks- und Spark-orientierte Abläufe dominieren. Hudi verdient eine genaue Prüfung, wenn fortlaufende Upserts und inkrementelle Verarbeitung wichtiger sind als breite Leseinteroperabilität.
Was Sie auch wählen, Datenqualität bleibt eine eigene Verantwortung. Eine Plattform kann Commits und Schemaregeln verwalten und dennoch falsche Werte akzeptieren, deshalb gehören Praktiken zur Datenqualität in Databricks in das Architektur-Review und nicht erst hinter die Inbetriebnahme.
Nutzen, Kompromisse und workload-getriebene Auswahl
Die Formatwahl sollte beim Workload beginnen, nicht bei einer allgemeinen Vorliebe. In einem Vergleich im Stil von TPC-DS lagen Iceberg und Delta bei mehreren leselastigen Abfragen nahe beieinander, während Hudi bei denselben Workloads langsamer war. Die interaktive Abfrage 19 lief in 1,45 Sekunden auf Iceberg, 1,38 Sekunden auf Delta und 2,92 Sekunden auf Hudi, während die Reporting-Abfrage 27 8,70 Sekunden auf Iceberg, 8,45 Sekunden auf Delta und 12,10 Sekunden auf Hudi brauchte. Für tiefe Analytik brauchte Abfrage 64 184,20 Sekunden auf Iceberg, 181,90 Sekunden auf Delta und 210,50 Sekunden auf Hudi, wie in diesem Benchmark zu offenen Tabellenformaten berichtet.
Diese Ergebnisse begründen keinen dauerhaften Sieger. Sie zeigen, warum repräsentative Dashboards, Joins, Filter, Schreibvorgänge und Wartungsoperationen mehr zählen als ein einzelner plakativer Benchmark.
Workload-Muster | Empfohlenes Format | Entscheidender Faktor |
|---|---|---|
Häufige Streaming-Upserts und inkrementelle Änderungen | Apache Hudi | Ingestionsverhalten auf Satzebene, Umgang mit Updates und die Wahl zwischen Merge-on-Read und Copy-on-Write |
Analytische Lesevorgänge über gemischte Engines | Apache Iceberg | Portabilität über Engines hinweg und Katalogintegration |
Databricks-zentrierte Lakehouse-Abläufe | Delta Lake | Integration des Transaktionslogs und enge Plattformabstimmung |
Interaktive BI und SQL-Dashboards | Iceberg oder Delta nach Tests | Effizienz des Lesepfads, Planungsaufwand und tatsächliches Dashboard-Verhalten |
KI- und ML-Datensätze, die über Werkzeuge hinweg geteilt werden | Workload-abhängig | Engine-Kompatibilität, Governance, Reproduzierbarkeit und Zugriffsmuster beim Training |
Wo sich der Nutzen zeigt
Interoperabilität erlaubt Teams, einen gesteuerten Datensatz aus mehreren Engines zu nutzen, statt für jeden Konsumenten Kopien zu pflegen. Transaktionale Commits schützen Reader vor Teilschreibvorgängen und helfen Pipelines, vollständige Tabellenzustände zu veröffentlichen. Katalogmetadaten tragen Berechtigungen, Auffindbarkeit, Lineage und Auditabläufe, wenn der Katalog als echter Plattformdienst behandelt wird.
Offene Tabellen können auch die KI-Bereitschaft stützen. Trainingspipelines profitieren, wenn historische Zustände reproduzierbar sind und dieselben gesteuerten Daten für Aufbereitung, Evaluierung und analytische Workloads bereitstehen.
Wo die Kompromisse bleiben
Die Katalogabhängigkeit erzeugt ein reales Ausfallmuster. Ist der Katalog oder der Metadatendienst nicht verfügbar, können Lese- und Schreibvorgänge stoppen, selbst wenn die zugrunde liegenden Dateien im Objektspeicher bleiben. Tabellenübergreifende Transaktionen und Fremdschlüsselverhalten entsprechen nicht einer klassischen relationalen Datenbank, und aktuelle Darstellungen betonen, dass ACID-Garantien in der Regel auf einzelne Tabellen begrenzt sind.
Auch der Betrieb geht nach dem ersten erfolgreichen Schreibvorgang weiter. Kompaktierung, Snapshot-Ablauf, Bereinigung verwaister Dateien, Partitionspflege und Schemaprüfung brauchen alle Verantwortliche. Das Format verringert Mehrdeutigkeit, doch es nimmt weder Plattformarbeit ab noch erzwingt es fachliche Korrektheit.
Bewährte Praktiken für den Betrieb offener Tabellenformate im Unternehmensmaßstab
Die Spezifikation gibt Ihnen ein verlässliches Vokabular für den Tabellenzustand. Sie liefert nicht die Betriebsdisziplin, die nötig ist, um diesen Zustand gesund zu halten. Vier Praktiken verdienen klare Verantwortlichkeit, bevor produktive Workloads eintreffen.
Den Katalog als Produktionsinfrastruktur behandeln
Der Metastore, REST-Katalog oder einheitliche Governance-Katalog ist eine Steuerungsebene. Geben Sie ihm Verfügbarkeitsziele, Zugriffsprüfungen, Prüfpfade, Sicherungsverfahren und ein Vorfalls-Runbook. Eine Tabelle mag im Objektspeicher liegen, doch Engines hängen weiterhin vom Katalog ab, um Identität, Metadaten, Berechtigungen und aktuellen Zustand aufzulösen.
Praktische Regel: Würde ein Katalogausfall die analytische Arbeit stoppen, überwachen und stellen Sie ihn wieder her wie eine Datenbank-Steuerungsebene, nicht wie eine Konfigurationsdatei.
Partitionierung soll echte Fragen beantworten
Wählen Sie Partitionen anhand beobachteter Abfragefilter und des Schreibverhaltens. Iceberg unterstützt die Evolution des Partitionslayouts, sodass Teams das Layout ändern können, wenn Datenvolumen oder Abfragemuster sich wandeln, doch eine Evolutionsfunktion beseitigt nicht die Kosten schlechter Erstentscheidungen.
Prüfen Sie nach jeder größeren Pipeline-Änderung, ob kleine Dateien entstehen. Partitionsschlüssel mit hoher Kardinalität können Daten über viele Dateien verstreuen, während zu breite Partitionen Engines zwingen können, mehr Daten als nötig zu scannen. Sortierung und Kompaktierung können die Lokalität verbessern, bringen aber Wartungsaufwand mit sich.
Snapshots begrenzen
Historische Snapshots helfen bei Reproduzierbarkeit, Rollback und Fehlersuche. Unbegrenzte Aufbewahrung erzeugt mehr Metadaten für die Planung und mehr zu verwaltende Objekte, definieren Sie also eine Richtlinie auf Basis von Wiederherstellungsbedarf, Auditanforderungen und Lebenszyklusregeln des Speichers.
Koppeln Sie den Snapshot-Ablauf mit der Bereinigung verwaister Dateien. Metadatenverweise zu entfernen, ohne unreferenzierte Daten sicher zu identifizieren, kann einen anderen Fehler erzeugen, deshalb sollte die Bereinigung bewusst, beobachtbar und getestet sein.
Betriebssignale beim Schreiben erzeugen
Writer wissen, wann ein Commit beginnt, wie viele Dateien sie erzeugen, wie lange der Commit dauert und ob eine Kompaktierung lief. Halten Sie diese Fakten als strukturierte Ereignisse fest, statt sie später aus verstreuten Logs zu rekonstruieren.

Verfolgen Sie Dateianzahl, Dateigrößen, Commit-Latenz, Snapshot-Alter, fehlgeschlagene Commits und den Zustand der Kompaktierung. Diese Signale verbinden Formatoperationen mit den Symptomen, die Nutzerinnen bemerken, etwa langsame Dashboards, veraltete Datensätze und unvollständige Ladevorgänge.
Die operative Reife entscheidet, ob ein Lakehouse verlässlich arbeitet. Die offene Spezifikation ist für gemeinsame Semantik nötig, doch Ihre Katalogrichtlinien, Wartungsjobs, Alarmwege und Ihr Verantwortungsmodell entscheiden, ob diese Semantik dem Produktionsdruck standhält.
Observability- und Integrationsmuster für produktive Lakehouses
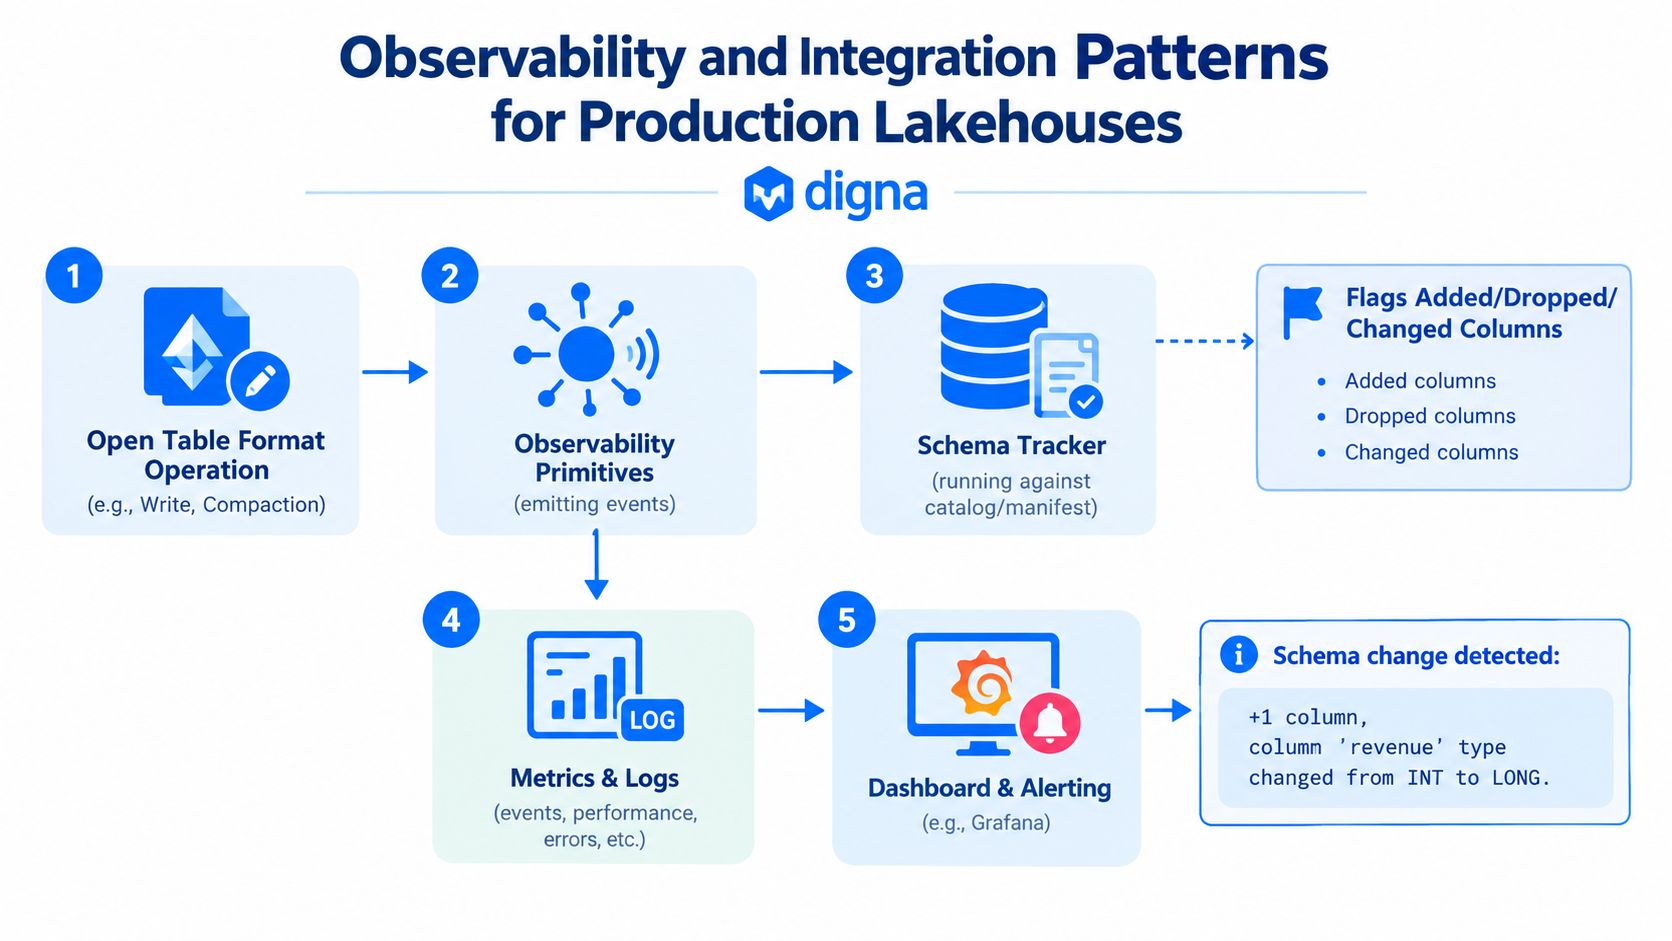
Eine Tabelle kann transaktional gültig und dennoch operativ falsch sein. Sie kann eine neue Spalte haben, die ein nachgelagertes Modell bricht, einen erfolgreichen Commit, der zu spät für eine Berichtsfrist eintraf, oder eine gültige Dateimenge, deren Satzvolumen deutlich von der etablierten Basislinie abweicht.
Observability sollte unmittelbar auf Tabellenoperationen abbilden. Schema-Tracking prüft Katalogmetadaten oder Manifestinformationen auf hinzugefügte, entfernte und typgeänderte Spalten. Prüfungen in der Datenbank bewerten Datensätze dort, wo sie ohnehin liegen, was den Export von Stichproben vermeidet und Teams erlaubt, Zeilenanzahlen, Null-Verhalten, Geschäftsregeln und ausgewählte Beziehungen zu testen.
Vier Signale, die zusammengehören
Erkennung von Schemaänderungen: Melden Sie eine hinzugefügte, entfernte oder typgeänderte Spalte, bevor ein nachgelagerter Konsument scheitert oder Werte erzwingt.
Datenvalidierung: Führen Sie Zusicherungen gegen die Tabelle aus, für Pflichtfelder, zulässige Werte, Geschäftsregeln auf Satzebene und Integritätsbedingungen.
Anomalie-Basislinien: Vergleichen Sie Satzanzahlen je Partition, Dateigrößen, Commit-Verhalten und weitere Kennzahlen mit dem historischen Verhalten des Datensatzes.
Überwachung der Timeliness: Vergleichen Sie Snapshot-Erstellung und Datenankunft mit dem erwarteten Lieferplan, damit eine technisch erfolgreiche Pipeline keinen Frischevorfall verdeckt.
Die sinnvolle Überwachungseinheit ist nicht nur der Job. Es ist der Tabellenzustand, den Konsumenten lesen. Eine erfolgreiche Aufgabe kann dennoch eine unvollständige Geschäftsperiode veröffentlichen, ein unverträgliches Schema einführen oder ein pathologisches Dateilayout erzeugen.
Details zu Integration und Bereitstellung
Eine Observability-Plattform kann sich mit Iceberg-REST- oder Unity-Catalog-APIs für den Zugriff auf Schema und Metadaten verbinden, strukturierte Writer-Ereignisse für die Anomalieanalyse aufnehmen und Warnungen an dieselben Vorfallskanäle senden, die für die Warehouse-Überwachung genutzt werden. Auch die Platzierung der Agents zählt. Teams müssen entscheiden, ob Monitoring-Komponenten neben der Compute-Umgebung, innerhalb eines privaten Netzwerks oder in einer anderen kontrollierten Dienstgrenze laufen.
Berechtigungen müssen zur RBAC des Katalogs passen. Das Monitoring sollte genug Metadaten und Tabelleninhalte sehen, um die nötigen Signale zu berechnen, ohne die Governance-Schicht zu umgehen. Eine Plattform wie dignas Lösung für Data Observability kann eine Option sein, mit Funktionen für Schema-Tracking, Validierung in der Datenbank, Anomalieerkennung und Timeliness-Überwachung innerhalb der Kundenumgebung.
Das übergeordnete Prinzip ist einfach: Jeder Commit sollte Nachweise darüber erzeugen, was sich geändert hat, wann es eintraf und ob sein Verhalten innerhalb einer akzeptierten Basislinie bleibt.
Bereitstellung und Betrieb in regulierten Umgebungen
Die Wahl zwischen Iceberg, Delta Lake oder Hudi ist in einer regulierten Umgebung selten die schwerste Entscheidung. Die schwierigen Fragen betreffen, wo der Katalog läuft, wie Engines sich authentifizieren, wie Berechtigungen auf sensible Spalten abbilden und wie Metadatenoperationen im Prüfpfad erscheinen.
Eine Bring-your-own-Cloud-Bereitstellung hält Speicher, Katalogdienste, Compute und Monitoring innerhalb der Cloud-Grenze der Organisation. Das Team steuert Netzwerkpfade und Aufbewahrung, verantwortet aber auch Verfügbarkeit, Upgrades, Schlüsselverwaltung und Wiederherstellungstests. Ein mehrregionaler Entwurf ergänzt Entscheidungen zu Replikation und Datenresidenz. Betreiberinnen müssen festlegen, welche Metadaten und Snapshots repliziert werden, wie Lineage Regionen überspannt und welches Rollback-Verfahren gilt, wenn Regionen auseinanderlaufen.
Eine luftdicht getrennte On-Premises-Bereitstellung ändert die Rahmenbedingungen erneut. Externe verwaltete Dienste stehen womöglich nicht bereit, also müssen Katalog-Upgrades, Formatkompatibilitätstests, Observability und Vorfallsnachweise innerhalb der isolierten Umgebung funktionieren.

Kontrollen, die vor der Produktion geklärt sein müssen
Ort des Katalogs: Wählen Sie einen verwalteten Dienst, einen selbst betriebenen Katalog oder eine einheitliche Governance-Plattform nach Wiederherstellungs-, Residenz- und Auditanforderungen.
Identität und Zugriff: Bilden Sie Katalogberechtigungen auf bestehende RBAC- oder ABAC-Richtlinien ab, einschließlich der Dienstidentitäten, die Ingestion und Monitoring nutzen.
Umgang mit sensiblen Daten: Kennzeichnen und steuern Sie personenbezogene Daten auf Katalog- und Plattformebene, statt anzunehmen, das Dateiformat setze Richtlinien durch.
Laufzeitabsicherung: Prüfen Sie Frische, Schemakompatibilität, Datenverhalten und Zugriffsereignisse fortlaufend, statt sich auf eine einmalige Validierung zu verlassen.
Teams sollten diese Entscheidungen zusammen mit den Anforderungen an die Datenresidenz dokumentieren. Das Format kann Tabellenhistorie und Dateizustand ausdrücklicher machen, doch die operative Reife entscheidet, ob das Lakehouse dauerhafte Auditnachweise liefern kann.
Eine praktische Checkliste, bevor Sie sich auf ein Format festlegen
Nutzen Sie diese Sätze in Ihrem nächsten Architektur-Review:
Katalogpassung: Prüfen Sie, ob der Katalog Ihre Engines, Ihr Identitätsmodell, Ihre Auditanforderungen und Ihren Wiederherstellungsentwurf trägt.
Engine-Kompatibilität: Testen Sie die tatsächlichen Kombinationen aus Spark, Trino, Flink, Warehouse und BI, die die Tabellen lesen oder schreiben werden.
Partitionsstrategie: Passen Sie Partitionierung und Sortierung an beobachtete Zugriffsmuster und Schreibverhalten an.
Snapshot-Richtlinie: Definieren Sie Aufbewahrung, Rollback, Kompaktierung und Bereinigung verwaister Dateien vor dem Produktiveinsatz.
Zugriffssteuerung: Bestätigen Sie, dass sensible Spalten, Dienstidentitäten und Monitoring-Berechtigungen bestehenden Governance-Richtlinien folgen.
Schemawarnungen: Überwachen Sie hinzugefügte, entfernte, umbenannte und typgeänderte Spalten, bevor nachgelagerte Konsumenten brechen.
Frische-SLAs: Vergleichen Sie die Snapshot-Ankunft mit den erwarteten Lieferzeiten für Batch- und Streaming-Konsumenten.
Anomalie-Basislinien: Verfolgen Sie Dateianzahl, Satzvolumen, Commit-Latenz und Partitionsverhalten über die Zeit.
Rollback-Verfahren: Testen Sie, wie Betreiberinnen einen fehlerhaften Snapshot erkennen und einen sicheren Tabellenzustand wiederherstellen.
Sehen Sie die Checkliste nach jedem größeren Engine-Upgrade, jeder regulatorischen Änderung und jedem Pipeline-Refactoring erneut durch. Ein offenes Tabellenformat verringert Mehrdeutigkeit, doch es beseitigt die operative Verantwortung nicht.
digna hilft Datenteams, Schemaänderungen zu überwachen, Datensätze in der Datenbank zu validieren, auffälliges Tabellenverhalten zu erkennen und Timeliness zu verfolgen, innerhalb der eigenen Cloud oder des eigenen Rechenzentrums. Besuchen Sie digna, um diese Kontrollen mit den Operationen des offenen Tabellenformats zu verbinden, auf die Ihr Lakehouse bereits baut.
Sich auf ein Format festzulegen klärt, wo Tabellenmetadaten liegen; es klärt nicht, ob die Werte darin korrekt sind, und genau dort beginnt Data Quality Management.
Häufig gestellte Fragen
Was löst ein offenes Tabellenformat tatsächlich?
Den fehlenden Vertrag zwischen Dateien und Engines. Rohdateien sagen nicht jeder Engine, welche Dateien zur logischen Tabelle gehören, also liegt ein offenes Tabellenformat neben den Daten und hält fest, worüber Engines sich einig sein müssen.
Was hält dieser Vertrag fest?
Fünf Dinge: eine Tabellenidentität unabhängig von einer einzelnen Engine, ein Dateiinventar, das benennt, welche Dateien dazugehören und welche nicht mehr gelesen werden sollen, das Partitionslayout, damit Engines überspringen können, die Schemahistorie mit Hinzufügungen, Entfernungen und Umbenennungen, und atomare Snapshots, damit Reader eine konsistente Version erhalten, während ein Writer committet.
Wie verbreitet ist Iceberg?
Apache Iceberg wird von 58 % der Organisationen für geschäftskritische Analytik genutzt, während 95 % es für KI- und Machine-Learning-Workloads einsetzen oder das planen. Diese beiden Zahlen erklären, warum die Formatwahl zu einer Plattformentscheidung geworden ist und nicht zu einem Speicherdetail.
Lösen Iceberg, Delta Lake und Hudi unterschiedliche Probleme?
Sie gehen dasselbe Problem unterschiedlich an, statt verschiedene Probleme zu lösen. Alle drei liefern den Tabellenvertrag; sie unterscheiden sich in Schreibmustern, im Umgang mit Deletes und in der Ökosystemkopplung, weshalb die Auswahl dem Workload folgen sollte und nicht der Marke.
Was sollten Sie prüfen, bevor Sie sich auf eines festlegen?
Dass es Ihre regulierte Bereitstellung übersteht, nicht nur Ihren Benchmark. Der Betrieb im Unternehmensmaßstab bringt Metadatenhygiene, Engine-Koordination und Bereitstellungsauflagen mit sich, die ein Proof of Concept auf einer Engine nicht zutage fördert.



