Monte-Carlo-Simulation: Ein praktischer Leitfaden
|
9
min. Lesezeit
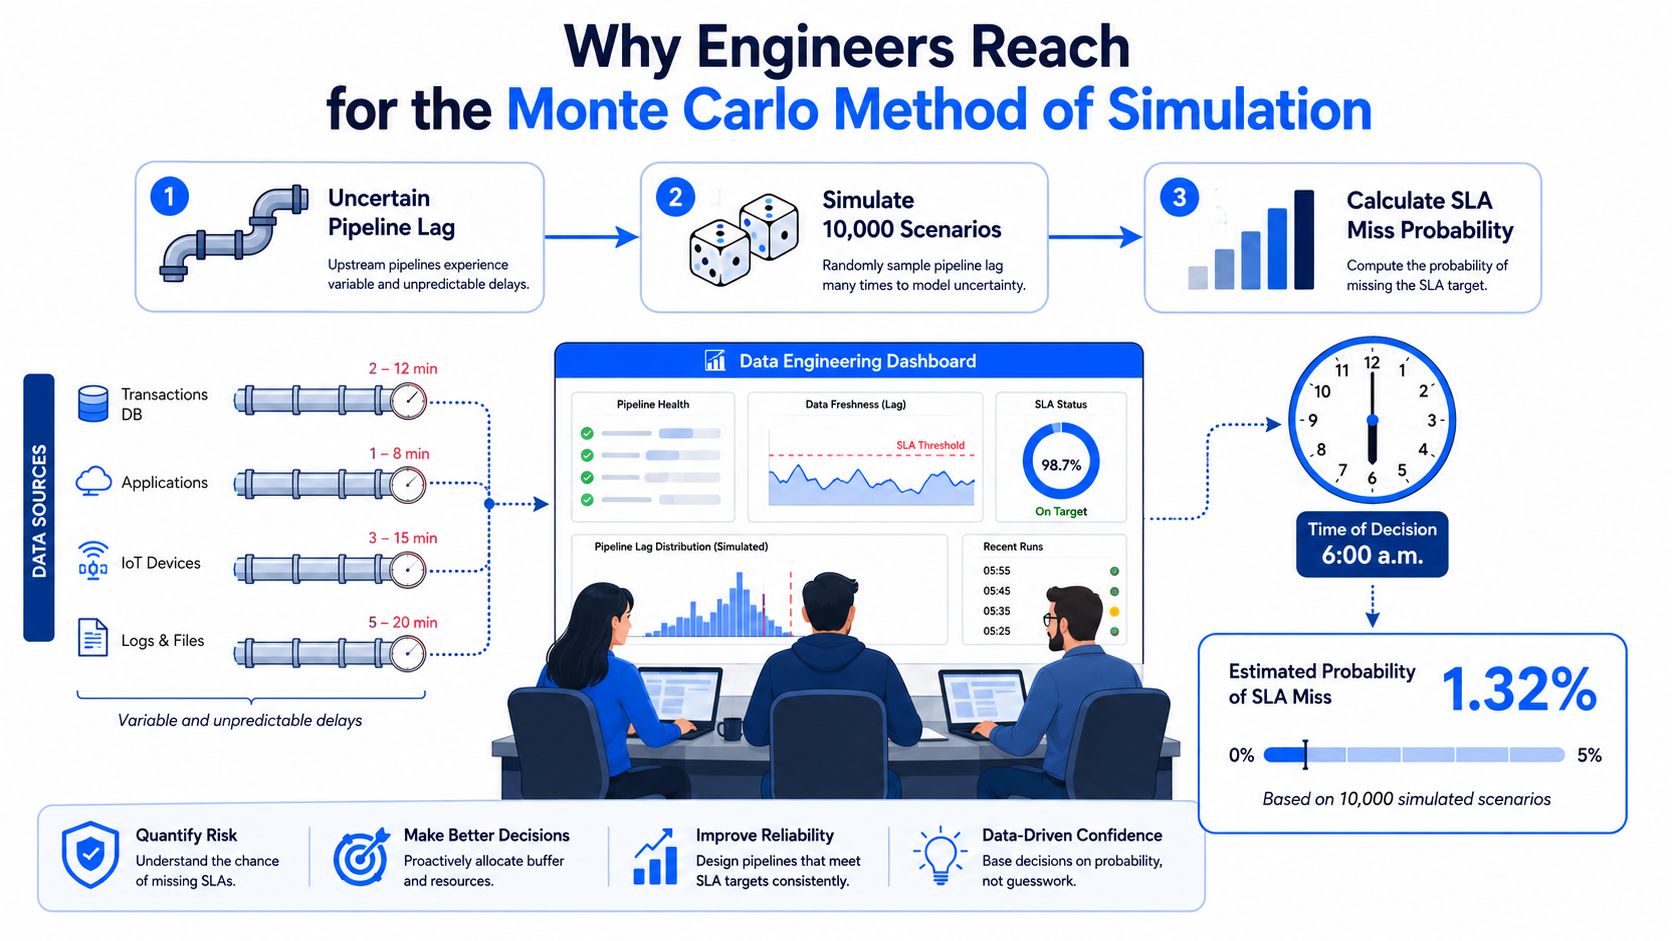
Ihr Team hat einen täglichen ETL-Job, der vor dem morgendlichen Berichtsfenster abgeschlossen sein muss. Upstream-Pipelines kommen zu unterschiedlichen Zeiten an, einige Tabellen erfordern Wiederholungsversuche und die Zeilenvolumina ändern sich von einem Durchlauf zum nächsten. Jemand stellt eine berechtigte geschäftliche Frage: Wie hoch ist die Wahrscheinlichkeit, dass der Job sein SLA verpasst?
Eine Tabellenkalkulation mit einem einzigen durchschnittlichen Verzögerungswert wird diese Frage nicht gut beantworten. Die möglichen Kombinationen vervielfachen sich schnell, und Fehlermodi interagieren miteinander. Die Monte-Carlo-Simulationsmethode bietet eine praktische Alternative. Sie verwandelt Unsicherheit in wiederholte Rechenexperimente und fasst die daraus resultierenden Ergebnisse dann als Wahrscheinlichkeiten, Bereiche und Risikomaße zusammen.
Inhaltsverzeichnis
Warum Ingenieure zur Monte-Carlo-Simulationsmethode greifen
Von einer unmöglichen Gleichung zu einem überschaubaren Experiment
Die Ursprünge der Monte-Carlo-Simulationsmethode
Warum der ENIAC-Meilenstein wichtig ist
Grundprinzipien, die Zufallsstichproben zum Funktionieren bringen
Der vierstufige Algorithmus
Fehler- und Konvergenzschätzung mit Zuversicht
Ein praktisches Konvertierungsbeispiel
Konvergenzdiagnose für die Produktion
Varianzreduktionstechniken, die man kennen sollte
Vier Ansätze und ihre Kompromisse
Pseudocode und In-Database-Implementierungsmuster
Ein Python-Referenzmodell
Die Berechnung dorthin verlagern, wo die Daten liegen
Anwendung der Monte-Carlo-Simulationsmethode in der Enterprise Data Quality
Timeliness und Pipeline-Frische
Schema-Drift und nachgelagerte Auswirkungen
Adaptive Null-Raten- und Anomalie-Überwachung
Häufige Missverständnisse und eine praktische Checkliste
Eine Runbook-Checkliste
Warum Ingenieure zur Monte-Carlo-Simulationsmethode greifen
Ein Dateningenieurteam kennt zwar das historische Verhalten jeder Upstream-Quelle, hat aber oft Schwierigkeiten, die Wahrscheinlichkeit des Verpassens einer festen Lieferfrist analytisch zu berechnen. Eine Quelle kann verspätet eintreffen, eine andere fehlschlagen und wiederholt werden, und eine dritte kann ein ungewöhnlich großes Batch liefern, das die Transformationszeit verlängert. Jeder Zweig verändert den nächsten, sodass eine einzige geschlossene Formel schwer zu pflegen und noch schwerer zu rechtfertigen ist.
Die Monte-Carlo-Simulation geht das Problem anders an. Das Team stellt unsichere Eingaben mit realistischen Verteilungen dar, generiert synthetische Pipeline-Durchläufe, bewertet, ob jeder Durchlauf vor dem SLA abgeschlossen wird, und aggregiert die Ergebnisse zu einer Wahrscheinlichkeitsschätzung. Das Ergebnis ist kein Versprechen, dass ein bestimmter Durchlauf zu spät kommt. Es ist eine evidenzbasierte Sichtweise darauf, wie sich das modellierte System unter vielen plausiblen Bedingungen verhält.
Von einer unmöglichen Gleichung zu einem überschaubaren Experiment
Der Reiz der Methode liegt nicht in der Zufälligkeit an sich. Es ist die Fähigkeit, ein unlösbares analytisches Problem durch ein lösbares Rechenexperiment zu ersetzen. Ingenieure können Fragen stellen wie:
Kapazitätsplanung: Wie viel Verarbeitungsspielraum benötigt die Arbeitslast bei der Ankunft großer Datenmengen?
Risikoprüfung: Wie oft führen Kombinationen aus Upstream-Verzögerungen und Wiederholungsverhalten zu einer SLA-Verletzung?
Zusagen an Stakeholder: Wie vertretbar ist die vorgeschlagene Lieferzeit, wenn die Eingaben variabel bleiben?
Jeder Simulationslauf verhält sich wie ein synthetischer Betriebstag. Ein Durchlauf zieht möglicherweise eine kurze Upstream-Verzögerung und ein mäßiges Zeilenvolumen nach sich. Ein anderer kombiniert eventuell mehrere verspätete Ankünfte mit zusätzlichen Wiederholungsversuchen. Das Modell zeichnet die Abschlusszeit auf und klassifiziert den Durchlauf als Erfolg oder Verletzung.
Praktische Regel: Modellieren Sie die Unsicherheit, die die Entscheidung beeinflusst. Das Hinzufügen zufälliger Eingaben, die das SLA nicht beeinflussen, erhöht nur die Komplexität.
Wenn Sie eine separate Einführung in den grundlegenden Arbeitsablauf wünschen, bietet das Polytreasury-Simulations-Tutorial nützlichen Einführungskontext. Für Datenteams in Unternehmen ist die wichtige Umstellung konzeptionell: Hören Sie auf, nach einer vermeintlich präzisen Fertigstellungszeit zu fragen, und fragen Sie stattdessen, wie sich die gesamte Bandbreite plausibler Durchläufe auf das operationelle Risiko auswirkt.
Die Origins Behind the Monte Carlo Method of Simulation
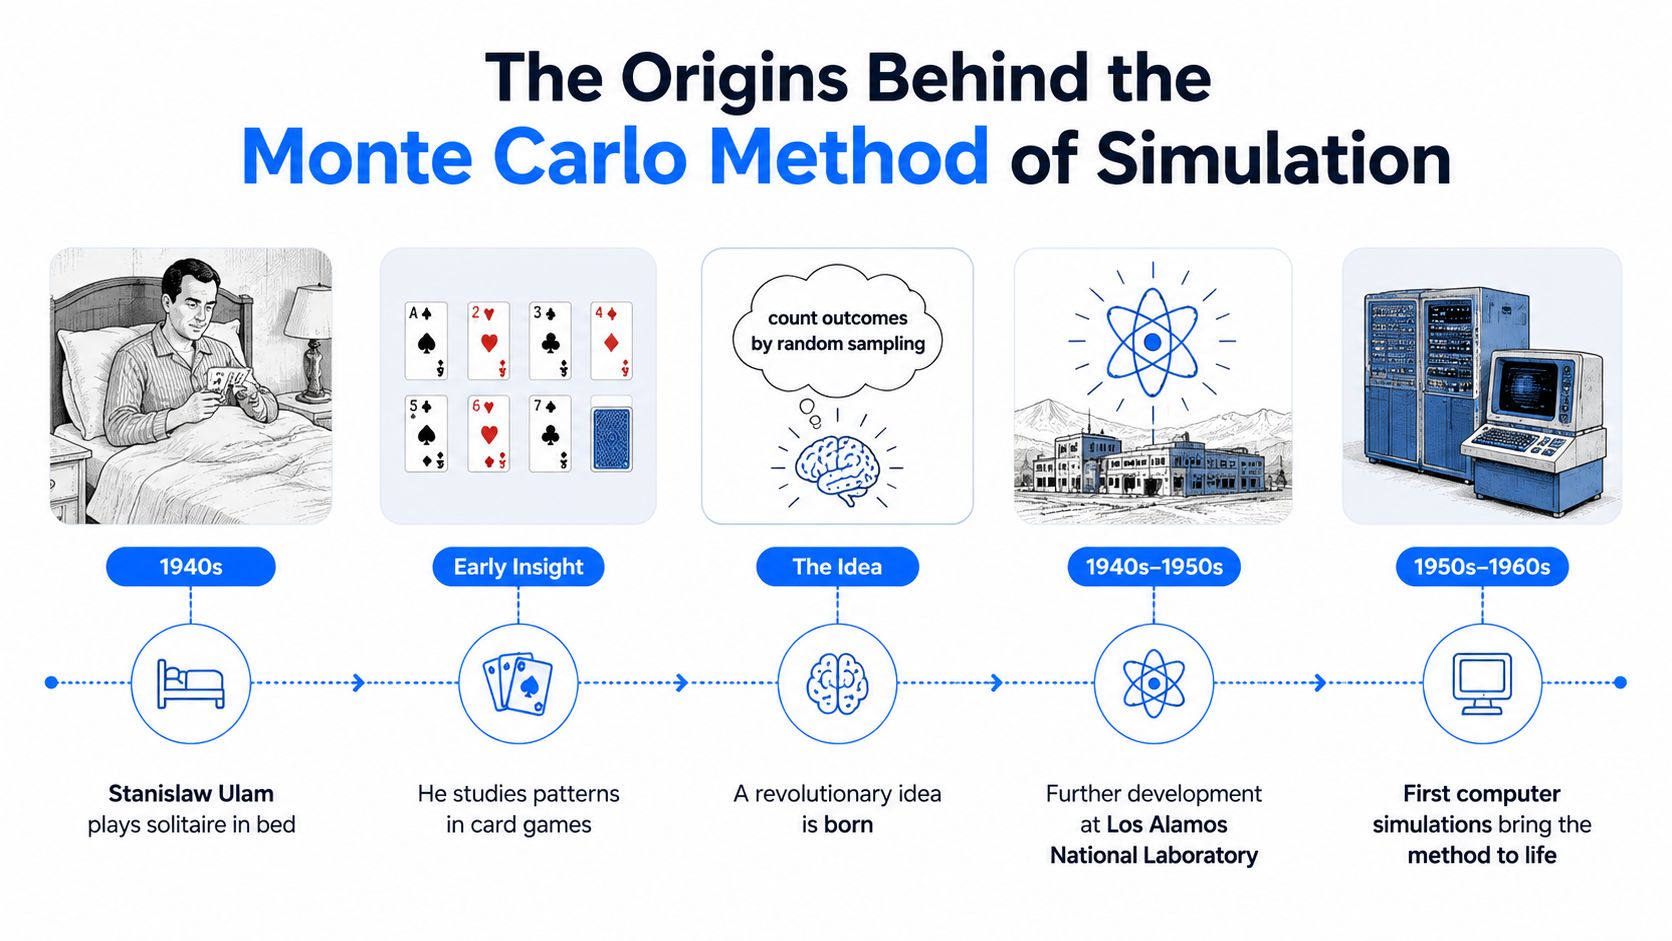
Die moderne Geschichte beginnt mit Stanisław Ulam, der sich von einer Krankheit erholte und über Solitär nachdachte. Er fragte sich, wie wahrscheinlich es sei, dass ein bestimmtes Kartenlayout zu einem Gewinn führt. Jede mögliche Anordnung analytisch zu zählen, wäre unpraktisch gewesen, aber das wiederholte Geben von Händen und Protokollieren des Ergebnisses war unkompliziert.
Diese Erkenntnis änderte die Fragestellung. Anstatt jedes Ergebnis aufzuzählen, konnte Ulam Zufallsversuche nutzen, um den Prozentsatz der Gewinne zu schätzen. Dieselbe Logik könnte auf Systeme mit enormen Zustandsräumen angewendet werden, bei denen eine direkte Berechnung unrealistisch wird.
Ulam teilte die Idee mit John von Neumann in Los Alamos während des Manhattan-Projekts. Von Neumann erkannte ihre Relevanz für die Neutronendiffusion und verwandte kernphysikalische Berechnungen. Die moderne computergestützte Form der Methode wurde bewusst in den Mitte der 1940er Jahre entwickelt, als die Forscher nach einer Möglichkeit suchten, über komplexes physikalisches Verhalten nachzudenken, das sich einer einfacheren analytischen Behandlung entzog.
Warum der ENIAC-Meilenstein wichtig ist
Ein wichtiger Meilenstein wurde 1948 erreicht, als von Neumann, Nicholas Metropolis und andere den ENIAC-Computer nutzten, um die ersten vollautomatischen Monte-Carlo-Berechnungen durchzuführen. Das erste nicht klassifizierte Papier folgte 1949. Dieser Übergang ist wichtig, weil er die Methode vom manuellen Nachdenken über den Zufall zur groß angelegten computergestützten Simulation überführte.
Metropolis half dabei, dem Ansatz seinen denkwürdigen Codenamen zu geben, der sich an den probabilistischen Charakter des Monte-Carlo-Casinos in Monaco anlehnte. Der Name blieb hängen, weil er die zentrale Intuition auf den Punkt bringt: Zufallsversuche können das Verhalten eines komplizierten Systems offenbaren.
Die Geschichte hält eine direkte Lektion für Dateningenieure bereit. Monte Carlo wurde nicht als eine vom Betrieb losgelöste akademische Übung geboren. Die Methode entstand, weil Forscher vor einem Problem standen, das zu kompliziert war, um es mit direkter Aufzählung bequem zu lösen. Unternehmensteams stehen vor demselben Muster, wenn Hunderte von Tabellen, Zeitplänen, Wiederholungsversuchen, Abhängigkeiten und sich ändernden Datenvolumina innerhalb einer Produktionsplattform interagieren.
Grundprinzipien, die Zufallsstichproben zum Funktionieren bringen
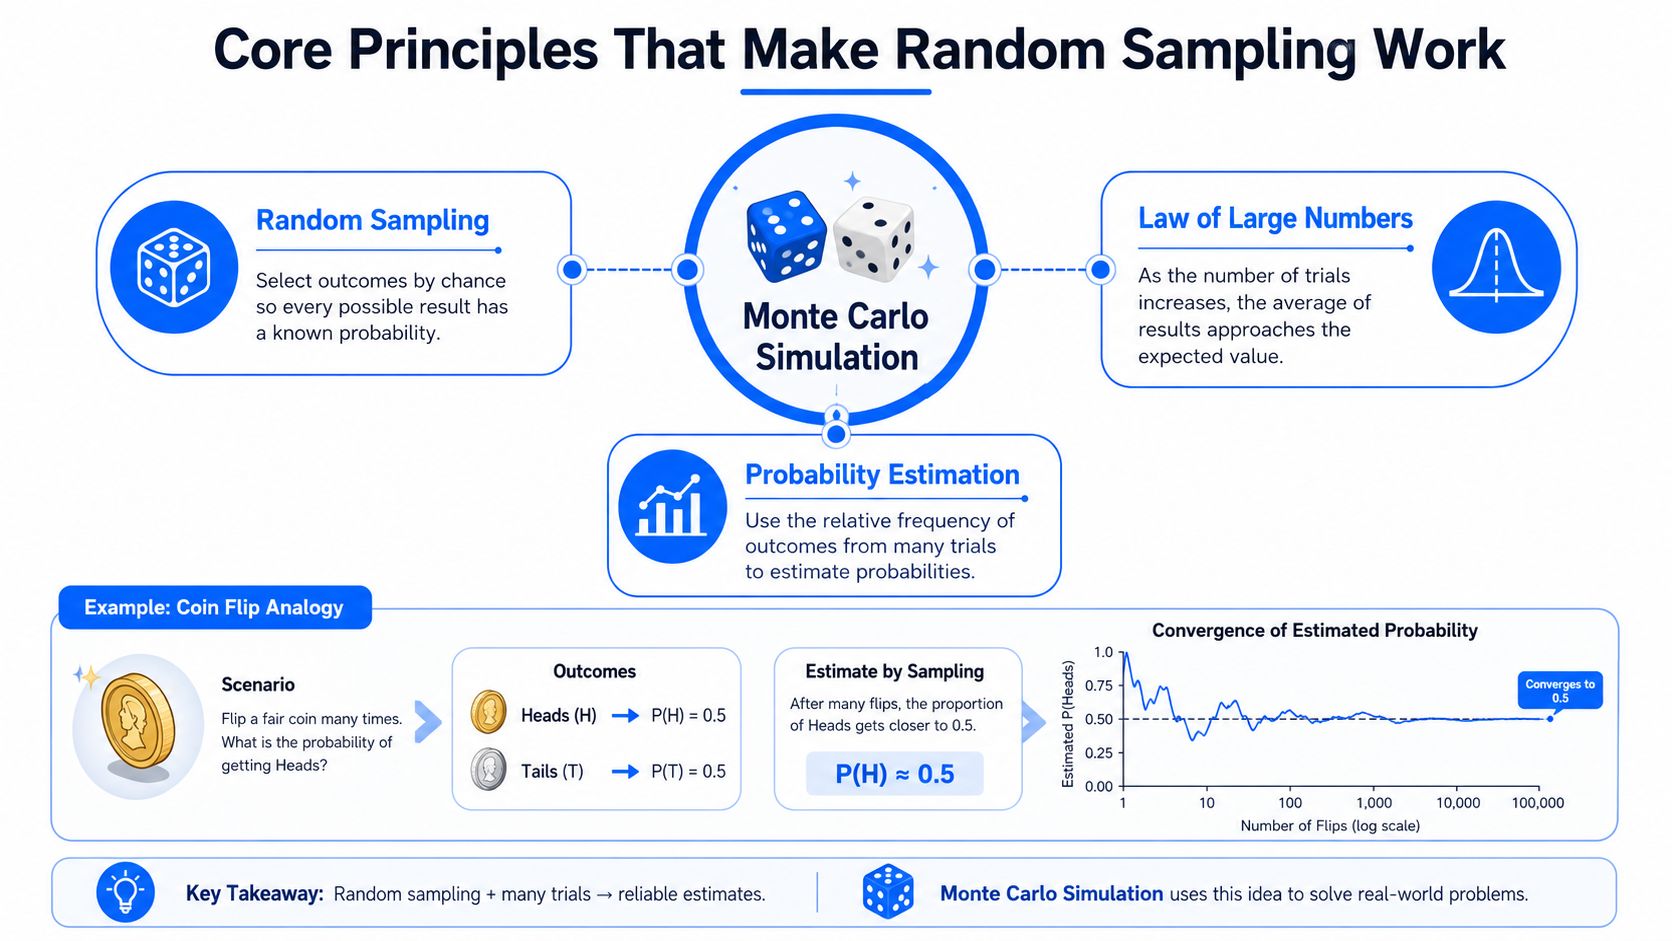
Angenommen, Sie möchten schätzen, wie oft eine faire Münze auf Kopf landet. Sie könnten die Wahrscheinlichkeit mathematisch herleiten oder die Münze wiederholt werfen und den Anteil der Kopf-Ergebnisse berechnen. Der zweite Ansatz ist bei einer einfachen Münze weniger elegant, liefert Ihnen aber das richtige mentale Modell für die Monte-Carlo-Simulation.
Für eine Enterprise-Pipeline wird die „Münze“ zu einem Systemmodell. Jeder Versuch tastet unsichere Eingaben ab, lässt diese Eingaben durch das Modell laufen und zeichnet eine Ausgabe wie die Fertigstellungszeit, die Anzahl fehlgeschlagener Validierungen oder den SLA-Status auf.
Der vierstufige Algorithmus
Definieren Sie den Eingabebereich. Wählen Sie eine Wahrscheinlichkeitsverteilung für jede unsichere Variable. Die Upstream-Verzögerung könnte anhand historischer Ankünfte modelliert werden, die Anzahl der Wiederholungsversuche anhand des beobachteten Betriebsverhaltens und die Zeilenanzahl anhand der jüngsten Partitionen.
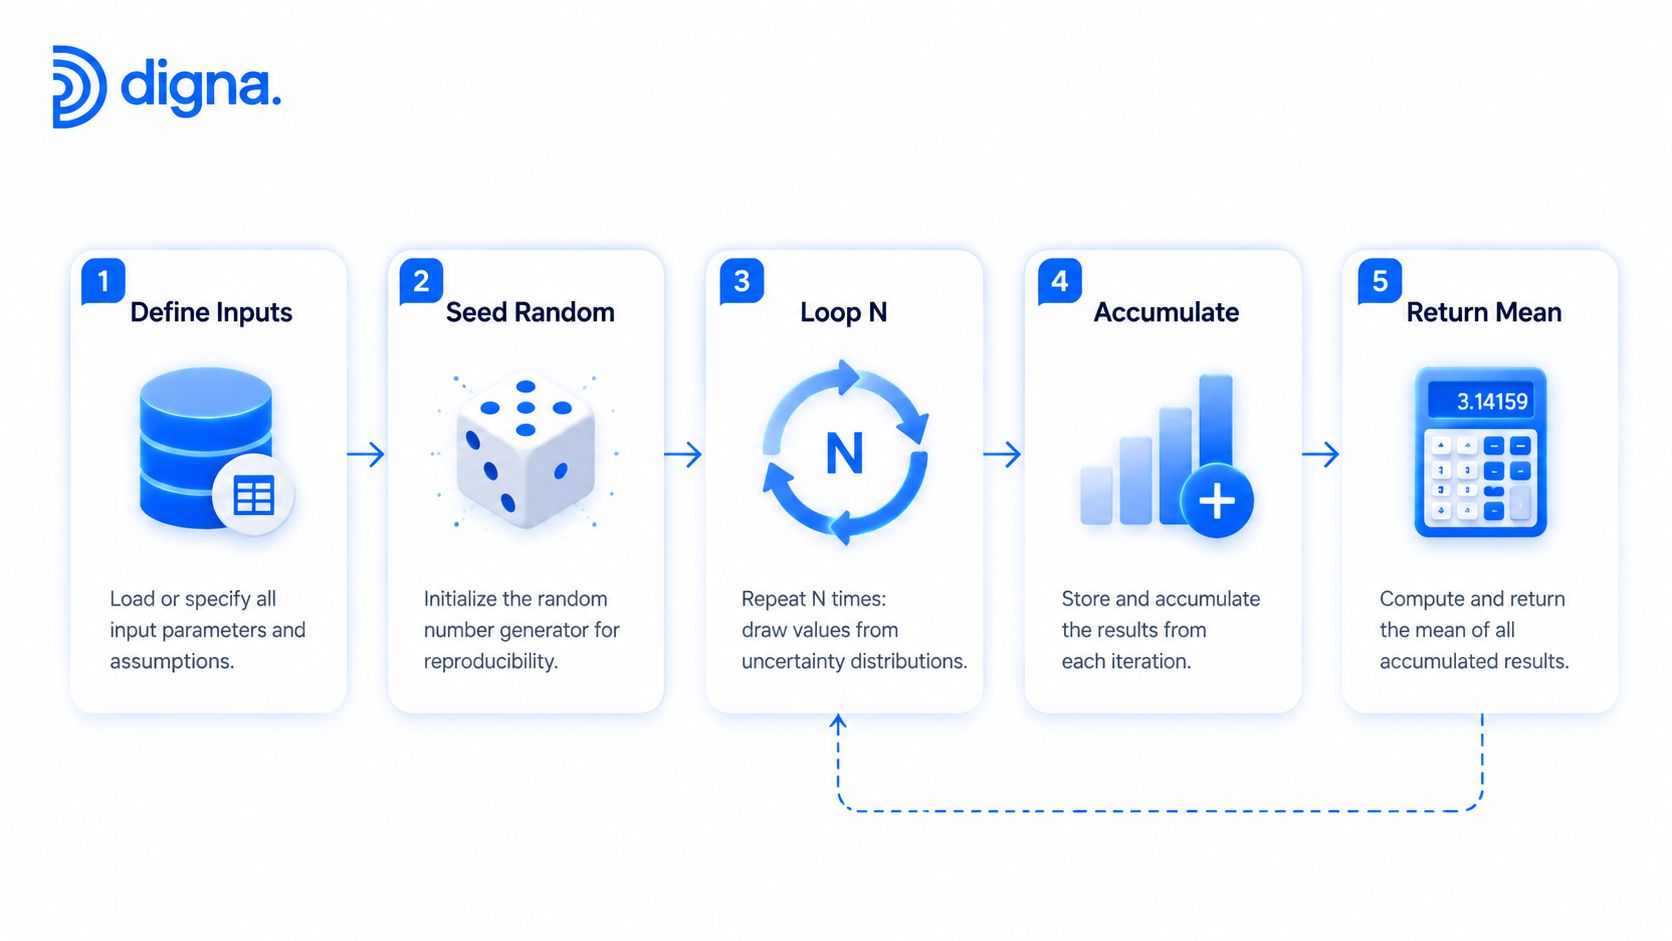
Generieren Sie Stichproben. Ein Pseudozufallsgenerator zieht bei jeder Iteration einen Wert aus jeder Eingabeverteilung. Der Generator ist unter einem festen Startwert (Seed) deterministisch, was einen Durchlauf reproduzierbar macht.
Bewerten Sie das System. Speisen Sie die abgetasteten Werte in das Pipeline-Modell ein. Das Modell kann Aufgabenlaufzeiten addieren, Wiederholungsregeln anwenden, den Ressourcenverbrauch berechnen oder einen Durchlauf als SLA-Verletzung klassifizieren.
Aggregieren Sie die Ausgaben. Fassen Sie die aufgezeichneten Ergebnisse mithilfe eines Mittelwerts, Perzentils oder einer Tail-Wahrscheinlichkeit zusammen. Teilen Sie für die SLA-Frage die Anzahl der verletzten Ergebnisse durch die Gesamtzahl der simulierten Durchläufe, um die modellierte Verletzungswahrscheinlichkeit zu schätzen.
Es sei die Ausgabe der Iteration (i) gleich (X_i). Der Erwartungswert wird durch den Stichprobenmittelwert approximiert:
[
E[X] \approx \bar{X} = \frac{1}{N}\sum_{i=1}^{N}X_i
]
Die Stichprobenvarianz kann geschrieben werden als:
[
Var(X) \approx s^2 = \frac{1}{N-1}\sum_{i=1}^{N}(X_i-\bar{X})^2
]
Diese Formeln machen das Modell an sich nicht korrekt. Sie fassen das Verhalten zusammen, das durch die von Ihnen bereitgestellten Annahmen erzeugt wird. Eine Verteilung, die saisonale Ankünfte, korrelierte Upstream-Verzögerungen oder seltene Wiederholungsstürme nicht darstellt, kann zu einem geschönten, aber irreführenden Ergebnis führen.
Für eine breitere Grundlage in statistischen Techniken für die Datenarbeit siehe statistische Methoden zur Datenanalyse. Das zentrale Prinzip bleibt einfach: Wiederholte Stichprobenziehungen liefern eine Schätzung, und das Gesetz der großen Zahlen besagt, dass die Schätzung mit zunehmender Anzahl der Simulationen stabiler wird.
Fehler- und Konvergenzschätzung mit Zuversicht
Das Monte-Carlo-Ergebnis ist eine Schätzung, kein exaktes Orakel. Zwei Konzepte erklären, warum sich die Schätzung mit mehr Iterationen verbessert. Das Gesetz der großen Zahlen beschreibt die Konvergenz des Stichprobenmittelwerts gegen den wahren Erwartungswert, während der zentrale Grenzwertsatz beschreibt, wie der Schätzer unter geeigneten Bedingungen dazu neigt, eine glockenförmige Verteilung um diesen Wert herum zu bilden.
Für den Stichprobenmittelwert ist eine übliche Annäherung an den Monte-Carlo-Standardfehler:
[
SE = \frac{\sigma}{\sqrt{N}}
]
Hierbei steht (\sigma) für die Standardabweichung des Ergebnisses und (N) für die Anzahl der Iterationen. Die Quadratwurzel ist betrieblich von Bedeutung. Eine Erhöhung der Anzahl der Durchläufe verbessert die Präzision, jedoch mit abnehmendem Grenznutzen. Eine Verdoppelung der Iterationen reduziert den Standardfehler in etwa um die Quadratwurzel aus zwei, nicht um die Hälfte.
Ein praktisches Konvertierungsbeispiel
Nehmen wir an, ein Team schätzt die Konversionsrate täglich aktiver Nutzer mit einem Modell, dessen Ergebnisvarianz aus den modellierten Eingaben bekannt ist. Jede Iteration tastet das plausible Volumen aktiver Nutzer und das Konversionsverhalten ab und berechnet dann die resultierende Rate. Das Team sollte die Anzahl der Iterationen nicht einfach deshalb wählen, weil sie hoch klingt. Es sollte eine Zielintervallbreite wählen, die zur Entscheidung passt.
Wenn die Führungsebene nur einen groben Planungsbereich benötigt, kann ein moderater Standardfehler akzeptabel sein. Wenn das Ergebnis eine kostspielige Kapazitäts- oder Kampagnenentscheidung steuert, benötigt das Team möglicherweise ein engeres Intervall. Die korrekte Anzahl von Durchläufen hängt von der Volatilität des Ergebnisses, der gewünschten Präzision und den Folgen des Handelns auf der Grundlage einer unsicheren Schätzung ab.
Iterationen (N) | Standardfehler (σ/√N) | Relative Reduzierung |
|---|---|---|
N | σ/√N | Ausgangswert |
2N | σ/√(2N) | Grob um die Quadratwurzel aus zwei reduziert |
4N | σ/√(4N) | Etwa die Hälfte des Ausgangsfehlers |
Die Tabelle drückt die Skalierungsbeziehung aus, anstatt eine universelle Anzahl von Durchläufen vorzuschreiben. Eine Schätzung seltener Ereignisse erfordert möglicherweise mehr Sorgfalt als eine durchschnittliche Konversionsrate, insbesondere wenn nur ein kleiner Teil der Iterationen das interessierende Ereignis hervorruft.
Konvergenzdiagnose für die Produktion
Ein Plot des laufenden Mittelwerts zeigt, ob sich die geschätzte Metrik in einem stabilen Bereich einpendelt. Ein Trace-Plot kann Muster in den generierten Ergebnissen offenbaren, während der Monte-Carlo-Standardfehler eine quantitative Abbruchregel liefert.
Praktische Anleitungen zur Beschreibung von Verteilungsformen finden Sie unter Wie man die Verteilung von Daten beschreibt. Stoppen Sie in der Produktion, wenn die Schätzung das vordefinierte Präzisionsziel erreicht und zusätzliche Durchläufe die Entscheidung nicht mehr wesentlich ändern. Dieser Ansatz ist verantwortungsvoller als die Wahl einer großen Anzahl von Iterationen in der Annahme, dass das Ergebnis verlässlich sein muss.
Varianzreduktionstechniken, die man kennen sollte
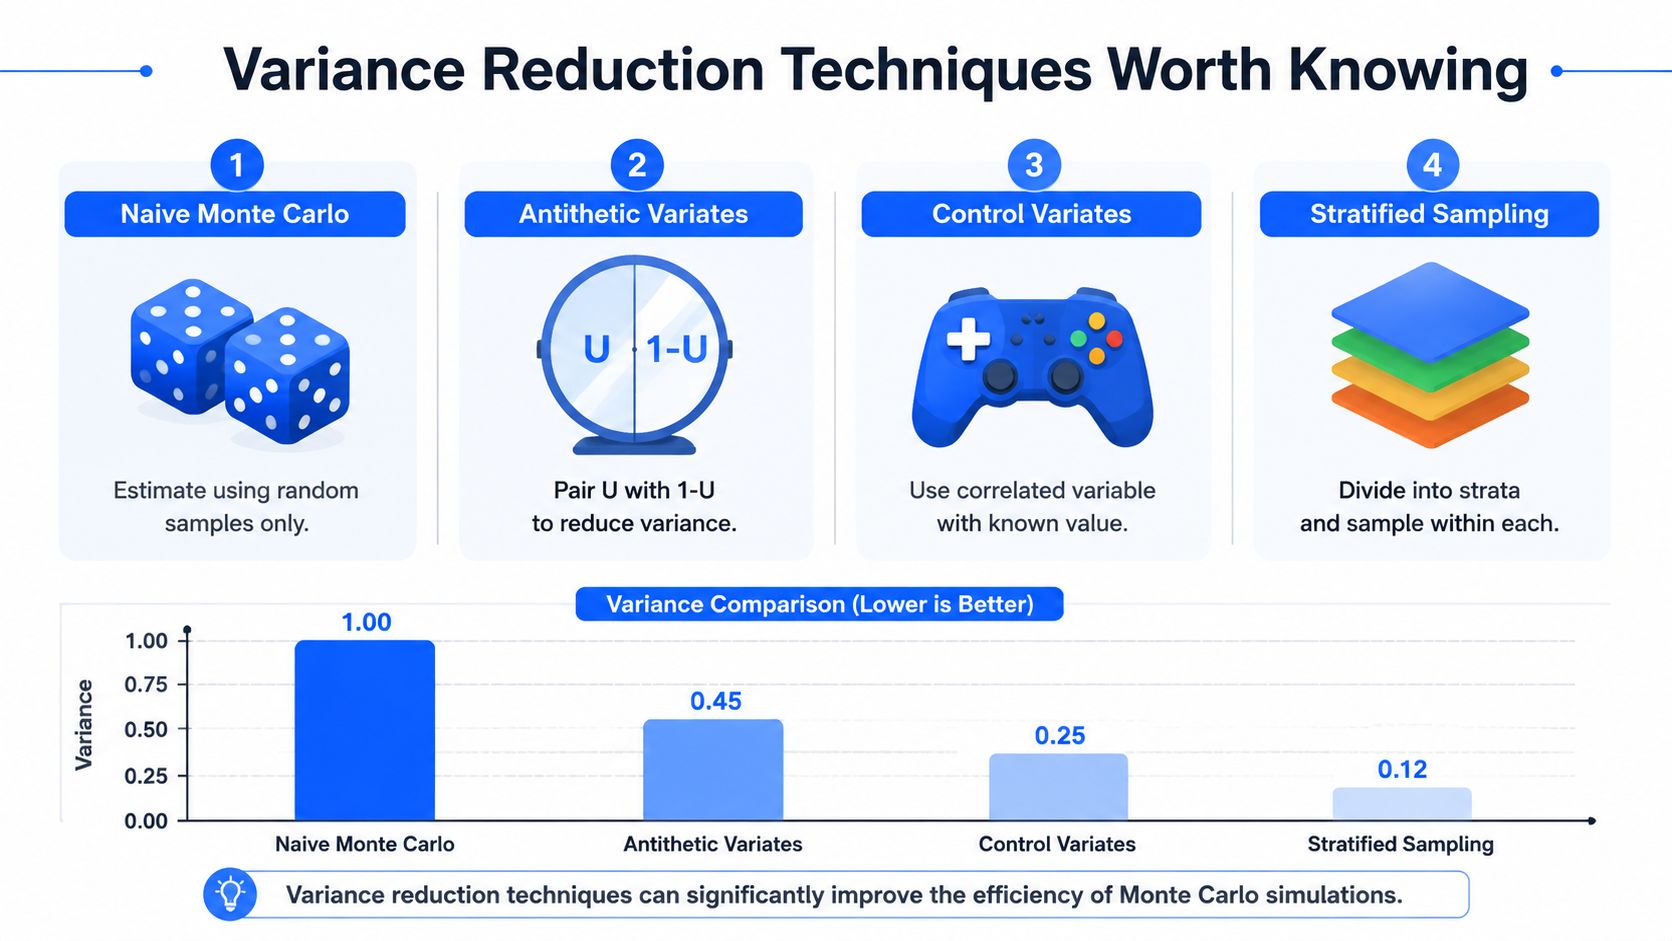
Eine naive Monte-Carlo-Stichprobenziehung ist leicht zu erklären und oft ein sinnvoller Ausgangspunkt. Sie kann jedoch Rechenkapazität verschwenden, wenn die Schätzung verrauscht ist, insbesondere bei seltenen Ereignissen. Varianzreduktionstechniken verbessern die Präzision, indem sie Stichproben intelligenter anordnen oder gewichten, ohne die Anzahl der Iterationen zu erhöhen.
Vier Ansätze und ihre Kompromisse
Antithetische Variablen paaren einen Zug (U) mit (1-U). Wenn das Modell monoton auf die abgetastete Eingabe reagiert, können sich die gepaarten Ausgaben in entgegengesetzte Richtungen bewegen und die Varianz verringern. Die Kosten hierfür sind zusätzliche Implementierungslogik und die Anforderung, dass die Paarung für das Modell sinnvoll ist. Dies kann für ein Pipeline-Dauer-Modell geeignet sein, bei dem eine gleichmäßige Eingabe eine monotone Verzögerungskomponente steuert.
Kontrollvariablen verwenden eine korrelierte Größe, deren Erwartungswert analytisch bekannt ist. Die Simulation schätzt die Beziehung zwischen dem Ziel und der Kontrollgröße und subtrahiert dann die verbleibende Abweichung. Dieser Ansatz kann sehr leistungsfähig sein, erfordert jedoch eine nützliche Kontrollvariable und eine sorgfältige Schätzung der Koeffizienten.
Stratifizierte Stichprobenziehung unterteilt den Eingabebereich in Schichten (Strata) und zieht Stichproben innerhalb jeder Region. Sie verhindert, dass die Simulation versehentlich einen wichtigen Teil des Bereichs unterrepräsentiert. So können beispielsweise Umsatzperzentil-Prognosen die Stichprobenabdeckung für Regionen mit niedriger, typischer und hoher Nachfrage reservieren, anstatt sich auf uneingeschränkte Zufallsziehungen zu verlassen.
Importance Sampling verschiebt die Vorschlagsverteilung hin zu einer Region mit seltenen Ereignissen und korrigiert das Ergebnis dann mit einem Likelihood-Verhältnis. Dies ist ein starker Kandidat für die Schätzung von SLA-Verletzungswahrscheinlichkeiten, wenn Verletzungen ungewöhnlich sind, aber eine falsche Gewichtung kann schwerwiegende Fehler verursachen und die Interpretation des Ergebnisses erschweren.
Modellierungsurteil: Eine Varianzreduktionsmethode ist nur dann nützlich, wenn ihre Annahmen mit dem System übereinstimmen. Geringeres numerisches Rauschen gleicht ein fehlerhaftes Abhängigkeitsmodell nicht aus.
Teams sollten dokumentieren, warum sie sich für eine bestimmte Technik entschieden haben, welche Verzerrungskorrektur sie anwendet und wie sie das Ergebnis mit einem naiven Ausgangswert validiert haben. Bei ungewöhnlichen Beobachtungen, die in das Eingabemodell einfließen, können Methoden zur Ausreißeridentifizierung helfen, echtes extremes Verhalten von Datenfehlern zu trennen, bevor die Simulation beginnt.
Pseudocode und In-Database-Implementierungsmuster
Ein wiederverwendbares Simulations-Template beginnt mit der Fragestellung, nicht mit dem Zufallsgenerator. Definieren Sie die Ausgabe, identifizieren Sie unsichere Eingaben, wählen Sie Verteilungen aus, legen Sie Abhängigkeiten fest und entscheiden Sie, wie die Ergebnisse genutzt werden sollen.
Eine kompakte Version sieht so aus:
Definieren Sie die Eingabeverteilungen und das Ziel-Ergebnis.
Initialisieren Sie eine Pseudozufallsquelle mit einem protokollierten Seed.
Ziehen Sie pro Iteration einen Wert aus jeder Verteilung.
Bewerten Sie das Systemmodell.
Speichern oder akkumulieren Sie das Ergebnis.
Geben Sie zusammenfassende Statistiken und ausgewählte Perzentile zurück.
Prüfen Sie die Konvergenz und validieren Sie die Annahmen.
Ein Python-Referenzmodell
Das folgende Beispiel schätzt den Value at Risk einer Verteilung von Kundenabwanderungsverlusten (Customer Churn). Es verwendet Platzhalter für die Modellparameter, sodass es eher um das Ausführungsmuster geht als um eine Aussage über ein bestimmtes Geschäftsergebnis.
Eine Produktionsimplementierung sollte den Seed, die Verteilungsparameter, die Modellversion, die Quellpartitionen und den Zeitstempel der Ausführung aufzeichnen. Sie sollte außerdem genügend Metadaten bewahren, um das Ergebnis nach einer Änderung der zugrunde liegenden Daten reproduzieren zu können.
Die Berechnung dorthin verlagern, wo die Daten liegen
Python eignet sich gut, wenn das Modell komplex ist, das Ergebnis granular sein muss oder das Team spezialisierte wissenschaftliche Bibliotheken benötigt. Datenteams in Unternehmen benötigen oft ein anderes Muster. Sie möchten Stichproben aus historischen Warehouse-Daten ziehen, diese mit Produktionstabellen verknüpfen und Qualitätsmetriken berechnen, ohne sensible Datensätze exportieren zu müssen.
Snowflake, BigQuery und Databricks können Warehouse-native Muster unter Verwendung von SQL-Zufallsfunktionen, Common Table Expressions, Array-Generatoren oder benutzerdefinierten Tabellenfunktionen unterstützen. Ein typisches Design generiert eine Iterationsrelation, zieht Stichproben von Eingabeparametern für jede Iteration, verknüpft diese Parameter mit aggregierten historischen Metriken, wertet den Zielausdruck aus und speichert nur die Simulationsergebnisse.
Dieses Muster belässt die Quelldaten im Warehouse, vermeidet unnötige Datenverschiebungen und ermöglicht es parallelen Workern, die Iterationsarbeit über die Execution Engine der Plattform zu bewältigen. Das Team kann kompakte Ergebnistabellen materialisieren, die Mittelwerte, Standardabweichungen, Perzentile und Verletzungsindikatoren enthalten, anstatt Rohspalten zu übertragen.
Eine praktische Diskussion darüber, wie Qualitätsberechnungen nahe an den Warehouse-Daten gehalten werden können, finden Sie unter In-Database-Ausführung der Datenqualität.
Wählen Sie Python, wenn das Modell spezialisierte Bibliotheken oder Ergebnisse auf Zeilenebene erfordert. Wählen Sie SQL oder eine Warehouse-native Funktion, wenn Datenresidenz, große Quelltabellen, governance und die Granularität der aggregierten Ergebnisse am wichtigsten sind.
Anwendung der Monte-Carlo-Simulationsmethode in der Enterprise Data Quality
Datenqualitätsteams können Simulationen nutzen, um historisches Verhalten in ein quantifiziertes operationelles Risiko zu übersetzen. Die nützliche Einheit ist nicht immer ein Kunde oder eine Transaktion. Es kann eine Tabellenpartition, ein Lieferereignis, eine Schemaversion oder eine im Laufe der Zeit beobachtete Geschäftsmetrik sein.
Timeliness und Pipeline-Frische
Ein Frischemodell kann Stichproben aus dem historischen Verhalten der Zeilenankunft ziehen und die Wahrscheinlichkeit berechnen, dass ein Datensatz nach seinem erwarteten Lieferfenster eintrifft. Anstelle eines einzigen statischen Schwellenwerts kann das Modell Schwankungen im Quell-Timing, in der Batch-Größe, in vorgelagerten Abhängigkeiten und in der Verarbeitungsdauer berücksichtigen.
Dieses Ergebnis unterstützt eine präzisere Alarmierungsentscheidung. Ein Team kann eine gewöhnliche verspätete Ankunft von einer Kombination von Bedingungen unterscheiden, die ein erhebliches nachgelagertes Risiko birgt. Es kann auch die simulierte Fertigstellungsverteilung nutzen, um die Kapazitätsplanung und die Priorisierung von Vorfällen zu unterstützen.
Schema-Drift und nachgelagerte Auswirkungen
Schema-Simulationen können mögliche strukturelle Änderungen darstellen, wie beispielsweise eine hinzugefügte Spalte, ein entferntes Feld oder eine Änderung des Datentyps. Das Modell kann dann bewerten, ob jede Änderung mit nachgelagerten Abfragen, Dashboards, Validierungsregeln oder Ingestion-Verträgen kollidiert.
Das Ergebnis ist eine wahrscheinlichkeitsorientierte Betrachtung des Änderungsrisikos. Eine Schemaänderung kann für einen Empfänger harmlos, für einen anderen jedoch störend sein. Die Simulation des Abhängigkeitsgraphen hilft Teams, ihre Prüfungsbemühungen dorthin zu lenken, wo eine strukturelle Änderung am wahrscheinlichsten ein kritisches Ergebnis beeinträchtigt.
Adaptive Null-Raten- und Anomalie-Überwachung
Null-Raten-Verteilungen können aus Bootstrap-Stichproben der jüngsten Partitionen generiert werden. Diese Stichproben bewahren beobachtete Abweichungen und können Schwellenwerten helfen, sich an saisonales Verhalten anzupassen, anstatt sich auf starre statische Grenzwerte zu verlassen. Derselbe Ansatz kann die Anomalieerkennung für Volumina, Duplikatsraten, Frische und andere Qualitätsmetriken unterstützen.
Die KPI-Volatilitätsmodellierung fügt eine weitere Ebene hinzu. Ein Team kann Umsatzpfade unter korreliertem Eingangsrauschen simulieren und dann Konfidenzbänder präsentieren, die Führungskräfte interpretieren können, ohne eine Punktprognose mit Gewissheit zu verwechseln.
digna kombiniert Datenanomalieerkennung, Timeliness-Überwachung, Validierung, Schema-Tracking und Business-Monitoring auf einer In-Database-Plattform. Ihr Ausführungsmodell belässt sensible Spaltendaten in der Umgebung des Kunden und generiert gleichzeitig statistische Ergebnisse, die Teams für Observability-Entscheidungen nutzen können. Der Monte-Carlo-Ansatz für Data Observability zeigt, wie Simulationen Vermutungen durch quantifiziertes Risiko für die von einer Plattform ausgegebenen Alarme ersetzen können.
Häufige Missverständnisse und eine praktische Checkliste
Eine Monte-Carlo-Simulation macht ein schwaches Modell nicht vertrauenswürdig. Zufallsziehungen können die falsche Verteilung mit beeindruckender Beständigkeit reproduzieren, und eine große Ergebnismenge kann fehlerhaften Annahmen den Anschein von Autorität verleihen.
Vier Missverständnisse führen in der Produktion immer wieder zu Problemen:
Zufällig bedeutet richtig: Ein Pseudozufallsgenerator zieht Stichproben aus der von Ihnen angegebenen Verteilung. Er kann nicht feststellen, ob diese Verteilung das tatsächliche Pipeline-Verhalten widerspiegelt.
Mehr Iterationen beseitigen jeden Fehler: Mehr Durchläufe verringern die Stichprobenvarianz, beseitigen jedoch keine Verzerrungen, die durch fehlende Abhängigkeiten, schlechte Daten oder ein falsch spezifiziertes Modell verursacht werden.
Eine Normalverteilung passt standardmäßig: Betriebsdaten können schief, saisonal, begrenzt oder schwerfällig (heavy-tailed) sein. Die Wahl der Verteilung muss durch Belege aus dem Quellverhalten gestützt werden.
Varianzreduktion ist automatisch besser: Antithetische, kontrollierte, stratifizierte und Importance-Stichproben bringen jeweils eigene Annahmen mit sich. Eine Technik, die für eine Arbeitslast geeignet ist, kann eine andere verzerren.
Quasi-Zufallsfolgen können manchmal den Integrationsfehler bei gleichem Rechenbudget verringern, erfordern jedoch andere Überlegungen als die gewöhnliche Pseudozufallsstichprobe. Betrachten Sie sie als eine zu testende Modellierungsoption, nicht als universellen Ersatz.
A runbook checklist
Überprüfen Sie vor der Durchführung einer Produktionssimulation Folgendes:
Validieren Sie Verteilungen: Vergleichen Sie das historische und das angepasste Verhalten mit Tests wie dem Kolmogorov-Smirnov- oder dem Anderson-Darling-Test und besprechen Sie das Ergebnis mit dem fachlichen Verantwortlichen (Domain Owner).
Legen Sie die Präzision zuerst fest: Definieren Sie die gewünschte Breite des Konfidenzintervalls, bevor Sie die Anzahl der Iterationen wählen.
Protokollieren Sie den Seed: Speichern Sie den Seed, die Eingabeversion, die Verteilungsparameter und die Modellversion zur Reproduzierbarkeit.
Halten Sie große Datenmengen nah: Bevorzugen Sie datenbankinterne Stichprobenziehungen, wenn die Quellzeilen groß oder sensibel sind.
Überprüfen Sie Abhängigkeiten: Prüfen Sie, ob sich vorgelagerte Variablen gemeinsam bewegen, anstatt Unabhängigkeit vorauszusetzen.
Testen Sie seltene Ereignisse: Vergleichen Sie Tail-Schätzungen mit alternativen Stichprobenstrategien und überprüfen Sie deren Gewichtung.
Überprüfen Sie Annahmen regelmäßig: Überprüfen Sie Verteilungen und die Wahl der Varianzreduktion in einem regelmäßigen Betriebszyklus.
Ein verantwortungsvoller Monte-Carlo-Workflow ist statistisches Engineering, kein Knopf mit der Aufschrift „Ausführen“. Das Modell sollte Unsicherheiten sichtbar machen, seine Annahmen offenlegen und den Bedienern einen klaren Grund geben, dem Ergebnis zu vertrauen oder es infrage zu stellen.
digna bietet In-Database-Datenqualitäts- und Observability-Funktionen für Anomalieerkennung, Timeliness, Validierung, Schema-Tracking und Business-Monitoring. Nutzen Sie die Monte-Carlo-Simulationsmethode, um Pipeline- und KPI-Risiken dort zu quantifizieren, wo Ihre Daten bereits liegen, und besuchen Sie digna, um einen Bereitstellungsansatz für Unternehmen zu erkunden.
Häufig gestellte Fragen
Wann greifen Engineers zur Monte-Carlo-Methode?
Wenn eine analytische Antwort außer Reichweite liegt. Ein Team kennt vielleicht das historische Verhalten jeder vorgelagerten Quelle und kann dennoch die Chance nicht berechnen, eine feste Lieferfrist zu verfehlen. Also stellt es Eingaben als Verteilungen dar, erzeugt synthetische Läufe und aggregiert die Ergebnisse zu einer Wahrscheinlichkeit.
Wie begann die Methode?
Mit Stanisław Ulam, der während einer Genesung über Solitär nachdachte und erkannte, dass wiederholtes zufälliges Spielen ein Ergebnis schätzen kann, das die direkte Kombinatorik umständlich macht. Er teilte die Idee mit John von Neumann in Los Alamos, und die moderne Rechenform entstand Mitte der 1940er Jahre.
Was zählt als ein Simulationslauf?
Ein synthetischer Betriebstag. Jeder Lauf zieht aus den Eingabeverteilungen, spielt die Pipeline vorwärts und hält fest, ob das Ergebnis die interessierende Bedingung erfüllte, etwa den Abschluss vor dem SLA. Tausende solcher Tage aggregiert ergeben die Wahrscheinlichkeitsschätzung.
Welche Unsicherheiten lohnen die Modellierung?
Nur jene, die die Entscheidung verändern. Zufällige Eingaben zu ergänzen, die das SLA nicht berühren, erhöht nur die Komplexität ohne die Antwort zu verbessern. Beginnen Sie deshalb bei der Entscheidung und arbeiten Sie rückwärts zu den Variablen, die sie wirklich bewegen.
Wozu dient Varianzreduktion?
Um mit weniger Läufen zu einer brauchbaren Schätzung zu kommen. Statt einfach mehr zu simulieren, strukturieren Varianzreduktionstechniken die Stichprobenziehung so um, dass die Schätzung schneller konvergiert. Das zählt, wenn jeder Lauf teuer ist oder die Simulation in der Datenbank neben produktiven Lasten läuft.


