10 Monte-Carlo-Simulationsanwendungen in der Datenstrategie
|
9
min. Lesezeit

Die Monte-Carlo-Simulation sagt keine garantierte Zukunft voraus. Sie wandelt unsichere Eingangsgrößen in Wahrscheinlichkeitsverteilungen um und zieht dann wiederholt Stichproben aus diesen Eingangsgrößen, um zu zeigen, wie sich die Ergebnisse unter verschiedenen Bedingungen verhalten können. Die Methode wurde in den 1940er Jahren von Stanislaw Ulam entwickelt und entwickelte sich später zum Standard in den Bereichen Finanzen, Ingenieurwesen, Physik, Logistik, Gesundheitswesen, Klimawissenschaft, Fertigung und Projektmanagement. Ein wegweisender Artikel im 1964 Harvard Business Review von David Hertz trug dazu bei, ihre Rolle in der Unternehmensfinanzierung zu etablieren, und moderne Modelle führen heute üblicherweise Tausende oder Millionen von Zufallsversuchen für Anwendungen wie die Bewertung von Aktienoptionen, Projektfinanzierung und Realoptionsanalysen durch (Corporate Finance Institute).
Das macht die Methode mächtig, aber auch anfällig für Missbrauch. Eine Simulation kann Unsicherheiten in großem Maßstab verarbeiten, liefert aber dennoch irreführende Ergebnisse, wenn ihre Eingangsdaten verzögert, unvollständig, anomal, falsch verteilt, auf falsche Weise korreliert oder strukturell verändert sind. Die zehn unten aufgeführten Anwendungen von Monte-Carlo-Simulationen konzentrieren sich daher auf mehr als nur das Modell selbst. Jede einzelne verbindet die Entscheidung mit den Datenbedingungen, die darüber entscheiden, ob das Ergebnis Vertrauen verdient.
Stellen Sie vier Fragen, bevor Sie ein Ergebnis als entscheidungsreif betrachten: Welche Variablen benötigen Wahrscheinlichkeitsverteilungen? Welche historischen Daten oder Live-Daten stützen diese Verteilungen? Wo könnten die Annahmen versagen? Wie wird Observability ungültige, verspätete, anomale oder strukturell veränderte Eingangsdaten erkennen, bevor sie das Ergebnis verfälschen?
Inhaltsverzeichnis
4. Schadenprognose- und Preisgestaltungsmodelle im Versicherungswesen
7. Modellierung der Auswirkungen von Umwelt- und Klimaveränderungen
8. Qualitätskontrolle in der Fertigung und Prognose von Fehlerraten
9. Budgetplanung im öffentlichen Sektor und fiskalische Wirkungsanalyse
Von simulierten Szenarien zu vertrauenswürdigen Entscheidungen
1. Finanzielle Risikobewertung und Portfoliomodellierung
Die Monte-Carlo-Simulation ist im Finanzwesen am nützlichsten, wenn die Entscheidung von vielen möglichen Marktentwicklungen abhängt. Analysten modellieren unsichere Marktrenditen, Zinssätze, Inflation und Cashflows für Portfolioptimierung, Value at Risk, Expected Shortfall, Altersvorsorgeplanung, Stresstests, Derivatebewertung und Asset-Liability-Analyse (Finanzanwendungen der Monte-Carlo-Simulation). Pfadabhängige Derivate erfordern besondere Sorgfalt, da ihr Wert davon abhängt, wie sich die Bedingungen entwickeln, und nicht nur vom Endergebnis.
Vertrauen in das Ergebnis beginnt bei den Eingaben. Verspätete Preise können veraltete Szenarien erzeugen, instabile Korrelationen können die Diversifizierung verfälschen, und ein geänderter Feldtyp kann Berechnungen verändern, ohne das Modell zu stoppen. Historische Daten benötigen zudem ausreichend Kontinuität und strukturelle Konsistenz, um die ausgewählten Verteilungen und Beziehungen zu stützen.
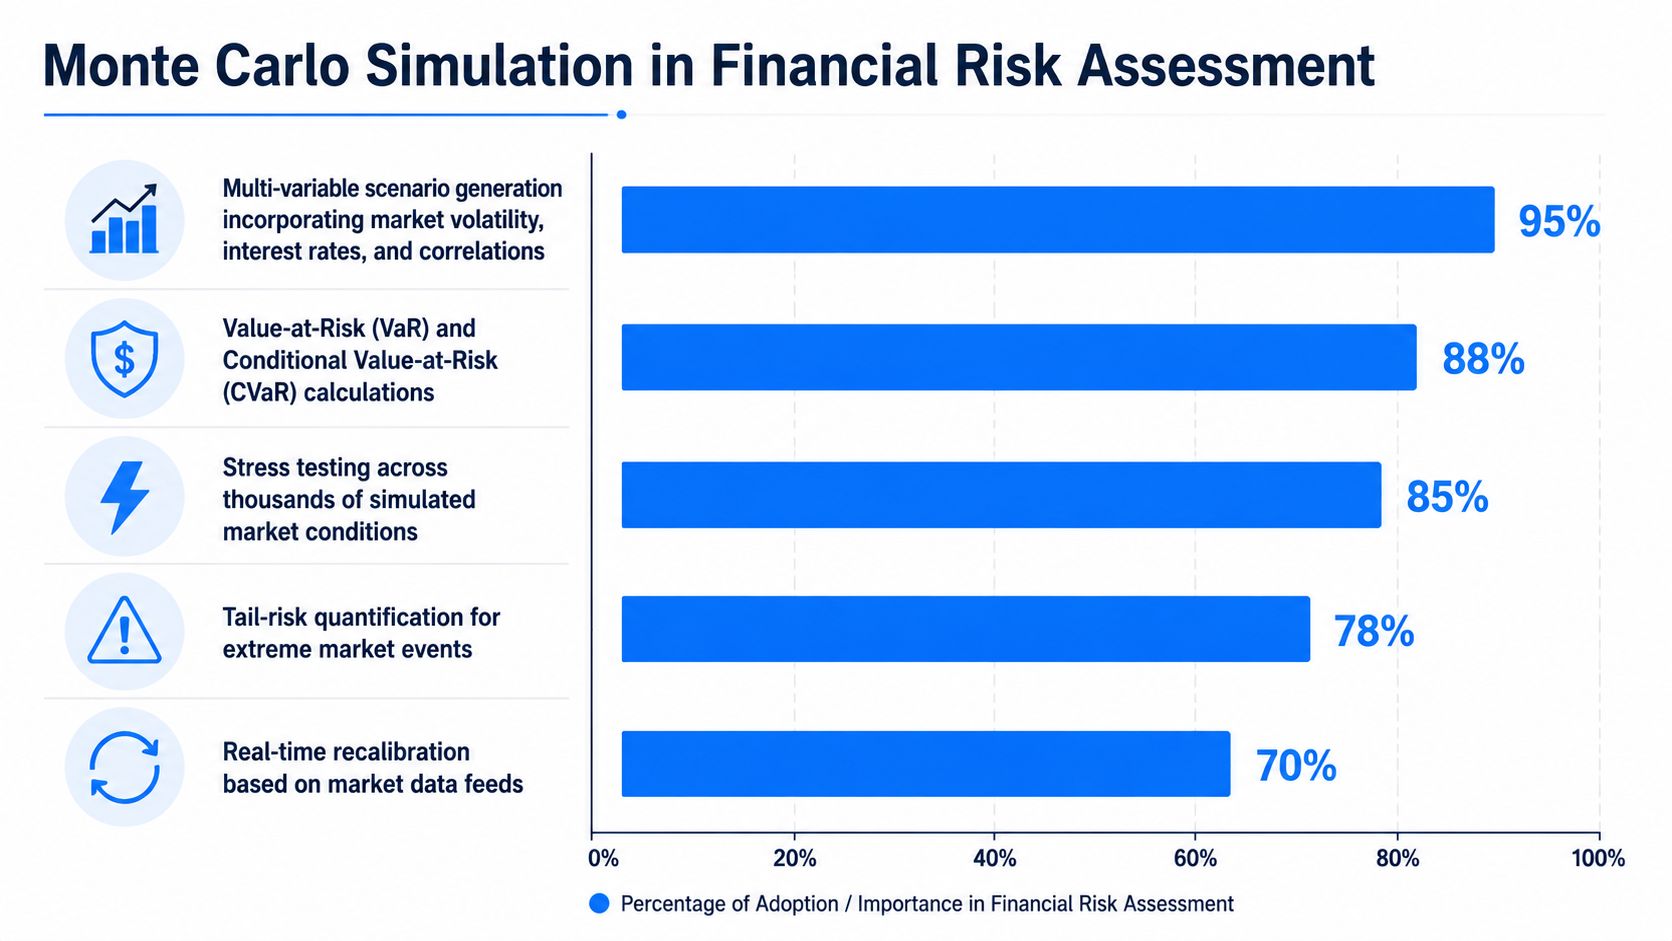
Datenkontrollen, die Risikoergebnisse schützen
Ein praktischer Observability-Workflow sollte:
Quelldatensätze validieren: Preise, Positionen, Risikopositionen und Klassifizierungen vor jedem Simulationslauf prüfen.
Bereitstellung von Markt-Feeds überwachen: Fehlende oder verzögerte Beobachtungen melden, bevor veraltete Werte in aktuelle Szenarien einfließen.
Erwartetes und beobachtetes Verhalten vergleichen: Richtwerte für Risikokennzahlen festlegen und ungewöhnliche Ergebnisbewegungen untersuchen, einschließlich Änderungen, die nicht durch Marktbedingungen erklärt werden können.
Strukturelle Abweichungen verfolgen: Hinzugefügte, entfernte oder neu typisierte Spalten erkennen, bevor sich nachgelagerte Berechnungen ändern.
Für Banken und andere regulierte Institutionen verbindet das Finanzdaten-Qualitätsmanagement für Banken Genauigkeit, Rückverfolgbarkeit und Berichtskontrollen. Dasselbe Prinzip gilt für die KI-Analyse im Aktienresearch, bei der Schlussfolgerungen von Daten abhängen, die zeitnah und zweckmäßig bleiben.
Die Observability sollte sowohl Modelleingaben als auch geschäftliche Signale abdecken, wie z. B. das Gesamtengagement, Verletzungen von Risikogrenzen und Änderungen der Portfoliokonzentration. Diese Signale helfen Analysten, echte Marktbewegungen von Pipeline-Fehlern oder Annahmeabweichungen zu unterscheiden.
Praktische Regel: Eine stabile Simulations-Engine kann instabile Marktdaten oder undokumentierte Annahmen nicht kompensieren.
2. Wirkstoffentwicklung und klinische Prüfungssimulation
Das Gesundheitswesen nutzt Monte-Carlo-Methoden, um Unsicherheiten über Patientenpfade, Behandlungsergebnisse, ökonomische Bewertungen und Nutzen-Risiko-Entscheidungen fortzupflanzen. Eine systematische Übersichtsarbeit identifizierte vier breite Einsatzzwecke im Gesundheitswesen: Gesundheitsrisiko- und Dosis-Wirkungs-Abschätzung, ökonomische Bewertung, Vergleich konkurrierender Technologien oder Strategien sowie verschiedene Machbarkeitsstudien oder Literaturarbeiten. Diese Kategorien enthielten in der Übersichtsarbeit 60, 18, 41 bzw. 23 Arbeiten (systematische Übersicht über Monte-Carlo-Anwendungen im Gesundheitswesen).
Klinische Forscher können simulierte Kohorten nutzen, um zu untersuchen, wie die Behandlungsreaktion je nach Patientencharakteristika variiert, wie sich eine unvollständige Rekrutierung auf die Studienergebnisse auswirkt oder wie sich konkurrierende Therapien über einen langen Zeitraum verhalten. Monte-Carlo-Methoden sind besonders wertvoll für die Optimierung der Krebstherapie, die personalisierte Medizin, die Vorhersage von Krankheitsverläufen und die Nutzen-Risiko-Bewertung. In einer Übersichtsarbeit zum Gesundheitswesen wird außerdem festgestellt, dass simulierte therapeutische Antibiotikakurven experimentellen Ergebnissen sehr nahe kommen können, während die Bayesianische Monte-Carlo-Regression für begrenzte, aber komplexe epidemiologische Datensätze geeignet sein kann (Monte Carlo in der Entscheidungsmodellierung im Gesundheitswesen).
Das Datenrisiko hat ungewöhnlich weitreichende Folgen. Fehlende Patientenakten, inkonsistente Codierung von unerwünschten Ereignissen, verzögerte Ergebnisberichte oder eine Änderung des Schemas der elektronischen Patientenakte können die scheinbare Form einer Verteilung verändern, ohne dass der Simulationscode geändert wird.
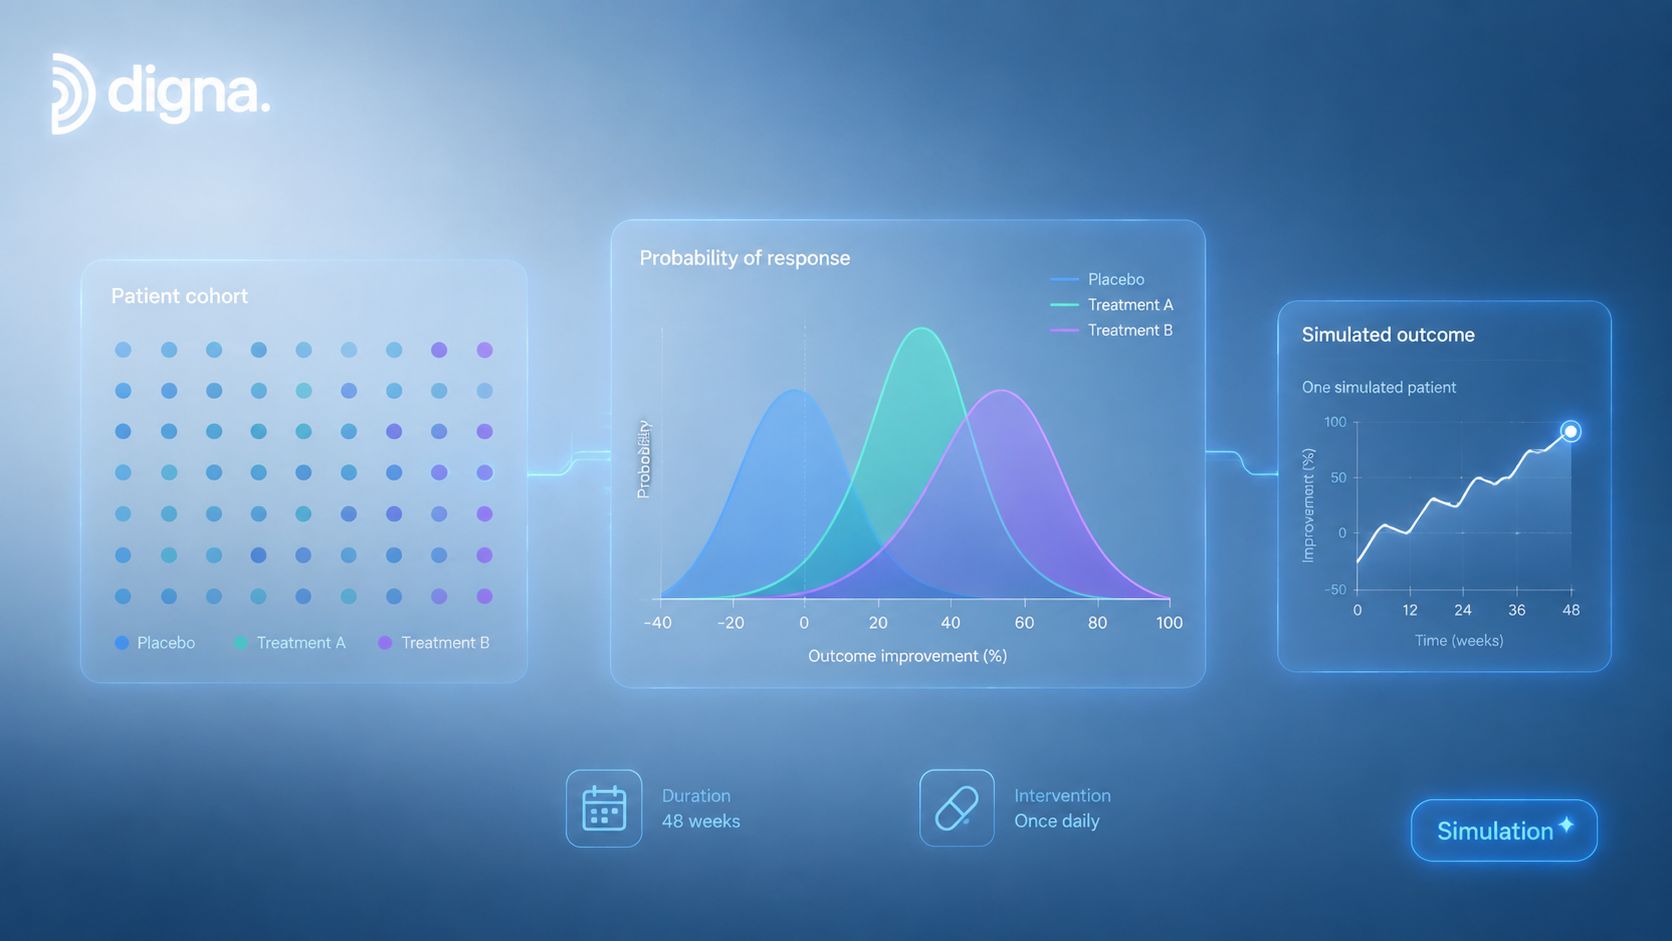
Reliability depends on clinical data lineage
Teams im Gesundheitswesen sollten jede Modelleingabe mit Kontrollen verbinden, die folgende Fragen beantworten:
Sind die erforderlichen Felder vollständig? Validierungsregeln können Patienten-, Behandlungs-, Registrierungs- und Ergebnisdaten überprüfen.
Verhalten sich unerwünschte Ereignisse plausibel? Die Erkennung von Data Anomalies kann ungewöhnliche Berichtsmuster für Untersuchungen aufdecken.
Treffen Ergebnisse planmäßig ein? Die Überwachung der Timeliness unterscheidet eine echte Veränderung von einer Verzögerung in der Berichterstattung.
Hat sich die Quellstruktur geändert? Die Schema-Verfolgung kann Änderungen in elektronischen Aufzeichnungen identifizieren, bevor Pipelines ausfallen.
Dies ist der Zweck der klinischen Datenvalidierung und regulatorischen Regeln in großem Maßstab. In diesem Umfeld ist Observability nicht nur ein technischer Komfort. Sie hilft, den Prüfpfad zwischen Quelldaten, modellierter Unsicherheit und einer Entscheidung, die sich auf Patienten oder behördliche Einreichungen auswirken kann, aufrechtzuerhalten.
3. Lieferketten- und Logistikoptimierung
Lieferkettenmodelle scheitern selten daran, dass Planer vergessen haben, dass die Nachfrage unsicher ist. Sie scheitern, weil die Unsicherheit mit Daten dargestellt wurde, die den aktuellen Betrieb nicht mehr beschreiben. Die Monte-Carlo-Simulation kann variable Nachfrage, Lieferantenlieferzeiten, Transportverzögerungen, Lagerbestände und Logistikkosten kombinieren, um Bestandsrichtlinien und Vertriebsoptionen unter vielen möglichen Bedingungen zu bewerten.
Ein Lagerteam könnte das Modell nutzen, um Nachbestellstrategien zu vergleichen. Ein Logistikplaner könnte untersuchen, wie verspätete Lieferantenlieferungen mit Nachfragewellen und Transportstörungen interagieren. Das nützliche Ergebnis ist kein einzelnes Bestandsziel. Es ist ein Blick auf den Kompromiss zwischen Verfügbarkeit, Betriebskapital, Servicerisiko und operativer Resilienz.
Watch the inputs that shape the scenario range
Lieferkettendaten benötigen Kontrollen an mehreren Stellen:
Validierung der Lieferzeiten: Überprüfen, ob Lieferanten- und Spediteurdatensätze plausible Werte und einheitliche Einheiten enthalten.
Überprüfung von Nachfrageanomalien: Plötzliche Prognose- oder Auftragsänderungen untersuchen, bevor Verteilungen daran angepasst werden.
Pünktlichkeit der Lieferung: Fehlende Sendungsereignisse und verspätete Bestätigungen erkennen, die den aktuellen Lagerbestand besser erscheinen lassen können, als er ist.
Schema-Änderungs-Tracking: Logistik- und Lagersysteme auf strukturelle Änderungen überwachen, die Felder entfernen oder neu interpretieren könnten.
Die übergeordnete Pipeline ist ebenso wichtig wie das Simulations-Notebook. Eine Datenpipeline-Architektur, die für zuverlässige Bewegungen und Transformationen ausgelegt ist, bietet Teams einen klareren Ort zur Überwachung von Erfassung, Transformationen und nachgelagertem Verbrauch.
Amazon, Walmart und Unilever werden in Branchendiskussionen über simulationsgestützte Bestands-, Standort- und Netzwerkplanung oft genannt, aber die operative Lehre ist allgemeiner Natur. Ein Modell kann nicht ableiten, ob eine Erhöhung der Lieferzeit auf ein echtes Lieferantenproblem, eine geänderte Zeitstempelkonvention oder einen verzögerten Feed zurückzuführen ist. Die Observability muss diese Unterscheidung sichtbar machen, bevor Planer auf der Grundlage der Ergebnisse handeln.
4. Schadenprognose- und Preisgestaltungsmodelle im Versicherungswesen
Versicherungssimulationen sind nur so zuverlässig wie die dahinter stehenden Schadendaten. Preis- und Reservierungsmodelle stellen die Unsicherheit in Bezug auf Schadenhäufigkeit und Schadenschwere dar. Die Monte-Carlo-Simulation ermöglicht es Aktuaren, mögliche Verluste abzuschätzen, die Angemessenheit von Reserven zu prüfen, Preisannahmen zu vergleichen und das Solvenzrisiko unter verschiedenen Bedingungen zu untersuchen. Sie unterstützt auch Katastrophen- und Asset-Liability-Analysen, bei denen Durchschnittswerte das Tail-Risk verschleiern können (Monte-Carlo-Anwendungen im Finanz- und Versicherungswesen).
Die Schadenklassifizierung bestimmt, ob eine simulierte Verschiebung das Risiko oder eine Datenbewegung widerspiegelt. Ein Anstieg schwerer Verluste kann auf ein echtes Risiko, eine Änderung der Schadenbearbeitung, doppelte Datensätze oder eine geänderte Codierung zurückzuführen sein. Wenn Analysten jede Änderung als geschäftliches Ereignis behandeln, legt der Versicherer die Preise möglicherweise auf der Grundlage eines Fehlers in seinen Quelldaten fest.
Aktuarische Bewegungen von Datenbewegungen trennen
Vor der Durchführung von Preis- oder Reserve-Simulationen sollten Teams:
Vollständigkeit der Schäden validieren: Erforderliche Felder, Policenbeziehungen, Deckungsregeln und Klassifizierungslogik prüfen.
Ungewöhnliche Schadenschwere untersuchen: Schadenmuster mit Risiko- und historischen Daten vergleichen, um potenzielle Datenqualitätsprobleme zu identifizieren.
Verarbeitungspläne überwachen: Verfolgen, ob Schadeneingaben und Reserveanpassungen pünktlich eingehen.
Schemaänderungen aufzeichnen: Änderungen am Schadensystem identifizieren, die aktuarische Extrakte oder nachgelagerte Formeln verändern könnten.
Die Observability sollte diese Eingangsdatenprüfungen mit geschäftlichen Signalen verknüpfen. Ein fehlendes Deckungsfeld kann die Segmentierung beeinflussen, während verzögerte Reserveaktualisierungen die aktuellen Verbindlichkeiten niedriger erscheinen lassen können, als sie sind. Die Überwachung sollte daher sowohl den Datenzustand als auch die resultierende Änderung bei der Preisgestaltung, den Reserven oder den Risikomaßen aufzeigen.
State Farm, Lloyd's of London und Berkshire Hathaway werden mit Versicherungsmodellierung in Verbindung gebracht, einschließlich Reservierungs-, Katastrophen- und Preisgestaltungsarbeiten. Ihre Beispiele ersetzen jedoch nicht die lokale Validierung. Risikodefinitionen, Schadensverfahren und das Verhalten von Quellsystemen unterscheiden sich je nach Versicherer, sodass eine für ein Portfolio geeignete Verteilung für ein anderes möglicherweise nicht passt.
Für die Financial Services-Lösung von digna ist die operative Verbindung direkt. Data Validation schützt Geschäftsregeln, die Erkennung von Data Anomalies hinterfragt unerwartete Schadenmuster, die Überwachung der Timeliness deckt veraltete Reserven auf und die Schema-Verfolgung hilft, die Modellkontinuität zu wahren.
5. Öl- und Gasexploration und Reservenschätzung
Entscheidungen im Untergrund basieren auf unvollständigem Wissen. Geologen und Ingenieure nutzen die Monte-Carlo-Simulation, um die Unsicherheit bezüglich Lagerstättengröße, Erholungsfaktoren, Bohrkosten, Produktionsverhalten und Projektökonomie darzustellen. Die resultierende Verteilung hilft Teams bei der Bewertung von Reservenschätzungen, der Durchführbarkeit von Bohrungen, Portfoliooptionen und den Konsequenzen verschiedener geologischer Interpretationen.
Ein Reservemodell kann mathematisch korrekt und dennoch operativ irreführend sein. Seismische Interpretationsdaten können revidiert werden, Bohrlochmessungen können verspätet eintreffen oder Produktionswerte können sich ändern, weil Geräte gealtert sind. Wenn diese Änderungen nicht von gewöhnlichen Abweichungen unterschieden werden, kann die Simulation einem Messproblem statt einer geologischen Möglichkeit eine Wahrscheinlichkeit zuweisen.
Bedeutung von Felddaten bewahren
Nützliche Kontrollen umfassen:
Validierung der Interpretation: Seismische Eingaben und Konfidenzfelder anhand definierter Qualitätsgrenzwerte prüfen.
Pünktlichkeit der Produktion: Verzögerte oder fehlende Bohrlochberichte kennzeichnen, bevor Modelle zur Reserveaktualisierung unvollständige Historien verarbeiten.
Erkennung von Messanomalien: Ungewöhnliche Produktionsmuster untersuchen, die auf Geräteprobleme oder Sensorfehler hindeuten könnten.
Schema-Verfolgung von Bohrlochprotokollen: Strukturelle Änderungen in Protokollierungssystemen erkennen, bevor Interpretationstools oder Extrakte ausfallen.
Shell, ExxonMobil und Saudi Aramco sind Beispiele, die mit Simulationen bei der Reservenschätzung, Projektbewertung und Erschließungsplanung in Verbindung gebracht werden. Ihre Skalierung verdeutlicht auch, warum Observability in die Nähe der Datenplattform gehört. Große Betriebsumgebungen führen zu häufigen Revisionen, und ein Modell benötigt versionierte Annahmen und eine sichtbare Datenherkunft, wenn von Entscheidungsträgern erwartet wird, dass sie die Ergebnisse verteidigen.
Der zentrale Kompromiss liegt zwischen Geschwindigkeit und Genauigkeit. Schnellere Modellaktualisierungen können eine agilere Planung unterstützen, aber nur, wenn die Teams sehen können, ob neue Daten vollständig, aktuell und strukturell mit dem vorherigen Lauf vergleichbar sind.
6. Kapazitätsplanung für Telekommunikationsnetze
Telekommunikationsbetreiber nutzen die Monte-Carlo-Simulation, um unsicheres Datenwachstum, Teilnehmerneuzugänge, Datenverbrauchsraten, Technologienutzung und Infrastrukturnachfrage zu untersuchen. Das Modell hilft Planern, Netzinvestitionsentscheidungen mit einer Reihe möglicher Lasten zu vergleichen, anstatt sich auf einen einzigen Wachstumspfad festzulegen.
Diese Anwendung offenbart eine besonders schwierige Datenbedingung: Das Netzwerkverhalten ändert sich im Laufe der Zeit. Ein Verkehrsmuster, das vor einer Produkteinführung, einem Ausfall, einem DDoS-Angriff oder einer Technologiemigration normal war, bietet möglicherweise keine stabile Grundlage mehr für zukünftige Stichproben. Wenn alle historischen Beobachtungen als austauschbar behandelt werden, kann dies eine Simulation zwar präzise, aber schlecht kalibriert machen.
Sich änderndes Netzwerkverhalten sichtbar machen
Ein Kapazitäts-Workflow sollte Folgendes kombinieren:
Validierung von Messungen: Regionale Verkehrsdaten auf Vollständigkeit, Einheitenkonsistenz und plausible Bereiche prüfen.
Pünktlichkeit von Feeds: Verzögerte Analyseladungen erkennen, bevor Planer sich auf veraltete Verkehrsprognosen verlassen.
Erkennung von Nutzungsanomalien: Ungewöhnliche Kundennachfrage von Netzwerkfehlern, Angriffen und Messfehlern trennen.
Überwachung von Managementschemata: Änderungen in Netzwerksystemen verfolgen, die Metriken unbrauchbar machen oder ihre Bedeutung verändern könnten.
Verizon, Deutsche Telekom und China Mobile sind Beispiele, die mit Simulationen für Bereitstellungs-, Kapazitäts- und Teilnehmerwachstumsplanung in Verbindung gebracht werden. Ihre Betriebsumgebungen unterscheiden sich, sodass die wichtigste Frage bei der Implementierung nicht lautet, ob Monte Carlo ausgeführt werden kann. Sondern ob die Daten über die verglichenen Zeiträume hinweg dieselben Dienstdefinitionen, Regionen und Messlogiken widerspiegeln.
Die Telecommunications-Lösung von digna kann diese Kontrollen über hochvolumige Kunden- und Betriebsdaten hinweg verknüpfen. Das unterstützt einen fundierteren Workflow, bei dem eine Kapazitätswarnung nicht nur das simulierte Risiko, sondern auch Belege für die Aktualität und Integrität der dahinter stehenden Daten enthält.
Eine Verkehrsverteilung ist nur dann nützlich, wenn das Team weiß, unter welchen Betriebsbedingungen sie entstanden ist.
7. Modellierung der Auswirkungen von Umwelt- und Klimaveränderungen
Klimasimulationen sind nur so glaubwürdig wie die Datenbedingungen, die ihren Unsicherheitsbereichen zugrunde liegen. Umweltmodelle kombinieren Beobachtungen, Parameter, Emissionspfade, physikalische Reaktionen und politische Annahmen. Monte-Carlo-Methoden pflanzen Abweichungen über diese Eingangsdaten fort und ermöglichen es Forschern, eine Verteilung möglicher Auswirkungen zu untersuchen, anstatt eine einzige deterministische Zukunft vorherzusagen. Sie werden in der Klimawissenschaft und anderen wissenschaftlichen Bereichen eingesetzt, um zu bewerten, wie sich unsichere Eingangsdaten auf Modellergebnisse auswirken.
Das Hauptdatenrisiko ist die strukturelle Inkonsistenz. Umweltsensoren, Satellitenprodukte, Stationsaufzeichnungen und modellierte Datensätze können sich in Auflösung, Kalibrierung, Zeitstempeln und Definitionen unterscheiden. Wenn diese Unterschiede nicht dokumentiert sind, kann eine Simulation eine Änderung im Beobachtungssystem als Klimasignal interpretieren. Stabile Ergebnisse erfordern daher sowohl statistische Analysen als auch Kontrollen über Herkunft, Versionierung und Vorverarbeitung.
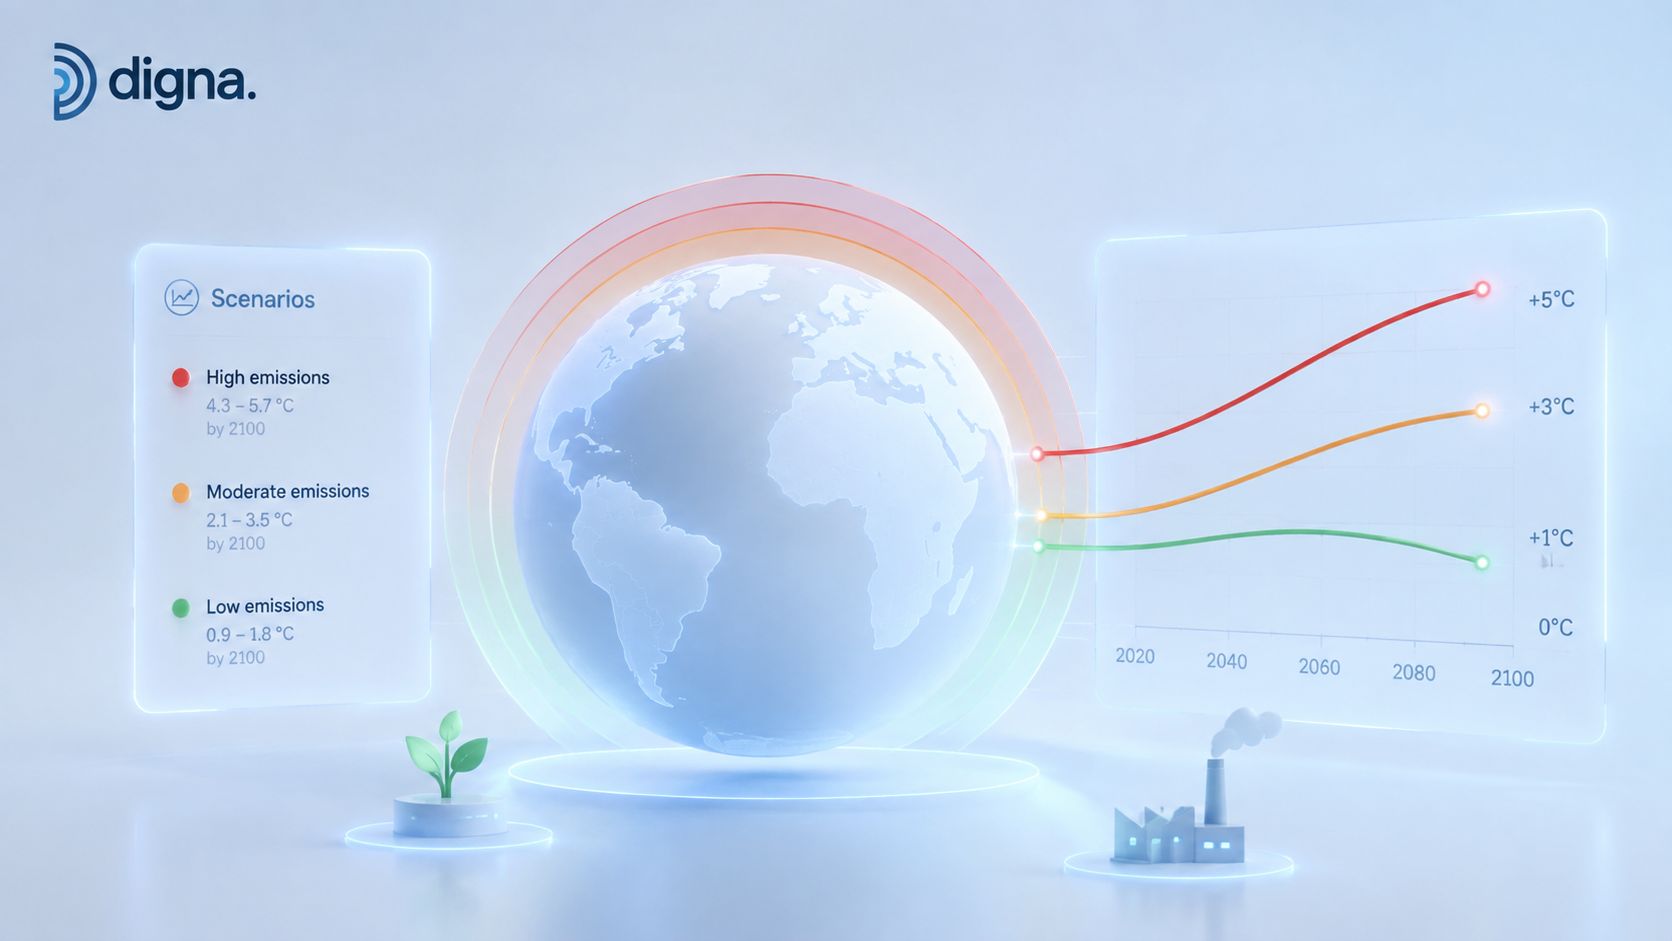
Herkunft als Teil des Modells behandeln
Umweltteams können die mit jedem Lauf verbundenen Eingaben und Geschäftsentscheidungen überwachen, indem sie:
Beobachtungen validieren: Konsistenz über Stationen, Zeiträume, Einheiten und Erfassungsmethoden hinweg prüfen.
Eintreffenmuster überwachen: Fehlende oder verzögerte Sensor-Feeds melden, bevor ein unvollständiges Zeitfenster in einen Modelllauf einfließt.
Messanomalien erkennen: Spitzen untersuchen, die auf Instrumente, Vorverarbeitung oder Übertragung und nicht auf Umweltveränderungen zurückzuführen sein können.
Pipeline-Struktur verfolgen: Schema-, Quell- und Transformationsänderungen in Satelliten- und Klimadaten-Workflows aufzeichnen.
Die in diesen Workflows verwendeten statistischen Methoden zur Datenanalyse sollten die Volatilität der Eingangsdaten untersuchen, ungewöhnliches Verhalten identifizieren und Belege für die Daten hinter jedem Ergebnis aufbewahren. Die Überwachung sollte auch Simulationsergebnisse mit Entscheidungen wie Investitionsannahmen, Anpassungsprioritäten und politischen Szenarien verknüpfen.
Die Bewertungsarbeit des IPCC, die Klimarisikoanalysen der Weltbank und die bei Investitionsentscheidungen genutzten Klimaszenarioanalysen betreffen unterschiedliche Akteure, teilen jedoch eine Governance-Anforderung: Analysten müssen die Unsicherheit der Umweltbedingungen von der durch die Datenpipeline eingebrachten Unsicherheit trennen.
8. Qualitätskontrolle in der Fertigung und Prognose von Fehlerraten
Fertigungsteams nutzen die Monte-Carlo-Simulation, um abzuschätzen, wie sich Abweichungen bei der Maschinenleistung, Materialeigenschaften, Toleranzen, Prozesseinstellungen und Prüfergebnissen auf die Fehlerraten auswirken. Die Fortpflanzung dieser Verteilungen durch ein Produktionsmodell hilft Ingenieuren, Qualitätskontrollstrategien zu vergleichen und die Zuverlässigkeit unter sich ändernden Betriebsbedingungen zu testen.
Zu den technischen Anwendungen gehören Toleranzanalyse, Zuverlässigkeitsdesign, Messunsicherheit, Roboter-Fehleranalyse und Designoptimierung (technische Anwendungen von Monte-Carlo-Methoden). Die Methode ist nützlich, da Defekte aus Wechselwirkungen zwischen Variablen resultieren können. Ein Bauteil kann seine individuelle Spezifikation erfüllen, während die kombinierten Toleranzen zu einem Fehler des Endprodukts führen.
Prozessdriften erkennen, bevor sie zur Modellannahme werden
Simulationsergebnisse hängen von stabilen Definitionen und zeitnahen Messungen ab. Die Observability der Produktion sollte Folgendes umfassen:
Sensorvalidierung: Messwerte mit zulässigen Bereichen und bekannten Prozessbeziehungen vergleichen.
Pünktlichkeit der Inspektion: Verspätete Qualitätsberichte kennzeichnen, bevor fehlende Aufzeichnungen ein wiederkehrendes Fehlermuster verschleiern.
Erkennung von Fehleranomalien: Ungewöhnliche Konzentrationen nach Linie, Schicht, Maschine, Material oder Produkt untersuchen.
Schema-Verfolgung: Änderungen in Qualitätsmanagement-Aufzeichnungen erkennen, bevor Analysetools Inspektionsfelder falsch interpretieren.
Toyota, Intel und Siemens werden mit Simulationen zur Produktionsoptimierung, Halbleiterausbeute und industriellen Qualitätssicherung in Verbindung gebracht. Diese Beispiele weisen auf dieselbe Implementierungsanforderung hin: Eine historische Fehlerverteilung ist unzureichend, wenn sich das Messsystem, der Inspektionsprozess oder die Produktdefinition geändert hat.
Überwachen Sie Modelleingaben und geschäftliche Ergebnisse gemeinsam. Eingangsdatenanomalien können eine Verschiebung des simulierten Fehlerbereichs erklären, während die Ausgangsüberwachung zeigen kann, ob sich Ausschuss-, Nacharbeits-, Ertrags- oder Garantiesignale außerhalb des etablierten Verhaltens bewegt haben. Diese Verbindung hilft Qualitätsteams, echte Prozessänderungen von einem Daten- oder Pipelineproblem zu unterscheiden, bevor Produktionskontrollen geändert werden.
9. Budgetplanung im öffentlichen Sektor und fiskalische Wirkungsanalyse
Budgets des öffentlichen Sektors kombinieren unsichere Einnahmen, Ausgaben, Beteiligungen, wirtschaftliche Bedingungen und politische Auswirkungen. Die Monte-Carlo-Simulation hilft Behörden zu untersuchen, wie diese Variablen in möglichen zukünftigen Haushaltsszenarien zusammenwirken. Anstatt sich auf eine einzige Einnahmenschätzung oder eine einzige Beteiligungsannahme zu verlassen, können Planer die Bandbreite der Ergebnisse und die mit politischen Entscheidungen verbundenen Kompromisse bewerten.
Diese Arbeit bringt eine besondere Anforderung an die Rechenschaftspflicht mit sich. Steuer-, Leistungs-, Renten- und Wirtschaftsindikatordaten fließen oft in formale Analysen, öffentliche Berichterstattung und Prüfungsprozesse ein. Ein fehlender Berichtszeitraum oder ein geändertes Berechtigungsfeld kann die scheinbare fiskalische Verteilung verändern, während die Berechnung technisch ausführbar bleibt.
Prüfbarkeit in jede modellierte Eingangsgröße einbauen
Behörden sollten Folgendes nutzen:
Regelbasierte Validierung: Berechtigungs-, Steuer-, Leistungs- und Abstimmungslogik erzwingen, bevor Simulationseingaben akzeptiert werden.
Überwachung der Pünktlichkeit: Die erwartete Bereitstellung von Steuer- und Abgabendaten, Beteiligungsdaten und Wirtschaftsdaten verfolgen.
Anomalieüberprüfung: Ungewöhnliche Steuer- oder Zahlungsmuster untersuchen, die auf betriebliche oder Datenqualitätsprobleme hinweisen können.
Schema-Historie: Belege aufbewahren, wenn Steuer- und Leistungssysteme ihre Struktur ändern.
Das Congressional Budget Office, der IWF und die kalifornische Rentenplanung sind Beispiele, die mit auf Monte-Carlo-Simulationen basierenden Haushalts-, Schulden- oder Verpflichtungsanalysen in Verbindung gebracht werden. Die zugrunde liegende Lehre ist nicht, dass jede Behörde das Modell einer anderen Institution kopieren sollte. Sondern dass öffentliche Entscheidungen eine sichtbare Kette vom Quelldatensatz über die Annahme bis hin zum simulierten Ergebnis benötigen.
Die Public Sector-Lösung von digna kann diese Kette durch Validierung, Pünktlichkeitsverfolgung, Erkennung von Data Anomalies und Schema-Überwachung unterstützen. Diese Kontrollen entscheiden nicht, welche Politik die beste ist. Sie helfen Entscheidungsträgern zu verstehen, ob die Beweise, die jede Option stützen, vollständig, aktuell und strukturell stabil sind.
10. Geschäftsüberwachung und KPI-Anomalieerkennung
Die Monte-Carlo-Simulation kann die Geschäftsüberwachung unterstützen, indem sie unsichere Nachfrage, operative Effizienz, Kundenverhalten und Marktbedingungen in erwartete Bereiche für Key Performance Indicators (KPIs) umwandelt. Teams können dann tatsächliche Ergebnisse mit dem modellierten Verhalten vergleichen und Ergebnisse untersuchen, die außerhalb des Bereichs liegen, den sie für plausibel halten.
Diese Anwendung verlagert Monte Carlo von der periodischen Planung in die operative Observability. Ein E-Commerce-Team kann Bestellungen und Rücksendungen überwachen. Ein Finanzdienstleistungsteam kann Handelsvolumina und Spreads untersuchen. Ein SaaS-Team kann Churn und Nutzung beobachten. In jedem Fall ist die Warnung nur nützlich, wenn die zugrunde liegende KPI-Berechnung korrekt und aktuell ist.
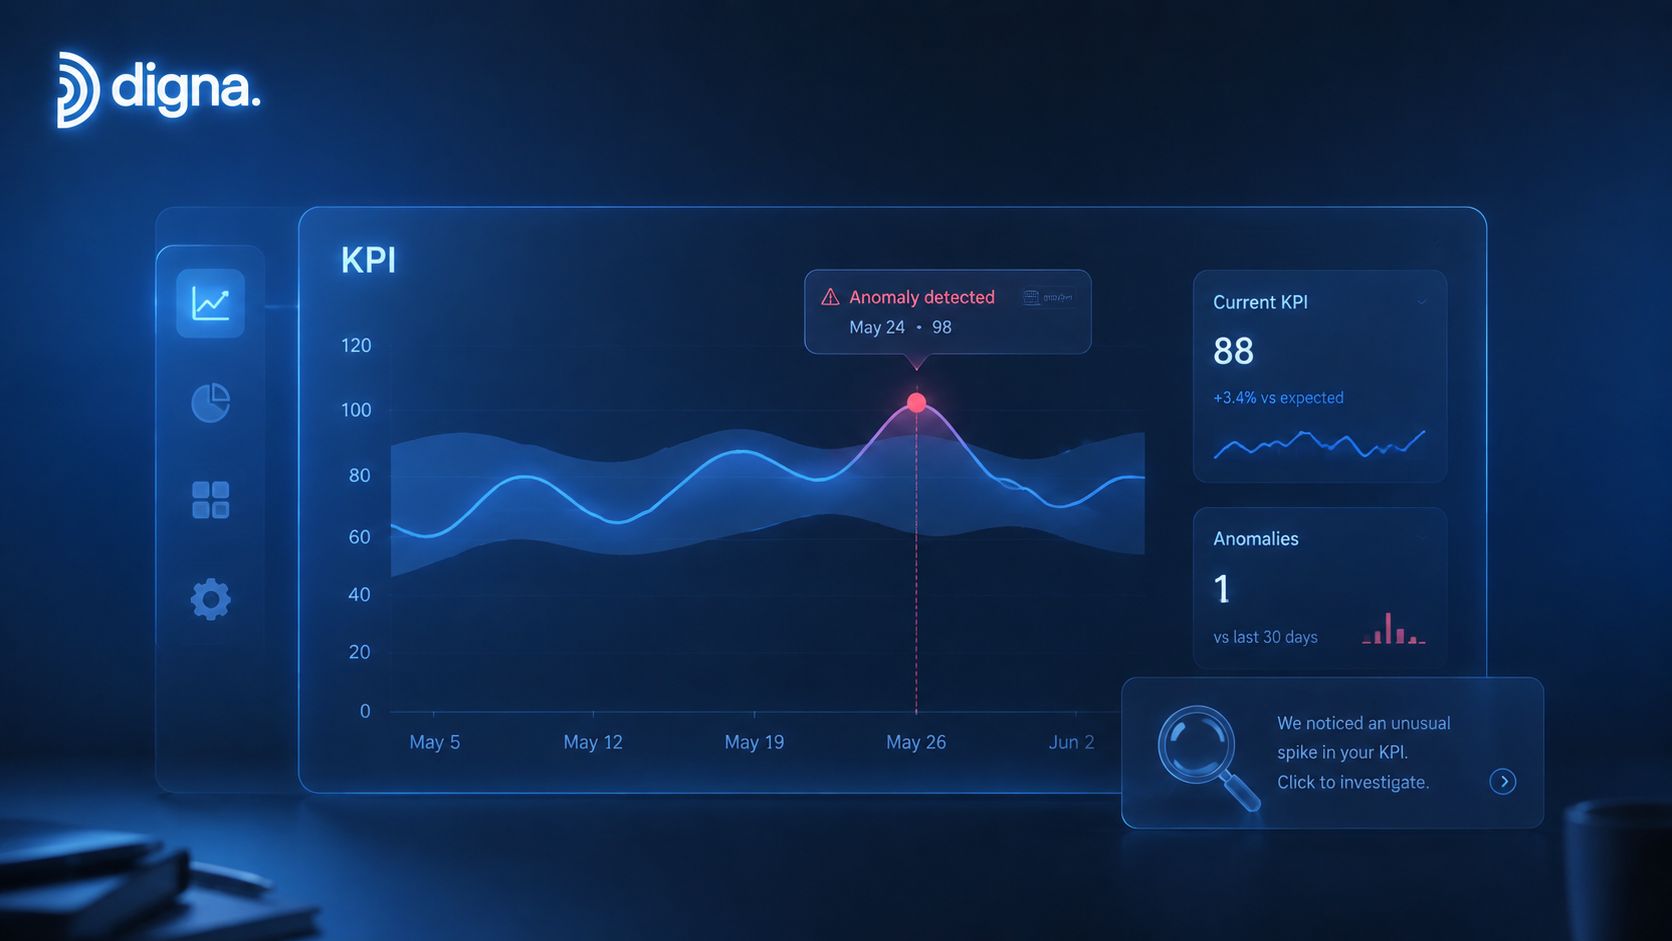
Sowohl die Metrik als auch ihre Erklärung überwachen
Ein zuverlässiger Workflow sollte:
Transaktionen validieren: Die zur Berechnung von Umsatz, Bestellungen, Rücksendungen, Churn oder Nutzung verwendeten Daten prüfen.
Pünktlichkeit von KPIs verfolgen: Warnen, wenn eine Metrik verspätet eintrifft oder eine geplante Berechnung ihr erwartetes Bereitstellungsmuster verpasst.
Anomalietypen vergleichen: Statistische Data Anomalies zusammen mit geschäftlichen KPI-Anomalien überprüfen.
Strukturelle Auswirkungen prüfen: Die Schema-Historie nutzen, um festzustellen, ob ein geändertes Feld die KPI-Definition verändert hat.
Die Zeitreihen-Anomalieerkennung von digna ist für dieses Betriebsmodell relevant, da Teams echte geschäftliche Veränderungen von Datenverhalten unterscheiden müssen, das nur wie eine Veränderung aussieht. Ein gemeinsamer Leitfaden für Flottenbetriebsberichte verdeutlicht zudem, warum die operative Berichterstattung von zuverlässigen Quellen- und Bereitstellungsprozessen abhängt.
Die nützlichste Warnung besagt nicht nur, dass ein KPI ungewöhnlich ist. Sie hilft bei der Beantwortung der Frage, ob sich das Geschäft geändert hat, sich die Daten geändert haben oder die Annahmen des Modells nicht mehr passen.
Monte-Carlo-Simulation: Vergleich der 10 Anwendungen
Anwendung | 🔄 Komplexität der Implementierung | ⚡ Ressourcenanforderungen | 📊 Erwartete Ergebnisse | Ideale Anwendungsfälle | ⭐ Hauptvorteile & 💡 Tipp |
|---|---|---|---|---|---|
Finanzielle Risikobewertung und Portfoliomodellierung | Hoch, fortschrittliche stochastische Modelle & Kalibrierung | Hoch, viel Rechenleistung, hochfrequente Marktdaten, Quant-Expertise | Wahrscheinlichkeitsbasierter VaR/CVaR, Stresstests, Tail-Risk-Schätzungen | Banken, Vermögensverwalter, Derivatebewertung, regulatorische Berichterstattung | ⭐ Erfasst nichtlineare Risiken und Tail-Risiken; unterstützt Compliance. 💡 Qualität und Pünktlichkeit der Eingangsdaten validieren. |
Wirkstoffentwicklung und klinische Prüfungssimulation | Hoch, komplexe Populations- & pharmakodynamische Modelle | Hoch, große klinische Datensätze, Datenschutzkontrollen, Rechenleistung | Erfolgswahrscheinlichkeiten von Studien, Optimierung der Stichprobengröße, Kosten-/Zeitersparnis | Pharma-F&E, Studiendesign, regulatorische Begründung | ⭐ Sagt Studienergebnisse voraus; ermöglicht adaptive Designs. 💡 Vollständigkeit klinischer Daten und Einhaltung des Datenschutzes sicherstellen. |
Lieferketten- und Logistikoptimierung | Mittel–Hoch, Multi-Knoten-Netzwerke & Integrationen | Mittel, historische Nachfrage, Lieferanten-Feeds, Integrationsaufwand | Optimierte Lagerbestände, reduzierte Kosten, verbesserter Servicegrad | Einzelhandel, Fertigung, 3PLs, Vertriebsnetzplanung | ⭐ Reduziert Lagerhaltungskosten und identifiziert Netzwerkschwachstellen. 💡 Qualität der Lieferanten-Lieferzeitdaten überwachen. |
Schadenprognose- und Preisgestaltungsmodelle im Versicherungswesen | Hoch, versicherungsmathematische Modelle und regulatorische Kontrollen | Mittel–Hoch, Schadenshistorie, Risikodatenbanken, aktuarielle Expertise | Prämienangemessenheit, Reserveschätzungen, Solvenzwahrscheinlichkeiten | Versicherer, Rückversicherer, Katastrophen-Pricing, Reservefestlegung | ⭐ Richtet Preise am Risiko aus; validiert Reserven für Aufsichtsbehörden. 💡 Vollständigkeit der Schadendaten validieren und anomale Spitzen überwachen. |
Öl- und Gasexploration und Reservenschätzung | Hoch, Geowissenschaften + ingenieurtechnische Unsicherheitsmodellierung | Hoch, seismische/Produktionsdaten, Fachexperten, Rechenleistung | P10/P50/P90 Reserveschätzungen, NPV-Verteilungen, Portfoliorisiko | Explorationsportfolio-Bewertung, Reserveberichterstattung, Projektprüfung | ⭐ Quantifiziert das Explorationsrisiko für die Kapitalallokation. 💡 Pünktlichkeit und Qualität von Seismik- und Produktionsdaten überprüfen. |
Kapazitätsplanung für Telekommunikationsnetze | Mittel, zeitvariable Verkehrsmodelle und geografische Granularität | Mittel, Netzwerktelemetrie, Teilnehmerdaten, Integration | Kapazitätsprognosen, Überlastungswahrscheinlichkeiten, CAPEX-Leitlinien | Mobilfunk-/Festnetzbetreiber bei der Planung von 5G-/Glasfaser-Rollouts | ⭐ Optimiert CAPEX; identifiziert Engpässe vor Ausfällen. 💡 Verkehrsmessungen validieren und Pünktlichkeit der Feeds überwachen. |
Modellierung der Auswirkungen von Umwelt- und Klimaveränderungen | Hoch, langfristige Unsicherheit über mehrere Modelle hinweg | Hoch, Satelliten-/Sensordatensätze, Modellensembles, Rechenleistung | Wahrscheinlichkeitsbasierte Klimaszenarien, Vergleiche politischer Wirksamkeit | Klimawissenschaft, Politikbehörden, Analysen für nachhaltige Finanzen | ⭐ Quantifiziert Klimarisiken und politische Kompromisse. 💡 Konsistenz der Beobachtungsdaten über Stationen/Quellen hinweg sicherstellen. |
Qualitätskontrolle in der Fertigung und Prognose von Fehlerraten | Mittel, Prozessfähigkeit & ursachenbasierte Szenariomodellierung | Mittel, Produktionssensoren, historische Laufdaten, Analytik | Prognosen zu Fehlerraten, optimierte Stichprobenziehung, reduzierter Ausschuss | Automobilindustrie, Halbleiterwerke, diskrete Fertigungslinien | ⭐ Reduziert Ausschuss und optimiert Inspektionspläne. 💡 Sensormesswerte validieren und Pünktlichkeit der Inspektionen überwachen. |
Budgetplanung im öffentlichen Sektor und fiskalische Wirkungsanalyse | Mittel–Hoch, makroökonomisches Szenariodesign & Annahmen | Mittel, Datensätze zu Steuern, Programmen und Wirtschaftsindikatoren | Verteilungen fiskalischer Risiken, Schuldentragfähigkeit, Wahrscheinlichkeiten politischer Auswirkungen | Staatliche Haushaltsbehörden, finanzpolitische Analysen, Rentenprognosen | ⭐ Quantifiziert finanzpolitische Risiken transparent für politische Entscheidungen. 💡 Programmdaten validieren und Berichtszeitpläne verfolgen. |
Geschäftsüberwachung und KPI-Anomalieerkennung | Mittel, Zeitreihen-Baselines und mehrdimensionale Szenarien | Mittel, Transaktions-/Betriebsdaten, Überwachungsinfrastruktur | Dynamische KPI-Baselines, frühere Anomalieerkennung, reduzierte Fehlalarme | Branchenübergreifender Betrieb, E-Commerce, SaaS, Finanzüberwachung | ⭐ Erkennt Anomalien früher und reduziert Fehlalarme. 💡 Baseline-Modelle mit Datenvalidierung und Schema-Verfolgung kombinieren. |
Von simulierten Szenarien zu vertrauenswürdigen Entscheidungen
In diesen zehn Anwendungen der Monte-Carlo-Simulation zeigt sich dasselbe Implementierungsmuster. Das Modell beginnt mit der Definition unsicherer Eingangsgrößen als Verteilungen, verbindet diese Eingangsgrößen über eine mathematische Struktur und interpretiert die Ergebnisse als Wahrscheinlichkeiten statt als Garantien. Das ist jedoch nur die analytische Ebene. Die operative Ebene bestimmt, ob die Verteilungen das verwaltete System noch zutreffend beschreiben.
Beginnen Sie mit den Quelldatensätzen. Die Data Validation sollte erforderliche Felder, zulässige Werte, Beziehungen, Einheiten und Geschäftsregeln bestätigen, bevor die Eingangsdaten das Modell erreichen. Dies ist wichtig bei Finanzpositionen, klinischen Aufzeichnungen, Lieferantenlieferzeiten, Schadenklassifizierungen, Bohrlochproduktion, Netzwerkverkehr, Klimabeobachtungen, Fabriksensoren, Steuerdaten und KPI-Transaktionen. Eine Simulation repariert keinen fehlerhaften Datensatz. Sie pflanzt den Einfluss des Datensatzes in jedes resultierende Szenario fort.
Bestätigen Sie dann den Zeitpunkt der Bereitstellung. Ein Datensatz kann bei seinem Eintreffen korrekt sein und dennoch für eine zeitkritische Entscheidung unbrauchbar sein, wenn er nach dem Modelllauf eintrifft. Die Überwachung der Timeliness sollte das erwartete Bereitstellungsverhalten erlernen, fehlende oder verzögerte Ladungen melden und eine betriebliche Verzögerung von einer gewöhnlichen Abweichung im Zeitplan unterscheiden. Dies ist besonders wichtig, wenn Simulationen häufig aktualisiert werden oder Entscheidungen von aktuellen Bedingungen abhängen.
Überwachen Sie als Nächstes Anomalien sowohl bei den Eingängen als auch bei den Ausgängen. Eine ungewöhnliche Eingabe kann ein reales Ereignis, einen Messfehler, ein Duplikat, einen Transformationsfehler oder einen Regimewechsel darstellen. Ein ungewöhnliches Ergebnis kann ein echtes geschäftliches Signal oder eine fehlerhafte vorgelagerte Berechnung widerspiegeln. Die Überprüfung beider Seiten gibt Analysten eine bessere Chance, die Ursache zu identifizieren, anstatt nur auf das Symptom zu reagieren.
Verfolgen Sie schließlich strukturelle Veränderungen. Hinzugefügte oder entfernte Spalten, Änderungen des Datentyps, geänderte Definitionen und veränderte Quellsystemlogiken können eine Pipeline ungültig machen, ohne einen offensichtlichen Softwarefehler zu erzeugen. Die strukturelle Überwachung sollte daher neben der statistischen Überwachung stehen, nicht dahinter.
Die Forschung hebt auch hervor, warum diese Disziplin wichtig ist. Eine MIT-Lebenszyklusanalysestudie nutzte die Varianz als Indikator für Unsicherheit und stellte fest, dass die Fehlalarm-/Fehlerquote von anfänglich 21 % auf 6,1 % sank, nachdem 20 Parameter geklärt waren, und sich dann bei 5,8 % stabilisierte, nachdem 39 Parameter geklärt waren (MIT-Lebenszyklusanalysestudie). Das Ergebnis stützt eine praktische Schlussfolgerung: Die iterative Verfeinerung unsicherer Parameter kann die Zuverlässigkeit von Entscheidungen erheblich verbessern. Das bedeutet nicht, dass jedes Modell die gleiche Verbesserung erzielt.
Auch die Rechenleistung spielt eine Rolle. In einem Benchmark für verteilte kinetische Monte-Carlo-Simulationen reduzierte die Parallelisierung die normierte Rechenzeit von 19,7 Stunden pro KMC-Zeiteinheit in einem seriellen Lauf auf 1,3 Stunden auf 625 Recheneinheiten, was einer Beschleunigung von etwa 15x entspricht. Eine Arbeitslast, die seriell etwas mehr als 1,5 Jahre gedauert hätte, wurde in 38 Tagen abgeschlossen (verteilter kinetischer Monte-Carlo-Benchmark). Eine schnellere Ausführung kann ein Modell einsatzfähig machen, aber Geschwindigkeit löst keine fehlerhaften Abhängigkeitsstrukturen oder veränderten Rahmenbedingungen.
Das ist die ungelöste Frage in vielen modernen Implementierungen. Berichte weisen auf Codekomplexität, lange Rechenzeiten und begrenzte Tuning-Daten in der Partikeltherapie hin (Übersicht über die Einschränkungen bei der Einführung von Monte Carlo). Ein Projekt-Risiko-Papier aus dem Jahr 2025 beschreibt zudem Lücken in der integrierten Kosten-Termin-Analyse, der täglichen Risikoentwicklung und expliziten Abhängigkeiten, bei denen ein Ereignis das Timing und die Wahrscheinlichkeit späterer Ereignisse verändert (Projekt-Risiko-Forschung 2025). Die gegenteilige Lehre ist wichtig: Der schwierigste Teil ist oft nicht die Durchführung von mehr Versuchen. Es geht darum, Korrelation, Zeitabhängigkeit, Entwicklung und Regimewechsel korrekt darzustellen.
digna kann diesen Workflow innerhalb der eigenen Umgebung des Kunden durch In-Database-Ausführung, Private-Cloud- oder On-Premises-Bereitstellung, modulare Observability-Funktionen und ein gemeinsames Dashboard für Ingenieure, Analysten und Stakeholder unterstützen. Seine Module decken Anomalieerkennung, Validierung, Pünktlichkeit, Schema-Verfolgung, Geschäftsüberwachung und Plattform-Observability ab, sodass Teams mit der Kontrolle beginnen können, die einem kritischen Modell am nächsten liegt, und diese bei wachsender Nutzung erweitern können.
Beginnen Sie mit einem kritischen Datensatz oder KPI. Dokumentieren Sie dessen erwartetes Verhalten, Quellabhängigkeiten, den Bereitstellungszeitplan, Validierungsregeln und strukturelle Annahmen. Überwachen Sie dann die Ein- und Ausgänge gemeinsam, bevor Sie dasselbe Muster auf weitere Monte-Carlo-Modelle ausweiten.
digna bietet umgebungsinterne Daten-Observability mit Validierung, Überwachung der Timeliness, Anomalieerkennung, Schema-Verfolgung und Geschäftsüberwachung für die Daten, die in Simulationsmodelle einfließen. Beginnen Sie mit einem kritischen Datensatz oder KPI und besuchen Sie dann digna, um zu erfahren, wie die Plattform Ihnen helfen kann, Simulationsergebnisse mit vertrauenswürdigen operativen Nachweisen zu verknüpfen.
Häufig gestellte Fragen
Wo wird Monte-Carlo-Simulation tatsächlich eingesetzt?
In Finanzwesen, Ingenieurwesen, Physik, Logistik, Gesundheitswesen, Klimaforschung, Fertigung und Projektmanagement, nach ihrer Entwicklung in den 1940er Jahren durch Stanislaw Ulam. Diese Breite macht die Methode mächtig und zugleich leicht missbrauchbar, weil dieselbe Mechanik sehr unterschiedliche Datenqualitätsrealitäten trifft.
Was fragt man, bevor ein Simulationsergebnis entscheidungsreif ist?
Vier Fragen, beginnend damit, welche Variablen wirklich Wahrscheinlichkeitsverteilungen brauchen. Die übrigen betreffen die Qualität der speisenden Eingaben, die im Modell steckenden Annahmen und die Entscheidung, die die Ausgabe tatsächlich stützen soll.
Wie nutzt man Monte Carlo im Finanzrisiko?
Analystinnen modellieren unsichere Marktrenditen, Zinsen, Inflation und Zahlungsströme für Portfoliooptimierung, Value at Risk, Expected Shortfall, Ruhestandsplanung, Stresstests, Derivatebewertung und Asset-Liability-Analyse. Vertrauen in das Ergebnis beginnt bei den Eingaben, nicht bei der Engine.
Welche Datenkontrollen schützen Simulationsausgaben?
Vier, die branchenübergreifend gelten: Quelldatensätze vor jedem Lauf validieren, die Lieferung von Markt- oder Quellfeeds überwachen, damit keine veralteten Werte in aktuelle Szenarien geraten, erwartetes gegen beobachtetes Verhalten der Risikokennzahlen vergleichen und strukturellen Drift verfolgen, bevor hinzugefügte, entfernte oder umtypisierte Spalten die Berechnung verändern.
Wie verbreitet ist der Einsatz im Gesundheitswesen?
Breit genug, um katalogisiert zu werden. Eine systematische Übersichtsarbeit gruppierte Monte-Carlo-Anwendungen im Gesundheitswesen in Kategorien mit 60, 18, 41 und 23 Arbeiten, die Patientenpfade, Behandlungsergebnisse, ökonomische Bewertungen und Nutzen-Risiko-Entscheidungen abdecken.


