Genauigkeit bei der Datenqualität: Metriken und Überwachung
|
8
min. Lesezeit
Die Datengenauigkeit (Data Accuracy) misst, ob Daten das reale Objekt, Ereignis oder den Wert, den sie darstellen sollen, korrekt abbilden. Eine Branchenzusammenfassung aus dem Jahr 2026 berichtet, dass 55 % der Datensätze Probleme mit der Genauigkeit aufweisen, wobei diese Probleme Unternehmen laut der Zusammenfassung des Talend Data Health Barometer 2023 durchschnittlich 3,1 Millionen US-Dollar pro Jahr kosten .
In dieser Kluft zwischen korrekt aussehenden Daten und der Realität nehmen viele Unternehmensfehler ihren Anfang. Eine Transaktion kann eine Formatprüfung bestehen, obwohl sie den falschen Betrag ausweist. Ein Patientendatensatz kann ein gültiges Datum enthalten, das jedoch zu einer anderen Person gehört. Ein CRM-Wert kann vollständig und wohlgeformt sein und dennoch den Kunden nicht mehr korrekt beschreiben. In jedem Fall ist die Datengenauigkeit ein Anspruch, der Beweise erfordert, und kein Label, das vergeben wird, weil ein Feld eine Validierung bestanden hat.
DAMA-DMBOK® 2.0 Revised Edition behandelt Genauigkeit als etablierte Datenqualitätsdimension, und das DAMA-Forschungspapier zu Datenqualitätsdimensionen definiert sie durch die Nähe der Datenwerte zu den realen Werten. Ein zuverlässiges Monitoring kombiniert daher Geschäftsregeln, Vergleiche mit vertrauenswürdigen Quellen, Anomaliensignale, strukturelle Kontrollen, Aktualitätsprüfungen und Rückverfolgbarkeit. Die Übersichtstabelle weiter unten in diesem Artikel vergleicht diese Kontrollmethoden nach Beweistyp, optimaler Nutzung, Einschränkungen und Einsatz im Unternehmen.
Stellen Sie sich eine Kundenadresse vor, die fälschlicherweise aus einem Quellsystem in ein Warehouse kopiert wurde. Das Warehouse-Dashboard aggregiert sie möglicherweise fehlerfrei, während ein KI-Workflow die falsche Region für die Segmentierung verwendet. Ein einzelner ungenauer Wert kann sich somit durch Berichte, Modelle und operative Entscheidungen bewegen, bevor sich jemand fragt, ob er der Realität entspricht.
Inhaltsverzeichnis
7. Datenherkunft (Data Lineage) und Auswirkungsanalyse für die Rückverfolgbarkeit der Genauigkeit
Genauigkeitssignale in vertrauenswürdige Entscheidungen verwandeln
1. Datenvalidierung gegen Geschäftsregeln
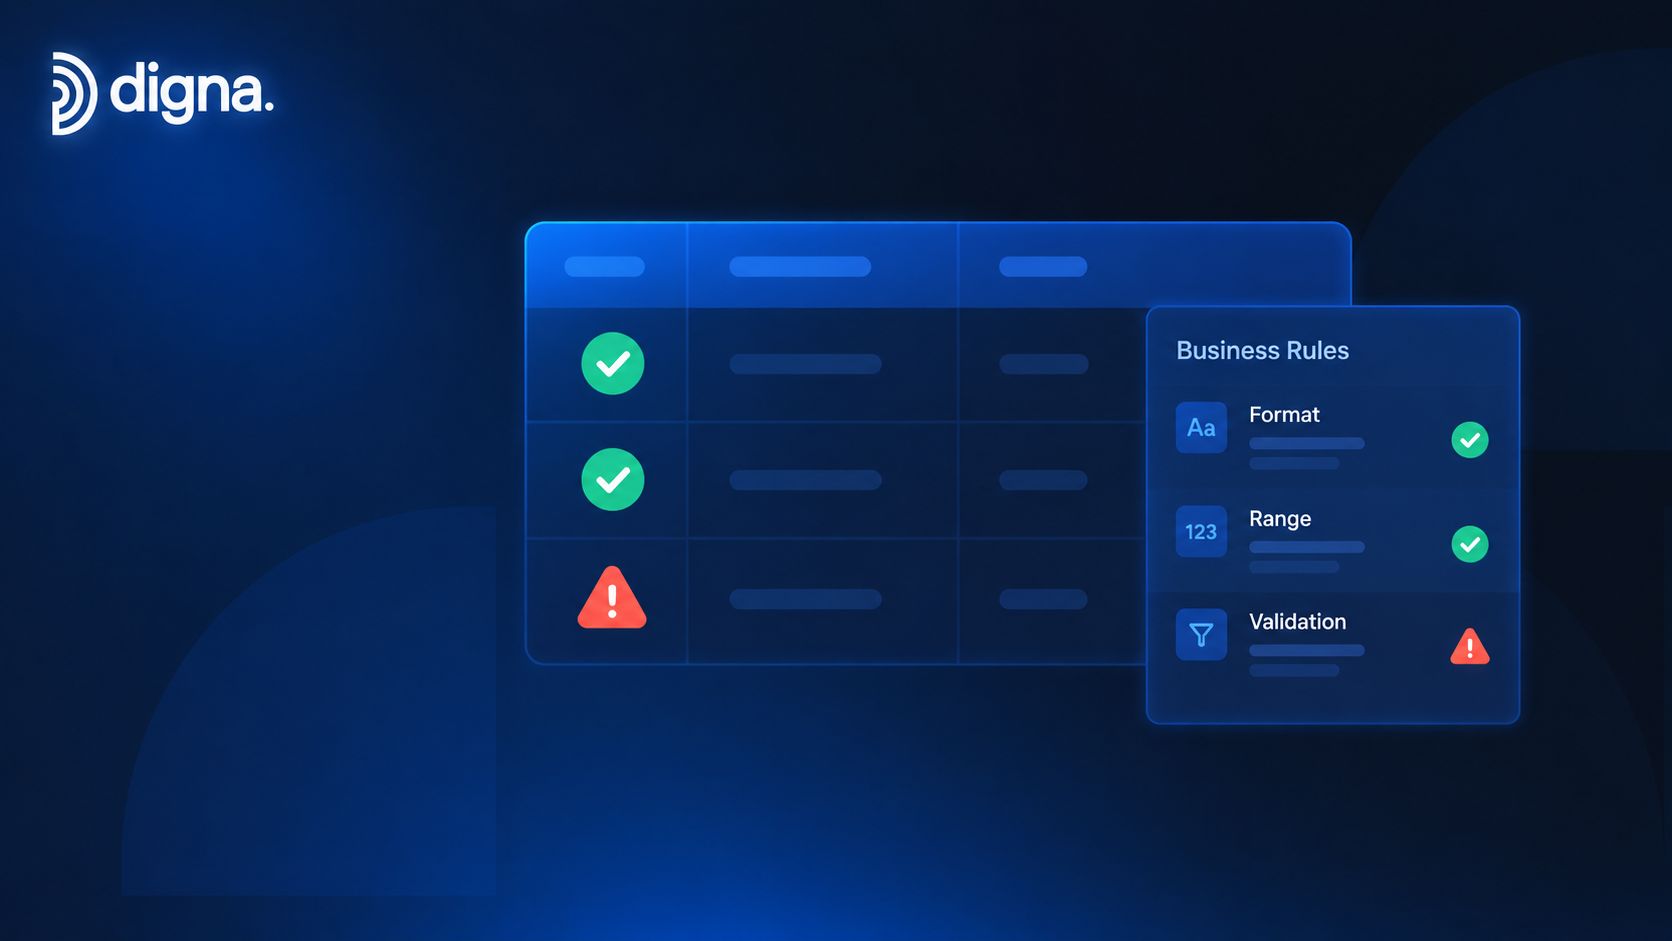
Die Validierung von Geschäftsregeln liefert den Nachweis, dass ein Wert definierte Bedingungen erfüllt, nicht den Beweis, dass er das Ereignis oder Objekt, das er beschreibt, korrekt darstellt. Sie wendet deterministische Prüfungen auf Datensätze, Felder, Beziehungen und Referenzwerte an. Eine Regel kann beispielsweise vorschreiben, dass ein Transaktionsbetrag positiv sein muss, ein Aufnahmedatum vor der Entlassung liegen muss oder eine Kundenkennung in einer freigegebenen Referenztabelle existieren muss.
Diese Prüfungen sind wiederholbar und auditierbar. Teams können die Regel dokumentieren, das Ergebnis aufzeichnen und fehlerhafte Datensätze untersuchen, was Compliance, Finanzkontrollen und operative Überprüfungen unterstützt. Die Validierung trennt zudem die Gültigkeit von der Genauigkeit. Eine Bereichsprüfung zeigt, dass ein Wert zulässig ist, kann aber nicht feststellen, ob er mit der zugrunde liegenden Transaktion oder dem Kunden übereinstimmt.
Praktische Regel: Beginnen Sie mit Regeln, die an Entscheidungen, regulatorische Berichte, Finanzkontrollen oder Kundenverpflichtungen gekoppelt sind. Validieren Sie nicht jede Spalte gleichermaßen, bevor Sie deren geschäftliche Konsequenzen ermittelt haben.
Ein Finanzinstitut kann Transaktionsbeträge auf Bedingungen des Kontotyps prüfen. Eine Gesundheitsorganisation kann die Reihenfolge der Daten überprüfen und sicherstellen, dass klinische Kennungen mit freigegebenen Codesätzen übereinstimmen. Ein Telekommunikationsanbieter kann Telefonnummernformate und Kunden-IDs verifizieren, während ein Einzelhändler Produktpreise mit Katalogdaten vergleichen und negative Bestellmengen ablehnen kann. Diese Kontrollen fangen definierte Mängel effizient ab, erfordern aber dennoch eine Untersuchung, wenn der Quellwert selbst falsch ist.
Validierungsnachweise nützlich machen
Die stärksten Implementierungen kombinieren mehrere Prüfungen:
Geschäftslogik: Codieren Sie Bedingungen, die operative Richtlinien widerspiegeln, nicht nur technische Formate.
Referenzvergleiche: Nutzen Sie Stammdaten, Nachschlagetabellen und freigegebene Listen, um zu bestätigen, dass Werte zur erwarteten Domäne gehören.
Fehlerüberwachung: Verfolgen Sie Fehler im Zeitverlauf sowie nach Quelle, Regel und Prozess, um wiederkehrende Mängel zu identifizieren.
Versionskontrolle: Dokumentieren und versionieren Sie Regeln, damit Analysten feststellen können, welche Kontrolle angewendet wurde, als ein Datensatz fehlschlug.
Offizielle statistische Richtlinien von Statistics Canada unterscheiden Genauigkeit von Konformitätsprüfungen im Validierungsstil. Diese Unterscheidung sollte in Produktions-Dashboards und Problem-Workflows sichtbar bleiben. digna Data Validation kann Geschäftsregeln auf Datensatzebene, Referenzprüfungen, Schwellenwerte und erwartete Bedingungen kodifizieren, mit datenbankinterner Ausführung und auditgerechter Nachverfolgung.
Gesundheitsteams können diesen Kontrollansatz auch mit Verifai-Gesundheitsangeboten verknüpfen, wenn domänenspezifische Workflows strukturierte Prüfungen und Überprüfungen erfordern.
2. Datenabgleich und systemübergreifender Vergleich
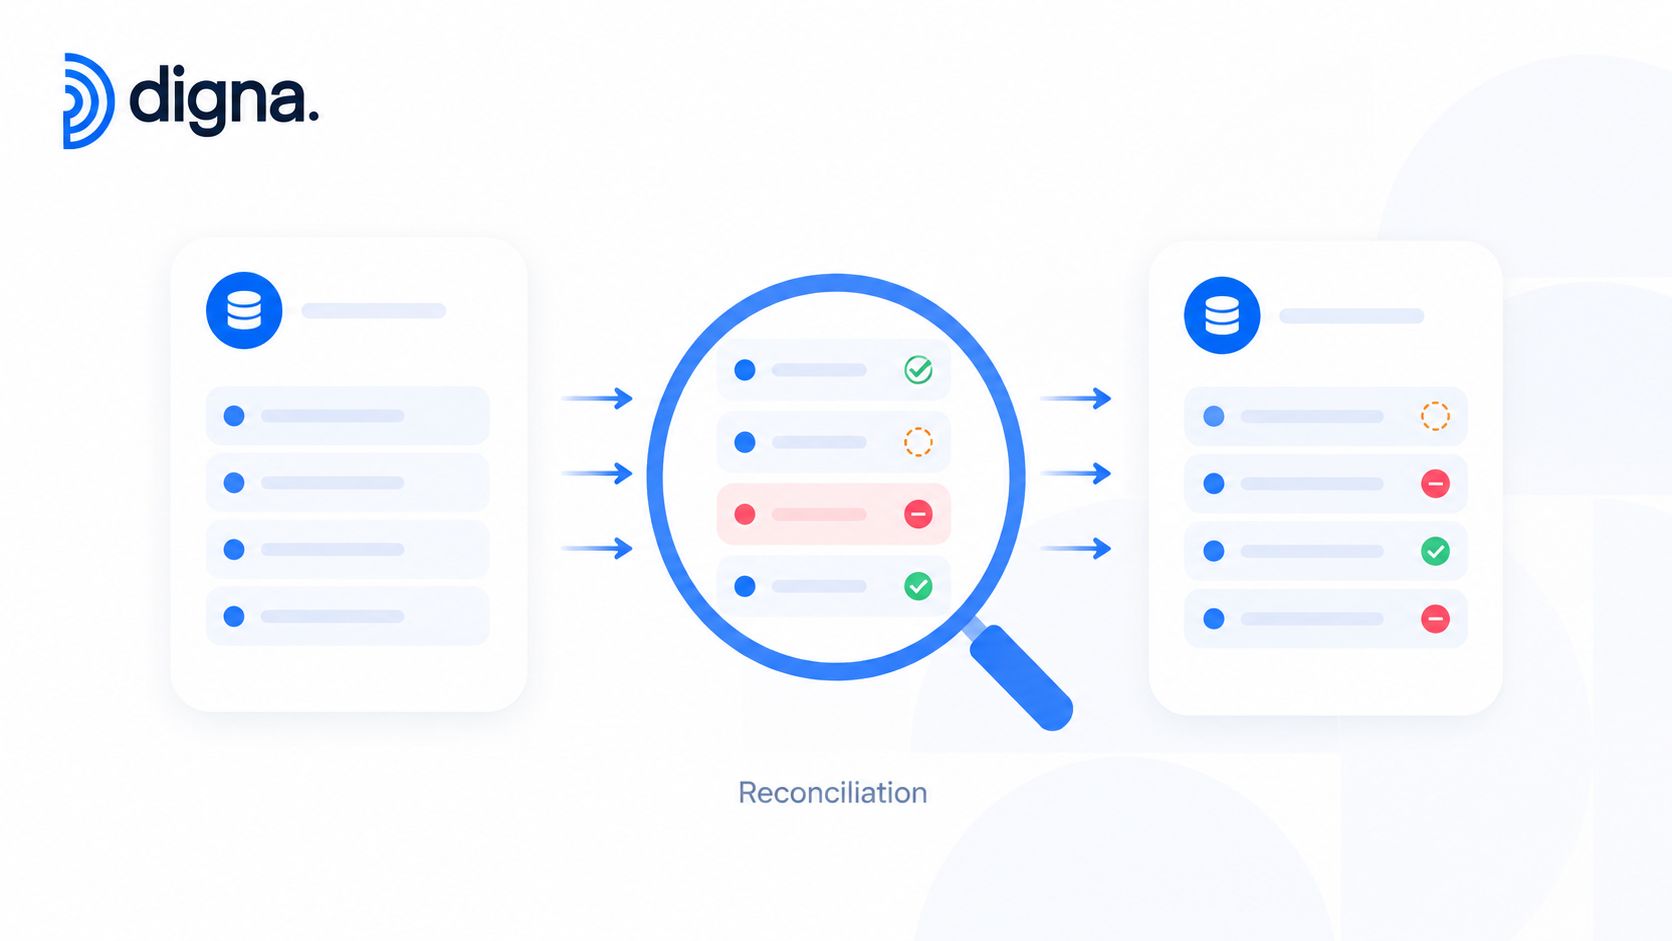
Genauigkeit wird dann vertretbar, wenn ein Unternehmen nachweisen kann, wie genau die Daten mit derselben geschäftlichen Realität über Systeme hinweg übereinstimmen. Der Datenabgleich (Reconciliation) prüft diese Verbindung, indem er eine vertrauenswürdige Quelle mit einem Ziel, einem Bericht, einem Warehouse oder einem abgeleiteten Datensatz vergleicht.
Eine Pipeline kann gültige Formate beibehalten, während sie Datensätze verliert, Transaktionen dupliziert, Beträge falsch rundet oder einen Kunden mit dem falschen Konto verknüpft. Replikations-, Migrations-, ETL- und Transformationsprozesse bergen diese Risiken. Ein systemübergreifender Vergleich deckt sie auf, indem er untersucht, ob separate Darstellungen immer noch übereinstimmen.
Der Vergleich hängt vom geschäftlichen Kontext ab. Eine Bank kann Transaktionsanzahlen und -beträge zwischen einer Handelsplattform und Abwicklungshauptbüchern abgleichen. Ein Gesundheitsdienstleister kann Quell-EHR-Datensätze mit Warehouse-Datensätzen vergleichen. Ein Telekommunikationsbetreiber kann veraltete Abrechnungsdaten nach einer Migration mit einem Cloud-Warehouse vergleichen. Ein Team im öffentlichen Sektor kann Leistungsdatensätze über operative, Berichts- und Audit-Datenbanken hinweg prüfen.
Vergleichsgrenze vor der Automatisierung festlegen
Gesamtsummen sind nützlich, wenn eine aggregierte Übereinstimmung aussagekräftig ist. Sie können jedoch auch sich gegenseitig aufhebende Fehler verbergen, weshalb ein Abgleich auf Datensatzebene erforderlich ist, wo sich einzelne Diskrepanzen auf Entscheidungen auswirken. Natürliche Schlüssel, zusammengesetzte Schlüssel und transformationsbewusste Abgleichslogiken helfen dabei, legitime Änderungen von Fehlern zu unterscheiden.
Ein praktischer Kontrollablauf umfasst:
Prüfungen von der Quelle bis zur Bereitstellung (Source-to-Stage): Finden Sie Erfassungsverluste und Parsing-Fehler vor der nachgelagerten Verarbeitung.
Prüfungen vom Stage bis zum Warehouse: Isolieren Sie Transformations- und Ladefehler.
Wertvergleiche: Prüfen Sie Beträge, Status, Daten und Klassifizierungen auf Abweichungen.
Ausnahmeberichte: Priorisieren Sie Diskrepanzen nach geschäftlicher Auswirkung und nachgelagerter Nutzung.
Der Abgleich liefert Beweise, keine Wahrheit an sich. Eine Übereinstimmung zeigt, dass zwei Darstellungen unter definierten Regeln übereinstimmen. Eine Nichtübereinstimmung stößt eine Untersuchung an, welche Quelle, Transformation oder Interpretation vertrauenswürdig ist.
Dokumentieren Sie die Single Source of Truth, planen Sie Vergleiche entsprechend dem operativen Risiko und weisen Sie ungelösten Abweichungen Verantwortliche zu. Bewahren Sie die Beweise auf, die zur Reproduktion jedes Ergebnisses erforderlich sind, einschließlich der Vergleichsebene, der Abgleichslogik, der Laufzeit und der betroffenen Datensätze. digna Data Reconciliation (Datenabgleich) unterstützt datenbankinterne Vergleiche zwischen vertrauenswürdigen Quellen und Zielsystemen, wodurch unnötige Datenbewegungen begrenzt und gleichzeitig ein Untersuchungspfad beibehalten wird.
3. Statistische Anomalieerkennung und Baseline-Lernen
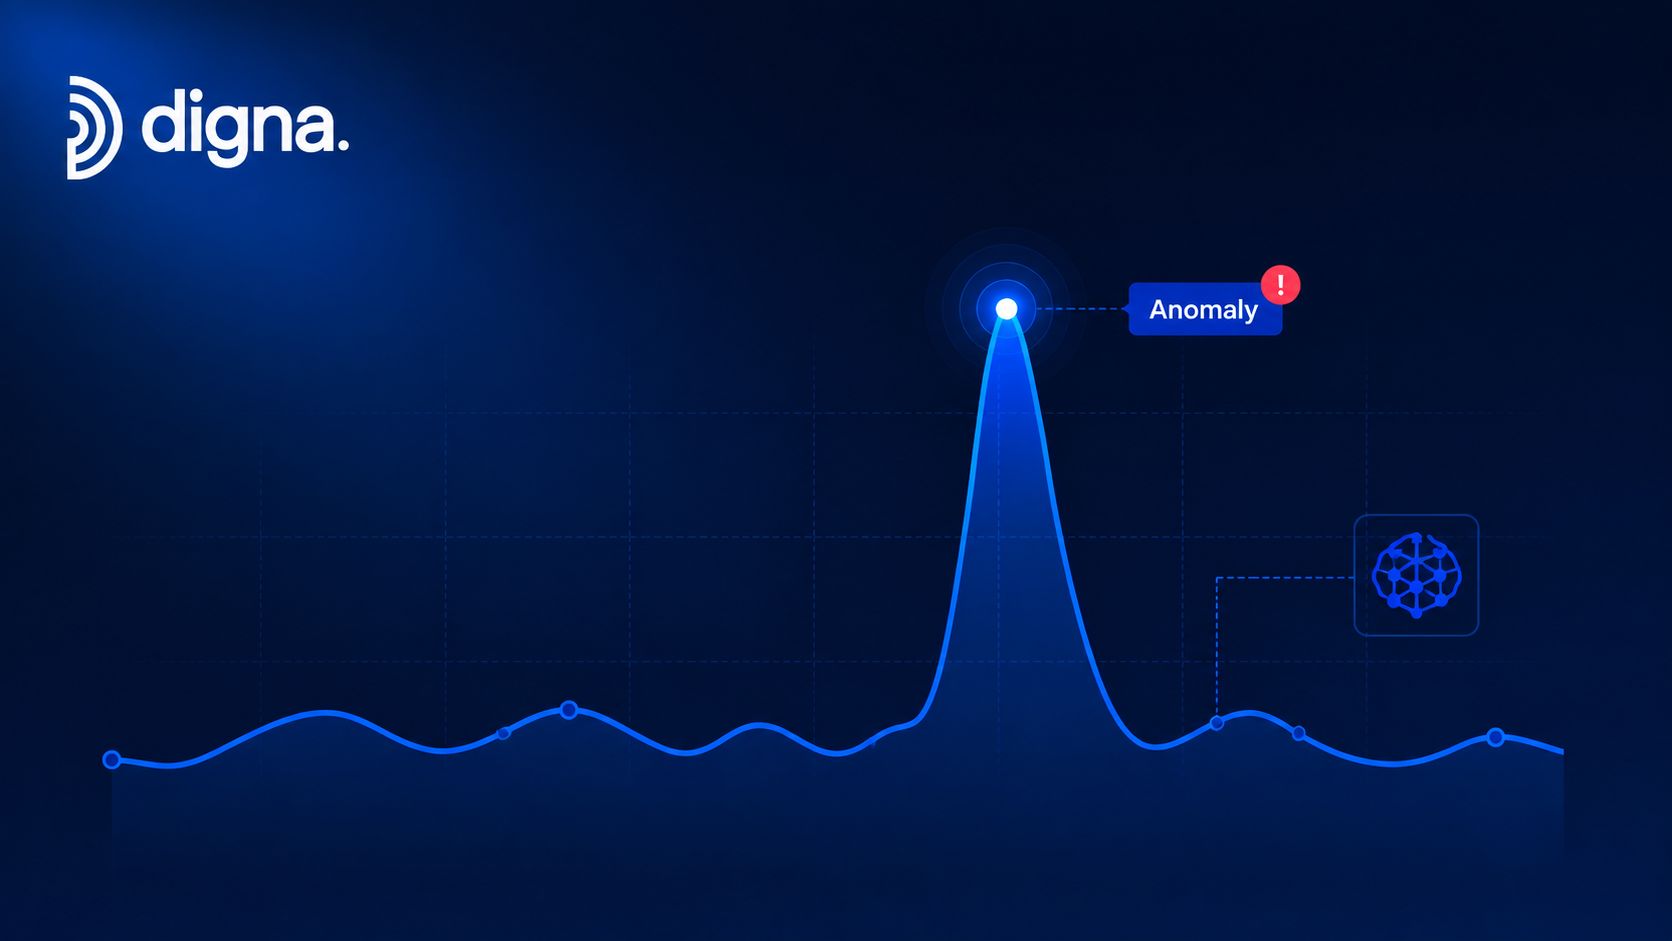
Genauigkeit ist ein vertretbarer Anspruch darüber, wie eng Daten die Realität abbilden. Die statistische Anomalieerkennung hilft dabei, diesen Anspruch zu prüfen, indem sie Verhaltensweisen identifiziert, die von einer etablierten Baseline abweichen. Sie ist dort nützlich, wo feste Regeln Saisonalität, Wachstum, Volatilität oder Beziehungen über Felder hinweg nicht erfassen können.
Eine Baseline kann das Datensatzvolumen, Werteverteilungen, Bereitstellungsmuster, Feldbeziehungen und geschäftliche Kennzahlen verfolgen. Eine abrupte Änderung des Handelsvolumens, der Patientenaufnahmen, der Telekommunikationsnutzung, der Einzelhandelsumsätze oder des Lagerbestands kann auf einen Fehler in der Quelle hinweisen. Sie kann jedoch auch ein echtes betriebliches Ereignis widerspiegeln, sodass die Warnmeldung ein Beweis für eine Untersuchung ist, kein Urteil über die Korrektheit.
Eine Werbeaktion kann zu einem legitimen Umsatzanstieg führen. Eine Richtlinienänderung kann die Aufnahme von Patienten im Gesundheitswesen verändern, während die Einführung eines neuen Produkts das Nutzungsverhalten beeinflussen kann. Jede Abweichung als Fehler zu behandeln, führt zu falschen Vorfällen und kann legitime geschäftliche Veränderungen verbergen.
Warnmeldungen mit der Untersuchung verknüpfen
Nutzen Sie Anomaliensignale, um die Aufmerksamkeit zu lenken, und prüfen Sie dann die zugrunde liegenden Datensätze und den Kontext:
Gelerntes Baseline-Modell: Modellieren Sie normales Verhalten für den Datensatz, anstatt einen universellen Schwellenwert anzuwenden.
Geschäftliche Überprüfung: Fragen Sie die Prozessverantwortlichen, ob die Änderung mit einem realen Ereignis, einer geplanten Einführung (Release) oder einer Richtlinienanpassung übereinstimmt.
Bestätigung der Kontrolle: Wenden Sie Validierung und Abgleich an, um festzustellen, ob betroffene Datensätze Fehler enthalten oder von vertrauenswürdigen Darstellungen abweichen.
Musterüberprüfung: Untersuchen Sie wiederkehrende Warnmeldungen nach Quelle, Transformation, Zeitraum und Kennzahl, um systematische Fehler zu identifizieren.
Priorisierte Warteschlange: Priorisieren Sie Untersuchungen nach der Größe der Anomalie, den geschäftlichen Auswirkungen und der nachgelagerten Nutzung, wenn eine manuelle Überprüfung nicht den gesamten Datensatz abdecken kann.
Der digna-Leitfaden zur Erkennung von Anomalien in Zeitreihen beschreibt, wie Zeitreihensignale diesen Workflow unterstützen können. digna Data Anomalies bietet ein KI-gestütztes Baseline-Lernen und reduziert so die Notwendigkeit, jeden Schwellenwert manuell zu definieren. digna Data Analytics unterstützt die Untersuchung historischer Trends, Volatilitäten und wiederkehrender Verhaltensweisen während der Analyse.
Stellen Sie Baselines mit versionierten Schwellenwerten, dokumentierten Prüfentscheidungen und Verantwortlichen für ungelöste Warnmeldungen bereit. Überwachen Sie das Warnmeldungsvolumen und wiederkehrende Muster nach der Bereitstellung, aber betrachten Sie Observability (Beobachtbarkeit) nicht als Beweis für die Richtigkeit von Werten. Sie zeigt lediglich, wo Nachweise erforderlich sind und ob sich die Kontrollen wie erwartet verhalten.
4. Schema-Tracking und strukturelle Validierung
Die Genauigkeit hängt sowohl von der Struktur als auch von den Werten ab. Ein Spaltentyp, ein Feldname, ein Schlüssel oder eine Tabellenbeziehung bestimmt, wie nachgelagerte Systeme Quelldaten interpretieren. Schema-Tracking erfasst diese strukturellen Elemente und deckt Änderungen auf, bevor sie Berichte, Modelle oder operative Workflows verfälschen.
Ein neues regulatorisches Feld in einem Finanz-Feed wird möglicherweise in Berichten weggelassen, wenn Transformationen nicht aktualisiert werden. Die Änderung eines klinischen Elements von Text in Numerisch kann die Erfassung stören oder seine Bedeutung verändern. Eine umstrukturierte Kundenreferenztabelle kann zu fehlgeschlagenen oder fehlerhaften Verknüpfungen (Joins) in der Telekommunikationsanalyse führen. Das Entfernen einer Audit-Spalte kann die Berichterstattung im öffentlichen Sektor schwächen, während die verbleibenden Werte immer noch gültig erscheinen.
Die schwierigsten Fehler sind die stillen Fehler. Eine tolerante Datenerfassung akzeptiert möglicherweise eine geänderte Struktur, und ein Dashboard läuft möglicherweise mit unvollständigen Feldern oder falsch verknüpften Datensätzen weiter. Der resultierende Genauigkeitsanspruch ist nicht mehr vertretbar, da die Daten nicht mehr die beabsichtigten Geschäftsentitäten und -beziehungen darstellen.
Strukturelle Änderungen als Bereitstellungsereignisse steuern
Die Schemaüberwachung gehört in denselben Kontrollprozess wie Datenkataloge, Datenherkunft (Lineage), Freigaben von Releases und die Kommunikation mit den Konsumenten. Jede genehmigte Änderung benötigt einen Verantwortlichen, ein Gültigkeitsdatum, eine Kompatibilitätsentscheidung und eine Versionshistorie. Eine nicht genehmigte Änderung sollte einen Vorfall auslösen, bevor sie einen kritischen Bericht oder ein Modell erreicht.
Nutzen Sie die folgenden Prüfungen, um die Kontrolle operativ umzusetzen:
Erkennung von Änderungen: Finden Sie hinzugefügte, entfernte, umbenannte und neu typisierte Felder.
Kompatibilitätstests: Überprüfen Sie, ob Verknüpfungen, Transformationen und konsumierende Anwendungen die Struktur weiterhin korrekt interpretieren.
Benachrichtigung der Konsumenten: Warnen Sie betroffene Teams, bevor eine genehmigte Änderung in die Produktion einfließt.
Risikoklassifizierung: Wenden Sie strengere Prüfungen auf Schemata an, die regulatorische, finanzielle, klinische oder KI-Workflows unterstützen.
Historische Aufzeichnungen: Bewahren Sie die Änderungshistorie für Audits und Ursachenanalysen auf.
digna Schema Tracker erkennt strukturelle Änderungen, einschließlich Änderungen von Spalten und Datentypen. Diese Prüfungen liefern den Nachweis, dass die Struktur kompatibel bleibt. Sie stellen nicht fest, ob jeder Wert korrekt ist, weshalb eine Validierung und ein Abgleich auf Wertebene weiterhin erforderlich sind.
5. Timeliness und Data Delivery Monitoring
Genauigkeit ist ein vertretbarer Anspruch darüber, wie eng Daten die Realität zum Zeitpunkt der Entscheidung abbilden. Ein Wert kann zum Zeitpunkt der Erfassung korrekt sein, aber irreführend, wenn er zu spät geliefert wird. Die Aktualitätsüberwachung (Timeliness) untersucht, ob kritische Daten wie erwartet eintreffen, ob eine Ladung fehlt und ob ihre Frische zum operativen Anwendungsfall passt.
Die Kontrolle ist wichtig bei der Abwicklung am Tagesende, bei Abläufen zur Entlassung von Patienten, bei morgendlichen Überprüfungen in der Telekommunikation und bei stündlichen Lagerbeständen im Einzelhandel. Ein Dashboard, das während des aktiven Verkaufs den Lagerbestand von gestern anzeigt, enthält zwar gültige Datensätze, stellt aber nicht den aktuellen Bestand dar. Veraltete Daten schränken daher ein, was Genauigkeit unterstützen kann.
Legen Sie die Erwartungen an die Bereitstellung gemeinsam mit den Geschäftsinhabern fest, nicht nur mit den Pipeline-Betreibern. Ein Job kann planmäßig abgeschlossen werden, während er unvollständige Inhalte liefert, während eine verspätete Ladung für einen historischen Bericht akzeptabel, für eine Live-Entscheidung jedoch ungeeignet sein kann.
Nutzen Sie ein Bereitstellungsprotokoll, das Untersuchungen unterstützt:
Erwartete Bereitstellung: Definieren Sie, wann jeder kritische Datensatz eintreffen soll.
Tatsächliche Ankunft: Erfassen Sie frühe, pünktliche, verspätete und fehlende Lieferungen.
Frische (Freshness): Vergleichen Sie das Alter der Datensätze mit den Anforderungen der Entscheidung.
Vollständigkeit bei Lieferung: Bestätigen Sie, dass der erwartete Inhalt eingetroffen ist, und nicht nur eine Datei oder Tabelle.
Muster von Vorfällen: Untersuchen Sie wiederkehrende Verzögerungen bei Quellen, Abhängigkeiten und Pipelines.
Die Echtzeit-Datenüberwachungsfunktionen von digna unterstützen Berechnungen der erwarteten Lieferung und die Überwachung von Zeitplänen. Das digna Timeliness-Modul nutzt gelernte Bereitstellungsmuster, um Verzögerungen, fehlende Ladungen und unerwartetes Ankunftsverhalten zu kennzeichnen. Diese Signale liefern Beweise über die Bereitstellungsleistung und helfen bei der Priorisierung von Untersuchungen. Kombinieren Sie diese mit Validierung und Abgleich, da Frische allein die Korrektheit nicht belegen kann. Bereitstellungsteams sollten außerdem Zuständigkeiten für Warnmeldungen, Eskalationsschwellenwerte und den Punkt definieren, an dem veraltete Daten von der operativen Nutzung ausgeschlossen werden müssen.
6. Reference Data Management und Master Data Governance
Die Genauigkeit hängt davon ab, ob Referenzdaten die geschäftliche Realität widerspiegeln, die mit den operativen Datensätzen beschrieben werden soll. Produktkataloge, Kundenstämme, geografische Taxonomien, Organisationshierarchien, klinische Codesätze, Kontenrahmenstrukturen und regulatorische Klassifizierungen liefern den Kontext für die Interpretation von Werten und die Durchführung von Qualitätskontrollen.
Ein falscher Produktpreis im Katalog kann dazu führen, dass nachgelagerte Validierungen fehlerhafte Transaktionen genehmigen. Unterschiedliche Anbieterkennungen können dazu führen, dass eine erfolgreiche Verknüpfung ein klinisches Ereignis mit der falschen Entität verknüpft. Fehler in den Referenzdaten breiten sich daher in abhängigen Systemen aus und können andere Qualitätssignale beruhigend aussehen lassen, ohne dass die Korrektheit bewiesen ist.
Die Governance-Anforderungen variieren je nach Domäne. Finanzdienstleistungsteams steuern möglicherweise Taxonomien von Gegenparteien und regulatorischen Entitäten. Gesundheitsteams verwalten Patientenidentifikatoren, Anbieternachweise und klinische Codesätze. Telekommunikationsunternehmen pflegen Kundenhierarchien, Dienstleistungskataloge und geografische Klassifizierungen. Abteilungen des öffentlichen Sektors verwalten Bürgerdaten und Codes für Leistungsprogramme.
Aufbau einer autoritativen Referenzschicht
Beginnen Sie mit den Domänen, die weitreichende Entscheidungen beeinflussen. Weisen Sie jeder einen verantwortlichen Owner, Genehmigungsregeln, Versionshistorie, Gültigkeitstermine und einen kontrollierten Verteilungsprozess zu. Diese Kontrollen liefern Nachweise für Untersuchungen und bieten eine vertretbare Grundlage für die Entscheidung, welche Werte die Konsumenten nutzen sollten.
Inhaberschaft (Ownership): Weisen Sie die Verantwortung für die Genehmigung, Überprüfung und Korrektur von Stammdatenwerten zu.
Versionierung: Bewahren Sie Änderungen auf, damit historische Aufzeichnungen interpretierbar bleiben.
Synchronisierung: Verteilen Sie genehmigte Werte konsistent über operative und analytische Systeme hinweg.
Nutzung der Validierung: Verknüpfen Sie Nachschlagetabellen mit Kontrollen auf Datensatzebene und dokumentieren Sie die erwartete Domäne.
Frische-Überwachung: Identifizieren Sie veraltete oder unvollständige Referenzwerte vor der nachgelagerten Nutzung.
„Master“ ist ein Governance-Status, kein Beweis für Korrektheit. Genehmigungs-Workflows, Abgleiche und regelmäßige Überprüfungen bleiben notwendig. digna Data Validation kann Referenzlisten und geschäftliche Einschränkungen anwenden, um Werte außerhalb der beabsichtigten Domäne zu kennzeichnen. Behandeln Sie diese Kennzeichnungen als Beweismittel für die Überprüfung und bestätigen Sie den Referenzwert sowie dessen Gültigkeitszeitraum, bevor Sie Produktionsdaten ändern.
7. Data Lineage und Impact Analysis for Accuracy Traceability
Genauigkeit ist ein vertretbarer Anspruch darüber, wie genau Daten die Realität abbilden, kein Rückschluss, der aus einem einzelnen Qualitätssignal gezogen wird. Data Lineage (Datenherkunft) zeigt, woher ein Wert stammt, welche Transformationen ihn verändert haben und welche Berichte, Dashboards oder Modelle ihn konsumiert haben. Die Auswirkungsanalyse (Impact Analysis) identifiziert die Personen und Prozesse, die nach einem Vorfall möglicherweise untersucht werden müssen.
Ein falscher Spesenbetrag in einem Executive-Dashboard veranschaulicht den Unterschied. Ermittler können den Wert aus dem Hauptbuch über die Bereitstellung, die Transformationslogik und die Warehouse-Tabellen zurückverfolgen und anschließend die betroffene Ausgabe überprüfen. Im Gesundheitswesen kann Lineage Berichte und Modelle identifizieren, die von geänderten Patientendemografien abhängen. Im Einzelhandel kann sie zeigen, wie fehlerhafte Produktdaten in die Bestandsführung, Prognosen und die Gewinn- und Verlustrechnung einfließen.
Lineage stellt nicht fest, ob ein Wert korrekt ist. Sie liefert Herkunftsnachweise (Provenance) zur Prüfung des Anspruchs, einschließlich seiner Quelle, Verarbeitungsverlauf und nachgelagerten Nutzung.
Rückverfolgbarkeit operativ nutzbar machen
Kartieren Sie zuerst Datenflüsse mit hoher Priorität. Erfassen Sie Quellmetadaten, Transformationslogik, Inhaberschaft und Abhängigkeiten und verknüpfen Sie Lineage-Aufzeichnungen mit Qualitätsvorfällen. Wiederkehrende Fehler können Ermittler zu einer risikoreichen Quelle oder Transformation führen, aber Validierung und Abgleich bestimmen letztendlich immer noch, ob der Wert der geschäftlichen Realität entspricht.
Nutzen Sie diese operativen Kontrollen:
Kartierung kritischer Datenflüsse: Priorisieren Sie regulierte Berichte, Finanzkennzahlen, Kundenprozesse und KI-Eingangsdaten.
Dokumentation der Transformationen: Erfassen Sie, was geändert wurde, warum es geändert wurde und wer es genehmigt hat.
Auswirkungsanalyse: Identifizieren Sie Dashboards, Modelle und Prozesse, die überprüft werden müssen.
Priorisierung der Behebung: Korrigieren Sie den ursprünglichen Fehler, bevor Sie nachgelagerte Kopien wiederholt ändern.
Aktualisierung von Änderungen: Aktualisieren Sie Lineage nach Änderungen an Pipelines, Schemata oder Inhaberschaften.
Die digna-Perspektive zur Kombination von Data Lineage und Datenqualität verknüpft Rückverfolgbarkeit mit der Reaktion auf Vorfälle. Die Katalogisierungs- und Integrationsfunktionen von digna können die Lineage-Dokumentation parallel zu Validierungs-, Anomalie-, Aktualitäts- und Schemakontrollen unterstützen.

7-Punkte-Vergleich der Datengenauigkeit
Element | Komplexität der Implementierung 🔄 | Ressourcenanforderungen ⚡ | Erwartete Ergebnisse 📊⭐ | Ideale Anwendungsfälle (Bestens geeignet für) | Hauptvorteile ⭐ | Tipps 💡 |
|---|---|---|---|---|---|---|
Datenvalidierung gegen Geschäftsregeln | Mittel 🔄 | Mittel ⚡ | Deterministische Erkennung von Regelverstößen; auditfähige Ergebnisse | Compliance, regulatorische Kontrollen, Durchsetzung auf Datensatzebene | Hohe Präzision und Wiederholbarkeit; Audit-Trails ⭐ | Beginnen Sie mit Regeln mit hoher Auswirkung; versionieren Sie Regeln und binden Sie Stakeholder ein 💡 |
Datenabgleich und systemübergreifender Vergleich | Mittel–Hoch 🔄 | Hoch ⚡ | Identifiziert fehlende/duplizierte Datensätze und Wertabweichungen; quantifiziert Diskrepanzen | Multi-System-Umgebungen, Migrationen, regulierte Branchen | Erkennt stillen Datenverlust und Transformationsfehler; stellt Verantwortlichkeiten her ⭐ | Definieren Sie eine Single Source of Truth; automatisieren Sie Zeitpläne; gleichen Sie auf mehreren Ebenen ab 💡 |
Statistische Anomalieerkennung und Baseline-Lernen | Niedrig–Mittel 🔄 | Mittel ⚡ | Adaptive Anomaliewarnungen und Drift-Erkennung; Frühwarnsignale | Große, komplexe Datensätze; saisonale/trendabhängige Daten; proaktive Überwachung | Erkennt neue/unerwartete Muster ohne manuelle Regeln ⭐ | Lassen Sie eine Anlernphase für die Baseline zu; kombinieren Sie sie mit Regelprüfungen; nutzen Sie Fachexperten für die Interpretation 💡 |
Schema-Tracking und strukturelle Validierung | Niedrig 🔄 | Niedrig ⚡ | Echtzeiterkennung von Schema-Drift (Spalten/Typen); verhindert stille Ausfälle | Heterogene Plattformen; häufige Schemaänderungen; Pipeline-Stabilität | Verhindert nachgelagerte Unterbrechungen; schnelle Reaktion auf Vorfälle; Audit-Trail ⭐ | Integrieren Sie Kataloge; implementieren Sie Änderungskontrollen und Warnmeldungen vor Änderungen 💡 |
Aktualität und Überwachung der Datenbereitstellung | Niedrig–Mittel 🔄 | Niedrig–Mittel ⚡ | Erkennt verspätete/fehlende/vorzeitige Ladungen; SLA-Einhaltung und verkürzte Erkennungszeit | Zeitkritische Berichterstattung, SLAs, Echtzeit-Betrieb | Reduziert die Latenz bei der Erkennung von Vorfällen; proaktive Warnmeldungen ⭐ | Setzen Sie klare SLAs; überwachen Sie auch die Vollständigkeit; berücksichtigen Sie Zeitzonen-/Uhrzeitabweichungen 💡 |
Referenzdatenmanagement & Master Data Governance | Hoch 🔄 | Hoch ⚡ | Single Source of Truth für gültige Werte; konsistente nachgelagerte Genauigkeit | Unternehmensweite Konsistenz, Kunden-/Produkt-/Stamm-Dimensionen | Verhindert systemübergreifende Inkonsistenzen; unterstützt Governance und Audits ⭐ | Priorisieren Sie kritische Stammdaten; nutzen Sie Versionskontrolle und automatisieren Sie die Synchronisierung 💡 |
Datenherkunft & Auswirkungsanalyse für die Rückverfolgbarkeit der Genauigkeit | Mittel–Hoch 🔄 | Hoch ⚡ | Schnelle Ursachenanalyse und nachgelagerte Auswirkungsanalyse; Herkunftsnachweis für Audits | Regulierte Branchen, komplexe Pipelines, große Unternehmen | Beschleunigt die Behebung und Risikobewertung; zeigt die Herkunft ⭐ | Automatisieren Sie die Metadatenerfassung; beginnen Sie mit kritischen Datenflüssen; halten Sie Lineage aktuell 💡 |
Genauigkeitssignale in vertrauenswürdige Entscheidungen verwandeln
Genauigkeit fragt, ob Daten die Realität widerspiegeln. Gültigkeit fragt, ob Daten definierten Formaten, Domänen oder Regeln entsprechen. Plausibilität (Reasonableness) fragt, ob ein Wert im Kontext plausibel erscheint. Diese Dimensionen überschneiden sich, sind aber nicht austauschbar.
Ein Datum kann gültig sein, weil es dem erforderlichen Format folgt, und plausibel, weil es in einen realistischen Zeitraum fällt, und dennoch ungenau, wenn es zum falschen Datensatz gehört. Eine Telefonnummer kann eine Formatprüfung bestehen, ohne mit dem angegebenen Kunden verbunden zu sein. Eine gemeldete Umsatzzahl kann plausibel aussehen, während sie eine Quellsystemgruppe auslässt. Jede bestandene Prüfung als Beweis für Genauigkeit zu behandeln, schafft falsches Vertrauen.
Die Richtlinien von Statistics Canada beschreiben Genauigkeit durch die Differenz zwischen einer Schätzung und dem wahren Wert der Grundgesamtheit, wobei Verzerrungen (Bias) und Varianz zur Ungenauigkeit beitragen. Sie weisen auch auf Zuverlässigkeitsschwellenwerte hin, die auf dem Variationskoeffizienten basieren, einschließlich Werten unter 16,6 % für allgemeine Zuverlässigkeit, Werten von 16,6 % bis 33,3 %, die eine Warnung enthalten sollten, und Werten über 33,3 %, die für den statistischen Kontext als unzuverlässig gelten . Unternehmensteams sollten diese Schwellenwerte nicht blind in die operative Datenqualität übernehmen. Sie sollten zweckmäßige Toleranzen definieren, die auf der Entscheidung, dem Risiko und den verfügbaren Beweisen basieren.
Ein praktischer Ablauf für den Genauigkeitsbetrieb
Realität definieren: Identifizieren Sie das Objekt, das Ereignis oder den Wert sowie die Felder, die diese darstellen.
Autoritativen Beweis benennen: Legen Sie vertrauenswürdige Quellen, Referenzdaten oder anerkannte Vergleichsmethoden fest.
Deterministische Kontrollen anwenden: Nutzen Sie Validierungsregeln für Geschäftslogik, Domänen, Beziehungen und Einschränkungen.
Darstellungen abgleichen: Vergleichen Sie Quelle, Bereitstellung, Warehouse, Berichte und abgeleitete Datensätze, wo dies angebracht ist.
Verhalten überwachen: Fügen Sie Anomalieerkennung, Aktualitätsprüfungen und strukturelle Überwachung hinzu, um unerwartete Zustände abzufangen.
Zurückverfolgen und untersuchen: Nutzen Sie Lineage, historische Analysen und Verantwortlichkeiten, um Ursachen zu finden und Entscheidungen zu dokumentieren.
Beheben und neu kalibrieren: Korrigieren Sie die Quelle oder die Transformation und prüfen Sie anschließend, ob die Kontrolle noch dem beabsichtigten Verwendungszweck entspricht.
Wie kann digna die Datengenauigkeit unterstützen?
digna Data Validation unterstützt deterministische Prüfungen gegen Geschäftsregeln, Referenzdaten, exakte Werte, Schwellenwerte, Bereiche und erwartete Bedingungen. digna Data Reconciliation vergleicht vertrauenswürdige Quell- und Zielsysteme, um Abweichungen in datenbankinternen Datensätzen zu identifizieren. digna Data Anomalies identifiziert unerwartete Abweichungen, die auf ungenaue Daten hinweisen können, wobei diese Warnmeldungen Signale für Untersuchungen sind, keine Beweise. digna Data Analytics hilft Teams dabei, historische Muster, Volatilitäten und wiederkehrende Verhaltensweisen rund um diese Signale zu untersuchen.
Die Plattform führt Metrikberechnungen und -analysen direkt in den Datenbanken des Kunden aus, mit Bereitstellungsoptionen in der Private Cloud oder On-Premises innerhalb der Cloud, VPC oder des Rechenzentrums des Kunden. Dieses Design sorgt dafür, dass die Daten an ihrem Ort verbleiben, während Ingenieure, Analysten und Governance-Teams eine gemeinsame Sicht auf Vorfälle und Trends erhalten. Ein Performance-Dashboard für Transportunternehmen veranschaulicht die Art der operativen Berichterstattung, die von zuverlässigen zugrunde liegenden Kennzahlen abhängt, obwohl das Vertrauen in das Dashboard immer noch Beweise über die Quelldaten erfordert.
Häufig gestellte Fragen
Was ist Datengenauigkeit (Accuracy) in der Datenqualität?
Datengenauigkeit ist der Grad, in dem Daten die Welt, ein Objekt, ein Ereignis oder einen Wert, den sie beschreiben sollen, korrekt oder sachlich richtig darstellen. Das DAMA-Forschungspapier zu Datenqualitätsdimensionen definiert sie als die Nähe zu realen Werten, was häufig anhand einer bekannten korrekten Quelle oder einer Source of Truth bewertet wird.
Wie wird die Datengenauigkeit gemessen?
Teams messen die Datengenauigkeit, indem sie stichprobenartig entnommene oder überwachte Werte mit autoritativen Quellen, wiederholten Messungen, internen Validierungsnachweisen, Referenzdaten oder sorgfältig definierten Erwartungen vergleichen. Eine gängige Metrik ist die Datengenauigkeitsrate (data accuracy rate), berechnet als korrekte Werte geteilt durch die Gesamtzahl der stichprobenartig geprüften Werte, wie in dieser Referenz für Datenqualitätsmetriken beschrieben. Wo kein externer Standard existiert, sollten Teams den Beweistyp und seine Einschränkungen dokumentieren, anstatt ein Ergebnis als absolute Wahrheit darzustellen.
Was ist der Unterschied zwischen Genauigkeit (Accuracy) und Gültigkeit (Validity)?
Die Gültigkeit prüft, ob Daten einem definierten Format, Bereich, einer Domäne oder einer Regel entsprechen. Die Genauigkeit prüft, ob der Wert die Realität widerspiegelt. Ein Wert kann gültig und plausibel sein, während er dennoch dem falschen Kunden, Ereignis, Produkt oder Zeitraum zugeordnet ist.
Wie kann die Datengenauigkeit kontinuierlich überwacht werden?
Eine kontinuierliche Überwachung kombiniert Validierung auf Datensatzebene, Abgleich mit vertrauenswürdigen Quellen, Referenzdatenprüfungen, Anomaliensignale, Schema-Tracking, Aktualitätsüberwachung und durch Lineage unterstützte Untersuchungen. Leitlinien für den Datenqualitätsbetrieb unterscheiden zudem Genauigkeitsprüfungen gegen autoritative Quellen von Gültigkeitsprüfungen wie regulären Ausdrücken und Bereichsregeln.
Welche Tools können die Datengenauigkeit überwachen?
Unternehmen nutzen üblicherweise Tools für Datenvalidierung, Abgleich, Referenzdaten, Observability, Anomalieerkennung, Schema-Tracking, Lineage und historische Analysen. digna führt diese Funktionen über digna Data Validation, digna Data Reconciliation, digna Data Anomalies, digna Data Analytics, Timeliness, Schema Tracker, Kataloge, Integrationen und datenbankinterne Ausführung zusammen. Tools können Beweise aufdecken und Untersuchungen priorisieren, aber die Geschäftsinhaber müssen immer noch bestätigen, ob die Werte die beabsichtigte Realität widerspiegeln.
Eine im Jahr 2025 veröffentlichte Studie zur Observability berichtet, dass 76 % der Unternehmen formalisierte Programme sowohl für die Datenqualität als auch für die Observability von Daten-Pipelines implementiert oder optimiert haben, während 68 % qualitative oder quantitative Metriken zur Erfolgsmessung nutzen . Diese Richtung ist praktisch: Genauigkeit funktioniert am besten als operative Disziplin mit dokumentierten Nachweisen, zugewiesener Inhaberschaft und kontinuierlichem Feedback, nicht als einmaliges Bereinigungsprojekt.
digna bietet datenbankinterne Datenvalidierung, Datenabgleich, Anomalieerkennung, Datenanalyse, Aktualitäts- und Schemaüberwachung für kritische Unternehmensdatensätze. Besuchen Sie digna, um eine modulare Plattform für Datenqualität und Observability kennenzulernen, die in Ihrer eigenen Umgebung läuft und Teams dabei unterstützt, Genauigkeitssignale in überprüfte, nachvollziehbare Entscheidungen zu verwandeln.


