8 Beispiele für Datenqualitätskontrolle für zuverlässige Daten
|
6
min. Lesezeit

Verlässliche Daten entstehen nicht durch eine einzige Validierungsregel. Sie resultieren aus dem Zusammenspiel mehrerer Kontrollen, da ein Datensatz zwar strukturell gültig, aber veraltet, vollständig, aber anomal oder technisch fehlerfrei sein kann, während er dennoch ein unplausibles Geschäftsergebnis liefert. Das finanzielle Risiko ist erheblich. In der Gartner-Forschung wird häufig geschätzt, dass die durchschnittlichen jährlichen Kosten durch schlechte Datenqualität bei 12,9 Millionen US-Dollar pro Organisation liegen, während entsprechende Zusammenfassungen Ungenauigkeiten als am häufigsten genannten Treiber identifizieren, der 68 % der Befragten betrifft (Zusammenfassung der Kosten und Treiber der Datenqualität).
Die operativen Belege weisen in dieselbe Richtung. Im Jahr 2023 meldeten Datenteams 67 monatliche Datenvorfälle, im Vergleich zu 59 im Jahr 2022. 68 % gaben an, dass die Erkennung von Vorfällen vier Stunden oder länger dauerte, und die durchschnittliche Behebungszeit stieg um 166 % auf 15 Stunden pro Vorfall (Datenqualitätsumfrage 2023). Diese Beispiele für Datenqualitätskontrollen behandeln jeden Fehlermodus separat und zeigen dann, wie deterministische Data Validation, statistische Überwachung, Timeliness-Kontrollen, Schema-Tracking, Analysen und die datenbankinterne Ausführung einander verstärken.
Die praktische Frage ist, wohin jede Kontrolle gehört, wie Teams sie implementieren sollten und welches operative Signal beweist, dass sie funktioniert. digna kombiniert diese Funktionen, während die Daten in der Umgebung des Kunden verbleiben, wodurch der Ansatz sowohl für regulierte Gesundheits- und Finanzdatensätze als auch für hochvolumige Telekommunikations- und Pipelines des öffentlichen Sektors relevant ist.
Inhaltsverzeichnis
1. KI-gestützte Anomalieerkennung mit Baseline-Lernen
Von ungewöhnlichen Zeilen zu ungewöhnlichem Verhalten
2. Record-Level Data Validation gegen Business-Regeln
Jede Regel nachvollziehbar machen
3. Timeliness-Überwachung mit Schätzung der erwarteten Lieferzeit
Schedules in operative Verträge verwandeln
4. Schema-Änderungserkennung und -Tracking
Strukturelle Änderungen als Eigentumsereignis behandeln
5. Business-KPI-Überwachung und Verhaltensanalyse
6. Datenplattform-Observability und Überwachung operativer Metriken
Technische Gesundheit mit dem Business-Service verknüpfen
7. Datenbankinterne Berechnung und Analyse von Qualitätsmetriken
Datenbewegungen reduzieren, ohne an Sichtbarkeit zu verlieren
8. Historische Trendanalyse und statistische Mustererkennung
Trendkontext mit sofortiger Erkennung paaren
8-Punkte-Datenqualitätskontroll-Vergleich
Beispiele in einen vielschichtigen Kontrollplan verwandeln
1. KI-gestützte Anomalieerkennung mit Baseline-Lernen
Ein fester Schwellenwert kann eine Transaktionsanzahl oberhalb eines willkürlichen Limits melden, kann aber auch bei saisonaler Nachfrage, geplanten Kampagnen oder normalem Wachstum Rauschen erzeugen. Baseline-Lernen adressiert diese Schwäche, indem es das übliche Verhalten jedes Datensatzes modelliert und neue Beobachtungen mit dem im Laufe der Zeit etablierten Muster vergleicht.
Das Ausfallsignal ist eine Abweichung, nicht zwingend eine Regelverletzung. Ein Finanzdienstleistungsteam bemerkt möglicherweise ein ungewöhnliches Transaktionsvolumenmuster, das auf einen Verarbeitungsfehler oder möglichen Betrug hinweist. Eine Gesundheitsorganisation könnte eine unerwartete Verschiebung bei den Patienteneinweisungen oder der Verteilung von Laborergebnissen untersuchen. Ein E-Commerce-Team fängt vielleicht einen Rückgang des Bestellvolumens ab, noch bevor Analysten bemerken, dass ein Dashboard unvollständig ist.
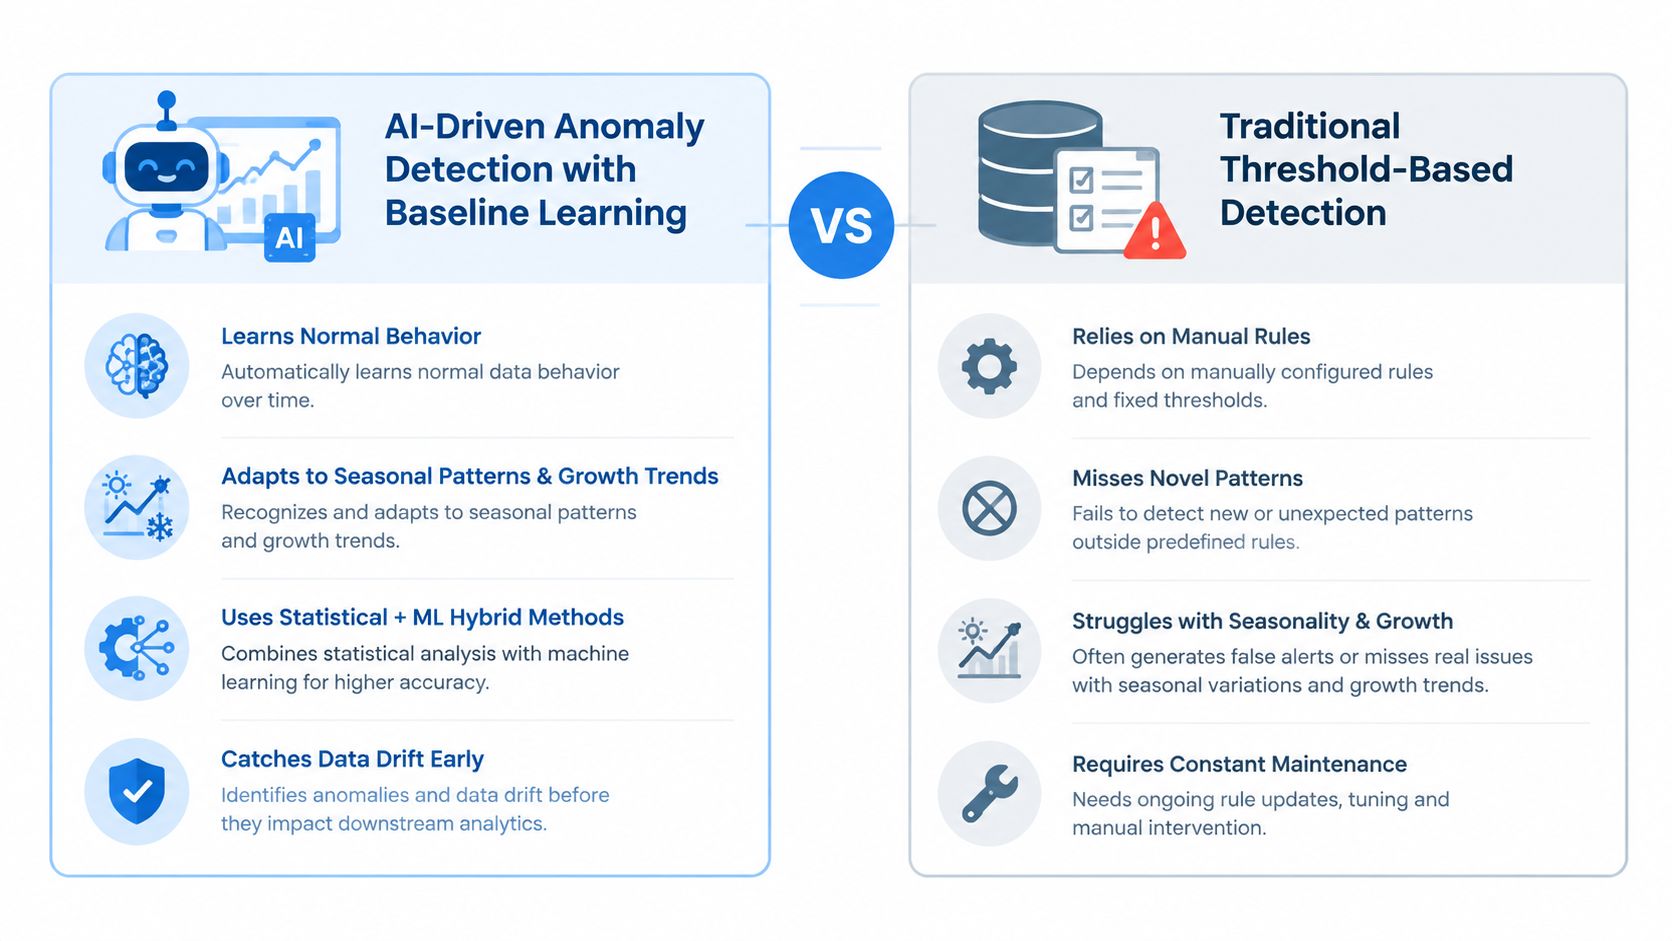
Von ungewöhnlichen Zeilen zu ungewöhnlichem Verhalten
Die Implementierung sollte sowohl Punktanomalien berücksichtigen, bei denen eine einzelne Beobachtung abnormal ist, als auch kollektive Anomalien, bei denen mehrere, für sich genommen plausible Metriken zusammen besorgniserregend werden. Auch die Sensitivität muss angepasst werden. Ein volatiler Zahlungsstrom benötigt möglicherweise ein anderes Warnverhalten als ein stabiler regulatorischer Datensatz.
Teams sollten der Baseline Zeit zum Lernen geben, bevor sie jede Warnung als handlungsrelevant behandeln. Sie können dann die Anomalieerkennung mit der Eingangsüberwachung kombinieren, da ein ungewöhnliches Volumen auf eine echte geschäftliche Veränderung hinweisen kann, während eine ausbleibende Lieferung auf einen Pipeline-Ausfall hindeuten kann.
Praktische Regel: Nutzen Sie gelerntes Verhalten, um zu entdecken, was feste Regeln nicht beschreiben können, und verwenden Sie dann deterministische Prüfungen, um zu bestätigen, ob die Abweichung gegen eine bekannte Geschäftsbedingung verstößt.
dignas KI-Anomalieerkennung für Zeitreihendaten erfüllt diese Rolle, indem sie sich änderndes Datenverhalten überwacht, ohne dass jedes erwartete Muster manuell geschrieben werden muss. Die messbare Folge ist eine frühere Sichtbarkeit abnormaler Bewegungen, mit weniger Warnungen, die nur an einfache statische Limits gebunden sind.
2. Record-Level Data Validation gegen Business-Regeln
Manche Fehler benötigen kein statistisches Modell. Wenn ein Feld einen numerischen Wert mit einem zweistelligen Dezimalformat enthalten muss, ist die Prüfung explizit. Wenn ein Autotyp nur „Compact“, „Standard“, „Full size“, „SUV“ oder „Other“ sein darf, kann eine Regel für zulässige Werte alles andere ablehnen oder isolieren. IBM dokumentiert auch feldübergreifende Logik wie Flugpreis + Steuern = Gesamtkosten (Business-Validierungsregeln).
Das macht die Record-Level-Validierung besonders nützlich, wo Auditierbarkeit eine Rolle spielt. Ein Finanzinstitut kann Transaktionen gegen Kreditlinien von Kunden validieren. Ein Gesundheitssystem kann überprüfen, ob Patienten-IDs über klinische Tabellen hinweg übereinstimmen. Ein Telekommunikationsanbieter kann prüfen, ob zu den Abrechnungsdatensätzen entsprechende Dienstnutzungseinträge vorhanden sind.
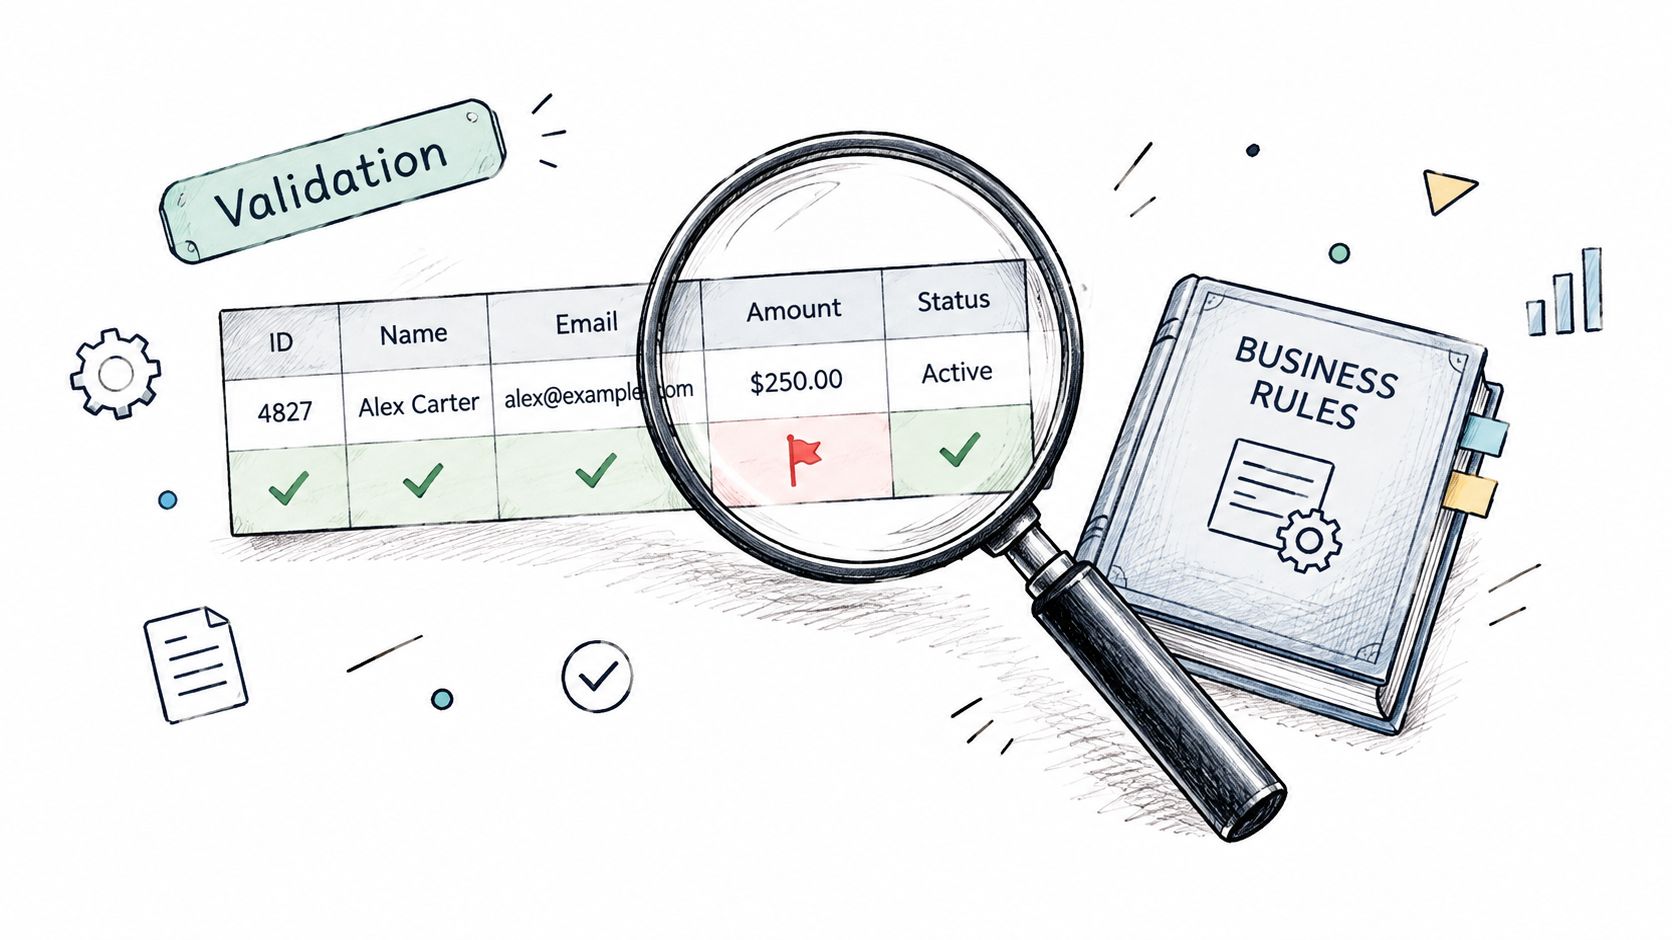
Jede Regel nachvollziehbar machen
Beginnen Sie mit Regeln, die an die folgenreichsten Datensätze gebunden sind, und beziehen Sie die Business-Verantwortlichen ein, bevor Sie die Regelbibliothek erweitern. Ein technisches Team weiß vielleicht, wie man ein Feld testet, aber ein Stakeholder aus den Finanzen oder der Klinik weiß, ob die geschäftliche Bedeutung des Feldes korrekt dargestellt wurde.
Nützliche Kontrollen umfassen:
Format-Validierung: Bestätigen, dass Werte dem erforderlichen Typ und Muster entsprechen.
Zulassungslisten-Validierung: Kategorische Felder auf verwaltete Werte beschränken.
Feldübergreifende Validierung: Überprüfen, ob zusammenhängende Spalten eine definierte Gleichung oder Abhängigkeit erfüllen.
Referenzielle Validierung: Bestätigen, dass IDs mit den Datensätzen verknüpft sind, auf die sie verweisen sollen.
Versionierte Regeln: Die Regeldefinition und ihr Gültigkeitsdatum für die Audit-Historie aufbewahren.
Deterministische Prüfungen ersetzen die Anomalieerkennung nicht. Sie liefern die prüfbereite Erklärung für eine bekannte Anforderung, während die Anomalieüberwachung Verhalten erkennt, an dessen Codierung niemand gedacht hat. dignas Data Validation-Regeln und kontinuierliche Qualitätskontrollen können als explizite Ebene in dieser Kombination verwendet werden.
Eine zuverlässige Kontrolle besagt nicht nur, dass eine Zeile fehlgeschlagen ist. Sie identifiziert die Geschäftsbedingung, den betroffenen Datensatz, die Regelversion und den für die Behebung verantwortlichen Owner.
3. Timeliness-Überwachung mit Schätzung der erwarteten Lieferzeit
Ein Datensatz kann jede Inhaltsprüfung bestehen und dennoch unbrauchbar sein, wenn die Datensätze von gestern erst nach der heutigen Berichtsdeadline eintreffen. Die Timeliness-Überwachung behandelt das Eingangsverhalten als Qualitätsdimension und nicht als separates Infrastrukturproblem.
Eine praktische Frischheitsberechnung verwendet den neuesten Ereignis-Zeitstempel in einer Tabelle. Die Frische kann als aktuelle Systemzeit minus dem maximalen Ereignis-Zeitstempel ausgedrückt werden, einschließlich der SQL-Form TIMESTAMPDIFF(MINUTE, MAX(event_timestamp), CURRENT_TIMESTAMP()) (Frische- und Latenzüberwachung).
Das Ausfallsignal könnte ein fehlender nächtlicher Ladevorgang sein, bevor sich die morgendlichen Dashboards öffnen. Ein Compliance-Team muss eventuell wissen, ob die Berichtsdaten bis zu einer erforderlichen Frist eingetroffen sind. Ein Data-Warehouse-Team entdeckt möglicherweise einen ETL-Prozess, der zunehmend langsamer wird, obwohl er immer noch erfolgreich abgeschlossen wird.
Schedules in operative Verträge verwandeln
Überwachen Sie den feinsten nützlichen Schedule für den Datensatz, sei es stündlich, täglich oder wöchentlich. Die erwartete Lieferung sollte die geschäftlichen Auswirkungen widerspiegeln, nicht nur die historische Abweichung. Geplante Wartungsfenster müssen ebenfalls dokumentiert werden, da die Kontrolle andernfalls Warnmeldungen erzeugt, von denen Ingenieure bereits wissen, dass sie harmlos sind.
Eine praktische Regel klassifiziert Datensätze, die älter als 12 Monate sind, als wahrscheinlich veraltet. Wenn mehr als 30 % einer Datenbank in diese Kategorie fallen, identifiziert die Quelle ein Timeliness-Problem, wobei auch anzumerken ist, dass oft eine 90-Tage-Aktualisierungsrate erforderlich ist, um die Timeliness aufrechtzuerhalten (Leitfaden zur Data Timeliness).
dignas Data Timeliness-Überwachung ergänzt das Qualitätsbild um das erwartete Lieferverhalten. Kombinieren Sie dies mit der Volumen-Anomalieerkennung. Ein Ladevorgang, der pünktlich mit einem unerwartet geringen Volumen eintrifft, ist ein anderer Fehler als ein Ladevorgang, der überhaupt nicht eintrifft – und Teams benötigen beide Signale, um effizient zu priorisieren.
4. Schema-Änderungserkennung und -Tracking
Eine Quelle kann gefüllt und scheinbar gesund bleiben, während eine strukturelle Änderung nachgelagerte Modelle unbrauchbar macht. Ein hinzugefügtes Feld mag harmlos sein, aber eine fehlende Nicht-Null-Spalte, ein umbenanntes Attribut oder ein geänderter Typ können Transformationen und Berichte ungültig machen.
Schema-Tracking erkennt diese Änderungen auf Spaltenebene und bewahrt die Evolutionshistorie. Die Profiling-Ausgabe von Azure Databricks enthält Drift-Maße wie count_delta, avg_delta und percent_null_delta zusammen mit einem drift_type, der zwischen Baseline- und aufeinanderfolgenden Fenstervergleichen unterscheidet (Ausgabe der Schema-Drift-Überwachung).
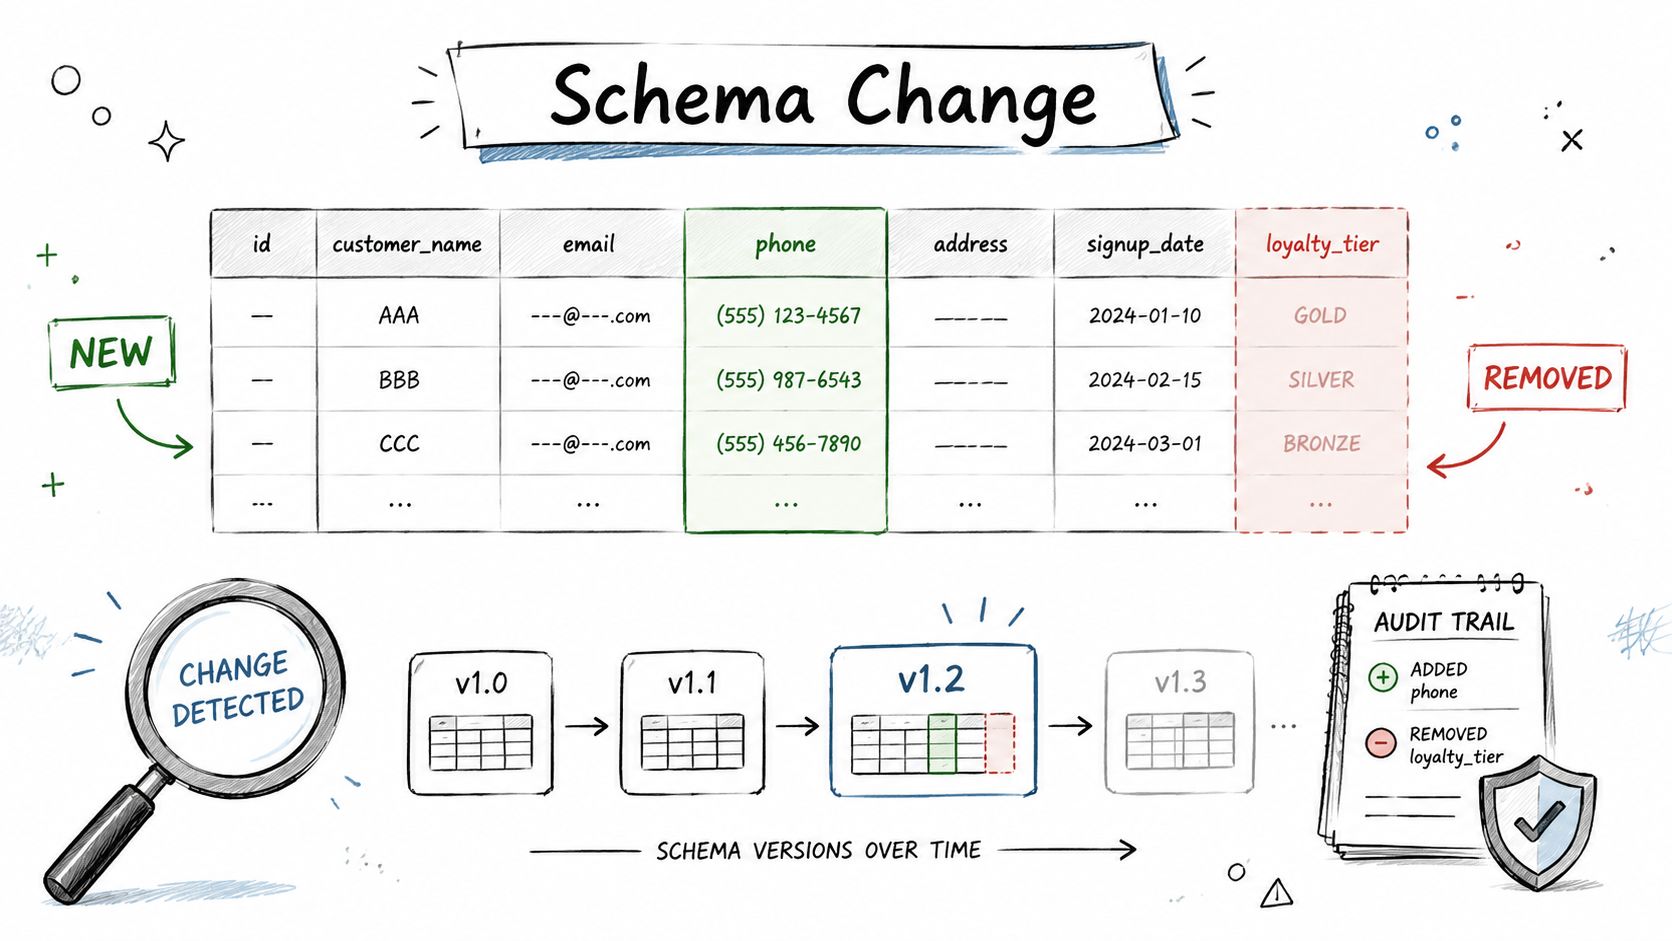
Strukturelle Änderungen als Eigentumsereignis behandeln
Ein Analytics-Engineering-Team sollte wissen, dass ein Quellsystem Felder hinzugefügt hat, bevor nachgelagerte Modelle ausfallen. Ein Warehouse-Team sollte in der Lage sein, eine unangekündigte Änderung durch einen Anbieter zu identifizieren. Platform Engineers können die Historie nutzen, um zu verstehen, ob unerwartete strukturelle Änderungen zu einem wiederkehrenden Governance-Problem werden.
Der Reaktionsprozess ist ebenso wichtig wie die Erkennung:
Die Änderung erfassen: Hinzugefügte, entfernte, umbenannte und typgeänderte Spalten aufzeichnen.
Den Owner benachrichtigen: Das Ereignis an die Quell- und nachgelagerten Betreuer weiterleiten.
Den Katalog aktualisieren: Die genehmigte Bedeutung und die erwarteten Konsumenten dokumentieren.
Inhaltsprüfungen verknüpfen: Die Validierung nach strukturellen Änderungen ausführen, um neu ungültige Werte abzufangen.
Den Vorfall überprüfen: Eine genehmigte Weiterentwicklung von einem unkontrollierten Abbruch unterscheiden.
dignas Schema-Drift-Überwachung liefert die strukturelle Ebene. Sie sollte nicht isoliert arbeiten. Schema-Tracking teilt Teams mit, was sich geändert hat, während die Validierung ihnen sagt, ob die neue Struktur immer noch die geschäftlichen Anforderungen erfüllt.
5. Business-KPI-Überwachung und Verhaltensanalyse
Technische Prüfungen können melden, dass Zeilen eingetroffen sind, Spalten existieren und Werte mit ihren Formaten übereinstimmen. Sie können jedoch für sich genommen nicht beantworten, ob sich das Geschäft plausibel verhält. KPI-Überwachung schließt diese Lücke, indem sie Verhaltensanalysen auf Metriken wie Umsatz, Kundenakquise, Bestellvolumen, Genehmigungsraten und Behandlungsergebnisse anwendet.
Ein E-Commerce-Team könnte eine unerwartete Verschiebung des durchschnittlichen Bestellwerts feststellen, bevor sich dies auf die Umsatzberichterstattung auswirkt. Ein Finanzdienstleistungsunternehmen könnte eine ungewöhnliche Änderung der Transaktionsgenehmigungsraten untersuchen. Eine Gesundheitsorganisation könnte Einweisungsmuster oder Behandlungsergebnisse mit etabliertem Verhalten vergleichen.
Beginnen Sie mit den KPIs, die am engsten mit Entscheidungen sowie finanziellen oder operativen Ergebnissen verknüpft sind. Business-Stakeholder sollten helfen, die Baseline zu definieren und Warnmeldungen zu interpretieren, da eine Kampagne, ein Produktlaunch, eine Richtlinienänderung oder ein saisonales Ereignis eine Bewegung erklären können, die für einen automatisierten Monitor anomal aussieht.
Eine KPI-Warnung ist am nützlichsten, wenn sie eine gemeinsame Untersuchung anstößt. Das Business-Team erklärt das Ereignis, und das Datenteam prüft, ob die zugrunde liegenden Datensätze dies stützen.
Die operative Folge ist eine bessere Trennung zwischen Datenfehlern und echten geschäftlichen Veränderungen. Ein sinkender Bestellwert kann die Nachfrage, einen fehlerhaften Ingestion-Job oder einen in einer Transformation eingeführten Filter widerspiegeln. Die Korrelation von KPI-Bewegungen mit Timeliness-, Volumen- und Schemasignalen weist den Zuständigen einen präziseren Weg zur Ursache.
Dokumentieren Sie jede gelöste Anomalie. Im Laufe der Zeit verbessert diese Aufzeichnung die Interpretation von Warnungen und demonstriert die Verbindung der Datenqualität mit geschäftlichen Ergebnissen, anstatt Qualitätsmetriken isoliert in einem technischen Dashboard zu belassen.
6. Datenplattform-Observability und Überwachung operativer Metriken
Gültige Zeilen garantieren keine zuverlässige Datenplattform. Observability untersucht, ob die Umgebung weiterhin Daten liefern kann, indem sie das Workload-Verhalten, den Ressourcenverbrauch, die Abfrageleistung, die Verfügbarkeit, die Ausführungsdauer und die Nutzungstrends verfolgt.
Ein Warehouse-Team stellt möglicherweise fest, dass sich die Abfrageleistung allmählich verschlechtert hat. Cloud-Nutzer bemerken eventuell ein unerwartetes Speicherwachstum, während Analytics Engineers eine ineffiziente Abfrage identifizieren, die einen unverhältnismäßig großen Anteil der Ressourcen verbraucht. Diese Bedingungen können die nachgelagerte Bereitstellung und Timeliness-Prüfungen verzögern, selbst wenn die Record-Level-Validierung erfolgreich verläuft.
Plattform-Observability verbindet das Infrastrukturverhalten mit den Qualitätsfehlern, die es verursachen kann.
Technische Gesundheit mit dem Business-Service verknüpfen
Definieren Sie normale Betriebsbereiche und überwachen Sie dann sowohl aktuelle Werte als auch deren Änderungsrichtung. Eine isolierte langsame Abfrage mag akzeptabel sein. Eine anhaltende Leistungsverschlechterung kann jedoch Dashboard-Aktualisierungen, geplante Transformationen und die Datenbereitstellung verzögern.
Interpretieren Sie Metriken anhand von Betriebskalendern. Finanzprozesse zum Monatsende, klinische Berichte und hochvolumige Telekommunikationsereignisse können zu legitimen Nachfragesteigerungen führen. Die Einbeziehung dieser Zyklen in die Baselines reduziert Fehlalarme und hilft Teams, erwartete Lasten von Kapazitäts- oder Workload-Problemen zu unterscheiden.
Die Implementierung sollte deterministische Schwellenwerte mit statistischer Überwachung kombinieren. Ein hartes Limit für die Verfügbarkeit oder die Ausführungszeit kann eine sofortige Eskalation auslösen, während die Trendanalyse ein allmähliches Speicherwachstum oder eine sich verschlechternde Abfragelatenz erkennen kann. Die Korrelation dieser Signale mit Schemaänderungen, Lieferverzögerungen und Validierungsfehlern grenzt die Ursachenanalyse ein.
Das Ergebnis sollte zu Maßnahmen führen, anstatt nur ein weiteres Dashboard zu füllen. Platform Engineers können der Abfrageoptimierung, Partitionierung, Workload-Isolierung oder Ressourcenzuweisung Priorität einräumen. Datenverantwortliche können aufzeigen, ob ein Vorfall auf das Plattformverhalten oder auf fehlerhafte Quelldatensätze zurückzuführen ist, und die Wiederherstellung anhand der wiederhergestellten Leistung und Lieferzeiten messen.
Für eine ergänzende operative Perspektive erklärt dieser Leitfaden zum Process Mining, wie Ereignisdaten das Prozessverhalten und Engpässe aufdecken können. Die Plattform-Observability überwacht die Umgebung, in der die Datenarbeit ausgeführt wird, während die Prozessanalyse untersucht, wie sich Aktivitäten durch einen operativen Workflow bewegen.
7. Datenbankinterne Berechnung und Analyse von Qualitätsmetriken
Das Verschieben von Produktionsdaten in einen externen Monitoring-Service wirft eine Frage der Data Governance auf, noch bevor es ein Qualitätsergebnis liefert. Die datenbankinterne Ausführung beantwortet diese Frage, indem sie Validierung, Anomalieanalyse, Metrikberechnung und zugehörige Prüfungen direkt in der eigenen Datenbankumgebung des Kunden ausführt.
Dieses Modell ist besonders für Daten aus dem Gesundheitswesen, dem Finanzsektor und dem öffentlichen Sektor relevant. Eine Gesundheitsorganisation kann Patientendatensätze innerhalb einer kontrollierten Infrastruktur halten. Ein Finanzdienstleistungsunternehmen kann die Qualitätsüberwachung an seinen Sicherheits- und Compliance-Vorgaben ausrichten. Eine Regierungsbehörde kann die Datensouveränität wahren und dennoch operative Qualitätsnachweise erbringen.
Datenbewegungen reduzieren, ohne an Sichtbarkeit zu verlieren
Der wesentliche Kompromiss liegt in der Ressourcenkoordination. Qualitätsberechnungen verbrauchen weiterhin Datenbankkapazität, weshalb Teams intensivere Analysen in geeigneten Fenstern planen, die Leistungsauswirkungen überwachen und mit Datenbankadministratoren an der Zuweisung arbeiten sollten. Bestehende Indexierungs- und Partitionierungsstrategien können ebenfalls effiziente Prüfungen unterstützen.
Ein modularer Rollout senkt das Einführungsrisiko. Teams können mit ressourcenschonenden Validierungen oder Timeliness-Prüfungen beginnen, die Auswirkungen auf die Datenbank messen und die Analysen im Zuge der Weiterentwicklung von Kapazitäten und Verantwortlichkeiten auf Anomalie- und historische Analysen ausweiten. Die Ergebnisse können dann in einem gemeinsamen Dashboard angezeigt werden, ohne dass rohe Produktionsdatensätze außerhalb der kontrollierten Umgebung offengelegt werden.
Die Plattform von digna ist so konzipiert, dass sie in der privaten Cloud oder der On-Premises-Umgebung des Kunden ausgeführt wird, wobei die Prüfungen dort stattfinden, wo die Daten liegen. Diese Architektur unterstützt einen vielschichtigen Kontrollplan für regulierte und sensible Datensätze, entbindet jedoch nicht von der Notwendigkeit von Zugriffskontrollen, Planungsdisziplin oder der Überwachung der Datenbankleistung.
Die operative Folge ist eine kontrollierte Observability. Teams erhalten Qualitätssignale, ohne Datenverschiebungen als Standardvoraussetzung zu etablieren, was die Abstimmung zwischen Data Governance-, Sicherheits-, Engineering- und Datenbankadministrations-Stakeholdern vereinfacht.
8. Historische Trendanalyse und statistische Mustererkennung
Ein einzelner Alarm kann ein Problem im Hier und Jetzt aufzeigen. Die historische Analyse identifiziert Verschlechterungen, die Teams andernfalls als normal akzeptieren würden. Sie untersucht, wie sich Frische, Validierungsfehler, Anomaliezahlen, Geschäfts-KPIs und Plattformmetriken im Laufe der Zeit verändern, und deckt so allmähliche Verschlechterungen, zyklisches Verhalten und Verschiebungen in der Volatilität auf.
Ein Analytics-Team stellt möglicherweise fest, dass sich die Datenfrische von Quartal zu Quartal verschlechtert. Data-Governance-Verantwortliche können Trendnachweise nutzen, um Infrastrukturinvestitionen zu begründen. Platform Engineers können einen anhaltenden Anstieg von Validierungsfehlern erkennen, während Business-Analysten saisonales Kundenakquiseverhalten von einem neu auftretenden Datenfehler unterscheiden können.
Trendkontext mit sofortiger Erkennung paaren
Die Kontrolle funktioniert am besten, wenn Teams das aktuelle Verhalten mit historischen Baselines vergleichen, anstatt jede Schwankung als gleichermaßen wichtig zu behandeln. Eine monatliche Überprüfung kann Veränderungen aufzeigen, bevor sie gravierend werden, während die Echtzeit-Anomalieerkennung dringende Abweichungen handhabt.
Das veröffentlichte Datenqualitäts-Framework betont messbare Dimensionen wie Timeliness, Pünktlichkeit, Granularität, Objektivität, Genauigkeit und Zuverlässigkeit, Kohärenz, Integrität, Glaubwürdigkeit und Sicherheit. Die zentrale operative Implikation ist klar: Eine Kontrolle wird dann handlungsrelevant, wenn Teams sie an eine Baseline, einen Schwellenwert und einen Trend im Zeitverlauf binden.
dignas statistische Mustererkennung kann diese historische Ebene unterstützen. Teams sollten wesentliche Trendänderungen und deren Ursachen dokumentieren und diese Erkenntnisse in Schwellenwerte, Pläne und Zuständigkeitsmodelle zurückführen. Das Ergebnis ist kein längerer Bericht, sondern ein Weg, normale Abweichungen von einer Kontrolle zu unterscheiden, die an Wirksamkeit verliert.
8-Punkte-Datenqualitätskontroll-Vergleich
Ansatz | Implementierungskomplexität 🔄 | Ressourcenanforderungen ⚡ | Erwartete Ergebnisse ⭐📊 | Ideale Anwendungsfälle | Wesentliche Vorteile 💡 |
|---|---|---|---|---|---|
KI-gestützte Anomalieerkennung mit Baseline-Lernen | Mittel–Hoch; ML-Training, Modell-Tuning 🔄🔄 | Historische Daten + moderates Compute; laufende Modellpflege ⚡⚡ | Hohe Erkennung neuartiger Anomalien; weniger Fehlalarme ⭐⭐⭐⭐ 📊 | Große/saisonale Datensätze; Betrugserkennung; metrikübergreifender Drift | Adaptive Baselines; datensatzübergreifend skalierbar; frühe Drifterkennung 💡 |
Record-Level Data Validation gegen Business-Regeln | Niedrig–Mittel; Regelerstellung & -pflege 🔄🔄 | Geringes Compute; erheblicher menschlicher/fachlicher Input für Regeln ⚡ | Hohe deterministische Korrektheit; Audit Trails für Compliance ⭐⭐⭐⭐ 📊 | Regulierte Bereiche; kritische Transaktionsdaten; Compliance-Prüfungen | Explizite, wiederholbare Durchsetzung; prüfbereite Nachweise 💡 |
Timeliness-Überwachung mit Schätzung der erwarteten Lieferzeit | Mittel; Zeitplanungsmodelle & Integrationen 🔄🔄 | Historische Lieferprotokolle + Integrationen; moderates Compute ⚡⚡ | Reduziert MTTD; prädiktive Warnungen bei verzögerten/fehlenden Ladungen ⭐⭐⭐⭐ 📊 | ETL-Pipelines, SLA-Überwachung, nächtliche/periodische Ladungen | Prädiktive Lieferschätzungen; SLA-Nachweise; proaktive Warnungen 💡 |
Schema-Änderungserkennung und -Tracking | Niedrig–Mittel; Integration mit Quellen & Versionierung 🔄🔄 | Zugriff auf Schema-Metadaten und Speicher; geringes Compute ⚡ | Sofortige Erkennung struktureller Änderungen; Unterstützung der Governance ⭐⭐⭐ 📊 | Analytics Engineering, Anbieter-Feeds, nachgelagerte Modelle | Verhindert stille Fehler; Schema-Versionshistorie für Audits 💡 |
Business-KPI-Überwachung und Verhaltensanalyse | Mittel; KPI-Definition + Baseline-Lernen 🔄🔄 | Geschäftliche Zusammenarbeit + historische KPI-Daten; moderates Compute ⚡⚡ | Erkennt geschäftsrelevante Verschiebungen; teamübergreifende Sichtbarkeit ⭐⭐⭐⭐ 📊 | Umsatz, AOV, Churn, operative KPIs; Abstimmung zwischen Business und Tech | Verbindet Datenqualität mit Geschäftsergebnissen; priorisiert Vorfälle 💡 |
Datenplattform-Observability und Überwachung operativer Metriken | Hoch; systemübergreifende Instrumentierung & Korrelation 🔄🔄🔄 | Hohe Telemetrie-, Speicher- und Analyseressourcen ⚡⚡⚡ | Ganzheitlicher Blick auf die Plattformgesundheit; Leistungs- & Kostenanalysen ⭐⭐⭐ 📊 | Platform Engineering, Kapazitätsplanung, Kostenoptimierung | Identifiziert Leistungsabfall und Optimierungspotenziale 💡 |
Datenbankinterne Berechnung und Analyse von Qualitätsmetriken | Mittel; In-DB-Bereitstellung & DBA-Koordination 🔄🔄 | DB-Compute-Ressourcen, Administratorrechte; Zeitplanung erforderlich ⚡⚡ | Wahrt Datenresidenz; schnellere, umfangreiche Prüfungen ohne Verschiebung ⭐⭐⭐⭐ 📊 | Sensible/regulierte Umgebungen; sehr große Datensätze | Wahrt Residenz und Sicherheit; reduziert Netzwerk- und Infrastrukturkosten 💡 |
Historische Trendanalyse und statistische Mustererkennung | Mittel; fortgeschrittene Analyse & Interpretation 🔄🔄 | Erfordert Wochen bis Monate an Historie und Analyse-Compute ⚡⚡⚡ | Deckt allmähliche Verschlechterung und zyklische Muster auf; strategische Erkenntnisse ⭐⭐⭐⭐ 📊 | Langfristige Überwachung, Governance-Berichterstattung, Kapazitätsplanung | Erkennt schleichende Probleme; unterscheidet Zyklen von echten Anomalien 💡 |
Beispiele in einen vielschichtigen Kontrollplan verwandeln
Die acht Beispiele adressieren unterschiedliche Fehlersignale, weshalb das Ersetzen durch einen einzigen universellen Score wichtige operative Unterschiede verbergen würde. Data Validation behandelt explizite Record-Logik, genehmigte Werte, Beziehungen und Audit-Anforderungen. Timeliness-Überwachung behandelt Lieferrisiken, fehlende Ladungen und Frische. Anomalieerkennung findet unerwartetes Verhalten, das niemand zuvor vollständig beschrieben hat.
Schema-Tracking schützt nachgelagerte Konsumenten vor strukturellem Drift. KPI-Überwachung übersetzt Datenverhalten in geschäftliche Auswirkungen. Plattform-Observability identifiziert Workload-, Leistungs-, Verfügbarkeits- und Verbrauchskonditionen, die eine zuverlässige Bereitstellung unterbrechen können. Datenbankinterne Ausführung steuert, wo Qualitätsanalysen ausgeführt werden, während die historische Analyse allmähliche Veränderungen aufzeigt, die punktuelle Prüfungen übersehen.
Die Belege sprechen dafür, diese als operative Kontrollen und nicht als dekorative Dashboard-Features zu behandeln. Datenteams meldeten 67 monatliche Vorfälle im Jahr 2023, und 68 % gaben an, dass die Erkennung mindestens vier Stunden dauerte (Belege der Umfrage 2023). Diese Kombination macht die Gestaltung von Zuständigkeiten und Reaktionen ebenso wichtig wie das Schreiben der Prüfung selbst.
Ein praktischer Rollout kann folgendem Ablauf folgen:
Kritische Datensätze priorisieren: Beginnen Sie mit Daten, die die regulatorische Berichterstattung, Patientenabläufe, Finanzentscheidungen, Kundentransaktionen oder hochwertige KI- und Analyse-Workflows stützen.
Die passendste Kontrolle wählen: Nutzen Sie eine Business-Regel für eine bekannte Record-Bedingung, Timeliness-Überwachung für Lieferrisiken, Schema-Tracking für strukturelle Änderungen oder Anomalieerkennung für Verhalten, das manuell schwer zu spezifizieren ist.
Die Baseline oder Regel etablieren: Definieren Sie die erwartete Lieferung, genehmigte Werte, strukturelle Erwartungen, das Verhalten geschäftlicher KPIs oder die historische Leistung.
Warnungen an die Verantwortlichen weiterleiten: Senden Sie eine fehlgeschlagene Validierung an den Datenverwalter, der die Quelle korrigieren kann, eine verspätete Ladung an den Pipeline-Verantwortlichen und eine KPI-Anomalie sowohl an geschäftliche als auch an technische Stakeholder.
Die Behebung dokumentieren: Halten Sie fest, was sich geändert hat, warum es sich geändert hat, wer es behoben hat und ob die Kontrolle angepasst werden muss.
Trends überprüfen: Untersuchen Sie wiederkehrende Fehler, das Rauschen von Warnmeldungen, die Behebungszeit und sich änderndes Datenverhalten, damit sich der Kontrollplan verbessert, anstatt blind erweitert zu werden.
Dieser vielschichtige Ansatz adressiert auch ein modernes Problem der Tragweite. Organisationen erforschen Kontrollen über strukturierte Tabellen hinaus, einschließlich semistrukturierter Daten und unstrukturierter Dokumente, sodass Qualitätsprogramme zunehmend JSON, Protokolle, Text, Bilder und Modelleingaben berücksichtigen müssen (Observability-Trends für KI). Deterministische Data Validation bleibt essenziell, funktioniert aber besser an der Seite von Anomalie- und Timeliness-Überwachung, wenn sich Pipelines kontinuierlich verändern.
digna ist eine relevante modulare Option zur Kombination dieser Kontrollen in Finanz-, Gesundheits-, Telekommunikations- und öffentlichen Umgebungen. Seine Plattform kann Verhalten überwachen, Datensätze validieren, Eingangsmuster verfolgen, Schemaänderungen erkennen, historische Metriken analysieren und Prüfungen innerhalb der Infrastruktur des Kunden ausführen. Die beste Bereitstellung beginnt dennoch mit einer definierten Fehlerart, einem verantwortlichen Owner und einer messbaren operativen Folge.
digna bietet datenbankinterne Validierung, Anomalieerkennung, Timeliness-Überwachung, Schema-Tracking, Business-Monitoring, Plattform-Observability und historische Analysen in einer modularen Plattform. Besuchen Sie digna, um zu evaluieren, wie diese Kontrollen die Zuverlässigkeit Ihrer kritischen Datenpipelines verbessern können, ohne dass Produktionsdaten außerhalb Ihrer Umgebung verschoben werden müssen.
Häufig gestellte Fragen
Wie sieht ein vollständiger Satz von Datenqualitätskontrollen aus?
Acht Kontrollen für unterschiedliche Fehlermodi, von KI-gestützter Anomalieerkennung mit Baseline-Learning und Validierung auf Satzebene gegen Geschäftsregeln über Timeliness-Monitoring und Schema-Tracking bis zu den Governance-Nachweisen, die regulierte Bereiche brauchen. Verlässliche Daten entstehen nicht aus einer einzigen Validierungsregel.
Wann ersetzt Anomalieerkennung einen festen Schwellenwert?
Wenn das Fehlersignal eine Abweichung ist und kein Regelverstoß. Ein fester Schwellenwert meldet eine Transaktionszahl über einer willkürlichen Grenze, erzeugt aber Rauschen bei saisonaler Nachfrage, Kampagnen oder normalem Wachstum. Gelernte Baselines erfassen zudem kollektive Anomalien, bei denen mehrere für sich plausible Kennzahlen gemeinsam auffällig werden.
Was macht eine Validierungsregel auf Satzebene nützlich?
Erklärbarkeit. Eine verlässliche Kontrolle meldet nicht nur, dass eine Zeile durchgefallen ist, sondern benennt die fachliche Bedingung, den betroffenen Datensatz, die Regelversion und die für die Behebung verantwortliche Person. Versionierte Regeln bewahren Definition und Gültigkeitsdatum, genau das braucht eine Audit-Historie.
Ab wann sind Daten zu alt?
Eine praktikable Regel stuft Datensätze älter als 12 Monate als wahrscheinlich veraltet ein und behandelt mehr als 30 % einer Datenbank in dieser Kategorie als Timeliness-Problem. Dieselbe Leitlinie merkt an, dass oft eine Aktualisierungsrate von 90 Tagen nötig ist.
Was kostet mangelhafte Datenqualität, und wie oft tritt sie auf?
Gartner-Forschung wird üblicherweise mit durchschnittlich 12,9 Millionen USD pro Organisation und Jahr zitiert, wobei Ungenauigkeit als häufigster Treiber 68 % der Befragten betrifft. Zur Häufigkeit: Datenteams meldeten 2023 monatlich 67 Datenvorfälle, nach 59 im Jahr 2022.


