Data Quality Observability: Ein Praxisleitfaden für Datenteams
|
8
min. Lesezeit

Sie kennen das Gefühl. Um 6:45 Uhr sieht ein Dashboard noch einwandfrei aus, um 8:00 Uhr stimmen die Zahlen nicht mehr, der VP will wissen, warum sich der Umsatz über Nacht verändert hat, und das Datenteam wühlt sich durch Pipeline-Logs, während alle anderen auf eine Antwort warten. Das ist Data Downtime, und sie ist einer der schnellsten Wege, aus einer vertrauenswürdigen Reporting-Schicht ein Risiko zu machen.
Data Quality Observability ändert diese Haltung. Statt auf kaputte Dashboards zu warten, beobachtet sie das Verhalten der Daten auf ihrem Weg durch die Systeme. So erkennen Teams verspätete Lieferungen, Schema Drift, Volumenverschiebungen und Validierungsfehler, bevor sie sich auf Entscheidungen auswirken. Es geht nicht um mehr Alerts. Es geht um frühere Signale, saubereres Triage und weniger Zeit, die man damit verbringt zu erklären, warum man den Zahlen nicht trauen kann.
Inhaltsverzeichnis
Die versteckten Kosten fehlerhafter Daten
Ein Vorfall am Montagmorgen beginnt selten dramatisch. Er beginnt mit einer veralteten Tabelle, einem fehlenden Load oder einer stillen Schemaänderung, die niemand rechtzeitig bemerkt hat. Bis das Problem sichtbar wird, hat sich der Schaden längst vom Data Warehouse ins Business verlagert.
Das Ausmaß dieses Problems wird leicht unterschätzt. Eine 2023 von Monte Carlo beauftragte Umfrage von Wakefield Research ergab, dass die monatlichen Datenvorfälle von 59 im Jahr 2022 auf 67 im Jahr 2023 gestiegen sind, ein 1,89-facher Anstieg der Data Downtime, und dass 68% der Befragten vier Stunden oder länger brauchten, um Vorfälle zu erkennen. Dieselbe Umfrage nannte eine durchschnittliche Behebungszeit von 15 Stunden pro Vorfall, und mehr als die Hälfte der Befragten gab an, dass mindestens 25% des Umsatzes von Datenqualitätsproblemen betroffen waren, wobei der durchschnittlich betroffene Umsatzanteil von 26% im Vorjahr auf 31% stieg. All das ist in einer Marktübersicht der Kategorie dokumentiert, im Marktbericht zu Data Observability.
Wie das in der Praxis aussieht
Eine Finanzanalystin aktualisiert eine Präsentation für den Vorstand und bemerkt eine Zahl, die nicht zum gestrigen Export passt. Ein Data Engineer prüft die Orchestrierungs-Logs und sieht, dass die Pipeline erfolgreich durchgelaufen ist. Das ist schlechter, nicht besser, denn das Problem steckt jetzt im Inhalt und nicht im Job-Status. Das Team vergleicht Zeilenanzahlen, sucht nach Schemaänderungen und schreibt Verantwortliche an, die womöglich gar nicht wissen, dass sie den Fehler verursacht haben.
Faustregel: Wenn das erste Anzeichen eines Problems die Frage eines Fachanwenders ist, sitzt die Monitoring-Schicht bereits zu weit downstream.
Genau deshalb ist Observability wichtig. Sie ersetzt keine Ursachenanalyse und macht Daten nicht auf magische Weise korrekt. Sie warnt früher, sodass das Team aufhören kann, jeden Vorfall als Überraschung zu behandeln, und ihn stattdessen als beherrschbares operatives Risiko angehen kann.

Die stärksten Teams, mit denen ich gearbeitet habe, haben aufgehört zu fragen: „Warum ist dieses Dashboard kaputtgegangen?“ und angefangen zu fragen: „Was hat sich geändert, bevor das Dashboard kaputtging?“ Dieser Perspektivwechsel ist der entscheidende Punkt. Data Quality Observability gibt Ihnen die Möglichkeit, diese Frage zu beantworten, bevor das Business den Preis dafür zahlt.
Data Quality Observability verstehen
Ein Dashboard kann gesund aussehen, während die Pipeline dahinter abdriftet. Eine Quelltabelle wird vielleicht noch pünktlich geladen, doch darunter ändert sich das Schema, eine Transformation beginnt Werte umzuformen, und die nachgelagerten Reports bleiben falsch, bis jemand die Abweichung bemerkt. Data Quality Observability konzentriert sich auf genau diese Systemsignale, nicht nur auf das Endergebnis auf Zeilenebene.
Von Regeln zu Signalen
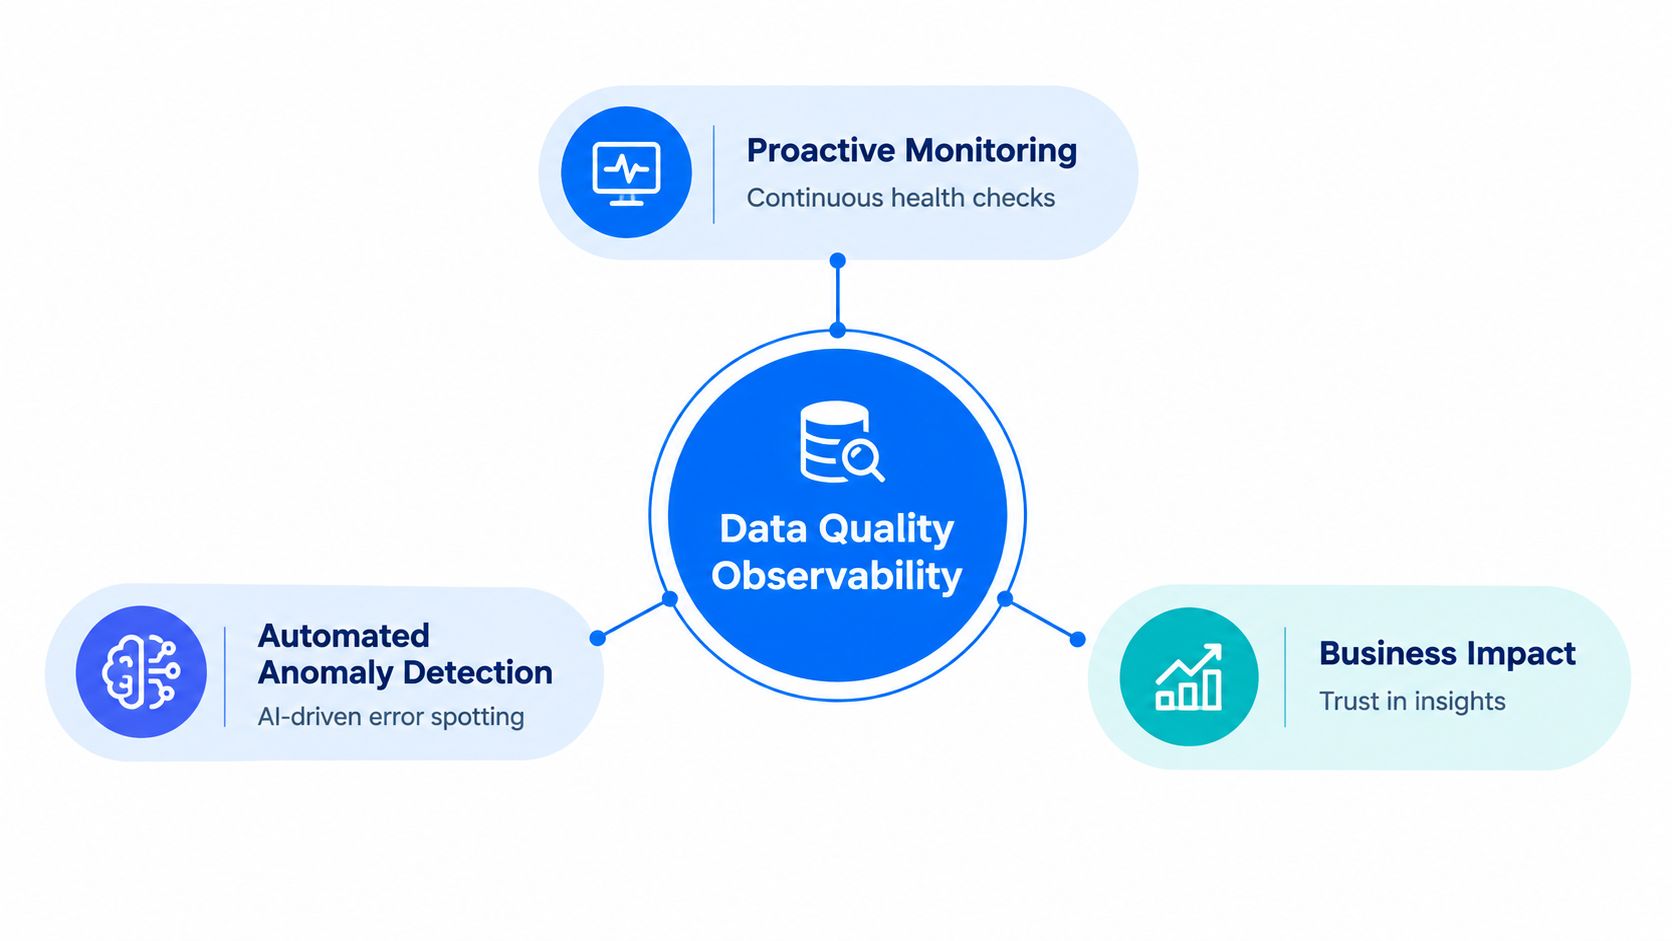
Regelbasierte Prüfungen bleiben wichtig. Sie sind präzise, auditierbar und nützlich, wenn Geschäftslogik auf Datensatzebene durchgesetzt werden muss. Sie übersehen aber auch vieles, weil sie nur erkennen, womit man ohnehin schon gerechnet hat. Observability betrachtet externe Signale wie Freshness, Volumen, Schema, Verteilung und Lineage und zeigt anhand dieser Muster, ob sich die Pipeline normal verhält, wie es praxisnahe Observability-Leitfäden definieren.
Dieser Wandel zählt vor allem dann, wenn Schema Drift ins Spiel kommt. Fügt eine Quelle eine Spalte hinzu, entfernt sie, benennt sie um oder ändert ihren Typ, kann eine fragile Transformation ohne Vorwarnung scheitern oder fehlerhafte Werte in nachgelagerte Analysen schicken, bevor es jemand merkt, Schema Drift ist ein zentrales Observability-Signal. Observability erkennt die strukturelle Änderung selbst, statt darauf zu warten, dass das fehlerhafte Ergebnis auftaucht.
Die Kehrseite ist Alert Fatigue. Statische Regeln können eine lange Kette wenig wertvoller Alerts erzeugen, besonders wenn Datenänderungen für das Business ganz normal sind. Verhaltensbasiertes Monitoring reduziert dieses Rauschen, indem es fragt, ob sich ein Muster auf bedeutsame Weise verändert hat. Das passt besser zu modernen Pipelines und zur Art, wie Teams Vorfälle untersuchen.
Observability ist am stärksten, wenn sie beobachtet, wie sich Daten verhalten, und nicht nur, ob eine Zeile eine Regel besteht.
Was Sie zuerst überwachen sollten
Beginnen Sie mit den Signalen, die Ihnen zeigen, ob die Pipeline lebt und konsistent ist.
Freshness: Verspätete Daten sind oft das erste Anzeichen einer blockierten oder beeinträchtigten Pipeline.
Volumen: Plötzliche Spitzen oder Einbrüche können auf Ingestion-Probleme, Duplikate oder unvollständige Loads hinweisen.
Schema: Unerwartete Feldänderungen sind oft der schnellste Weg zu kaputten Transformationen.
Verteilung: Verschiebungen in Wertemustern können stille Datenkorruption aufdecken, die auf Tabellenebene noch gültig aussieht.
Lineage: Wer weiß, woher Daten kommen und wohin sie fließen, kann Auswirkungen nachverfolgen, statt zu raten.
Das praktische Ziel ist einfach. Datenqualitätsprüfungen sagen Ihnen, ob ein Datensatz akzeptabel ist, Observability sagt Ihnen, ob sich der gesamte Datenfluss so verhält, dass Sie ihm vertrauen können. Eine ausführlichere Darstellung, wie verhaltensbasierte Signale statische Regeln ersetzen, finden Sie im Überblick zu Data Observability.
Zentrale Signale für die Überwachung der Datengesundheit
Monitoring funktioniert am besten, wenn jedes Signal einem Fehlermuster und einer geschäftlichen Konsequenz zugeordnet ist. Klassische regelbasierte Prüfungen bleiben nützlich, behandeln aber oft jede Abweichung als gleich dringend. KI-gestützte Observability ergänzt verhaltensbasierte Baselines und hilft Teams, erwartbare Schwankungen von Mustern zu unterscheiden, die die Datenverfügbarkeit, das nachgelagerte Reporting oder operative Entscheidungen gefährden. Das Ziel sind weniger wertlose Alerts und eine schnellere Reaktion auf Data Downtime.
Freshness, Volumen, Schema und Validierung greifen ineinander
Timeliness ist oft die früheste Warnung, dass eine Pipeline stockt oder an Leistung verliert. Moderne Implementierungen lernen den Lieferrhythmus eines Datensatzes, berechnen, wann der nächste Load eintreffen sollte, und schlagen Alarm, wenn er verspätet ist oder ausbleibt, wie es in Leitfäden zum operativen Monitoring beschrieben wird. Timeliness-Logik kann auch Lieferungen erkennen, die früher als erwartet eintreffen. Das ist relevant, wenn eine Quelle von ihrem üblichen Rhythmus abweicht, dieses rhythmusbasierte Muster wird auch in Plattform-Leitfäden behandelt.
Anomalieerkennung gibt einem einfachen Schwellenwert Kontext. Eine Spitze in einer Tabelle mit Kundenaktivitäten kann auf eine legitime Kampagne zurückgehen oder auf einen duplizierten Feed, der Datensätze erneut einspielt. Ein Verhaltensmodell kann die geschäftliche Erklärung nicht allein ermitteln, aber es kann eine bedeutsame Veränderung melden, bevor sich Analysten auf die betroffenen Daten verlassen.
Schema-Tracking begrenzt strukturelle Fehler in nachgelagerten Systemen. Ein Finanz-Feed fügt vielleicht ein nullable Feld hinzu, oder ein Extrakt aus dem Gesundheitswesen ändert eine Typdefinition, ohne dass an der Quelle ein offensichtliches Problem sichtbar wird. Der Fehler zeigt sich womöglich erst später in einer Transformation, einem Modell oder einem Dashboard, wo die Diagnose mehr Zeit kostet.
Validierung verbindet Observability mit Geschäftsregeln. Prüfungen auf Zeilenebene vergleichen Werte mit erwarteten Formaten, Längen und Qualitätsmetriken. Sie unterstützen Compliance-Arbeit, Audit-Nachweise und die gezielte Prüfung risikoreicher Datensätze. Die Validierung auf Zeilenebene ist in der Fachliteratur zur Verifikation beschrieben.
Ein Leitfaden zu Data-Observability-Metriken hilft dabei, jede Metrik dem Fehlermuster zuzuordnen, das sie aufdecken soll.
Signal | Was es erkennt | Was es nicht erkennt |
|---|---|---|
Freshness | Verspätete oder fehlende Loads | Falsche fachliche Bedeutung |
Volumen | Fehlende Daten, Duplikate, erneut eingespielte Feeds | Feingranulare Fehler auf Zeilenebene |
Schema | Hinzugefügte, entfernte, umbenannte oder umtypisierte Felder | Semantische Fehler in gültigen Spalten |
Validierung | Regelverstöße auf Datensatzebene | Unerwartetes Verhalten außerhalb des Regelwerks |
Fokus ist wichtiger als Abdeckung
Die eigentlichen Kosten entstehen nicht bei der Auswahl der Signale. Sie entstehen, wenn man sie wahllos auf große Datenlandschaften, mehrere Stacks und viele Tabellen anwendet. Breitere Abdeckung erhöht den Aufwand für Rechenleistung, Metadaten und Alerting, eine praktische Warnung, die Databricks hervorhebt. Zu viele Alerts führen zudem zu operativer Ermüdung. Sobald Engineers den Benachrichtigungen nicht mehr trauen, kann ein echter Datenausfall hinter routinemäßigen Schwankungen untergehen.
Priorisieren Sie Pipelines, deren Ausfall Umsatz, Reporting, Compliance oder den Kundenbetrieb beeinträchtigen würde. KI-gestützte Erkennung kann sich wiederholende Schwellenwert-Alerts reduzieren, während explizite Validierung für bekannte Regeln weiterhin angemessen ist. Zusammen eingesetzt sorgen diese Ansätze für einen ruhigeren Alert-Strom mit klarerer Verantwortung und schnellerer Reaktion auf Vorfälle.
Architekturmuster für Observability
Die meisten Observability-Fehlschläge gehen auf Architekturentscheidungen zurück, nicht auf das Monitoring-Signal selbst. Teams verschieben entweder zu viele Daten in ein separates Tool, oder sie bauen Prüfungen nachträglich an und hoffen, dass Latenz und Sicherheitsabwägungen keine Rolle spielen. In der Praxis muss die Architektur respektieren, wo die Daten bereits liegen.
Prüfungen nah an den Daten halten
Das stärkste Muster ist die In-Database-Ausführung. Die Monitoring-Logik läuft im Data Warehouse oder Data Lake selbst, die Daten bleiben, wo sie sind, und das Team vermeidet unnötige Bewegungen zwischen Systemen. Das ist sowohl für die Sicherheit als auch für die Performance wichtig, besonders wenn die Plattform bereits sensible Datensätze oder hohe Lasten verarbeitet.
Genau hier zahlt sich Modularität aus. Ein monolithischer Observability-Stack ist oft schwer einzuführen, weil er Teams zu einem breiten Rollout zwingt, bevor sie einen Nutzen nachgewiesen haben. Mit einem modularen Setup beginnen Sie mit einem Problem, etwa Schema Drift oder Pünktlichkeit, und erweitern auf Validierung oder Business-Monitoring, sobald das erste Signal funktioniert.
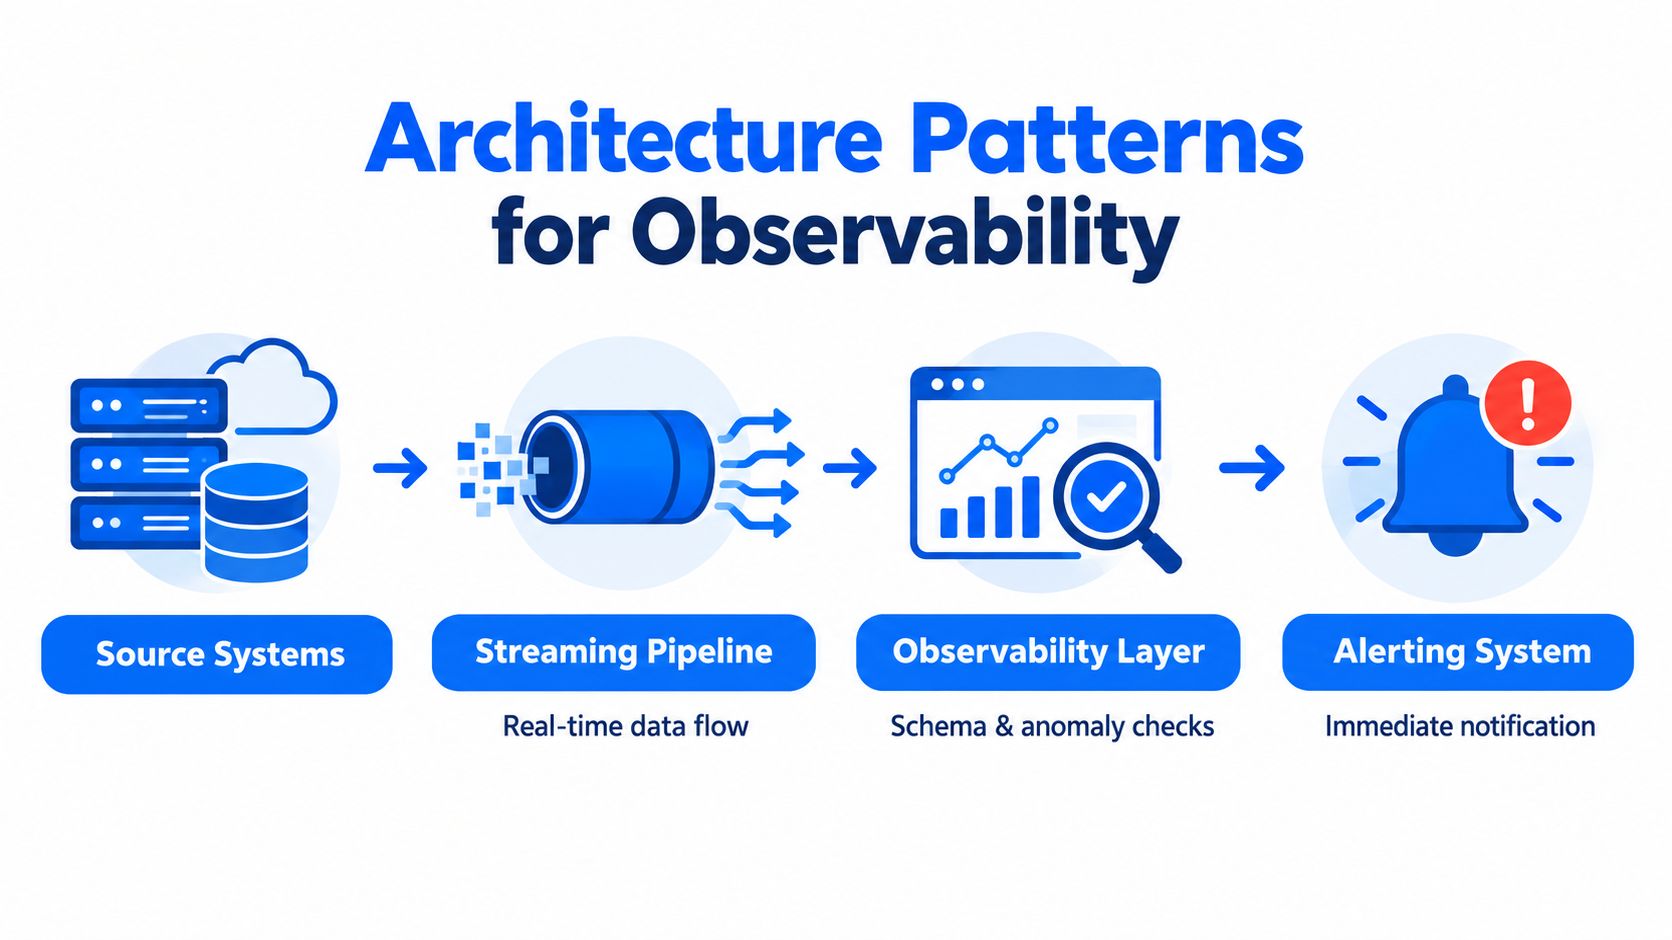
Eine saubere Architektur folgt meist dieser Abfolge:
Quellsysteme liefern operative oder analytische Daten.
Streaming- oder Batch-Pipelines bringen die Daten in die verwaltete Umgebung.
Eine Observability-Schicht wertet Freshness-, Schema- und Anomaliesignale dort aus, wo die Daten bereits liegen.
Ein Alerting-System leitet nur relevante Vorfälle an die zuständige Person weiter.
Warum sich modulare Plattformen leichter in den Betrieb bringen lassen
Eine modulare Plattform hält den Blast Radius klein, wenn Sie Observability in einen ausgereiften Stack einführen. Sie können sie zuerst auf die wichtigsten Tabellen richten und dann erweitern, sobald das Team der Signalqualität vertraut. Das erleichtert auch den Rollout für Data-Engineering-Teams, weil sich die Monitoring-Logik gemeinsam mit den Pipelines weiterentwickelt, statt ein separates Betriebsmodell zu erzwingen.
Der Leitfaden zur Observability-Architektur von digna passt gut zu diesem modularen Muster, besonders für Teams, die das Monitoring nah am Data Warehouse oder Data Lake halten möchten, statt eine abgekoppelte Schicht aufzubauen, deren Betrieb teuer ist.
Es geht nicht um Architektur um ihrer selbst willen. Es geht darum, Reibung zu reduzieren, Datenbewegungen zu verringern und sicherzustellen, dass die Monitoring-Schicht nicht selbst zu einer weiteren Quelle operativen Rauschens wird.
Die Rolle von Observability in Analytics und KI
Analytics und KI scheitern beide schnell, wenn die Eingangsdaten abdriften. Ein Dashboard kann falsch sein, weil ein Feed zu spät kommt. Ein Modell kann unzuverlässig werden, weil sich Feature-Werte verschieben. In beiden Fällen bleibt das Problem oft unsichtbar, bis das Business die Auswirkungen spürt.
Warum KI die Messlatte höher legt
Eine Quelle aus dem Jahr 2025 zur Lücke zwischen Markt und Adoption stellte fest, dass 48% der Befragten niedrige Datenqualität als größtes Hindernis für KI-Readiness nannten. Eine weitere Umfrage ergab, dass 74% der Organisationen die Überwachung kritischer Geschäftsprozesse für wichtig halten und 54% sagen, dass die Qualität der Alert-Erkennung den ROI von Observability am stärksten beeinflusst, wie in der Analyse der Marktteilnehmer zusammengefasst. Das sind keine abstrakten Zahlen. Sie zeigen, dass Teams Observability nicht mehr als Nischenthema des Engineerings betrachten, sondern als Voraussetzung für KI und das Reporting an die Geschäftsleitung.
Das ist wichtig, weil KI-Pipelines nicht nur von sauberen Datensätzen abhängen. Sie brauchen stabile Inputs, vorhersehbares Feature-Verhalten und vertrauenswürdige nachgelagerte Signale. Ändern die Daten, die das Modell speisen, ihre Form, liefert das Modell vielleicht weiterhin ein Ergebnis, doch dieses Ergebnis kann an Nutzen verlieren, ohne dass ein offensichtliches Fehlersignal erscheint.
Business-Kennzahlen verdienen dieselbe Disziplin
Observability ist inzwischen über das klassische Pipeline-Monitoring hinaus in Richtung Geschäftsprozess-Monitoring gewachsen. Dieser Wandel ist wichtig, denn Führungskräfte interessiert nicht, ob ein Schema-Diff spannend war. Sie interessiert, ob Kundenabwanderung, Auftragsvolumen, Schadenbearbeitung oder andere Business-KPIs den erwarteten Bereich verlassen haben. Wer diese Kennzahlen direkt auf den zugrunde liegenden Daten überwacht, erkennt operative Abweichungen früher, ohne darauf zu warten, dass die Reporting-Schicht sie sichtbar macht.
Der Leitfaden zur KI-Readiness von digna folgt dieser breiteren Sichtweise, denn bei Observability geht es nicht mehr nur um technische Gesundheit. Es geht darum nachzuweisen, dass das Datenfundament Analytics, Automatisierung und KI tragen kann, ohne blinde Flecken zu erzeugen.
Wenn Teams das richtig machen, fragen sie nicht mehr, ob das Dashboard läuft. Sie fragen, ob die Signale hinter dem Dashboard noch Vertrauen verdienen.
Modulare Plattformen und Beispiele aus der Praxis
Der Vorteil modularer Observability liegt darin, dass Teams ein konkretes Zuverlässigkeitsproblem lösen können, ohne gleich ein komplett neues Betriebsmodell einzukaufen. Das ist in Unternehmensumgebungen entscheidend, in denen Teams aus Finanzwesen, Gesundheitswesen, Telekommunikation und öffentlichem Sektor mit unterschiedlichen Fehlermustern und unterschiedlicher Toleranz gegenüber Rauschen zu tun haben.
Wo modulare Observability passt
Ein Team im Finanzdienstleistungsbereich achtet in der Regel auf Timing, Transaktionsintegrität und nachgelagertes Reporting. Kommt ein regulatorischer Feed zu spät, ist das nicht nur ein operatives Problem. Es beeinträchtigt das Vertrauen in das Reporting und kann zu verpassten Fristen führen. Eine modulare Plattform kann sich zunächst auf Pünktlichkeit und Anomalieerkennung für die kritischen Feeds konzentrieren und dann Schema-Tracking und Validierung dort ergänzen, wo Geschäftsregeln am meisten zählen.
Ein Team im Gesundheitswesen hat andere Rahmenbedingungen. Klinische und operative Datensätze brauchen oft Validierung, strukturelle Stabilität und Nachvollziehbarkeit über Quellsysteme hinweg. Schemaänderungen in einer EHR-Pipeline können genauso störend sein wie eine verspätete Lieferung, weil sie nachgelagerte Analysen oder Reporting-Workflows lahmlegen können, selbst wenn das Quellsystem scheinbar einwandfrei läuft.
Warum eine Plattform trotzdem fokussiert bleiben kann
digna ist eine Option in dieser Kategorie. Das modulare Setup vereint KI-gestützte Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking und Validierung auf Datensatzebene in der eigenen Umgebung des Kunden. Dieses Modell ist hilfreich, wenn Teams ihre Daten an Ort und Stelle belassen und Observability ergänzen möchten, ohne Produktionsdaten in einen separaten externen Dienst zu ziehen.
Die Use-Case-Seite von digna eignet sich gut für Teams, die vergleichen möchten, wie diese Module zu unterschiedlichen operativen Anforderungen passen. Entscheidend ist aber nicht die Marke, sondern das Designprinzip: Beginnen Sie mit den Signalen, die zu Ihren risikoreichsten Pipelines passen, und erweitern Sie nur dort, wo das Monitoring mehr Vertrauen schafft als Aufwand erzeugt.
Wenn eine Plattform nicht erklären kann, warum ein Alert für das Business relevant ist, ist sie noch nicht fertig.
Dieses Prinzip gilt branchenübergreifend. Der beste Observability-Rollout ist meist derjenige, der klein anfängt, seinen Nutzen beweist und dann nur dort wächst, wo das Team das Signal sauber halten kann.
Verbreitete Missverständnisse auf dem Prüfstand
Das größte Missverständnis ist, dass Observability nur eine schönere Methode sei, fehlerhafte Datensätze zu finden. Das stimmt nicht. Die Qualität einzelner Datensätze bleibt wichtig, doch das schwierigere Problem ist die Entscheidung, was Aufmerksamkeit verdient, denn jede zusätzlich überwachte Tabelle erhöht Kosten, Metadaten und Alerting-Aufwand.
Mehr Monitoring bedeutet nicht automatisch mehr Vertrauen
Ein lauter Alert-Strom kann das Vertrauen schneller untergraben als gar kein Monitoring. Wenn jede kleine Abweichung einen Alarm auslöst, ignorieren Engineers Warnungen irgendwann, und das System verliert an Glaubwürdigkeit. Deshalb ist die Steuerung des Umfangs so wichtig, besonders in großen Datenlandschaften, in denen es teuer und ablenkend ist, alles gleichermaßen zu überwachen.
Ein weiterer häufiger Fehler ist die Annahme, Observability sei nur etwas für Großunternehmen. Auch kleinere Teams profitieren, allerdings nur, wenn sie sich auf die Pipelines konzentrieren, die am wichtigsten sind. Überwacht ein dreiköpfiges Datenteam jede unwichtige Tabelle im Data Warehouse, geht es in Arbeit unter, die es nicht braucht.
Observability dort einsetzen, wo das Business den Schmerz spürt
Die praktische Regel ist einfach. Überwachen Sie zuerst die Assets, bei denen Verzögerung, Drift oder Ausfall das Reporting, das Kundenerlebnis, die Compliance oder die Modellqualität beeinträchtigen würden. Sobald diese stabil sind, erweitern Sie mit derselben Disziplin auf angrenzende Datensätze.
Gute Observability reduziert Unsicherheit. Schlechte Observability erzeugt nur eine polierte Version von Alert Fatigue.
Das ist der zentrale Zielkonflikt. Mehr Erkennung ist nur dann nützlich, wenn das Team darauf reagieren kann, und zwar schnell genug, damit es einen Unterschied macht. Andernfalls wird die Monitoring-Schicht zu einer weiteren Quelle von Reibung.
Ihre Data-Observability-Strategie aufbauen
Eine tragfähige Strategie beginnt mit den Pipelines, deren Ausfall am meisten schaden würde. Das klingt selbstverständlich, doch viele Teams beginnen immer noch mit dem am einfachsten zu instrumentierenden Datensatz statt mit dem wichtigsten. Das Ergebnis ist ein sauberes Dashboard für eine risikoarme Tabelle und kein echter Schutz dort, wo das Business tatsächlich exponiert ist.
Mit kritischen Pfaden beginnen, nicht mit breiter Abdeckung
Identifizieren Sie die Tabellen, Feeds und nachgelagerten Reports, die Finanzen, Betrieb, Kundenerlebnis oder KI-Workloads antreiben. Legen Sie dann fest, welche Signale für jeden davon am wichtigsten sind. In einer Pipeline ist ein verspäteter Load das Kernproblem, in einer anderen zählen Schemaänderungen oder Verteilungsverschiebungen mehr.
Nutzen Sie Observability anschließend, um das manuelle Erstellen von Regeln zu reduzieren. Das heißt nicht, auf Validierung zu verzichten. Es heißt, tiefgehende Prüfungen auf Datensatzebene für die Assets zu reservieren, bei denen fachliche Korrektheit am meisten zählt, und den Rest der Datenlandschaft dem verhaltensbasierten Monitoring zu überlassen. Diese Balance hält das System praxistauglich.
Auf Handeln ausrichten, nicht nur auf Erkennen
Alerting sollte zu Verantwortlichkeit, Triage und Lösung führen. Kann die Plattform einen Vorfall nicht an das Team weiterleiten, dem die Daten gehören, wird aus dem Signal kein Fix. Zeigt der Alert nicht die voraussichtlichen Auswirkungen auf nachgelagerte Systeme, verbringen Engineers zu viel Zeit damit, den Blast Radius von Hand zu rekonstruieren.
Sie erzielen bessere Ergebnisse, wenn Sie früh diese drei Entscheidungen treffen:
Zuerst Pipelines mit hoher Wirkung wählen: Überwachen Sie die Daten, deren Ausfall Geschäftsentscheidungen verändern würde.
Signal von Rauschen trennen: Stimmen Sie Alerts so ab, dass das Team bedeutsame Abweichungen sieht und nicht jede kleine Schwankung.
Das Betriebsmodell einfach halten: Setzen Sie auf modulare Funktionen, damit Observability mit dem Stack wächst, statt ihn zu überfordern.
Das langfristige Ziel ist Vertrauen, nicht Tooling. Wenn Monitoring Teil der Art wird, wie das Team zuverlässige Daten ausliefert, arbeiten Analytics-Teams schneller, Fachanwender stellen weniger misstrauische Fragen, und das Data Engineering verbringt seine Woche nicht mehr damit, vermeidbare Vorfälle aufzuräumen.
Wenn Sie Ihre Strategie für Data Quality Observability schärfen möchten: digna bietet Teams modulare Anomalieerkennung, Timeliness-Prüfungen, Schema-Tracking und Validierung in ihrer eigenen Umgebung. Besuchen Sie digna und sehen Sie, wie dieser Ansatz zuverlässige Analytics und KI unterstützt, ohne unnötige Datenbewegungen oder operatives Rauschen zu erzeugen.
Wenn Sie sehen möchten, wie dieser modulare In-Database-Ansatz über eine ganze Plattform hinweg aussieht, von Freshness und Schemaänderungen bis zu Anomalien und Validierung, zeigt unsere Seite zur Data Platform Observability, wie digna diese Signale überwacht, ohne Daten aus Ihrer Umgebung zu bewegen.
Häufig gestellte Fragen
Was ist Data Quality Observability?
Data Quality Observability beobachtet, wie sich Daten auf ihrem Weg durch Pipelines verhalten, und nutzt dafür Signale wie Freshness, Volumen, Schema, Verteilung und Lineage. Statt auf ein kaputtes Dashboard zu warten, meldet sie verspätete Loads, Schema Drift oder Volumenverschiebungen frühzeitig. So fragen Teams, was sich geändert hat, bevor das Dashboard kaputtging, statt warum es kaputtging.
Wie unterscheidet sich Data Observability von regelbasierten Datenqualitätsprüfungen?
Regelbasierte Prüfungen erkennen nur Probleme, mit denen man bereits gerechnet hat, während Observability normales Verhalten lernt und bedeutsame Veränderungen meldet. Regeln bleiben wertvoll für präzise, auditierbare Logik auf Datensatzebene, übersehen aber unerwartete Fehler und können Teams mit wenig wertvollen Alerts überfluten. Der Beitrag empfiehlt, Validierung für bekannte Regeln beizubehalten und den Rest dem verhaltensbasierten Monitoring zu überlassen.
Welche Data-Observability-Signale sollte ich zuerst überwachen?
Beginnen Sie mit Freshness, Volumen, Schema, Verteilung und Lineage, denn sie zeigen, ob eine Pipeline lebt und konsistent ist. Jedes Signal entspricht einem Fehlermuster: Freshness erkennt verspätete oder fehlende Loads, Volumen erkennt Duplikate und erneut eingespielte Feeds, und Schema erkennt hinzugefügte, entfernte, umbenannte oder umtypisierte Felder. Semantische Fehler erkennt allerdings keines davon allein.
Wie lange dauert es, einen Datenvorfall zu erkennen?
Oft länger, als Teams erwarten: In einer Umfrage von Wakefield Research aus dem Jahr 2023 brauchten 68% der Befragten vier Stunden oder länger, um Datenvorfälle zu erkennen. Die Behebung dauerte im Schnitt 15 Stunden pro Vorfall, und die monatlichen Vorfälle stiegen im Jahresvergleich von 59 auf 67. Deshalb sind frühere Signale wichtiger als schnellere Feuerwehreinsätze.
Sollten Observability-Prüfungen im Data Warehouse laufen?
Ja, die In-Database-Ausführung ist das stärkste Architekturmuster, weil die Monitoring-Logik dort läuft, wo die Daten bereits liegen, statt sie in ein separates Tool zu kopieren. Das verbessert Sicherheit und Performance bei sensiblen oder rechenintensiven Workloads, und mit einem modularen Setup können Teams mit einem einzelnen Problem wie Schema Drift beginnen, bevor sie erweitern.



