Data Quality Assessment: Definition und Praxisleitfaden
|
7
min. Lesezeit

Ein Data Quality Assessment ist ein systematischer Prozess, der die Eignung von Daten für ihren Verwendungszweck über mehrere Dimensionen hinweg misst, darunter Genauigkeit, Vollständigkeit, Aktualität, Konsistenz und Lineage, statt sich auf eine einzelne Genauigkeitsprüfung zu beschränken. Das moderne Verständnis geht auf die Definition „Fitness for Use“ von 1996 zurück und umfasst heute strukturierte Frameworks wie das sechsteilige Bewertungsmodell des IWF.
Der gängige Rat lautet: Daten bereinigen, Nullwerte zählen und weitermachen. Dieser Ansatz scheitert, sobald ein technisch valider Datensatz zu spät eintrifft, widersprüchliche fachliche Definitionen verwendet oder seine Nachvollziehbarkeit verliert, bevor er einen Analytics- oder Machine-Learning-Workload erreicht.
Inhaltsverzeichnis
Die Definition von Data Quality Assessment neu denken
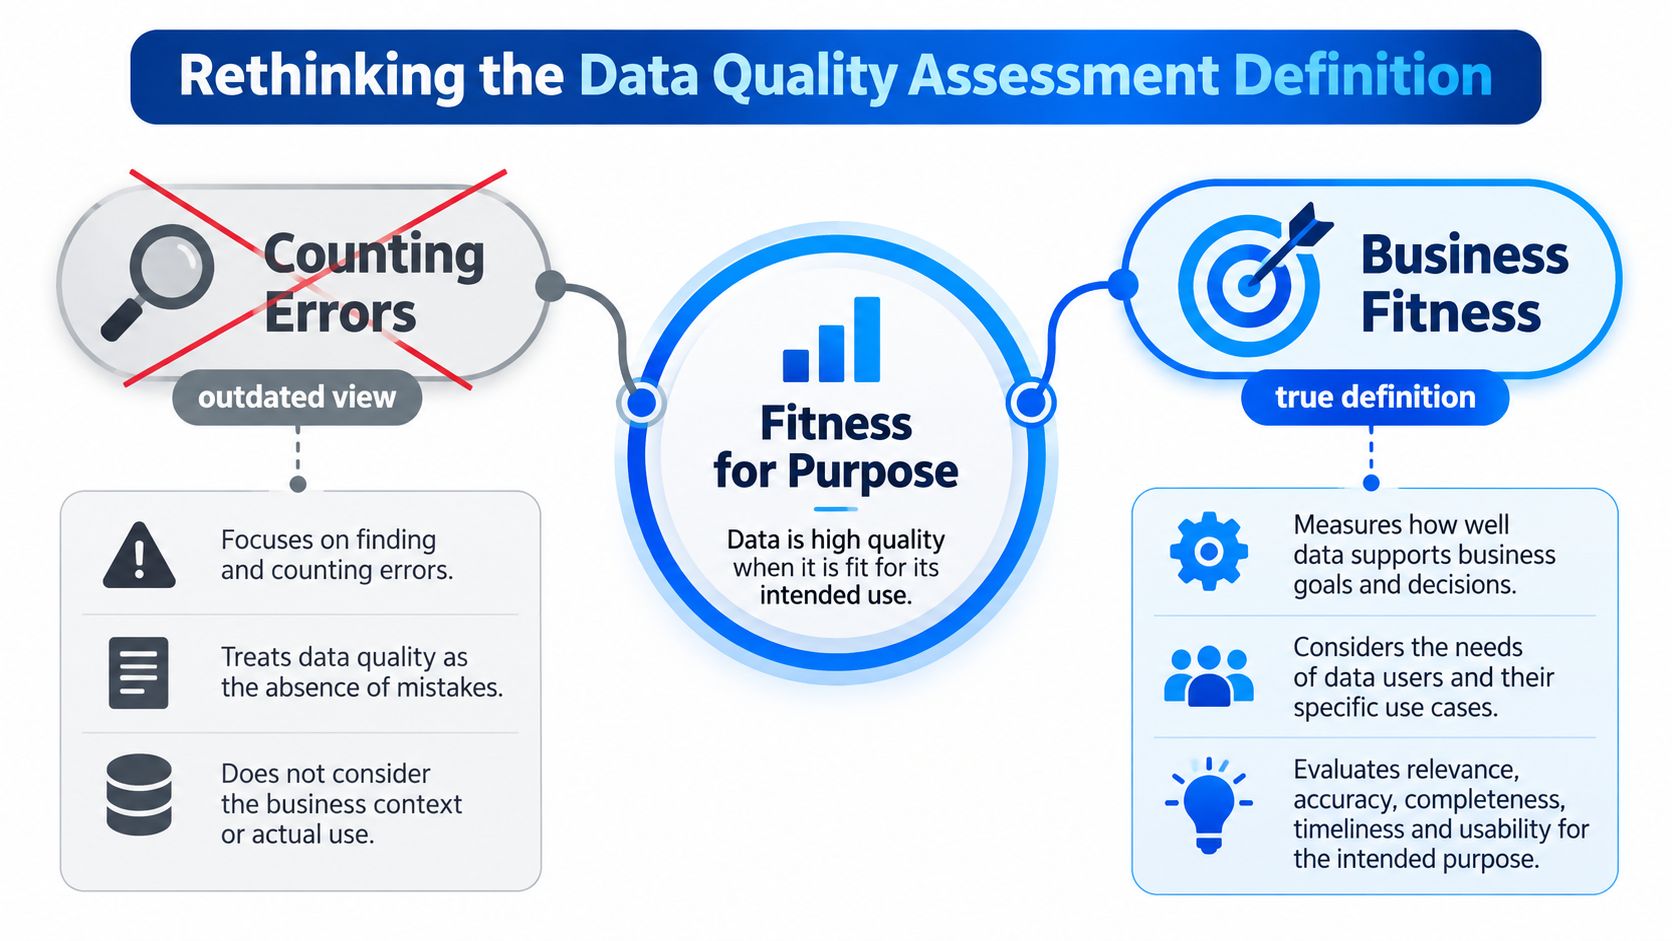
Auch ein sauberer Datensatz kann ein unzuverlässiges Ergebnis liefern. Ein Data Quality Assessment bedeutet nicht, zu prüfen, ob Werte Fehler enthalten. Es ist ein standardbasierter Prozess, der Daten profiliert, die für ihre Verwendung relevanten Dimensionen misst und prüft, ob das Ergebnis einen operativen, analytischen, regulatorischen oder Machine-Learning-Zweck unterstützt.
Eine technisch valide Tabelle kann in der Produktion trotzdem versagen. Die Datensätze von gestern können korrekt, für eine operative Entscheidung aber zu spät sein. Ein befülltes Feld kann eine fehlende Abdeckung verschleiern, weil ein ganzes Kundensegment nie in den Datensatz gelangt ist. Zwei Systeme können intern übereinstimmen und „aktiver Kunde“ dennoch unterschiedlich definieren. Für Analytics und KI können solche semantischen Konflikte Features erzeugen, die konsistent wirken, aber unterschiedliche fachliche Konzepte abbilden.
Der umfassendere Fitness-for-Use-Ansatz entstand in den 1990er-Jahren in der akademischen Datenqualitätsforschung. Wang und Strong definierten Datenqualität 1996 als „Fitness for Use“ und verlagerten den Fokus damit von Fehlerzahlen auf die Bedürfnisse der Datenkonsumenten, wie dieser Überblick über die Geschichte des Data Quality Assessment dokumentiert.
Warum ein einzelner Score nicht reicht
Ein einzelner Genauigkeits-Score kann nicht zeigen, ob Definitionen, Lineage, Aktualität und Abdeckung der Grundgesamtheit eine Entscheidung tragen. Ein wiederholbares Assessment verknüpft jede Messung mit einem dokumentierten Zweck und benennt die Risiken, die für diesen Workload relevant sind.
Operative Nutzung: Kann die Pipeline verwendbare Daten liefern, wenn nachgelagerte Prozesse sie benötigen?
Analytische Nutzung: Tragen Definitionen, Joins und Abdeckung eine belastbare Schlussfolgerung?
Regulatorische Nutzung: Kann die Organisation Quelle, Kontrollen, Transformationen und Nachweise hinter dem Ergebnis erklären?
KI-Nutzung: Bilden Trainingsdaten und Features die beabsichtigten fachlichen Konzepte konsistent genug für Evaluierung und Deployment ab?
Statistics Canada beschreibt Qualität in seinem Data Quality Toolkit über Merkmale wie Relevanz, Abdeckung, Granularität, Genauigkeit, Zuverlässigkeit, Standardisierung, Aktualität, Pünktlichkeit, Reproduzierbarkeit und Vertrauenswürdigkeit. Diese Bandbreite erklärt, warum ein Assessment eine laufende Kontrolle ist und kein einmaliges Urteil. Schemas, Quellen, Definitionen, Nutzer und Anforderungen ändern sich, also müssen sich auch Prüfungen und Verantwortlichkeiten mit ihnen ändern.
Eine breitere Einführung bietet dieser Leitfaden dazu, was Datenqualität bedeutet. Die praktische Frage lautet, ob sich die richtigen Nutzer bei einer bestimmten Entscheidung auf die Daten verlassen können und ob die Organisation begründen kann, warum.
Die fünf Kerndimensionen der Datenqualität
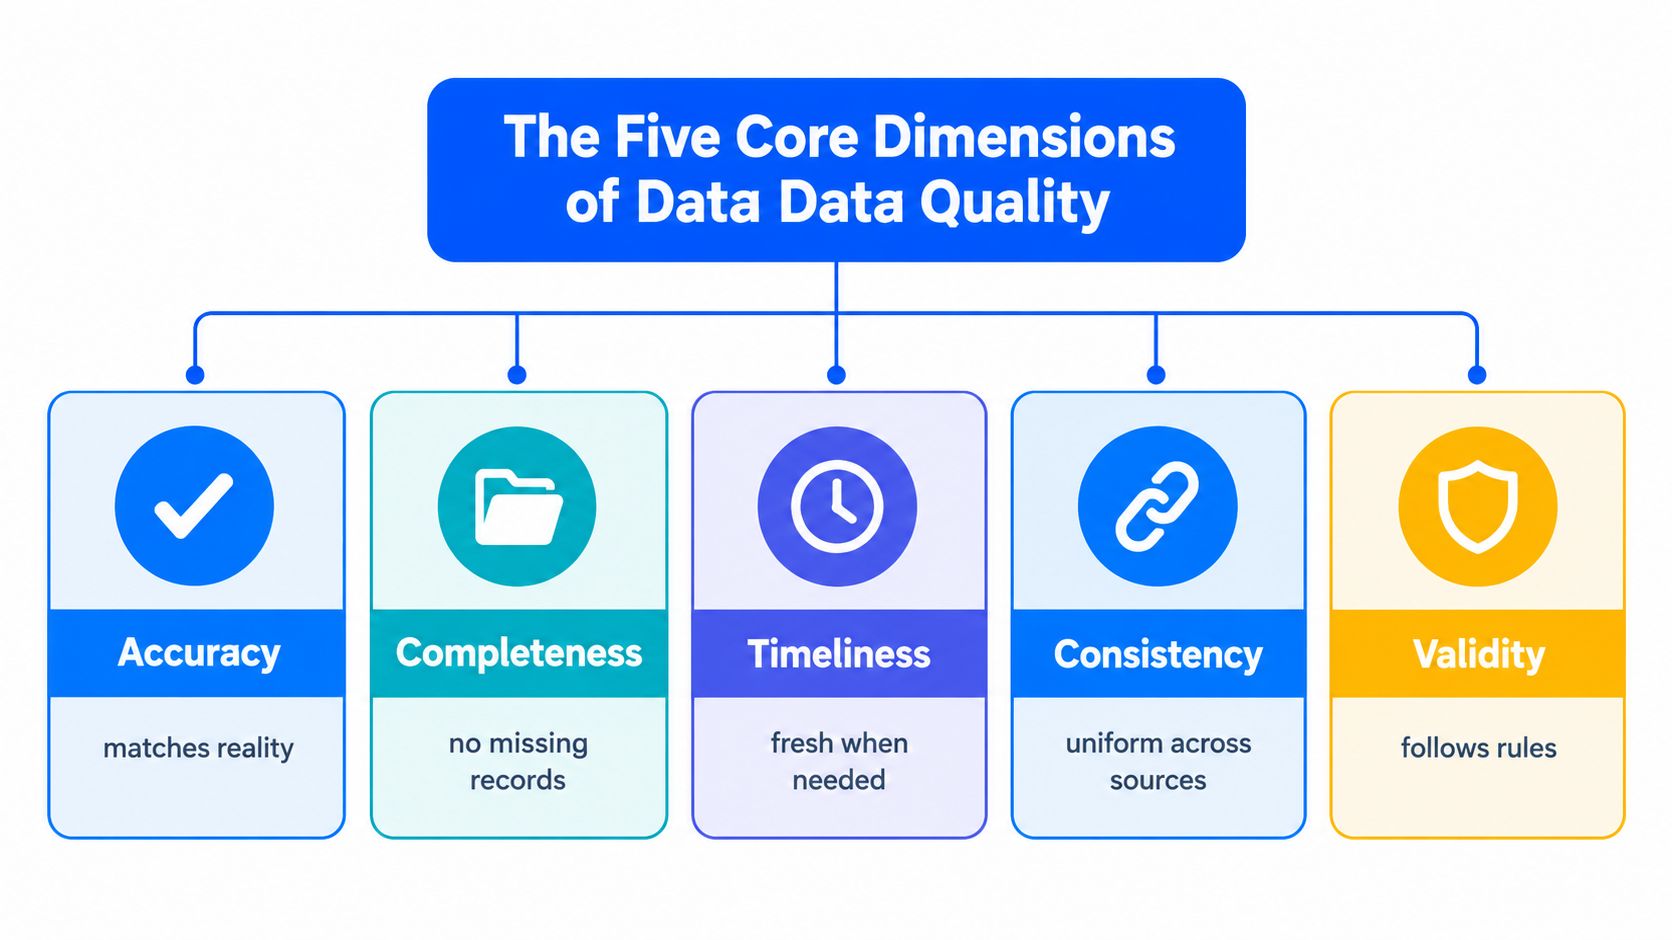
Ein brauchbares Assessment braucht eine kleine Zahl von Dimensionen, die Teams wiederholt messen und im Kontext interpretieren können. Diese Dimensionen legen unterschiedliche Fehlerarten offen. Ein Datensatz kann Formatprüfungen bestehen und für Analytics oder Machine Learning dennoch unzuverlässig sein, wenn seine Werte die falsche fachliche Bedeutung tragen. Nutzen Sie diesen Überblick über die Dimensionen der Datenqualität als Messmodell und passen Sie die Regeln dann an den Workload an.
Genauigkeit fragt, ob Daten die Realität oder eine maßgebliche Quelle widerspiegeln. Ein Datum kann dem geforderten Format entsprechen und trotzdem falsch sein. Produktive Prüfungen können Datensätze mit Quellsystemen, Referenzdaten, Abstimmungssummen oder freigegebenen fachlichen Fakten vergleichen. Im Machine Learning können ungenaue Labels oder Features ein Modell hervorbringen, das konsistent auf fehlerhaften Eingaben arbeitet.
Vollständigkeit fragt, ob erforderliche Datensätze und Attribute vorhanden sind. Unterscheiden Sie zwischen einem zulässigen Nullwert und einem fehlenden Wert, der einen Prozess, eine Analyse oder ein Modell-Feature blockiert. Auch die Abdeckung zählt. Prüfen Sie Systeme, Grundgesamtheiten und relevante Zeiträume, statt Vollständigkeit allein an befüllten Spalten festzumachen.
Aktualität misst, ob Daten für ihren Verwendungszweck rechtzeitig genug eintreffen. Ein Monatsbericht, ein operativer Alert und ein Modell-Feature können unterschiedliche Anforderungen an die Aktualität haben. Legen Sie akzeptable Lieferfenster fest und bewerten Sie die Folgen einer Verspätung, statt jede Verzögerung als gleich gravierend zu behandeln.
Konsistenz prüft, ob gleichwertige Werte, Beziehungen und Definitionen über Systeme und Transformationen hinweg übereinstimmen. Das betrifft Formate und Codes, legt aber auch semantische Konflikte offen. Zwei Abteilungen berechnen dieselbe Kennzahl womöglich unterschiedlich, sodass sauber wirkende Daten keinen verlässlichen Vergleich und kein verlässliches Trainingsset ermöglichen.
Validität prüft, ob Werte den festgelegten Regeln, Formaten, Referenzlisten und strukturellen Erwartungen entsprechen. Eine Regel kann bestätigen, dass ein Status zu einer freigegebenen Menge gehört. Feldübergreifende Regeln prüfen, ob zusammengehörige Attribute fachlich zueinander passen, und finden so Fehler, die eine Validierung auf Spaltenebene übersieht.
Nachvollziehbarkeit ins Modell aufnehmen
Lineage ist im visuellen Modell keine eigene Säule, doch Produktionsteams brauchen sie, um jedes Ergebnis zu interpretieren. Schlägt eine Regel fehl, sollten Engineers die betroffene Quelle, Transformation, Tabelle, den Bericht oder das Modell identifizieren können. Ohne diesen Pfad beschreibt ein Score ein Symptom, ohne zu zeigen, wo die Behebung ansetzen muss.
ISO-nahe Leitlinien unterscheiden zwischen syntaktischer Qualität, semantischer Qualität und pragmatischer Qualität. Die Syntax umfasst die festgelegte Struktur, die Semantik die beabsichtigte Bedeutung und die Pragmatik den Zweck des Nutzers, wie dieser Überblick über die Qualitätskonzepte von ISO 8000 erläutert. Diese Unterscheidung verhindert, dass Teams technisch saubere Daten automatisch als geeignet für Analytics oder KI betrachten.
Jede Dimension braucht einen Verantwortlichen, eine Regel oder Kennzahl, einen akzeptablen Schwellenwert und einen Eskalationsweg. Kontinuierliche Prüfungen machen diese Kontrollen umsetzbar, statt das Modell als bloße Checkliste stehen zu lassen.
Historischer Kontext und Standards
Die Definition des Data Quality Assessment hat sich in Etappen entwickelt. Die akademische Forschung der 1990er-Jahre erweiterte den Qualitätsbegriff von reiner Korrektheit auf Fitness for Use. Es folgte die formale Standardisierung: ISO veröffentlichte 2011 ihren Datenqualitätsstandard, wie im bereits zitierten historischen Überblick vermerkt. Dieser Wandel ist bis heute wichtig, denn ein Wert kann sauber formatiert und technisch valide sein und für einen Analysten oder ein Machine-Learning-Modell trotzdem die falsche fachliche Bedeutung tragen.
Der IWF entwickelte sein Data Quality Assessment Framework nach einer Diskussion im Exekutivdirektorium im Dezember 1997. Im Juli 2001 wurde ein Papier vorgestellt, 2003 wurde das Framework öffentlich beschrieben. Es besteht aus sechs Teilen: Zuerst kommen die Voraussetzungen für Qualität, danach werden fünf weitere Dimensionen untersucht. Das Data Quality Assessment Framework des IWF trennt die ermöglichenden Rahmenbedingungen, einschließlich Governance und institutioneller Regelungen, von der Qualität statistischer Produkte und Prozesse.
Diese Trennung macht einen typischen Fehler in Unternehmen sichtbar. Ein Team kann technisch korrekte Datensätze über einen undokumentierten Prozess erzeugen oder eine formale Governance pflegen, während seine Daten unvollständig bleiben. Keines der beiden Ergebnisse ist für Reporting, Forecasting oder KI-Training vertrauenswürdig. Ein Assessment sollte daher Verantwortlichkeiten, rechtliche Rahmenbedingungen, Dokumentation, Prozessfähigkeit und die jedem Feld zugewiesene Bedeutung untersuchen, nicht nur die gespeicherten Werte.
Der ISO-Standard für Data Profiling behandelt Profiling als Grundlage des Assessments. Profiling liefert Spaltenanalysen und Datensatzstatistiken, doch Engineers müssen diese Beobachtungen weiterhin fachlichen Anforderungen und Qualitätsdimensionen zuordnen. ISO 8000-61 verknüpft das Datenqualitätsmanagement zudem mit Prozessfähigkeit und organisatorischer Reife.
Standards machen aus Meinungen Belege
Standards ersetzen kein Urteilsvermögen. Sie machen es explizit und wiederholbar. Ein reguliertes Team kann dokumentieren, warum ein Aktualitätsschwellenwert existiert, welche Datensätze im Scope sind, wie ein Fehler berechnet wird und wer das verbleibende Risiko akzeptiert.
Dieser Audit Trail macht behördliche Leitlinien auch im kommerziellen Umfeld nützlich. Der Ansatz der EPA versteht ein Data Quality Assessment als wissenschaftliche und statistische Bewertung, ob Daten die richtige Art, Qualität und Menge für ihren Verwendungszweck haben. Dasselbe Prinzip gilt für Analytics im Finanzwesen, im Gesundheitswesen und im öffentlichen Sektor.
Teams, die einen breiteren Governance-Kontext suchen, können Standards mit den Leitlinien des DAMA DMBOK kombinieren. Der Praxistest ist einfach: Ein Framework hat seine Berechtigung, wenn Engineers und Data Owner damit konsistente Entscheidungen über semantische Risiken, Modelleignung und Behebung treffen können.
Operative Risiken einer mangelhaften Bewertung
Eine mangelhafte Bewertung scheitert selten mit einer offensichtlichen roten Warnung. Viel häufiger läuft eine Pipeline technisch erfolgreich durch und liefert Daten, die die damit verbundene Entscheidung nicht mehr tragen.
Ein veraltetes Dashboard ist ein Aktualitätsproblem. Eine umbenannte Quellspalte, die eine nicht überwachte Transformation durchläuft, ist ein Schema- und Lineage-Problem. Ein Bericht, der zwei valide, aber unterschiedlich definierte Kennzahlen kombiniert, ist ein Konsistenz- und Semantikproblem. Jedes dieser Probleme kann unsichtbar bleiben, wenn Teams nur Nullwerte, Formate oder die Validität auf Zeilenebene überwachen.
Was zuerst kaputtgeht
Der sichtbare Vorfall liegt oft nachgelagert zum eigentlichen Qualitätsmangel:
Dashboards verlieren an Glaubwürdigkeit: Analysten stoßen auf widersprüchliche Zahlen und beginnen, Extrakte manuell abzugleichen.
Pipelines verbergen Verzögerungen: Ein erfolgreicher Job-Status kann verdecken, dass eine Datei zu spät kam oder nur teilweise geladen wurde.
Schemas driften unbemerkt: Hinzugefügte, entfernte oder umtypisierte Spalten können das Verhalten nachgelagerter Systeme ändern, ohne einen Anwendungsfehler auszulösen.
Modelle erben Mehrdeutigkeit: Ein Machine-Learning-Workflow kann widersprüchliche Definitionen als vergleichbare Features behandeln, weil die Werte strukturell valide aussehen.
Die Behebung verlangsamt sich: Ohne Lineage und klare Verantwortlichkeiten diskutieren Teams, wo das Problem begann, statt den verantwortlichen Prozess zu reparieren.
Die Kosten beschränken sich nicht auf Nacharbeit. Nutzer verlieren womöglich das Vertrauen in governte Datensätze und legen private Tabellen oder parallele Abfragen an. Engineers müssen dann mehrere inoffizielle Versionen derselben Kennzahl betreuen, was künftige Assessments erschwert.
Praxisregel: Bewerten Sie die Fehlerarten, die die Entscheidung entwerten können, nicht nur die Mängel, die sich am leichtesten zählen lassen.
Ein kontinuierliches Assessment trägt dieser betrieblichen Realität Rechnung. Teams können beim Onboarding profilieren, doch das Monitoring in der Produktion sollte Lieferverhalten, Verteilungen, strukturelle Änderungen, Validierungsergebnisse und Business-Kennzahlen über die Zeit beobachten. Das Ziel ist nicht, jede Anomalie zu beseitigen. Es geht darum, wesentliche Änderungen früh zu erkennen, sie mit den betroffenen Konsumenten zu verknüpfen und einem Verantwortlichen genug Belege zum Handeln zu geben.
Manuelle Regeln versus kontinuierliche Observability
Handgeschriebene Regeln haben weiterhin ihren Platz. Sie funktionieren gut, wenn eine Anforderung explizit, stabil und rechtlich oder operativ wichtig ist. Ein Pflichtfeld, ein freigegebener Statuscode oder eine Bedingung der referenziellen Integrität sollten deterministisch bleiben, weil die Organisation eine klare Entscheidung zwischen bestanden und nicht bestanden braucht.
Problematisch wird es, wenn Teams manuelle Regeln für jedes denkbare Muster einsetzen. Regelbibliotheken wachsen schneller, als ihre Verantwortlichen sie prüfen können, und eine Regel, die für das Schema des Vorjahres sinnvoll war, kann nach einer Migration irrelevant werden. Statische Prüfungen erkennen zudem meist bekannte Mängel und übersehen ungewöhnliche, aber valide Änderungen bei Volumen, Timing, Verteilung oder Verhalten.
Assessment-Ansatz | Skalierbarkeit | Wartung | Erkennungsfähigkeit |
|---|---|---|---|
Manuelle deterministische Regeln | Stark bei gezielten, klar definierten Kontrollen | Erfordert Verantwortliche, Reviews und Anpassungen bei geänderten Anforderungen | Wirksam bei bekannten Bedingungen und fachlichen Einschränkungen |
Periodisches Profiling | Nützlich zur Erkundung unbekannter Datensätze | Geringe operative Kontinuität zwischen den Assessments | Findet Muster, Nullwerte, Verteilungen und Ausreißer zum Zeitpunkt der Prüfung |
Kontinuierliche Observability | Skaliert über sich ändernde Pipelines, wenn Baselines und Verantwortlichkeiten gepflegt werden | Erfordert Tuning, Incident-Triage und Governance-Disziplin | Erkennt Abweichungen bei Verhalten, Aktualität, Struktur und Qualitätstrends |
Hybrides Assessment | Kombiniert breites Monitoring mit präzisen Kontrollen | Verteilt den Wartungsaufwand auf verschiedene Regeltypen | Deckt sowohl explizite Anforderungen als auch bisher unbekannte Anomalien ab |
Die richtige Mischung wählen
Manuelle Regeln sind sinnvoll, wenn das Business die Anforderung präzise formulieren und erklären kann, warum eine Verletzung relevant ist. Kontinuierliche Erkennung ist nützlicher bei Verhalten, das natürlich schwankt, etwa Lieferzeiten oder Verteilungen von Datensätzen. Statistische Methoden und Machine Learning können erwartete Muster etablieren, ersetzen aber keinen fachlichen Kontext. Ein ungewöhnliches Ergebnis kann ein Mangel sein, eine legitime saisonale Verschiebung oder eine geplante Änderung.
Das Muster, das sich in der Produktion meist am besten bewährt, ist deterministische Validierung plus adaptives Monitoring. Das eine setzt durch, was immer gelten muss. Das andere achtet auf Änderungen, an deren Kodierung vorab niemand gedacht hat.
Teams, die diesen Trade-off abwägen, finden in dieser Diskussion über manuell gepflegte technische Datenqualitätsregeln weitere Anhaltspunkte. Die wichtige Designentscheidung ist nicht, ob Regeln oder Observability gewinnen. Entscheidend ist, welche Belege eine feste Policy erfordern und welches Verhalten einen kontinuierlichen Vergleich mit einer sich verändernden Baseline verdient.
Ein Data Quality Assessment durchführen
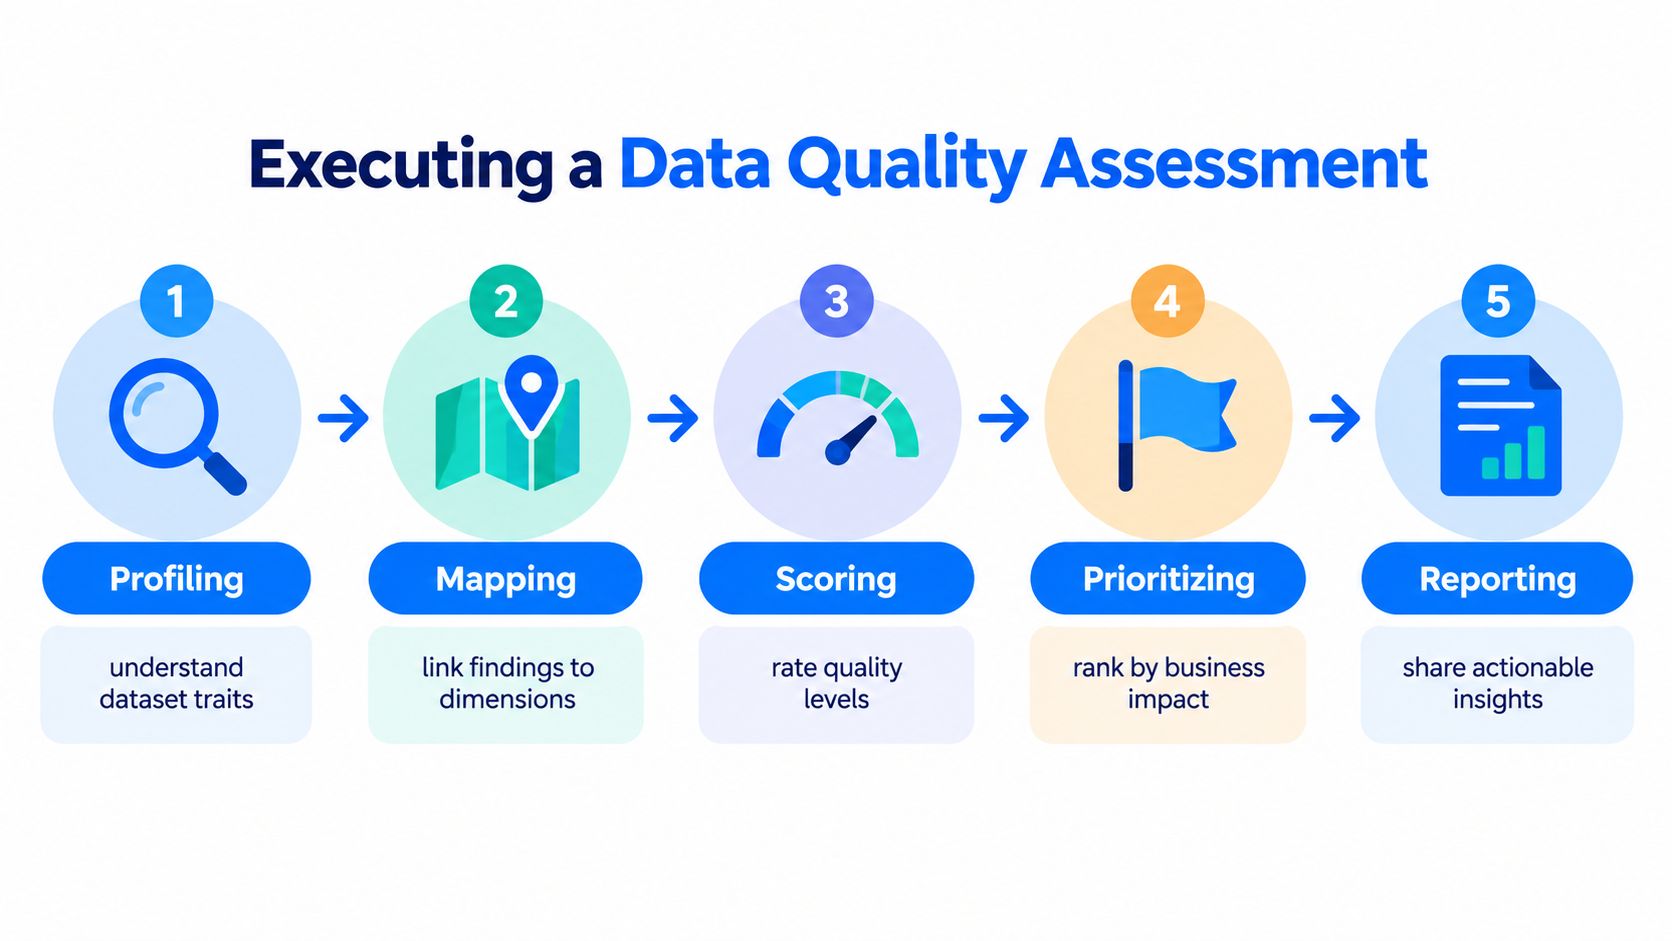
Ein nützliches Assessment macht aus Beobachtungen Entscheidungen. Der folgende Workflow hält Profiling, Messung, fachlichen Kontext und Behebung miteinander verbunden.
Mit Profiling beginnen
Untersuchen Sie zunächst Struktur und Verhalten des Datensatzes. Erfassen Sie Spalten, Typen, Wertemuster, Nullwerte, Eindeutigkeit, Verteilungen, Beziehungen, Lieferhistorie und verfügbare Metadaten. Profiling ist Erkundung, nicht das abschließende Assessment. Es zeigt, was offenbar passiert, entscheidet aber nicht, ob das Muster akzeptabel ist.
Befunde dem Verwendungszweck zuordnen
Identifizieren Sie als Nächstes die Konsumenten und die Entscheidung, die die Daten unterstützen. Ordnen Sie jeden Befund Dimensionen wie Genauigkeit, Vollständigkeit, Aktualität, Konsistenz, Validität und Lineage zu. Halten Sie dann die semantischen Anforderungen fest, die technisches Profiling nicht ableiten kann, darunter fachliche Definitionen, Scope, Verantwortlichkeiten und maßgebliche Quellen.
Ein fehlender Wert kann in einem Workflow akzeptabel und in einem anderen ein Ausschlusskriterium sein. Eine veränderte Verteilung kann auf Data Drift hindeuten oder ein legitimes Geschäftsereignis widerspiegeln. Der Kontext bestimmt die Interpretation.
Schwellenwerte festlegen
Definieren Sie messbare Erwartungen pro Datensatz, statt unternehmensweite Standardwerte zu verwenden. Nützliche Kontrollen sind Pflicht- und optionale Felder, akzeptable Nullwertquoten, Aktualitätsgrenzen, die Erkennung von Schemaänderungen, erwartete Zeilenvolumen, zulässige Werte und Abstimmungsbedingungen. Standardbasierte Qualitätsleitlinien betonen explizite Dimensionen und dokumentierte Anforderungen, was die Ergebnisse besser reproduzierbar macht.
Validieren und priorisieren
Wenden Sie fachliche Regeln auf Zeilenebene zusammen mit einem Monitoring auf Datensatzebene an. Priorisieren Sie Fehler anschließend nach geschäftlicher Auswirkung, betroffenen Konsumenten, regulatorischer Exposition und Behebungsaufwand. Ein kleiner Mangel in einem kritischen regulatorischen Feld kann schnelleres Handeln erfordern als ein größerer Mangel in einem ungenutzten Attribut.
Das auf den öffentlichen Sektor ausgerichtete Messmodell liefert ein praxistaugliches Muster: an Policies geknüpfte Assertions identifizieren, sie mit der geschäftlichen Auswirkung verbinden, Mängel kategorisieren, ihren Beitrag zur Konformität quantifizieren und die Ergebnisse in einem Drill-down-fähigen Format berichten.
Berichten und operationalisieren
Veröffentlichen Sie das Ergebnis schließlich mit Belegen, Verantwortlichkeiten, betroffenen Assets und dem nächsten Schritt. Verankern Sie die Prüfungen in der Pipeline oder im Observability-Layer, damit dasselbe Assessment läuft, wenn sich Daten ändern, und nicht nur dann, wenn jemand daran denkt, ein Audit anzustoßen.
Ein praxistauglicher Workflow für Datenqualitäts-Audits sollte die Historie bewahren. Verfolgen Sie Ergebnisse als Trend über die Zeit, dokumentieren Sie akzeptierte Ausnahmen und verifizieren Sie die Behebung. Ohne historische Belege können Teams einen neuen Vorfall nicht von einem wiederkehrenden Mangel unterscheiden.
Fallstudie - die Datenqualitäts-Transformation bei ITSV
ITSV, das IT-Rückgrat der österreichischen Sozialversicherung, stand vor dem Wartungsaufwand einer großen Sammlung handgeschriebener Qualitätsregeln. Die Organisation ersetzte 9.000 manuell erstellte Regeln durch digna Data Anomalies und Data Timeliness und bewegte sich damit von einem Modell, das primär auf Regelpflege beruhte, hin zu kontinuierlicher Observability.
Der Wert der Umstellung lag nicht nur in weniger Regeln. ITSV brauchte einen Monitoring-Ansatz, der mit seiner Datenlandschaft skaliert, ohne dass Spezialisten sich jedes erwartete Muster merken müssen. Kontinuierliche Anomalieerkennung half, Alert-Rauschen zu reduzieren, während das Aktualitäts-Monitoring die Aufmerksamkeit darauf lenkte, ob Daten gemäß dem erwarteten operativen Verhalten eintrafen.

Was das Beispiel zeigt
Die Transformation verdeutlicht drei praktische Lehren:
Regelmenge ist keine Qualitätsreife: Tausende Prüfungen können einen großen Wartungsaufwand erzeugen, ohne semantischen Drift oder unerwartetes Verhalten abzudecken.
Adaptives Monitoring schont die Aufmerksamkeit: Weniger unnötige Alerts verschaffen Engineers mehr Zeit, relevante Änderungen zu untersuchen.
Wissen gehört ins System: Ein Monitoring-Prozess, der vom Gedächtnis Einzelner abhängt, wird fragil, wenn Personen ihre Rolle wechseln oder das Unternehmen verlassen.
Das Beispiel ITSV macht deterministische Regeln nicht überflüssig. Kritische fachliche Anforderungen brauchen weiterhin eine explizite Validierung. Es zeigt aber, warum Teams davon profitieren, diese Kontrollen mit einem Monitoring zu kombinieren, das das normale Verhalten von Datensätzen lernt und Abweichungen zur Prüfung markiert.
Das stärkste Betriebsmodell regelt zudem die Verantwortung nach der Erkennung. Eine Anomalie ohne Kontext, Lineage und Verantwortlichen wird zu einem weiteren Ticket im Backlog. Eine Anomalie, die mit einem betroffenen Prozess und einem klaren Entscheidungsverantwortlichen verknüpft ist, kann zu einem kontrollierten Behebungs-Workflow werden.
Überlegungen zur Einführung im Unternehmen
Die Einführung im Unternehmen gelingt, wenn die Assessment-Architektur Sicherheit, Governance und die bestehende Arbeitsweise der Teams respektiert. Daten in einen separaten Monitoring-Service zu verschieben, kann unnötige Risiken, Duplikate und Reibung bei Freigaben erzeugen. Die In-Database-Ausführung hält Metrikberechnung und Analyse innerhalb der Datenbanken des Kunden, sodass die Daten an Ort und Stelle bleiben und Teams dennoch Qualitätsnachweise erhalten.
Flexibilität beim Deployment ist ebenso wichtig. Private-Cloud- und On-Premises-Installationen passen zu Organisationen, die Kontrollen in ihrer eigenen Cloud, Virtual Private Cloud oder ihrem Rechenzentrum benötigen. Die richtige Wahl hängt von Sicherheitsrichtlinien, Netzwerkdesign, operativer Verantwortung und davon ab, wie schnell sich die Plattform an bestehende Warehouses und Pipelines anbinden muss.
Auf geteilte Verantwortung auslegen
Ein Data Engineer braucht Incident-Details und Lineage. Ein Analytics Engineer muss das Verhalten von Kennzahlen verstehen. Ein fachlicher Stakeholder braucht einen klaren Status und eine Aussage zur Auswirkung. Ein nutzerzentriertes Dashboard sollte alle drei bedienen, ohne dass jede Gruppe ihre eigene Interpretation zusammenbauen muss.
Achten Sie auf eine Implementierung, die die operativen Grundlagen von Anfang an mitbringt:
In-Database-Berechnung: Quelldaten bleiben in der vom Kunden kontrollierten Umgebung.
Modulare Einführung: Beginnen Sie mit der Funktion, die das dringendste Risiko adressiert, und erweitern Sie, wenn Verantwortlichkeiten und Messung reifen.
Integriertes Scheduling: Assessments laufen konsistent, statt von Ad-hoc-Skripten abzuhängen.
Katalog und Zusammenarbeit: Befunde werden mit Assets, Verantwortlichen, Incidents und Entscheidungen verknüpft.
Transparente Preislogik: Nachvollziehen, wie aktive Tabellen, Module, Umgebungen und Support das Kostenmodell beeinflussen.
KI-gestütztes Monitoring kann den manuellen Wartungsaufwand senken, braucht aber weiterhin Governance. Teams müssen Baselines prüfen, Ausnahmen erklären, sensible Daten schützen und entscheiden, welche Befunde die nachgelagerte Nutzung blockieren. Automatisierung sollte repetitive Erkennungs- und Routing-Arbeit abnehmen, nicht die Verantwortung.
Die beste Implementierung ist daher weder ein riesiges Projekt zum Schreiben von Regeln noch eine undurchsichtige Machine-Learning-Schicht. Sie ist ein kontrolliertes System, das explizite fachliche Regeln, adaptive Anomalieerkennung, Lineage, Aktualitäts-Monitoring, Schema-Bewusstsein und sichtbare Verantwortlichkeiten vereint.
digna bietet eine Enterprise-Plattform für Datenqualität und Data Observability, die in der Umgebung des Kunden läuft, mit Anomalieerkennung, Aktualitäts-Monitoring, Validierung auf Zeilenebene, Schema-Tracking, In-Database-Ausführung und gemeinsamen Dashboards für Datenteams und Stakeholder. Besuchen Sie digna und erfahren Sie, wie kontinuierliches Assessment Daten für Analytics und KI vertrauenswürdiger machen kann.
Regeln decken die Fehler ab, die Sie vorhersehen können. Für alle anderen lernt digna Data Anomalies das normale Volumen, die Verteilung und das Verhalten jeder Tabelle und markiert Abweichungen, die keine handgeschriebene Regel vorhergesehen hat.
Häufig gestellte Fragen
Was ist ein Data Quality Assessment?
Ein Data Quality Assessment ist ein standardbasierter Prozess, der Daten profiliert, die für ihre Verwendung relevanten Dimensionen misst und prüft, ob sie einen operativen, analytischen, regulatorischen oder Machine-Learning-Zweck unterstützen. Es geht über das Zählen von Fehlern hinaus, denn eine technisch valide Tabelle kann trotzdem zu spät eintreffen oder die falsche fachliche Bedeutung tragen.
Welche Dimensionen hat ein Data Quality Assessment?
Der Beitrag verwendet fünf Kerndimensionen: Genauigkeit, Vollständigkeit, Aktualität, Konsistenz und Validität, ergänzt um Lineage für die Nachvollziehbarkeit. Lineage ist keine eigene Säule, ermöglicht Engineers aber, eine fehlgeschlagene Regel bis zur betroffenen Quelle, Transformation, Tabelle, zum Bericht oder Modell zurückzuverfolgen, sodass die Behebung an der richtigen Stelle ansetzt.
Wer hat Datenqualität als Fitness for Use definiert?
Wang und Strong definierten Datenqualität 1996 als Fitness for Use und verlagerten den Fokus damit von Fehlerzahlen auf die Bedürfnisse der Datenkonsumenten. Die formale Standardisierung folgte, als ISO 2011 ihren Datenqualitätsstandard veröffentlichte, und der IWF beschrieb sein sechsteiliges Data Quality Assessment Framework 2003 öffentlich.
Wie führt man ein Data Quality Assessment Schritt für Schritt durch?
Profilieren Sie zunächst Struktur, Nullwerte, Verteilungen und Lieferhistorie und ordnen Sie die Befunde dann dem Verwendungszweck und seinen Konsumenten zu. Legen Sie anschließend Schwellenwerte pro Datensatz fest, etwa Aktualitätsgrenzen und akzeptable Nullwertquoten, priorisieren Sie Fehler nach geschäftlicher Auswirkung und verankern Sie die Prüfungen schließlich in der Pipeline, damit das Assessment bei jeder Datenänderung erneut läuft.
Sollten Datenqualitätsprüfungen auf manuellen Regeln oder automatisiertem Monitoring beruhen?
Die meisten Teams brauchen beides: deterministische Regeln für Anforderungen, die immer gelten müssen, und adaptives Monitoring für Verhalten, das niemand vorab kodiert hat. ITSV, das IT-Rückgrat der österreichischen Sozialversicherung, ersetzte 9.000 handgeschriebene Regeln durch digna Data Anomalies und Data Timeliness und behielt eine explizite Validierung für kritische fachliche Anforderungen bei.



