Wydarzenia Data Analytics wyjaśnione od śledzenia do zaufania
|
7
min. czyt.

Masz pulpit nawigacyjny, który wygląda na spokojny, zespół wciąż wdraża nowości, a mimo to pewnego ranka liczby nie do końca pokrywają się z tym, co widzi dział sprzedaży, produktu i wsparcia. To ciche niebezpieczeństwo, które niosą ze sobą zdarzenia Data Analytics. Kod może nadal się uruchamiać, ale jeśli znaczenie zdarzenia ulegnie przesunięciu, pulpit nawigacyjny może wciąż opowiadać historię, która nie odpowiada już rzeczywistości.
Dlatego niezawodne zdarzenia to nie tylko problem ze śledzeniem. To problem związany z Data Contract, a umowa musi obowiązywać inżynierów, analityków i biznes. Jeśli model zdarzeń jest niejasny, każdy downstreamowy lejek, model atrybucji i potok funkcji dziedziczy tę dwuznaczność. Jeśli model jest jasny, reszcie stosu łatwiej zaufać. Zobacz powiązaną ideę wiarygodnych danych jako danych prawidłowych, aby poznać szersze podejście do jakości stojące za tym zaufaniem.
Kluczowa idea: zdarzenie jest użyteczne tylko wtedy, gdy jego znaczenie pozostaje na tyle stabilne, aby ludzie i systemy mogli na nim polegać.
Praktyczna ścieżka jest prosta, nawet jeśli szczegóły wymagają dyscypliny. Najpierw zrozum, czym naprawdę jest zdarzenie. Następnie zaprojektuj model tak, aby skalował się wraz ze zmianami produktu. Następnie wyeliminuj typowe tryby awarii, które niszczą dane. Na koniec stale waliduj strumień jako żywy kontrakt, a nie jednorazową listę kontrolną.
Spis treści
Wprowadzenie: Dlaczego zdarzenia analityczne budują lub niszczą zaufanie
Czym naprawdę są zdarzenia Data Analytics i jak działają
Trzy części, które mają znaczenie
Od surowej interakcji do potoku analitycznego
Projektowanie modelu zdarzeń, który skaluje się wraz z Twoim produktem
Zacznij od kategorii, a następnie przejrzyście nazwij zdarzenie
Zdecyduj, które pola są wymagane
Typowe pułapki, które uszkadzają dane zdarzeń, i jak ich unikać
Wzorce zdrowe i niezdrowe
Uważaj na błędy związane z czasem i strefą czasową
Walidacja jakości zdarzeń za pomocą kontraktów i obserwowalnych sygnałów
Pięć sygnałów, które ujawniają różne rodzaje problemów
W przypadku ruchu o charakterze impulsowym linie bazowe wygrywają ze stałymi progami
Wprowadzanie Event Observability w życie z digna
Budowanie niezawodnych zdarzeń analitycznych w perspektywie długoterminowej
Wprowadzenie: Dlaczego zdarzenia analityczne budują lub niszczą zaufanie
Pulpit nawigacyjny może wyglądać na sprawny, podczas gdy strumień zdarzeń pod nim zaczął już dryfować. Menedżer produktu widzi wykres rejestracji. Analityk widzi ten sam wykres. Inżynier danych sprawdza potok i nie zauważa niczego uszkodzonego. Pułapka polega na tym, że system może być technicznie „aktywny”, podczas gdy znaczenie zdarzenia przesunęło się na tyle, by zniekształcić decyzje.
Właśnie dlatego zdarzenia Data Analytics leżą u podstaw prawie każdej metryki, na której zależy ludziom. Zasilają lejki, widoki retencji, odczyty eksperymentów, atrybucję marketingową, alerty operacyjne i funkcje ML. Gdy definicja zdarzenia jest rozmyta, każdy zespół wypełnia luki inaczej, a te różnice nie zawsze wychodzą na jaw, dopóki ktoś nie zapyta, dlaczego dwa raporty się różnią.
Sama ta dziedzina ma głębokie korzenie. IEEE International Conference on Data Science and Advanced Analytics (IEEE DSAA) opisuje się jako wiodące forum nauki o danych, wspierane wspólnie przez IEEE, ACM, ASA i CCF jak opisano w przeglądzie ekosystemu zdarzeń analitycznych. Tego rodzaju wsparcie instytucjonalne to silny sygnał, że zdarzenia analityczne nie są tematem pobocznym, ale stanowią część podstawowej infrastruktury zawodowej w tej dziedzinie.
Inna zmiana ma charakter praktyczny. Wskaźniki frekwencji na wydarzeniach w środowisku zawodowym pokazują również, jak często rzeczywisty udział różni się od liczby osób na liście rejestracyjnej. W badaniu porównawczym z 2026 r. wydarzenia stacjonarne zazwyczaj konwertują około 60% do 70% odpowiedzi RSVP na rzeczywistych uczestników, wirtualne wydarzenia na żywo konwertują około 40% do 50% rejestracji na frekwencję, a stacjonarne konferencje zawodowe i akademickie często odnotowują wskaźnik nieobecności na poziomie 30% do 40% źródło. Ten sam wzorzec ma znaczenie w pracy analitycznej, ponieważ zespoły również muszą planować spadek między intencją a rzeczywistym zachowaniem danych.
Czym naprawdę są zdarzenia Data Analytics i jak działają
Użytecznym sposobem myślenia o zdarzeniu jest traktowanie go jako potwierdzenia wykonania akcji. Potwierdzenie mówi o tym, co się stało, kiedy to się stało i zawiera wystarczający kontekst, aby zrozumieć to później. Bez tego kontekstu potwierdzenie jest tylko skrawkiem papieru. W analityce surowe kliknięcie, wyświetlenie, przesłanie formularza lub błąd staje się przydatne dopiero po przekształceniu w ustrukturyzowane dane o zdarzeniach.
Trzy części, które mają znaczenie
Każde solidne zdarzenie wymaga trzech składników. Akcja mówi o tym, co się stało, np. wyświetlenie strony, kliknięcie przycisku lub przesłanie formularza. Kontekst informuje o tym, gdzie i jak to się stało, np. strona, urządzenie, identyfikator użytkownika lub wersja aplikacji. Czas informuje, kiedy to nastąpiło, co ma znaczenie, ponieważ czas często zmienia znaczenie zdarzenia.
Praktyczna zasada: jeśli nie potrafisz wyjaśnić akcji, kontekstu i czasu prostym językiem, zdarzenie jest wciąż zbyt niespójne, aby mu zaufać.
Dzięki tej strukturze analityka oparta na zdarzeniach sprawdza się w obszarze produktu, marketingu i operacji. Specjalista ds. marketingu może analizować ruch z kampanii. Analityk produktu może badać lejek. Inżynier może prześledzić ścieżkę błędu. Nie zadają tego samego pytania, ale wszyscy odczytują ten sam bazowy sygnał.
Od surowej interakcji do potoku analitycznego
Podróż zazwyczaj zaczyna się od surowej interakcji w aplikacji lub usłudze. Interakcja ta jest rejestrowana jako zdarzenie, przesyłana przez warstwę strumieniowania lub gromadzenia danych, a następnie trafia do hurtowni lub repozytorium typu lakehouse, gdzie analitycy i modele mogą z niej korzystać. Ważną częścią jest nie tylko sam ruch, ale spójność znaczenia na każdym kroku.
Ludzie często mylą zdarzenia z encjami lub sesjami. Encja to rzecz, na której Ci zależy, np. użytkownik lub konto. Sesja to ograniczony czasowo okres aktywności. Zdarzenie to pojedynczy zaobserwowany fakt. Jeśli te pojęcia się zacierają, zespoły zaczynają przeciążać pola, a model staje się trudny do rozbudowy.
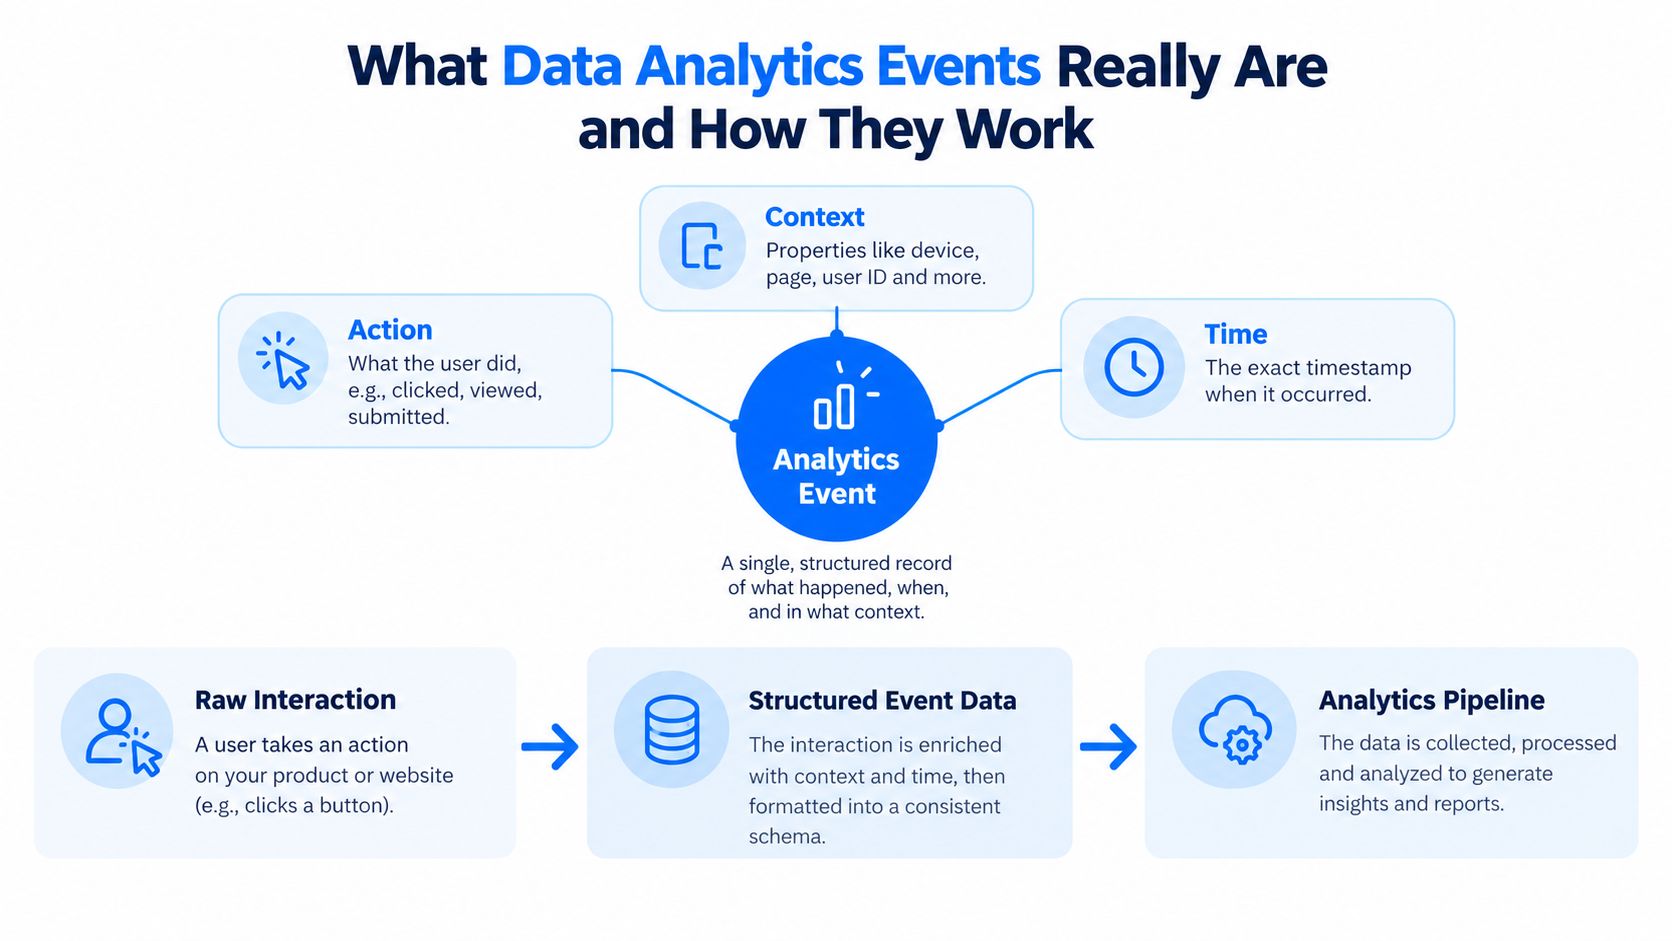
Gdy semantyka pozostaje stabilna, praca w dalszej części potoku staje się łatwiejsza. Dane o zdarzeniach mogą wspierać pulpity nawigacyjne, eksperymenty, funkcje rekomendacji i monitorowanie operacyjne, bez konieczności tworzenia przez każdy zespół własnej wersji prawdy.
Projektowanie modelu zdarzeń, który skaluje się wraz z Twoim produktem
Skalowalny model zdarzeń zaczyna się od umiaru. Zespoły często chcą instrumentować wszystko naraz, a po sześciu miesiącach kończą z przepełnionym katalogiem niemal identycznych zdarzeń, których nikt nie potrafi wyjaśnić. Lepszy model utrzymuje taksonomię na niewielkim poziomie, nazywa rzeczy jasno i oddziela to, co się stało, od szczegółów z tym związanych.
Zacznij od kategorii, a następnie przejrzyście nazwij zdarzenie
Trwała taksonomia zazwyczaj zaczyna się od szerokich kategorii, takich jak działania użytkownika i zdarzenia systemowe. W tym miejscu konwencja nazewnictwa powinna pozostać spójna, często w stylu czasownik_rzeczownik, np. user_signed_up lub invoice_failed. Ten wzorzec pomaga zarówno ludziom, jak i maszynom odczytać zdarzenie bez zgadywania, która część jest akcją, a która podmiotem.
Kolejną decyzją jest to, czy dany szczegół powinien znaleźć się w nowym zdarzeniu, czy we właściwości. Jeśli podstawowe działanie jest takie samo, ale zmienia się jeden atrybut, zachowaj go jako właściwość. Jeśli zmienia się samo znaczenie działania, utwórz nowe zdarzenie. Taki podział zapobiega zamianie modelu w długą listę przypadków szczególnych.
Decide which fields are required
Każde zdarzenie powinno mieć krótką listę wymaganych pól, dzięki którym rekord nadaje się do użytku. Zazwyczaj należą do nich tożsamość, znacznik czasu i podstawowy kontekst. Właściwości opcjonalne mogą dodać szczegółów, ale nie powinny być wymagane do podstawowej interpretacji, ponieważ czyni to instrumentację podatną na błędy.
Rozstrzyganie tożsamości również wymaga przemyślanego działania. Użytkownik może najpierw pojawić się jako anonimowy, a dopiero później jako uwierzytelniony. Jeśli model nie potrafi powiązać tych stanów w przejrzysty sposób, analiza lejka i raportowanie cyklu życia stają się niespójne. To samo zdarzenie może być nadal technicznie poprawne, pozostając jednocześnie niekompletnym z punktu widzenia analizy.
W przypadku zespołów, które chcą struktury zorientowanej na hurtownię danych, idea ta łączy się ściśle z dyscypliną tabel faktów i wymiarów. Zdarzenia działają jako fakty, podczas gdy pola kontekstowe pomagają analitykom dzielić je w stabilny sposób.

Dobre modele zdarzeń sprawiają, że na przyszłe pytania łatwiej odpowiedzieć, a nie trudniej je zadać.
Dokumentacja ma tak samo duże znaczenie jak nazewnictwo. Inżynierowie potrzebują szczegółów wdrożenia, a analitycy jasnych definicji. Jeśli obie grupy potrafią odczytać ten sam kontrakt, zmiany w produktach przestają tworzyć zaskakujące interpretacje.
Typowe pułapki, które uszkadzają dane zdarzeń, i jak ich unikać
Większość problemów ze zdarzeniami nie wygląda początkowo dramatycznie. Potok nadal działa. Pulpit nawigacyjny wciąż się odświeża. Problem polega na tym, że z czasem dane stają się mniej rzetelne, a uszkodzenia ujawniają się w analizach szybciej niż w alertach.
Wzorce zdrowe i niezdrowe
Niezdrowy wzorzec | Dlaczego szkodzi | Zdrowszy wzorzec |
|---|---|---|
Niespójne nazewnictwo | Podzielone metryki, uszkodzone złączenia, zdezorientowani odbiorcy | Standaryzowane nazewnictwo we wszystkich zespołach |
Brakujące właściwości | Analitycy tracą kontekst i opierają się na domysłach | Wymagane pola dla kluczowego kontekstu |
Przeciążone właściwości | Jedno pole oznacza zbyt wiele rzeczy | Zdarzenia o jednym przeznaczeniu i jasne właściwości |
Zduplikowane wyzwalanie | Lejki zawyżają dane, atrybucja staje się niespójna | Deduplikacja na etapie przechwytywania lub pozyskiwania |
Niejawne wartości domyślne | Ukryte wymuszanie typów maskuje rzeczywiste zachowanie | Jawne wartości i udokumentowane reguły |
Najtrudniejszym problemem zazwyczaj nie są złe intencje, ale dryfowanie. Producent zmienia nazwę pola, usuwa właściwość lub zaczyna wysyłać inny kształt danych bez powiadomienia zespołu downstreamowego. Właśnie dlatego dryfowanie schematu tak często uszkadza potoki danych i dlatego katalog zdarzeń wymaga aktywnego zarządzania.
Uważaj na błędy związane z czasem i strefą czasową
Błędy czasowe łatwo przeoczyć, ponieważ zdarzenie i tak dociera. Trafia po prostu do niewłaściwego przedziału, w niewłaściwy dzień lub z błędnym założeniem dotyczącym strefy czasowej. W przypadku metryk operacyjnych i analizy kohortowej może to zmienić narrację bez przerywania zapytania.
Zduplikowane zdarzenia powodują innego rodzaju szkody. Użytkownik klika raz, ale platforma rejestruje to dwukrotnie. Krok w lejku wygląda na skuteczniejszy niż w rzeczywistości. Cecha modelu zostaje zawyżona. Rozwiązaniem zazwyczaj nie jest tworzenie większej liczby pulpitów nawigacyjnych, ale jaśniejsze reguły przechwytywania i logika walidacji.
Praktyczna zasada: jeśli pole może oznaczać dwie różne rzeczy, rozdziel je, zanim dwuznaczność się rozprzestrzeni.
Najbezpieczniejszym nawykiem podczas przeglądu jest prześledzenie każdego zdarzenia od producenta do pulpitu nawigacyjnego i zadanie jednego pytania na każdym etapie: „Czy to nadal oznacza to samo?”. Jeśli odpowiedź się zmienia, kontrakt wymaga dopracowania, zanim kolejni odbiorcy zaczną na nim polegać.
Walidacja jakości zdarzeń za pomocą kontraktów i obserwowalnych sygnałów
Zdarzenie analityczne powinno zachowywać się jak żywy kontrakt. Porozumienie jest zawierane zanim ktokolwiek wdroży zmiany, a następnie potok stale sprawdza, czy rzeczywiste zdarzenia nadal pasują do niego na produkcji. Na tym podejściu opartym na kontraktach opiera się przewodnik po kontraktach danych.
Pięć sygnałów, które ujawniają różne rodzaje problemów
Nowoczesna Observability zazwyczaj śledzi świeżość, jakość, wolumen, schemat i pochodzenie (lineage) jak opisano w modelu observability. Świeżość odpowiada na pytanie, czy dane dotarły w oczekiwanym czasie. Jakość sprawdza, czy wartości i typy nadal mają sens. Wolumen sprawdza, czy liczba wygląda normalnie. Schemat weryfikuje, czy struktura uległa zmianie. Pochodzenie (lineage) pokazuje, skąd dane pochodzą i jak się przemieszczały.
Każdy sygnał wskazuje na inny tryb awarii. Świeżość pozwala wyłapać opóźnione lub brakujące dostawy, zanim pulpity nawigacyjne zaczną dryfować, dlatego okna dostaw powinny odpowiadać sposobowi, w jaki firma wykorzystuje dane zgodnie ze wskazówkami dotyczącymi Timeliness. Monitorowanie schematu wykrywa dodane, usunięte i zmienione pola oraz zmiany typów, co jest dokładnie tym, co ma ujawnić monitorowanie dryfu schematu jak opisano w przeglądzie monitorowania schematu.
W przypadku ruchu o charakterze impulsowym linie bazowe wygrywają ze stałymi progami
Ruch związany ze zdarzeniami rzadko pozostaje na stałym poziomie. Premiery, kampanie i cykle biznesowe zmieniają kształt strumienia. Ruchome, uwzględniające sezonowość linie bazowe sprawdzają się lepiej niż stałe progi dla wielu strumieni zdarzeń, ponieważ porównują bieżące zachowanie z podobnym okresem, zamiast zakładać, że każdy dzień powinien wyglądać identycznie jak zalecają praktyki wykrywania dryfu zdarzeń.
Walidacja kontraktu powinna odbywać się jak najwcześniej, najlepiej na etapie pozyskiwania danych. Zmiany o charakterze addytywnym mogą być bezpieczne, jeśli zachowują kompatybilność wsteczną. Zmiany powodujące brak kompatybilności powinny być poddawane kwarantannie. Surowe pola powinny pozostać dostępne, gdyby konwersja typów miała wymazać znaczenie. Taka dyscyplina ogranicza ciche awarie i zapobiega rozprzestrzenianiu się szumu informacyjnego o alertach w zespole zgodnie ze wskazówkami dotyczącymi kontraktów strumieni zdarzeń.
Sygnał | Na co odpowiada | Jaką awarię może ujawnić |
|---|---|---|
Świeżość | Czy dotarło na czas? | Opóźnione załadunki, pominięte dostawy |
Jakość | Czy dane są prawidłowe? | Błędne typy, nieprawidłowe wartości |
Wolumen | Czy liczba jest zgodna z oczekiwaniami? | Brakujące partie, zalew duplikatów |
Schemat | Czy struktura uległa zmianie? | Dodane, usunięte, zmienione pola |
Pochodzenie (lineage) | Skąd to pochodzi? | Niejasne źródło, ukryta transformacja |
Celem nie jest tworzenie większej liczby reguł. Chodzi o uczynienie zachowania zdarzeń na tyle widocznym, aby analitycy i inżynierowie mogli ufać danym bez konieczności czytania każdego wiersza logu.
Wprowadzanie Event Observability w życie z digna
Operacjonalizacja jakości zdarzeń oznacza traktowanie potoku jak żywego systemu, a nie statycznego zasobu. Zespoły potrzebują sposobu na kontrolowanie czasu dostarczania, wykrywanie zmian strukturalnych i ujawnianie nietypowych zachowań bez konieczności tworzenia osobnej reguły dla każdego zbioru danych.
digna realizuje to poprzez działanie bezpośrednio w środowisku klienta i wykonywanie testów wewnątrz bazy danych, dzięki czemu dane pozostają na swoim miejscu. Zestaw modułów obejmuje Timeliness, śledzenie schematu, Data Validation oraz Data Anomalies, ze wspólnym pulpitem nawigacyjnym dla inżynierów, analityków i interesariuszy odpowiedzialnych za governance. Taka konfiguracja ma znaczenie, ponieważ ten sam strumień zdarzeń często musi jednocześnie obsługiwać raportowanie, alerty i dane wejściowe modeli.
Dla zespołów, które chcą poznać szerszy punkt odniesienia, przegląd Data Observability pokazuje, jak te elementy pasują do siebie w środowiskach produkcyjnych. Podstawowa idea jest prosta. Kontrole Timeliness weryfikują oczekiwane okna dostaw. Śledzenie schematu wychwytuje dodane lub usunięte pola oraz zmiany typów. Wykrywanie anomalii potrafi nauczyć się normalnego zachowania i ujawnić odchylenia bez ręcznie tworzonych reguł.
To połączenie jest szczególnie przydatne, gdy zespoły produktowe często wdrażają zmiany. Zmiana, która wygląda na nieszkodliwą w pull request, może nadal zmienić kształt zdarzenia, opóźnić zasilanie danymi lub wpłynąć na liczbę zdarzeń downstream. Monitorowanie pozwala wychwycić ten efekt tam, gdzie ma to znaczenie – na rzeczywistej ścieżce danych.
Jeśli porównujesz narzędzia operacyjne dla systemów generujących dużą liczbę zdarzeń, narzędzia rynku predykcyjnego polybacktest stanowią przydatne, powiązane odniesienie do tego, jak myślenie w kategoriach observability ujawnia się w innych przepływach pracy opartych na zdarzeniach. Ogólna lekcja przekłada się bezpośrednio, ponieważ dane o zdarzeniach stają się wiarygodne wtedy, gdy ich jakość jest mierzona w sposób ciągły, a nie zakładana po wdrożeniu.
Budowanie niezawodnych zdarzeń analitycznych w perspektywie długoterminowej
Niezawodne zdarzenia nie dzieją się same z siebie. Wynikają one z łańcucha decyzji, od pierwszej definicji działania po kontrole, które dbają o to, by ta definicja pozostała rzetelna w czasie. Jeśli jedno ogniwo jest słabe, odczuwa to cały stos analityczny.
Najprostszym sposobem na ustalenie priorytetów jest zadanie trzech pytań. Które zdarzenia wpływają na najważniejsze decyzje? Które z nich najprawdopodobniej ulegną przesunięciu wraz ze zmianami produktu? Które z nich nie mają jasnego właściciela? Zajmij się nimi w pierwszej kolejności, ponieważ to właśnie te zdarzenia najprawdopodobniej powodują ciche szkody analityczne.
Własność ma tak samo duże znaczenie jak narzędzia. Inżynierowie muszą wiedzieć, kto zatwierdza zmiany schematu. Analitycy muszą wiedzieć, które definicje są stabilne. Zespoły ds. governance potrzebują wglądu w to, co i kiedy się zmieniło. Gdy te role są jasne, jakość zdarzeń przestaje być problemem wszystkich, a staje się zarządzanym procesem.
Długoterminową korzyścią są nie tylko czystsze pulpity nawigacyjne. To szybsza analiza, mniej poprawek i większa pewność, gdy zespoły wykorzystują analitykę do kierowania produktem i systemami AI. Jeśli Twój katalog zdarzeń nadal wydaje się niestabilny, zweryfikuj definicje, zacieśnij kontrakty i umieść observability na krytycznej ścieżce, zanim kolejny cichy dryf trafi na produkcję.
Jeśli chcesz w praktyczny sposób zwiększyć zaufanie do danych o zdarzeniach, odwiedź witrynę digna i sprawdź, jak jej weryfikacja w bazie danych, śledzenie schematu, monitorowanie Timeliness i wykrywanie anomalii łączą się w jeden operacyjny przepływ pracy. Narzędzie zostało stworzone dla zespołów, które potrzebują, aby niezawodne zdarzenia analityczne pozostały niezawodne w miarę ciągłych zmian produktów, potoków i odbiorców.
Najczęściej zadawane pytania
Czym jest zdarzenie w analityce danych?
To pokwitowanie działania. Każde solidne zdarzenie potrzebuje trzech składników: akcji, kontekstu i czasu. Jeśli nie potrafisz wyjaśnić tych trzech prostym językiem, zdarzenie jest wciąż zbyt luźne, by mu ufać, niezależnie od tego, co mówi plan śledzenia.
Czym zdarzenie różni się od encji albo sesji?
Zdarzenie zapisuje, że coś wydarzyło się w danym momencie, encja opisuje rzecz trwającą, a sesja grupuje aktywność w oknie czasu. Mylenie ich to częsty błąd modelowania i powód, dla którego wskaźniki niżej w łańcuchu przestają się zgadzać.
Jak nazywać i strukturyzować zdarzenia?
Zacznij od powściągliwości. Zbuduj trwałą taksonomię z szerokich kategorii, takich jak akcje użytkownika i zdarzenia systemowe, a potem świadomie decyduj, czy nowy szczegół zasługuje na własne zdarzenie, czy na właściwość. Każde zdarzenie potrzebuje też krótkiej listy pól obowiązkowych, które czynią rekord użytecznym.
Dlaczego dane zdarzeń dryfują?
Bo znaczenie zmienia się szybciej niż kod śledzenia. Zdarzenie technicznie wciąż istnieje, gdy jego semantyka przesuwa się pod spodem, więc pulpity wyglądają spokojnie, a liczby przestają zgadzać się z tym, co widzą sprzedaż, produkt i wsparcie. Zdarzenie jest użyteczne tylko dopóty, dopóki jego znaczenie pozostaje stabilne.
Dlaczego rozwiązywanie tożsamości wymaga namysłu?
Bo decyduje o tym, czy zdarzenia dotyczące tej samej osoby faktycznie się połączą. Ustal wymagane pola tożsamości przy projektowaniu modelu, zamiast łatać je później, i udokumentuj tę decyzję, bo dokumentacja liczy się tu tak samo jak nazewnictwo.



