Zarządzanie ryzykiem jakości danych: Praktyczny przewodnik
|
8
min. czyt.
Pulpit nawigacyjny jest nieaktualny, ale potok ma status zielony. Model generuje nieznane wyniki, mimo że żadne wdrożenie nie uległo zmianie. Raport regulacyjny zawiera niespójne sumy, a dochodzenie rozpoczyna się od gorączkowego przeszukiwania logów pozyskiwania, kodu transformacji i arkuszy kalkulacyjnych. W każdym przypadku widoczna awaria pojawia się na końcu procesu, podczas gdy podstawowy problem z jakością mógł pojawić się znacznie wcześniej.
Ten wzorzec jest dobrze znany inżynierom danych, ponieważ tradycyjne działania związane z jakością danych często rozpoczynają się dopiero po tym, jak ktoś zauważy szkody biznesowe. Zespoły naprawiają rekordy, aktualizują regułę, ponownie uruchamiają zadanie i idą dalej. Ta sama słabość powraca, gdy źródło nadrzędne zmienia swój schemat, dostawa dociera z opóźnieniem lub wskaźnik wykracza poza swoje normalne zachowanie.
Zarządzanie ryzykiem jakości danych traktuje te zdarzenia jako awarie kontroli, a nie odizolowane zgłoszenia do oczyszczenia. Praktycznym celem jest wykrywanie nietypowych zachowań, walidacja krytycznych rekordów, śledzenie oczekiwań dotyczących dostaw i kierowanie incydentów, zanim wpłyną one na decyzje, zgodność (Compliance) lub systemy skierowane do klientów. Ma to znaczenie w skali przedsiębiorstwa, ponieważ powszechnie cytowane szacunki IBM określiły roczny koszt niskiej jakości danych w Stanach Zjednoczonych na około 3,1 biliona dolarów w 2016 roku (Dyskusja społeczności SAP na temat szacunków IBM).
Spis treści
Dlaczego zarządzanie ryzykiem jakości danych ma teraz znaczenie
Koszt reaktywnego oczyszczania
Zrozumienie wymiarów ryzyka jakości danych
Dopasowanie wymiarów do trybów awarii
Priorytetyzacja według konsekwencji
Budowanie rejestru ryzyka jakości danych
Używanie pól operacyjnych
Przykładowe wpisy w rejestrze ryzyka jakości danych
Strategie monitorowania, które wcześnie wykrywają ryzyka
Wykrywanie anomalii
Monitorowanie terminowości (Timeliness)
Monitorowanie zmian schematu
Projektowanie kontroli i przepływów eskalacji
Umieszczanie walidacji blisko danych
Kierowanie alertów według wpływu
Walidacja założeń statystycznych
Mierzenie efektywności programu i iteracja
Mierzenie jakości sygnału, a nie wolumenu alertów
Przegląd rejestru jako artefaktu kontrolnego
Wprowadzenie do programu ryzyka jakości danych
Rozszerzanie w kontrolowanych przyrostach
Dlaczego zarządzanie ryzykiem jakości danych ma teraz znaczenie
Zespół ds. danych może mieć niezawodną orkiestrację, pomyślne statusy zadań i rozbudowane testy jednostkowe, a mimo to dostarczać bezużyteczne dane. Źródło może wysłać prawidłowy plik z niekompletną populacją biznesową. Tabela może załadować się pomyślnie ze zmienioną nazwą kolumny. Raport może odświeżać się zgodnie z harmonogramem przy użyciu rekordów, które nie pasują już do założeń leżących u podstaw jego obliczeń.
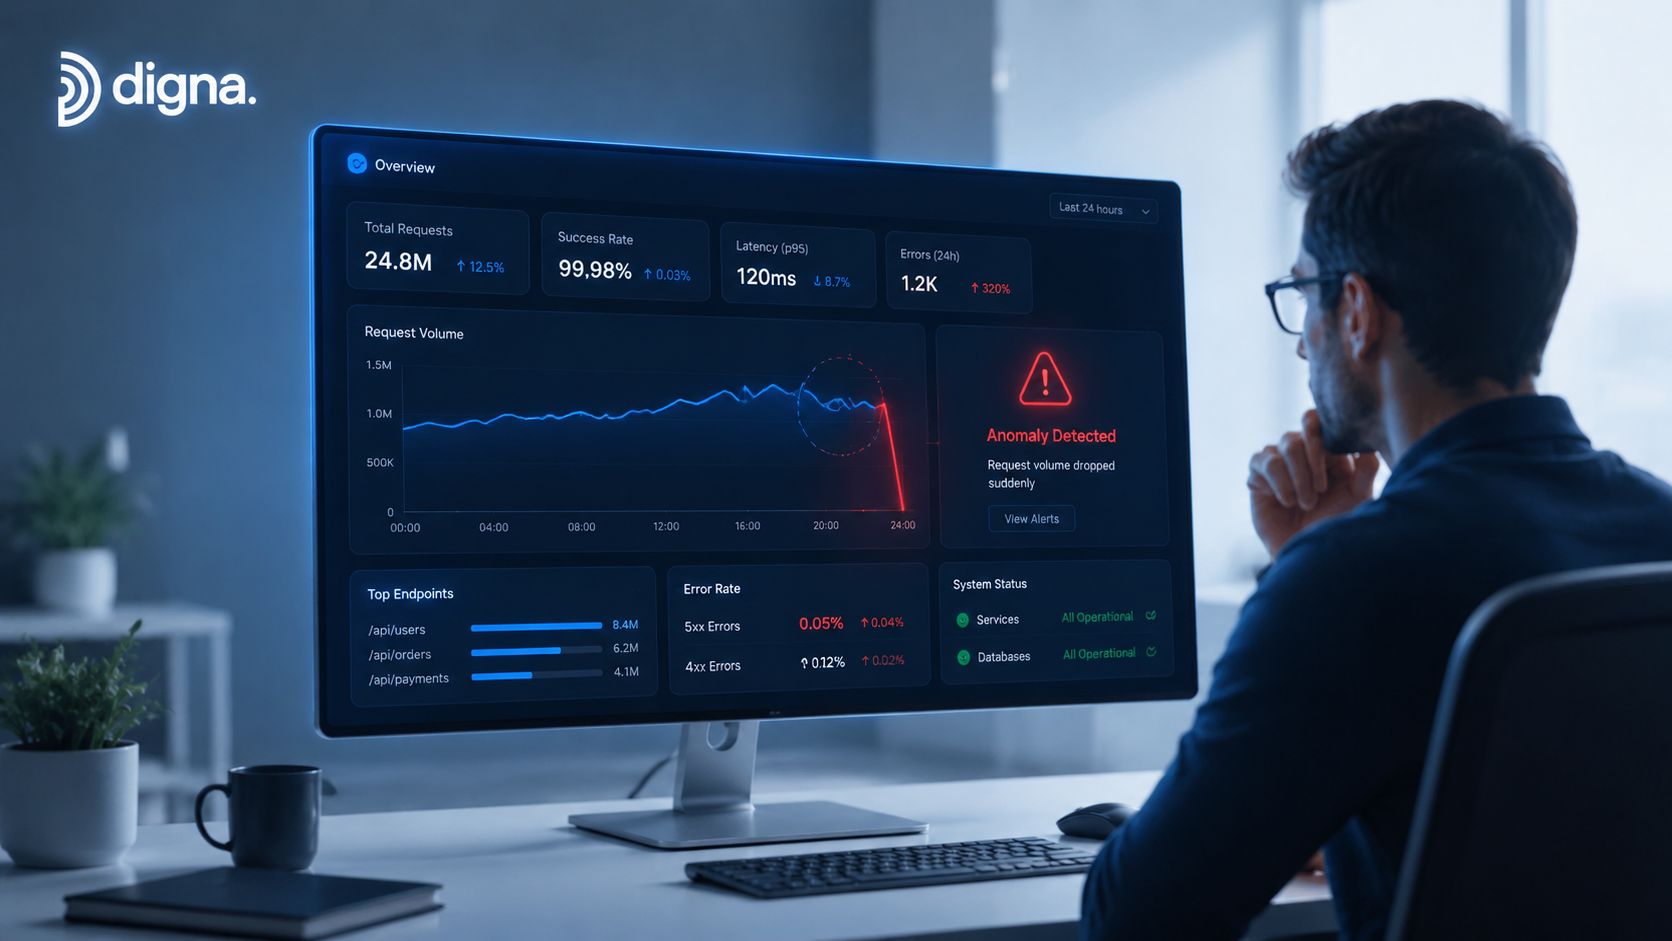
Symptom produkcyjny zazwyczaj decyduje o tym, kto zostanie wezwany. Analitycy widzą nieaktualny pulpit nawigacyjny. Zespoły ds. zgodności (Compliance) znajdują niespójność. Badacze danych kwestionują wyniki modelu. Inżynierowie śledzą następnie problem w systemach, z których każdy zgłosił sukces. To dochodzenie jest kosztowne, ponieważ techniczna sprawność potoku i przydatność jego danych do użycia to dwa różne pytania kontrolne.
Koszt reaktywnego oczyszczania
Ręczne utrzymywanie reguł sprawdza się, dopóki liczba źródeł, tabel i przypadków użycia pozostaje możliwa do zarządzania. Przestaje działać, gdy zespoły muszą ręcznie kodować każdą oczekiwaną wartość, wzorzec dostawy i zmienność strukturalną. Okresowe audyty mają podobne ograniczenie. Mogą zidentyfikować historyczne błędy, ale nie wykryją niezawodnie cichej awarii między cyklami przeglądu.
Ciągły program obserwuje zachowanie, zamiast czekać na skargę. Porównuje bieżący wolumen i dystrybucje z ustalonymi liniami bazowymi, ocenia, czy dane dotarły wtedy, gdy użytkownicy ich potrzebowali, i identyfikuje zmiany strukturalne, zanim zawiedzie logika niższego szczebla. Walidacja na poziomie rekordów dodaje osobną warstwę dla reguł biznesowych, których zagregowane monitorowanie nie jest w stanie wykryć.
Zasada operacyjna: Zielony status potoku dowodzi jedynie, że przepływ pracy został zakończony. Nie dowodzi to, że powstałe dane są dokładne, terminowe (Timeliness), spójne ani przydatne do podjęcia decyzji.
Zmiana ma również charakter organizacyjny. Jakość danych staje się wspólną dyscypliną ryzyka, z właścicielami, poziomami ważności, ścieżkami reagowania i dowodami. Przydatny przegląd wartości biznesowej stojącej za tym podejściem jest dostępny w wyjaśnieniu korzyści płynących z jakości danych według digna, ale kwestia wdrożenia pozostaje operacyjna: które awarie mają największe znaczenie, jak zespół je wykryje i co stanie się po alercie?
Zespoły powinny zacząć od produktów danych, które wpływają na raportowanie regulowane, decyzje finansowe, operacje na klientach lub uczenie maszynowe. Nie muszą monitorować wszystkiego natychmiast. Potrzebują kontroli w punktach, w których niewykryty defekt zmieniłby wynik.
Zrozumienie wymiarów ryzyka jakości danych
Potok może zakończyć się pomyślnie, podczas gdy jego dane wyjściowe pozostają niebezpieczne. Dokładna numerycznie tabela, która dociera po terminie raportowania, jest operacyjnie bezużyteczna. Kompletna tabela ze sprzecznymi definicjami w różnych systemach może dawać wprowadzający w błąd obraz przedsiębiorstwa. Świeży zestaw danych z nieoczekiwaną zmianą typu może zakłócić pracę odbiorców niższego szczebla bez zmiany jakichkolwiek wartości.
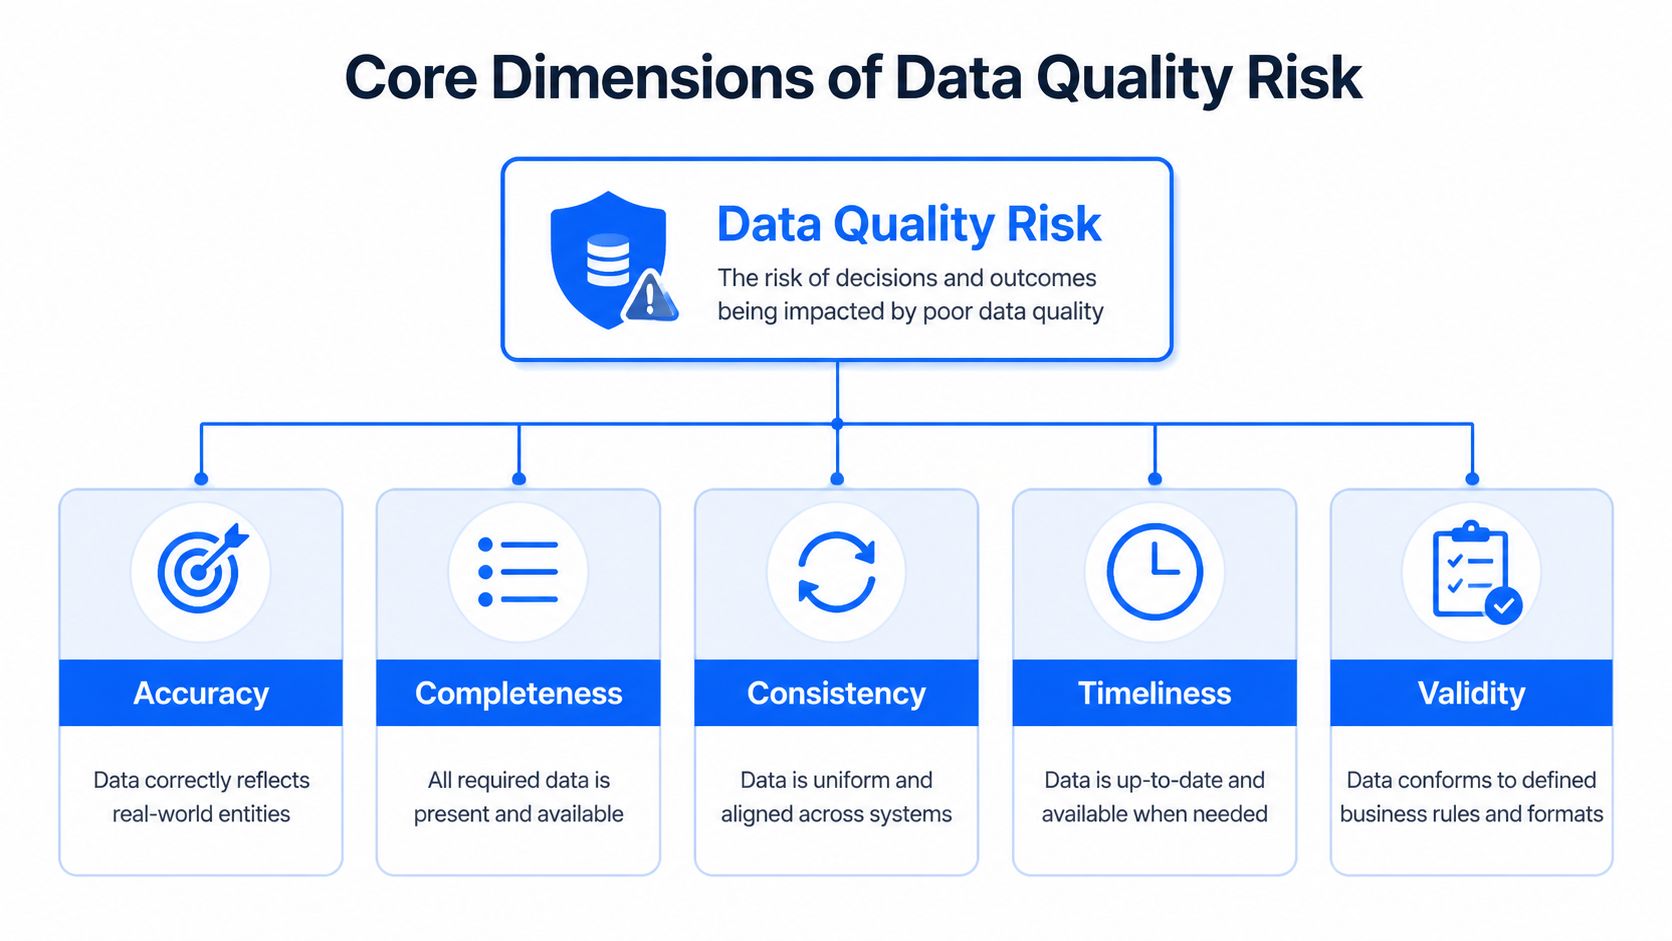
Ryzyko jakości wymaga zatem wymiarów, które odpowiadają obserwowalnym trybom awarii. ISO 8000-61:2016 definiuje procesy zarządzania jakością danych, podczas gdy ramy oceny jakości danych MFW organizują jakość wokół integralności, metodologicznej solidności, dokładności i wiarygodności, użyteczności i dostępności (odniesienie do ISO 8000-61, Ramy oceny jakości danych MFW). Te odniesienia wspierają powtarzalną ocenę zamiast jednorazowego oczyszczania. Zespoły mogą również zapoznać się z tym praktycznym przewodnikiem po wymiarach jakości danych podczas definiowania swojego słownictwa kontrolnego.
Dopasowanie wymiarów do trybów awarii
Dokładność pyta, czy rekordy reprezentują świat lub zdarzenia, które opisują. Nieprawidłowy status konta, kwota lub identyfikator klienta mogą zniekształcić decyzję, nawet jeśli obecny jest każdy oczekiwany wiersz.
Kompletność obejmuje wymagane rekordy i pola. Brak opcjonalnych atrybutów może być tolerowany, podczas gdy brak identyfikatorów lub pól regulacyjnych może zatrzymać proces.
Spójność, nazywana spójnością w niektórych wytycznych statystycznych, sprawdza, czy definicje i wartości są zgodne w różnych systemach. Różne reprezentacje tego samego klienta, produktu lub transakcji powodują konieczność uzgadniania i mogą podważać raportowanie.
Terminowość (Timeliness) mierzy, czy dane są dostępne wtedy, gdy ich odbiorca ich potrzebuje. Codzienny zestaw danych planistycznych i operacyjny strumień danych o ryzyku mają różne oczekiwania dotyczące dostawy, dlatego monitorowanie musi stosować progi specyficzne dla danego produktu.
Poprawność sprawdza formaty, domeny, relacje i reguły biznesowe. Wartość może mieć poprawny typ danych i nadal naruszać dozwolony status lub relację.
Priorytetyzacja według konsekwencji
Monitorowanie każdej kolumny w stopniu równym marnuje wysiłek inżynieryjny i generuje szum alertów. Klasyfikuj produkty danych według krytyczności, identyfikuj wymiary, które mogą zmienić decyzję, i powiąż każde ryzyko z kontrolą. Używaj wykrywania anomalii w przypadku nieoczekiwanych zmian wolumenu lub dystrybucji, kontroli terminowości (Timeliness) w przypadku opóźnionych lub brakujących ładunków oraz śledzenia schematu w przypadku zmian strukturalnych, zanim odbiorcy napotkają błędy. Wytyczne MFW uwzględniają również relewantność, dokładność, terminowość (Timeliness), spójność, interpretowalność i dostępność, więc dokładność nie powinna stać się jedynym monitorowanym wymiarem.
Praktyczna ocena stawia trzy pytania:
Co może się zmienić? Zidentyfikuj decyzję, raport, model lub proces, na który ma to wpływ.
Jak objawiłaby się awaria? Zdefiniuj sygnał, taki jak brakujący ładunek, przesunięcie dystrybucji, nieprawidłowy rekord lub modyfikacja schematu.
Jaka reakcja jest proporcjonalna? Wybierz blokadę, ostrzeżenie, zgłoszenie lub przegląd trendów na podstawie wpływu i pewności.
To mapowanie chroni zespoły przed monitorowaniem tego, co jest jedynie łatwe do zmierzenia. Wymiar jakości staje się operacyjnie użyteczny, gdy łączy się ze wskazanym odbiorcą, obserwowalnym sygnałem i zdefiniowaną reakcją.
Budowanie rejestru ryzyka jakości danych
Rejestr ryzyka powinien pomóc inżynierowi zdecydować, co sprawdzić o drugiej w nocy. Ogólne wpisy, takie jak „dane klientów mogą być niedokładne”, nie dają jasnych wytycznych do działania, wymagań dotyczących dowodów ani ścieżki eskalacji.
Zacznij od zasobów danych, które wspierają decyzje, raporty, modele lub operacyjne przepływy pracy. Dla każdego zasobu zapisz jego właściciela, odbiorców, oczekiwania dotyczące dostawy, wrażliwe pola, zależności nadrzędne i znane tryby awarii. Następnie opisz każde ryzyko jako przyczynę, zdarzenie i konsekwencję. „Zespół nadrzędny usuwa wymagane pole, powodując, że potok kwalifikacji klientów generuje niekompletne decyzje” daje osobom reagującym znacznie więcej wskazówek niż „dryf schematu”.
Używanie pól operacyjnych
Każdy wpis wymaga wystarczających szczegółów, aby nadać priorytet pracom i wesprzeć reakcję:
Opis ryzyka: Określ awarię i jej konsekwencje biznesowe.
Ważność: Opisz wpływ, jeśli zdarzenie dotrze do odbiorcy. Używaj pojęć: krytyczny, wysoki, średni lub niski, zgodnie z definicjami uzgodnionymi wewnętrznie.
Prawdopodobieństwo: Oprzyj je na zaobserwowanej historii, zachowaniu źródła, częstotliwości zmian i złożoności procesu, a nie na intuicji.
Właściciel: Przypisz osobę lub zespół zdolny do zbadania sprawy i koordynowania naprawy.
Łagodzenie skutków: Nazwij kontrolę, bramkę, mechanizm awaryjny, uzgadnianie lub działanie eskalacyjne.
Dowód: Przechowuj historię alertów, wyniki walidacji, pochodzenie i notatki z rozwiązania problemu.
Status przeglądu: Zapisz, czy kontrola jest aktywna, generuje szum, brakuje jej, czy jest w trakcie ponownej oceny.
Rejestr powinien odróżniać problem źródłowy od problemu z wykrywaniem. Jeśli dostawa jest opóźniona, zespół źródłowy może odpowiadać za naprawę, podczas gdy zespół platformy odpowiada za monitorowanie terminowości (Timeliness). Taki podział pozwala zachować precyzyjną odpowiedzialność i zapobiega sytuacji, w której alert staje się substytutem naprawy.
W przypadku pól o wysokim priorytecie katalog krytycznych elementów danych może pomóc zespołom skoncentrować kontrolę na rekordach i atrybutach najbardziej podatnych na wpływ na decyzje.
Przykładowe wpisy w rejestrze ryzyka jakości danych
Opis ryzyka | Ważność | Prawdopodobieństwo | Właściciel | Strategia łagodzenia |
|---|---|---|---|---|
Wymagana kolumna nadrzędna zostaje usunięta lub zmieniono jej nazwę, co powoduje uszkodzenie transformacji niższego szczebla | Wysoka | Średnie | Zespół platformy danych | Śledzenie zmian schematu, testowanie zgodności i zatrzymywanie zależnych zadań, gdy zmiana narusza kontrakt |
Krytyczny potok dociera po oknie raportowania odbiorcy | Wysoka | Średnie | Właściciel systemu źródłowego | Monitorowanie wzorców przybycia, obliczanie oczekiwanego czasu dostawy i eskalowanie pominiętych ładunków |
Reguła biznesowa różni się między systemami operacyjnymi i analitycznymi | Wysoka | Średnie | Właściciel domeny danych | Uruchamianie walidacji na poziomie rekordów i uzgadnianie wyników między systemami |
Świeżość spada bez awarii zadania | Średnia | Średnie | Zespół inżynierii analiz | Monitorowanie dostaw i aktualizowanie progów w przypadku zmiany zachowania źródła |
Pola opcjonalne stają się nieoczekiwanie puste w całej populacji źródłowej | Średnia | Niskie | Koordynator danych | Śledzenie dystrybucji, badanie zmian u źródła i dokumentowanie zaakceptowanych wyjątków |
Traktuj rejestr jako działający rekord kontrolny, a nie jednorazowy dokument ładu (governance). Przeglądaj go, gdy zmienia się źródło, metoda integracji, model lub proces biznesowy. Zintegrowane produkty danych mogą wprowadzać ryzyko poprzez powiązanie, harmonizację lub modelowanie, a nie tylko poprzez oryginalne źródło. Zmiana schematu, opóźniony ładunek lub przesunięcie dystrybucji powinny aktualizować odpowiedni wpis o ryzyku, jego dowody lub właściciela.
Rejestr spełnia swoją rolę, gdy steruje konfiguracją monitorowania, dyskusjami na temat własności i przeglądami incydentów. Powinien pokazywać, które ryzyka mają aktywne kontrole, które alerty generują szum i które luki nadal wymagają prac inżynieryjnych. To powiązanie pozwala zespołowi przejść od reaktywnego gaszenia pożarów do ciągłej kontroli.
Strategie monitorowania, które wcześnie wykrywają ryzyka
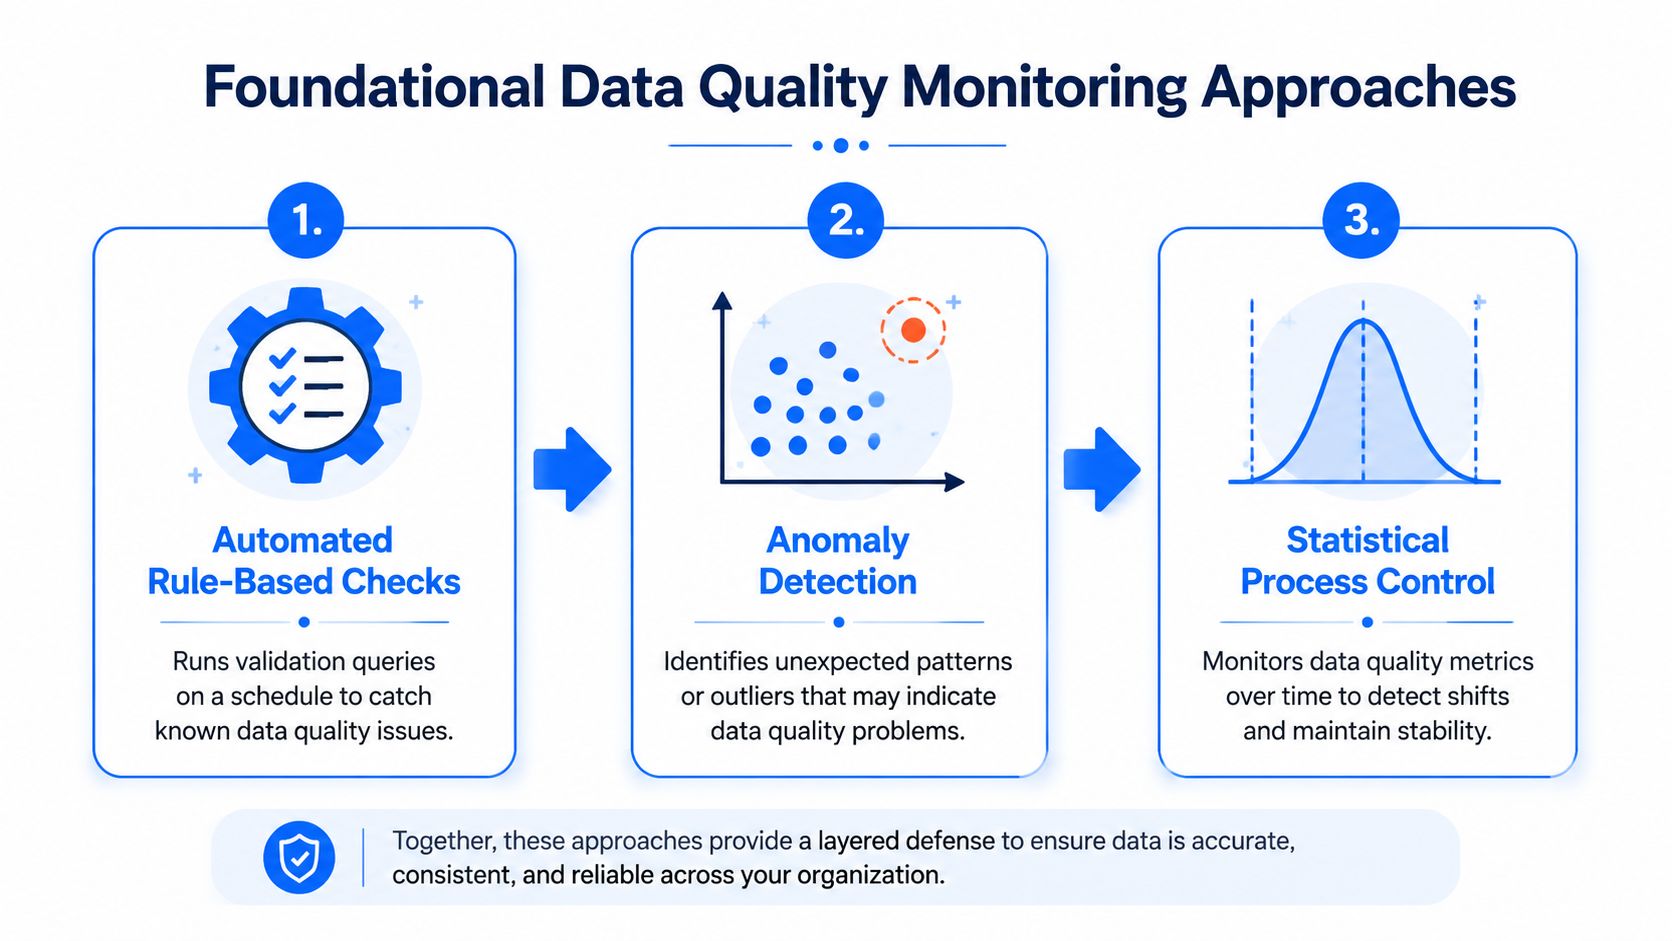
Potok może mieć status zielony, podczas gdy odbiorcy otrzymują bezużyteczne dane. Monitorowanie produkcji wymaga kilku warstw: deterministycznych reguł dla znanych naruszeń, wykrywania anomalii dla nieznanych zachowań, kontroli terminowości (Timeliness) dla ryzyka dostawy oraz śledzenia schematu dla kontraktów strukturalnych.
Wykrywanie anomalii
Uczenie się linii bazowej pomaga, gdy inżynierowie nie mogą zapisać reguły dla każdego prawidłowego wzorca. Monitory mogą badać wolumen, puste zachowania, dystrybucje i wskaźniki biznesowe, a następnie flagować istotne odchylenia od ustalonego zachowania zestawu danych.
Nietypowa wartość nie staje się automatycznie incydentem. Sezonowość, planowane wersje (Release), przejęcia i uzasadnione zdarzenia biznesowe mogą przesunąć linię bazową. Oddziel metryki techniczne od biznesowych, dołącz kontekst operacyjny do alertów i pozwól właścicielom oznaczać zdarzenia jako oczekiwane lub nieoczekiwane. Te decyzje usprawniają późniejsze dochodzenia bez przekształcania każdego wyjątku w stałą regułę ręczną.
Monitorowanie terminowości (Timeliness)
Ładunek może zakończyć się sukcesem, ale dotrzeć za późno dla odbiorców. Śledź wzorce przybycia każdego krytycznego zestawu danych, w tym brakujące, opóźnione i nieoczekiwanie wczesne dostawy. Oblicz oczekiwane okno dostawy na podstawie zaobserwowanego zachowania, a następnie ustaw reakcję zgodnie z terminem odbiorcy.
Opóźniony strumień danych może uzasadniać ostrzeżenie, gdy pulpit nawigacyjny niższego szczebla ma tryb awaryjny. To samo opóźnienie może wymagać eskalacji, gdy wpływa na złożenie sprawozdania regulacyjnego lub obliczenie ryzyka. Komunikaty alertów powinny zawierać informację o ostatnim udanym przybyciu, oczekiwanym oknie, produktach, na które ma to wpływ, oraz właścicielu, który może potwierdzić status źródła.
Zespoły formalizujące projektowanie powiadomień mogą skorzystać z tego przewodnika po alertach w czasie rzeczywistym, aby ustrukturyzować alerty wokół odpowiedniej osoby reagującej i ograniczyć szum, którego można uniknąć.
Monitorowanie zmian schematu
Dryf schematu powoduje dezorientujące incydenty, ponieważ źródło może pozostać dostępne, podczas gdy odbiorcy niepoprawnie interpretują jego dane wyjściowe. Śledź dodane i usunięte kolumny, zmienione nazwy pól, modyfikacje typów danych oraz zmiany, które naruszają udokumentowany kontrakt.
Kompatybilny dodatek może wymagać przeglądu bez konieczności przestoju. Usunięcie wymaganego pola lub zmiana typu powinna zasadniczo wstrzymać przetwarzanie zależne, dopóki właściciel nie potwierdzi wpływu. Przechowuj schemat przed i po wraz z alertem, aby inżynierowie nie musieli rekonstruować zmiany z logów wdrożeniowych.
Sygnały te są najbardziej użyteczne w jednym widoku operacyjnym. Podejście do monitorowania i raportowania danych powinno pokazywać anomalię, historię dostaw, zdarzenie schematu, zasób, którego dotyczy problem, oraz bieżący status incydentu razem. Narzędzie ma mniejsze znaczenie niż zachowanie kontekstu od wykrycia do rozwiązania, dzięki czemu zespoły mogą zastąpić reaktywne gaszenie pożarów ciągłą kontrolą.
Projektowanie kontroli i przepływów eskalacji
Alert staje się kontrolą dopiero wtedy, gdy zespół zdefiniuje reakcję, dyspozycję danych, odpowiedzialnego właściciela i dowody wymagane do zamknięcia. Bez tych decyzji monitorowanie generuje powiadomienia, ale nie ogranicza ekspozycji na dalszych etapach.
Używaj twardych kontroli, gdy nieprawidłowe dane nie mogą się rozprzestrzeniać. Potok może odrzucić rekord z niemożliwą relacją, wstrzymać publikowanie na dalszym etapie, gdy zniknie wymagane pole schematu, lub poddać kwarantannie partię, która narusza krytyczny kontrakt. Używaj miękkich kontroli w przypadku nietypowych, ale potencjalnie uzasadnionych działań, takich jak nieoczekiwana zmiana wolumenu biznesowego, która wymaga weryfikacji przez człowieka, a nie automatycznego blokowania.

Umieszczanie walidacji blisko danych
Kontrole na poziomie rekordów wymuszają reguły, których zagregowane metryki nie mogą udowodnić. Waliduj wymagane pola, dozwolone wartości, relacje między podmiotami, daty wejścia w życie, warunki duplikacji oraz wymagania regulacyjne lub umowne. Uruchamiaj te kontrole w bazie danych, gdzie jest to praktyczne. Utrzymywanie obliczeń blisko danych ogranicza ich ruch, respektuje granice bezpieczeństwa i pozwala uniknąć ładowania dużych tabel do pamięci aplikacji.
Praktyczny wzorzec inżynieryjny łączy ustandaryzowane ramy dla oczekiwań schematu z bezpośrednim SQL dla dużych kontroli reguł biznesowych. SecurityScorecard opisuje użycie Great Expectations do walidacji schematów, DataHub do scentralizowanej widoczności i Apache Airflow do orkiestracji. Jego zespół umieścił kontrole reguł biznesowych w SQL po stronie bazy danych, zamiast pobierać bardzo duże tabele do Pythona (konto walidacji potoku).
Zasada projektowania kontroli: Zatrzymaj potok, gdy oczekiwana szkoda biznesowa wynikająca z rozprzestrzeniania się danych przewyższa operacyjny koszt jego zablokowania.
Kierowanie alertów według wpływu
Użyteczna ścieżka eskalacji rejestruje cztery decyzje:
Wykryto problem: Przechwyć dokładną kontrolę, zaobserwowaną wartość, oczekiwane zachowanie, znacznik czasu i zasób, którego dotyczy problem.
Alert dla zespołu: Powiadom właściciela, który może przeprowadzić dochodzenie, a nie szeroki kanał bez odpowiedzialnej osoby reagującej.
Analiza wpływu: Zidentyfikuj raporty, modele, odbiorców i procesy regulacyjne na dalszych etapach.
Zgłoszenie rozwiązania: Zapisz poprawkę, dyspozycję danych, przyczynę źródłową i dowody potwierdzające zamknięcie.
Wezwij dyżurnego inżyniera lub właściciela danych w przypadku zdarzeń, które mogą uszkodzić krytyczne produkty. Odchylenia o niższym wpływie wysyłaj do kolejki przeglądu. Jednakowa pilność uczy osoby reagujące ignorowania systemu.
Zespoły formalizujące ścieżki własności i reagowania mogą skorzystać z tego przewodnika wspierającego eskalację w celu zdefiniowania tras i obowiązków. Wspólny widok incydentów powinien zachować otwarte problemy, zasoby, których dotyczy problem, historię nawrotów i bieżący status, dając inżynierom, analitykom i interesariuszom te same dowody operacyjne.
Walidacja założeń statystycznych
Wykrywanie anomalii nadal wymaga oceny. Statystyczny przepływ pracy związany z jakością powinien wyjaśniać cele projektu i projekt pobierania próbek, przeglądać dane, wybierać odpowiednią metodę, weryfikować jej założenia, a następnie wyciągać wnioski (statystyczny przepływ pracy związany z jakością).
Ta sekwencja ogranicza liczbę fałszywych alarmów i błędów niewykrycia spowodowanych niezrozumieniem danych. Wartości odstające, nielosowe braki danych, sezonowość lub nieodpowiednie ramy próbkowania mogą wyglądać jak awarie jakości, podczas gdy odzwierciedlają proces pomiaru. Wybierz najprostszą prawidłową metodę, udokumentuj jej założenia i wymagaj przeglądu, gdy te założenia przestaną obowiązywać.
Mierzenie efektywności programu i iteracja
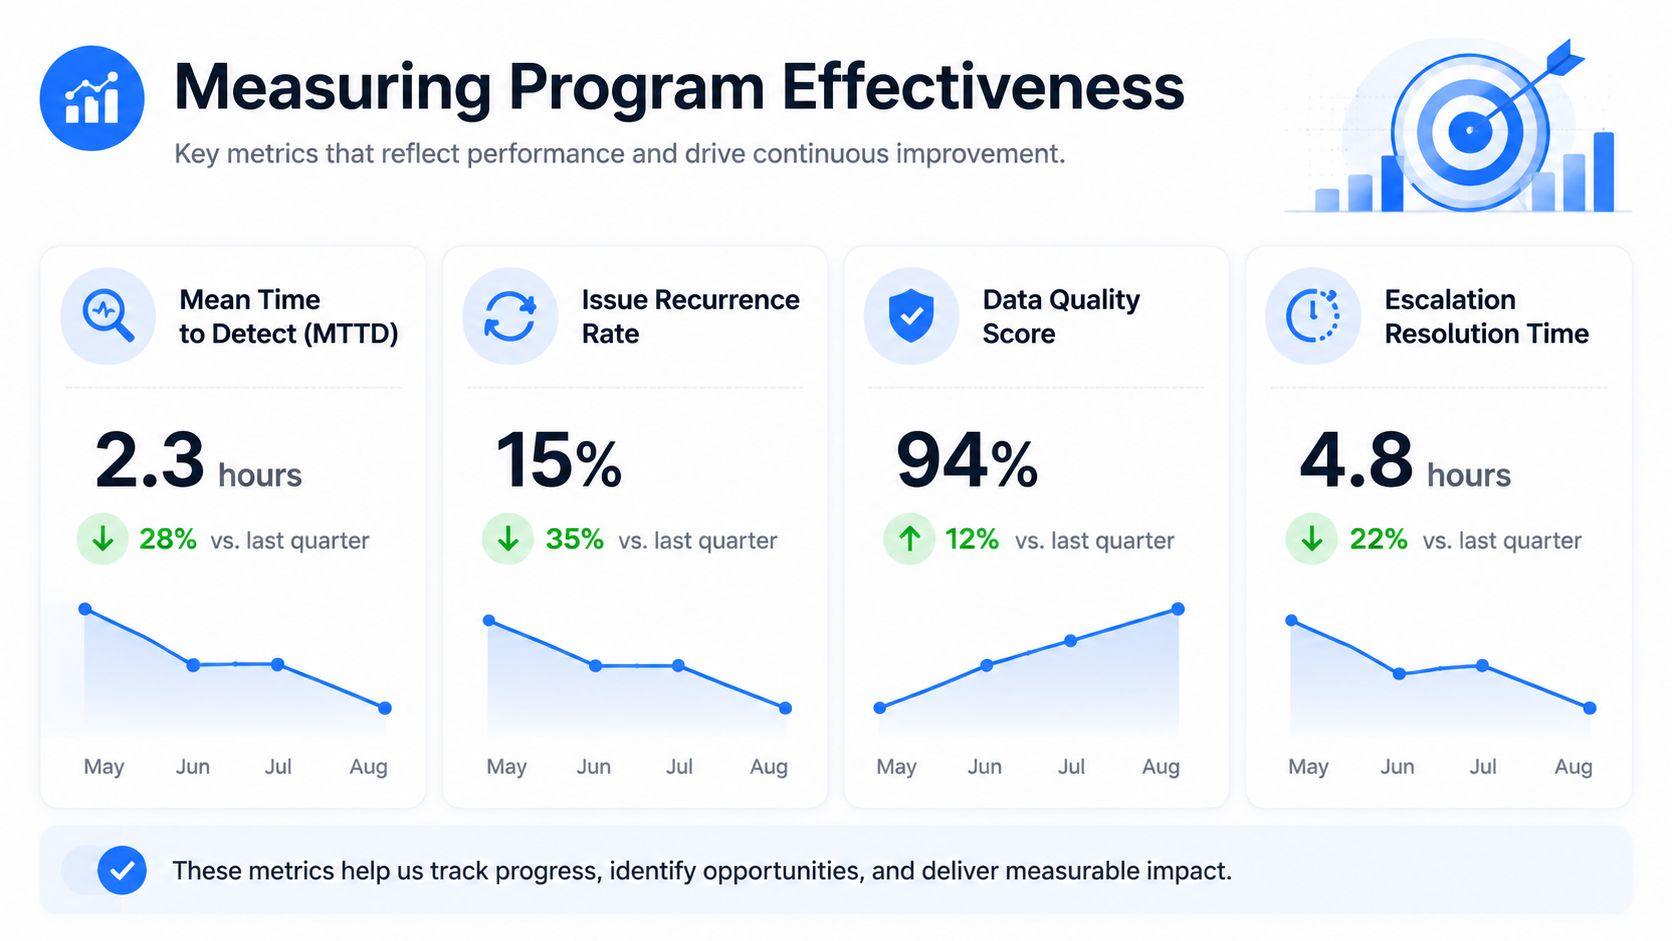
Program jakościowy zasługuje na swoje miejsce w produkcji poprzez zmniejszenie ekspozycji, skrócenie czasu reakcji lub uwidocznienie niepewności. Sam wysoki wynik na pulpicie nawigacyjnym niewiele dowodzi. Miary muszą łączyć wykrywanie, dochodzenie, zachowanie kontroli i wpływ biznesowy.
Śledź średni czas wykrywania, średni czas rozwiązania, nawroty, wskaźnik fałszywych alarmów, pokrycie krytycznych zasobów oraz udział incydentów ze zidentyfikowanym właścicielem. Segmentuj wyniki według ważności i produktu danych. W przeciwnym razie wiele kontroli o niskim wpływie może maskować krytyczny strumień danych o słabych kontrolach. Praktyczne ramy metryk jakości danych mogą pomóc w standaryzacji tych miar w różnych produktach.
Mierzenie jakości sygnału, a nie wolumenu alertów
Szybki alert nadal generuje pracę dochodzeniową, jeśli brakuje mu kontekstu. Sprawdź, czy każde powiadomienie identyfikuje tabelę, której dotyczy problem, zmienione zachowanie, oczekiwaną linię bazową, prawdopodobnego właściciela i dostępną ścieżkę naprawczą. Powtarzające się alerty dla zaakceptowanego wzorca sezonowego zazwyczaj wskazują na problem z progiem lub linią bazową.
Przejrzyj historyczne dane dotyczące Observability pod kątem zmienności, powtarzających się awarii i stopniowego pogarszania się sytuacji. Wykorzystaj te wzorce do dostosowania zakresu monitorowania i siły kontroli. Nie rozszerzaj progów jedynie w celu stłumienia szumu. Zapisz ryzyko, które akceptuje szerszy próg, a następnie zweryfikuj, czy ten kompromis pozostaje uzasadniony.
Problem z zaufaniem może pozostać po wdrożeniu Observability. Z raportu BARC 2025 wynika, że 42% organizacji nadal nie ufa wynikom AI/ML, podczas gdy 58% wdrożyło lub zoptymalizowało programy Data Observability (dyskusja na temat badania BARC). Monitorowanie jest zatem konieczne, ale niewystarczające. Zespoły potrzebują sygnałów o anomaliach wraz z monitorowaniem terminowości (Timeliness), śledzeniem schematów i walidacją na poziomie rekordów, aby wyjaśnić, dlaczego należy ufać modelowi lub pulpitowi nawigacyjnemu.
Przegląd rejestru jako artefaktu kontrolnego
Przeglądy incydentów powinny aktualizować prawdopodobieństwo, ważność, własność i status łagodzenia skutków. Dodaj ryzyko, gdy źródło wprowadza nową metodę integracji lub zmienia się proces biznesowy. Wycofaj kontrolę dopiero po usunięciu leżącego u jej podstaw ryzyka, a nie tylko dlatego, że alerty przestały się pojawiać.
Z raportu KPMG 2026 Global Third-Party Risk Management Survey wynika, że tylko 17% organizacji opisało jakość swoich danych na najwyższym poziomie. Raport wykazał również, że 52% respondentów posiadających dane wysokiej jakości było bardzo pewnych decyzji dotyczących zarządzania ryzykiem, w porównaniu z 40% respondentów o niskiej jakości danych, którzy nie byli pewni (badanie KPMG). Konsekwencja operacyjna jest bezpośrednia: niska jakość danych zmniejsza zaufanie do decyzji, w tym do zautomatyzowanych przepływów pracy związanych z ryzykiem.
Każdy incydent jest dowodem na działanie systemu kontroli. Celem jest szybsze, bardziej precyzyjne wykrywanie poważnych awarii, z jasnym zapisem reakcji organizacji.
Wprowadzenie do programu ryzyka jakości danych
Zacznij od jednego krytycznego produktu danych, a nie od inwentaryzacji w całej firmie. Nazwij jego odbiorców, udokumentuj decyzje, które wspiera, wymien jego nadrzędne zależności i zapisz tryby awarii, które inżynierowie już znają. Następnie wybierz mały zestaw kontrolny obejmujący różne ryzyka, takie jak wykrywanie anomalii dla zachowania, monitorowanie terminowości (Timeliness) dla dostawy, śledzenie schematu dla struktury i walidacja na poziomie rekordów dla logiki biznesowej.
Pierwsza linia bazowa powinna być obserwowalna i możliwa do zweryfikowania. Przechwyć normalne zachowanie przy dostawie, oczekiwany wolumen, ważne dystrybucje, wymagane pola i bieżący schemat. Zdefiniuj, kto otrzymuje alerty i kiedy awaria blokuje publikację. Jeśli zespół nie potrafi wyjaśnić reakcji, kontrola nie jest gotowa do wdrożenia produkcyjnego.
Rozszerzanie w kontrolowanych przyrostach
Modułowe wdrażanie pozwala zespołom uczyć się bez tworzenia trudnej do opanowania przestrzeni alertów:
Zacznij od zasobu o największych konsekwencjach: Wybierz zestaw danych, w którym awaria wpłynęłaby na decyzje, zgodność (Compliance) lub operacje na klientach.
Dodaj jedną funkcję monitorowania: Zacznij od monitorowania terminowości (Timeliness) lub wykrywania anomalii, jeśli głównym problemem jest cicha zmiana zachowania. Dodaj kontrole schematu i walidacji, gdy mapa awarii stanie się wyraźniejsza.
Uruchamiaj kontrole blisko źródła: Wykonywanie w bazie danych ogranicza niepotrzebny ruch i utrzymuje wrażliwe dane w środowisku klienta.
Przeglądaj każdy alert: Oznaczaj oczekiwane zmiany, dostosowuj progi i przekształcaj powtarzające się ustalenia w udokumentowane kontrole.
Świadomie rozszerzaj zakres: Dodawaj zasoby, gdy nowe źródło, model, raport lub proces regulacyjny stwarza istotne ryzyko.
Wymagania dotyczące wdrożenia mają znaczenie w środowiskach regulowanych. Platforma działająca w chmurze prywatnej, VPC lub centrum danych może wspierać lokalną kontrolę danych produkcyjnych. Kontrole w bazie danych mogą być dostosowane do wymogów bezpieczeństwa, podczas gdy metody statystyczne połączone z uczeniem maszynowym mogą dostosować wykrywanie anomalii do zachowania linii bazowej każdego zestawu danych. Cennik, który pozwala uniknąć opłat za wywołania API lub liczbę alertów, może również ułatwić prognozowanie ekspansji, chociaż zespoły powinny nadal zdefiniować zakres aktywnych tabel i własność przed wdrożeniem większej ilości danych.
Zarządzanie ryzykiem jakości danych kończy się sukcesem, gdy staje się częścią procedur wdrażania (Release), obsługi incydentów i zarządzania zmianą. Traktuj jakość jako stały system kontroli, a zespoły będą mogły wykrywać nieaktualne strumienie danych, niestabilne schematy, nietypowe zachowania i nieprawidłowe rekordy, zanim te awarie staną się incydentami biznesowymi.
digna dostarcza platformę jakości danych i Data Observability dla przedsiębiorstw, która działa w Twoim środowisku, łącząc wykrywanie anomalii, monitorowanie terminowości (Timeliness), śledzenie schematów, walidację na poziomie rekordów i analizę historyczną. Odwiedź digna, aby ocenić modułowy punkt wyjścia do przekształcania krytycznych ryzyk jakości danych w ciągłe, wykonalne kontrole.
Najczęściej zadawane pytania
Co zmienia zarządzanie ryzykiem jakości danych?
Traktuje incydenty jako awarie kontroli, a nie odosobnione zgłoszenia porządkowe. To przeformułowanie przeprowadza zespół od wielokrotnego naprawiania tej samej usterki do pytania, która kontrola powinna była ją wychwycić i dlaczego tego nie zrobiła.
Co naprawdę dowodzi zielony status potoku?
Wyłącznie tego, że przepływ się zakończył. Nie dowodzi, że powstałe dane są dokładne, terminowe, spójne ani przydatne do decyzji, dlatego zespół może mieć niezawodną orkiestrację, udane statusy zadań i obszerne testy jednostkowe, a i tak dostarczać bezużyteczne dane.
Dlaczego reaktywne porządkowanie przestaje się skalować?
Bo ręczne utrzymanie reguł działa tylko dopóty, dopóki liczba źródeł, tabel i zastosowań pozostaje możliwa do opanowania. Powyżej tego punktu ciągły program obserwujący zachowanie zastępuje model czekania na skargę i pisania kolejnej reguły.
Od czego powinien zacząć program ryzyka?
Od produktów danych wpływających na sprawozdawczość regulacyjną, decyzje finansowe, obsługę klientów albo uczenie maszynowe. Start w tym miejscu wiąże pierwsze kontrole z konsekwencjami już widocznymi poza zespołem danych.
Jaki jest koszt w skali kraju?
Szeroko cytowany szacunek IBM określił roczny koszt słabej jakości danych w Stanach Zjednoczonych na około 3,1 biliona dolarów w 2016 r. Liczby tego rzędu są raczej kierunkowe niż precyzyjne, ale tłumaczą, dlaczego dyscyplina przesunęła się od porządkowania do ryzyka.



