Zarządzanie metadanymi: Twój podręcznik strategiczny na rok 2026
|
8
min. czyt.

Jesteś na spotkaniu, ktoś pyta, dlaczego wczorajszy pulpit nawigacyjny nie zgadza się z dzisiejszymi danymi liczbowymi, a trzy osoby podają trzy różne definicje tej samej metryki. Dane znajdują się w hurtowni, potok danych został uruchomiony, a mimo to nikt nie ufa wynikom na tyle, by podjąć decyzję. Właśnie w tym momencie zarządzanie metadanymi przestaje być zadaniem w tle, a staje się elementem spajającym całą operację na danych.
Spis treści
Dlaczego zarządzanie metadanymi ma teraz kluczowe znaczenie
Uszkodzony pulpit nawigacyjny zwykle nie ulega awarii w spektakularny sposób. Zaczyna zwracać błędne odpowiedzi po zmianie nazwy kolumny, przesunięciu źródła lub aktualizacji transformacji, czego nikt nie zauważa. Zespół BI utrzymuje raport przy życiu, analityk nadal eksportuje dane do programu Excel, a biznes powoli traci zaufanie do danych.
Przejście od dokumentacji do kontroli operacyjnej
Ta cicha awaria jest powodem, dla którego metadane przeszły z obszaru dokumentacji do infrastruktury operacyjnej. Badanie rynkowe oszacowało globalny rynek zarządzania metadanymi na 2,84 mld USD w 2025 roku i prognozuje, że osiągnie on wartość 27,97 mld USD do 2035 roku przy CAGR na poziomie 25,7%. To samo badanie wskazuje, że Ameryka Północna posiadała ponad 39,15% udziału, katalogi danych i narzędzia do ich wyszukiwania odpowiadały za 58,4% globalnego udziału, a rynek amerykański osiągnął wartość 1,01 mld USD w 2025 roku. Dane te wskazują na prostą rzeczywistość – metadane znajdują się obecnie w rdzeniu stosu technologicznego danych, co przedstawiono w raporcie rynkowym Market.us dotyczącym zarządzania metadanymi.
Presja stojąca za tą zmianą ma charakter praktyczny. Gdy metadane są słabe, analitycy danych mogą spędzać nawet 80% swojego czasu na czyszczeniu danych, co pozostawia mniej czasu na modelowanie, testowanie i wdrażanie. Tego rodzaju opóźnienie trudno zignorować w organizacjach próbujących jednocześnie wspierać analitykę, Compliance i sztuczną inteligencję. Raport rynkowy Market.us dotyczący zarządzania metadanymi
Dlaczego zespoły biznesowe również się tym interesują
Starsze programy zarządzania metadanymi często funkcjonowały w obrębie działów IT. Biznes miał z nimi kontakt tylko wtedy, gdy słownik wymagał nowego pojęcia lub raport wymagał zatwierdzenia. Ten model już się nie sprawdza, ponieważ odbiorcami metadanych są często użytkownicy biznesowi – powszechnie cytowane badanie wykazało, że niemal 80% konsumentów metadanych należało do tej grupy, podczas gdy dwie trzecie respondentów stwierdziło, że metadane miały większe znaczenie w 2020 roku niż 10 lat wcześniej. To samo badanie pokazuje również, jak szeroka stała się ta potrzeba w różnych rolach, które zależą od wspólnych definicji i wiarygodnego kontekstu. Ankieta Dataversity dotycząca zarządzania metadanymi
Badanie to pokazuje również, dlaczego dyskusja uległa zmianie. Najczęstszymi źródłami były hurtownie danych, relacyjne bazy danych, modele danych i słowniki biznesowe, a najbardziej pożądanym przyszłym zasobem były platformy dużych zbiorów danych (big data). W praktyce metadane stały się zorientowaną na biznes warstwą kontrolną dla governance, analityki i audytowalności – na wzór nastawni pokazującej, co działa, co się zmieniło i kto powinien zareagować. Zespoły potrzebujące prostego punktu wejścia mogą również zrozumieć dostęp do Llama 3.1, zanim zdecydują, jak duża część kontekstu metadanych powinna trafić do współdzielonych systemów.
Katalog danych zapewnia tej warstwie kontrolnej użyteczny interfejs użytkownika, ponieważ pomaga ludziom znajdować zasoby, badać kontekst i śledzić własność bez konieczności przeszukiwania wielu narzędzi. To jest właśnie ta wartość operacyjna, która liczy się najbardziej. Jeśli użytkownik biznesowy nie potrafi określić, co oznacza dane pole, kto jest jego właścicielem i czy korzystanie z niego jest bezpieczne, warstwa metadanych nie spełnia swojego zadania.
Kluczowe komponenty zarządzania metadanymi
Dobre zarządzanie metadanymi zaczyna się od prostej definicji. Zarządzanie metadanymi to systematyczny proces tworzenia, przechowywania, organizowania i utrzymywania metadanych w odniesieniu do zasobów danych organizacji. IBM opisuje je jako organizowanie, optymalizację i wykorzystywanie metadanych w celu poprawy dostępności i jakości, podczas gdy Snowflake definiuje je jako praktyki, zasady i narzędzia, które określają sposób tworzenia, utrzymywania, wzbogacania i udostępniania metadanych do użytku. Przegląd zarządzania metadanymi IBM, Przegląd zarządzania metadanymi Snowflake
Sześć typów metadanych, które mają znaczenie w praktyce
Użyteczna taksonomia przedsiębiorstwa dzieli metadane na metadane techniczne, opisowe, strukturalne, administracyjne, operacyjne oraz metadane jakości. Metadane techniczne obejmują schematy i typy danych. Metadane opisowe zawierają pojęcia i definicje biznesowe. Metadane strukturalne pokazują relacje między elementami. Metadane administracyjne obejmują prawa dostępu i okresy przechowywania. Metadane operacyjne śledzą pochodzenie i transformacje. Metadane jakości dotyczą kompletności i świeżości danych. Typy metadanych Atlan
Ten podział ma znaczenie, ponieważ każdy typ odpowiada na inne pytanie. Jeśli programista BI chce wiedzieć, czy metryka jest zbudowana na właściwych polach, pomocne będą metadane techniczne i strukturalne. Jeśli lider ds. governance potrzebuje kontekstu dotyczącego przechowywania i dostępu, metadane administracyjne stanowią źródło prawdy. Jeśli analityk debuguje raport, metadane operacyjne i metadane jakości powiedzą mu, skąd pochodzą dane i czy zmieniły się w sposób, któremu można zaufać.
Amerykańskie Narodowe Instytuty Zdrowia (NIH) przytaczają definicję metadanych opracowaną przez Krajową Organizację Standardów Informacyjnych (NISO) jako „Ustrukturyzowane informacje, które opisują, wyjaśniają, lokalizują lub w inny sposób ułatwiają wyszukiwanie, używanie lub zarządzanie zasobem informacyjnym”. Ta definicja jest przydatna, ponieważ bezpośrednio łączy metadane z wyszukiwaniem, używaniem i zarządzaniem, a nie tylko z samym wyszukiwaniem. Podręcznik podstaw metadanych NIH
Jak poszczególne elementy współpracują ze sobą
Katalog to drzwi wejściowe. Pochodzenie danych (lineage) to mapa. Zarządzanie (stewardship) to model własności. Wersjonowanie schematów to dziennik zmian. Żaden z tych elementów nie działa dobrze samodzielnie. Gdy definicje znajdują się w jednym narzędziu, pochodzenie danych w drugim, a oceny jakości jeszcze gdzie indziej, zespoły tracą możliwość prześledzenia problemu od początku do końca. Taka fragmentacja jest dokładnie tym, co utrudnia diagnozowanie awarii pulpitów nawigacyjnych i zachowanie spójności między systemami. EWSolutions o silosach metadanych
Pomocnym sposobem myślenia o tym procesie jest oddzielenie tego, co jest definiowane, od tego, gdzie to się znajduje i jak ludzie to odnajdują. Katalog danych organizuje pojęcia. Repozytorium przechowuje metadane. Własność i wersjonowanie utrzymują je w aktualności. Odkrywanie (discovery) sprawia, że są one użyteczne dla osób, które ich potrzebują.
Przydatnym punktem odniesienia dla zespołów budujących te drzwi wejściowe jest zrozumieć dostęp do Llama 3.1, ponieważ pokazuje, jak metadane i wzorce dostępu są często omawiane razem w rzeczywistych pracach wdrożeniowych. W celu uzyskania praktycznego spojrzenia przedsiębiorstwa na warstwę katalogu, warto również przeczytać przegląd digna dotyczący tego, czym jest katalog danych.

Integracja z jakością danych i Observability
Metadane stają się operacyjne, gdy zasilają kontrole jakości i procesy observability. Katalog, który mówi ludziom tylko, jak nazywa się tabela, pomaga w wyszukiwaniu informacji. Katalog, który pokazuje również, kiedy ta tabela się zmieniła, kto od niej zależy i czy ostatnie ładowanie przebiegło normalnie, pomaga inżynierom zapobiegać incydentom, zanim te się rozprzestrzenią.
Od pasywnego kontekstu do aktywnych sygnałów
Praktyczna zmiana polega na umieszczeniu metadanych obok walidacji i monitorowania, zamiast traktowania ich jako pasywnego materiału referencyjnego w tle. Nowoczesne wytyczne wskazują, że zarządzanie metadanymi powinno obejmować pochodzenie danych, własność, wrażliwość, wykorzystanie oraz sygnały dotyczące jakości, ponieważ zespoły muszą wiedzieć, które pulpity nawigacyjne są używane i czy dane zachowują się zgodnie z oczekiwaniami. Badanie MIT CDOIQ z 2025 roku cytowane w zweryfikowanych danych wykazało, że tylko 12% firm zgłosiło silnie zintegrowane zarządzanie metadanymi w warstwach technicznej, biznesowej i operacyjnej. Wideo z badania MIT CDOIQ
Ta luka ma znaczenie, ponieważ odłączone metadane tworzą martwe punkty. Jeśli śledzenie schematów jest odizolowane od monitorowania jakości, analityk może dostrzec uszkodzony pulpit nawigacyjny długo po tym, jak pojawił się problem u źródła. Jeśli pochodzenie danych jest oddzielone od alertów runtime, zespół może zobaczyć, że coś się zmieniło, nie wiedząc, co to uszkodziło. Observability zamienia metadane w aktywny interfejs kontrolny, co pomaga zespołom śledzić objawy aż do systemów źródłowych, zamiast pozostawiać je w statycznym repozytorium dokumentów.
Platforma digna ma tutaj kluczowe znaczenie, ponieważ łączy wykonywanie wewnątrz bazy danych, wykrywanie anomalii oparte na AI, ciągłe śledzenie schematów i monitorowanie terminowości wewnątrz własnego środowiska klienta. Taka konfiguracja odpowiada modelowi operacyjnemu, którego pożąda wiele zespołów – gdzie metadane, jakość i monitorowanie wspierają ten sam proces obsługi incydentów, zamiast znajdować się w osobnych narzędziach. Dla zespołów chcących praktycznie spojrzeć na powiązanie między metadanymi a kontrolą jakości, przewodnik digna dotyczący metadanych i jakości danych stanowi przydatny punkt wyjścia.
Spostrzeżenie operacyjne: jeśli warstwa metadanych nie potrafi wyjaśnić uszkodzonego raportu w kontekście źródła, transformacji i wpływu na odbiorców, nadal pozostawia to zbyt wiele domysłów w całym procesie.
Jak wygląda dobra integracja
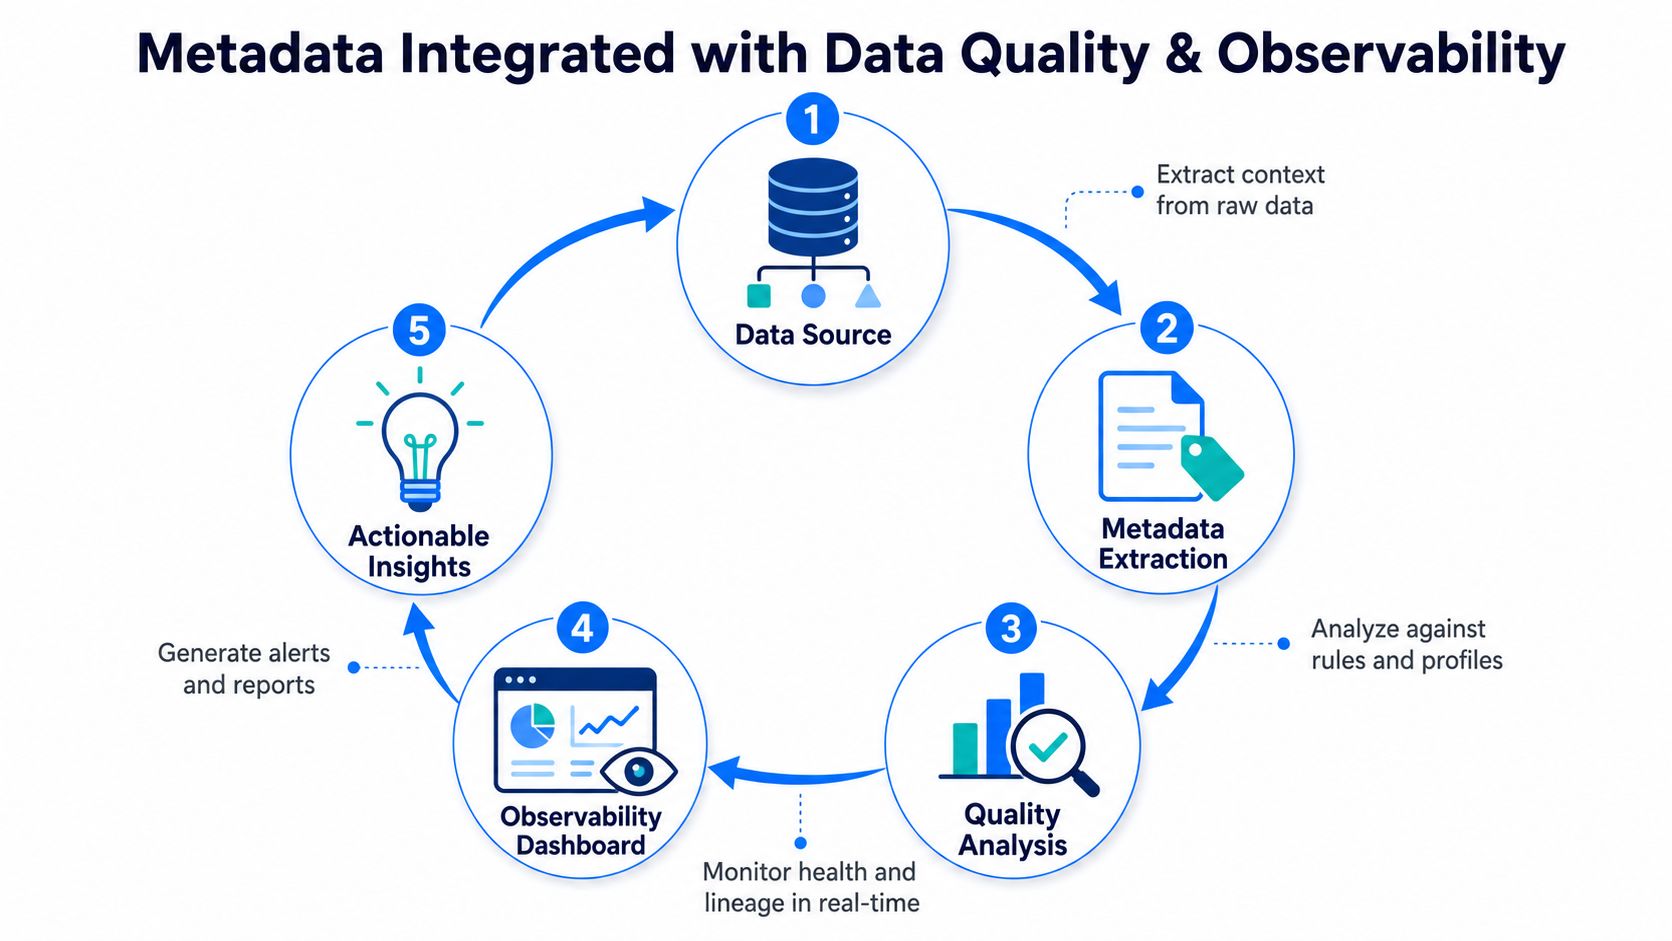
Praktyczny przepływ pracy zazwyczaj zaczyna się od systemu źródłowego. Ekstrakcja metadanych rejestruje schematy, właścicieli i pochodzenie danych. Reguły jakości oceniają dane pod kątem oczekiwanych wzorców. Observability ujawnia anomalię lub opóźnienie. Zadanie trafia do odpowiedniego zespołu, ponieważ metadane wskazują na dotknięty problemem zasób i jego odbiorców końcowych.
Ten łańcuch ma znaczenie w codziennej pracy. Zmiana schematu powinna informować programistę BI, który pulpit nawigacyjny może ulec awarii. Kwestia świeżości danych powinna informować analityka operacyjnego, czy opóźnienie jest nowe, czy się powtarza. Błąd walidacji powinien dać liderowi ds. governance wystarczający kontekst do oceny, czy problem ma charakter lokalny, czy systemowy. Dla zespołów budujących silniejsze mechanizmy kontroli jakości danych i observability, artykuł na temat ram ładu IT (IT governance) dla projektów w Wielkiej Brytanii oferuje przydatną, pokrewną perspektywę.
Kwestie związane z governance i bezpieczeństwem
Katalog metadanych może na pierwszy rzut oka wydawać się niegroźny, ponieważ nie zawiera surowych danych klientów ani samych transakcji finansowych. Takie spojrzenie pomija jednak ryzyko operacyjne. Metadane ujawniają strukturę, własność, wzorce dostępu, reguły przechowywania i logikę biznesową, co może obnażyć sposób działania wrażliwych systemów oraz to, kto i co może w nich zobaczyć.
Utrzymywanie dokładności i aktualności metadanych
Pierwszym pytaniem z zakresu governance jest świeżość danych. W skali przedsiębiorstwa metadane stają się trudniejsze w utrzymaniu, ponieważ wyszukiwanie, pobieranie, aktualizacja i uzgadnianie stają się coraz bardziej wymagające wraz ze wzrostem wolumenu i różnorodności rekordów. IBM zauważa, że duże, rozproszone środowiska potrzebują automatyzacji i governance, ponieważ ręczne aktualizacje szybko prowadzą do powstawania nieaktualnych lub przestarzałych wpisów. Przegląd zarządzania metadanymi IBM
Ten problem ujawnia się podczas prac związanych ze zgodnością (compliance). Nieaktualne metadane osłabiają dowody, spowalniają analizę przyczyn źródłowych i utrudniają wykazanie, co się zmieniło, gdy pytają o to audytorzy. Rozwiązanie ma charakter operacyjny, a nie kosmetyczny. Rejestruj metadane podczas wykonywania potoku, przypisuj własność i wersjonuj zmiany, tak aby metadane poruszały się wraz z danymi, a nie pozostawały w tyle.
Pochodzenie (lineage) i proweniencja (provenance) danych wymagają tej samej dyscypliny. Jasna ścieżka lineage pokazuje, skąd pochodzi dany zasób, jak się zmieniał i gdzie jest używany, podczas gdy provenance pomaga wyjaśnić pochodzenie i historię samych danych. Zespoły potrzebujące wyraźniejszego rozróżnienia mogą wykorzystać to wyjaśnienie różnic między proweniencją danych a pochodzeniem danych (data lineage) jako punkt odniesienia przy projektowaniu mechanizmów kontrolnych i ścieżek audytu.
Balansowanie między kompletnością a przeładowaniem informacjami
Istnieje jeszcze jedna pułapka, którą łatwo przeoczyć. Zbyt duża ilość metadanych może być równie problematyczna, jak ich zbyt mała ilość. Najnowsze wytyczne zalecają definiowanie pól wymaganych i opcjonalnych oraz audytowanie przestarzałych wpisów, dzięki czemu katalogi pozostają użyteczne, a nie przepełnione. Ma to znaczenie w środowiskach obejmujących hurtownie, jeziora danych, narzędzia SaaS i modele AI, gdzie dryf schematów i ciągłe zmiany mogą szybko zamienić katalog w bałagan. Przewodnik Datagalaxy po zarządzaniu metadanymi
Bezpieczeństwo wymaga tej samej dyscypliny. Metadane powinny być chronione za pomocą kontroli dostępu, zarządzania opartego na rolach (role-based stewardship) oraz zatwierdzania zmian, które odpowiadają wrażliwości opisywanych przez nie danych. Jeśli metadane ujawniają wyjątki w polityce przechowywania lub logikę reguł biznesowych, zasługują na governance w takim samym stopniu, jak zasoby, które dokumentują.
Dla zespołów budujących formalne kontrole, ramy ładu IT (IT governance) dla projektów w Wielkiej Brytanii stanowią użyteczny punkt odniesienia do strukturyzacji odpowiedzialności i nadzoru nad programami danych.

Plan wdrożenia i lista kontrolna
Program zarządzania metadanymi kończy się sukcesem, gdy zaczyna się od chaosu, który już masz, a nie od teoretycznego stanu przyszłego. Większość organizacji nie potrzebuje wielkiego projektu od pierwszego dnia. Potrzebują jasnego spisu tego, co istnieje, kto jest tego właścicielem i które zestawy danych powodują najwięcej problemów, gdy ulegają zmianom.
Zacznij od danych generujących największe tarcia
Pierwszy etap powinien skupiać się na krytycznych domenach, tabelach, raportach i potokach, które wywołują najwięcej pytań, incydentów lub wymagają ręcznego uzgadniania. To tam metadane najszybciej tworzą widoczną wartość. Jeśli zespół nie widzi pochodzenia (lineage), świeżości ani własności tych zasobów, reszta katalogu ich nie uratuje.
Następnie zdefiniuj minimalne pola metadanych, które muszą istnieć dla każdego zasobu o wysokiej wartości. Ogranicz listę wymaganych pól do minimum. Poproś o nazwę biznesową, lokalizację techniczną, właściciela, opis i najważniejsze sygnały operacyjne. Wszystko inne można dodać później, jeśli będzie służyć realnej decyzji lub kontroli.
Buduj z myślą o automatyzacji od samego początku
Ręczne utrzymywanie metadanych nie sprawdza się na dłuższą metę. Źródła opisujące operacje na metadanych wskazują, że środowiska rozproszone wymagają automatyzacji, ponieważ procesy ręczne prowadzą do powstawania nieaktualnych, niespójnych lub przestarzałych rekordów. Praktyczną odpowiedzią jest automatyczne pobieranie metadanych z warstw orkiestracji, hurtowni i transformacji, a następnie aktualizowanie ich w momencie zmiany. Przegląd zarządzania metadanymi IBM
Prosta lista kontrolna pomaga zespołom zachować rzetelność:
Oceń stan obecny: zinwentaryzuj główne źródła, katalogi, słowniki i luki we własności.
Zdefiniuj reguły governance: zdecyduj, kto może edytować, zatwierdzać lub wycofywać wpisy metadanych.
Wybierz platformę: wybierz narzędzia, które mogą łączyć się z systemami, z których już korzystasz.
Przeprowadź pilotaż dla krytycznej domeny: zacznij od jednego obszaru biznesowego, który co tydzień odczuwa koszty złych metadanych.
Mierz i ulepszaj: weryfikuj świeżość, stopień wdrożenia oraz liczbę nierozwiązanych problemów z metadanymi.
Najlepsze wdrożenia nie traktują metadanych jako osobnego projektu porządkowego. Wpinają je w procesy wykonywania potoków, walidacji i alertów, dzięki czemu zmiany schematów i sygnały jakości podróżują razem. To sprawia, że metadane są użyteczne w momencie, gdy ktoś musi podjąć działanie, a nie dzień po przeglądzie incydentu.

Przykłady z rzeczywistych przedsiębiorstw
Zarządzanie metadanymi wydaje się abstrakcyjne, dopóki nie uratuje zespołu przed podjęciem złej decyzji. W praktyce te same wzorce pojawiają się w finansach, opiece zdrowotnej, telekomunikacji i sektorze publicznym, ponieważ każde z tych środowisk zależy od identyfikowalności, terminowości i pewności co do raportowania końcowego.
Finanse i sprawozdawczość regulowana
W usługach finansowych zespoły używają metadanych do śledzenia danych do sprawozdawczości regulacyjnej, walidacji krytycznych reguł biznesowych i wykrywania nietypowych wzorców, zanim wpłyną one na zgodność. Stawka jest wysoka. Problem z raportowaniem, który maskuje przerwę w pochodzeniu danych lub nieaktualną definicję, może szybko stać się problemem audytowym. Metadane dają zespołom ds. ryzyka i governance możliwość odpowiedzi na pytania: co się zmieniło, gdzie nastąpiła zmiana i kto musi o tym wiedzieć.
Opieka zdrowotna i niezawodność operacyjna
Zespoły medyczne polegają na metadanych, aby utrzymać wiarygodność danych klinicznych i operacyjnych. Zmiany schematów, opóźnienia w dostarczaniu danych i niekompletne rekordy mogą wpływać na raportowanie pacjentów i operacje wewnętrzne na długo zanim ktokolwiek wykryje przyczynę źródłową. Ciągłe śledzenie pomaga tym zespołom ocenić, czy zmiana jest odosobniona, czy stanowi część szerszego problemu w przepływie danych.
Telekomunikacja i operacje w sektorze publicznym
Zespoły telekomunikacyjne pracują z dużymi wolumenami danych klientów i sieci, więc nieoczekiwane zmiany mogą się szybko rozprzestrzeniać. Metadane pomagają im wychwycić przesunięcia strukturalne i walidować krytyczne rekordy, zanim systemy downstream nasilą problem. Organizacje sektora publicznego stosują podobne kontrole w celu poprawy niezawodności, identyfikowalności i gotowości do audytu w rządowych programach danych.
Zrzut ekranu z interfejsu observability platformy digna pokazuje, jak tego rodzaju widok operacyjny może połączyć incydenty, status danych i śledzenie zmian w jednym miejscu. Ma to znaczenie, ponieważ inżynierowie i analitycy potrzebują tych samych dowodów, gdy próbują zdecydować, czy problem ma charakter techniczny, biznesowy, czy oba te rodzaje.
Kluczowe wnioski i kolejne kroki
Zarządzanie metadanymi nie polega już tylko na katalogowaniu pól. To warstwa operacyjna, która pomaga zespołom odkrywać dane, wyjaśniać je, nadzorować i ufać im, gdy przemieszczają się między systemami. Najsilniejsze programy łączą metadane z jakością, Observability i własnością, dzięki czemu problemy ujawniają się wcześnie, a odpowiednie osoby mogą na nie zareagować.
Zacznij od wąskiego zestawu krytycznych zbiorów danych, zdefiniuj pola metadanych, które mają znaczenie, i zautomatyzuj ich przechwytywanie wszędzie tam, gdzie to możliwe. Następnie zacieśnij governance, aby metadane pozostały aktualne, bezpieczne i użyteczne, zamiast rozrastać się w chaos. Zespoły, które traktują metadane jak żywy system, zazwyczaj spędzają mniej czasu na kłótniach o definicje, a więcej na ulepszaniu samych danych.
digna pomaga zespołom monitorować zachowanie danych, zmiany schematów, terminowość i walidację w ich własnym środowisku, co czyni ją naturalnym wyborem do prac nad jakością i Observability z uwzględnieniem metadanych. Jeśli budujesz bardziej niezawodną warstwę metadanych dla analityki lub sztucznej inteligencji, odwiedź digna i zobacz, jak jej platforma wspiera zespoły zajmujące się danymi, które potrzebują kontroli, identyfikowalności i ciągłego monitorowania.
Najczęściej zadawane pytania
Dlaczego zarządzanie metadanymi stało się pilne?
Bo metadane przeszły z dokumentacji do infrastruktury operacyjnej. Zepsuty pulpit zwykle nie zawodzi z hukiem, i właśnie ta cicha awaria zamienia metadane z miłego dodatku w to, czego potrzebujesz, by ją zdiagnozować.
Jak wygląda klasyczny objaw?
Trzy osoby podają trzy różne definicje tego samego wskaźnika, gdy ktoś pyta, dlaczego wczorajszy pulpit nie zgadza się z dzisiejszymi liczbami. Ta rozbieżność jest uwidocznioną luką w metadanych.
Jak szybko rośnie ten rynek?
Badanie rynku oszacowało globalne zarządzanie metadanymi na 2,84 mld USD w 2025 r. i prognozowało 27,97 mld USD do 2035 r., przy CAGR 25,7 %. Wzrost tego rzędu odzwierciedla zmianę w tym, czego oczekuje się od metadanych, a nie tylko wyższe wydatki.
Czym różni się dokumentacja od kontroli operacyjnej?
Dokumentacja zapisuje, co dane powinny znaczyć; kontrola operacyjna używa tego zapisu, by o czymś zdecydować. Metadane, których nie konsultuje żaden potok, alert ani decyzja o dostępie, są opisem, a nie kontrolą.
Od czego powinien zacząć program metadanych?
Od definicji, o które już się spiera. Te spory wskazują wskaźniki, których znaczenie jest kwestionowane, i właśnie tam wspólna definicja zmienia wynik, zamiast wypełniać katalog.


