Wiarygodne dane to poprawne dane: praktyczny przewodnik
|
7
min. czyt.
Jest poniedziałkowy poranek. Pulpit nawigacyjny zarządu świeci na zielono, przychody wyglądają na stabilne, a nocny potok danych zakończył pracę bez błędów. Jednak do wtorkowego popołudnia menedżer produktu odkrywa, że współczynniki konwersji były błędne przez trzy dni, ponieważ zmiana schematu w systemie źródłowym zmieniła sposób obsługi wartości null. Pod względem operacyjnym nic nie zawiodło. Przepływ pracy uruchomił się zgodnie z harmonogramem i dostarczył dane na czas. Same dane nie były już jednak prawidłowe.
To rozróżnienie jest przyczyną jednych z najkosztowniejszych incydentów na nowoczesnych platformach danych. Wiarygodne dane to poprawne dane, ale potok danych, który działa spójnie, nie oznacza automatycznie tworzenia godnych zaufania rekordów. Niezawodność produkcyjna zależy od tego, czy dane pozostają poprawne, aktualne, spójne strukturalnie i dopasowane do decyzji, które wspierają.
Spis treści
Praktyczne mechanizmy kontrolne dla zapewnienia poprawności i niezawodności
Dlaczego statyczna walidacja nie wystarcza nowoczesnym platformom danych
Kiedy wiarygodne dane nie przechodzą testu poprawności
Pierwszy alert zazwyczaj nie jest alertem. To pytanie na Slacku.
„Dlaczego konwersja spadła dla jednego kanału?”
Pulpit nawigacyjny nadal pokazuje pomyślne odświeżenie. Narzędzie do orkiestracji zadań nie zgłasza żadnych awarii. Liczba wierszy wygląda wiarygodnie, a hurtownia danych zaakceptowała każdy rekord. Szybkie porównanie ujawnia, że usługa nadrzędna zmieniła reprezentację brakujących wartości. Transformacja nadal się wykonywała, ale jej logika łączenia i agregacji potraktowała te wartości inaczej. Metryka, która wyglądała na stabilną, została obliczona na podstawie zmienionego znaczenia.
To niebezpieczna luka między niezawodnością potoku a poprawnością danych. Niezawodny potok danych może ukończyć każde zaplanowane zadanie, dostarczając jednocześnie rekordy, które naruszają logikę biznesową. Prawidłowy zestaw danych może również stać się operacyjnie niewiarygodny, jeśli dotrze zbyt późno, niekompletny lub zmieni swoją strukturę bez ostrzeżenia.
Zielony potok danych wciąż może być błędny
Podstawowy monitoring często odpowiada na pytania operacyjne:
Czy zadanie się rozpoczęło?
Czy zostało zakończone?
Czy hurtownia danych zaakceptowała zapytanie?
Czy oczekiwane zadanie wygenerowało dane wyjściowe?
Czy pulpit nawigacyjny się odświeżył?
Te kontrole są ważne, ale nie dają odpowiedzi na pytanie, czy identyfikator klienta nadal odpowiada właściwemu klientowi, czy znacznik czasu należy do zamierzonego okresu sprawozdawczego lub czy kod statusu pozostaje w zatwierdzonym słowniku biznesowym.
Poprawność to mechanizm kontrolny, który łączy pomyślne przetwarzanie z wartościowymi danymi wyjściowymi. IBM opisuje poprawność jako odrębny wymiar jakości danych obejmujący format, typ, zakres i ograniczenia reguł biznesowych, zauważając jednocześnie, że pozornie wiarygodne dane mogą nadal być niepoprawne, gdy naruszają oczekiwania strukturalne lub semantyczne w swoim wyjaśnieniu wymiarów jakości danych.
Niepoprawnie sformatowany e-mail, ujemny wiek, nieoczekiwany kod lub pusty klucz łączenia (null) mogą przejść etap pozyskiwania danych, ponieważ warstwa przechowywania na to pozwala. Modele i raporty podrzędne dziedziczą wówczas tę wadę. Im dalej rekord wędruje, tym trudniej zidentyfikować pierwotną przyczynę.
Zasada praktyczna: Pomyślne uruchomienie dowodzi, że oprogramowanie ukończyło swoją pracę. Nie dowodzi to, że wynik zasługuje na zaufanie.
Ryzyko biznesowe jest znaczne. W artykule z 2017 roku w MIT Sloan Management Review przytoczono badania szacujące, że złe dane kosztują większość firm od 15% do 25% przychodów z powodu zniekształconych decyzji, raportowania i wyników finansowych (odniesienie do MIT Sloan Management Review). Szacunek ten pomaga wyjaśnić, dlaczego poprawność powinna znajdować się w mechanizmach kontrolnych przedsiębiorstwa, a nie tylko na listach kontrolnych inżynierów.
Zrozumienie poprawności i niezawodności danych
Potok danych może pomyślnie zakończyć pracę o 2 w nocy i nadal opublikować bezużyteczne dane do śniadania. Pole może zostać sparsowane, zadanie może zmienić kolor na zielony, a pulpit nawigacyjny może się odświeżyć, podczas gdy rekordy naruszają reguły nadające im znaczenie. Poprawność i niezawodność opisują różne mechanizmy kontrolne służące do wychwytywania takich błędów.
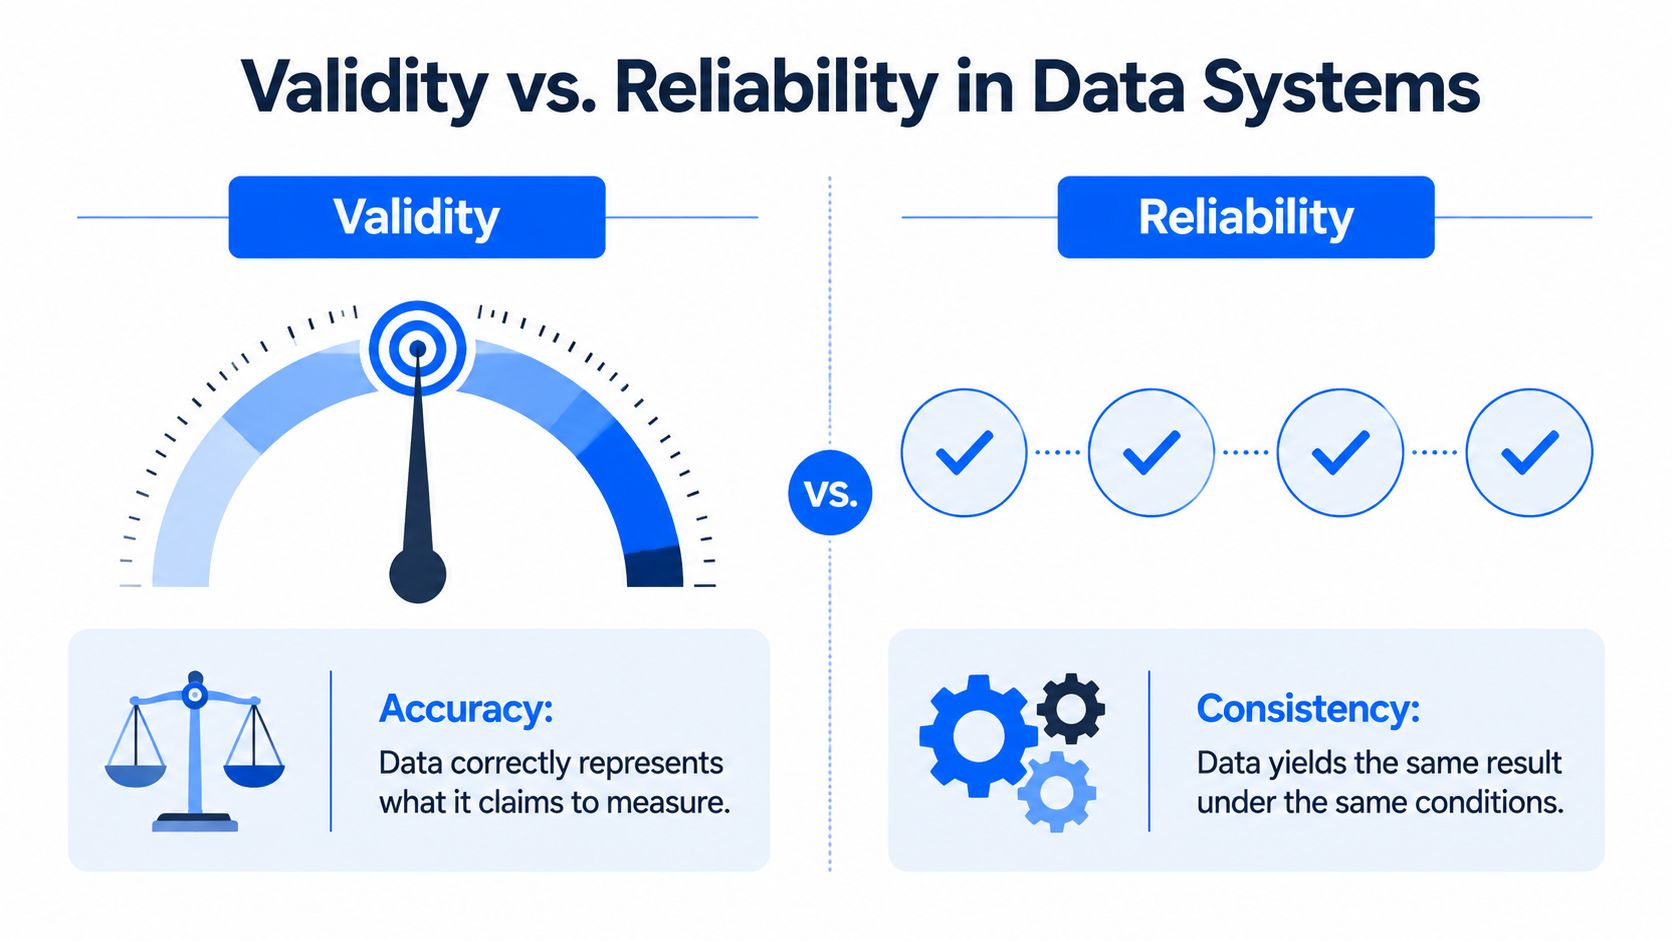
Poprawność bada, czy rekord reprezentuje to, co powinien reprezentować, i czy jest zgodny z regułami dopuszczalnych danych. Niezawodność bada, czy wyniki pozostają spójne w czasie i w zmieniających się warunkach pomiaru. W publikacji ONZ dotyczącej standardów statystycznych te dwie właściwości są traktowane jako powiązane, ale oddzielne.
Waga, która stale pokazuje o 5 funtów za dużo, jest niezawodna, ponieważ daje powtarzalne wyniki, ale nie jest poprawna, ponieważ jej odczyty mijają się z rzeczywistą wagą. Waga, która waha się losowo, nie jest ani niezawodna, ani poprawna.
Co oznacza poprawność w środowisku produkcyjnym
Na platformie danych poprawność obejmuje więcej niż to, czy wartość wygląda wiarygodnie. Inżynierowie powszechnie sprawdzają:
Zgodność typów: Pola numeryczne zawierają liczby, daty są poprawnie analizowane, a identyfikatory zachowują swoją wymaganą reprezentację.
Zgodność zakresu: Wartości mieszczą się w sensownych dolnych i górnych granicach.
Zgodność formatu: Adresy e-mail, kody, numery telefonów i znaczniki czasu są zgodne z przyjętymi wzorcami.
Integralność referencyjna: Klucze obce odwołują się do rekordów we właściwej tabeli wymiarów lub tabeli referencyjnej.
Zgodność z regułami biznesowymi: Powiązane pola są zgodne ze sobą oraz z procesem, który opisują.
Wiek klienta wynoszący 37 lat może być dokładny i poprawny. Ujemny wiek jest niepoprawny, nawet jeśli baza danych go akceptuje. Znacznik czasu może być zgodny z wymaganym formatem, a jednocześnie reprezentować niewłaściwe zdarzenie, ponieważ system nadrzędny zastosował nieoczekiwaną strefę czasową.
Rozróżnienie między dokładnością a poprawnością ma kluczowe znaczenie w produkcji. Dokładność dotyczy tego, czy wartość odzwierciedla rzeczywistość. Poprawność dotyczy tego, czy jest zgodna z warunkami, jakie określa Data Contract i projekt pomiaru. Wartość może wydawać się rozsądna, a mimo to naruszać regułę chroniącą interpretację podrzędną. W przewodniku po poprawności danych wyjaśniono, jak zespoły mogą oceniać to rozróżnienie w praktyce.
Dlaczego niezawodność wymaga czegoś więcej niż tylko spójności
Niezawodność obejmuje pewną dostępność, kompletne dostarczenie i przybycie w ramy czasowe wymagane do podjęcia decyzji. Potok danych, który co noc powtarza tę samą wadliwą transformację, jest spójny, ale jego wyniki nie są wiarygodnym dowodem. Prawidłowe rekordy, które docierają po spotkaniu planistycznym, mogą również okazać się bezużyteczne.
Wskaźniki Worldwide Governance Indicators Banku Światowego zestawiają ustandaryzowane dane z wielu źródeł dla ponad 200 gospodarek z lat 1996-2024, korzystając z 35 źródeł międzynarodowych, takich jak badania gospodarstw domowych, badania przedsiębiorstw i oceny eksperckie. Porównania między rynkami wymagają danych, które pozostają strukturalnie poprawne i spójnie produkowane.
Observability łączy te właściwości operacyjnie. Kontrole świeżości, alerty o zmianach schematu, monitorowanie wolumenu i trendy błędów reguł pokazują, czy prawidłowe rekordy stale napływają w niezawodny sposób. Sformułowanie „potok danych jest niezawodny” powinno opisywać zachowanie przy dostarczaniu. Sformułowanie „dane są poprawne” powinno opisywać zgodność i znaczenie. Zaufanie do środowiska produkcyjnego wymaga obu tych elementów.
Typowe błędy, które niszczą zaufanie do danych
Potok danych może pomyślnie przejść kontrole pozyskiwania danych, a następnie uszkodzić zestaw danych. Błędy te ujawniają się zazwyczaj wtedy, gdy rekordy napotykają transformacje, złączenia, reguły biznesowe lub zmieniające się struktury nadrzędne. Kontrole produkcyjne muszą testować te interakcje, a nie tylko izolowane pola.
Cicha zmiana schematu
Usługa nadrzędna dodaje, usuwa, zmienia nazwę lub typ pola. Konsument może nadal działać, ponieważ zapytanie nadal się analizuje lub elastyczny ładunek akceptuje zmianę. Transformacja może następnie zmapować niewłaściwe pole, porzucić nowy status lub zmienić zachowanie wartości null bez zgłaszania błędu operacyjnego. Wskazówki dotyczące dryfu schematu od digna opisują, w jaki sposób zmiany strukturalne mogą negatywnie wpłynąć na odbiorców bez wykrycia ich przez system.
Propagacja wartości null
Wymagany klucz złączenia staje się null w niewielkiej części przychodzących rekordów. Testy schematu i typu na poziomie źródła nadal przechodzą pomyślnie, ale złączenie wyklucza te rekordy. Tabele faktów tracą powiązane wiersze, a agregacje wykazują zaniżone wartości bez wyraźnego błędu pozyskiwania. Kontrole dystrybucji i monitorowanie dopasowania złączeń mogą ujawnić tę lukę.
Niezgodności stref czasowych
Znacznik czasu może pozostać poprawny składniowo, podczas gdy zmienia się interpretacja jego strefy czasowej. Agregacje godzinowe, dzienne lub miesięczne przypisują wówczas zdarzenia do niewłaściwego okresu. Walidator formatu zatwierdza wartość, mimo że jej znaczenie analityczne uległo zmianie. Monitoring powinien porównywać założenia dotyczące stref czasowych i zachowanie na granicach okresów, zwłaszcza wokół odcięć raportowania.
Zduplikowane dostarczanie
Przesyłanie strumieniowe typu „co najmniej raz” może dostarczyć jedno zdarzenie więcej niż raz. Walidacja na poziomie wiersza zatwierdza każdą kopię, ponieważ każdy rekord jest indywidualnie poprawny. Bez idempotencji lub deduplikacji zagregowane przychody, aktywność i transakcje zostaną zawyżone. Identyfikatory zdarzeń i alerty o współczynniku duplikatów zapewniają kontrolę na poziomie zdarzeń biznesowych.
Nieaktualne wymiary
Rekord faktu może zawierać poprawnie wyglądający klucz, którego brakuje w bieżącej tabeli wymiarów. Standardowa walidacja schematu nie pokazuje, że dane referencyjne są stare. Po złączeniu analitycy mogą zobaczyć nieznane kategorie, brakujące atrybuty lub błędną segmentację. Kontrole integralności referencyjnej i kontrole świeżości wymiarów pozwalają wychwycić różne części tego problemu.
Błąd | Co wykrywa podstawowa walidacja | Co psuje się w produkcji |
|---|---|---|
Cicha zmiana schematu | Analizowalność i oczekiwane typy pól | Transformacje, złączenia lub mapowania używają zmienionej struktury |
Propagacja wartości null | Typ kolumny i podstawowy format | Złączenia pomijają rekordy, a sumy końcowe stają się niekompletne |
Niezgodność stref czasowych | Składnia znacznika czasu | Okna serii czasowych przypisują zdarzenia do niewłaściwego okresu |
Zduplikowane dostarczanie | Poprawność pojedynczego wiersza | Agregacje wielokrotnie zliczają to samo zdarzenie biznesowe |
Nieaktualne wymiary | Struktura tabeli faktów | Złączenia referencyjne tracą atrybuty lub tworzą nierozwiązane klucze |
Wnioski operacyjne są bezpośrednie: poprawność rekordu jest konieczna, ale niewystarczająca. Testy muszą również monitorować relacje, dystrybucje, zachowanie przy dostarczaniu i zmiany strukturalne. Observability łączy te kontrole z wynikami, pokazując, czy poprawny zestaw danych nadal dociera w oczekiwanym kształcie, ilości i czasie. Bez takiego wglądu zespoły walidują poszczególne elementy, pomijając awarię systemu.
Jak Timeliness i stabilność schematu dopełniają całości
Rekord może przejść każdą regułę walidacji w momencie tworzenia, a mimo to być błędny dla decyzji, którą ma wspierać. Jeśli wczorajsza migawka stanów magazynowych dotrze po dzisiejszym uruchomieniu alokacji, jej typy, zakresy i reguły biznesowe mogą być poprawne. Zbiór danych jest jednak nadal nieprzydatny, ponieważ nie odzwierciedla już aktualnego stanu operacyjnego.
Świeżość jest zatem czasowym ograniczeniem poprawności. Monitoring powinien sprawdzać, czy oczekiwane dane dotarły, czy nie brakuje żadnej partii i czy najnowsze rekordy mieszczą się w uzgodnionym oknie operacyjnym. Ten przewodnik po aktualności danych, metrykach i monitorowaniu wyjaśnia, jak sprawić, by to okno było mierzalne. A praktyczny przewodnik po monitorowaniu świeżości danych kładzie nacisk na ten sam cel operacyjny: „dane powinny być aktualne” musi stać się warunkiem, który może zostać spełniony, nie spełniony i wywołać działanie.
Trzy osie gotowości produkcyjnej
Oceń każdy krytyczny zestaw danych w trzech powiązanych ze sobą osiach:
Poprawność: Wartości spełniają wymagania dotyczące typu, formatu, zakresu, relacji i reguł biznesowych.
Świeżość: Dane docierają w uzgodnionym oknie dostawy i odzwierciedlają odpowiedni stan firmy.
Stabilność strukturalna: Pola, typy, tabele i relacje pozostają zgodne z systemami odbiorczymi.
Zestaw danych może spełniać warunki jednej osi, a na innej zawodzić. Eksport danych klienta może zawierać poprawne rekordy, ale dotrzeć już po rozpoczęciu kampanii. Transmisja strumieniowa może docierać w sposób ciągły, jednocześnie duplikując zdarzenia. Tabela może zachować swój schemat nawet po tym, jak źródło zmieni znaczenie kodu statusu.
Schema stability to aktywny kontrakt
Zmiany schematu wymagają oceny wpływu, a nie automatycznego odrzucenia. Nowa kolumna dopuszczająca wartości null może być bezpieczna dla konsumentów ignorujących nieznane pola. Usunięta kolumna, zmieniona nazwa pola lub zmiana typu mogą zepsuć transformację lub nieznacznie zmienić jej wynik.
Observability łączy świeżość, zmiany schematu, przesunięcia wolumenu i awarie potoków danych, zamiast traktować je jako odizolowane alerty. Analiza przeprowadzona przez firmę Ataccama na temat jakości danych i observability danych opisuje świeżość jako aktualność, zmiany schematu jako zmiany strukturalne, a anomalie wolumenu jako nieoczekiwane zmiany rozmiaru zestawu danych.
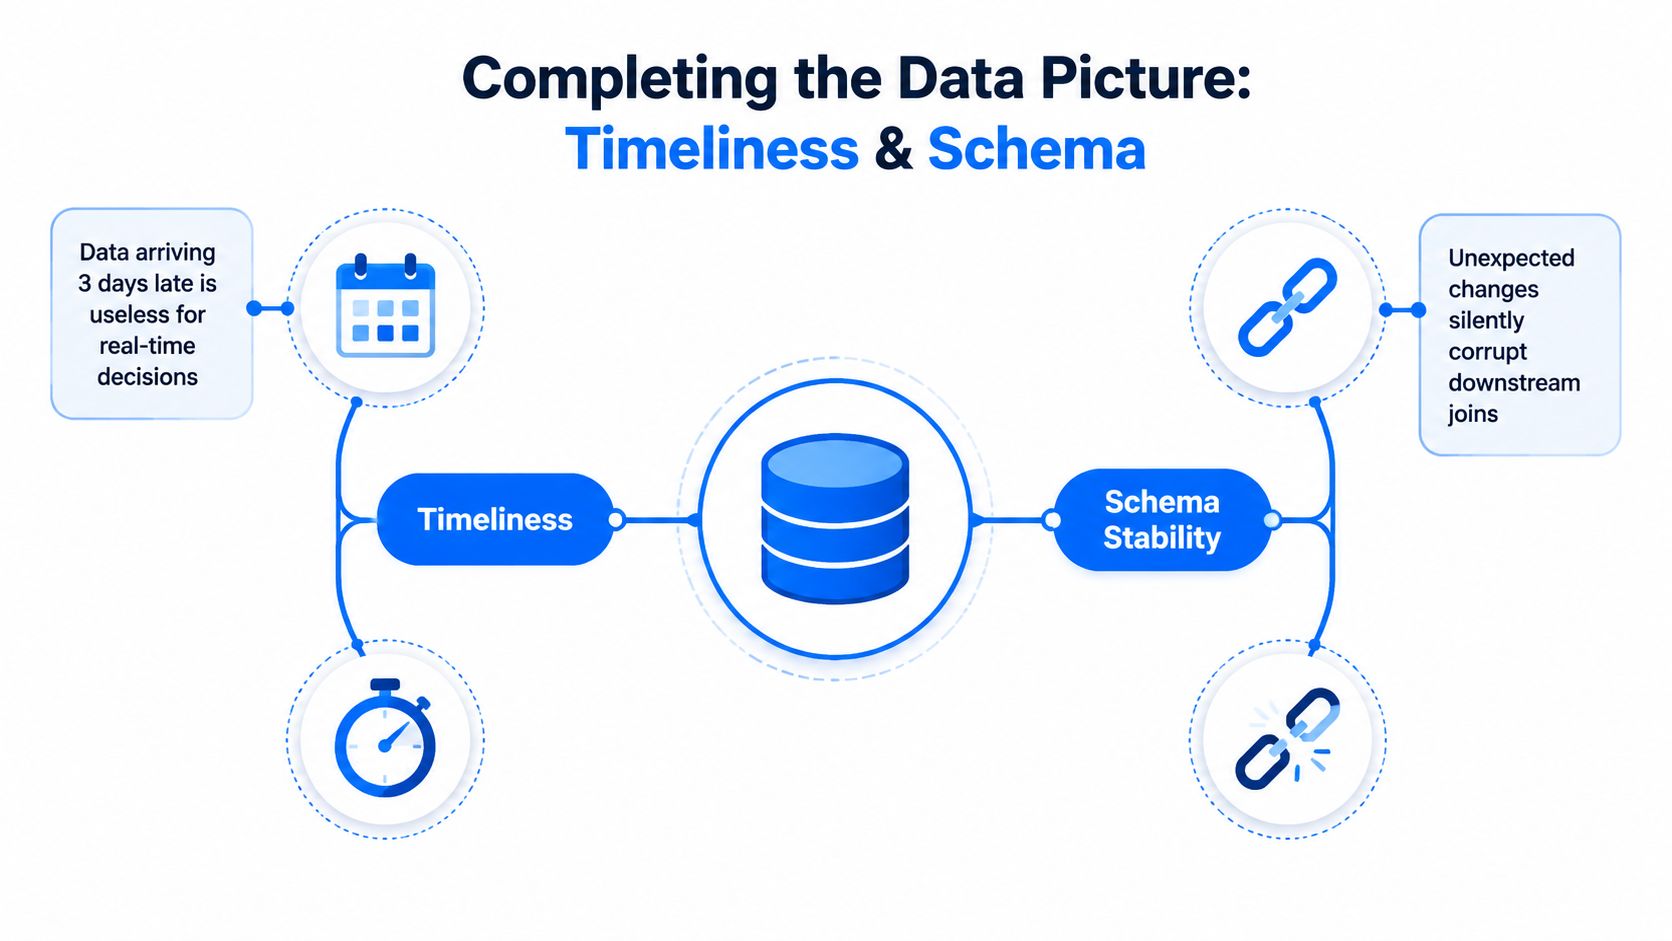
Interakcja ma większe znaczenie niż jakikolwiek pojedynczy wynik. Poprawność bez świeżości daje prawdę historyczną w niewłaściwym momencie podejmowania decyzji. Świeżość bez stabilności strukturalnej dostarcza aktualne dane, które odbiorcy mogą błędnie odczytać. Stabilność strukturalna bez poprawności zachowuje niezawodny kształt dla wadliwych wartości.
Wiarygodne dane to poprawne dane tylko wtedy, gdy poprawność, świeżość i stabilność strukturalna idą w parze.
Praktyczne mechanizmy kontrolne dla zapewnienia poprawności i niezawodności
Mechanizmy kontrolne działają najlepiej, gdy znajdują się blisko awarii, którą mają wychwycić. Pojedynczy test na końcu potoku danych to zbyt późno na uszkodzony kontrakt źródłowy, podczas gdy dziesiątki niezróżnicowanych alertów powodują zmęczenie i zachęcają zespoły do ignorowania systemu monitoringu.
Zacznij od testów wielowarstwowych
Na etapie źródłowym lub na granicy warstwy przejściowej (staging) zastosuj asercje na poziomie kolumn dla wymaganych pól, akceptowanych typów, zachowania wartości null, zakresów i zatwierdzonych wartości referencyjnych. Dodaj kontrole dystrybucji tam, gdzie poprawny rekord może nadal tworzyć niepoprawny zestaw danych, np. nagłe nagromadzenie danych w jednej kategorii lub nieoczekiwany spadek liczby wypełnionych wartości.
W warstwie integracji przetestuj relacje. Kontrole integralności referencyjnej powinny potwierdzać, że klucze się zgadzają. Kontrole unikalności powinny identyfikować zduplikowane zdarzenia biznesowe. Reguły wielokolumnowe powinny weryfikować kombinacje, takie jak status i data zakończenia, zamiast testować każde pole w izolacji.
W warstwie konsumpcji monitoruj metryki, z których korzystają interesariusze. Pulpit nawigacyjny może pozostać technicznie dostępny, podczas gdy jego podstawowe metryki przychodów, klientów lub ryzyka zachowują się nietypowo. Kontrole na poziomie biznesowym stanowią ostateczną ochronę przed błędami, których asercje niższego poziomu nie interpretują.
Dodaj operacyjny moduł Observability
Monitory świeżości powinny śledzić oczekiwane wzorce dostarczania, opóźnione partie, brakujące załadunki i wczesne dostawy. Detektory zmian schematu (schema-diff) powinny flagować dodane, usunięte, zmienione lub przekształcone pola, zanim zmiana wpływająca na działanie dotrze do modeli zależnych. Dokumentacja monitora observability danych firmy Datadog opisuje wykrywanie na poziomie bazy danych, schematu, tabeli i kolumny.
Wykrywanie anomalii wolumenu zamyka kolejną ważną lukę. Może ujawnić ciche obcięcie danych, nieoczekiwane skoki duplikatów i częściową ekstrakcję, nawet jeśli każdy dostarczony wiersz pomyślnie przejdzie walidację.
Mechanizm kontrolny | Co wychwytuje | Etap potoku danych | Ważność alertu |
|---|---|---|---|
Asercje wartości null i zakresów | Brakujące wymagane wartości i nieprawidłowe granice | Źródło lub staging | Wysoka, gdy kluczowe pola zawodzą |
Kontrole referencyjne | Nierozwiązane klucze wymiarów i referencyjne | Integracja | Wysoka dla dotkniętych złączeń |
Monitorowanie świeżości | Spóźnione, brakujące lub nieoczekiwanie wczesne ładowanie danych | Źródło i staging | Krytyczna dla zbiorów danych kluczowych przy podejmowaniu decyzji |
Wykrywanie zmian schematu (schema diff) | Dodane, usunięte, zmienione lub przekształcone pola | Kontrakt źródłowy | Krytyczna dla zmian powodujących błędy |
Wykrywanie anomalii wolumenu | Obcięcie danych, nagłe skoki duplikatów i częściowe ładowanie | Staging i konsumpcja | Wysoka, gdy wpływa na agregacje |
Monitorowanie metryk biznesowych | Nieoczekiwane zachowanie wskaźników KPI | Konsumpcja | Ważność zależy od wpływu na biznes |
Progi powinny odzwierciedlać normalne zachowanie, a nie arbitralną doskonałość. Ostrzeżenie, które uruchamia się przy każdym weekendowym wahaniu, uczy operatorów lekceważenia alertów. Użyteczny pulpit nawigacyjny stanu zdrowia danych łączy sygnały techniczne z informacją o własności, zasobach, których dotyczy problem, ostatnim pomyślnym dostarczeniu i ryzyku dla decyzji biznesowych. Zespoły mogą również stosować reguły i kontrole ciągłej walidacji danych, aby połączyć mechanizmy kontrolne na poziomie rekordów z bieżącym monitorowaniem jakości.
Why Static Validation Is Not Enough for Modern Data Platforms
Statyczne reguły walidacji są przydatnymi punktami kontrolnymi, ale stają się zawodne, gdy zespoły traktują je jako kompletną strategię zapewniania niezawodności. Reguła zapisana raz może potwierdzić, że pole nie jest puste (null), ale może pominąć nową wartość enum, zmienioną semantykę, zduplikowany wzorzec zdarzeń lub źródło, które przestało dostarczać aktualne dane.
Nowoczesne platformy przetwarzają strumieniowe zdarzenia, półstrukturalne ładunki i odpowiedzi od podmiotów zewnętrznych, które ewoluują poza cyklem Release zespołu zajmującego się hurtownią danych. Takie środowisko operacyjne wymaga ciągłego Observability, a nie tylko walidacji w określonym punkcie czasowym.
Konsekwencje biznesowe mogą być poważne. Jeden ze zgłoszonych incydentów u sprzedawcy detalicznego dotyczył statycznej kontroli wartości null, która pominęła nową wartość typu enum i błędnie przekierowała 4 miliony USD w atrybucji. Inny przykład z branży fintech dotyczył zakodowanej na stałe asercji zakresu, która nie wykryła zamiany kodu waluty, co zawyżyło oceny ryzyka. Przykłady te ilustrują główną słabość reguł statycznych: mogą one weryfikować znane warunki, jednocześnie pomijając nieznane, ale brzemienne w skutkach zachowania.
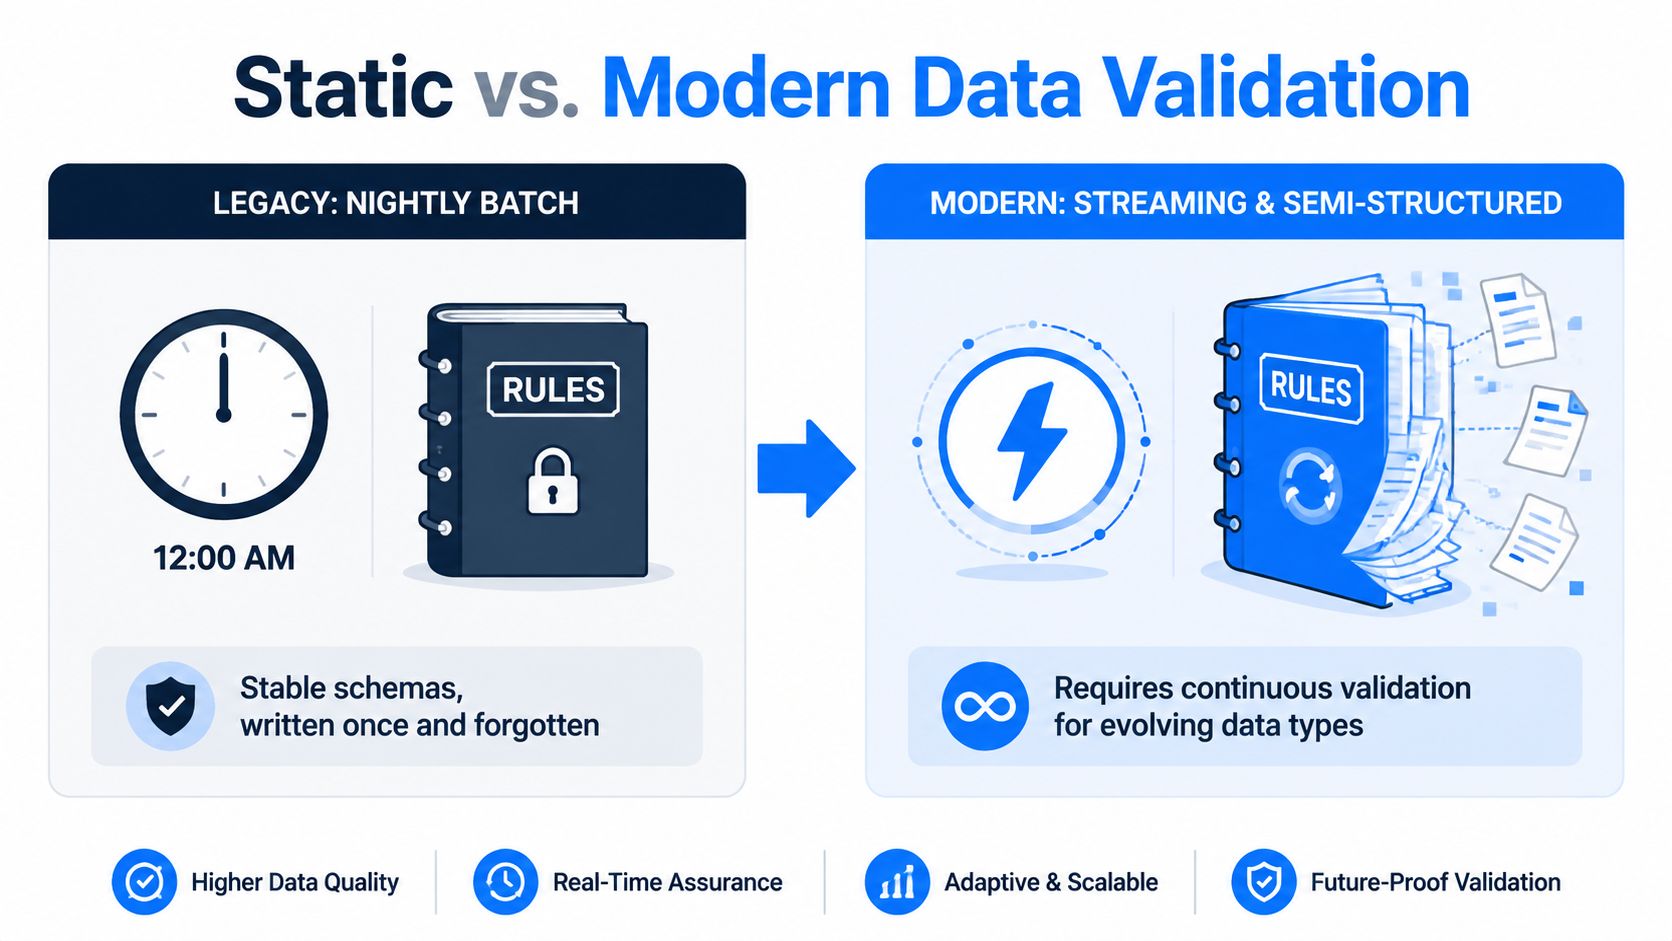
Ciągłe Observability monitoruje, jak dane zachowują się w czasie. Łączy ono wyraźne kontrakty z wykrywaniem anomalii, śledzeniem świeżości, analizą wolumenu i monitorowaniem zmian schematu. Taki model nie eliminuje reguł deterministycznych. Umieszcza je w pętli sprzężenia zwrotnego, która pozwala zidentyfikować, kiedy środowisko uległo zmianie.
Praktyczna zmiana polega na przejściu od pytania „czy ta wartość przeszła test?” do „czy ten zbiór danych nadal zachowuje się zgodnie z oczekiwaniami dla swojego celu?”. To pytanie pozwala wykryć awarie, których statyczna walidacja nie jest w stanie przewidzieć.
Budowanie skalowalnej strategii niezawodności danych
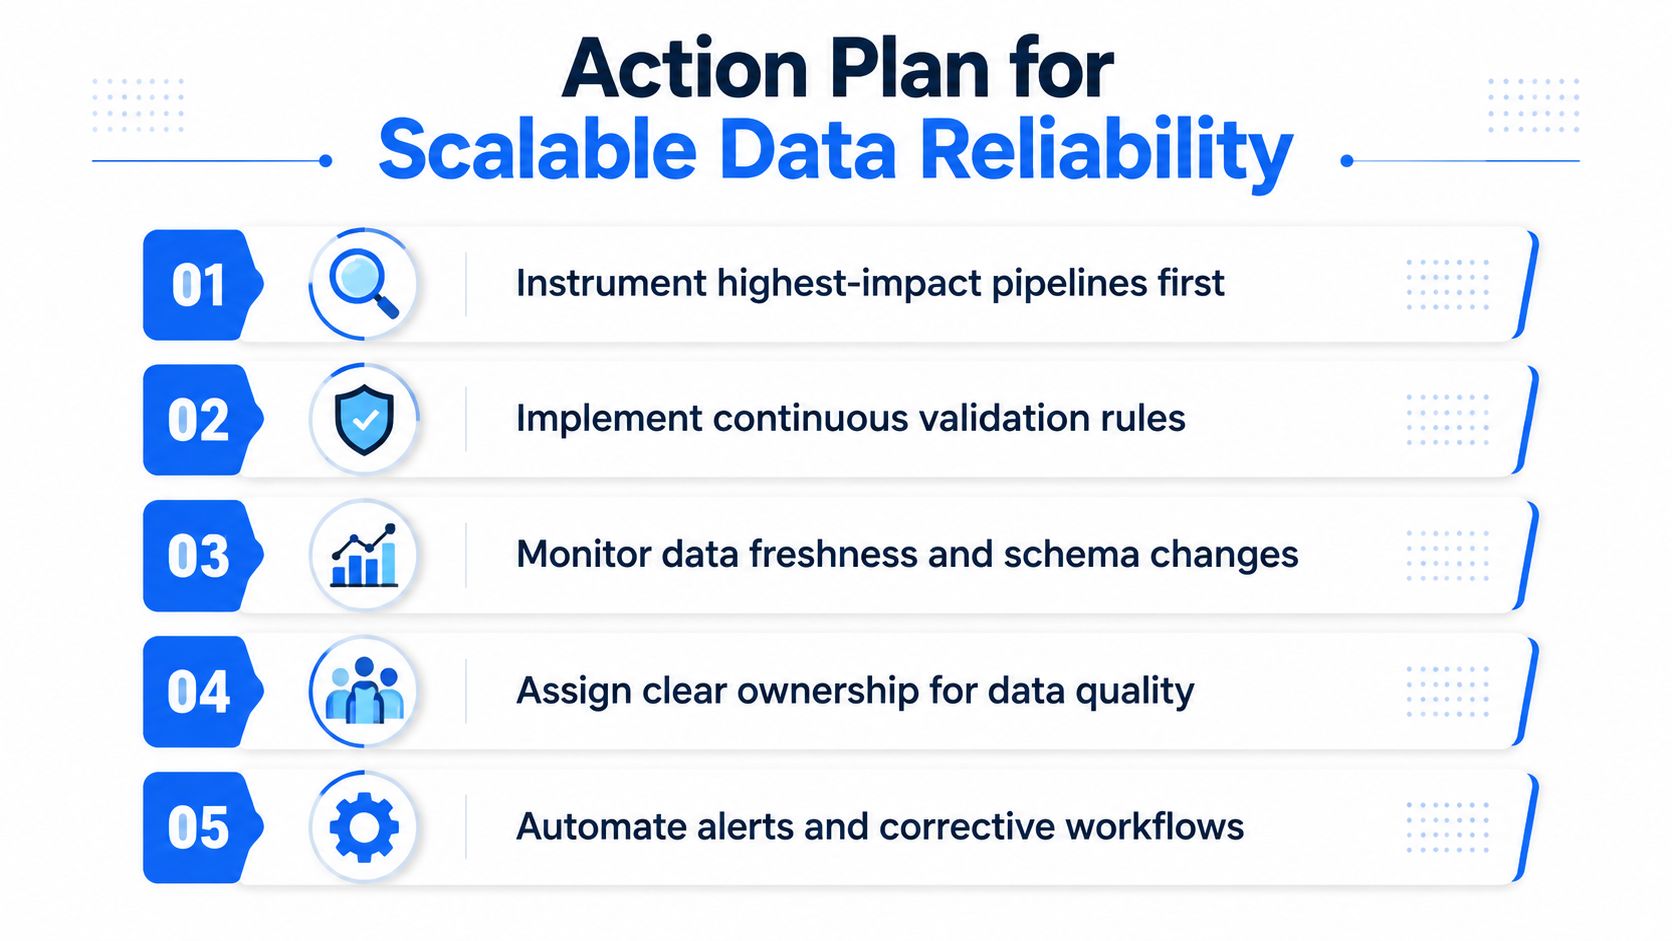
Zespoły nie muszą monitorować każdej tabeli przed poprawą zaufania. Zacznij od potoków, które zasilają raporty regulacyjne, wskaźniki zarządcze, operacje na klientach, decyzje finansowe lub funkcje AI.
Użyj następującej sekwencji:
Określ priorytety według wpływu: Przypisz krytyczne zestawy danych do decyzji i modeli, które od nich zależą.
Zdefiniuj kontrakty dostarczania: Określ oczekiwania dotyczące świeżości, kompletności i spójności schematów.
Zastosuj wielowarstwowe kontrole: Połącz deterministyczną walidację z monitorowaniem anomalii, wolumenu i struktury.
Przypisz odpowiedzialność: Zapewnij inżynierom, analitykom i biznesowym interesariuszom jasne ścieżki eskalacji.
Zamknij pętlę: Wykorzystuj incydenty do doprecyzowania progów, kontraktów i procesów naprawczych.
Dla zespołów analizujących komunikację zarządu obok danych operacyjnych, analiza językowa telekonferencji wynikowych może dostarczyć kontekstu do interpretacji języka biznesowego i sygnałów o wynikach. Tego rodzaju analiza kontekstowa nadal zależy od danych źródłowych, które muszą pozostać poprawne, aktualne i stabilne strukturalnie.
Standard operacyjny dobrze podsumowuje perspektywa digna na niezawodność danych: observability powinno łączyć stan techniczny z wiarygodnością konsumowanych danych. Skalowanie niezawodności nie polega na gromadzeniu statycznych reguł. Chodzi o budowanie pętli sprzężenia zwrotnego, które pomagają zespołom wykrywać zmiany, rozumieć ich wpływ i reagować, zanim niepoprawne dane wpłyną na decyzje.
digna pomaga zespołom ds. danych monitorować poprawność rekordów, świeżość, zmiany schematu, anomalie i metryki biznesowe w ich własnym środowisku danych. Odwiedź digna, aby zobaczyć, jak ciągłe observability może pomóc wykryć uszkodzone potoki i niepoprawne dane, zanim trafią one do pulpitów nawigacyjnych, analiz i procesów AI.
Najczęściej zadawane pytania
Czy dane mogą być niezawodne, ale nietrafne?
Tak, i ta luka powoduje jedne z najdroższych incydentów w nowoczesnych platformach danych. Niezawodność potoku oznacza, że zadanie się wykonało i wydało wynik o czasie; trafność oznacza, że wartości nadal znaczą to, co zakłada biznes.
Na co faktycznie odpowiada podstawowy monitoring?
Na pytania operacyjne: czy zadanie ruszyło, czy się skończyło, czy hurtownia przyjęła zapytanie, czy oczekiwany task wydał wynik, czy pulpit się odświeżył. To ważne, ale żadne z nich nie mówi, czy identyfikator klienta nadal wskazuje właściwego klienta.
Jak awaria trafności wygląda z zewnątrz?
Jak pytanie, a nie jak alert. Ktoś pyta, dlaczego konwersja spadła w jednym kanale, choć pulpit wciąż pokazuje udane odświeżenie, a w tym momencie wiarygodnie wyglądający potok od jakiegoś czasu publikuje już nieprawidłowe dane.
Które kontrole trafności wychwytują to, co pomija monitoring?
Te powiązane ze znaczeniem: czy identyfikator klienta nadal wskazuje właściwego klienta, czy znacznik czasu należy do zamierzonego okresu sprawozdawczego i czy kod statusu pozostaje w zatwierdzonym słowniku biznesowym.
Jak łączą się Timeliness i trafność?
Pokrywają różne połowy zaufania. Timeliness potwierdza, że dane są na miejscu, gdy potrzebuje ich decyzja; trafność potwierdza, że obecne dane opisują to, co deklarują. Zbiór potrzebuje obu, zanim ktokolwiek nazwie go godnym zaufania.



