Rozwiązania w zakresie jakości danych: Przewodnik dla kupujących 2026
|
7
min. czyt.

Prawdopodobnie znasz już tę awarię. Piątkowy pulpit nawigacyjny wyglądał czysto, poniedziałkowe poranne liczby się nie zgadzają, a zespół BI utknął na śledzeniu wadliwego ładowania, opóźnionej tabeli źródłowej lub zmiany schematu, której nikt nie zapowiedział. Zanim ktoś ponownie zaufa raportowi, model wygenerował już podejrzane wyniki, a biznes przestał działać na podstawie danych.
Spis treści
Co naprawdę robią rozwiązania do zarządzania jakością danych
To jedno pytanie powinno zadecydować o Twojej krótkiej liście
h2 id="61">Cicha awaria wewnątrz większości platform danych
Awaria rzadko wygląda dramatycznie. Hurtownia nadal się ładuje, pulpity nawigacyjne nadal się renderują, a alerty milczą. Następnie analityk zauważa, że weekendowe źródło dotarło z opóźnieniem, tabela wymiarów zmieniła swój kształt lub metryka przesunęła się na tyle, że finanse i operacje nie zgadzają się już co do liczby.
Właśnie w tym miejscu rozwiązania do zarządzania jakością danych zmieniły się z narzędzia do porządkowania zaplecza w warstwę Observability dla danych produkcyjnych. Podejście Modern Data Quality traktuje teraz tę kategorię jako klasę platformy z ciągłym monitorowaniem, walidacją i wykrywaniem anomalii w potokach analitycznych i AI, a nie tylko jako narzędzie do naprawiania rekordów po tym, jak ktoś złoży skargę. Definicja Gartnera ujmuje ten szerszy zakres jako „zestaw procesów i technologii służących do identyfikowania, rozumienia, zapobiegania, eskalacji i korygowania problemów w danych”, które wspierają podejmowanie decyzji i governance w procesach biznesowych (Ujęcie rynkowe rozwiązań jakości danych według Atlan).
Co psuje się jako pierwsze na produkcji
Pierwszą rzeczą, która zawodzi, jest zazwyczaj zaufanie, a nie potok danych. Model może nadal dokonywać oceny, ale gdy dane wejściowe ulegną dryfowi, wynik staje się trudny do obrony. Pulpit nawigacyjny BI może się stale odświeżać, ale jeśli świeżość lub dryf schematu zmieniają znaczenie liczb, zespoły przestają go używać, zanim ktokolwiek udowodni przyczynę źródłową.
Praktyczna zasada: jeśli użytkownicy częściej pytają, czy pulpit nawigacyjny jest „poprawny”, niż o to, co on oznacza, platforma potrzebuje Observability, a nie kolejnego czyszczenia wsadowego.
Starszy model zakładał, że praca nad jakością odbywała się w ramach zaplanowanych zadań czyszczenia. Nie sprawdza się to w chmurowych hurtowniach danych, środowiskach mieszanych (wsadowo-strumieniowych) ani w przepływach pracy AI, gdzie dane zmieniają się szybciej niż utrzymywane są zestawy reguł. Ta zmiana rynkowa ma znaczenie, ponieważ jakość danych jest teraz powiązana z digna Timeliness, wykrywaniem zmian schematów i gotowym na AI governance, dlatego kupujący oceniają te platformy jako część struktury operacyjnej stosu danych, a nie jako refleks programistyczny.
What Data Quality Solutions Actually Do
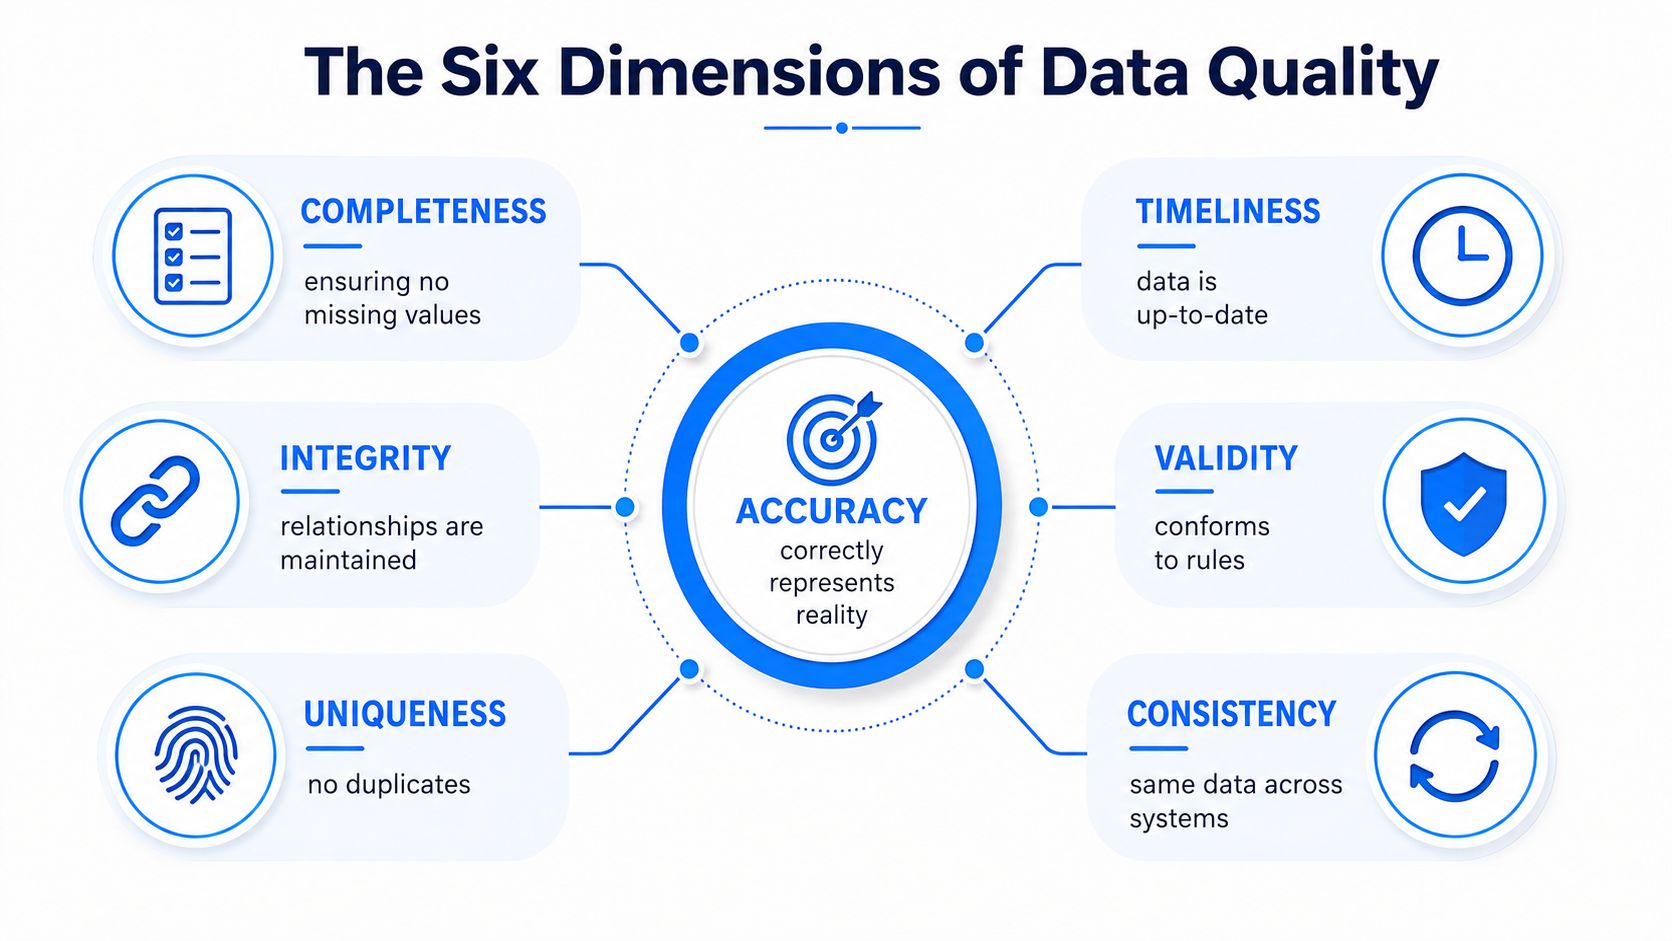
Na poziomie technicznym kategoria ta stała się mierzalna, gdy branża przestała traktować jakość jako ogólną, subiektywną ocenę. Struktura oceny jakości danych (Data Quality Assessment Framework) porządkuje jakość na: kompletność, terminowość, poprawność, integralność, unikalność i spójność, podczas gdy szersze wytyczne często dodają dokładność i dostępność jako cechy wspierające (Przegląd struktur jakości danych autorstwa Alation).
Sześć wymiarów w działającej hurtowni danych
Praktyczna platforma nie mówi po prostu „ta tabela jest zła”. Ona mierzy, co jest nie tak.
Kompletność sprawdza, czy nie brakuje wymaganych wartości.
digna Timeliness sprawdza, czy dane dotarły wtedy, kiedy powinny.
Poprawność sprawdza, czy wartości są zgodne z regułami, formatami i dozwolonymi zakresami.
Integralność sprawdza, czy relacje między tabelami są nadal zachowane.
Unikalność sprawdza, czy w miejscach, w których nie powinno ich być, nie pojawiają się duplikaty.
Spójność sprawdza, czy ta sama koncepcja zgadza się w różnych systemach.
Te ramy mają znaczenie, ponieważ zmieniły kwestię jakości w problem inżynieryjny. Wynik jakości danych może być zbudowany z wymiarów takich jak dokładność, kompletność, spójność, terminowość, poprawność i unikalność i połączony w ważony procent. Dzięki temu zespoły inżynierskie i interesariusze biznesowi mogą patrzeć na ten sam sygnał bez konieczności czytania tej samej logiki zapytań.
Praktyczne słownictwo, którego powinni używać kupujący
Najprostszym sposobem oceny dostawców jest pytanie, jakie wymiary mierzą, jak je mierzą i co robią, gdy metryka się zmienia. Jeśli platforma nie potrafi wyrazić brakujących wartości, nieprawidłowych formatów, wskaźników duplikacji lub progów świeżości w sposób, na który Twój zespół może zareagować, oznacza to, że nie realizuje ona zadań związanych z jakością w środowisku produkcyjnym.
Skorzystaj z tego przewodnika po metrykach jakości danych, aby przyporządkować wymiary do kontroli operacyjnych przed porównaniem narzędzi.
Powód, dla którego stało się to kategorią oprogramowania, jest prosty. Gdy jakość staje się zestawem metryk z punktami odniesienia, progami i dryfem, można ją monitorować w sposób ciągły. To zupełnie co innego niż czyszczenie danych po tym, jak raport okaże się błędny.
Cztery komponenty techniczne, które mają znaczenie
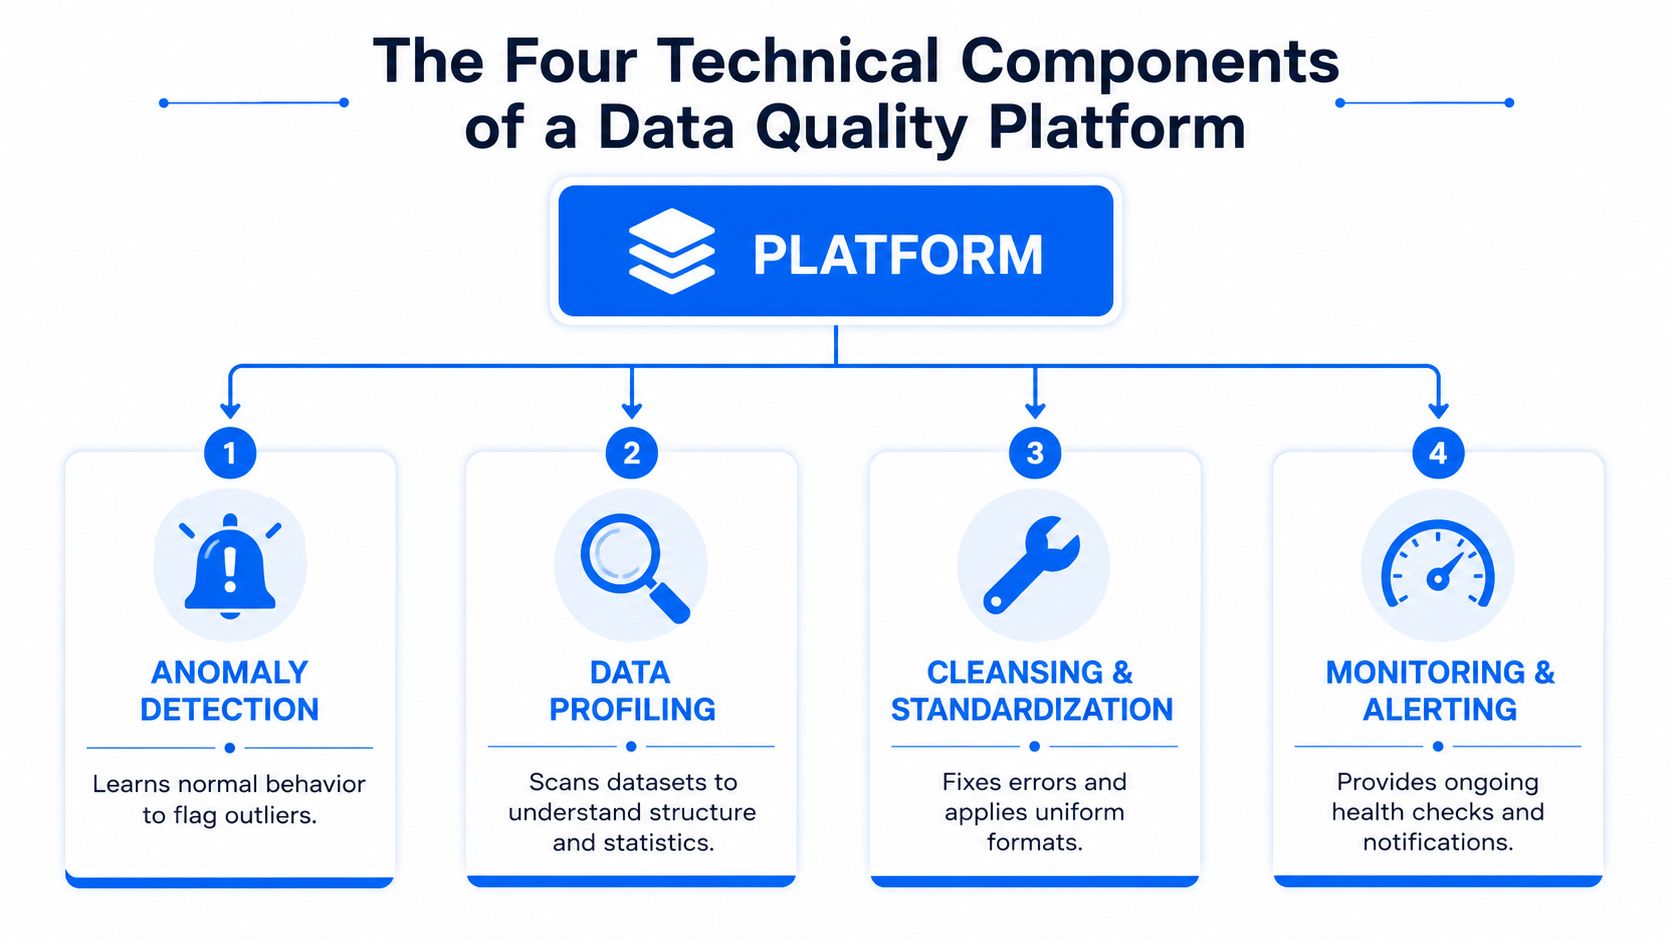
Większość platform produkcyjnych opiera się na czterech możliwościach i nie wszystkie z nich są współzamienne. Wykrywanie anomalii, terminowość, walidacja oraz śledzenie schematów rozwiązują różne tryby awarii, a dobra platforma wie, którą z nich zastosować jako pierwszą.
Anomaly detection and validation aren't the same thing
Wykrywanie anomalii uczy się, jak wygląda norma, a następnie flaguje odchylenia w wolumenie, rozkładzie lub zachowaniu bez zmuszania człowieka do pisania nowej reguły dla każdej zmiany pola. Gartner opisuje nowoczesne rozszerzone rozwiązania jakości danych jako łączące profilowanie i monitorowanie z AI/ML, analizą grafów i analityką metadanych w celu wykrywania wartości odstających, anomalii, wzorców i dryfów w źródłach lokalnych, chmurowych, relacyjnych, nierelacyjnych, wsadowych i strumieniowych (Gartner o rozszerzonych rozwiązaniach jakości danych).
Walidacja jest węższa i bardziej jednoznaczna. Sprawdza, czy wiersz spełnia znaną regułę biznesową lub techniczną, co jest idealne, gdy oczekiwanie jest stabilne, np. format kodu, wymagane pole lub wartość ograniczona przedziałem.
Użyteczny podział wygląda następująco: wykrywanie anomalii znajduje to, o czym nie wiedziałeś, że należy tego szukać, a walidacja wymusza to, o czym już wiesz, że powinno być prawdą.
Timeliness and schema tracking catch different outages
digna Timeliness monitoruje oczekiwane okna dostarczenia i wykrywanie opóźnień. Jeśli ładowanie źródła zazwyczaj następuje do określonego czasu i nie mieści się w tym schemacie, platforma powinna to ujawnić, zanim nieświeże dane dotrą do pulpitu nawigacyjnego lub magazynu funkcji ML. Śledzenie schematów monitoruje dodane kolumny, usunięte kolumny oraz zmiany typów, które często są przyczyną niepowodzeń dalszych transformacji lub błędnych połączeń (joins).
Wielką wartością jest nie tylko samo wykrywanie, ale też klasyfikacja (triage). Wytyczne branżowe zalecają łączenie profilowania, kontroli świeżości i analizy przyczyn źródłowych opartej o pochodzenie danych (lineage), aby zespoły mogły stwierdzić, czy problem wynika z opóźnienia źródła, błędu transformacji, czy dryfu na dalszych etapach (Wskazówki lakeFS dotyczące narzędzi jakości danych). Skraca to czas reakcji na incydenty, ponieważ alert wskazuje na klasę awarii, a nie tylko na sam objaw.
How the four map back to the quality dimensions
Wykrywanie anomalii zazwyczaj pomaga w zapewnieniu spójności, integralności, a czasem kompletności. digna Timeliness mapuje się bezpośrednio na wymiar, jakim jest digna Timeliness. Walidacja obejmuje poprawność i częściowo dokładność. Śledzenie schematów chroni spójność i często tłumaczy błędy w integralności na dalszych etapach.
To mapowanie to model mentalny, który warto zapamiętać. Dostawca może mieć silną walidację, a mimo to pomijać opóźnione dane. Inny może szybko wykrywać anomalie, ignorując przy tym reguły biznesowe. Systemy produkcyjne wymagają zarówno odpowiedniego pokrycia, jak i umiejscowienia tych mechanizmów.
Where the Quality Engine Runs
Architektura to kluczowa decyzja zakupowa. Jeśli silnik jakości działa w złym miejscu, platforma może być technicznie sprawna, a mimo to nie przejść audytu bezpieczeństwa, generować opóźnienia lub naruszać wymagania dotyczące lokalizacji przechowywania danych (residency).
Three execution models behave very differently
Wykonywanie wewnątrz bazy danych (In-database execution) utrzymuje kontrole wewnątrz hurtowni lub bazy danych klienta. Zazwyczaj oznacza to mniejszy ruch danych, mniejszą ekspozycję i szybszą inspekcję, ponieważ dane nie opuszczają pierwotnego systemu. Dobrze pasuje to również do sytuacji, gdy zespoły chcą, aby obliczanie metryk pozostało blisko danych, a działy ds. prywatności nalegają na ścisłą kontrolę.
SaaS zarządzany przez dostawcę centralizuje przetwarzanie w środowisku dostawcy. Zaletą jest prostsza obsługa zarządzana, ale kompromis jest oczywisty: dane muszą przekroczyć granicę, co rodzi pytania o dostęp, lokalizację przechowywania oraz to, co dokładnie jest kopiowane lub transformowane.
Wdrożenia hybrydowe dzielą pracę. Niektóre kontrole pozostają blisko danych, podczas gdy szersza orkiestracja, alerty lub przepływy pracy metadanych żyją gdzie indziej. Może to działać dobrze, ale tylko wtedy, gdy platforma jasno określa ten podział, aby inżynierowie mogli analizować kwestie opóźnień i bezpieczeństwa.
Pierwsze pytanie dotyczące architektury to nie „jakie funkcje posiadacie?”, ale „dokąd trafiają dane i kto może je zobaczyć?”.
Why regulated industries ask different questions
Finanse, opieka zdrowotna, telekomunikacja i sektor publiczny zazwyczaj mniej dbają o długą listę funkcji, a bardziej o operacyjne konsekwencje wdrożenia. Czy dostawca może przetwarzać dane bez ujawniania wierszy produkcyjnych? Czy platforma może działać w chmurze prywatnej lub lokalnie (on-premise)? Czy model nie obciąża niepotrzebnie potoku danych? Czy pozwala na przechowywanie danych w środowisku klienta?
To jest właśnie ta luka na większości stron rynkowych. Wspominają o monitorowaniu, governance i pochodzeniu danych (lineage), ale rzadko stawiają sprawę wdrożenia na samym początku. Dla kupujących z branż regulowanych to pominięcie jest kosztowne, ponieważ niewłaściwa topologia może zablokować zakup na długo przed zakończeniem oceny technicznej.
Questions that surface architectural risk fast
Gdzie odbywa się przetwarzanie? Jeśli opuszcza granice Twojej chmury, wyjaśnij dlaczego.
Jakie dane są kopiowane? Metadane to jedno, rekordy produkcyjne to drugie.
Czy oprogramowanie może działać w Twoim środowisku? Chmura prywatna i on-premise nie są opcjonalne w wielu przedsiębiorstwach.
Co dzieje się z opóźnieniami? Dodatkowe etapy mają znaczenie, gdy potoki danych są już i tak mocno obciążone.
Właściwa odpowiedź zależy od obciążenia pracą, ale architektura powinna być jasna, zanim ktokolwiek zacznie rozmawiać o pulpitach nawigacyjnych.
Choosing by Workload Not by Feature List
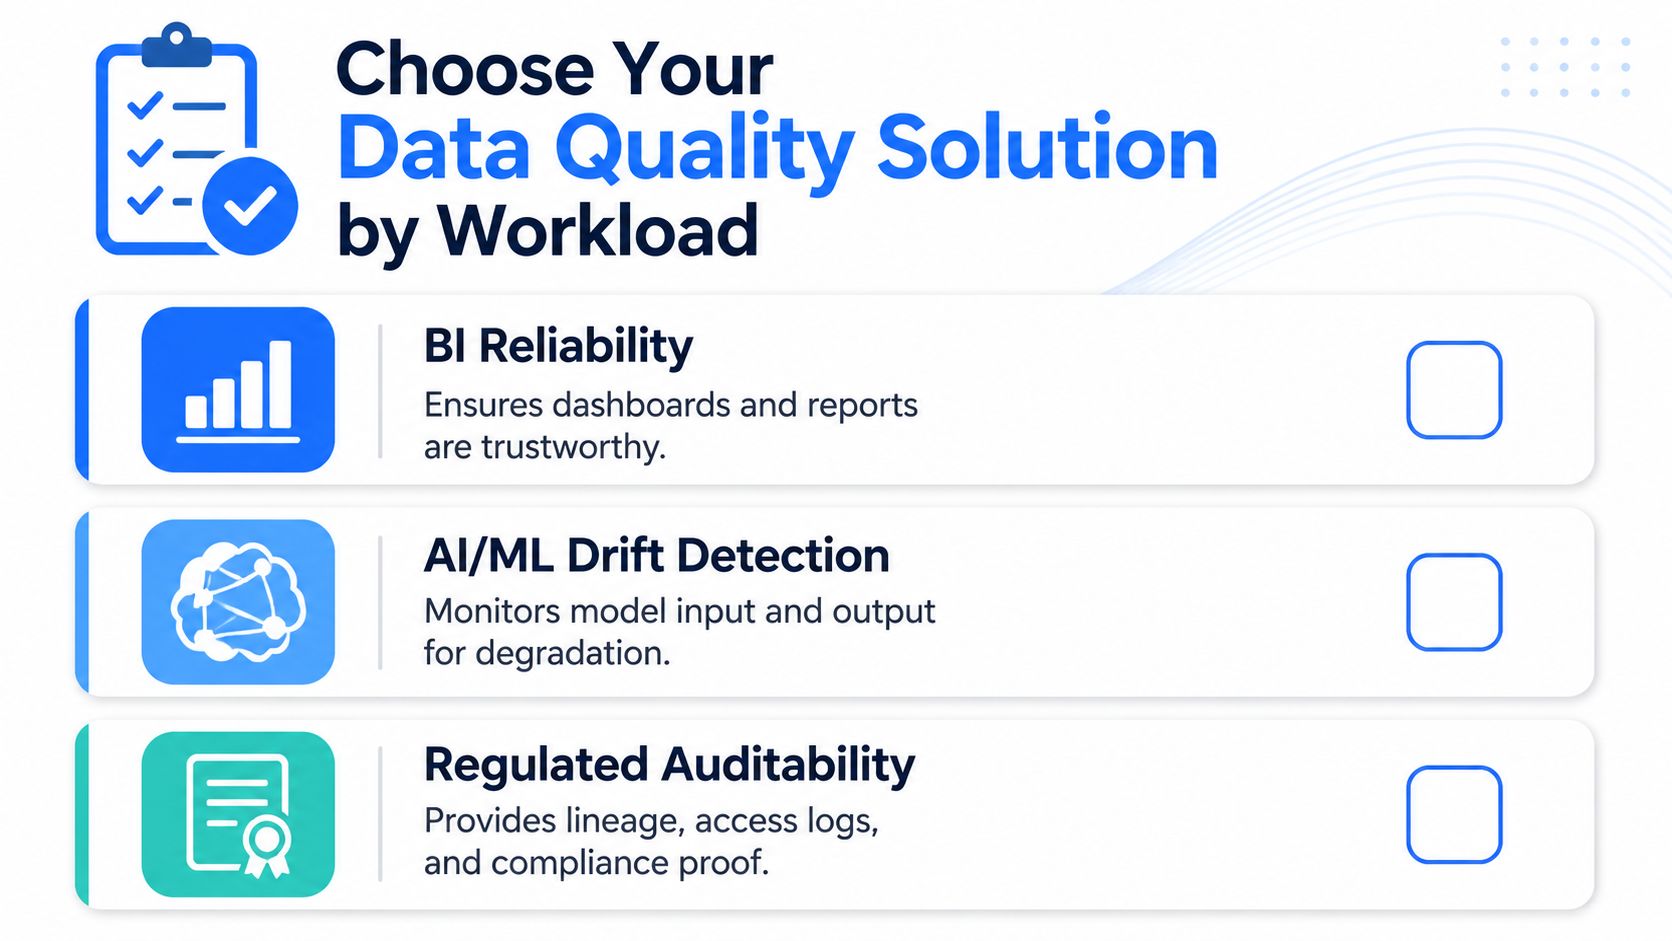
Listy funkcji przesłaniają kluczową decyzję. Niezawodność BI, wykrywanie dryfu AI i audytowalność w branżach regulowanych nie wymagają tego samego zestawu kontroli, a zakup niewłaściwej kombinacji zazwyczaj prowadzi do jednego z dwóch rezultatów: zbyt wielu alertów lub zbyt słabego sygnału.
Match the workload to the control surface
Dla niezawodności BI najważniejsze są na początek digna Timeliness i walidacja. Pulpity nawigacyjne psują się najczęściej, gdy źródło jest opóźnione, dane wejściowe są niepełne lub reguła biznesowa zmienia się pod raportem. Platforma powinna wcześnie ujawniać nieświeże ładowania i zapobiegać dotarciu uszkodzonych wierszy do raportów zarządczych.
Dla wykrywania dryfu w AI i ML większe znaczenie mają wykrywanie anomalii i śledzenie schematów. Modele mogą tolerować pewne warianty, ale nie mogą bez końca tolerować cichych przesunięć rozkładu danych. Gdy setki tabel zmieniają się w czasie, statyczne reguły nie nadążają i uczenie statystyczne staje się praktycznym rozwiązaniem.
Dla audytowalności w branżach regulowanych kluczowe są walidacja, integralność, kontekst pochodzenia danych (lineage) oraz ścieżki audytu. Celem nie jest tylko wyłapanie błędnego rekordu. Chodzi o udowodnienie, co zostało sprawdzone, kiedy to sprawdzono i jaka logika została zastosowana.
The organizational piece decides whether the tool survives
Badacze z MIT, opisując zarządzanie jakością danych, wskazali pięć krytycznych czynników sukcesu: certyfikację istniejących danych korporacyjnych, standaryzację definicji danych, certyfikację źródeł zewnętrznych, kontrolowanie generowania wewnętrznego oraz zapewnienie audytowalności danych. Opisali również pięcioczęściowy model operacyjny oparty na wizji dopasowanej do biznesu, centralnej odpowiedzialności w systemach informatycznych (IS), edukacji kierowników projektów i systemów, szkoleniach dla całej organizacji IS oraz ciągłym doskonaleniu (Artykuł MIT dotyczący zarządzania jakością danych).
To nie jest abstrakcyjna porada dotycząca governance. Wyjaśnia ona, dlaczego niektóre wdrożenia są przyjmowane, a inne porzucane. Jeśli odpowiedzialność jest niejasna lub ścieżki audytu są słabe, narzędzie staje się kolejnym miejscem, w którym alerty po prostu umierają bez echa.
A short shortlist checklist
Najpierw określ obciążenie pracą. Przypadki użycia związane z BI, AI lub audytem wymagają różnych sygnałów.
Sprawdź najsłabszy wymiar. Opóźnione dane, błędne zmiany schematu lub naruszenia reguł zazwyczaj ujawniają lukę.
Zapytaj, kto odpowiada za wyjątki. Jeśli nikt nie zajmuje się dalszymi działaniami, platforma szybko się zestarzeje.
Potwierdź audytowalność. Potrzebujesz ścieżki śledzenia, a nie tylko samego alertu.
Zweryfikuj model operacyjny. Ciągłe doskonalenie za każdym razem wygrywa z jednorazowym czyszczeniem.
From Proof of Value to Production
Najszybsza demonstracja Proof of Value zazwyczaj maskuje najtrudniejszą pracę produkcyjną. Platforma wygląda świetnie, gdy ktoś skieruje ją na czystą, przykładową tabelę, ale zatrzymuje się, gdy musi nauczyć się punktów odniesienia (baselines), zintegrować się z potokami i wspierać ludzi będących właścicielami danych.
The implementation sequence that actually works
Zacznij od uczenia się punktów odniesienia na danych historycznych. Daje to platformie normalne zakresy, oczekiwane rozkłady i wzorce docierania danych, zamiast zmuszania do tworzenia każdej kontroli od podstaw jako sztywno zapisanej reguły. Następnie skonfiguruj zbiory danych i tabele metryk, które chcesz obserwować, ponieważ systemy produkcyjne wymagają jasnego wykazu tego, co jest monitorowane.
Kolejnym krokiem jest konfiguracja reguł walidacji. Zespoły kodują oczekiwania biznesowe, których nie można wywnioskować statystycznie, takie jak dozwolone formaty, wymagane wartości i kontrole krzyżowe pól. Następnie zintegruj platformę ze ścieżkami agregacji i transformacji, tak aby kontrole były uruchamiane tam, gdzie dochodzi do awarii, a nie dopiero po tym, jak hurtownia zostanie już zanieczyszczona.
Where teams usually stall
Większość przestojów zdarza się na etapie przekazywania zadań. Inżynierowie danych są właścicielami potoku, analitycy są właścicielami pulpitu nawigacyjnego, a biznes jest właścicielem procesu – ale nikt nie jest właścicielem kolejki wyjątków. Kiedy alerty są zbyt hałaśliwe lub interfejs użytkownika jest zbyt techniczny, ludzie przestają go otwierać. Kiedy system wymaga osobnych narzędzi do digna Timeliness, walidacji i śledzenia zmian schematu, rutynowe monitorowanie staje się przykrym obowiązkiem, a nie nawykiem.
Praktyczna zasada: jeśli pierwszy miesiąc wymaga specjalisty do każdej nowej tabeli, wdrożenie samoobsługowe (self-service) napotka poważne trudności.
What the platform should produce along the way
Potrzebujesz wyuczonych rozkładów, zaplanowanych kontroli świeżości, migawek schematów oraz wspólnego widoku trendów, który mogą odczytać zarówno analitycy, jak i inżynierowie. Dobre wdrożenie ułatwia również przeglądanie incydentów, ponieważ zespół może porównać wczorajszy punkt odniesienia z dzisiejszą awarią bez konieczności odtwarzania całego potoku z pamięci.
Przepływ pracy monitorowania ma kluczowe znaczenie, ponieważ jakość produkcji to pętla, a nie jednorazowa konfiguracja. Platforma musi stale się uczyć, wysyłać alerty i zachowywać wystarczającą historię, aby wyjaśnić, co się zmieniło.
How This Comes Together in digna
Problem przedsiębiorstwa nie jest trudny do zdefiniowania. Raporty stają się nieświeże, modele dryfują, a zmiany schematów umykają uwadze, ponieważ kontrole odbywają się w zbyt wielu miejscach. Platforma pomaga tylko wtedy, gdy łączy wykrywanie anomalii, digna Timeliness, walidację i śledzenie schematów w jeden model operacyjny, działający blisko danych.
What the platform pieces do together
digna Data Anomalies uczy się normalnych zachowań i flaguje nieoczekiwane zmiany bez konieczności ciągłej konserwacji reguł. digna Data Analytics bada historyczne metryki Observability, dzięki czemu zespoły mogą dostrzec trendy, przesunięcia i wzorce zamiast pojedynczego, punktowego alertu. digna Timeliness monitoruje punktualność dostarczania danych pod kątem wyuczonych wzorców i harmonogramów użytkowników, co pozwala wychwycić opóźnione lub brakujące załadunki, zanim odczuje to biznes.
digna Data Validation wymusza reguły na poziomie rekordów na potrzeby logiki biznesowej i wymogów audytowych, podczas gdy digna Schema Tracker flaguje dodane, usunięte lub zmienione pod kątem typu kolumny. To połączenie idealnie mapuje się na omówione wcześniej wymiary jakości, zwłaszcza na kompletność, digna Timeliness, poprawność, integralność, unikalność i spójność.
Why the execution model matters here
Wybór architektury decyduje o przydatności produktu w środowiskach regulowanych. Obliczanie metryk wewnątrz bazy danych (In-database) zatrzymuje dane w środowisku klienta, a wdrożenie w chmurze prywatnej lub on-premise oznacza, że dostawca nie ma dostępu do produkcyjnych zbiorów danych. Ogranicza to przesyłanie danych i znacznie ułatwia rozmowy na temat prywatności i lokalizacji danych (residency) z zespołami ds. bezpieczeństwa.
Zunifikowany interfejs użytkownika ma również znaczenie w praktyce. Gdy inżynierowie, analitycy i interesariusze widzą tę samą linię trendu, alert i historię schematu, zespoły spędzają mniej czasu na uzgadnianiu narzędzi, a więcej na naprawianiu potoku danych. Na tym polega wartość połączenia Observability i jakości w jednym miejscu – mniej barier między wykryciem, wyjaśnieniem i działaniem.
The One Question That Should Drive Your Shortlist
Większość dyskusji kupujących zaczyna się od funkcji, a kończy na obawach dotyczących architektury, które powinny zostać poruszone na samym początku. Lepsze pytanie jest proste: czy to rozwiązanie działa tam, gdzie znajdują się nasze dane, pasuje do naszego modelu bezpieczeństwa i governance oraz informuje nas o problemach, zanim dowie się o nich biznes?
Jeśli odpowiedź brzmi „tak”, potwierdź resztę punktów po kolei. Sprawdź lokalizację wykonywania procesów. Sprawdź dostęp dostawcy do danych produkcyjnych. Sprawdź zakres wykrywania anomalii, digna Timeliness, walidacji i śledzenia schematów. Sprawdź dopasowanie do obciążenia pracą, które zainicjowało ocenę. Upewnij się, że model operacyjny wspiera ciągłe doskonalenie, a nie tylko jednorazowe sprzątanie.
Nowoczesne rozwiązania do zarządzania jakością danych nie są już tylko wąskimi narzędziami do oczyszczania. To operacyjne platformy do zapewniania Observability, wykrywania zmian w schematach, monitorowania terminowości i gotowego na AI governance. Jeśli Twoja krótka lista nie potrafi wyjaśnić tych elementów w kontekście Twojego środowiska, oznacza to, że nie jest gotowa na wdrożenie produkcyjne.
Jeśli chcesz platformy zbudowanej wokół kontroli jakości wewnątrz bazy danych (in-database), prywatnego wdrożenia oraz ciągłego monitorowania anomalii, digna Timeliness, walidacji i zmian w schematach, zapoznaj się z rozwiązaniem digna. Zostało ono zaprojektowane dla zespołów, które potrzebują, aby jakość danych pozostała w ich własnym środowisku, dając jednocześnie inżynierom i interesariuszom jedno miejsce do sprawdzania, co się zmieniło i dlaczego.