Niespójne źródła danych: Praktyczny przewodnik integracji
|
7
min. czyt.
Prawdopodobnie już to przeżyłeś. Poniedziałkowe spotkanie standup rozpoczyna się od słów jednej osoby, że system CRM wskazuje na silny ubiegły kwartał, dział finansów twierdzi, że marża wygląda zupełnie inaczej, a magazyn produktów pokazuje jeszcze trzecią liczbę. Nikt nie kłamie, ale w pokoju i tak zapada cisza, ponieważ każdy raport opisuje nieco inną wersję firmy.
To właśnie sprawia, że rozproszone źródła danych są tak frustrujące. Problemy rzadko zaczynają się od spektakularnej awarii – zaczynają się od drobnych decyzji, znacznika czasu zinterpretowanego w jeden sposób w jednym potoku, reguły zwrotów zaktualizowanej w innym lub definicji „aktywnego klienta”, która zmieniła się na tyle, by zniekształcić pulpit nawigacyjny. Jeśli odziedziczyłeś stos raportowania, który rósł wraz z przeszłymi inicjatywami, fuzjami, zmianami dostawców i „tymczasowymi” poprawkami, które nigdy nie zniknęły, doskonale wiesz, jak normalne się to wydaje.
Spis treści
Gdy Twoje raporty przestają być spójne
Co naprawdę oznaczają rozproszone źródła danych
Stos niedopasowań
Cztery praktyczne wyzwania, na które natrafisz jako pierwsze
Cztery tryby awarii, które ujawniają się wcześnie
Strategie integracji, spośród których warto wybierać
Harmonizacja i walidacja, które wytrzymują próbę czasu
Ujednolicenie znaczenia przed liczbą
Gdzie jest miejsce na walidację
Monitorowanie jako system wczesnego ostrzegania
Sygnały monitorowania i to, co wykrywają
Lista kontrolna do wdrożenia przy kolejnym projekcie integracyjnym
Decyzje przed wdrożeniem
Budowa i walidacja
Gdy Twoje raporty przestają być spójne
Lider finansowy przychodzi z arkuszem kalkulacyjnym, analityk produktu otwiera pulpit nawigacyjny magazynu danych, a zespół CRM wskazuje na swój własny widok przychodów. Wszystkie trzy liczby na pierwszy rzut oka wyglądają rozsądnie, co sprawia, że brak spójności jest jeszcze bardziej kłopotliwy. Zespół nie otrzymuje wyraźnego sygnału o błędzie, lecz trzy prawdopodobne historie, z których żadna nie może być w pełni prawdziwa jednocześnie.
Zazwyczaj jest to moment, w którym ludzie obwiniają magazyn danych, warstwę BI lub ostatnie zadanie ETL, którego dotykali. Przyczyna często leży jednak wyżej. Jeden potok mógł przeliczyć znaczniki czasu na czas lokalny, inny mógł zastosować nową politykę zwrotów, a trzeci może nadal liczyć „aktywnego klienta” według definicji, której nikt nie udokumentował po ostatnim wdrożeniu.
Właśnie dlatego uzgadnianie danych w mniejszym stopniu polega na „sprawianiu, by raporty pasowały do siebie”, a bardziej na śledzeniu, który system jest właścicielem danej wersji rzeczywistości. Przydatnym punktem wyjścia jest prosty model myślowy: każde źródło ma własne reguły, a reguły te mogą się rozchodzić bez intencji jakiegokolwiek zespołu. Przystępne wyjaśnienie tego problemu uzgadniania znajdziesz w przeglądzie uzgadniania danych digna.
Zasada praktyczna: jeśli trzy raporty się nie zgadzają, nie zaczynaj od przepisywania pulpitu nawigacyjnego. Zacznij od pytania, które pole, reguła lub znacznik czasu zmieniły się jako pierwsze.
To zamieszanie jest tak powszechne, ponieważ nowoczesne stosy danych powstają w wyniku nawarstwiającej się historii, a nie z jednego czystego diagramu architektury. Oznacza to, że to samo zdarzenie biznesowe może być reprezentowane w systemie CRM, systemie finansowym, magazynie danych i narzędziu wsparcia – każde z nich ma własny cykl i własne słownictwo. Gdy tak się dzieje, „liczba” przestaje być jedną liczbą, a staje się przedmiotem negocjacji między systemami.
Co naprawdę oznaczają rozproszone źródła danych
Słowo „rozproszone” brzmi jak problem z formatem, ale to tylko pierwsza warstwa. Jedno źródło może dostarczać dane w formacie JSON, inne jako CSV, kolejne jako Parquet, a eksport od dostawcy może być zablokowany we własnej strukturze. Nawet na tym poziomie kształt danych wpływa już na sposób ich pobierania, parsowania i walidacji.
Kolejną warstwą jest cykliczność. Nocny plik wsadowy, strumieniowy kanał zdarzeń i ręcznie utrzymywany arkusz kalkulacyjny zachowują się w potoku zupełnie inaczej. Jeśli potraktujesz je tak samo, najświeższe źródło może okazać się najmniej wiarygodne, ponieważ dociera w złym czasie, z niewłaściwymi założeniami.
Następnie pojawia się warstwa, którą większość przewodników pomija: semantyka. Dwa systemy mogą mieć kolumnę o nazwie customer_id, ale w jednym może to być klucz główny systemu ewidencji, podczas gdy w drugim jest to identyfikator marketingowy, który został zanonimizowany na potrzeby raportowania kampanii. Etykiety się zgadzają, ale znaczenie już nie – i to właśnie tutaj naiwne złączenia wprowadzają ludzi w błąd.

Stos niedopasowań
Dobrym sposobem na wyobrażenie sobie rozproszonych źródeł danych jest stos. Różnice formatów znajdują się na samym dole, powyżej są granice systemów, a różnice semantyczne na samej górze, tam gdzie żyje znaczenie biznesowe. Każda warstwa potęguje tę poniżej, dlatego złączenie może wyglądać na udane technicznie, a jednocześnie być błędne pod kątem analitycznym.
Gdy zespoły szukają lepszego procesu wyszukiwania w magazynach, interfejsach API i starszych narzędziach, zazwyczaj potrzebują sposobu na wczesne ujawnienie tych warstw. Praktycznym punktem wyjścia są wskazówki dotyczące wyszukiwania danych od digna, ponieważ inwentaryzacja źródeł i kontrole znaczenia muszą nastąpić, zanim transformacje utrwalą błędne założenia.
Zbiór danych może być idealnie sformatowany, a mimo to błędny w kontekście pytania, które zadajesz.
To jest właśnie sedno nieporozumienia. Ludzie często zakładają, że integracja danych polega głównie na przenoszeniu bajtów z jednego miejsca do drugiego. W praktyce chodzi o dopasowanie formatu, cykliczności, konstrukcji systemu i znaczenia biznesowego, tak aby ostateczny widok nie tylko pomyślnie się załadował, ale też mówił prawdę.
Cztery praktyczne wyzwania, na które natrafisz jako pierwsze
Pierwsze problemy z integracją pojawiają się szybko i zazwyczaj wyglądają prozaicznie. Dane wyjściowe z webhooka Stripe docierają jako zagnieżdżony JSON, podczas gdy starszy system ERP wciąż generuje nocne pliki o stałej szerokości znaków. Niedopasowanie kształtu jest oczywiste, ale kosztem jest ciągłe wnioskowanie o schemacie i czas poświęcony przez ludzi na decydowanie, które pole jest nadrzędne.
Cztery tryby awarii, które ujawniają się wcześnie
Wyzwanie | Jak to wygląda | Typowy objaw |
|---|---|---|
Heterogeniczność formatów | Zagnieżdżony JSON z jednej strony, eksporty o stałej szerokości z drugiej | Zadania ładowania przerywają się lub wnioskują o błędnym schemacie |
Niedopasowanie cykliczności | Zgłoszenia w czasie rzeczywistym zmieszane z cotygodniowymi plikami ankiet | Pulpity nawigacyjne starzeją się po cichu i wprowadzają użytkowników w błąd |
Różnice w jakości | Wzbogacanie danych zewnętrznych obok niepełnego strumienia kliknięć własnych | Wartości null, duplikaty i niestabilne agregaty |
Konflikt semantyczny | „Kraj” oznacza kod ISO w jednym systemie i dowolny tekst w innym | Złączenia kończą się sukcesem, ale wskaźnik KPI jest błędny |
Niedopasowanie cykliczności to kwestia, która najbardziej zwodzi zespoły. Zgłoszenia do pomocy technicznej mogą napływać niemal w czasie rzeczywistym, podczas gdy ankiety satysfakcji klientów docierają w cotygodniowym pliku CSV, co oznacza, że jakikolwiek widok z „ostatnich 24 godzin” może być niepełny, choć nie wygląda na uszkodzony. Jeśli analityk nie zna profilu opóźnień każdego źródła, pomyli różnice w świeżości danych ze zmianami biznesowymi.
Zróżnicowanie jakości to cichy zabójca. Dane wzbogacone przez podmioty zewnętrzne mogą sąsiadować z danymi o strumieniu kliknięć własnych (first-party) z brakującymi sesjami, zduplikowanymi identyfikatorami lub niespójnymi rekordami, a połączony wynik może nadal wyglądać na tyle czysto, by przejść pobieżną kontrolę. Tego rodzaju niestabilność jest dokładnie powodem, dla którego jakość źródła musi być traktowana jako część projektu, a nie jako praca porządkowa po fakcie.
Konflikt semantyczny jest najtrudniejszy, ponieważ ukrywa się za znanymi nazwami pól. Źródło, które używa pola country dla kodów ISO, inne, które przechowuje dowolny tekst, i trzecie, które zachowuje nieaktualny skrót, są „poprawne” w swoich własnych systemach. W momencie ich porównania znaczenie biznesowe ulega rozbiciu.
Dla zespołów próbujących zrozumieć, jak stopniowe zmiany strukturalne zamieniają się w uszkodzone potoki, wskazówki dotyczące dryfu schematu od digna pomagają sformułować problem jako wyzwanie operacyjne, a nie tylko uciążliwość związaną z modelowaniem.
Jeśli nazwa pola wygląda znajomo, zwolnij. Znajome nazwy to miejsca, w których kryją się błędy semantyczne.
Właśnie dlatego projekty integracyjne tak często utykają w martwym punkcie. Pierwsze problemy nie są egzotyczne, są zwyczajne i powtarzalne, i zmuszają zespoły do wyboru między szybkością a zaufaniem, zanim jeszcze ustali się ostateczny kształt stosu technologicznego.
Strategie integracji, spośród których warto wybierać
ETL, ELT, CDC i modelowanie kanoniczne rozwiązują różne problemy i łatwo ich nadużyć, gdy ludzie traktują je jak ideologię. ETL sprawdza się, gdy odbiorcy potrzebują ustrukturyzowanych, wyselekcjonowanych danych, a systemy źródłowe są na tyle stabilne, że można dokonać transformacji przed załadowaniem bez ciągłego poprawiania procesów. To dobre rozwiązanie dla starszych systemów odbiorczych, kanałów zgodności (Compliance) i warstw raportowania, które powinny widzieć tylko zweryfikowane struktury.
ELT ma większy sens, gdy magazyn danych działa szybko, a analitycy chcą najpierw surowych, wiernych danych, a transformacji w drugiej kolejności. Pozwala to zespołom zachować szczegółowość źródła i wrócić do logiki później, bez konieczności ponownego pobierania danych. Jest to szczególnie przydatne, gdy pytania biznesowe zmieniają się szybciej niż systemy źródłowe.
CDC należy do ścieżki operacyjnej. Gdy systemy niższego szczebla muszą szybko odzwierciedlać zmiany źródłowe, przechwytywanie zmian danych (change data capture) utrzymuje opóźnienie na tyle małe, że procesy produktowe, wsparcia lub finansowe mogą pozostać zsynchronizowane z tym, co właśnie się wydarzyło. Kompromisem jest to, że CDC może szybciej przenosić niepewność, więc nadal wymaga walidacji przy odbiorze.
Modelowanie kanoniczne rozwiązuje zupełnie inny problem – spójność. Jeśli sprzedaż, produkt i finanse potrzebują tej samej definicji klienta lub produktu przed rozpoczęciem jakichkolwiek prac na dalszych etapach, model kanoniczny daje im jeden wspólny kontrakt. Na początku wymaga to więcej czasu, ale zapobiega tworzeniu przez każdy zespół własnej wersji prawdy na dalszych etapach.
Najbardziej przemyślane stosy zazwyczaj łączą te wzorce. Zespół może wprowadzać CDC do strefy przejściowej (staging), używać ELT wewnątrz magazynu danych, zasilać model kanoniczny w BI i nadal używać ETL do przygotowania eksportu dla starszego systemu. To nie jest brak spójności, ale architektura dopasowana do potrzeb.
Jeśli porównujesz opcje integracji dla zastosowań analitycznych i wrażliwych na prywatność, pomocnym kontekstem może być rozwiązanie BI dbające o prywatność, ponieważ wzorzec integracji i warstwa konsumpcji danych zazwyczaj muszą być projektowane razem.
W przypadku projektów zorientowanych na magazyny danych, strona integracji magazynu danych digna stanowi użyteczny punkt odniesienia pokazujący, jak w praktyce łączą się warstwy ładowania i udostępniania danych.
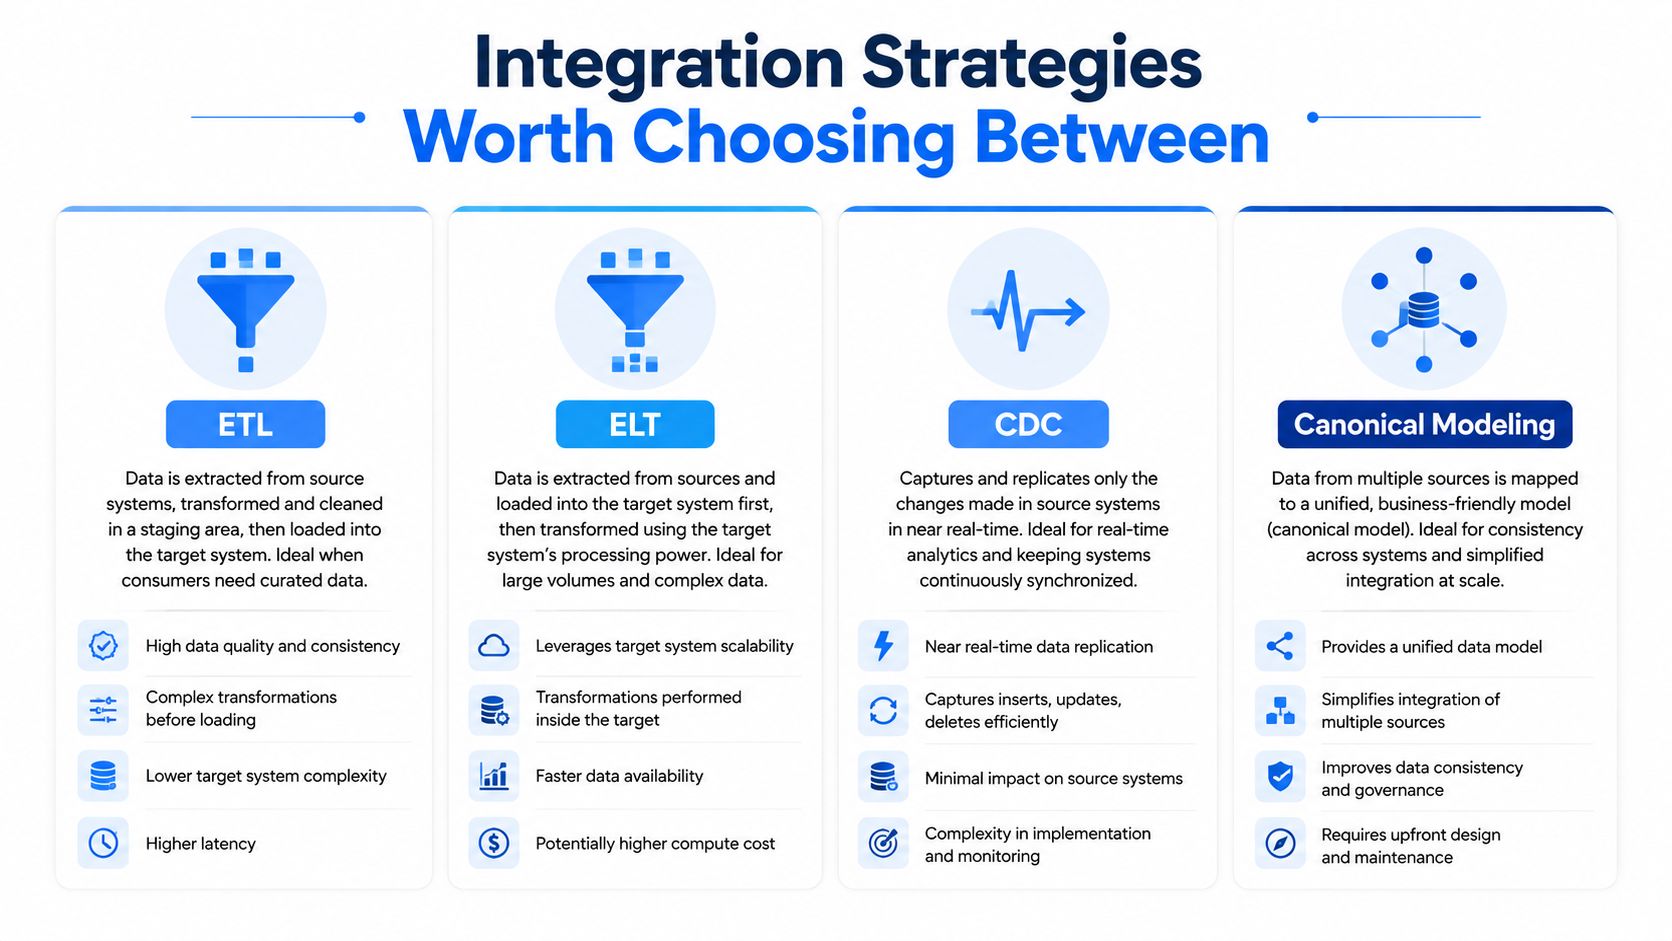
Właściwa strategia integracji to ta, która odpowiada odbiorcy, wymaganiom dotyczącym opóźnień oraz poziomowi zaufania, jaki można wyegzekwować na granicy systemów.
Wiele zespołów marnuje tygodnie na kłótnie o to, który wzorzec jest „nowoczesny”. Taka dyskusja mija się z celem. Kluczowym pytaniem jest to, który wzorzec utrzymuje kontrakt semantyczny na tyle jasnym, by zespoły korzystające z danych na dalszych etapach mogły ich używać bez konieczności inżynierii wstecznej.
Harmonizacja i walidacja, które wytrzymują próbę czasu
Harmonizacja zaczyna się od deduplikacji, ale nie tej uproszczonej, która zakłada, że idealne klucze już istnieją. Niezależne systemy rzadko współdzielą bezbłędne identyfikatory, dlatego klucze blokujące i dopasowywanie probabilistyczne stają się często konieczne, by określić, które rekordy prawdopodobnie odnoszą się do tego samego podmiotu. Ten krok powinien nastąpić przed tym, jak logika łączenia utrwali zdublowane wpisy jako fałszywą pewność.
Ujednolicenie znaczenia przed liczbą
Po dopasowaniu rekordów należy znormalizować warstwę jednostek. Waluty, strefy czasowe, systemy miar i kalendarze obrachunkowe tworzą niewidoczne rozbieżności, gdy zespoły zakładają, że dana wartość oznacza to samo wszędzie. Kwota przychodu w czasie lokalnym i kwota przychodu w UTC mogą być poprawne, a mimo to nieporównywalne.
Następnym krokiem jest uzgadnianie semantyczne. Tabele mapowania i autorytatywne definicje mają tutaj kluczowe znaczenie, ponieważ nazwy pól często kryją różnice w regułach biznesowych, których nie wychwyci żadna kontrola typów danych. Czysta nazwa kolumny nic nie daje, jeśli jedno źródło traktuje „klienta” jako konto, inne jako użytkownika, a trzecie jako podmiot rozliczeniowy.
Ta sama zasada pojawia się przy tworzeniu „złotego rekordu” (golden record), gdzie zespoły próbują zdecydować, która wersja danych klienta, produktu czy lokalizacji powinna być uznana za nadrzędną. Jeśli szukasz innego praktycznego ujęcia tego problemu, podejście BatchData do złotego rekordu jest przydatnym zewnętrznym punktem odniesienia pokazującym, jak współdzielona warstwa rekordów wpływa na spójność danych na dalszych etapach.
Walidacja powinna opierać się na harmonizacji, a nie następować po niej. Kontrole schematu powinny odbywać się na granicy, kontrole spójności referencyjnej między systemami, reguły biznesowe (takie jak nieujemne ilości) wewnątrz potoku, a uzgadnianie na poziomie wierszy powinno porównywać sumy kontrolne z każdego źródła. Strukturyzowany sposób myślenia o tych kontrolach opisuje przewodnik po regułach walidacji digna, ponieważ walidacja musi towarzyszyć danym, a nie czekać, aż ktoś zgłosi błąd na pulpicie nawigacyjnym.
Gdzie jest miejsce na walidację
Walidacja na samym końcu to zbyt późno. Zanim pulpit nawigacyjny zacznie wyglądać źle, kontekst, który wyjaśniłby awarię, zdąży się już przedawnić.
Najlepszym wzorcem jest walidacja przy każdym przekazaniu danych, ponieważ każde przekazanie wciąż zachowuje kontekst źródłowy, właściciela i pierwotne założenie. Dzięki temu naprawianie błędów jest szybsze, a spory krótsze. Powstrzymuje to również zespoły przed traktowaniem połączonych danych jako wiarygodnych tylko dlatego, że pomyślnie przeszły proces ładowania.
Monitorowanie jako system wczesnego ostrzegania
Monitorowanie pomaga tylko wtedy, gdy wykryje przyczynę, zanim raport stanie się zagadką. Najczystszym sposobem na to jest wspólne śledzenie terminowości, anomalii i zmian schematu, a nie traktowanie ich jako osobnych kolejek. Jeśli źródło dociera z opóźnieniem, pulpit nawigacyjny już się starzeje, nawet jeśli liczby wciąż wyglądają nienagannie.
Monitorowanie terminowości (Timeliness) to pierwsza linia obrony, ponieważ problemy ze świeżością danych często zaczynają się na wcześniejszych etapach i rozprzestrzeniają dalej bez widocznych przerw. Jeśli umowa SLA ulega opóźnieniu, zespół musi o tym wiedzieć, zanim użytkownicy biznesowi zaczną podejmować decyzje na podstawie nieaktualnych danych. Ma to największe znaczenie tam, gdzie późno docierające źródło może zmienić wskaźnik KPI bez zmiany kształtu wykresu.
Wykrywanie anomalii obejmuje inną klasę błędów. Gwałtowne zmiany wolumenu, przesunięcia rozkładu i skoki współczynnika wartości pustych (null-rate) mogą ujawnić uszkodzony filtr, brakujące złączenie lub nieudane wdrożenie wyżej w strukturze na długo przed tym, jak ktoś zauważy spadek przychodów. Na tym polega wartość obserwowania zachowania źródła, a nie tylko wyniku na pulpicie nawigacyjnym.
Śledzenie schematu zamyka ten cykl. Dodanie kolumn, zmiany typów danych i dryf opcjonalności (nullability) to ciche zmiany strukturalne, które psują odbiór danych na dalszych etapach, mimo że potok wydaje się „działać”. W przypadku systemów danych, które muszą reagować na zmieniające się wymagania dotyczące klasyfikacji i ochrony, NIST zauważa, że monitorowanie powinno wychwytywać zmiany w samych zasobach i w razie potrzeby uruchamiać zrewidowane mechanizmy kontrolne – dlatego śledzenie schematów powinno być częścią pętli operacyjnej, a nie tylko dokumentacji.
Praktyczny widok monitorowania to jeden pulpit nawigacyjny pogrupowany według źródeł, z powiązaniami pochodzenia danych (lineage) dołączonymi do każdego alertu. Pozwala to inżynierowi dyżurnemu prześledzić opóźniony plik, anomalię wolumenu lub zmianę schematu z powrotem do systemu źródłowego bez przełączania się między narzędziami. Najlepsze zespoły przestają pytać: „Który raport jest błędny?”, a zaczynają: „Które źródło zmieniło się jako pierwsze?”.
Sygnały monitorowania i to, co wykrywają
Kategoria sygnału | Co śledzi | Wcześnie wykryta awaria |
|---|---|---|
Timeliness | Opóźnienie dostarczenia, brakujące ładowania, przedwczesne dostarczenie | Nieaktualne pulpity nawigacyjne i ukryte opóźnienia |
Wykrywanie anomalii | Przesunięcia wolumenu, rozkładu, współczynnika wartości null | Uszkodzone filtry, brakujące złączenia, błędy na wcześniejszych etapach |
Śledzenie schematu | Dodane kolumny, zmiany typów, dryf opcjonalności (nullability) | Awarie potoku wynikające ze zmian strukturalnych |
Różnica między monitorowaniem reaktywnym a proaktywnym polega na czasie. Zespoły reaktywne dowiadują się o problemie po skargach użytkowników. Zespoły proaktywne wychwytują przyczynę, gdy jest jeszcze mała, co pozwala ocalić zaufanie i zaoszczędzić czas na rozwiązywanie incydentów.
Lista kontrolna do wdrożenia przy kolejnym projekcie integracyjnym
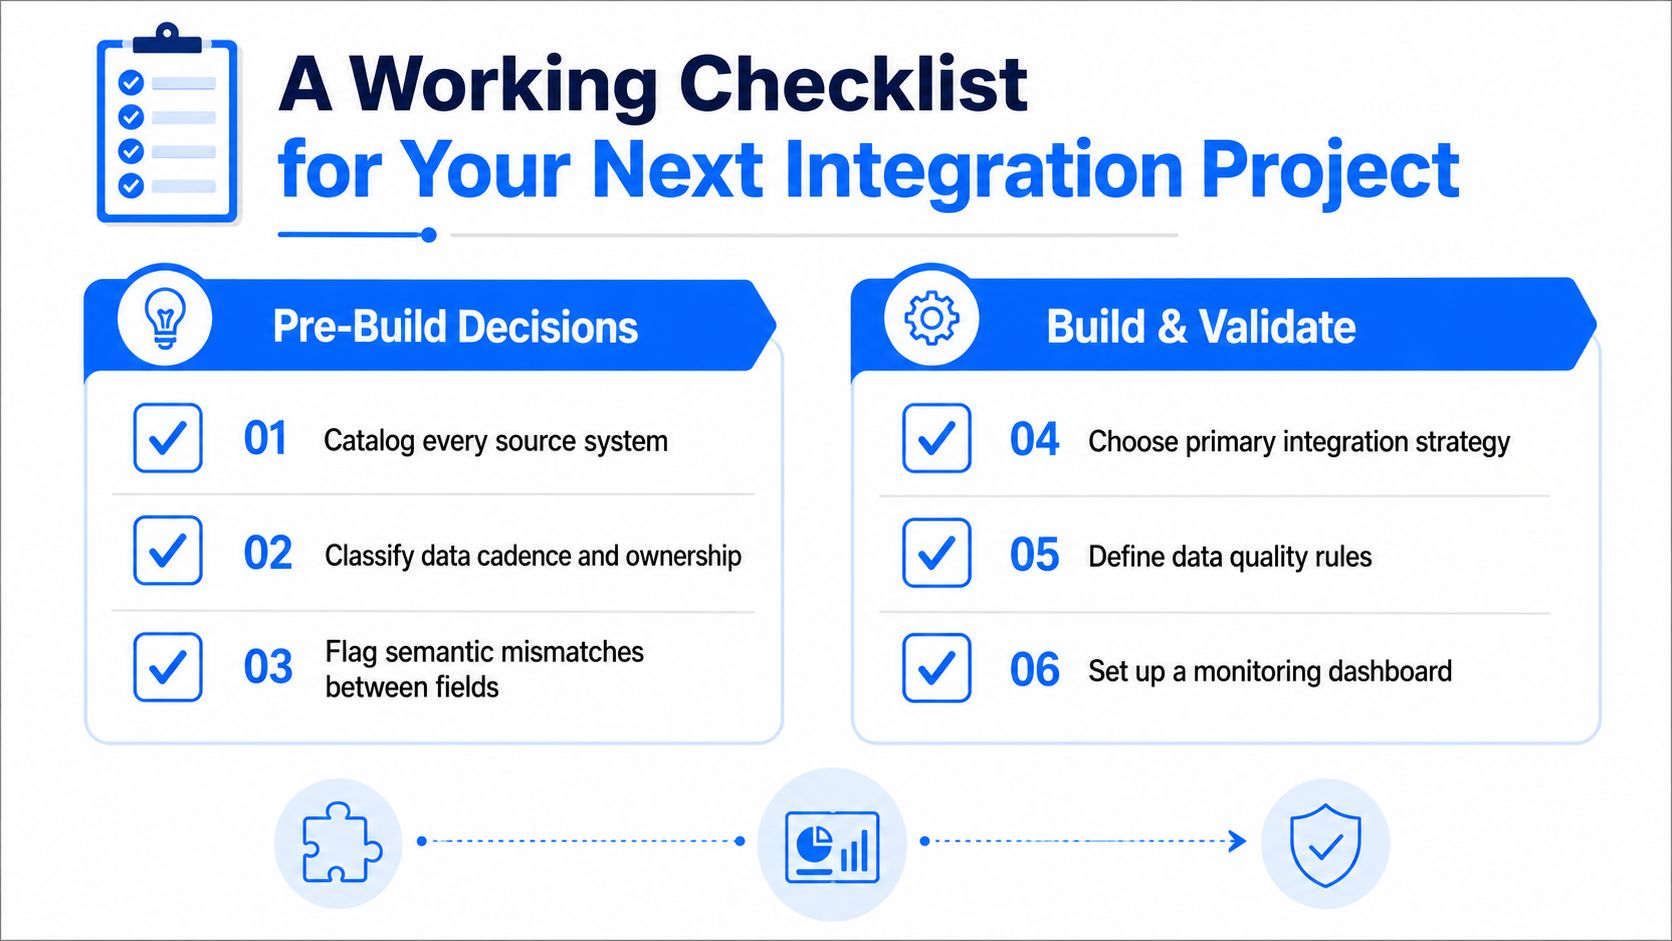
Zacznij zanim napiszesz pierwszą transformację. Skataloguj każde źródło, określ jego cykliczność i wskaż właściciela, który szybko odpowie na pytania dotyczące schematu i znaczenia danych. Wcześnie oznaczaj konflikty semantyczne, szczególnie w przypadku pól takich jak klient, przychód, kraj i produkt.
Decyzje przed wdrożeniem
Skataloguj każdy system źródłowy, aby nie odkryć ukrytego arkusza kalkulacyjnego już po uruchomieniu.
Określ cykliczność i własność, aby opóźnione pliki i niejasne przekazywanie danych nie stały się nagłymi incydentami.
Oznacz niedopasowania semantyczne, aby zespoły nie używały tej samej nazwy pola do różnych znaczeń biznesowych.
Budowa i walidacja
Wybierz główny wzorzec integracji (ETL, ELT lub CDC) w zależności od odbiorcy i potrzeb dotyczących opóźnień.
W pierwszej kolejności udokumentuj model kanoniczny, aby transformacje nie kodowały sprzecznych definicji.
Ustaw progi walidacji i alerty o świeżości danych, aby błędne ładowania szybko kończyły się niepowodzeniem, zamiast przedostawać się do systemów BI.
Dodaj monitory dryfu schematu i kontrole liczby wierszy, aby utracone źródła i zmiany strukturalne były widoczne, zanim zauważą je użytkownicy.
Jeśli potrzebujesz konkretnego planu działania, przeprowadź jednodniowy audyt źródeł, naszkicuj schemat kanoniczny na tablicy i wepnij jedną kontrolę observability do najbardziej obciążonego potoku danych. To wystarczy, aby zatrzymać pierwszą rundę cichych błędów, bez czekania, aż komitet zatwierdzi całą architekturę.
Jeśli Twój zespół zmaga się z niespójnymi raportami, dryfem semantycznym lub potokami, które ulegają awarii dopiero wtedy, gdy pulpit nawigacyjny wyświetla już błędne dane, digna daje Ci możliwość monitorowania terminowości, walidacji, zmian schematu i anomalii w Twoim własnym środowisku. Odwiedź digna, aby zobaczyć, jak to rozwiązanie wpisuje się w rzeczywisty stos integracyjny, i użyj go jako punktu wyjścia do budowania danych, którym Twoje zespoły będą mogły zaufać.
Najczęściej zadawane pytania
Co naprawdę znaczą „rozproszone źródła”?
Więcej niż problem formatu. Format jest tylko pierwszą warstwą; pod spodem leżą odmienne definicje, odmienne rytmy aktualizacji i odmienne wyobrażenia o tym, który system posiada którą wersję rzeczywistości, i to właśnie sprawia, że raporty się rozjeżdżają.
Od czego zacząć, gdy trzy raporty się nie zgadzają?
Nie od przepisywania pulpitu. Zacznij od pytania, które pole, reguła albo znacznik czasu zmieniły się pierwsze, bo uzgadnianie mniej dotyczy dopasowywania raportów, a bardziej prześledzenia, który system posiada którą wersję rzeczywistości.
Dlaczego nowoczesne stosy wytwarzają ten problem?
Bo powstają z nagromadzonej historii, a nie z jednego czystego diagramu architektury. Każdy system przyszedł, by rozwiązać konkretny problem w konkretnym czasie, a nakładanie się ich zakresów rzadko projektowano świadomie.
Kogo obwinia się najpierw?
Hurtownię, warstwę BI albo ostatnie zadanie ETL, którego ktoś dotknął. Ten odruch jest zrozumiały i zwykle błędny, bo rozbieżność zaczęła się zazwyczaj wyżej, w definicji, a nie w warstwie, w której stała się widoczna.
Czego wymaga harmonizacja poza mapowaniem?
Zgody co do własności. Mapowanie pól między systemami załatwia część mechaniczną, a rozstrzygnięcie, który system jest miarodajny dla którego pojęcia, jest tą częścią, która powstrzymuje powrót tego samego sporu co kwartał.


