Buduj zaufanie dzięki raportowaniu jakości danych: Przewodnik na rok 2026
|
9
min. czyt.

Znasz ten moment. Prezentacja dla zarządu jest gotowa, dashboard działa na żywo i nagle jedna liczba wygląda na tyle błędnie, że zatrzymuje całe spotkanie. Narzędzie BI nie zawiodło. Zawiodły dane pod nim, a teraz zespół musi zdecydować, czy zaufać wykresowi, wstrzymać spotkanie, czy spędzić kolejną godzinę na śledzeniu błędnego ładowania przez trzy systemy.
Dlatego właśnie raportowanie jakości danych (data quality reporting) ma kluczowe znaczenie. Zmienia ono zaufanie z intuicyjnego odczucia w powtarzalną praktykę i daje każdemu zespołowi, od inżynierii po finanse, wspólny sposób na sprawdzenie, czy dane są użyteczne, aktualne i wystarczająco spójne, aby podejmować na ich podstawie decyzje.
Spis treści
Sześć kluczowych metryk, które muszą znaleźć się w Twoich raportach
Integracja raportowania z ramami zarządzania (Governance Framework)
Dlaczego Twoje dashboardy Cię okłamują
Najgorsze problemy z dashboardami rzadko wyglądają jak awarie oprogramowania. Wyglądają jak spadek przychodów, który nie pasuje do pipeline'u sprzedaży, nagła zmiana liczby klientów z dnia na dzień lub karta wyników kadry kierowniczej, która zmusza wszystkich do zabawy w detektywa przed spotkaniem. Dashboard to tylko powierzchnia. Główną przyczyną jest to, że leżące u podstaw dane utraciły zaufanie gdzieś pomiędzy pobieraniem, transformacją a konsumpcją.
Koszt finansowy nie jest abstrakcyjny. Słaba jakość danych kosztuje organizacje średnio 12,9 miliona dolarów rocznie, a 68% specjalistów ds. danych twierdzi, że wykrycie incydentu związanego z danymi zajmuje im cztery godziny lub więcej, przy czym średni czas rozwiązania problemu wynosi 15 godzin na incydent (statystyki jakości danych Gitnux). To nie jest zwykła niedogodność w raportowaniu. To stracony czas na podejmowanie decyzji, przerwane procesy robocze i opóźnione działania w całej firmie.
Wiele zespołów zakłada, że rozwiązaniem są „lepsze dashboardy”. Zazwyczaj są to lepsze dowody. Gdy metryka jest błędna, zespół musi wiedzieć, czy problemem jest brakujące ładowanie, złamana reguła, zmiana schematu, czy transformacja, która zmieniła znaczenie danych, nie będąc zauważoną.
Jednym z użytecznych sposobów myślenia o tym jest to, że dashboard jest symptomem, podczas gdy system raportowania jest warstwą diagnostyczną. Jeśli kiedykolwiek widziałeś, jak zduplikowane rekordy zawyżają liczbę lub nieaktualna tabela napędza fałszywy trend, problem często leży na wcześniejszym etapie w pipeline. Dlatego wiele zespołów zaczyna od zmapowania swojego stosu raportowania do zachowania samych danych, a nie tylko do powierzchni wykresu, a wyjaśnienie redunancji danych i anomalii w systemach raportowania analitycznego autorstwa digna jest praktycznym punktem odniesienia dla tego typu myślenia.
Praktyczna zasada: jeśli liczby na dashboardzie nie można powiązać z sygnałem jakości, nie powinna być ona traktowana jako podstawa do podejmowania decyzji.
Co oznacza raportowanie jakości danych
Raportowanie jakości danych to ustrukturyzowany sposób na udowodnienie, że dane nadają się do określonego celu. Nie jest to zrzut ekranu ani lista kontrolna ukryta w narzędziu do zarządzania przepływem pracy. Jest to warstwa dowodowa, która informuje interesariuszy o tym, co zostało zmierzone, co przeszło pomyślnie, co się nie udało i jakiego kontekstu potrzebują przed użyciem danych w analityce, operacjach lub sztucznej inteligencji.
Od kontroli ad hoc do audytowalnych dowodów
Dyscyplina ta ma formalne korzenie w oficjalnej statystyce. ONZ i Europejski System Statystyczny zbudowały raportowanie wokół podstawowych wymiarów, takich jak dokładność, terminowość i spójność, co sprawiło, że jakość stała się mierzalna, porównywalna i audytowalna w różnych organizacjach i branżach (wytyczne ONZ i Eurostatu dotyczące jakości). Ta historia ma znaczenie, ponieważ pokazuje, że nowoczesne raportowanie nie powstało jako udogodnienie BI. Zaczęło się jako dyscyplina governance.
Celem nie jest tworzenie większej liczby dokumentów. Celem jest stworzenie rejestru, który wspiera działanie. Solidny raport informuje, czy dane są wystarczająco dobre dla danego przypadku użycia, gdzie leżą słabe punkty i jak te słabe punkty wpływają na decyzje biznesowe.
Wytyczne ONZ dotyczące raportów jakości jasno określają tę strukturę. Wymagają one, aby raport określał główne zmienne i dane wejściowe, definiował jednostki statystyczne i populacje docelowe, opisywał zasięg geograficzny i czasowy, wyjaśniał metody walidacji oraz odnotowywał wszelkie przerwy w szeregach czasowych wraz z jasnymi wyjaśnieniami (wytyczne ONZ dotyczące raportów jakości). To całkowite przeciwieństwo podejścia „na dashboardzie wygląda w porządku”.
Co musi udowodnić prawdziwy raport
Użyteczny raport odpowiada na wąskie, ale krytyczne pytanie: czy temu zestawowi danych można zaufać przy podejmowaniu tej decyzji?
To pytanie musi być powiązane z przydatnością do określonego celu, a nie z ogólną etykietą zaliczenia lub niezaliczenia. Praktyczny system raportowania musi również pokazywać sygnały jakości stojące za odpowiedzią, aby analitycy mogli prześledzić wynik wstecz aż do pipeline, zamiast traktować raport jako statyczne podsumowanie. Narzędzie digna i jego przegląd metryk jakości danych to użyteczny przykład tego, jak te kontrole mogą być sformułowane do celów operacyjnych.
Nowoczesny system raportowania musi również rejestrować strukturę, a nie tylko język podsumowania. Norma ISO 19157-1:2023 traktuje jakość danych geograficznych jako standaryzowany artefakt metadanych z komponentami jakości, procedurami oceny i zasadami raportowania, które mogą być spójnie wymieniane między organizacjami (ISO 19157-1:2023). Ta idea dobrze przekłada się na dane korporacyjne, gdzie zespoły potrzebują raportów, które mogą walidować, udostępniać i porównywać w czasie.
Dla zespołów regulowanych i wielofunkcyjnych najtrudniejszą częścią często nie jest obliczenie wyniku. Jest to zdefiniowanie kontekstu wokół tego wyniku. Jeśli nikt nie widzi, co zostało przetransformowane, przefiltrowane lub przekodowane przed pomiarem, raport może wyglądać czysto, będąc jednocześnie wprowadzającym w błąd.
Sześć kluczowych metryk, które muszą znaleźć się w Twoich raportach
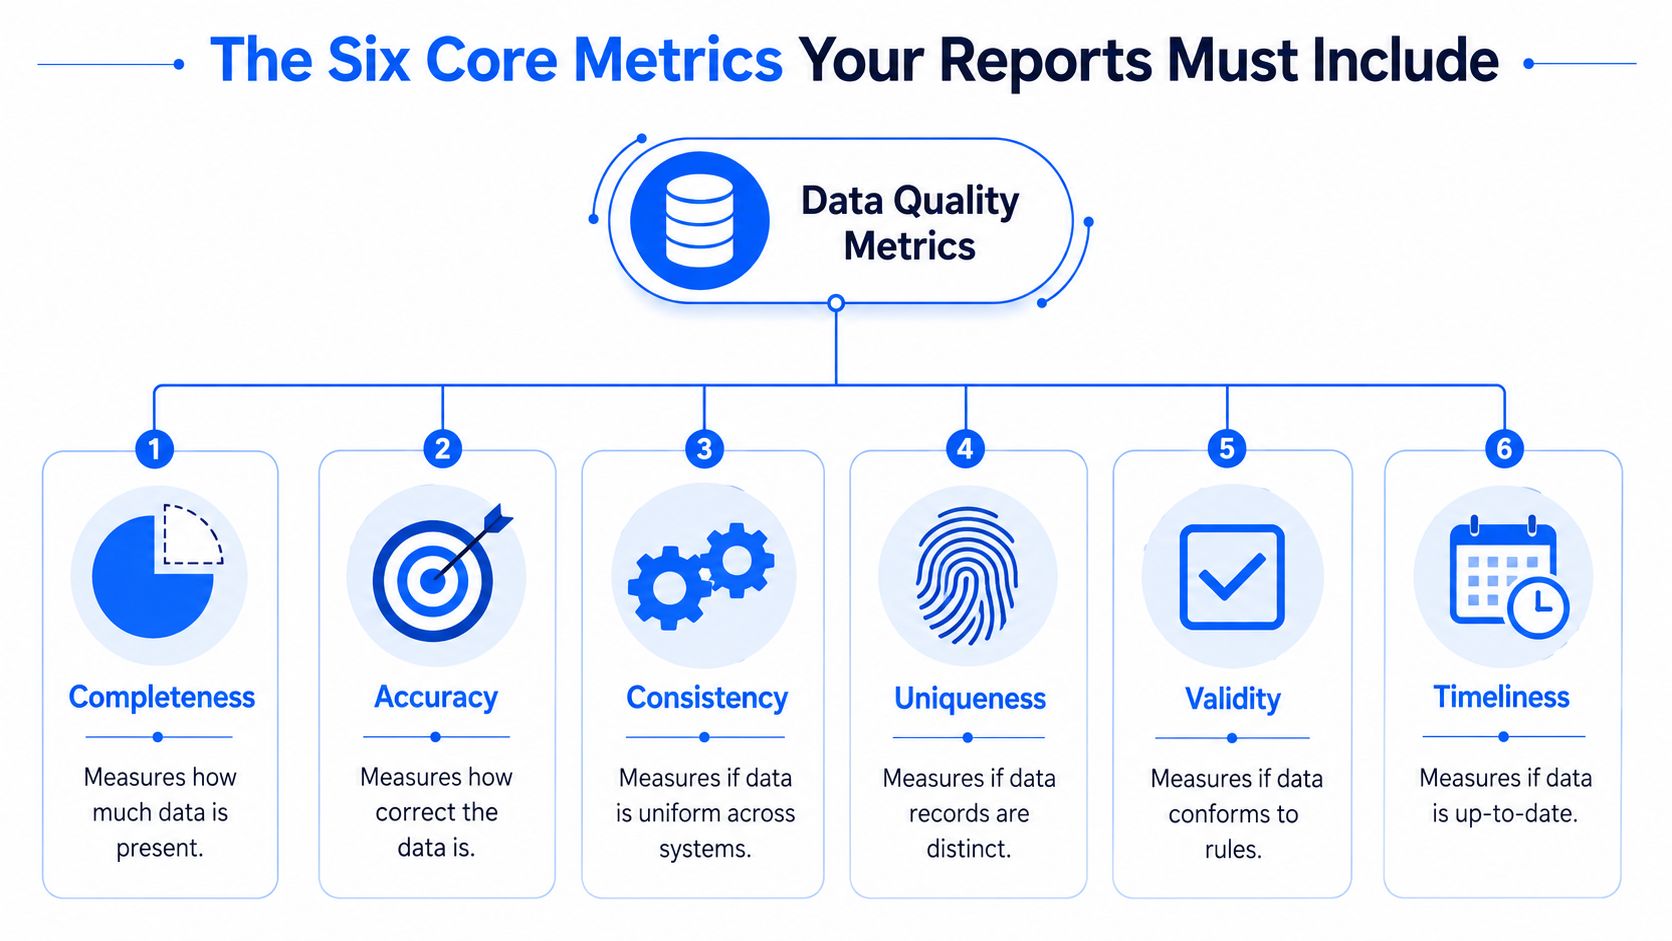
Rzetelny raport nie próbuje obejmować każdego możliwego problemu z danymi. Kotwiczy on dyskusję w sześciu wymiarach, na które zespoły governance mogą reagować. Raport zgodny z zasadami governance powinien obejmować kompletność, dokładność, spójność, terminowość, unikalność i ważność, a także analizę wpływu na biznes i plan naprawczy (przewodnik po raportach jakości danych Murdio).
Wymiary, które mają znaczenie
Kompletność informuje, czy wymagane dane są obecne. To pierwsze miejsce, w które patrzy wiele zespołów, ale też łatwo mu zbyt mocno zaufać. Pole może być wypełnione, a mimo to zawierać błędne informacje.
Dokładność mierzy, czy dane odzwierciedlają rzeczywistość. W praktyce oznacza to zazwyczaj sprawdzanie ich z systemami źródłowymi, zatwierdzonymi wartościami referencyjnymi lub regułami biznesowymi, które definiują, jak wygląda „poprawność”.
Spójność odpowiada na pytanie, czy to samo pojęcie ma takie samo znaczenie w różnych systemach, pipeline'ach i raportach. Atrybut klienta, produktu lub konta w takich przypadkach często rozchodzi się między zespołami.
Terminowość mierzy, czy dane docierają wystarczająco wcześnie, aby były użyteczne. W tym miejscu platforma taka jak digna może monitorować świeżość, oczekiwane dostarczenie oraz opóźnione lub brakujące ładowania w środowisku klienta.
Unikalność sprawdza, czy rekordy są odrębne. Zduplikowane tożsamości, powtarzające się transakcje i skopiowane zdarzenia – wszystko to ujawnia się tutaj.
Ważność testuje, czy wartości są zgodne z regułami. Może to oznaczać sprawdzanie typów, domen, zakresów lub ograniczeń biznesowych na poziomie rekordów i to właśnie tutaj naturalnie pasują kontrole walidacyjne digna.
Praktyczna zasada: jeśli metryka nie przekłada się na decyzję, próg i właściciela, jej miejsce jest w fazie eksploracji, a no nie w raporcie.
Przekształcanie metryk w sygnały operacyjne
Najlepsze raporty unikają generycznych kart wyników. Wiążą one każdy wymiar z pytaniem, które zadaje zespół. Czy dane są wystarczająco kompletne, aby je opublikować? Czy są wystarczająco dokładne do fakturowania? Czy są wystarczająco terminowe na spotkanie operacyjne? Czy są wystarczająco ważne do użytku regulacyjnego?
W tym miejscu raport przestaje być bierny. Dobrze zaprojektowany system łączy te metryki ze śledzeniem wyjątków, historią trendów i statusem naprawczym. Zespoły mogą wtedy zobaczyć, czy problem się zmniejsza, pogłębia, czy też przemieszcza między pipeline'ami i domenami.
Jeśli potrzebujesz zwięzłego punktu odniesienia dla modelu metryk, przegląd metryk jakości danych digna jest przydatny jako produktowe przełożenie tego samego wzorca governance.
Wybór odpowiedniego raportu dla Twoich odbiorców
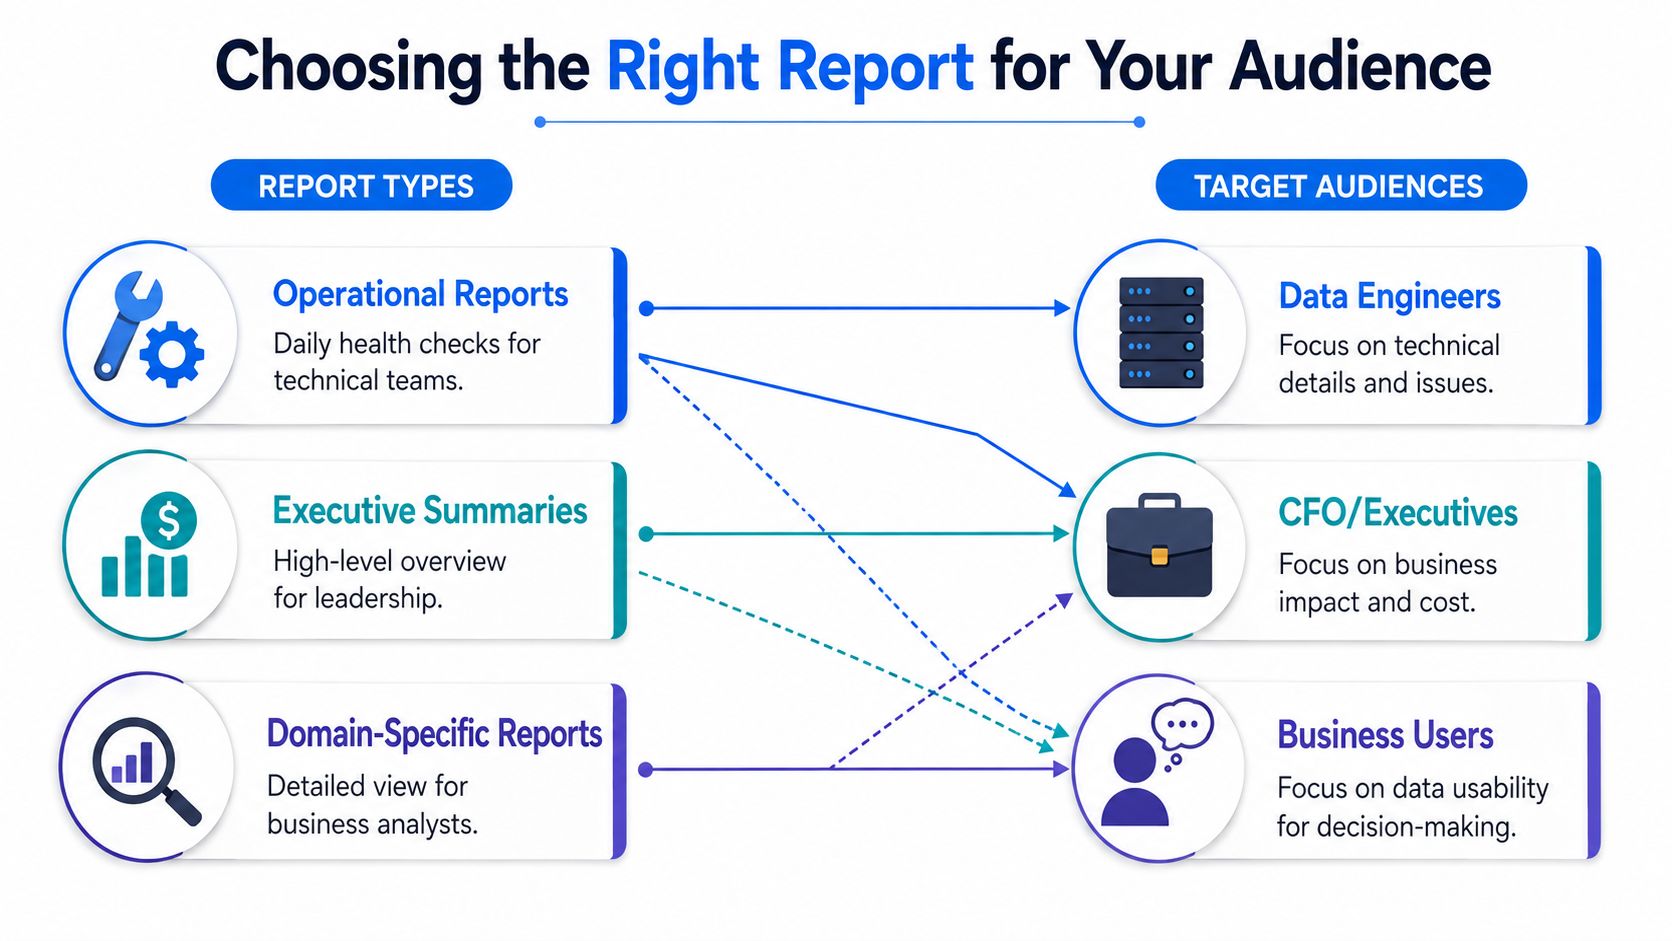
Raport, który pomaga inżynierowi danych, może przytłoczyć dyrektora finansowego. Podsumowanie, które sprawdza się w przypadku zespołu zarządzającego, może ukryć dokładnie tę awarię, którą musi naprawić steward danych. Chodzi o to, aby dopasować poziom szczegółowości do podejmowanej decyzji, a nie traktować każdego odbiorcę tak, jakby potrzebował tego samego dokumentu.
Typy raportów jakości danych według odbiorców | ||||
|---|---|---|---|---|
Typ raportu | Główni odbiorcy | Cel | Przykładowe metryki | Częstotliwość |
Raporty operacyjne | Inżynierowie danych, analitycy dyżurni | Szybkie wychwytywanie awarii i kierowanie incydentów | Świeżość, nieudane reguły, zmiany schematu | Ciągła lub codzienna |
Raporty taktyczne | Stewardzi danych, liderzy analityki | Śledzenie wzorców i priorytetyzacja poprawek | Powtarzające się awarie reguł, braki danych, duplikaty | Cotygodniowa |
Raporty strategiczne | Dyrektorzy finansowi, kadra zarządzająca, komitety governance | Przegląd ryzyka, wpływu na biznes i odpowiedzialności | Status kluczowych zasobów, nierozwiązane incydenty, postęp prac naprawczych | Comiesięczna lub kwartalna |
Dopasowanie raportu do zadania
Raportowanie operacyjne powinno być bezpośrednie i szczegółowe. Ma ono na celu poinformowanie zespołu technicznego, co się zepsuło, gdzie się zepsuło i co wymaga natychmiastowej uwagi. Dlatego tak ważne jest kierowanie alertów – komunikat musi trafić do osoby, która może coś z tym zrobić.
Raportowanie taktyczne znajduje się pośrodku. Pomaga zespołom dostrzegać powtarzające się błędy, porównywać domeny i sprawdzać, czy działania naprawcze przynoszą skutek. To właściwe miejsce na widoki trendów i podsumowania jakości dla poszczególnych domen.
Raportowanie strategiczne to zupełnie inna kwestia. Kadra kierownicza nie potrzebuje informacji o każdym nieudanym wierszu. Potrzebuje podsumowania ekspozycji biznesowej, odpowiedzialności oraz informacji o tym, czy organizacja odnotowuje poprawę, czy też pogorszenie sytuacji. Przejrzysty raport strategiczny powinien brzmieć jak instrument governance, a nie dziennik inżynieryjny.
Wybory projektowe, które redukują szum
Raport staje się bezużyteczny, gdy miesza odbiorców. Jeśli dashboard zawiera każdy wynik walidacji, każdą flagę anomalii i każdą notatkę o cyklu życia, nikt nie wie, co robić dalej. Lepszym wzorcem jest separacja ze wspólnym rodowodem danych (lineage), dzięki czemu każdy odbiorca otrzymuje wycinek, którego potrzebuje, podczas gdy wszyscy nadal widzą tę samą podstawową prawdę.
Pomaga tu również prosta zasada. Jeśli raport służy do działania, niech ma charakter operacyjny. Jeśli służy do ustalania priorytetów, niech będzie taktyczny. Jeśli służy do rozliczania odpowiedzialności, niech będzie strategiczny. Treść się zmienia, ale dowody powinny pozostać spójne we wszystkich trzech przypadkach.
Nowoczesne architektury do ciągłego raportowania
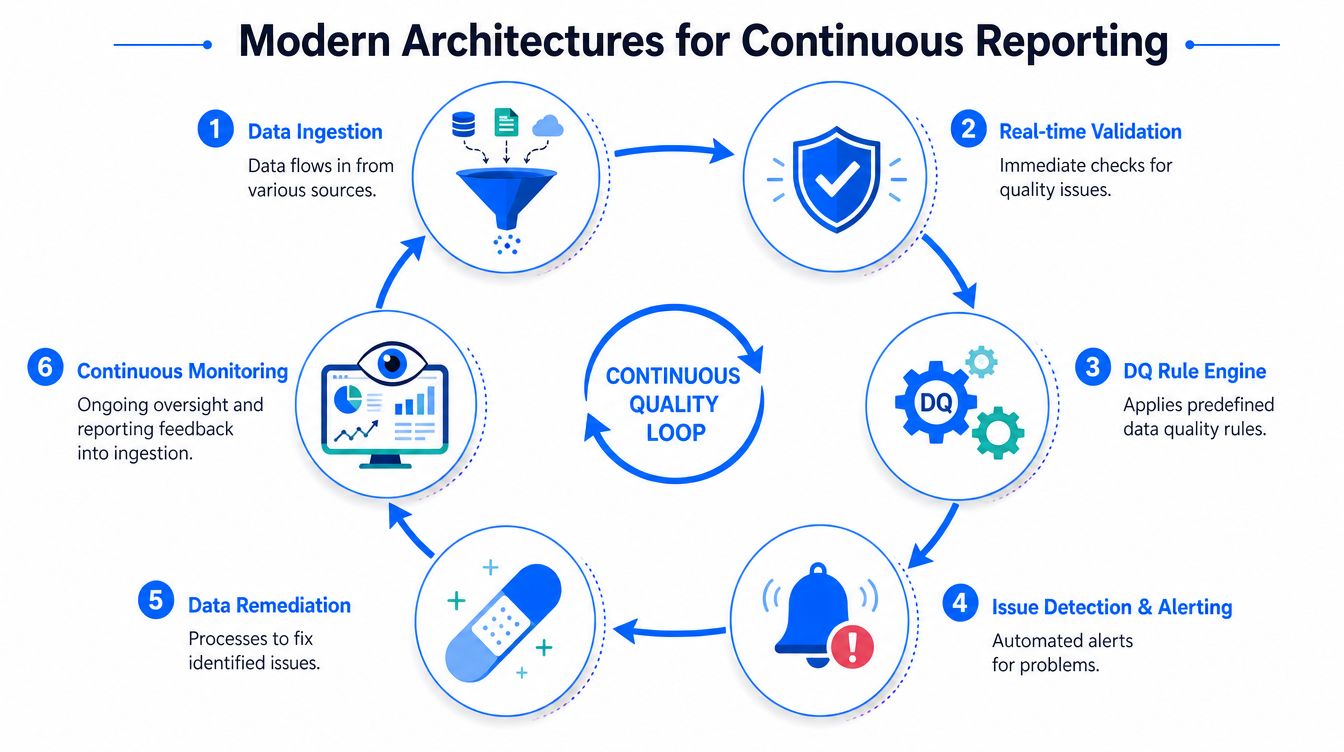
Hurtownia danych może wyglądać zdrowo rano i wprowadzać w błąd już w południe. Systemy źródłowe dryfują, pipeline'y zwalniają, schematy się zmieniają, a raport, na którym polegają ludzie, nadal pokazuje wczorajszą wersję rzeczywistości. Tradycyjne raportowanie zostało stworzone do przeglądu po fakcie, więc rozsypuje się, gdy dane napływają w sposób ciągły, a zespoły biznesowe muszą ufać wynikom, gdy pipeline jest wciąż w ruchu.
Dlaczego statyczna dokumentacja zostaje w tyle
Statyczna dokumentacja nie nadąża za środowiskiem operacyjnym, które zmienia się każdego dnia. Ramy jakości danych NCES (NCES data quality framework) traktują raportowanie jako coś, co musi ujawniać kompromisy, powracać do zagrożeń i korzystać z nowoczesnych szablonów lub narzędzi, które zmieniają wewnętrzną dokumentację w raporty, na podstawie których ludzie mogą działać. Logika ta pasuje do hurtowni i pipeline'ów, gdzie dryf, opóźnienia i zmiany schematów pojawiają się bez ostrzeżenia.
Odpowiedzią architektoniczną jest przybliżenie kontroli jakości do samych danych. Wykonywanie operacji wewnątrz bazy danych (in-database) zatrzymuje dane na miejscu, ogranicza niepotrzebny ruch i sprawia, że monitorowanie w dużej skali staje się praktyczne. Wspiera również ciągłe kontrole, które mogą odróżnić krótkotrwały incydent w pipeline od szerszego problemu z jakością.
Praktyczna zasada: jeśli kontrola jest uruchamiana kilka godzin po wylądowaniu danych, raport jest już opóźniony w stosunku do działalności firmy.
Co musi robić ciągłe raportowanie
Ciągły system raportowania musi obserwować przychodzące dane, walidować je pod kątem reguł, wykrywać anomalie i zachowywać jasną ścieżkę tego, co się zmieniło. Sygnały o świeżości, wyniki reguł, zmiany strukturalne i historia trendów – wszystko to musi wskazywać na ten sam zasób, aby raport pozostawał połączony z rzeczywistością operacyjną.
Architektura stojąca za tym systemem ma tak samo duże znaczenie jak same metryki. Nowoczesna architektura pipeline'ów danych powinna wspierać kontrole tam, gdzie dane już żyją, utrzymywać widoczność rodowodu danych (lineage) i ułatwiać śledzenie wadliwego sygnału wstecz do źródła oraz do konsumentów na dalszych etapach. Bez tego raportowanie staje się stosem odłączonych wyników zamiast systemem wspierającym działanie.
Platforma digna dobrze wpisuje się w ten model jako jedna z opcji. Jej platforma działa wewnątrz własnego środowiska klienta, wykonuje kontrole wewnątrz bazy danych i łączy moduły Data Anomalies, Timeliness, Data Validation oraz Schema Tracker w celu monitorowania zachowania danych bez ich przenoszenia z produkcji. Wartością jest ciągłość, a nie tylko samo wykrywanie. Zespoły otrzymują system, który może podążać za danymi w miarę ich zmian, zamiast czekać, aż zaplanowany audyt nadrobi zaległości.
Ciągłe raportowanie zmienia również sposób obsługi incydentów. Pozwala zespołom stwierdzić, czy awaria jest jednorazowym przerwaniem pipeline'u, powtarzającym się problemem na wcześniejszym etapie, czy też trwałym problemem z jakością danych. To rozróżnienie sprawia, że raportowanie staje się strategiczne, a nie tylko reaktywne.
Projektowanie praktycznego dashboardu jakości danych
Użyteczny dashboard nie ma na celu imponować ludziom. Ma pomagać im w podejmowaniu decyzji. Układ powinien w oczywisty sposób pokazywać, co się zmieniło, czy zmiana ma znaczenie i kto jest odpowiedzialny za reakcję. Jeśli ktoś musi przeklikać pięć kart tylko po to, by dowiedzieć się, że tabela jest opóźniona, dashboard nie spełnia swojego zadania.
Buduj stronę wokół zasobu, a nie schematu organizacyjnego
Zacznij od jednego krytycznego zestawu danych lub domeny, a następnie zakotwicz dashboard wokół jego bieżącego stanu zdrowia. Dobry układ zazwyczaj zawiera panel świeżości, podsumowanie walidacji, trend anomalii oraz wskaźnik zmian schematu. Daje to inżynierom, analitykom i stewardom jedno miejsce, w którym mogą zobaczyć, czy dane są gotowe, ryzykowne czy uszkodzone.
Nie chodzi o to, by prezentować każdą metrykę w równym stopniu. Chodzi o to, by ważny sygnał był widoczny na pierwszy rzut oka. Oś czasu dla terminowości informuje użytkowników, czy dostarczanie danych dryfuje. Widżet walidacji pokazuje awarie reguł według typu. Wykres anomalii wyróżnia nieoczekiwane zachowania dotyczące wolumenu lub wartości. Panel schematu pokazuje, czy struktura zmieniła się w sposób, który mógłby zakłócić pracę użytkowników na dalszych etapach.
Projektuj z myślą o diagnozie, a nie o dekoracji
Dashboardy zawodzą, gdy tylko raportują status. Odnoszą sukces, gdy wspierają diagnozę. Oznacza to, że każdy widżet powinien odpowiadać na inne pytanie, a cała strona powinna łączyć symptomy z kontekstem.
Solidny układ zazwyczaj zachowuje następującą sekwencję:
Najpierw aktualny status: pokaż, czy stan zasobu jest prawidłowy, obniżony czy krytyczny.
Następnie co się zmieniło: wyróżnij przesunięcia schematów, brakujące ładowania i skoki anomalii.
Dlaczego to ma znaczenie: dołącz powiązany proces biznesowy, tabelę lub raport na dalszym etapie.
Co robić teraz: skieruj problem do właściwego właściciela i ścieżki naprawczej.
Dlatego też dashboardy zorientowane na użytkownika działają lepiej niż odizolowane narzędzia operacyjne. Gdy ten sam interfejs służy inżynierom danych, analitykom i interesariuszom, raport nie rozbija się na osobne wersje prawdy. Staje się wspólną płaszczyzną operacyjną dla budowania zaufania, selekcji problemów (triage) i działań następczych.
Integracja raportowania z ramami zarządzania (Governance Framework)
Raport bez przypisanej odpowiedzialności to tylko szum. Jeśli nikt nie odpowiada za naprawę, dashboard staje się dekoracją, a organizacja staje się bardzo dobra w wielokrotnym obserwowaniu tego samego problemu. governance to to, co zamienia sygnał w odpowiedzialność.
Uczyń własność i kontekst nienegocjowalnymi
Największą ślepą plamą w raportowaniu jest pochodzenie danych (provenance). Użytkownicy muszą znać oryginalne źródło i kroki transformacji zastosowane zanim zestaw danych zostanie uznany za wysokiej jakości, ponieważ czysty raport wciąż może wprowadzać w błąd, gdy dane pochodzą z wielu systemów lub procesów roboczych wtórnego wykorzystania (wytyczne dotyczące pochodzenia i kontekstu transformacji). Ten kontekst ma tak samo duże znaczenie jak sam wynik jakości.
Kierowanie alertów powinno być jawne, a nie improwizowane. Awarie o wysokim ryzyku potrzebują jasnych właścicieli, podczas gdy kwestie o niższym priorytecie mogą być grupowane w zaplanowane przeglądy. Progi powinny być na tyle znaczące, aby uniknąć zmęczenia alertami, ponieważ zbyt duży szum uczy ludzi ignorowania systemu.
Ramy governance potrzebują również dowodów, które przetrwają kontrolę. Jeśli pracujesz w środowiskach regulowanych, zasób taki jak unikanie kar RODO dzięki data governance jest przydatnym przewodnikiem, ponieważ łączy myślenie o kontroli, odpowiedzialności i Compliance w sposób, z którego mogą korzystać zespoły techniczne.
Traktuj raportowanie jako wspólny model operacyjny
Najskuteczniejsze organizacje nie doklejają raportowania do governance po fakcie. Budują reguły raportowania, model własności i ścieżkę eskalacji wspólnie. W ten sposób każdy sygnał o jakości ma przypisaną do siebie ludzką ścieżkę działania.
Rezultatem jest system, który pomaga zespołom ufać danym, działać szybciej, gdy coś się zepsuje, i wyjaśniać interesariuszom, dlaczego dana metryka jest bezpieczna do użycia lub nie. To jest główna funkcja raportowania jakości danych (data quality reporting) – nie tylko pokazywanie, co się stało, ale upewnienie się, że ktoś może coś z tym zrobić.
Jeśli chcesz zastąpić reaktywne gaszenie pożarów danych ciągłymi sygnałami zaufania, platforma digna zapewnia zespołom monitorowanie wewnątrz bazy danych, walidację, śledzenie terminowości, wykrywanie anomalii i widoczność zmian schematów w ich własnym środowisku. Odwiedź stronę, zapoznaj się z modułami i zobacz, jak system raportowania może pomóc Twojemu zespołowi przejść od sprzątania po fakcie do proaktywnej kontroli.



Poznaj zespół tworzący platformę
Zespół z Wiednia, składający się z ekspertów od AI, danych i oprogramowania, wspierany rygorem akademickim i doświadczeniem korporacyjnym.