Jak budować pulpity nawigacyjne jakości danych, które naprawdę działają
|
7
min. czyt.

Znasz już ten schemat. Pulpit nawigacyjny wygląda dobrze o 8:30, ktoś zakłada, że nocne ładowanie zakończyło się pomyślnie, a zanim dział finansów otworzy liczby podczas przeglądu kadry kierowniczej, patrzy na dane z zeszłego tygodnia. Nikt nie otrzymuje wezwania, ponieważ nic nie „popsuło się” w sposób, który pulpit nawigacyjny mógłby wyjaśnić — zawiódł jedynie rurociąg, czas i zaufanie do raportu.
To prawdziwy problem z wieloma pulpitami nawigacyjnymi jakości danych. Wyglądają jak nadzór, ale zachowują się jak dekoracja, dopóki nie zostaną powiązane z procesem przepływu danych, wyraźnymi kontrolami i odpowiedzialnością. Użyteczny pulpit nawigacyjny nie tylko pokazuje wynik, ale mówi zespołowi, co poszło nie tak, gdzie wystąpił błąd, kto jest za niego odpowiedzialny i co należy zrobić dalej.
Spis treści
Dlaczego większość pulpitów nawigacyjnych jakości danych zawodzi przed południem
Odwzoruj proces przepływu danych przed wyborem pojedynczej metryki
Sześć wskaźników KPI, które musi śledzić każdy pulpit nawigacyjny jakości danych
Wzorce paneli dla Timeliness, anomalii, schematów i walidacji
Wybór wzorców wizualnych, które pozwalają na podjęcie decyzji w niecałe dziesięć sekund
Architektura, obliczenia w bazie danych i przekazywanie zadań w ramach nadzoru
Why Most Data Quality Dashboards Fail Before Noon
Poniedziałkowy poranek zazwyczaj obnaża słabe punkty. Dział finansów otwiera pulpit nawigacyjny, widzi liczby z zeszłego tygodnia i nikt nie zauważa, że nocne ładowanie opóźniło się, ponieważ widok nadal renderuje się czysto. Raport wygląda zdrowo, spotkanie zarządu się rozpoczyna, a pierwszą osobą, która zdaje sobie sprawę z problemu, jest ta zmuszona do wyjaśnienia, dlaczego pulpit nawigacyjny kłamał przez zaniechanie.
Ten wzorzec awarii jest powszechny, ponieważ zespoły traktują pulpity nawigacyjne jak statyczne raporty zamiast operacyjnych warstw kontrolnych. Monitorują objawy na dalszych etapach, gdy dane zostały już skonsumowane, co oznacza, że alert pojawia się po wystąpieniu wpływu na biznes. Polegają również na binarnych testach zaliczony/niezaliczony, co tworzy fałszywe poczucie pewności, ponieważ zielone światło często ukrywa powolny spadek jakości, brak świeżości danych lub zmianę schematu, która jeszcze nie doprowadziła do awarii.
Zasada praktyczna: jeśli pulpit nawigacyjny nie potrafi powiedzieć, co się zmieniło, kiedy się zmieniło i kto powinien podjąć działania, nie jest to system kontrolny.
Lepszy pulpit nawigacyjny ujawniłby opóźnienie, gdy tylko zaplanowana dostawa się przesunęła, a nie po tym, jak dział finansów odświeżył raport. Pokazałby, że problem leży na ścieżce dostarczania, a nie w logice biznesowej na dalszych etapach. To rozróżnienie ma znaczenie, ponieważ nieświeża partia, uszkodzone złączenie i brakująca kolumna wymagają różnych reakcji, a pojedynczy wynik kondycji ukrywa tę różnicę.
Wiele zespołów popełnia również ten sam błąd strukturalny w kwestii odpowiedzialności. Gromadzą ścianę metryk, ale nikt nie wie, który zespół jest odpowiedzialny za naprawę lub które sprawdzenie odpowiada któremu ryzyku. Rezultatem jest szum alertów, rozmycie odpowiedzialności i pulpity nawigacyjne, na które rzuca się okiem podczas incydentu, a przez resztę tygodnia ignoruje.
Map the Data Journey Before You Pick a Single Metric
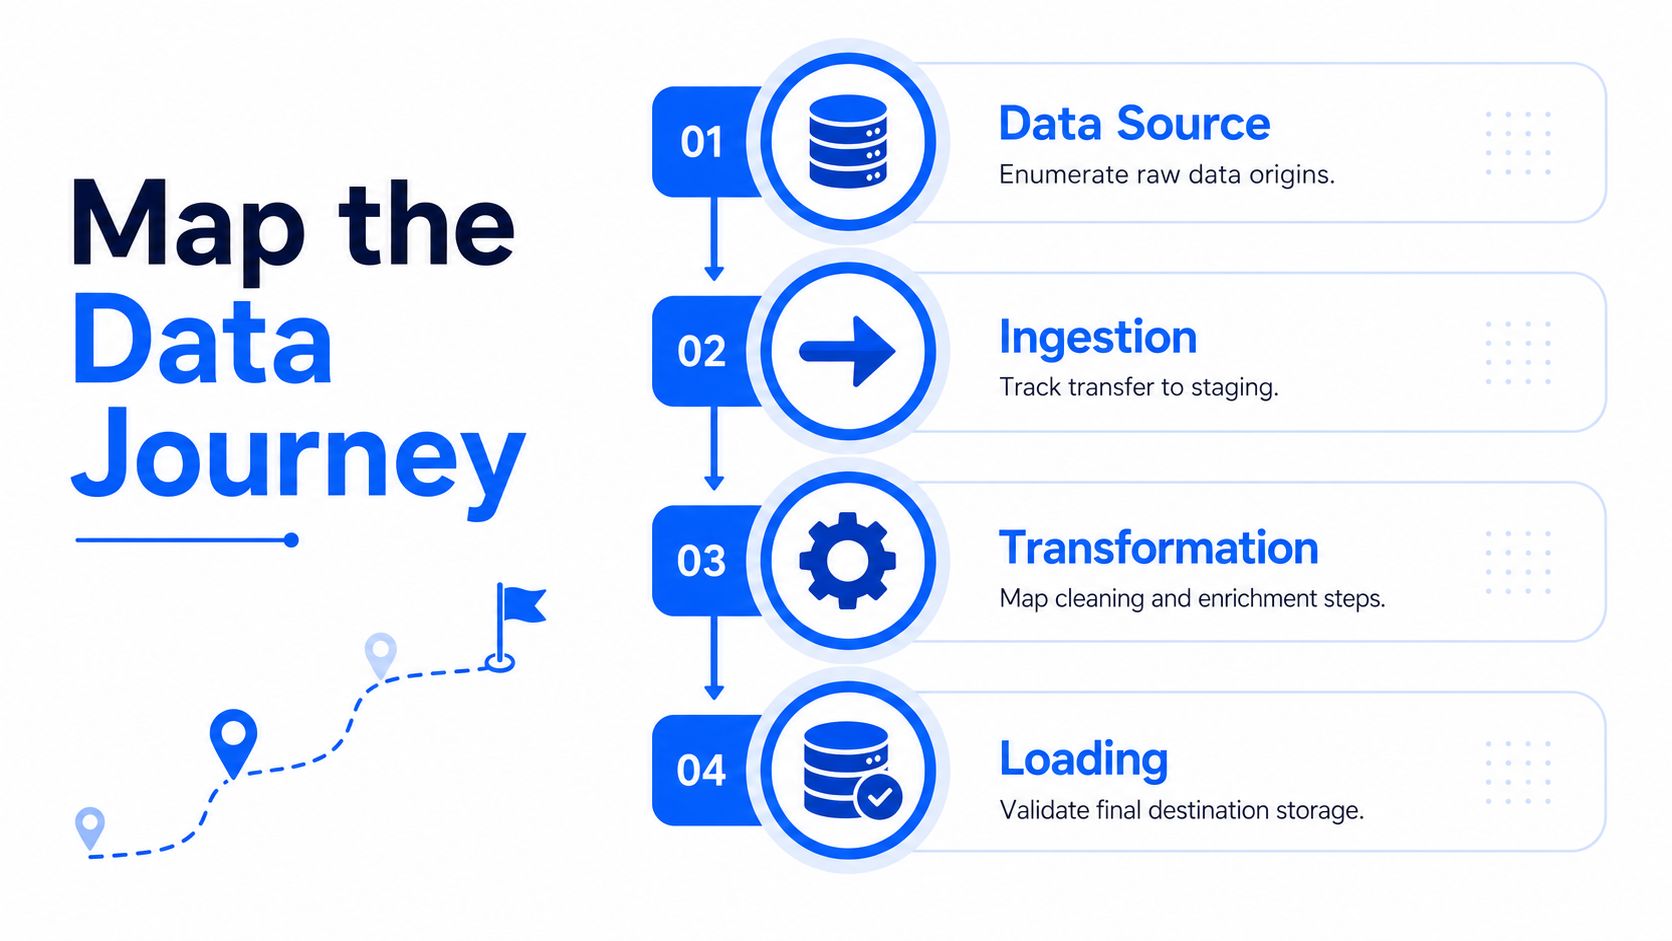
Pulpit nawigacyjny staje się użyteczny dopiero po zrozumieniu rurociągu jako sekwencji kontrolowanych kroków. Zacznij od zmapowania pełnego procesu przepływu danych — od źródła, przez pozyskiwanie i transformację, aż po udostępnianie — i zidentyfikuj, gdzie na każdym etapie może dojść do uszkodzenia. To mapowanie stanowi różnicę między wykryciem uszkodzonego wyniku a zapobieganiem uszkodzeniu w pierwszej kolejności, dlatego kontekst procesu ma większe znaczenie niż surowy wolumen metryk.
Attach controls to failure modes
Każde ryzyko powinno otrzymać kontrolę w punkcie, w którym może ono wystąpić. W praktyce oznacza to podjęcie decyzji, czy kontrola ma charakter zapobiegawczy, wykrywający czy korygujący, zamiast dorzucania ogólnych testów na końcu rurociągu z nadzieją na najlepsze. Spóźniony plik od dostawcy to nie to samo co zniekształcony rekord, a zduplikowany klucz w obszarze roboczym to nie to samo co uszkodzona tabela referencyjna.
Użyteczną jednostką projektową jest rekord kontrolny. Dla każdej kontroli należy udokumentować ryzyko, konsekwencje w przypadku niewykrycia, opis kontroli oraz dowód wykonania. Taka struktura sprawia, że pulpit nawigacyjny jest poddawany audytowi i daje operatorom możliwość podjęcia konkretnych działań zamiast niejasnego czerwonego kafelka.
Dobrym przykładem jest rurociąg zamówień klientów. Przy pozyskiwaniu kontrola zapobiegawcza może odrzucić zniekształcony plik, zanim zostanie zapisany. Podczas transformacji kontrola wykrywająca może oflagować nieoczekiwany wzrost wartości null w statusie zamówienia. Przy ładowaniu kontrola korygująca może skierować uszkodzoną partię do tabeli kwarantanny i powiadomić właściciela danych.
Nie monitoruj tylko tabeli końcowej. Jeśli uszkodzenie pojawi się na wcześniejszym etapie, objaw na dalszym etapie jest już zbyt późny, aby zapobiec szkodom biznesowym.
A simple mapping discipline that works
Wyszczególnij każdy etap. Zapisz, gdzie dane wchodzą, przemieszczają się, zmieniają kształt i stają się zdatne do użytku.
Nazwij tryb awarii. Pomyśl o brakującym pliku, zduplikowanym wierszu, nieprawidłowym kodzie, dryfcie schematu lub nieświeżym ładowaniu.
Wybierz typ kontroli. Zapobiegawcza w celu zatrzymania złych danych, wykrywająca w celu wykrycia dryftu, korygująca w celu skierowania do naprawy.
Zapisz odpowiedzialność. Kontrola nie jest kompletna, dopóki ktoś nie jest odpowiedzialny za reakcję.
Niewielka dyscyplina w tym obszarze pozwala uniknąć wielu hałaśliwych powiadomień z monitoringu w przyszłości. Gdy pulpit nawigacyjny jest zakorzeniony w procesie przepływu danych, każda metryka ma swoje miejsce, a każdy alert wskazuje na rzeczywiste ryzyko operacyjne.
The Six KPIs Every Data Quality Dashboard Must Track
Sześć podstawowych wymiarów nadal stanowi kręgosłup każdego poważnego pulpitu nawigacyjnego jakości danych, ale działają one tylko wtedy, gdy każdy z nich jest powiązany z mierzalną kontrolą. Celem nie jest abstrakcyjna ocena danych. Celem jest wykrycie, czy konkretne ryzyko pogarsza się, jest stabilne, czy już zakłóca proces biznesowy.
Measure each dimension as a control signal
Dokładność to zgodność między zestawem danych a zaufanym systemem ewidencji. W praktyce może to oznaczać wybiórcze uzgadnianie między rekordami źródłowymi i docelowymi lub porównywanie na poziomie pól dla kluczowych atrybutów.
Kompletność jest zazwyczaj wyrażana jako wskaźnik wartości null, ale dryf liczby wierszy również ma znaczenie. Tabela może wyglądać na zapełnioną, a mimo to może brakować w niej dużej części oczekiwanych rekordów.
Spójność sprawdza, czy relacje zachodzą między tabelami. Integralność referencyjna jest oczywistym przykładem, ale jest nim również zgodność między polami, gdzie jedna kolumna musi logicznie pasować do drugiej.
Timeliness wymaga więcej uwagi niż zwykłe sprawdzenie świeżości. Oczekiwany czas przybycia i rzeczywisty czas przybycia mówią o tym, czy opóźnienie jest nieszkodliwe, czy stanowi problem biznesowy, a to rozróżnienie jest niezbędne w przypadku niestabilnych rurociągów.
Ważność mierzy, czy wartości na poziomie rekordów spełniają reguły biznesowe, takie jak dozwolone zakresy, formaty lub logika warunkowa.
Unikalność śledzi zduplikowane klucze lub inne wzorce duplikacji, które zniekształciłyby zliczenia, złączenia lub widoki klientów na dalszych etapach.
Najbardziej praktyczną metodologią jest najpierw zdefiniowanie krytycznych elementów danych, zmapowanie reguł biznesowych na sprawdzenia techniczne, a następnie użycie wielopoziomowych progów zamiast binarnego modelu pass/fail. Praktyczne wskazówki zalecają priorytetowe traktowanie pól, które wpływają na zgodność (Compliance), raportowanie lub przychody, a następnie ustawienie przedziałów ważności, aby zespoły mogły dokonywać segregacji zamiast traktować każdą awarię jako równie pilną. To samo źródło zaleca również ścisły brązowy próg poniżej 95% do natychmiastowej naprawy, co jest przydatnym wzorcem, gdy pole ma kluczowe znaczenie dla regulowanego przepływu pracy lub raportu o przychodach. Practical framework for accuracy and trust
Wymiar | Typ kontroli | Przykładowa metryka | Wzorzec brązowego progu |
|---|---|---|---|
Dokładność | Wykrywająca | Wyrywkowe dopasowanie rekordów do systemu ewidencji | Natychmiastowy przegląd w przypadku rozbieżności w kluczowych polach |
Kompletność | Wykrywająca | Wskaźnik wartości null i dryf liczby wierszy | Poniżej ścisłego limitu dla wymaganych pól |
Spójność | Wykrywająca | Błędy integralności referencyjnej | Natychmiastowa naprawa uszkodzonych relacji |
Timeliness | Zapobiegawcza lub wykrywająca | Oczekiwane przybycie w stosunku do rzeczywistego przybycia | Opóźnienie poza uzgodniony przedział harmonogramu |
Ważność | Zapobiegawcza lub wykrywająca | Wskaźnik pomyślnych reguł przy sprawdzeniach na poziomie pól | Poniżej limitu dla pól regulowanych lub o wysokim ryzyku |
Unikalność | Wykrywająca | Wskaźnik zduplikowanych kluczy | Natychmiastowe zbadanie kluczy tożsamości lub transakcyjnych |
Częstym błędem jest nadawanie wszystkim sześciu wymiarom równej wagi. To rozprasza uwagę i generuje hałaśliwe alerty, ponieważ nie każda reguła zasługuje na taką samą reakcję operacyjną. Mała liczba krytycznych sprawdzeń, wyraźnie podzielona na przedziały i przypisana do właścicieli, za każdym razem wygrywa z gigantycznym stosem zielonych i czerwonych plakietek. W celu zapoznania się z bardziej szczegółowym katalogiem metryk warto zestawić wewnętrzny przewodnik na stronie metryk jakości danych digna z własną listą krytycznych elementów danych.
Panel Patterns for Timeliness, Anomalies, Schema, and Validation
Powierzchnia pulpitu nawigacyjnego powinna odzwierciedlać rodzaj zadawanego pytania, a nie odwrotnie. Widok główny wymaga szybkiego odczytu, czy rurociąg jest sprawny. Widoki szczegółowe potrzebują wystarczającej ilości szczegółów, aby wyjaśnić, dlaczego tak nie jest. To rozróżnienie ma znaczenie, ponieważ wynik kondycji bez paneli z możliwością inspekcji staje się zrzutem ekranu, a nie działającym narzędziem.
Timeliness and anomaly panels
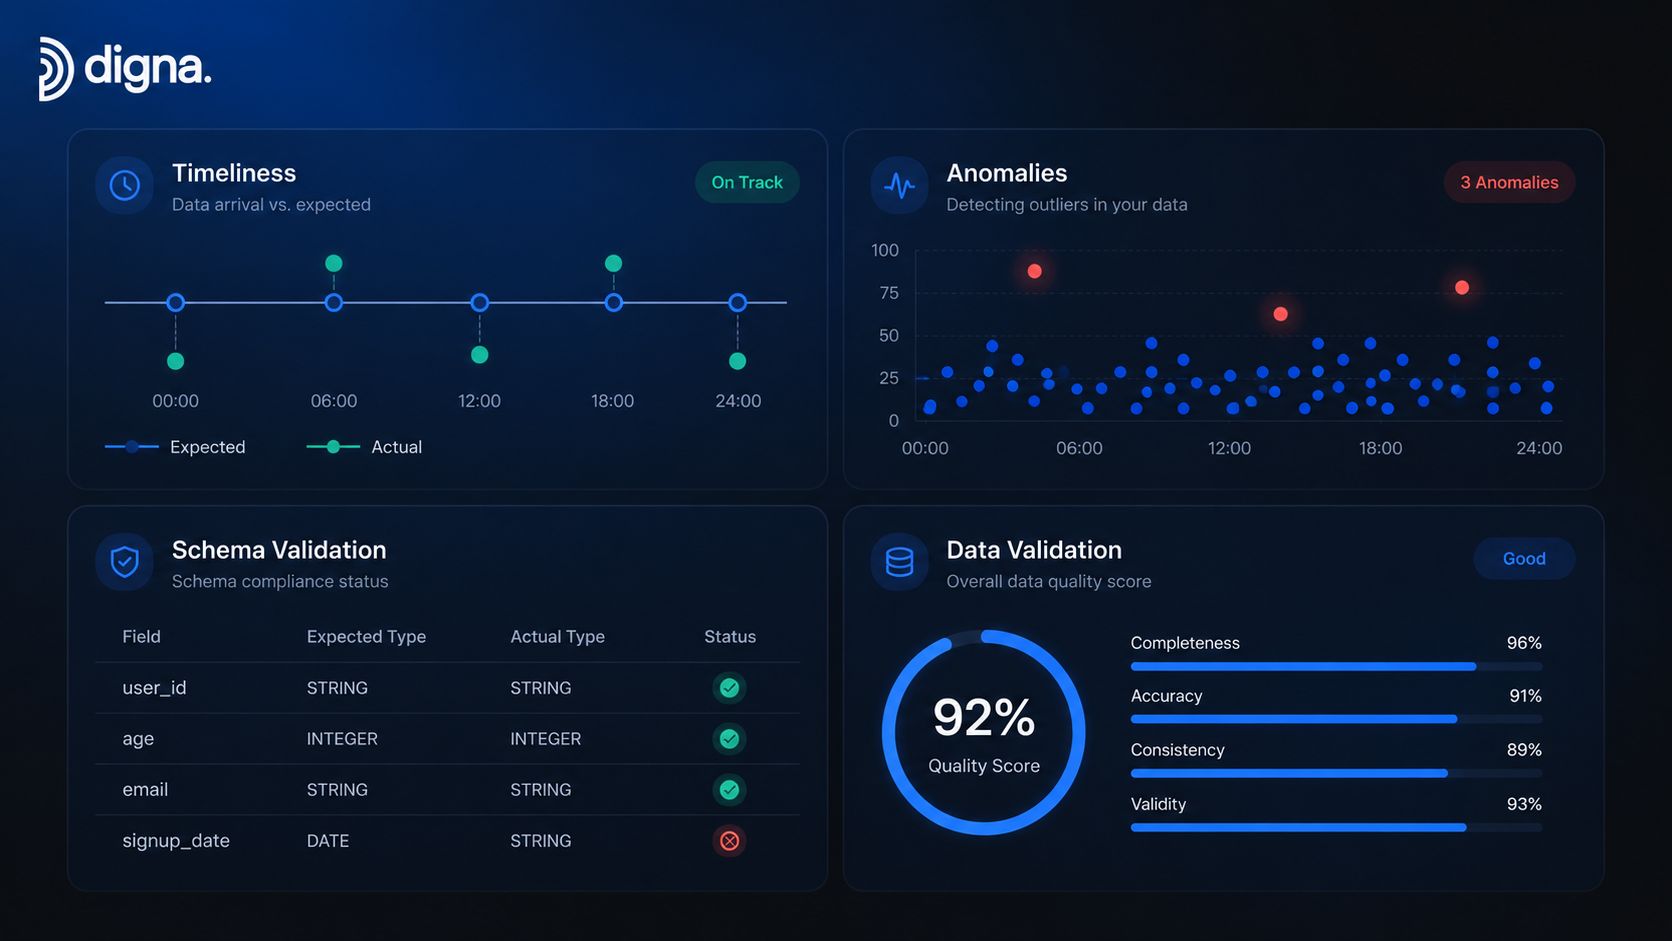
Panel terminowości powinien porównywać oczekiwany czas przybycia z rzeczywistym czasem przybycia i wyraźnie pokazywać opóźnienie. Kilkuminutowe opóźnienie partii to inna sytuacja operacyjna niż całkowite pominięcie harmonogramu przez partię. Przydatnym wynikiem jest opóźnienie w konkretnej jednostce oraz widoczny znacznik harmonogramu, który informuje operatora, czy problem jest rutynowy, czy odbiega od wzorca.
Panel anomalii powinien pokazywać wyuczone zachowanie bazowe w zestawieniu z bieżącą wartością, a następnie wyróżniać punkty wykraczające poza oczekiwany przedział. Działa to lepiej niż pojedyncza liczba, ponieważ rejestruje zarówno stopniowy dryf, jak i nagłe przerwy. Miejsce na kontekst historyczny jest również tutaj, ponieważ nagły skok niewiele znaczy bez wcześniejszego wzorca określającego, co jest „normalne”.
Schema and validation panels
A Schema Tracker powinien rejestrować dodane kolumny, usunięte kolumny i zmiany typów wraz ze znacznikami czasu i powiązanymi obiektami na dalszych etapach. Pozwala to inżynierom zobaczyć promień rażenia, zanim uszkodzone pole dotrze do raportowania lub oceny modelu. Pomaga to również, gdy niewinnie wyglądająca zmiana nazwy zamienia się w incydent produkcyjny, ponieważ zadanie na dalszym etapie nadal oczekuje starego kształtu danych.
Panel walidacji powinien zawierać listę reguł, które nie przeszły testu na poziomie rekordów, przykładowe rekordy i ścieżki przypisania odpowiedzialności. Nie powinien ukrywać rzeczywistych błędnych wierszy za ogólnym wynikiem. Operatorzy muszą wiedzieć, co uległo awarii, w który zestaw danych uderzyło i kto jest odpowiedzialny za naprawę.
Dobra strona główna odpowiada na jedno pytanie: czy cokolwiek zmierza w kierunku awarii. Wszystko inne znajduje się o jedno kliknięcie głębiej.
Platformy takie jak digna organizują te powierzchnie wokół Data Timeliness, Data Anomalies, Schema Tracker i Data Validation. Układ ten dobrze odpowiada powyższym panelom, ponieważ oddziela monitorowanie operacyjne od inspekcji śledczej. Wewnętrzna nota dotycząca najlepszych praktyk pod adresem najlepsze praktyki w zakresie Observability stanowi przydatny punkt odniesienia przy podejmowaniu decyzji, jak wiele szczegółów powinno znaleźć się na pierwszym ekranie, a ile w widoku szczegółowym.
Choosing Visual Patterns That Drive Decisions in Under Ten Seconds
Każdy wykres na pulpicie nawigacyjnym jakości danych powinien pozwalać na podjęcie decyzji w niecałe dziesięć sekund. Jeśli tak nie jest, prawdopodobnie zajmuje miejsce, które powinno należeć do karty wyników, linii trendu lub widoku pochodzenia danych (lineage). Właściwy wzorzec zależy od tego, czy użytkownik musi coś zauważyć, porównać, czy zbadać.

Match the chart to the decision
Karta wyników z kolorami sygnalizacji świetlnej sprawdza się najlepiej, gdy jedynym pytaniem jest to, czy w tej chwili wymagane jest działanie. Jest to przydatne dla kadry kierowniczej, która chce uzyskać szybki sygnał dotyczący kilku krytycznych zestawów danych.
Skumulowana linia trendu jest lepsza, gdy zadaniem jest wykrycie powolnego spadku jakości. Wskaźniki o pojedynczej wartości wyglądają estetycznie, ale ukrywają to, czy metryka dryfuje z tygodnia na tydzień, czy też pozostaje stabilna z normalną wariancją.
Widok topologii lub pochodzenia danych (lineage) to jedyny uczciwy sposób na pokazanie promienia rażenia zmiany schematu. Jeśli zmiana nazwy kolumny wpływa na trzy zadania na dalszych etapach i dwa pulpity nawigacyjne, użytkownik powinien widzieć tę ścieżkę, a nie tylko uszkodzoną tabelę.
Use separate views for separate roles
Widok dla kadry kierowniczej powinien kompresować stan programu do niewielkiej liczby decyzji. Widok dla opiekuna danych (data steward) wymaga określenia odpowiedzialności, wyjątków i statusu naprawy. Widok inżyniera dyżurnego potrzebuje znaczników czasu, próbek i konkretnej kontroli, która zakończyła się niepowodzeniem.
Ta sama podstawowa metryka może służyć wszystkim trzem grupom odbiorców, ale nie w tej samej prezentacji. Prosty wykres słupkowy może wystarczyć do ustalania priorytetów, podczas gdy gęste drzewo szczegółowe jest lepsze do badania po fakcie. Dekoracyjne wizualizacje są stratą czasu, jeśli nie skracają czasu do podjęcia działania.
Jeśli wykres wygląda imponująco, ale nie wpływa na kolejny krok, jego miejsce jest w prezentacji, a nie w systemie monitorowania.
Zasada jest prosta. Używaj najprostszego rozwiązania wizualnego, które wciąż odpowiada na pytanie operacyjne. Wszystko, co bardziej skomplikowane, zwiększa obciążenie poznawcze bez usprawnienia naprawy.
Alerting, Escalation, and Tuning Out Alert Fatigue
Alertowanie to obszar, w którym wiele pulpitów nawigacyjnych albo zdobywa zaufanie, albo traci je bezpowrotnie. Jeśli każde przekroczenie progu wywołuje ten sam rodzaj szumu, operatorzy przestają wierzyć systemowi. Jeśli system alarmuje tylko o poważnych awariach, omija powolny spadek jakości, którego naprawa na wcześniejszym etapie byłaby tania.
Design alerts around ownership and severity
Wielopoziomowe alerty działają lepiej niż pojedynczy próg, ponieważ mapują ścieżki reakcji. Przedział krytyczny powinien powiadomić wyznaczonego właściciela. Przedział wysoki może wywołać pilny przegląd. Niższe przedziały powinny być rejestrowane, analizowane pod kątem trendów i oczekiwać na agregację, chyba że się utrzymują.
Każdy alert potrzebuje wyznaczonego właściciela i linku do procedury postępowania (runbook). Bez tego alert jest tylko skargą ze znacznikiem czasu. Mapowanie odpowiedzialności ma znaczenie, ponieważ osoba otrzymująca sygnał powinna już wiedzieć, czy może go naprawić, przekierować, czy eskalować.
Najtrudniejszą częścią jest dostrajanie. Jeden z publicznych przykładów ITSV opisywał ponad 140 codziennych alertów, z których większość była ignorowana, ponieważ zalew skrzynki odbiorczej uniemożliwiał oddzielenie sygnału od szumu. Taki jest koszt nieskalibrowanego alertowania i właśnie dlatego nauka stanu bazowego oraz mapowanie odpowiedzialności są tak ważne. Data quality dashboard importance and alert fatigue
Reduce noise without hiding real risk
Okna o znanym, prawidłowym statusie powinny być wyciszane. Planowana konserwacja, przełączenia partii i zaplanowane uzupełnienia danych nie powinny niepokoić zespołu, jeśli zdarzenie było oczekiwane i udokumentowane. Godziny ciszy i okna wyjątków pozwalają na korzystanie z pulpitu nawigacyjnego bez tworzenia w nim luk.
Metryką operacyjną, która ma największe znaczenie, nie jest surowa liczba alertów. Jest nią to, czy ludzie szybko reagują na właściwe alerty i czy system nadal generuje fałszywe alarmy. Jeśli wskaźnik potwierdzania jest słaby, próg jest prawdopodobnie zbyt hałaśliwy, trasowanie jest błędne lub właściciel nie jest rzeczywisty.
Widziałem, jak zespoły odzyskiwały zaufanie dopiero po zawężeniu warunków wymagających powiadomienia do garstki tych, które zagrażają usłudze lub zgodności (Compliance). Wszystko inne jest nadal śledzone, ale nie zakłóca nikomu nocy, chyba że wpływ na biznes to uzasadnia. Ta równowaga sprawia, że pulpit nawigacyjny działa jak system kontrolny, a nie syrena alarmowa.
Architecture, In-Database Computation, and Governance Handoffs
Domyślną architekturą dla poważnego pulpitu nawigacyjnego jest obliczanie metryk w bazie danych. Pozostawienie analiz tam, gdzie dane już się znajdują, pozwala zachować świeżość, ograniczyć niepotrzebny ruch i uniknąć kopiowania wrażliwych rekordów do innego systemu tylko po to, by je zmierzyć. Ten wzorzec ułatwia również utrzymanie analizy trendów, wykrywania anomalii i śledzenia schematów w tym samym magazynie metryk bez fragmentacji rurociągu.
Connect the dashboard to governance, not just monitoring
Pulpit nawigacyjny powinien płynnie łączyć się z governance. Opiekunowie danych (data stewards) odpowiadają za biznesową interpretację paneli, inżynieria za kontrole operacyjne, a audyt potrzebuje identyfikowalnego rejestru tego, co się zmieniło i co zostało zrobione. To przekazanie działa tylko wtedy, gdy pulpit nawigacyjny zapisuje wystarczający kontekst do przeglądu, w tym historię kontroli i dowody wykonania.
Projekt platformy ma znaczenie. System taki jak digna oblicza sygnały wewnątrz środowiska klienta, co utrzymuje widok operacyjny w zgodzie z modelem rezydentności danych i pozwala uniknąć dodatkowych kopii tylko na potrzeby monitorowania. To samo podejście wspiera również procesy governance, ponieważ wyniki można powiązać z kontraktami danych (Data Contract), pochodzeniem danych (lineage) i procesami przeglądu bez przekształcania pulpitu nawigacyjnego w osobną wyspę.
Czysta ścieżka wdrożenia jest prosta:
Trzymaj obliczenia blisko danych. Sygnały o świeżości są słabsze, gdy zależą od ruchu między systemami.
Przechowuj historię dla każdego uruchomienia kontroli. Jeden wiersz na uruchomienie daje trendy, a nie tylko stan bieżący.
Kieruj wyniki do właścicieli. Wynik bez przypisanego właściciela to tylko notatka.
Zasilaj governance z tego samego magazynu metryk. Dzięki temu zadania stewardship, audyt i inżynieria pozostają spójne.
Pulpit nawigacyjny nie jest produktem końcowym. To punkt kontrolny, w którym spotykają się operacje, analityka i governance. Gdy jest zbudowany w ten sposób, pulpit nawigacyjny pomaga zespołom szybciej wykrywać spadek jakości, przypisywać właściwe poprawki i udowadniać, że naprawa zadziałała.
Jeśli budujesz lub przebudowujesz pulpity nawigacyjne jakości danych, skup się na mapowaniu procesów, wielopoziomowych progach i odpowiedzialności za alerty, zanim dopracujesz wizualizacje. digna zapewnia monitorowanie w bazie danych pod kątem anomalii, terminowości, walidacji, zmian schematu i analizy trendów, dzięki czemu zespoły mogą utrzymać pętlę kontrolną we własnym środowisku. Odwiedź digna, jeśli chcesz zaprojektować pulpit nawigacyjny, który łączy kontrole, odpowiedzialność i reakcję bez zamieniania monitoringu w kolejne źródło szumu.


