Playbook poprawy jakości danych dla zespołów korporacyjnych
|
6
min. czyt.

Kwartalny pulpit nawigacyjny przychodów może wyglądać idealnie zdrowo, jednocześnie zawyżając rezerwacje w regionie EMEA przez całe tygodnie. Aktualizacja oprogramowania dostawcy zmienia kolumnę waluty w systemie źródłowym, do hurtowni zaczynają spływać wartości puste (null), a dalsza transformacja błędnie interpretuje brakujące wartości. Dział finansowy odkrywa problem podczas przygotowań do posiedzenia zarządu, gdy analitycy rozesłali już raporty, a liderzy podjęli na ich podstawie decyzje.
Ten incydent to nie jest przede wszystkim problem pulpitu nawigacyjnego. To porażka w obszarze data quality improvement obejmująca kontrolę schematu, terminowość (Timeliness), własność i reagowanie na incydenty. Rozwiązaniem nie jest kolejny odizolowany zakup narzędzia monitorującego. Jest nim model operacyjny, który definiuje, co oznaczają wiarygodne dane, przypisuje odpowiedzialność zespołom, które je tworzą, wykrywa defekty blisko ich źródła i mierzy, jak szybko organizacja przywraca zaufanie.
Spis treści
Dlaczego większość programów jakości danych utyka w martwym punkcie, zanim się rozpocznie
Narzędzie rzadko stanowi model operacyjny
Zakres pokrycia musi wykraczać poza kompletność
Ocena bieżącego stanu jakości danych
Budowanie punktu odniesienia w oparciu o cztery źródła dowodów
Tworzenie mierzalnego obrazu dojrzałości
Definiowanie umów SLA i wskaźników KPI, które faktycznie działają
Klasyfikacja zbiorów danych według konsekwencji
Oddzielenie wczesnych sygnałów od miar wyników
Walidacja, detekcja anomalii, terminowość (Timeliness) i kontrola schematu
Dopasowanie kontroli do defektu
Wykonywanie wewnątrz bazy danych, integracja z przepływem pracy i scenariusze procedur
Kierowanie sygnałów do istniejących procesów pracy
Tworzenie wykonywalnych scenariuszy procedur
Organizacja zespołów, własność i kadencja operacyjna
Podział ról
Zamiana spotkań w artefakty
Pomiar ROI i pierwsze 90 dni
Przekształcanie strat operacyjnych w uzasadnienie biznesowe
Zastosowanie skoncentrowanej sekwencji 90 dni
Dlaczego większość programów jakości danych utyka w martwym punkcie, zanim się rozpocznie
Pierwsza reakcja na incydent taki jak ten w regionie EMEA jest często przewidywalna. Ktoś proponuje platformę jakości danych, inny zespół buduje pulpit nawigacyjny pokazujący odsetek wartości pustych, a centrum doskonałości publikuje standardy, których producenci nigdy nie widzą. Organizacja tworzy widoczną aktywność bez zmiany warunków, które pozwoliły na wystąpienie defektu.
Narzędzie rzadko stanowi model operacyjny
Narzędzie do kontroli jakości może obliczać metryki, wykonywać reguły i kierować alerty. Nie może jednak zdecydować, czy właścicielem pola waluty jest zespół finansowy, czy zespół systemów komercyjnych. Nie może również określić, czy brakująca wartość powinna zablokować ładowanie danych, poddać kwarantannie dotknięte rekordy, czy też wygenerować ostrzeżenie przy jednoczesnym kontynuowaniu przetwarzania.
Taka decyzja wymaga udokumentowanej umowy między producentami a konsumentami. Bez niej zespoły debatują nad alertami po incydencie, zamiast wcześniej uzgodnić akceptowalne zachowanie. Przydatne omówienie przyczyn strukturalnych znajduje się w tej analizie przyczyn niepowodzeń projektów związanych z jakością danych, w szczególności w rozróżnieniu między symptomami technicznymi a przyczynami organizacyjnymi.
Zakres pokrycia musi wykraczać poza kompletność
Wskaźniki wartości pustych są przydatne, ale tabela może być kompletna i nadal zawierać błędy. Zasilenie danymi może dotrzeć z opóźnieniem, zawierać zmieniony schemat, używać nieprawidłowego kodu waluty lub wprowadzać zduplikowane klucze biznesowe. Zespoły, które mierzą tylko kompletność, tworzą fałszywe poczucie kontroli, ponieważ sprawdzają jeden wymiar, ignorując okno decyzyjne i znaczenie danych.
Działający program przypisuje kontrole do ryzyka, które ma znaczenie:
Standardy: Definicje, akceptowane wartości, własność i procedury zmian.
Odpowiedzialność: Wyznaczeni producenci i opiekunowie danych (stewardzi) mający uprawnienia do rozwiązywania defektów.
Informacja zwrotna: Alerty, zgłoszenia, retrospektywy i zmiany w potokach danych (pipelines), które zapobiegają ponownemu wystąpieniu problemów.
Jakość wymaga również spojrzenia ekonomicznego. Raport podsumowujący IBM Institute for Business Value wykazał, że 43% dyrektorów operacyjnych wskazało kwestie jakości danych jako swój najważniejszy priorytet w obszarze danych. Ponad jedna czwarta organizacji zgłosiła roczne straty przekraczające 5 milionów USD, podczas gdy 7% zgłosiło straty na poziomie co najmniej 25 milionów USD. Liczby te wyjaśniają, dlaczego jakość powinna być uwzględniana w przeglądach operacyjnych, a nie tylko w zaległościach technicznych inżynierów.
Praktyczną jednostką postępu jest cykl od incydentu do rozwiązania. Program działa poprawnie, gdy wcześniej wykrywa awarie, kieruje je do właściwego właściciela, ogranicza wpływ na kolejne etapy procesu i przekształca każdy wniosek po incydencie w silniejszą kontrolę potoku danych.
Ocena bieżącego stanu jakości danych
Zacznij od dowodów, a nie od frustracji interesariuszy. Ludzie często mówią, że nie ufają danemu zbiorowi danych, ale to odczucie może wynikać z kilku widocznych incydentów, niejasnych definicji lub mierzalnych defektów. Twój punkt odniesienia powinien obejmować wszystkie te trzy elementy.
Budowanie punktu odniesienia w oparciu o cztery źródła dowodów
Po pierwsze, przeprowadź archeologię incydentów. Wyeksportuj zgłoszenia powiązane z danymi z ostatnich sześciu miesięcy z systemu Jira lub ServiceNow. Pogrupuj zgłoszenia według domeny, zbioru danych, którego dotyczyły, typu defektu, przyczyny źródłowej, czasu wykrycia, czasu rozwiązania oraz tego, czy ten sam problem pojawił się już wcześniej. Nie odrzucaj „małych” zgłoszeń. Powtarzające się ręczne korekty często ujawniają słabość procesu, którą później obnaża poważna awaria.
Po drugie, profiluj kluczowe tabele automatycznie. Zbadaj wskaźniki wartości pustych, unikalną kardynalność, wartości minimalne i maksymalne, zduplikowane klucze, integralność referencyjną oraz zmiany dystrybucji. Tam, gdzie to stosowne, porównaj liczbę rekordów w źródle i celu, ale nie traktuj zgodnej liczby wierszy jako dowodu poprawności. Transformacja może zachować wolumen, jednocześnie uszkadzając wartości.
Po trzecie, przeprowadź osobne ankiety wśród producentów i konsumentów. Zapytaj producentów, które pola ich zdaniem należą do nich, a konsumentów – czy dane są odpowiednie do podejmowania decyzji. Zgromadź jakościowe oceny zaufania wraz z wzorcami użytkowania, kluczowymi raportami, modelami i operacyjnymi przepływami pracy. Często używany zbiór danych o niskim poziomie zaufania zasługuje na priorytet, nawet jeśli jego historia incydentów jest spokojna.
Po czwarte, sklasyfikuj defekty według sześciu wymiarów. Używaj dokładności, kompletności, spójności, terminowości (Timeliness), poprawności (Compliance) i unikalności jako wspólnego słownictwa. Model dojrzałości jakości danych może pomóc zespołom przekształcić rozproszone obserwacje w powtarzalny punkt odniesienia, a nie jednorazowe warsztaty.
Tworzenie mierzalnego obrazu dojrzałości
Oceń każdy wymiar w skali od 1 do 5, opierając się na jednoznacznych dowodach. Niska ocena może oznaczać, że organizacja nie posiada wspólnej definicji ani powtarzalnego pomiaru. Średnia ocena może wskazywać na zautomatyzowane kontrole, ale niespójną własność. Wysoka ocena powinna wymagać udokumentowanych progów, monitorowanych kontroli, odpowiedzialnych właścicieli, historii incydentów i regularnego doskonalenia.
Wymiar | Główny wskaźnik | Podejście do próbkowania | Typowe źródło wykrywania |
|---|---|---|---|
Dokładność | Zgodność z autorytatywnym źródłem lub zweryfikowanym wynikiem | Porównanie kluczowych pól z rekordami źródłowymi lub zatwierdzonymi danymi referencyjnymi | Uzgadnianie danych, weryfikacja przez konsumenta |
Kompletność | Wskaźniki wartości pustych, brakujących rekordów i wymaganych pól | Weryfikacja pełnych tabel dla kluczowych pól, próbkowanie dla atrybutów o niższym ryzyku | Profilowanie, testy walidacyjne |
Spójność | Zgodność między systemami, tabelami i definicjami | Porównanie wspólnych kluczy, jednostek, etykiet i obliczonych wartości | Międzysystemowe uzgadnianie danych |
Timeliness | Przybycie i dostępność w odniesieniu do okna decyzyjnego | Monitorowanie każdej oczekiwanej partycji lub zdarzenia dostarczenia | Monitor harmonogramu, logi potoków danych |
Compliance | Zgodność z typami, zakresami, formatami i regułami biznesowymi | Pełna kontrola pól z ograniczeniami, celowane próbkowanie złożonych rekordów | Sprawdzanie schematów, silnik reguł |
Unikalność | Wskaźnik duplikatów dla zdefiniowanych kluczy biznesowych | Skanowanie pełnych kluczy lub przyrostowe wykrywanie duplikatów | Ograniczenia bazy danych, profilowanie |
Utrzymuj wersjonowanie punktu odniesienia. Wynik bez powiązanych testów, próbek i definicji nie pozwoli na porównanie wyników kwartał do kwartału.
Definiowanie umów SLA i wskaźników KPI, które faktycznie działają
Umowa SLA dotycząca jakości danych wymaga czterech elementów: właściciela, progu, okna pomiarowego i ścieżki eskalacji. Usuń którykolwiek z nich, a SLA stanie się jedynie pobożnym życzeniem. Sformułowanie „utrzymywać świeżość danych” jest niewykonalne. Natomiast sformułowanie „dane o ryzyku muszą zostać dostarczone w uzgodnionym oknie decyzyjnym, a w przypadku przekroczenia progu właściciel danych o ryzyku zostanie powiadomiony” ma charakter operacyjny.
Klasyfikacja zbiorów danych według konsekwencji
Nie stosuj tej samej intensywności kontroli do każdej tabeli. Sklasyfikuj zbiory danych jako krytyczne, operacyjne lub eksploracyjne w zależności od wpływu na biznes, wymogów regulacyjnych, zależności na kolejnych etapach procesów i oczekiwań dotyczących odzyskiwania danych.
Krytyczne zbiory danych wspierają raportowanie finansowe, decyzje o ryzyku, sprawozdawczość regulacyjną lub kluczowe operacje z klientami. Operacyjne zbiory danych napędzają powtarzające się przepływy pracy i raportowanie zarządcze. Eksploracyjne zbiory danych wspierają analizy, w których opóźnione lub niepełne dane są niedogodnością, ale nie powodują natychmiastowych szkód.
Progi powinny odzwierciedlać rzeczywiste zastosowanie, a nie uniwersalną kartę wyników. Tabela faktów dotycząca przychodów może wymagać 95% kompletności, podczas gdy śródstandardowy strumień danych o ryzyku może wymagać 98% świeżości, ale te liczby mają znaczenie tylko wtedy, gdy każda z nich jest powiązana z właścicielem, zdefiniowanym oknem pomiarowym i jasną reakcją. Chodzi o to, aby kompromisy biznesowe były widoczne.
Oddzielenie wczesnych sygnałów od miar wyników
Liczba wierszy i wskaźniki wartości pustych opisują stan danych po przetwarzaniu. Są one przydatnymi wskaźnikami opóźnionymi, ale nie powiedzą Ci, czy model operacyjny ulega poprawie. Dodaj wskaźniki wyprzedzające, takie jak wskaźnik naruszeń SLA, czas potwierdzenia zgłoszenia, wskaźnik defektów zgłaszanych przez konsumentów, wskaźnik powtarzających się incydentów oraz odsetek krytycznych zbiorów danych z aktualnymi scenariuszami procedur.
Poziom | SLA świeżości danych | KPI kompletności | KPI poprawności (Compliance) | Odpowiedzialność właściciela |
|---|---|---|---|---|
Krytyczny | Zdefiniowane przez okno decyzyjne i monitorowane przy każdym dostarczeniu | Wymagane pola mierzone przy każdym ładowaniu | Reguły biznesowe blokują lub poddają kwarantannie istotne błędy | Wyznaczony opiekun, właściciel będący producentem oraz eskalacja dyżurna |
Operacyjny | Uzgodnione okno dostarczania ze stanami ostrzeżeń i naruszeń | Trend monitorowany pod kątem zatwierdzonego progu | Nieprawidłowe rekordy kierowane do poprawy przed ich użyciem | Producent rozwiązuje problem, opiekun potwierdza przydatność |
Eksploracyjny | Dostępność na zasadzie starannego działania z widocznym statusem | Profilowane okresowo zamiast blokowania pracy | Ostrzeżenia udokumentowane pod kątem znanych ograniczeń | Konsument akceptuje ryzyko lub zgłasza je wyżej |
Publikuj umowy SLA tam, gdzie pracują producenci. Umieść je w repozytorium hurtowni, konfiguracji potoku danych, szablonie pull request i scenariuszu procedury obsługi incydentów. Portal ładu (governance) może przechowywać kanoniczną definicję, ale nie powinien być jedynym miejscem, w którym inżynierowie mogą znaleźć treść umowy.
Validation, Anomaly Detection, Timeliness, and Schema Controls
Żadna pojedyncza kontrola nie wyłapie każdego defektu. Walidacja oparta na regułach (Data Validation) zapewnia precyzję tam, gdzie warunki umowy są znane. Detekcja oparta na sztucznej inteligencji zapewnia szersze pokrycie w przypadkach, gdy normalne zachowanie jest trudne do zakodowania. Kontrole terminowości (Timeliness) i schematu dotyczą takich rodzajów błędów, które często umykają weryfikacji na poziomie wartości.
Dopasowanie kontroli do defektu
Walidacja deterministyczna to właściwy wybór dla pól wymaganych, unikalności, integralności referencyjnej, zestawów akceptowanych wartości, typów danych i znanych reguł biznesowych na poziomie wierszy. Jest łatwa w interpretacji i powiązaniu ze ścieżką audytu. Jej słabością jest utrzymanie. Każda nowa reguła wymaga stworzenia, przetestowania i przypisania właściciela, a reguła nie wykryje błędu, którego nikt wcześniej nie przewidział.
Detekcja anomalii uczy się normalnych rozkładów, wolumenów, kardynalności i zachowań w czasie. Może wykryć cichy dryf danych, nieoczekiwane przesunięcia i zmiany w strukturze danych dostawcy bez konieczności tworzenia reguły dla każdej możliwości. Wadą jest interpretacja. Alert statystyczny wymaga kontekstu, a zespoły muszą go odpowiednio dostroić, aby nietypowe, ale w pełni poprawne zdarzenia nie powodowały zmęczenia alertami.
Monitorowanie terminowości (Timeliness) sprawdza, czy dane docierają i stają się użyteczne w określonym oknie decyzyjnym. Tabela, która istnieje, ale odzwierciedla stan z wczoraj, nie jest przydatna w procesie śróddziennym. Wskazówki dotyczące monitorowania terminowości (timeliness) i walidacji danych zalecają automatyczne progi starzenia się danych, tak aby nieaktualne rekordy były oznaczane flagą, zanim oparte na nich zostaną kolejne etapy procesów.
Śledzenie schematu wersjonuje typy kolumn, dopuszczalność wartości pustych, struktury zagnieżdżone i obecność pól. Powinno ono odróżniać zmiany o charakterze addytywnym od zmian powodujących błędy (breaking changes) oraz od dryfu semantycznego. Dodanie kolumny dopuszczającej wartości puste może być bezpieczne dla jednego konsumenta, a dla innego destrukcyjne, dlatego kluczowe znaczenie ma analiza powiązań (lineage) i wpływu zmian.
Kontrola | Co wykrywa | Co pomija | Profil kosztów | Najlepiej dopasowana warstwa |
|---|---|---|---|---|
Deterministyczna walidacja (Data Validation) | Znane naruszenia reguł i błędy zapisów umownych | Nietypowe wzorce wykraczające poza zdefiniowane reguły | Przewidywalny nakład pracy przy tworzeniu i utrzymaniu | Pozyskiwanie, normalizacja, serwowanie danych |
Detekcja anomalii oparta na AI | Przesunięcia dystrybucji, nietypowe wolumeny, cichy dryf zachowań | Kontekst wymagający biznesowego wyjaśnienia | Mniejsza potrzeba ręcznego tworzenia reguł, większa konieczność strojenia | Szerokie monitorowanie w potokach danych |
Kontrole terminowości (Timeliness) | Pominięte zasilenia, opóźnione partycje, nieaktualne (ale obecne) dane | Wartości, które docierają na czas, ale zawierają błędy | Niski po zdefiniowaniu harmonogramów i okien czasowych | Granice pozyskiwania i dostarczania danych |
Śledzenie schematu | Dodane, usunięte lub zmienione pod kątem typu pola i struktury | Zmiany znaczeniowe bez zmian strukturalnych | Umiarkowany nakład pracy na metadane i określenie własności | Umowy dotyczące źródeł i granice potoków danych |
Zespoły oceniające wzorce automatyzacji mogą również zapoznać się z analizami automatyzacji Truespeak w celu uzyskania szerszego kontekstu dotyczącego przepływu pracy. Program jakości powinien nadal decydować, które błędy blokują przetwarzanie, które kierują rekordy do kwarantanny, a które jedynie powiadamiają konsumentów. Większa automatyzacja nie zawsze jest lepsza, jeśli przenosi niepewność do nieprzejrzystej kolejki.
Podejście wielowarstwowe jest skuteczniejsze niż wybór wyłącznie między regułami a sztuczną inteligencją. Używaj reguł walidacji danych (Data Validation) i ciągłej kontroli jakości dla znanych zobowiązań, a następnie dodaj detekcję anomalii dla nietypowych przypadków brzegowych.
Wykonywanie wewnątrz bazy danych, integracja z przepływem pracy i scenariusze procedur
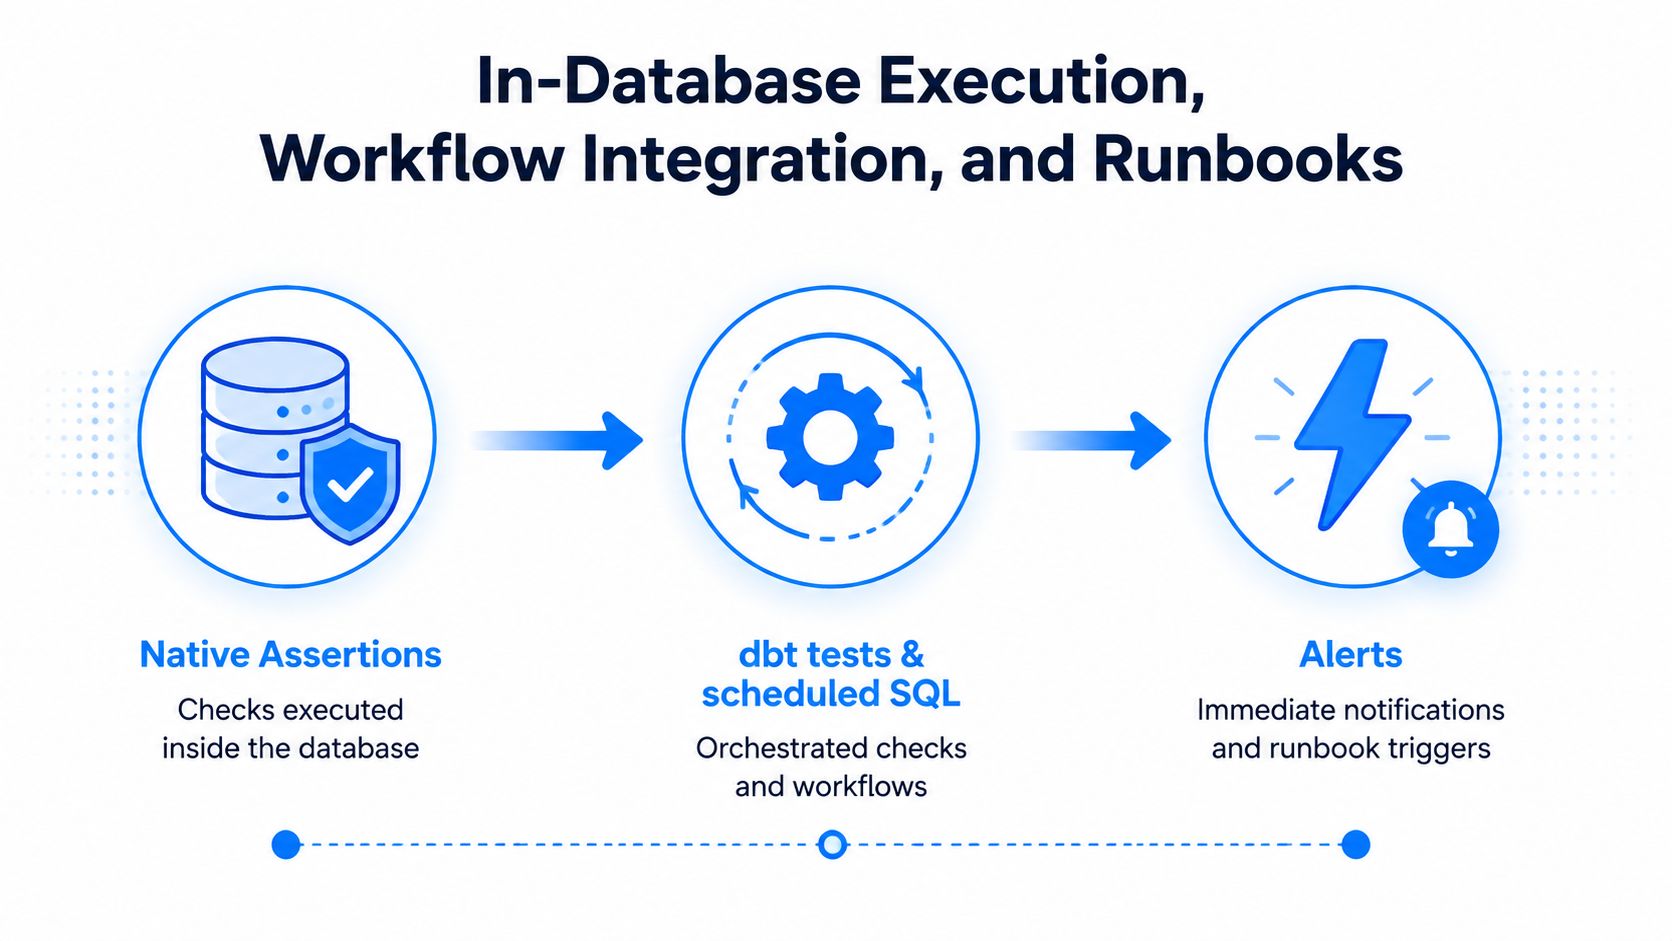
Uruchamiaj kontrole na granicy, w miejscu, gdzie dane są produkowane lub transformowane. Natywne asercje, testy dbt i zaplanowane zapytania SQL utrzymują walidację blisko tabeli i ułatwiają powiązanie błędów z konkretnym zasileniem, partycją lub transformacją. Oddzielna warstwa monitorowania może przynieść wartość dodaną, ale nie powinna wprowadzać dużego opóźnienia między powstaniem defektu a jego wykryciem.
Kierowanie sygnałów do istniejących procesów pracy
Używaj routingu opartego na ważności problemu, zamiast wysyłać każdy wynik na każdy kanał.
Stopień ważności 1: Powiadom dyżurnego inżyniera za pomocą PagerDuty, gdy krytyczny zbiór danych jest niedostępny, w istotny sposób nieprawidłowy lub nie pojawił się w wyznaczonym oknie decyzyjnym.
Stopień ważności 2: Otwórz wątek na Slacku z producentem i opiekunem danych, gdy dotyczy to konsumentów, ale istnieje kontrolowane rozwiązanie alternatywne.
Działania następcze: Utwórz zgłoszenie w systemie Jira dla powtarzających się defektów, utrzymania reguł, dokumentacji lub naprawy potoku danych.
Wskazówki dotyczące automatyzacji przepływu pracy danych są przydatne przy projektowaniu tych przekazań zadań, ale zasada jest prosta: alerty muszą docierać do osoby, która może zmienić proces produkcji danych.
Tworzenie wykonywalnych scenariuszy procedur
Scenariusz procedury (runbook) powinien pozwolić inżynierowi na rozpoczęcie diagnozy bez konieczności szukania pierwotnego autora. Powinien zawierać:
Sygnaturę błędu: Metrykę, regułę lub harmonogram, który został naruszony.
Strefę wpływu (blast radius): Tabele, pulpity nawigacyjne, modele, raporty i procesy biznesowe, na które błąd ma wpływ.
Prawdopodobnego właściciela: Producenta, opiekuna danych, zespół platformy lub zewnętrznego dostawcę.
Trzy pierwsze zapytania: Kontrole wartości źródłowych, wyników transformacji i wpływu na dalsze etapy.
Krok izolacji problemu: Przywrócenie poprzedniej wersji (rollback), kwarantanna, wstrzymanie ładowania danych lub powiadomienie konsumentów.
Szablon komunikacji: Co się stało, na co ma to wpływ, co powinni zrobić użytkownicy i kiedy pojawi się kolejna aktualizacja.
Deduplikuj alerty w zdefiniowanym oknie czasowym, wyciszaj alerty potomne, gdy wyjaśnia je awaria nadrzędnego potoku danych, i łącz raporty o niskiej ważności w zbiorcze podsumowania. Przed uznaniem procesu za gotowy przeprowadź próbny test incydentu. Upewnij się, że alert się uruchamia, właściciel jest osiągalny, zapytania działają, cofanie zmian jest bezpieczne, a zgłoszenie rejestruje wystarczającą liczbę dowodów do późniejszej analizy retrospektywnej.
Organizacja zespołów, własność i kadencja operacyjna
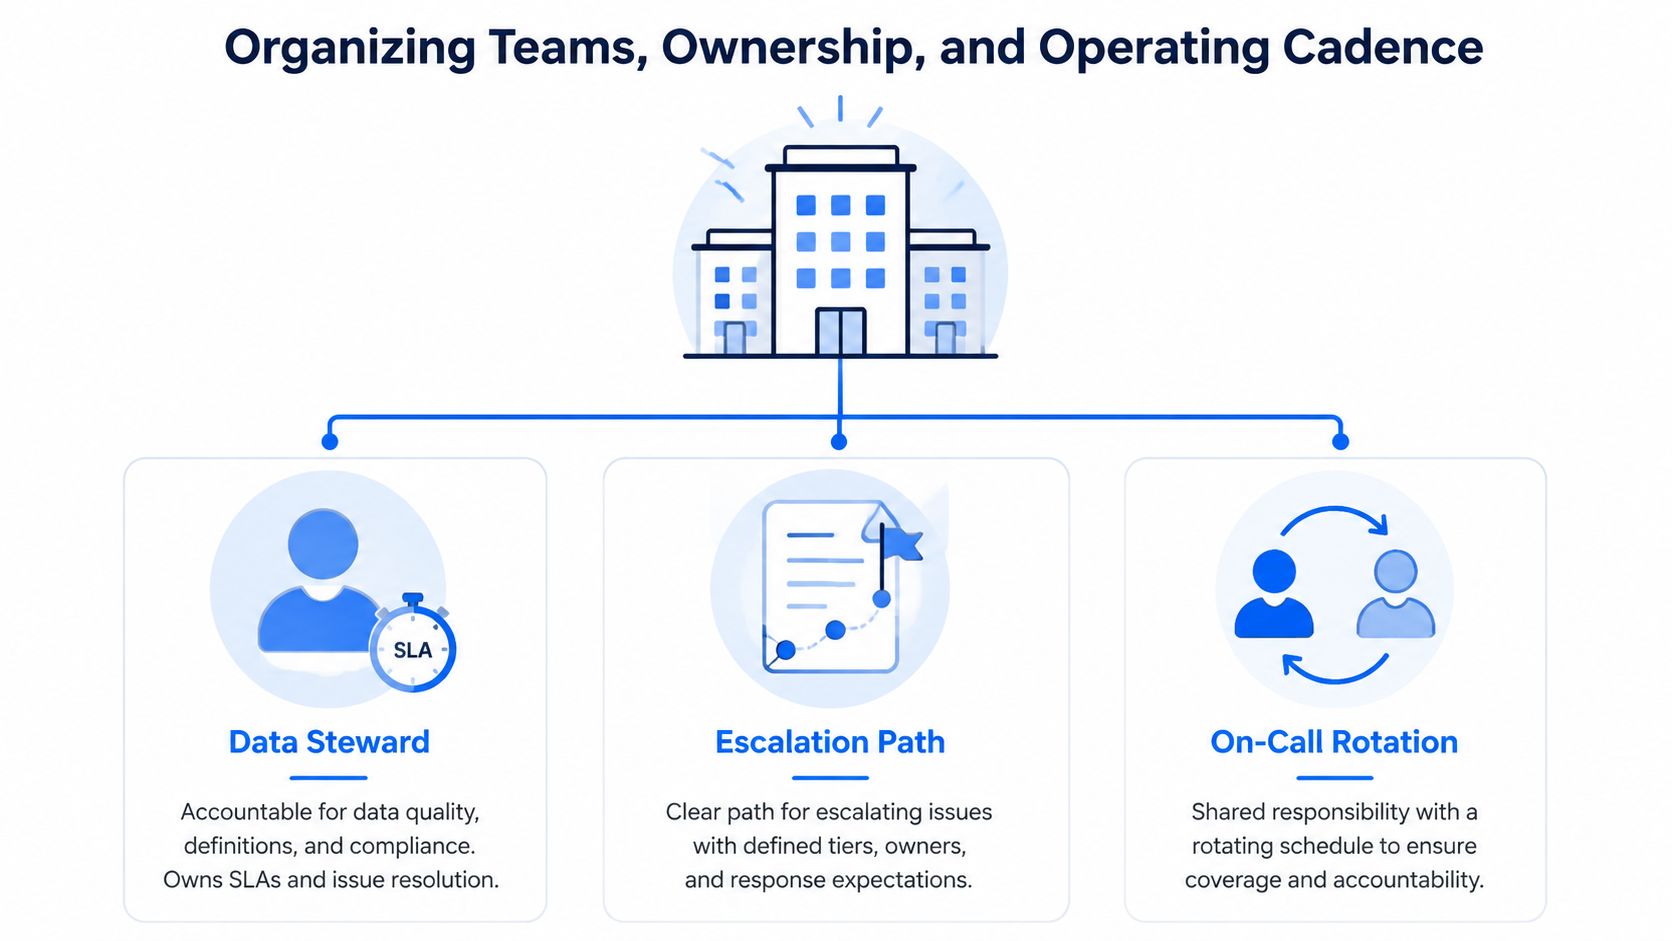
Własność staje się jasna, gdy każdy zbiór danych ma wyznaczonego opiekuna (stewarda), producenta, konsumenta i ścieżkę eskalacji. Centrum doskonałości może dostarczać szablony i prowadzić szkolenia, ale nie powinno odpowiadać za defekt, którego nie jest w stanie samodzielnie naprawić.
Podział ról
Producent danych odpowiada za pozyskiwanie danych, umowy źródłowe, zmiany schematów i zachowanie potoków danych. Opiekun danych (steward) odpowiada za definicje, oczekiwania jakościowe, interpretację biznesową i koordynację rozwiązywania problemów. Konsument danych weryfikuje, czy zbiór danych jest odpowiedni dla raportu, modelu lub decyzji operacyjnej, i zgłasza konkretne defekty.
Incydenty dotykające wielu domen wymagają wyznaczenia lidera incydentu. Jeśli dostawca jest właścicielem źródła, zespół systemów komercyjnych odpowiada za aplikację, a zespół platformy za hurtownię danych, lider koordynuje działania zabezpieczające, podczas gdy każda z grup prowadzi dochodzenie w swoim zakresie.
Zamiana spotkań w artefakty
Właściwy rytm pracy przynosi decyzje, a nie tylko dyskusje:
Cotygodniowa selekcja (triage): Przegląd nowych anomalii, przypisywanie właścicieli oraz zamykanie lub eskalowanie incydentów.
Miesięczny przegląd KPI: Porównanie realizacji umów SLA, powtarzających się defektów, zgłoszeń od konsumentów i zaległych działań naprawczych.
Kwartalne odświeżenie kontraktu: Przegląd definicji, progów, powiązań danych (lineage), zmian regulacyjnych i nowych konsumentów.
Zastosuj uproszczoną macierz RACI dla każdego krytycznego zbioru danych. Producent jest odpowiedzialny za wdrożenie (Responsible), opiekun odpowiada za zgodność i definicje (Accountable), konsumenci są konsultowani w zakresie wpływu (Consulted), a zespół platformy lub ładu (governance) jest informowany o zmianach systemowych (Informed). Dostosuj nazewnictwo, jeśli Twoja organizacja używa innego modelu, ale nie pozostawiaj odpowiedzialności rozproszonej w bezimiennym komitecie.
Model operacyjny wymaga również rotacji dyżurów (on-call) dla najważniejszych potoków danych. Bez tego alerty przychodzą po godzinach pracy, a organizacja mierzy czas wykrywania, godząc się jednocześnie na powolne odzyskiwanie sprawności. Informacja o własności powinna znajdować się w katalogu, repozytorium, treści alertu i scenariuszu procedury, a nie tylko w dokumencie ze spotkania.
Pomiar ROI i pierwsze 90 dni
Kadra kierownicza nie potrzebuje kolejnego wskaźnika jakości bez przełożenia na finanse. Zacznij od pojęcia data downtime (przestoju danych) – okresu, w którym zbiór danych jest niedostępny, nieaktualny lub niewiarygodny do zamierzonego zastosowania. Praktyczny wzór to DDT = N × (TDD + TTR), gdzie liczba incydentów jest mnożona przez sumę średniego czasu wykrywania i średniego czasu naprawy, jak opisano w tych wskazówkach dotyczących pomiaru przestoju danych.
Przekształcanie strat operacyjnych w uzasadnienie biznesowe
Podlicz godziny, które analitycy, inżynierowie, pracownicy działu finansów i zespołów operacyjnych spędzili w poprzednim kwartale na dochodzeniu przyczyn błędnych danych. Pomnóż te godziny przez odpowiedni całkowity koszt roboczogodziny, a następnie dodaj udokumentowane konsekwencje, takie jak skorygowane prognozy, opóźnione decyzje, nieudane działania wobec klientów czy koszty dostosowania do przepisów (Compliance).
Śledź te same kategorie po wdrożeniu zmian. Porównanie powinno wykazać mniej incydentów, krótszy czas wykrywania, krótszy czas rozwiązania, mniejszą liczbę poprawek i mniejsze ryzyko związane z decyzjami podejmowanymi na podstawie niewiarygodnych danych. Nie twórz teorii, że każdy uniknięty incydent to gwarantowany przychód. Oddziel realne oszczędności od unikania ryzyka i jasno przedstaw przyjęte założenia.
Dla wielu przedsiębiorstw stawka jest wysoka. IBM podaje, że ponad jedna czwarta organizacji szacuje roczne straty z powodu złej jakości danych na ponad 5 milionów USD, podczas gdy 7% szacuje te straty na ponad 25 milionów USD. Użyj tych liczb jako kontekstu, a nie jako substytutu dla własnego punktu odniesienia.
Zastosowanie skoncentrowanej sekwencji 90 dni
Faza | Dni | Kluczowe rezultaty | Kryteria sukcesu |
|---|---|---|---|
Punkt odniesienia | 1 do 15 | Sprofilowanie 5 najważniejszych krytycznych tabel, zdefiniowanie umów SLA, przypisanie właścicieli, zarejestrowanie obecnego czasu przestoju | Każdy priorytetowy zbiór danych ma umowę, właściciela i początkowy pomiar |
Wdrożenie narzędzi | 16 to 45 | Wdrożenie kontroli schematu i świeżości w bazie danych, skierowanie alertów do kanałów dyżurnych, opublikowanie scenariuszy procedur | Naruszenia docierają do odpowiedzialnego zespołu wraz z użytecznym kontekstem diagnostycznym |
Strojenie | 46 do 75 | Dodanie detekcji anomalii, przegląd fałszywych alarmów, dostosowanie progów i udokumentowanie wyjątków | Liczba alertów jest możliwa do opanowania, a istotne zmiany są poddawane analizie |
Przegląd | 76 do 90 | Przeprowadzenie przeglądu kwartalnego, raport o zmianach w czasie przestoju i reakcji, wybór kolejnego obszaru do objęcia programem | Kierownictwo widzi wpływ operacyjny i zatwierdza kolejny etap rozbudowy |
Model uzasadnienia biznesowego dla jakości danych może pomóc w ustrukturyzowaniu narracji finansowej wokół kosztów, ryzyka i mierzalnych wyników.
Unikaj czterech pułapek. Pozorne metryki (vanity metrics) premiują liczbę kontroli, a nie ich użyteczność. Zmęczenie alertami ukrywa poważne awarie w natłoku szumu informacyjnego. Wdrażanie narzędzi bez przypisania odpowiedzialności tworzy pulpity nawigacyjne zamiast rzeczywistej naprawy problemów. Pomijanie retrospektywy po pierwszym incydencie gwarantuje, że ten sam rodzaj błędu powróci.
Zacznij od pięciu krytycznych tabel, jednego wyznaczonego właściciela dla każdej z nich oraz pisemnej definicji tego, co oznacza, że dane są „dostępne i wiarygodne”. Następnie zmierz pierwszy incydent od momentu wykrycia do rozwiązania – ten cykl powie Ci o dojrzałości programu znacznie więcej niż najbardziej dopracowany wskaźnik jakości.
digna oferuje walidację w bazie danych (Data Validation), detekcję anomalii, monitorowanie terminowości (Timeliness) i śledzenie schematu w Twoim własnym środowisku, dzięki czemu zespoły mogą powiązać kontrole jakości z potokami i zbiorami danych, z których już korzystają. Odwiedź digna, aby ocenić modułowe podejście do poprawy jakości danych w hurtowniach, jeziorach danych (data lakes) i korporacyjnych potokach danych.
Najczęściej zadawane pytania
Dlaczego programy jakości danych grzęzną, zanim ruszą?
Bo pierwszą reakcją na incydent jest zwykle kupno albo konfiguracja narzędzia. Narzędzie jakości policzy wskaźniki, wykona reguły i pokieruje alertami, ale nie zdecyduje, co znaczy poprawnie, a to wymaga udokumentowanego kontraktu między producentami a odbiorcami.
Czy mierzenie udziału wartości pustych wystarczy?
Nie. Udział wartości pustych bywa użyteczny, ale tabela może być kompletna i mimo to błędna. Pokrycie musi sięgać poza kompletność do definicji, dopuszczalnych wartości i relacji, które rozstrzygają, czy kompletny rekord jest też poprawny.
Co przypisuje działający program?
Kontrole do ryzyk, które się liczą, w trzech obszarach: standardy obejmujące definicje, dopuszczalne wartości, własność i procedury zmian; odpowiedzialność przez wskazanych producentów i stewardów z uprawnieniem do usuwania usterek; oraz sprzężenie zwrotne przez alerty, zgłoszenia, retrospektywy i zmiany w potokach zapobiegające nawrotom.
Dlaczego jakość potrzebuje perspektywy ekonomicznej?
Bo bez niej każdy zbiór danych wygląda na równie zasługujący na uwagę. Powiązanie kontroli z kosztem awarii pozwala zespołowi uzasadnić, gdzie wkładać wysiłek, a co na razie zostawić monitorowane, lecz nienaprawione.
Jak wygląda klasyczna awaria?
Pulpit przychodowy wyglądający na całkowicie zdrowy, choć przez tygodnie zawyża zamówienia jednego regionu. Incydent nie jest przede wszystkim problemem pulpitu i dlatego wymiana pulpitu albo dołożenie kolejnej kontroli rzadko zapobiega następnemu.