Kontrola jakości danych w badaniach naukowych: praktyczny przewodnik
|
6
min. czyt.
Problemów z jakością danych zwykle nie wykrywa się wtedy, gdy zbiór jest jeszcze świeżo po zebraniu. Wychodzą na jaw dopiero wtedy, gdy arkusz został skopiowany, plik scalony, nazwa pola zmieniona, a ktoś pyta, dlaczego w jednym wierszu widnieje niemożliwa data albo brakująca wizyta kontrolna, której nikt w porę nie zgłosił. Tak właśnie wygląda kontrola jakości danych w badaniach naukowych: to nie schludna lista kontrolna na końcu, lecz łańcuch kontroli, który musi przetrwać każde przekazanie danych.
Spis treści
Dlaczego kontrola jakości danych w badaniach zawodzi po cichu
Zespół badawczy może tygodniami zbierać rekordy, które wyglądają na czyste, a mimo to odziedziczyć bałagan. Błędy często pozostają ukryte, ponieważ transkrypcja, transfer, aktualizacje i zapisy stwarzają kolejne okazje do cichego dryfu, a wiele zespołów sprawdza jakość wyłącznie na etapie zbierania danych. Zanim ktoś zauważy wartość odstającą lub brakującą zmienną, formularz źródłowy może być już głęboko zakopany, schemat mógł się zmienić, a porządkowanie danych zamienia się w ich rekonstrukcję.
Dlatego najlepsze systemy traktują jakość jako obowiązek obejmujący cały cykl życia danych, a nie jednorazowy audyt. Dobrym punktem wyjścia jest przyjrzenie się strukturalnym przyczynom, przez które projekty się sypią, i naprawienie otaczającego je procesu, a nie tylko objawów, co opisuje ta praktyczna notatka o tym, dlaczego projekty jakości danych kończą się porażką.
Praktyczna zasada: jeśli rekord może przejść z rąk do rąk, może też stracić integralność.
Dalsza część przewodnika opiera się na pięciu elementach, które sprawdzają się pod presją: walidacji na każdym etapie przetwarzania, mierzalnych progach, pochodzeniu danych i dokumentacji, odtwarzalności oraz ścieżkach audytu. To połączenie ma znaczenie, ponieważ największe błędy nie są spektakularne, tylko zwyczajne, a właśnie zwyczajne błędy umykają zespołom, które sprawdzają dane dopiero na mecie.
Pięć wymiarów jakości danych
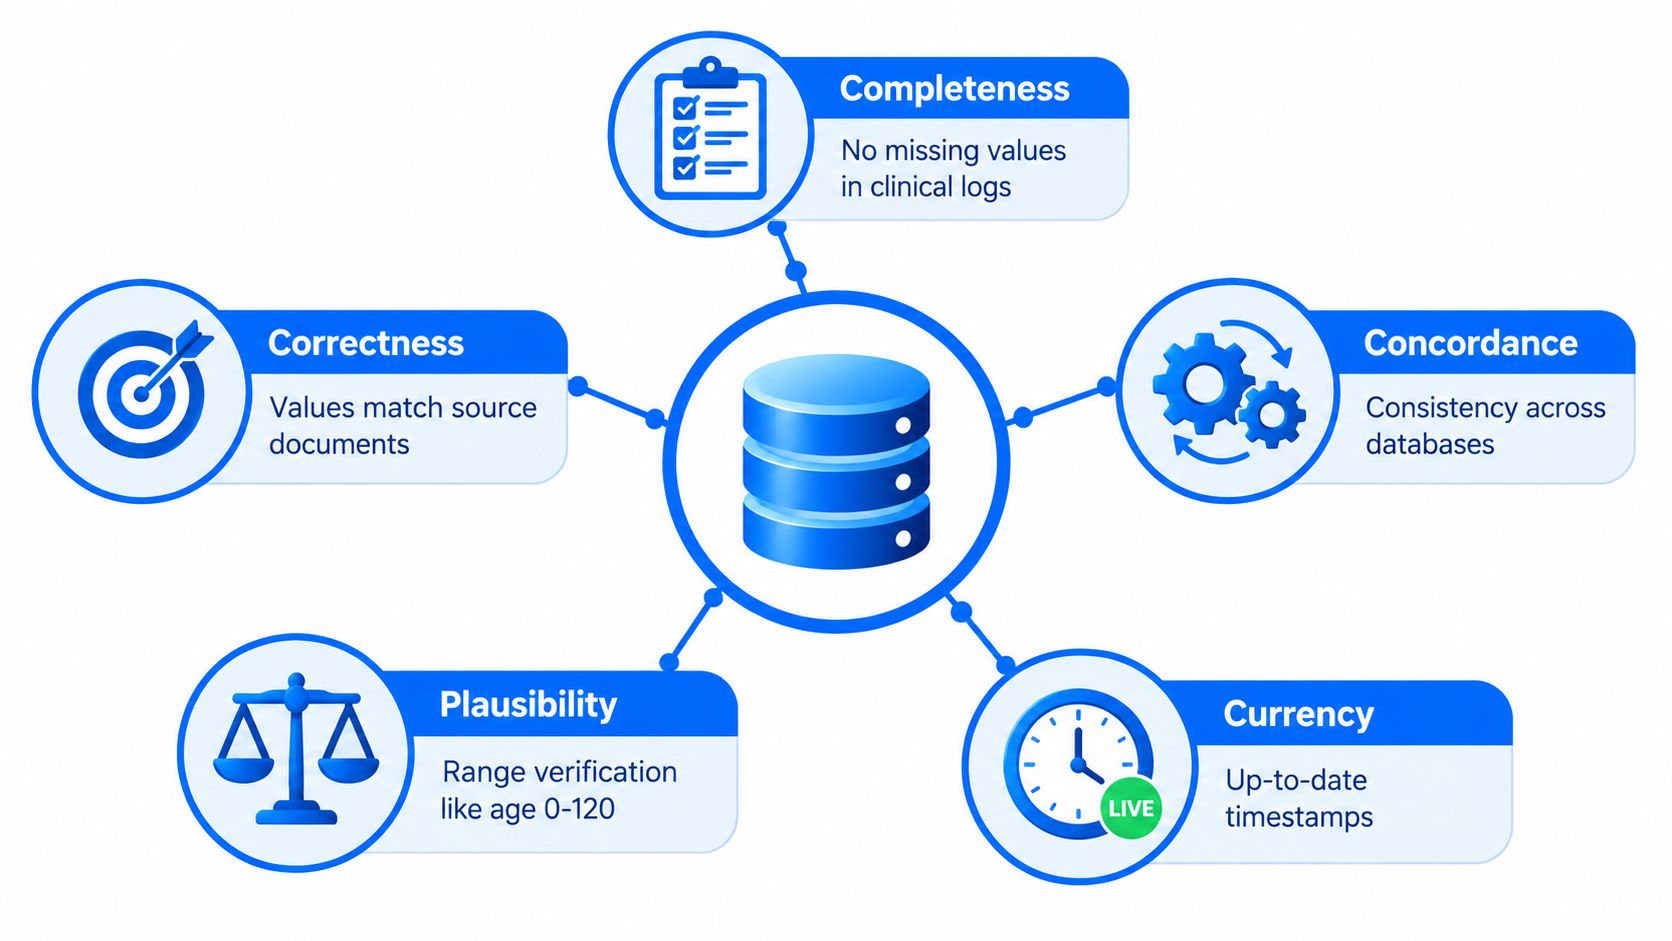
Dobra kontrola jakości zaczyna się od wspólnego języka. Jeśli zespół mówi, że „dane wyglądają dobrze”, nie precyzując, co sprawdził, jego członkowie zwykle mówią o różnych rzeczach. Pięć wymiarów – kompletność, poprawność, zgodność, wiarygodność i aktualność – pozwala odróżnić braki od sprzeczności, a dane nieaktualne od wartości niemożliwych.
Co wychwytuje każdy wymiar
Kompletność dotyczy luk. Brakująca wizyta kontrolna, puste pole z wynikiem laboratoryjnym czy pominięta data zgody – wszystko to należy do tej kategorii i nie jest tym samym problemem co błędne wartości. Prosty cotygodniowy raport kompletności kluczowych pól wystarczy, aby pokazać, gdzie skupiają się luki.
Poprawność odpowiada na pytanie, czy wartość zgadza się ze źródłem. Jeśli data urodzenia została błędnie wpisana albo wynik badania skopiowano z niewłaściwego wiersza, liczba może mieć idealny format, a mimo to być fałszywa. Praktycznym sposobem sprawdzenia jest ukierunkowane porównanie z dokumentacją źródłową na niewielkiej próbie najważniejszych rekordów.
Zgodność oznacza spójność między systemami. Dwie bazy danych, które różnią się statusem włączenia tego samego uczestnika, generują później pracę przy uzgadnianiu, dlatego identyfikatory, daty wizyt i flagi statusu warto porównywać między systemami wcześnie. W tym miejscu wiele zespołów nadmiernie ufa tabeli „głównej” i przeoczy fakt, że tabela główna to po prostu ostatnie miejsce, w którym wylądował błąd.
Wiarygodność wychwytuje wartości technicznie poprawne, ale nieprawdopodobne. Wiek 0 w kohorcie dorosłych, data wypisu wcześniejsza niż data przyjęcia czy nieprawdopodobna sekwencja znaczników czasu powinny uruchamiać weryfikację, nawet jeśli pole przechodzi kontrole formatu. Zwykle to właśnie tutaj zespoły potrzebują alertów opartych na regułach, a nie wyłącznie ręcznej inspekcji.
Aktualność to terminowość danych. Rekord może być poprawny, a mimo to zbyt stary, by z niego korzystać, szczególnie w badaniach podłużnych, w których liczą się zmiany statusu. Nieaktualny znacznik czasu lub opóźniona aktualizacja zasługują na osobną kontrolę, bo dane nieaktualne często udają dane kompletne.
Tekst o wymiarach jakości danych przyda się, jeśli zespół potrzebuje wspólnego słownictwa przed napisaniem reguł. Zespoły często przeceniają poprawność, a za mało sprawdzają wiarygodność i aktualność – a to właśnie tam kryją się ciche błędy.
Test przydatności: jeśli kontrola nie potrafi powiedzieć, jaki rodzaj problemu znalazła, nie jest jeszcze wystarczająco precyzyjna.
Walidacja na każdym etapie przetwarzania danych
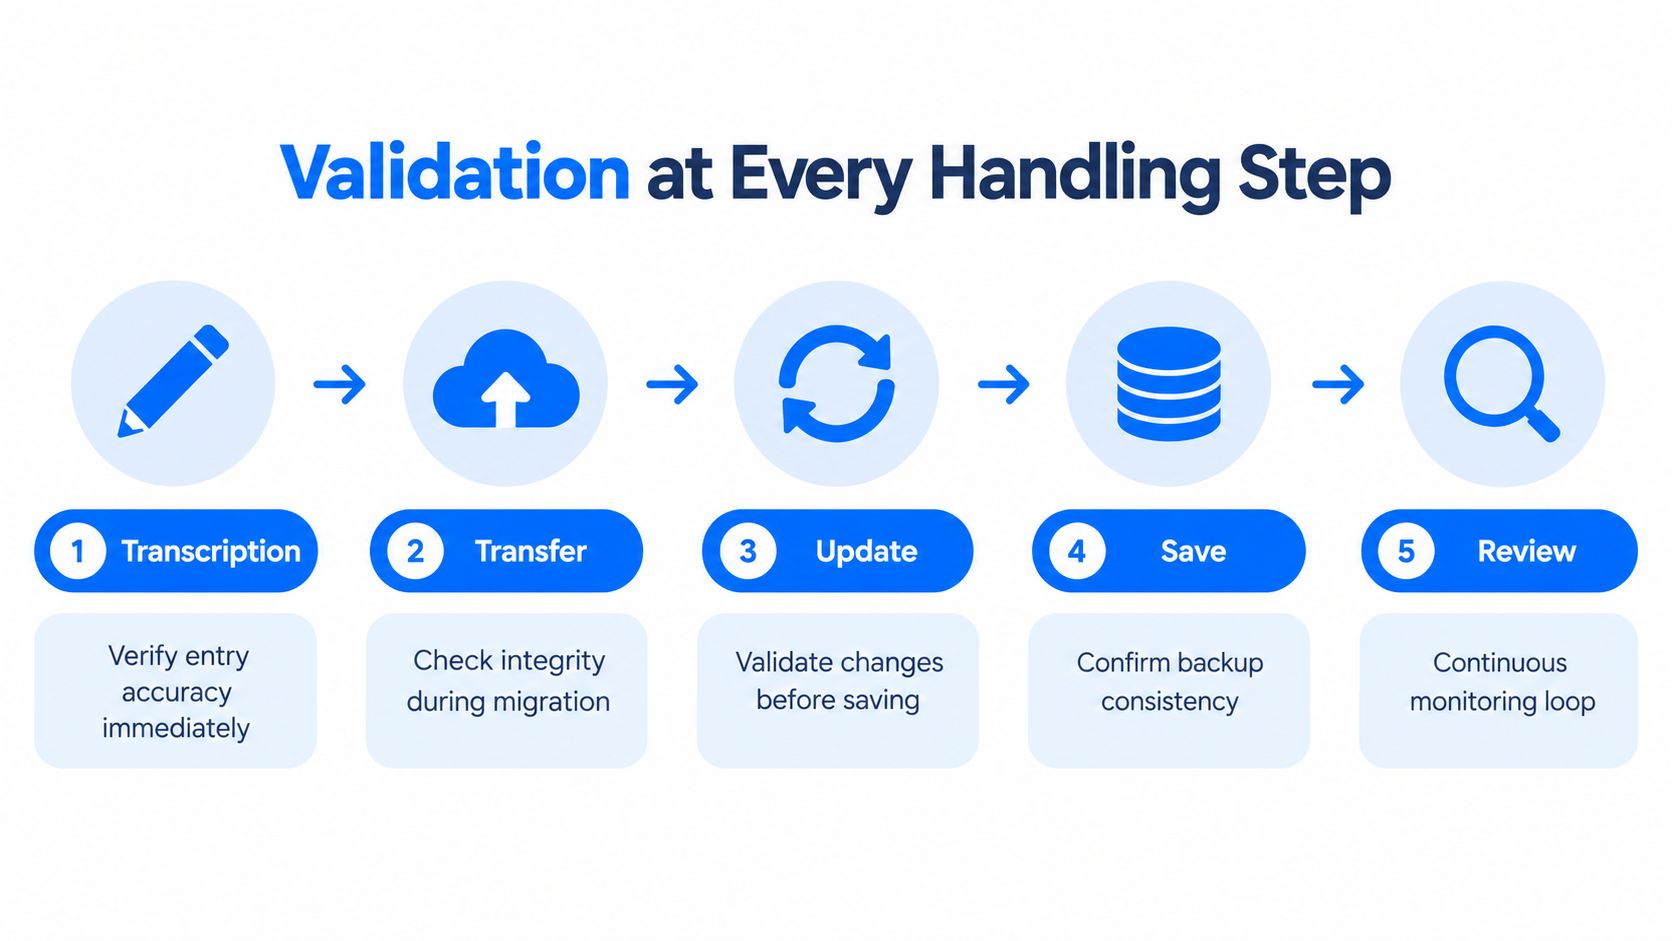
Kontrola jakości powinna mieć miejsce wszędzie tam, gdzie ktoś dotyka danych, a nie tylko podczas końcowego przeglądu. Wytyczne dla badań klinicznych jasno mówią, że walidacja powinna odbywać się przy transkrypcji, transferze, aktualizacji lub zapisie danych na nowym nośniku, a klasyczne procedury obejmują podwójne wprowadzanie danych, programowe kontrole zakresów i spójności, regularny przegląd wskaźnika błędów oraz weryfikację przez przełożonego lub współpracownika. Chodzi o audytowalność, ponieważ każdy etap przetwarzania to miejsce, w którym błąd może się pojawić lub zostać ukryty.
Droga papierowego formularza do analizy
Zacznij od papierowych formularzy. Podczas transkrypcji jedna osoba wprowadza rekord, a druga ponownie sprawdza próbkę lub wykonuje podwójne wprowadzanie pól, w których łatwo o literówkę, takich jak daty czy pomiary liczbowe. Prosty rejestr rozbieżności bardzo szybko się tu zwraca.
Gdy dane trafiają do arkusza kalkulacyjnego, od razu uruchom kontrole zakresów i reguły spójności. Data urodzenia w przyszłości, brakujący kod wizyty czy wynik laboratoryjny spoza dopuszczalnej dziedziny powinny zatrzymać plik, zanim ktokolwiek zacznie analizę.
Gdy arkusz staje się bazą danych do analizy, sprawdź sam transfer. Oznacza to porównanie liczby wierszy, kluczowych identyfikatorów i wszystkich pól podatnych na obcięcie, przekodowanie lub konwersję typów. Jeśli problem po raz pierwszy ujawnia się dopiero w bazie danych, straciłeś już szansę, by ustalić, czy wynikł on przy wprowadzaniu, czy przy migracji.
Po aktualizacjach kieruj zmiany do weryfikacji przez współpracownika lub przełożonego. Taki przegląd nie musi być ceremonialny – musi odpowiedzieć na jedno pytanie: czy aktualizacja zachowała znaczenie rekordu?
Strona o regułach walidacji i ciągłych kontrolach to dobry przykład tego, jak zespoły wdrażają takie zabezpieczenia w systemach działających codziennie. Kluczowe jest powiązanie kontroli z konkretnym etapem, bo okresowy przegląd przeprowadzany po trzech przekazaniach danych jest już spóźniony.
Kontrola po transferze jest lepsza niż nic, ale to nie to samo, co kontrolowanie samego transferu.
Mierzalne progi w monitorowaniu jakości
Kontrola jakości staje się operacyjna, gdy zespół uzgodni liczby, a nie hasła. Uzasadnione progi, wskazani właściciele i stały harmonogram przeglądów zamieniają wskaźniki jakości w mechanizmy kontrolne. Dashboard bez osoby odpowiedzialnej za jego przegląd to tylko tapeta.
Próbkowanie wciąż ma znaczenie. Wytyczne dotyczące zapewnienia jakości wspierają twarde limity, na podstawie których zespoły mogą działać. Na poziomie ośrodka nie więcej niż 5% włączonych uczestników powinno nie spełniać kryteriów włączenia lub wyłączenia, rekrutacja powinna terminowo osiągać co najmniej 90% celu, odsetek rezygnacji powinien wynosić najwyżej 5%, a wskaźnik błędów wprowadzania danych najwyżej 0,001%.
Wskaźnik | Próg | Sposób monitorowania |
|---|---|---|
Losowa weryfikacja ze źródłem | 5% rekordów | Uzgadnianie wybranych rekordów z dokumentacją źródłową |
Niespełnienie kryteriów włączenia lub wyłączenia | Nie więcej niż 5% w ośrodku | Przegląd rejestrów skriningu i odstępstw od protokołu |
Postęp rekrutacji | Co najmniej 90% celu w terminie | Śledzenie rekrutacji względem zaplanowanych kamieni milowych |
Odsetek rezygnacji | Nie więcej niż 5% | Monitorowanie rejestrów retencji i wycofań |
Wskaźnik błędów wprowadzania danych | Nie więcej niż 0,001% | Porównywanie wprowadzonych wartości z polami źródłowymi i rejestrowanie rozbieżności |
Nie chodzi o to, by zebrać te wskaźniki i później je podziwiać. Chodzi o to, by przeglądać je według stałego harmonogramu, przypisać jednego właściciela do każdego progu i spisać ścieżkę reakcji, zanim dojdzie do pierwszego przekroczenia. Tu właśnie pomaga widok monitorowania aktualności danych, bo opóźniona kontrola często oznacza to samo, co brak kontroli.
Dopasuj reakcję do rodzaju awarii. Niewielka seria błędów wprowadzania wymaga ukierunkowanych ponownych kontroli, natomiast powtarzające się niedotrzymanie celów rekrutacji lub retencji zwykle oznacza, że trzeba zmienić sam proces. Jeśli przekroczenie progu nie uruchamia jasnego działania, próg jest tylko dekoracją.
Dokumentacja pochodzenia danych i ścieżki audytu
Pytanie audytora nigdy nie jest abstrakcyjne. Zwykle brzmi: „Skąd wzięła się ta liczba?”. Jeśli odpowiedź wymaga odwoływania się do pamięci, rozmów na boku i przekopywania starych eksportów, proces nie jest jeszcze audytowalny. Dokumentacja pochodzenia danych (provenance) to zapis ich źródła, obsługi i transformacji, który pozwala odpowiedzieć na to pytanie bez gorączkowych poszukiwań.
Rzetelny zapis pochodzenia danych mówi, kto miał z nimi do czynienia, co się zmieniło, kiedy i dlaczego. Zachowuje też pierwotną wartość w przypadku korekty, ponieważ oryginał jest często jedynym sposobem, by ocenić, czy poprawka była uzasadniona, czy po prostu wygodna. Ma to szczególne znaczenie, gdy to samo pole edytowało wiele osób w wielu narzędziach.
Co musi zawierać ścieżka audytu
Najczystsza struktura jest prosta. Przechowuj pliki danych pod kontrolą wersji, prowadź rejestr zmian powiązany z każdym etapem przetwarzania, formułuj pisemne zapytania dotyczące podejrzanych lub brakujących wartości i jednoznacznie opisz w planie analizy braki, których nie da się uzupełnić. Pisemne zapytania są ważne, bo zamieniają niepewność w identyfikowalną decyzję zamiast ukrytego wyjątku.
Wytyczne badawcze dotyczące iteracyjnej kontroli jakości danych stawiają sprawę jasno. Zespoły powinny przeprowadzać proste przeglądy statystyczne w trakcie zbierania danych, wysyłać pisemne zapytania dotyczące podejrzanych lub brakujących wartości i wprost raportować w planie analizy braki niemożliwe do uzupełnienia (wytyczne dotyczące iteracyjnego procesu). To nie biurokratyczny narzut, tylko sposób na to, by analiza uczciwie pokazywała, czego nie da się naprawić.
Jeśli nie potrafisz pokazać drogi od źródła do analizy, nie masz ścieżki audytu, tylko opowieść.
Recenzent pytający, „skąd wzięła się ta liczba”, powinien móc zobaczyć rekord źródłowy, zastosowaną transformację, datę zmiany i osobę, która ją zatwierdziła. Jeśli odpowiedź wymaga projektu rekonstrukcji, ścieżka jest zbyt uboga na poważną pracę. To właśnie pochodzenie danych pozwala zespołowi wyjaśnić liczbę, zamiast bronić swoich wspomnień o niej.
Miejsce AI w kontroli jakości danych
AI przydaje się w kontroli jakości danych, ale tylko w wąskim zakresie. Potrafi wykrywać anomalie, grupować podejrzane rekordy i dostrzegać wzorce trudne do zapisania w postaci reguł, co ma znaczenie przy dużych zbiorach danych ze stabilną linią bazową. Skraca też czas ręcznej selekcji, gdy działa obok deterministycznej walidacji, a nie zamiast niej. Zespołom budującym taką warstwę warto przestudiować model opisany w tekście o tym, jak AI wykrywa anomalie danych w pipeline’ach danych.
Ryzyko polega na tym, że automatyczne czyszczenie może wymyślać wiarygodnie wyglądające, ale błędne korekty. Najnowsze publikacje naukowe wskazują na realny brak standardowych benchmarków dla systemów jakości danych opartych na LLM i ostrzegają, że automatyczne oczyszczanie może wprowadzać halucynowane poprawki. Traktuj AI jako asystenta osoby weryfikującej, a nie jako autorytet, który samodzielnie przepisuje rekordy.
Zastosowania bezpieczne i niebezpieczne
Bezpieczne zastosowania to oznaczanie anomalii do przeglądu, ustalanie priorytetów rekordów do ręcznej inspekcji i sugerowanie potencjalnych problemów, które człowiek może potwierdzić. Niebezpieczne zastosowania to nadpisywanie wartości źródłowych bez ujawnienia tego faktu, rozstrzyganie niejednoznacznych rekordów bez akceptacji człowieka oraz pełnienie roli jedynego strażnika przed udostępnieniem danych.
To zabezpieczenie jest nudne, ale skuteczne. Zachowuj pierwotne wartości obok wszelkich automatycznych korekt, weryfikuj próbki rekordów oznaczonych przez AI i dokumentuj ścieżkę decyzji dla każdej zaakceptowanej zmiany. Przechowuj pierwotną wartość w osobnej kolumnie wraz ze znacznikiem czasu transformacji i nazwiskiem osoby zatwierdzającej, aby każda korekta pozostawała odwracalna i audytowalna. Jeśli zespół potrzebuje szerszego spojrzenia na governance, materiał o governance i narzędziach AI do danych od MakeAutomation będzie przydatnym uzupełnieniem, ponieważ osadza AI w kontrolach operacyjnych, a nie w szumie marketingowym.
Dla zespołów, które chcą stosować AI, nie oddając kontroli, platforma taka jak digna może działać w warstwie walidacji i wykrywania anomalii, gdzie kontrole pozostają przejrzyste i powiązane z danymi źródłowymi. To właściwy wzorzec: AI pomaga zauważyć, ludzie decydują.
Lista kontrolna jakości danych
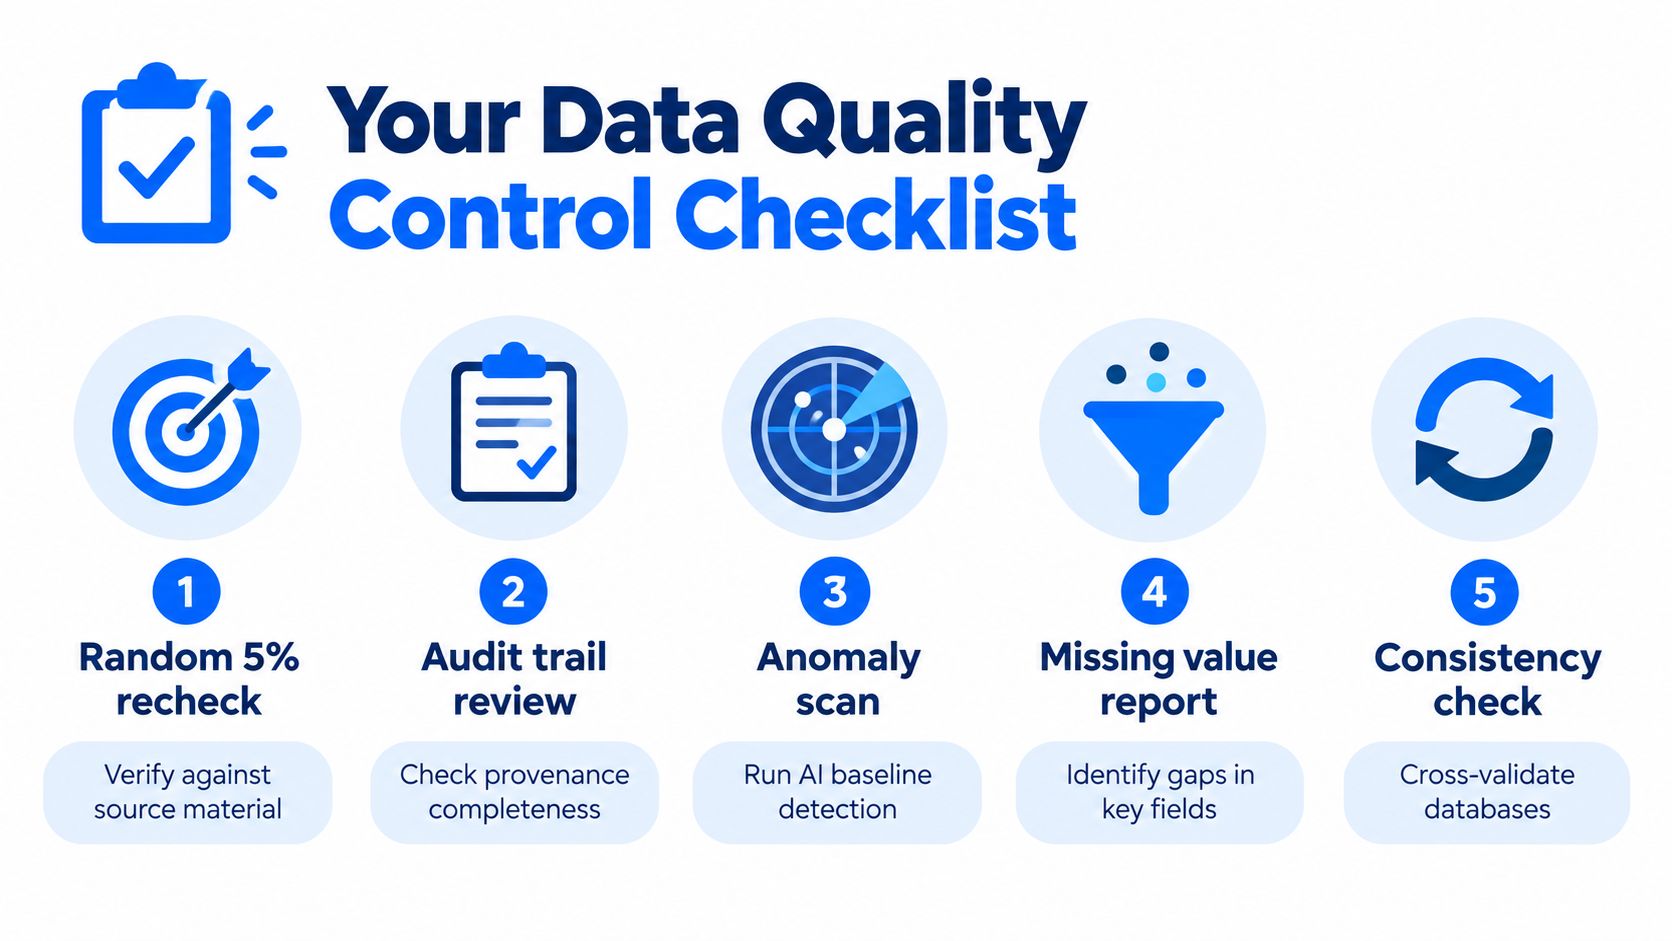
Lista kontrolna działa tylko wtedy, gdy jest na tyle krótka, by korzystać z niej w trakcie bieżącej pracy, i na tyle rygorystyczna, by wychwycić dryf przed rozpoczęciem analizy. Trzymaj ją pod ręką przy pracy, a nie w prezentacji.
Losowa weryfikacja ze źródłem: Sprawdzaj losową 5-procentową próbkę z materiałem źródłowym według stałego cotygodniowego harmonogramu, aby wychwycić dryf transkrypcji, zanim plik zostanie zamknięty.
Walidacja przy każdym przekazaniu: Przypisz konkretną kontrolę do transkrypcji, transferu, aktualizacji, zapisu i przeglądu. Ogólna obietnica, że „sprawdzimy później”, nie przetrwa w zapracowanym pipeline’ie.
Wskazany właściciel progów: Wyznacz jedną osobę do regularnego przeglądu progów rekrutacji, rezygnacji i błędów wprowadzania. Wskaźniki zmieniają zachowanie tylko wtedy, gdy ktoś jednoznacznie za nie odpowiada.
Udokumentowane pochodzenie danych: Przechowuj pliki pod kontrolą wersji, rejestr zmian i pisemne zapytania dotyczące podejrzanych lub brakujących wartości, powiązane z konkretną transformacją. Dzięki temu późniejsze audyty są możliwe bez odtwarzania całego łańcucha z pamięci.
Weryfikacja korekt AI: Wymagaj ręcznego przeglądu rekordów oznaczonych przez AI, zachowuj pierwotną wartość i zapisuj, dlaczego korekta została przyjęta lub odrzucona.
Spójność między bazami danych: Porównuj kluczowe pola między systemami, aby problemy ze zgodnością wychodziły na jaw przed publikacją, a nie po niej.
Jeśli potrzebujesz praktycznego modelu operacyjnego, połącz tę listę kontrolną z działającą na bieżąco warstwą kontroli zamiast kolejnego arkusza kalkulacyjnego. Rozwiązanie oparte na governance i narzędziach AI do danych pozwala utrzymać walidację na poziomie rekordów, wykrywanie anomalii, monitorowanie aktualności i śledzenie schematów w środowisku, w którym dane już się znajdują. digna wpisuje się w taką pętlę kontroli, gdy zespoły badawcze potrzebują kontroli, które pozostają przejrzyste i powiązane z rekordami źródłowymi.
Zespołom, które chcą, aby opisane wyżej kontrole zakresów, spójności i kompletności uruchamiały się automatycznie przy każdym przekazaniu danych, a nie podczas okresowego przeglądu, digna Data Validation zapewnia wykonywanie reguł na poziomie rekordów bezpośrednio w bazie danych, w której dane badawcze już się znajdują.
Najczęściej zadawane pytania
Jakie jest pięć wymiarów jakości danych w badaniach naukowych?
Kompletność, poprawność, zgodność, wiarygodność i aktualność. Razem pozwalają odróżnić brakujące wartości od błędnych, rozbieżności między systemami od wpisów niemożliwych, a rekordy nieaktualne od bieżących, dzięki czemu zespół badawczy zyskuje wspólny język do opisu tego, co faktycznie wykryła kontrola, zamiast mówić, że dane wyglądają dobrze.
Kiedy w projekcie badawczym powinna odbywać się walidacja danych?
Na każdym etapie przetwarzania danych: przy ich transkrypcji, transferze, aktualizacji lub zapisie na nowym nośniku. Typowe mechanizmy kontrolne to podwójne wprowadzanie danych, programowe kontrole zakresów i spójności, regularny przegląd wskaźnika błędów oraz weryfikacja aktualizacji przez współpracownika lub przełożonego, a nie tylko końcowy przegląd przed analizą.
Jakie progi jakości stosuje się w badaniach klinicznych?
Wytyczne NINDS zalecają, aby w ośrodku nie więcej niż 5% uczestników nie spełniało kryteriów włączenia lub wyłączenia, rekrutacja terminowo osiągała co najmniej 90% celu, odsetek rezygnacji wynosił najwyżej 5%, a wskaźnik błędów wprowadzania danych najwyżej 0,001%, przy czym losowe 5% rekordów należy ponownie zweryfikować z dokumentacją źródłową.
Co powinna zawierać ścieżka audytu danych badawczych?
Pliki danych pod kontrolą wersji, rejestr zmian powiązany z każdym etapem przetwarzania, pisemne zapytania dotyczące podejrzanych lub brakujących wartości oraz jednoznaczny opis w planie analizy braków, których nie da się uzupełnić. Powinna pokazywać, kto zmienił wartość, kiedy i dlaczego, oraz zachowywać pierwotną wartość obok każdej korekty.
Czy można zaufać AI w czyszczeniu danych badawczych?
Tylko jako asystentowi. AI przydaje się do oznaczania anomalii i ustalania priorytetów rekordów do ręcznego przeglądu, ale automatyczne oczyszczanie może wymyślać wiarygodnie wyglądające, błędne korekty. Zachowuj pierwotne wartości obok każdej korekty, weryfikuj próbki rekordów oznaczonych przez AI i wymagaj akceptacji człowieka przed przyjęciem zmiany.



