Kompletność danych: Co mówi DAMA i jak ją mierzyć
|
6
min. czyt.

Najbardziej popularna rada dotycząca kompletności danych jest również najbardziej wprowadzająca w błąd: policz wartości NULL i uznaj zadanie za wykonane. Czym jest kompletność danych? To stopień, w jakim obecne są wszystkie dane wymagane do określonego celu. Ta definicja zmienia pytanie z „Czy są puste komórki?” na „Czy ten zestaw danych zawiera to, czego potrzebuje proces biznesowy, raport, model lub kontrola?”
Wypełnione pole wciąż może zawierać błędną wartość, podczas gdy NULL w polu opcjonalnym może nie mieć żadnego praktycznego wpływu. Kompletność jest zatem pytaniem o przydatność do użycia, a nie żądaniem abstrakcyjnej doskonałości. Wytyczne Organizacji Narodów Zjednoczonych dotyczące pokrycia i kompletności wprowadzają to samo koncepcyjne rozróżnienie w statystyce oficjalnej, gdzie kompletność porównuje zarejestrowane zdarzenia z globalną sumą, którą mają reprezentować.
Spis treści
Co naprawdę oznacza kompletność danych
Kompletność danych to stopień, w jakim obecne są wszystkie dane wymagane do określonego celu. W przedsiębiorczym zbiorze danych może to oznaczać wypełnione obowiązkowe atrybuty, kompletne rekordy biznesowe, oczekiwaną liczbę rekordów, wymagane okresy sprawozdawcze lub wszystkie źródłowe zbiory danych potrzebne w procesie końcowym.
Właśnie dlatego kompletność to nie tylko brak wartości NULL. Przypuśćmy, że tabela klientów zawiera brakujący identyfikator klienta. Jest to błąd kompletności, gdy identyfikator jest wymagany do łączenia tabel, uzgadniania danych lub raportowania. Brakująca drugorzędna preferencja marketingowa może być akceptowalna, jeśli zamierzone użycie od niej nie zależy.
To rozróżnienie oddziela również kompletność od innych wymiarów jakości danych. Jeśli adres jest obecny, ale błędny, problem dotyczy dokładności. Jeśli numer telefonu jest obecny, ale narusza wymagany format, problem dotyczy poprawności. Kompletność pyta jedynie o to, czy wymagane informacje istnieją w zdefiniowanym zakresie.
Zacznij od celu biznesowego
Przed wyborem metryki określ, co dane muszą wspierać:
Raportowanie regulacyjne może wymagać każdego podmiotu podlegającego raportowaniu i obowiązkowego atrybutu.
Przetwarzanie operacyjne może zależeć od identyfikatorów, dat i pól statusu.
Analityka może tolerować brakujące atrybuty wzbogacające, o ile podstawowa populacja pozostaje dostępna.
Rozwój sztucznej inteligencji (AI) wymaga wystarczającej liczby pól, rekordów i okresów do zamierzonej analizy, ponieważ braki mogą zmniejszyć wielkość próby do analizy i prowadzić do stronniczych lub nieprecyzyjnych szacunków, jak opisano w tym przeglądzie brakujących danych hostowanym przez NIH.
Zasada praktyczna: Zdefiniuj, co oznacza „wystarczająco kompletny” przed rozpoczęciem pomiarów. W przeciwnym razie pulpit nawigacyjny raportuje liczbę, nie informując nikogo, czy ta liczba wspiera decyzję.
Użyteczna definicja robocza to: wymagane rekordy, pola, relacje i okresy dostarczania są obecne w oczekiwanym zakresie i tempie dla zdefiniowanego przypadku użycia. Taka definicja daje właścicielom danych coś, co mogą przekształcić w mechanizmy kontrolne.
Pięć typów kompletności, które warto mierzyć
Organizacje potrzebują więcej niż jednego spojrzenia na kompletność, ponieważ brakujące wartości i brakujące populacje to różne awarie. Pięć poniższych typów obejmuje typowe potrzeby monitorowania w przedsiębiorstwie, chociaż zespoły powinny wybrać kombinację pasującą do wymagań biznesowych.
Kompletność atrybutów
Kompletność atrybutów odpowiada na pytanie, czy wymagane pola są wypełnione. Typowe przykłady obejmują:
Brakujące identyfikatory klientów
Brakujące daty transakcji
Brakujące numery kont
Wartości
NULLw atrybutach biznesowych wymaganych przez raport lub proces
Rekord klienta może istnieć, ale jeśli brakuje jego identyfikatora, rekord może być bezużyteczny do deduplikacji lub łączenia tabel. Odpowiednią miarą jest udział oczekiwanych rekordów zawierających wartość w określonym atrybucie.
Kompletność rekordów
Kompletność rekordów sprawdza, czy każdy dostępny rekord zawiera jednocześnie wszystkie obowiązkowe pola. Transakcja może mieć identyfikator i kwotę, ale brakować w niej identyfikatora klienta, waluty lub daty transakcji. Liczenie wiersza jako obecnego ukryłoby fakt, że rekord nie jest operacyjnie kompletny.
Kompletność liczby rekordów
Kompletność liczby rekordów porównuje dostarczoną populację z populacją oczekiwaną. Na przykład codzienna tabela transakcji, która zwykle zawiera 10 milionów rekordów, a nagle zawiera 7 milionów rekordów, ma problem z kompletnością populacji, nawet jeśli każdy dostarczony wiersz ma idealnie wypełnione pola.
Artykuł badawczy DAMA na temat jakości danych wspiera to szersze spojrzenie, omawiając kompletność w odniesieniu do rekordów, plików, atrybutów i metadanych.
Kompletność czasowa
Kompletność czasowa sprawdza, czy obecne są wszystkie oczekiwane daty lub okresy sprawozdawcze. Potok finansowy może załadować się pomyślnie, pomijając dzień sprawozdawczy, miesiąc lub partycję. Tabela może zawierać prawidłowe wiersze, ale szereg czasowy jest niekompletny.
Kompletność zbioru danych
Kompletność zbioru danych odpowiada na pytanie, czy dostępny jest każdy zbiór danych wymagany przez proces końcowy. Miesięczny przepływ pracy sprawozdawczej może wymagać zbiorów danych dotyczących klientów, transakcji, produktów i kursów walut. Jeśli jedno źródło nie dotrze, dane wejściowe przepływu pracy są niekompletne, nawet jeśli pozostałe tabele są wypełnione.
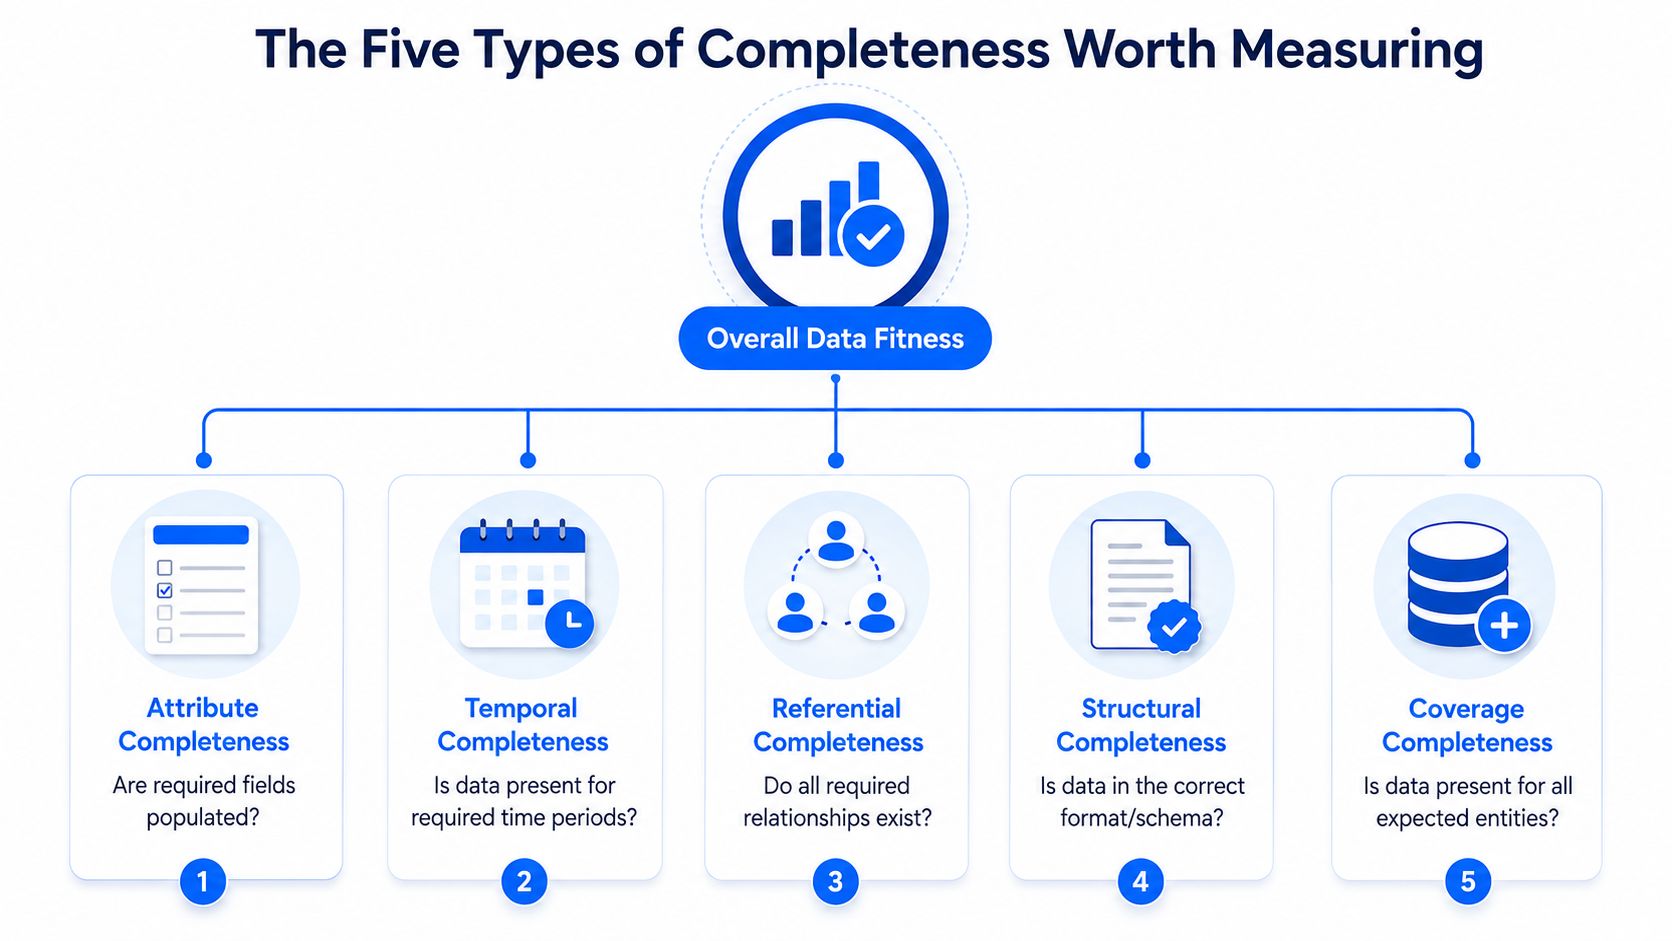
Te kontrole nie są zamienne. Zespół może potrzebować kompletności atrybutów i rekordów dla bazy klientów, kompletności liczby rekordów i czasowej dla transakcji oraz kompletności zbioru danych dla zależności orkiestracji.
Jak DAMA i DMBOK podchodzą do kompletności
DAMA International oraz wydanie zrewidowane DAMA-DMBOK® 2.0 traktują kompletność jako wymiar jakości danych. Te ramy są najbardziej użyteczne, gdy zespoły stosują kompletność w powiązaniu z wymaganiami biznesowymi i przydatnością do użycia, zamiast traktować ją jako uniwersalny wynik techniczny. Przegląd ram zarządzania danymi i DAMA zapewnia powiązany kontekst dla pozycjonowania jakości danych w szerszych praktykach zarządzania.
Ujęcie DAMA jest zbieżne z praktycznym pytaniem: co trzeba wiedzieć, aby te dane mogły pełnić swoją zamierzoną rolę? Wytyczne rządu Wielkiej Brytanii dotyczące jakości danych stwierdzają, że dane są kompletne, gdy obecne są wszystkie dane wymagane do określonego zastosowania, i zalecają mierzenie kompletności dla danych krytycznych, a nie dla każdego pola w każdym zbiorze danych.
To oznacza, że 100% kompletność nie jest automatycznie właściwym wymaganiem dla każdego zbioru danych. Wskaźnik kompletności na poziomie 98% może być akceptowalny w jednym przypadku użycia analitycznego, ale nieakceptowalny w raportowaniu regulacyjnym. Te wartości ilustrują decyzję z zakresu governance, a nie uniwersalne progi.
Określanie wymagań na podstawie wpływu
Użyteczna polityka łączy kompletność z konsekwencjami:
Zidentyfikuj raport, model, proces lub kontrolę, która konsumuje dane.
Zdefiniuj rekordy i atrybuty, bez których nie może funkcjonować.
Ustal akceptowalny próg kompletności z właścicielem danych.
Udokumentuj, co się stanie, gdy próg nie zostanie osiągnięty.
Zweryfikuj wymaganie, gdy zmieni się przypadek użycia.
Klucz podstawowy, atrybut regulacyjny lub identyfikator transakcji zazwyczaj zasługują na surowsze traktowanie niż opcjonalne, opisowe wzbogacenie danych. Wkładem DAMA jest słownictwo i dyscyplina pozwalające na wyraźne dokonanie tego rozróżnienia. Nie zastępuje ono jednak lokalnych decyzji właścicieli.
Metryki i wzory do pomiaru kompletności
Metryki kompletności danych powinny mierzyć braki, które mogą wpłynąć na zdefiniowany przypadek użycia. Silny model pomiarowy łączy wskaźniki na poziomie pól, rekordów, populacji, czasu i zbiorów danych, zamiast opierać się na pojedynczym zliczeniu wartości null.
Podstawowy wzór to:
Wskaźnik kompletności = wypełnione wymagane wartości / oczekiwane wymagane wartości × 100
W przypadku kompletności atrybutu „wypełnione wymagane wartości” to liczba rekordów z wartością w wybranym polu. W przypadku kompletności rekordów licznik zlicza rekordy zawierające każdy obowiązkowy atrybut. W przypadku kompletności populacji porównaj dostarczone rekordy z oczekiwaną populacją rekordów. Mianownik musi odzwierciedlać biznesową definicję oczekiwanych danych, a nie jedynie liczbę wierszy, które akurat dotarły.
Kluczowe miary
Wskaźnik NULL: Udział rekordów, w których brakuje wybranego pola. Pomaga zlokalizować luki na poziomie pól, ale nie ujawnia brakujących rekordów ani zbiorów danych.
Pokrycie wymaganych pól: Udział wypełnionych oczekiwanych wartości dla obowiązkowych atrybutów.
Liczba rekordów: Liczba rekordów dostarczonych dla określonego ładowania, partycji, podmiotu lub okresu.
Wariancja liczby rekordów: Różnica między obserwowanym a oczekiwanym wolumenem, przy użyciu udokumentowanego punktu odniesienia lub uzgadniania źródłowego.
Dostępność zbioru danych: Czy obecne jest każde wymagane źródło, tabela, plik lub partycja.
Pokrycie czasowe: Czy reprezentowane są wszystkie wymagane daty i okresy sprawozdawcze.
Trendy kompletności: Zmiana każdej miary w czasie, co pomaga odróżnić jednorazowy incydent od pogarszania się sytuacji.
Metryka | Co mierzy | Typowe użycie |
|---|---|---|
Wskaźnik NULL | Brakujące wartości w wybranym atrybucie | Wymagany identyfikator klienta lub numer konta |
Pokrycie wymaganych pól | Wypełnione obowiązkowe wartości w stosunku do oczekiwanych wartości | Kontrole operacyjne i regulacyjne |
Liczba rekordów | Dostarczona populacja wierszy | Monitorowanie partii i strumieni zdarzeń |
Wariancja liczby rekordów | Różnica w stosunku do oczekiwanego wolumenu | Wykrywanie utraty wierszy lub niekompletnych załadowań |
Pokrycie czasowe | Obecność wymaganych okresów | Finanse, operacje i analiza szeregów czasowych |
Dostępność zbioru danych | Obecność wymaganych źródeł danych | Kontrole zależności w procesach końcowych |
Trend kompletności | Zmiana kompletności w czasie | Analiza powtarzających się problemów i dryfu procesu |
Wskazówki dotyczące metryk jakości danych od digna oferują dodatkowy kontekst dla wyboru miar. Ważną decyzją z zakresu governance jest priorytetyzacja krytycznych atrybutów i populacji. Mierzenie każdego pola w ten sam sposób generuje szum informacyjny i może utrudnić dostrzeżenie poważnej luki.
Czym różni się kompletność od dokładności i poprawności
Kompletność pyta, czy wymagane dane są obecne. Dokładność pyta, czy są one poprawne. Poprawność pyta, czy są one zgodne z wymaganymi regułami lub formatem. Wymiary te mogą zawodzić niezależnie od siebie, dlatego zespoły powinny unikać przypisywania jednej ogólnej etykiety „problemu z jakością” do wszystkich trzech.
Rozważmy numer telefonu klienta:
Kompletność: Czy numer telefonu jest obecny, gdy firma tego wymaga?
Poprawność (Validiy): Czy wartość jest zgodna z przyjętym formatem numeru telefonu?
Dokładność (Accuracy): Czy wartość odpowiada rzeczywistemu numerowi telefonu klienta?

Kompletność a dokładność
Brakujący numer telefonu to problem z kompletnością. Prawidłowo sformatowany numer telefonu, który należy do innego klienta, to problem z dokładnością. W obu przypadkach pole jest obecne, ale tylko jedna wartość poprawnie reprezentuje rzeczywisty podmiot.
Wyjaśnienie wymiarów jakości danych przez Dataversity opisuje kompletność jako pomiar tego, jakich informacji brakuje, a nie tego, czy przechowywane informacje są dokładne lub poprawne. Ta separacja ma znaczenie, ponieważ naprawa przebiega inaczej. Brakujące dane mogą wymagać uzupełnienia w systemie źródłowym lub ponownego przetworzenia, podczas gdy niedokładne dane mogą wymagać weryfikacji, korekty lub nadzoru nad danymi podstawowymi (master data).
Kompletność a poprawność
Brakujący numer telefonu jest niekompletny. Numer telefonu zawierający litery, gdy schemat wymaga wzorca numerycznego, jest niepoprawny (invalid). Prawidłowo sformatowany, ale błędny numer telefonu jest niedokładny.
Pytanie | Wymiar | Przykład |
|---|---|---|
Czy wymagana wartość jest obecna? | Kompletność | Brakuje numeru telefonu |
Czy jest zgodna z regułą? | Poprawność (Validity) | Numer telefonu ma nieprawidłowy format |
Czy odpowiada rzeczywistości? | Dokładność | Numer należy do kogoś innego |
Rozróżnienie IBM pomiędzy kompletnością, dokładnością i poprawnością wzmacnia ten model trzech pytań. Używaj go przy przypisywaniu właścicieli, projektowaniu testów i wyjaśnianiu incydentów interesariuszom biznesowym.
Monitorowanie kompletności w nowoczesnych potokach danych
Potok pomyślny pod względem technicznym niekoniecznie produkuje kompletne dane. Wyobraźmy sobie hurtownię danych otrzymującą codzienne dane o klientach i transakcjach: zadanie ETL kończy się powodzeniem, orkiestracja zgłasza sukces, a tabela docelowa jest dostępna, ale wolumen transakcji jest znacznie niższy niż zwykle, a wymagane identyfikatory klientów wykazują gwałtowny wzrost wartości NULL.
Pojedynczy status potoku nie wykryje obu tych warunków. Pierwszy to problem z liczbą rekordów lub populacją. Drugi to kompletność atrybutów. Projekt monitorowania musi badać dane po ich dostarczeniu, a nie tylko to, czy kod uruchomił się bez błędu wykonania.

Używaj kontroli wielowarstwowych
Walidacja deterministyczna sprawdza znane wymagania, takie jak to, czy obowiązkowy identyfikator klienta nie jest wartością
NULL.Wykrywanie anomalii identyfikuje nieoczekiwane zmiany w wolumenie rekordów, wskaźnikach wartości null, rozkładach lub zachowaniu dostaw.
Analiza historyczna pokazuje, czy odchylenie jest odosobnione, sezonowe, powtarzające się, czy stanowi część dłuższego pogorszenia.
Monitorowanie terminowości sprawdza, czy oczekiwane dane dotarły w wymaganym czasie i z oczekiwaną częstotliwością.
W tym scenariuszu kontrole kompletności danych dla potoków przedsiębiorstwa można zorganizować wokół utraty wierszy, utraty pól, brakujących rekordów i brakujących pól. Kontrola powinna również identyfikować partycję źródłową lub dostawę odpowiedzialną za lukę, aby inżynierowie mogli zbadać sprawę, a nie tylko obserwować czerwony status.
Pomyślne uruchomienie ETL dowodzi, że proces został wykonany. Nie dowodzi, że dotarły wymagane dane biznesowe.
Ciągłość ma znaczenie, ponieważ kompletność zmienia się w czasie. Czysty dziś zbiór danych może stać się niekompletny po wydaniu nowej wersji systemu źródłowego, zmianie filtra ekstrakcji, opóźnionej partycji lub przekazaniu przepływu pracy. Ciągłe monitorowanie sprawia, że stan ten staje się widoczny blisko momentu, w którym ulega zmianie.
Jak Can digna Support Data Completeness?
digna wspiera kompletność danych poprzez odrębne możliwości dla jawnych reguł, nietypowych zachowań i kontekstu historycznego. Każda funkcja dotyczy innej warstwy, dlatego zespół nie powinien traktować jednego modułu jako całkowitego zamiennika dla wszystkich kontroli kompletności.
digna Data Validation
digna Data Validation wspiera znane, oparte na regułach wymagania, w tym:
Wymagane pola nie mogą mieć wartości
NULL.Każda transakcja musi posiadać wymagany identyfikator.
Obowiązkowe atrybuty biznesowe muszą być wypełnione.
Zdefiniowane reguły kompletności muszą być spełnione.
Jest to podstawowa funkcja dla wymagań, które można sformułować bezpośrednio i oceniać rekord po rekordzie.
digna Data Anomalies
digna Data Anomalies może identyfikować nieoczekiwane zmiany w zachowaniach związanych z kompletnością, takie jak nagłe wzrosty wskaźników NULL, nieoczekiwane spadki liczby rekordów, znaczące zmiany rozkładu i nietypowe odchylenia od historycznych wolumenów danych.
Wykrywanie anomalii identyfikuje nietypowe zachowanie. Nie dowodzi ono automatycznie, że dane są niekompletne. Uzasadniona zmiana sezonowa może wyglądać nietypowo, podczas gdy subtelny błąd kompletności może mieścić się w szerokim wzorcu historycznym. Zespoły nadal potrzebują kontekstu biznesowego oraz, w stosownych przypadkach, jawnych reguł walidacji.
digna Data Analytics
digna Data Analytics zapewnia kontekst historyczny dla metryk kompletności. Zespoły mogą badać trendy liczby rekordów, trendy wskaźnika NULL, historyczną kompletność, powtarzające się wzorce brakujących danych oraz zmiany między okresami sprawozdawczymi.
Wymaganie kompletności | Przykład | Funkcja digna |
|---|---|---|
Wymagane wartości | Wymagane pole nie może mieć wartości | digna Data Validation |
Wolumen rekordów | Oczekiwana liczba rekordów | digna Data Anomalies |
Historyczna kompletność | Wykrywanie pogorszenia stanu w czasie | digna Data Analytics |
Dostępność zbioru danych | Oczekiwane źródło danych jest obecne | digna Data Validation / digna Data Anomalies |
To powiązanie jest celowe. Walidacja wymusza znane warunki, anomalie ujawniają nieoczekiwane zachowania, a analityka pomaga określić, czy problem jest odosobniony czy powtarzający się.
Kluczowe wnioski i najczęściej zadawane pytania
Kompletność danych to zmienny stan biznesowy, a nie statyczna kontrola wartości null. Zdefiniuj wymagane dane dla każdego przypadku użycia, mierz odpowiednią warstwę i monitoruj, czy rekordy, atrybuty, okresy i zbiory danych nadal docierają zgodnie z oczekiwaniami.
Czym jest kompletność danych?
To stopień, w jakim obecne są wszystkie dane wymagane do określonego celu. Zakres zależy od przydatności do użycia.
Jakie są rodzaje kompletności danych?
Typowe rodzaje obejmują kompletność atrybutów, rekordów, liczby rekordów, czasową i zbioru danych. Każdy z nich odnosi się do innego ryzyka związanego z brakującymi danymi.
How is Data Completeness measured?
Używaj miar takich jak wskaźnik NULL, pokrycie wymaganych pól, liczba rekordów, wariancja liczby rekordów, dostępność zbioru danych, pokrycie czasowe i trendy kompletności.
Co DAMA mówi o kompletności danych?
DAMA-DMBOK traktuje kompletność jako wymiar jakości danych i odnosi wymagania do potrzeb biznesowych oraz przydatności do użycia.
Czy 100% kompletność danych jest zawsze wymagana?
Nie. Wartość 100% nie jest uniwersalnie odpowiednia. Wymaganie powinno odzwierciedlać konsekwencje brakujących danych dla zamierzonego zastosowania.
Jaka jest różnica między kompletnością a dokładnością?
Kompletność pyta, czy wymagana wartość jest obecna. Dokładność pyta, czy ta wartość jest poprawna.
Jaka jest różnica między kompletnością a poprawnością?
Kompletność dotyczy obecności. Poprawność (Validity) dotyczy zgodności ze zdefiniowanymi formatami, regułami lub standardami.
Jak można stale monitorować kompletność danych?
Połącz walidację opartą na regułach, monitorowanie rekordów i dostaw, wykrywanie anomalii oraz analizę historyczną w potokach wsadowych, strumieniowych i między-systemowych.
Które moduły digna wspierają kompletność danych?
digna Data Validation, digna Data Anomalies i digna Data Analytics wspierają różne potrzeby związane z kompletnością. Powinny być one przypisane do konkretnej kontroli, a nie traktowane jako zamienne.
digna zapewnia funkcje digna Data Validation, digna Data Anomalies i digna Data Analytics do sprawdzania wymaganych wartości, identyfikowania nietypowych zachowań rekordów i wskaźników wartości null oraz analizowania kompletności w czasie. Odwiedź digna, aby zobaczyć, jak te kontrole mogą wpasować się w Twoje podejście do monitorowania jakości danych.


