Jak mierzyć dokładność danych: 8 praktycznych metod
|
9
min. czyt.

Dokładność mierzy się poprzez porównanie danych z zaufanym punktem odniesienia lub stanem faktycznym (ground truth), a następnie wzmocnienie tego porównania poprzez walidację, uzgadnianie (reconciliation), próbkowanie, wykrywanie anomalii i analizę historyczną. W przypadku krytycznych zbiorów danych jeden z praktycznych punktów odniesienia definiuje dokładność jako poprawne rekordy ÷ wszystkie rekordy × 100, z sugerowanym celem na poziomie co najmniej 98% dla kluczowych danych, choć właściwy próg zależy od ryzyka biznesowego i konkretnego przypadku użycia (praktyczne ramy Acceldata).
Popularna porada mówi, aby uruchomić kilka testów na obecność wartości null, upewnić się, że daty mają właściwy format i uznać zbiór danych za dokładny, gdy proces przetwarzania (pipeline) zaświeci się na zielono. Takie podejście mierzy jednak kompletność i poprawność, a niekoniecznie prawdziwość danych. Adres klienta może być kompletny i poprawnie sformatowany, a mimo to błędny. Kwota transakcji może pomyślnie przejść walidację techniczną, ale różnić się od kwoty faktycznie pobranej. Data taka jak 31 grudnia 2099 może być poprawna składniowo, lecz nieprawidłowa jako data urodzenia klienta.
Dokładność danych to stopień, w jakim dane prawidłowo odzwierciedlają rzeczywisty obiekt, zdarzenie lub wartość, którą opisują. Wymagany poziom zależy od planowanego zastosowania. Mała rozbieżność może być tolerowana w analizie eksploracyjnej, lecz niedopuszczalna w sprawozdawczości finansowej, dokumentacji medycznej, danych regulacyjnych lub przy automatycznym podejmowaniu decyzji.
Rygorystyczna ocena oddziela od siebie błąd systematyczny (bias), precyzję, niepewność, poprawność, zasadność, terminowość oraz zmiany strukturalne. Metrologia opisuje dokładność jako bliskość do wartości prawdziwej lub referencyjnej, podczas gdy błąd systematyczny odzwierciedla systematyczne odchylenie, a precyzja – rozrzut wielokrotnych pomiarów (wytyczne National Physical Laboratory). Poniższe metody traktują dokładność jako nagromadzone dowody na to, że dane odzwierciedlają rzeczywistość, a nie jako jeden uniwersalny wynik.
Spis treści
3. Uzgadnianie między systemami (Cross-System Reconciliation)
8. Zintegrowana, wielometodowa strategia monitorowania dokładności
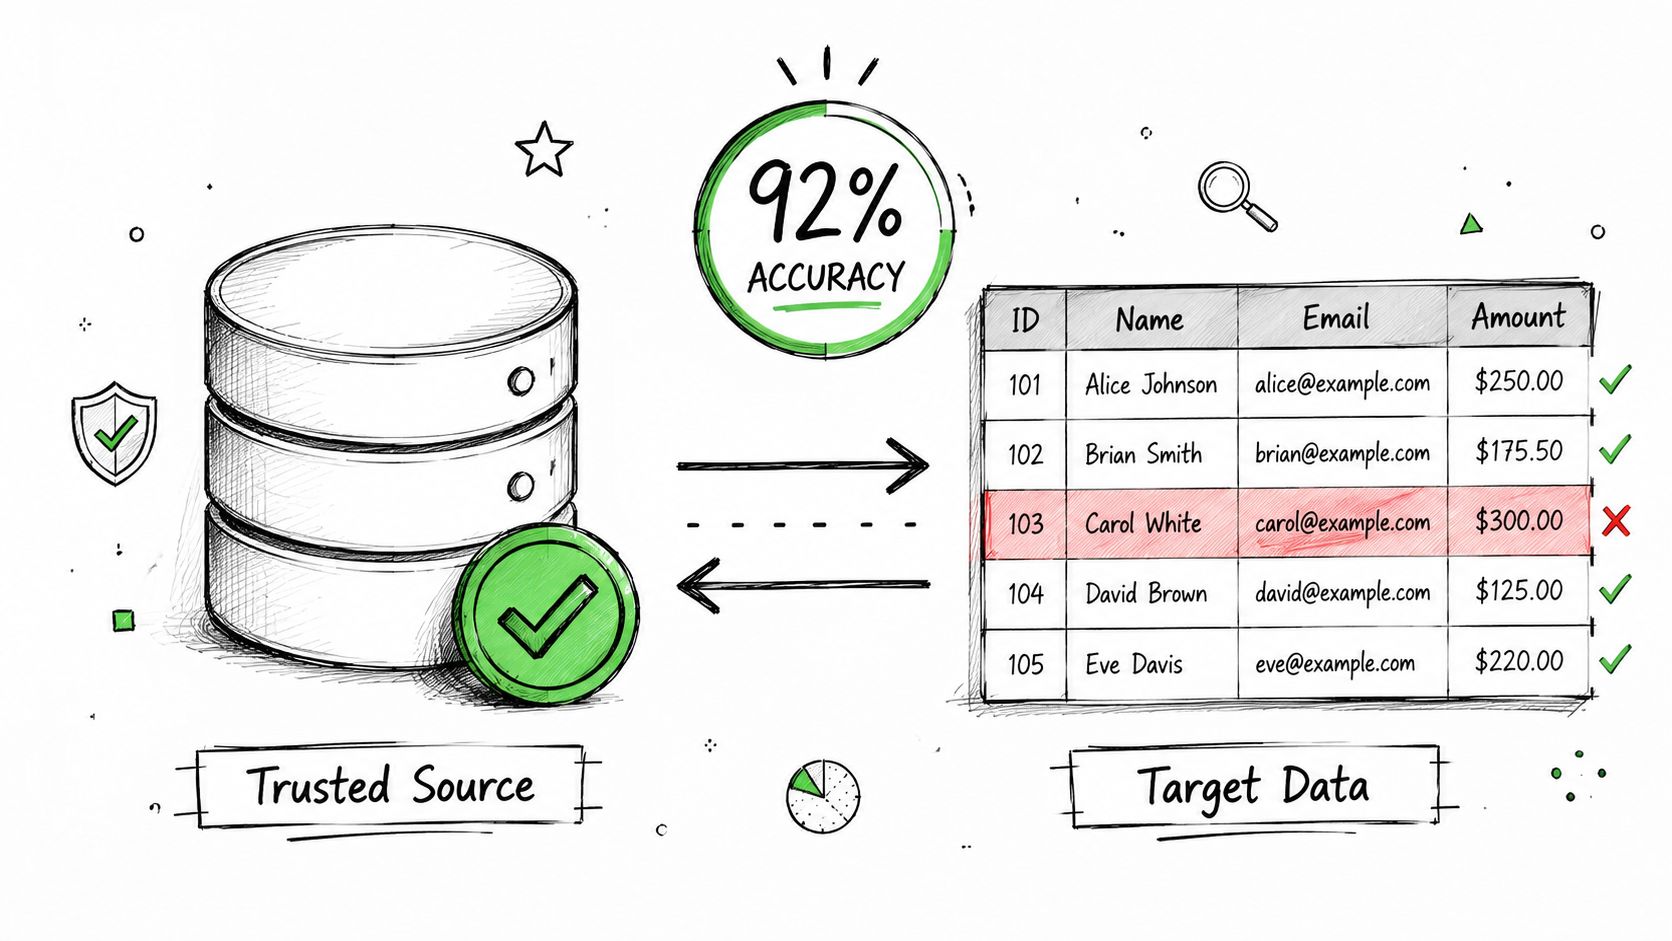
1. Porównanie z zaufanymi źródłami danych
Bezpośrednie porównanie dostarcza najsilniejszego dowodu wstępnego, gdy źródło ma zdefiniowane uprawnienia i wdrożone kontrole. Zbiór danych w hurtowni można porównać z nadrzędną bazą danych klientów (master database), cenę analityczną z zatwierdzonym systemem cenowym, a kwotę raportowaną ze zweryfikowanym dziennikiem transakcji. Pytanie jest konkretne: czy zarejestrowana wartość zgadza się z referencją użytą do przedstawienia oczekiwanego obiektu, zdarzenia lub wartości?
Podstawowa miara to:
Wskaźnik dokładności = poprawnie dopasowane rekordy ÷ oceniane rekordy × 100
Wskaźnik ten ma sens tylko wtedy, gdy zespół zdefiniuje pojęcie „dopasowania”. Dokładna równość może być odpowiednia dla identyfikatora transakcji lub zatwierdzonej ceny produktu. Adres może wymagać normalizacji, podczas gdy pole statusu może potrzebować reguły opartej na dacie wejścia w życie, ponieważ systemy aktualizują się w różnym czasie. Wynik mierzy zatem zgodność przy zastosowaniu określonej metody porównawczej, a nie dokładność w każdym możliwym sensie.
Zdefiniuj punkt odniesienia przed wykonaniem obliczeń
Zarejestruj zaufane źródło, właściciela, częstotliwość aktualizacji, objęte zakresem pola, klucz dopasowania oraz dopuszczalne okno czasowe. Ładowanie hurtowni danych, które przez krótki czas pozostaje w tyle za systemem nadrzędnym, może wynikać z normalnego opóźnienia przetwarzania, a nie z błędnej wartości. Źródło referencyjne może również zawierać przestarzałe lub obarczone błędem systematycznym rekordy, dlatego jego autorytet powinien opierać się na wdrożonych kontrolach, a nie być przyjmowany z góry.
Praktyczna zasada: Porównanie dowodzi zgodności z wybranym punktem odniesienia. Nie dowodzi ono, że sam punkt odniesienia reprezentuje rzeczywisty obiekt, zdarzenie lub wartość, chyba że źródło to posiada własne kontrole jakości.
Przykłady zastosowań obejmują:
Tożsamość klienta: Porównanie adresów w hurtowni z nadrzędnym rekordem CRM i rejestrowanie, czy dopasowanie jest dokładne, znormalizowane czy oparte na dacie wejścia w życie.
Sprawozdawczość finansowa: Porównanie kwot transakcji w bazie danych raportowania z bankowym systemem źródłowym.
Zarządzanie produktem (Product governance): Weryfikacja cen analitycznych z zatwierdzonym cennikiem referencyjnym.
Cykl życia klienta: Weryfikacja pól statusu z autorytatywnymi rekordami biznesowymi.
Zespoły mogą wykorzystać rozwiązanie digna Data Reconciliation do automatyzacji cyklicznych porównań między źródłem a celem, badania niezgodnych dopasowań i śledzenia, czy rozbieżności mają charakter odosobniony, czy też trwały. Progi akceptacji należy ustalać odpowiednio do konsekwencji biznesowych. Idealne dopasowanie nie zawsze jest wymagane, podczas gdy minimalna niezgodność może być niedopuszczalna w przypadku pól o kluczowym znaczeniu.
2. Walidacja reguł biznesowych
Reguły biznesowe przekształcają oczekiwanie dotyczące dokładności w deterministyczny test. Suma na fakturze powinna być równa sumie jej pozycji powiększonej o podatek. Rabat klienta powinien mieścić się w limicie dla danego poziomu klienta. Koszt produktu nie powinien przekraczać jego zatwierdzonej ceny sprzedaży. Każda reguła dostarcza możliwego do zweryfikowania dowodu na to, że określona relacja jest zachowana.
Metoda ta jest użyteczna, ponieważ jej zakres jest jednoznaczny. Nieudana kontrola wskazuje, które oczekiwanie zostało naruszone, i często pozwala wyizolować dotknięty rekord, pole lub transformację. Walidacja reguł sprawdza się w przypadku kluczowych pól, kontroli zgodności (Compliance), wyliczanych wskaźników oraz relacji, które można ocenić bez subiektywnej oceny.
Pomyślne przejście reguły dowodzi zgodności z logiką zapisaną w tej regule. Nie oznacza to jednak, że leżąca u jej podstaw wartość odzwierciedla rzeczywistość. Spójna wewnętrznie faktura może nadal zawierać błędną kwotę opłaty, a nieujemna ilość zapasów magazynowych może różnić się od stanu faktycznego. Jak pokazuje porada dotycząca wykrywania oszustw związanych z drogomierzami, pomyślne przejście kontroli formatu nie gwarantuje, że wartość odzwierciedla stan rzeczywisty.
Projektuj reguły wspólnie z osobami, które rozumieją procesy, jakie te reguły reprezentują. Dla każdej reguły udokumentuj chronione pola, uzasadnienie biznesowe, procedurę w przypadku błędu oraz warunki, w których wyjątek jest uzasadniony. Przetestuj reguły na danych historycznych, aby określić oczekiwane zachowanie, a następnie weryfikuj je przy każdej zmianie produktów, polityk, statusów lub transformacji.
Rozwiązanie digna Data Validation umożliwia kontrole na poziomie rekordów przy użyciu wartości, przedziałów, progów, danych referencyjnych i warunków biznesowych. Zespoły mogą wykorzystywać te kontrole do egzekwowania sprecyzowanych oczekiwań na dużą skalę, zachowując szczegóły błędów do późniejszej analizy.
Praktyczny zestaw kontrolny powinien traktować priorytetowo:
Kluczowe wskaźniki: Zacznij od przychodów, sald, pól regulowanych oraz miar operacyjnych.
Własność biznesową: Zaangażuj interesariuszy domenowych do zatwierdzania reguł i udokumentowanych wyjątków.
Identyfikowalność wyników: Przechowuj błędne rekordy, dokładne przyczyny niepowodzeń, wersje reguł i statusy zgłoszeń.
Wielowarstwowość: Połącz deterministyczną walidację z porównywaniem z zaufanymi źródłami i sygnałami o anomaliach.
Pokrycie regułami powinno być monitorowane jako część potoku przetwarzania (pipeline), a nie traktowane jako raz skonfigurowane i zamknięte zadanie. Reguła może działać poprawnie, stając się jednocześnie niekompletną z powodu zmiany procesów biznesowych. To ograniczenie wyjaśnia, dlaczego walidacja stanowi tylko jeden z rodzajów dowodów w szerszej strategii monitorowania dokładności.
3. Uzgadnianie między systemami (Cross-System Reconciliation)
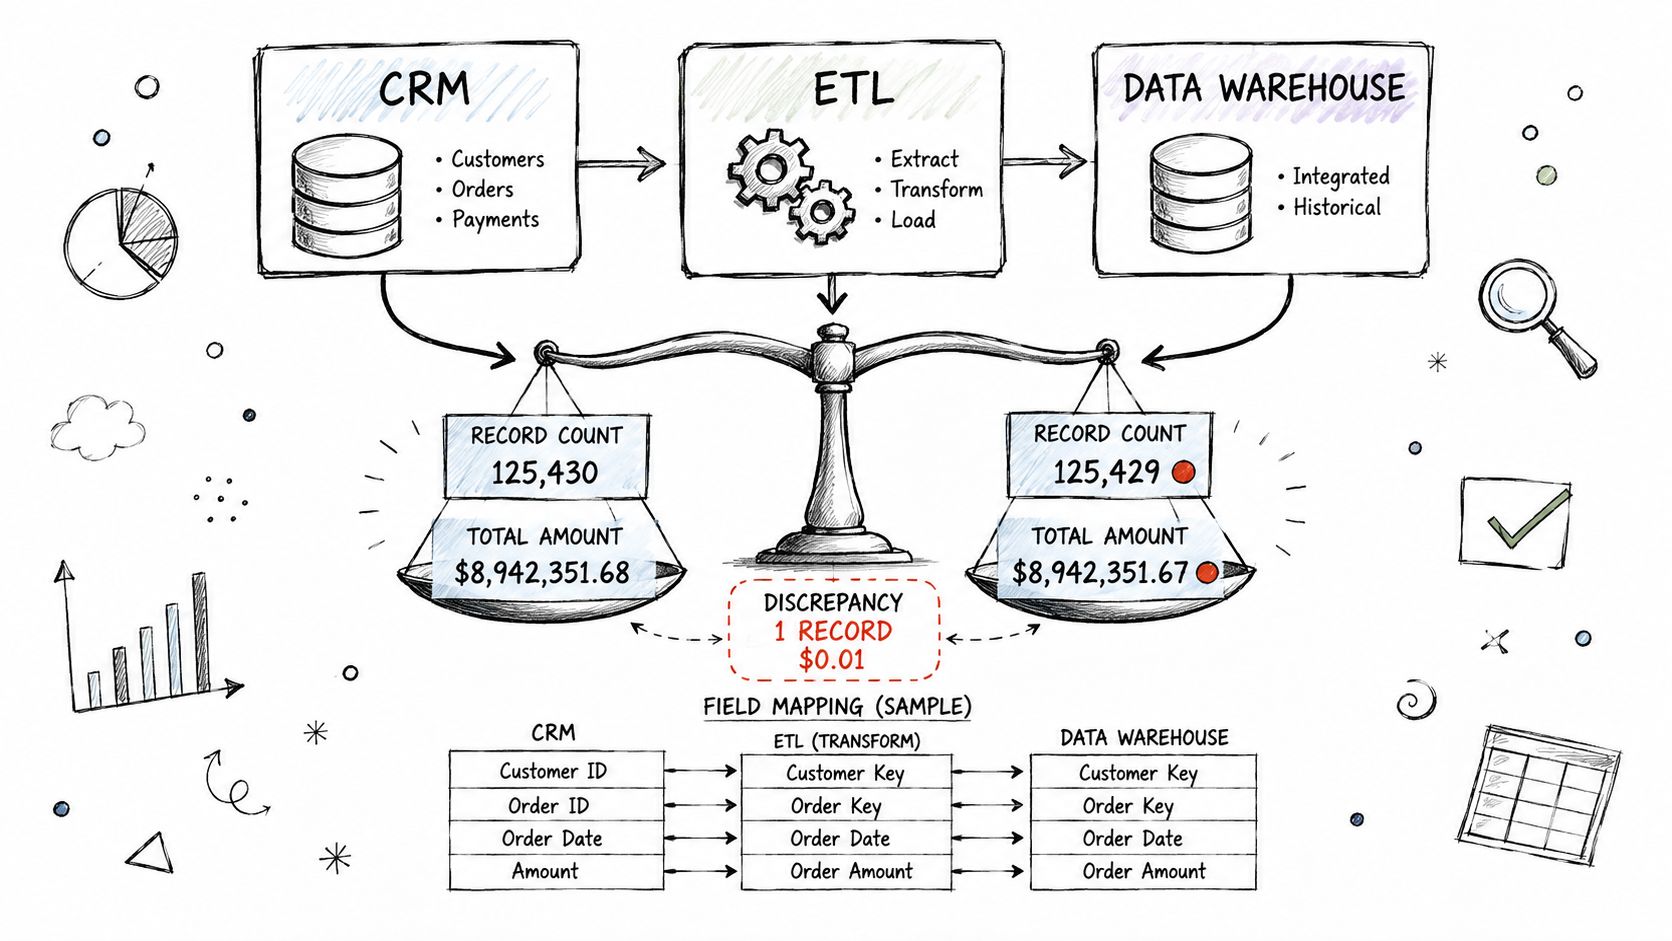
Uzgadnianie między systemami sprawdza, czy transformacja zachowała informacje wymagane w kolejnych etapach procesu (downstream). Porównuje ono rekordy między systemem źródłowym a docelowym, zamiast jedynie badać, czy poszczególne pola mają prawidłowy format. Porównanie to może obejmować liczby rekordów, agregaty, wskaźniki biznesowe oraz profile statystyczne.
Proces finansowy dobrze obrazuje, dlaczego to ważne. Źródło może zawierać rekordy transakcyjne, podczas gdy hurtownia przechowuje przetworzone dane raportowe. Oba systemy mogą zawierać poprawne daty i niepuste kwoty, a mimo to suma w hurtowni może się różnić, ponieważ rekordy zostały przefiltrowane, zduplikowane, obcięte lub nieprawidłowo przekształcone.
Uzgadnianie powinno odbywać się na kilku poziomach. Kontrole na poziomie pojedynczych rekordów pozwalają zidentyfikować brakujące lub nieoczekiwane podmioty. Kontrole agregatów porównują sumy transakcji, przychody, salda lub inne zatwierdzone miary. Kontrole profilu badają rozkłady i częstotliwości wartości, których pojedyncza suma mogłaby nie ujawnić.
Określ okno czasowe uzgadniania uwzględniające znane opóźnienia i czas przetwarzania. Zdefiniuj tolerancje, warunki alertów, odpowiedzialność i kroki naprawcze, zanim pojawią się rozbieżności. Różnica przekraczająca próg tolerancji powinna automatycznie tworzyć zgłoszenie do wyjaśnienia, zawierające odpowiedni kontekst diagnostyczny.
Użyteczne mechanizmy kontrolne obejmują:
Liczbę rekordów: Porównanie liczby rekordów źródłowych i docelowych po zastosowaniu udokumentowanych filtrów.
Agregaty: Porównanie sum, średnich i innych zatwierdzonych wskaźników biznesowych.
Pokrycie: Potwierdzenie, że oczekiwane rekordy faktur lub klientów trafiają do systemów odbiorczych.
Analizę trendów: Śledzenie powtarzających się różnic w celu oddzielenia pojedynczych incydentów od systemowych błędów transformacji.
Użyj digna Data Reconciliation, aby wspierać regularne porównania między zbiorami danych źródłowych i docelowych. Wynik jest dowodem na spójność, a nie ostatecznym potwierdzeniem, że każda wartość jest dokładna. System źródłowy może być nieaktualny lub błędny, a zgodne sumy mogą maskować wzajemnie znoszące się błędy. Udokumentuj, który system dostarcza zaufanych oczekiwań i kiedy każdy z nich powinien być aktualny, a następnie połącz wyniki uzgadniania z walidacją, sygnałami o anomaliach i weryfikacją przez człowieka.
4. Analiza statystyczna, historyczna i wykrywanie anomalii
Wartość może spełniać każdą predefiniowaną regułę, a mimo to zachowywać się niezgodnie z procesem, który reprezentuje. Analiza statystyczna i historyczna dodaje kontekst poprzez badanie rozkładów, trendów, zmienności, terminowości oraz powtarzających się odchyleń. Wykrywanie anomalii rozszerza to podejście, identyfikując nieoczekiwane zmiany, których zespoły mogły nie zapisać w postaci sztywnych reguł.
Wyobraźmy sobie, że średnia wartość transakcji wzrasta o 300% z dnia na dzień. To nie dowodzi, że dane są błędne. Zmiana może wynikać z uzasadnionej decyzji cenowej, dużego zakupu klienta lub zdarzenia biznesowego. Tworzy to jednak alert o wysokim priorytecie, ponieważ zaobserwowane zachowanie gwałtownie odbiega od ustalonego wzorca.
Badaj odchylenia, nie etykietuj ich automatycznie
Do użytecznych sygnałów należą nagłe zmiany w rozkładzie wieku klientów, nietypowa wariancja cen produktów, nieoczekiwane zmiany liczby transakcji oraz wzorce przychodów odbiegające od zachowań historycznych. Zespoły powinny monitorować jednocześnie liczby rekordów, agregaty, rozkłady i czas dostarczania, ponieważ pojedyncza metryka może maskować naturę problemu.
Rozwiązanie digna's statistical methods for data analysis ułatwia analizę trendów, zmienności i zachowań historycznych. Oparte na sztucznej inteligencji uczenie się punktu odniesienia (baseline learning) pozwala wykrywać odchylenia bez konieczności ręcznego konfigurowania każdego progu, jednak sam punkt odniesienia nadal wymaga kontekstu operacyjnego.
Anomalia jest dowodem na to, że zachowanie uległo zmianie. Sama w sobie nie jest dowodem na to, że zmieniona wartość jest niedokładna.
Zacznij od okresu próbnego (warm-up), który pozwoli systemowi poznać odpowiednią ilość zachowań historycznych w celu modelowania normalnej zmienności. Dostosuj czułość podczas znanych kampanii, migracji, zdarzeń sezonowych lub aktualizacji systemów. Zapisuj wyjaśnienia, gdy anomalia okazuje się uzasadniona biznesowo. Taka decyzja usprawnia przyszłą klasyfikację alertów i zapobiega traktowaniu każdej nietypowej obserwacji jako błędu danych.
Analiza statystyczna pomaga również odróżnić dokładność od niepewności. Organizacja Narodów Zjednoczonych ds. Wyżywienia i Rolnictwa wyjaśnia, że dokładności analitycznej nie da się określić bezpośrednio ilościowo i wiąże się ona z błędem losowym oraz systematycznym, podczas gdy błędy standardowe i przedziały ufności komunikują niepewność wokół pomiarów (metodologia FAO dotycząca jakości danych). Stabilny wzorzec może nadal być systematycznie obarczony błędem.
5. Porównanie z danymi referencyjnymi (Reference Data)
Porównanie z danymi referencyjnymi sprawdza, czy pole pasuje do zatwierdzonej zewnętrznej listy, tabeli słownikowej lub kontrolowanego słownika. Dostarcza ono dowodów na poprawność, zwłaszcza w przypadku pól kategorycznych i wymiarowych, lecz samo w sobie nie przesądza o dokładności. Wartość może być zgodna z oczekiwanym formatem, a mimo to nieadekwatna do kontekstu biznesowego.
Na przykład pole kraju może zawierać poprawnie sformatowany dwuliterowy kod, który nie jest akceptowany w danym procesie. Kategoria produktu może być uzupełniona i unikalna, ale wskazywać na nieaktualną gałąź hierarchii produktów. Kod działu może istnieć w rekordzie nawet po tym, jak dział ten został usunięty ze słownika nadrzędnego organizacji.
Zachowaj odpowiedni stan referencyjny
Dane referencyjne ulegają zmianom. Listy walut, stawki podatkowe, hierarchie produktów, struktury organizacyjne i tabele statusów mogą dodawać, usuwać lub zmieniać nazwy wartości. Zapisuj wersję referencyjną i datę wejścia w życie użytą do każdej walidacji. W przeciwnym razie rekordy historyczne mogą być oceniane na podstawie późniejszego stanu biznesowego, co generuje fałszywe błędy lub ukrywa rzeczywiste rozbieżności.
Zastosuj tę kontrolę do pól takich jak:
Kody krajów: Porównaj wartości klienta ze standardem kodów krajów ISO 3166.
Taksonomia produktów: Dopasuj kody kategorii do zatwierdzonej hierarchii.
Waluty: Waliduj kody walut transakcji z oficjalną listą walut.
Struktura organizacyjna: Porównaj kody działów pracowników z aktualnymi danymi słownikowymi.
Statusy: Sprawdź wartości statusu transakcji z określoną tabelą statusów.
Wynik dowodzi, że wartość odpowiada akceptowanemu punktowi odniesienia. Nie dowodzi jednak, że ta referencja jest odpowiednia dla daty transakcji lub że rekord źródłowy odzwierciedla rzeczywistość. Dodaj daty wejścia w życie, udokumentowane wyjątki i ścieżki audytu (audit trails), gdy dane referencyjne wspierają sprawozdawczość regulowaną.
Porównywanie z referencjami wzmacnia również walidację reguł biznesowych. Reguła może wymagać, aby dział istniał, podczas gdy kontrola referencyjna określa, czy jego kod jest zatwierdzony. Jeśli referencja ulegnie zmianie, zaktualizuj kontrolę i zapisz zmianę. Dzięki temu warstwa walidacji pozostaje spójna z biznesem, zamiast traktować przestarzałe mapowanie jako dowód dokładności.
6. Próbkowanie i weryfikacja ręczna
Zautomatyzowane kontrole są wydajne, ale weryfikacja ręczna ujawnia rodzaje błędów, które mogą umknąć regułom i automatycznym porównaniom. Zespoły wybierają reprezentatywne rekordy i weryfikują je z fakturami, systemami źródłowymi, potwierdzeniami od klientów, badaniami lub innymi dowodami stanu faktycznego.
Próbka może obejmować rekordy klientów, których adresy są sprawdzane z oficjalnymi bazami, rekordy transakcji porównywane z fakturami źródłowymi lub podejrzane ceny produktów weryfikowane z zatwierdzonymi dokumentami. Wynik to nie tylko wskaźnik zaliczenia testu. Pokazuje on również, czy błędy wynikają z nieaktualnych danych, logiki transformacji, błędów ręcznego wprowadzania, wad systemów źródłowych czy też niejasnej definicji prawdy.
Świadomie zaprojektuj próbę
Wybór losowy pozwala oszacować ogólne warunki, natomiast próbkowanie warstwowe (stratification) zapewnia, że uwaga zostanie skupiona na rekordach o wysokim ryzyku lub wysokiej wartości. Udokumentuj populację, metodę doboru, dowody weryfikacji, osobę weryfikującą, datę, kryteria decyzyjne oraz klasyfikację błędów. Statystyczne metody próbkowania pomagają określić odpowiednią wielkość próby, ale metoda musi być dopasowana do ryzyka i planowanego zastosowania.
Weryfikacja ręczna powinna walidować automatyczną kontrolę, a nie tylko ją powtarzać.
Użyj próbkowania, aby poddać próbie założenia stojące za zautomatyzowanymi wskaźnikami dokładności. Jeśli automatyczne porównanie wykazuje wysoką zgodność, kontrole ręczne mogą sprawdzić, czy domniemane źródło jest rzeczywiście aktualne i wiarygodne. Jeśli wykrywanie anomalii flaguje nietypowe rekordy, celowana weryfikacja pomoże ustalić, czy rekordy te odzwierciedlają uzasadnione zdarzenia biznesowe.
Ocena ludzka dostarcza również dowodów jakościowych. Osoby weryfikujące mogą odkryć, że „poprawność” zależy od dat wejścia w życie, zgody klienta, konwencji geograficznych lub wyjątków biznesowych, które nie zostały uwzględnione w modelu danych. Wnioski te powinny wracać jako wkład do reguł, danych referencyjnych, logiki uzgadniania i progów monitorowania.
Próbkowanie jest pracochłonne, dlatego należy je planować wokół krytycznych zbiorów danych i znanych obszarów ryzyka. Śledź powtarzające się wzorce błędów, zamiast traktować każdy zweryfikowany rekord jako odosobniony przypadek. Z czasem organizacja dowiaduje się, które kontrole automatyczne warto rozbudować, a które sygnały generują zbyt wiele uzasadnionych wyjątków.
7. Kompletność i terminowość jako wskaźniki dokładności
Dokładność to dowód na to, że dostarczone dane odzwierciedlają rzeczywistość. Kompletność i terminowość nie dowodzą, że poszczególne wartości są prawdziwe, ale sprawdzają, czy zbiór danych reprezentuje właściwą populację w wymaganym momencie. Brakujące rekordy, pominięte kluczowe pola lub opóźnione ładowanie mogą sprawić, że skądinąd poprawne wartości staną się bezużyteczne.
Dzienny zbiór transakcji może zawierać dokładne rekordy, lecz dotrzeć po terminie raportowania. Raport opisuje wtedy tylko te rekordy, które odebrano, a nie stan biznesowy z momentu, gdy decyzje były wymagane. Zbiór nadrzędny klientów, który wyklucza nowo utworzonych użytkowników, tworzy dokładny, lecz tylko częściowy obraz, mogąc wprowadzić w błąd analizy na kolejnych etapach.
Śledź pokrycie i dostarczanie jako osobne sygnały operacyjne:
Zachowanie czasu przybycia: Porównaj czas dostarczenia z ustalonym harmonogramem, aby zidentyfikować spóźnione, brakujące lub nieoczekiwanie wczesne ładowania danych.
Pokrycie: Porównaj liczbę dostarczonych rekordów z oczekiwaną populacją lub liczbą z zaufanego źródła.
Kluczowe pola: Mierz zapełnienie pól używanych w złączeniach, obliczeniach, decyzjach o uprawnieniach lub raportach regulacyjnych.
Punkty zmian: Badaj nagłe przesunięcia w pokryciu po zmianie źródła, schematu lub potoku przetwarzania.
Zdefiniuj akceptowalne luki przed rozpoczęciem monitorowania. Spóźniony przyrostowy ładunek danych może być oczekiwany podczas zaplanowanych prac konserwacyjnych, natomiast niewyjaśnione opóźnienie może wskazywać na awarię źródła lub potoku. Kontrola pokrycia wymaga również jasnego mianownika. Sama liczba rekordów nie pokaże, czy brakująca populacja skupia się w segmencie o wysokim wpływie.
Funkcja Timeliness w digna monitoruje wzorce przybycia i oczekiwane czasy dostarczania danych. Narzędzie Schema Tracker wykrywa zmiany strukturalne, w tym dodane lub usunięte kolumny oraz zmodyfikowane typy danych. Sygnały te nie ustalają prawdy na poziomie pojedynczych wartości. Pozwalają jednak zidentyfikować sytuacje, w których dotychczas niezawodny proces dokładności może przestać być bezpieczny, sugerując potrzebę porównania źródeł, walidacji reguł lub celowanej weryfikacji.
Wytyczne dotyczące jakości danych stawiają dokładność obok kompletności, spójności, wiarygodności i terminowości (wytyczne rządu Kanady dotyczące jakości danych). Łączne traktowanie tych wymiarów daje zespołom silniejszy dowód na przydatność danych: wartości powinny być poprawne, pokrycie powinno odpowiadać zamierzonej populacji, a informacje powinny docierać na czas, by wspierać ich wykorzystanie.
8. Zintegrowana, wielometodowa strategia monitorowania dokładności
Najsilniejszy model operacyjny łączy różne metody, zamiast wymagać, aby jeden wskaźnik dźwigał cały ciężar oceny. Porównanie z zaufanym źródłem bada zgodność z oczekiwanym stanem. Walidacja biznesowa testuje jawną logikę. Uzgadnianie sprawdza przepływ danych między systemami. Wykrywanie anomalii i analiza historyczna badają zachowanie danych. Próbkowanie weryfikuje, czy zautomatyzowane założenia sprawdzają się w konfrontacji z rzeczywistymi dowodami.
Proces raportowania finansowego pokazuje, jak te warstwy ze sobą współpracują. System źródłowy zawiera dane transakcyjne, a hurtownia obsługuje raportowanie. Wymagane pola są uzupełnione, a potok danych kończy pracę, lecz suma w hurtowni różni się od zaufanego źródła.
Wyjaśnianie tej sytuacji może przebiegać następująco:
Uzgodnij metryki źródłowe i docelowe, aby zidentyfikować rozbieżność i jej zakres.
Zwaliduj reguły biznesowe dla kwot transakcji, dat, identyfikatorów i wyliczanych pól.
Zbadaj anomalie, aby określić, czy dotknięte wartości lub liczby rekordów zmieniły się w nieoczekiwany sposób.
Użyj analityki historycznej, aby zidentyfikować, kiedy odchylenie się rozpoczęło i czy się powtarza.
Pobierz próbkę wybranych rekordów do weryfikacji ze źródłami, aby sklasyfikować błąd.
Sprawdź terminowość i zmiany w schemacie pod kątem opóźnionych ładunków, zmian strukturalnych lub zmodyfikowanego zachowania potoku.
Dopasuj metody do ryzyka
Dane medyczne mogą wymagać monitorowania kompletności, walidacji referencyjnej, wykrywania anomalii oraz okresowej weryfikacji ręcznej. Bilingi telekomunikacyjne mogą potrzebować uzgadniania przychodów, reguł opłat, analizy wzorców użycia oraz monitorowania zmian strukturalnych. Dane sektora publicznego mogą wymagać identyfikowalnych wersji referencyjnych, powtarzalnej walidacji oraz gotowych do audytu rekordów wyjaśnień.
Wykorzystaj wpływ biznesowy, aby zdecydować, od czego zacząć. Powiąż każdy krytyczny element danych z jego zaufanym punktem odniesienia, regułami, kontrolami uzgadniania, sygnałami behawioralnymi, planem próbkowania i ścieżką eskalacji. Korelowanie wniosków z różnych metod pomaga zespołom odróżnić lokalny uszkodzony rekord od awarii całego potoku danych.
Platforma taka jak digna może połączyć moduły Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness oraz Schema Tracker w jeden wspólny proces monitorowania. Platforma działa w środowisku klienta i przeprowadza analizy bezpośrednio w bazie danych, dzięki czemu dane pozostają na swoim miejscu, podczas gdy inżynierowie, analitycy i zespoły ds. governance analizują incydenty i trendy.
Porównanie 8 metod: Pomiar dokładności danych
Metoda | Złożoność wdrożenia 🔄 | Wymagania zasobowe i utrzymanie ⚡ | Oczekiwane rezultaty 📊⭐ | Idealne przypadki użycia 💡 | Kluczowe zalety ⭐ |
|---|---|---|---|---|---|
Porównanie z zaufanymi źródłami danych | Średnia; mapowanie i logika dopasowań; utrzymanie zaufanego źródła | Umiarkowane; moc obliczeniowa dla dużych zbiorów; bieżące utrzymanie źródeł | Wysokie; mierzalne wskaźniki dokładności; jasne dowody niezgodności | Dane strukturyzowane z autorytatywnymi bazami nadrzędnymi (CRM, cenniki, finanse) | Obiektywna, skalowalna identyfikacja niezgodności na poziomie pól |
Walidacja reguł biznesowych | Niska–Średnia; sformalizowanie i wersjonowanie reguł | Niska–Średnia; tworzenie reguł i zaangażowanie interesariuszy | Jasne audyty sukcesu/porażki; silny dowód zgodności (Compliance) | Procesy regulowane i kontrole deterministyczne (faktury, rabaty) | Możliwa do audytowania, wydajna w wykrywaniu systematycznych naruszeń reguł |
Uzgadnianie między systemami (Cross-System Reconciliation) | Średnia–Wysoka; mapowanie, okna czasowe, znajomość potoków danych | Średnie; integracje, zaplanowane porównania, moce obliczeniowe | Wykrywa utratę/uszkodzenie danych; waliduje spójność end-to-end | Wielosystemowe procesy ETL, systemy finansowe i raportowe | Ujawnia błędy transformacji/przesyłu wraz z dowodami naprawczymi |
Analiza statystyczna, historyczna i wykrywanie anomalii | Średnia; uczenie punktu odniesienia i strojenie modeli | Niska–Średnia; dane historyczne, wiedza analityczna | Ujawnia wartości odstające, trendy i sygnały stopniowej degradacji | Monitorowanie trendów, wczesne ostrzeganie o nowych problemach, nowe zbiory danych | Adaptacyjne wykrywanie problemów, które omijają reguły/kontrole referencyjne |
Porównanie z danymi referencyjnymi (Reference Data) | Niska; kontrole oparte na słownikach; zarządzanie wersjami referencji | Niska–Średnia; zarządzanie danymi referencyjnymi i ich aktualizacje | Zapewnia spójność kategoryczną/wymiarową oraz porównywalność | Standardowe kody/słowniki (kody ISO, stawki podatkowe, hierarchie produktów) | Wymusza standardy; zapobiega błędom agregacji/klasyfikacji |
Próbkowanie i weryfikacja ręczna | Niska złożoność, ale wysoki nakład pracy operacyjnej 🔄 | Wysokie; pracochłonne, wymaga przeszkolonego personelu, ograniczona skala ⚡ | Jakościowe dowody o wysokim poziomie pewności dla próbkowanych rekordów 📊 | Audyty, walidacja kontroli automatycznych, dowody regulacyjne | Wykrywa błędy, które omijają metody automatyczne; dostarcza kontekst przyczynowy |
Kompletność i terminowość jako wskaźniki dokładności | Niska–Średnia; definiowanie harmonogramów i punktów odniesienia 🔄 | Niska; narzędzia monitorujące; ustalanie progów; opcjonalne harmonogramowanie AI ⚡ | Wczesne ostrzeganie o brakujących/opóźnionych danych; zwiększa zaufanie do danych 📊 | Potoki danych z umowami SLA, raportowanie operacyjne, dane wrażliwe na czas | Proaktywne wykrywanie problemów z dostarczaniem potoków danych |
Zintegrowana, wielometodowa strategia monitorowania dokładności | Wysoka; koordynacja wielu technik i ich dostrajanie 🔄 | Wysokie; wiele modułów, integracja, ciągłe utrzymanie ⚡ | Kompleksowe pokrycie, szybsze reagowanie na incydenty, gotowość do audytu 📊⭐ | Kluczowe obszary (finanse, opieka zdrowotna, telekomunikacja, sektor publiczny) | Wielorakie linie dowodowe; wychwytuje różnorodne scenariusze błędów dokładności |
Przekształć kontrole dokładności w ciągły proces dowodowy
Żaden pojedynczy wskaźnik dokładności nie udowodni, że dane odzwierciedlają rzeczywistość w każdym kontekście. Procent dopasowanych rekordów może maskować obarczone błędem źródło referencyjne. Wynik walidacji może wskazywać, że rekordy są zgodne z regułami biznesowymi, pomijając jednocześnie błąd transformacji. Proces uzgadniania może ujawnić rozbieżność bez wyjaśnienia, czy odpowiada za nią źródło, cel czy też okno czasowe.
Praktycznym rozwiązaniem jest zbudowanie łańcucha dowodów. Zacznij od zdefiniowania planowanego zastosowania oraz poziomu błędu, jaki biznes może zaakceptować. Ustal zaufany punkt odniesienia – czy to system nadrzędny, zatwierdzone dane referencyjne, zweryfikowany rejestr transakcji czy też udokumentowana obserwacja ze świata rzeczywistego. Następnie określ, co stanowi dopasowanie i zapisz czas, wersję, odpowiedzialność oraz wyjątki stojące za tą decyzją.
Zapisz najważniejsze oczekiwania w postaci deterministycznych reguł. Reguły powinny chronić kluczowe wskaźniki, zobowiązania prawne, relacje i obliczenia. Testuj je na danych historycznych, zachowuj błędne rekordy wraz z dokładnymi przyczynami niepowodzeń i aktualizuj je przy zmianach produktów, polityk, schematów oraz procesów biznesowych.
Uzgadniaj metryki źródłowe i docelowe w punktach, w których dane się przemieszczają. Porównuj liczby rekordów, agregaty, pokrycie i profile, uwzględniając znane opóźnienia przetwarzania. Rozbieżność nie jest automatycznie dowodem na to, że cel jest niedokładny, ale stanowi sygnał, że potok danych wymaga zbadania.
Wykorzystaj wykrywanie anomalii i analizę historyczną, aby uzyskać kontekst, którego nie zapewnią sztywne kontrole. Nagłe przesunięcie może ujawnić błąd systemu źródłowego, uszkodzoną transformację, dryf schematu (schema drift) lub uzasadnione zdarzenie biznesowe. Analitycy powinni dokumentować wyjaśnienia, a nie tylko zamykać alerty. Taka historia usprawnia przyszłą klasyfikację i pomaga zespołom dostrajać punkty odniesienia bez wyciszania istotnych zmian.
Weryfikacja ręczna pozostaje istotna dla danych o wysokim ryzyku oraz do testowania, czy zautomatyzowane kontrole mierzą właściwe rzeczy. Próbkowanie może ujawnić systematyczne błędy, niejasne definicje referencyjne oraz kategorie błędów, których nie wychwyci żadna istniejąca reguła. Traktuj te wnioski jako wkład w projektowanie monitoringu.
Terminowość, kompletność i zmiany schematu działają jak systemy wczesnego ostrzegania. Spóźniony lub częściowy zbiór danych może być dokładny w odniesieniu do zawartych w nim rekordów, lecz niewiarygodny dla decyzji, którą ma wspierać. Zmiana strukturalna może unieważnić logikę odbiorczą bez generowania oczywistego błędu na poziomie pola. Monitorowanie tych wskaźników obok kontroli dokładności daje zespołom bardziej realistyczny obraz przydatności danych.
Platforma digna wspiera ten oparty na dowodach proces poprzez funkcje Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness oraz Schema Tracker. Zespoły mogą zacząć od zbiorów danych o wysokim wpływie, ustalić progi oparte na potrzebach biznesowych, dokumentować analizy i rozszerzać pokrycie w miarę ewolucji wymagań i zauważonych zagrożeń.
Niezależne opinie użytkowników pokazują również, dlaczego pomiary techniczne należy łączyć z percepcją interesariuszy. W badaniu użytkowników z 2023 roku, 72% respondentów oceniło dokładność danych statystycznych jako dobrą lub bardzo dobrą, przy średniej ocenie 4,03, podczas gdy inne badanie wykazało zaledwie 29,39% satysfakcji z jakości danych (Wyniki badania satysfakcji użytkowników z 2023 r.). Ten kontrast dowodzi, że zbiór danych akceptowalny technicznie i zbiór danych cieszący się zaufaniem to nie zawsze to samo.
Mierz zgodność z rzeczywistością, testuj wspierającą ją logikę, badaj zmiany zachowań i zachowuj dowody stojące za każdą decyzją. W ten sposób zespoły odpowiedzialne za dane przechodzą od zielonego wskaźnika w potoku przetwarzania do danych, z których mogą odpowiedzialnie korzystać.
Platforma digna zapewnia jakość danych i Observability bezpośrednio w środowisku pracy poprzez moduły Data Validation, Data Reconciliation, Data Anomalies, Data Analytics, Timeliness oraz Schema Tracker. Odwiedź digna, aby zobaczyć, jak Twój zespół może przekształcić kontrole dokładności w ciągły proces dowodowy w hurtowniach, jeziorach danych i potokach przetwarzania.



Poznaj zespół tworzący platformę
Zespół z Wiednia, składający się z ekspertów od AI, danych i oprogramowania, wspierany rygorem akademickim i doświadczeniem korporacyjnym.