Czym jest dryf danych i jak mu zapobiegać?
|
5
min. czyt.

Masz pulpit nawigacyjny, który w poniedziałek wyglądał dobrze, model, który przeszedł walidację w zeszłym miesiącu, i interesariusza pytającego, dlaczego dzisiejsze liczby wydają się „nie takie”. Tak zazwyczaj objawia się dryft danych (data drift) – poprzez błędną prognozę, dziwną rekomendację lub raport, który nie pasuje już do tego, co widzą zespoły w terenie.
Denerwujące jest to, że nic nie musi się „popsuć” w oczywisty sposób. Potok może działać dalej, tabele mogą się zapełniać, a model wciąż może zwracać pewne odpowiedzi. Główny problem polega na tym, że świat poszedł do przodu, podczas gdy Twój stos danych pozostał zakotwiczony w jego starszej wersji.
Kiedy dobre modele schodzą na złą drogę: Ciche zagrożenie dryftem danych
Model, który zachowywał się idealnie podczas testów, może zacząć podejmować dziwne decyzje na produkcji, a pierwszą oznaką często nie jest czerwony komunikat o błędzie. To zespół ds. sprzedaży kwestionujący pulpit nawigacyjny, zespół ds. finansów uzgadniający niedopasowane liczby lub kierownik ds. operacyjnych pytający, dlaczego te same dane wejściowe prowadzą teraz do innej decyzji. Ta luka między „wczoraj działało” a „dzisiaj nie ma sensu” to miejsce, w którym żyje dryft danych (data drift).
W praktyce dryft danych (data drift) oznacza, że właściwości statystyczne danych wejściowych zmieniają się w czasie, więc rozkład treningowy nie odpowiada już warunkom rzeczywistym. To niedopasowanie może przenikać do warstw BI, przepływów raportowania i zautomatyzowanych decyzji, a nie tylko do wyników uczenia maszynowego. W Hiszpanii stało się to trudniejsze do zignorowania, ponieważ z raportu Komisji Europejskiej DESI 2022 wynika, że 75% przedsiębiorstw miało już przynajmniej podstawowy poziom intensywności cyfrowej, powyżej średniej UE wynoszącej 69% (Kontekst DESI 2022 dla Hiszpanii).
Dlatego problemem nie jest tylko jakość modelu. To ciągłość działania. Gdy większość biznesu opiera się już na danych, niewielka zmiana w transakcjach, zachowaniach klientów lub wzorcach schematów może szybko rozprzestrzenić się na resztę stosu. Ryzyko objawia się najpierw jako dezorientacja, potem jako złe decyzje, a na końcu jako utrata zaufania do liczb.
Dbaj o wiarygodność modelu dzięki kontrolom jakości danych
Praktyczna zasada: jeśli interesariusze pytają „dlaczego to wygląda źle?” zanim zapytają „jak dokładny jest model?”, masz już do czynienia z problemem obserwowalności (observability), a nie modelowania.
Problem Statku Tezeusza w Twoich danych
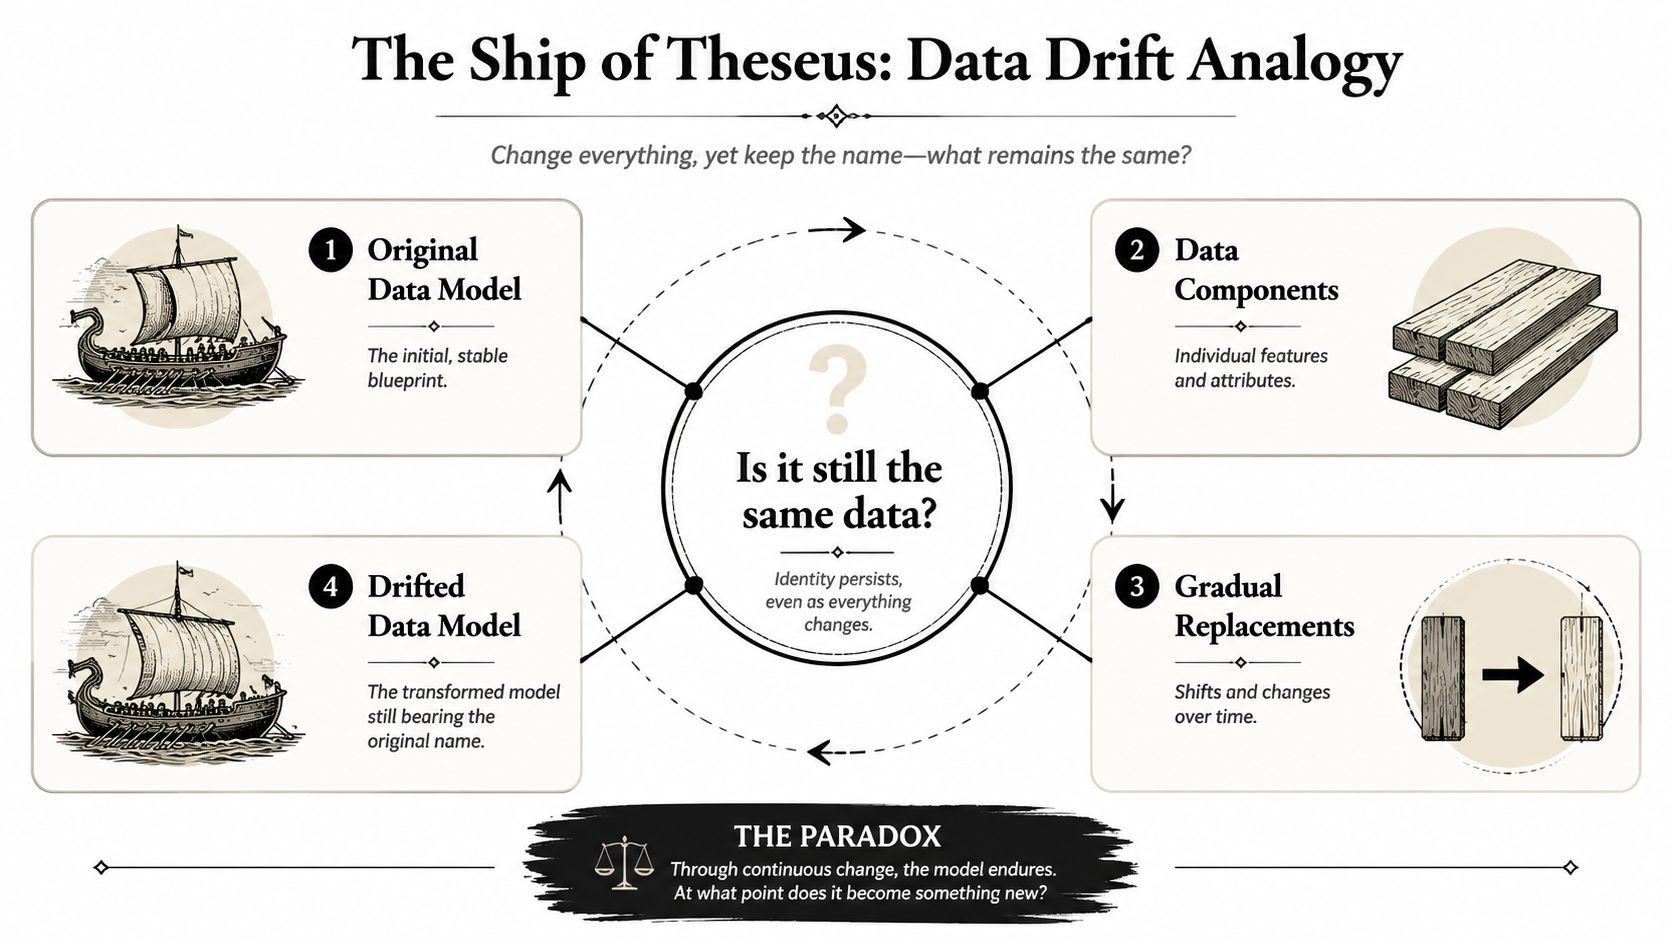
Dryft danych (data drift) dobrze wpisuje się w paradoks Statku Tezeusza. Potok może zachować tę samą nazwę, te same tabele, a nawet ten sam tytuł pulpitu nawigacyjnego, podczas gdy jego zawartość powoli przestaje odpowiadać danym, na których został zbudowany. Jedna cecha zaczyna przychodzić z innymi wartościami, inna przychodzi z opóźnieniem, źródło ponownie używa etykiety kategorii dla czegoś nieco innego, a aktywny zestaw danych staje się innym obiektem, mimo że nikt nie zmienił jego nazwy.
To właśnie sprawia, że dryft jest trudny do wykrycia na produkcji. Zazwyczaj nie pojawia się jako jedna, oczywista awaria. Wkrada się jako drobne podstawienia, które same w sobie wyglądają nieszkodliwie, a następnie zmieniają ogólny rozkład na tyle, by wpłynąć na zachowanie raportów, alertów i modeli. W praktyce zespoły potrzebują monitorowania dryftu i porównywania rozkładów, ponieważ czekanie na widoczną awarię biznesową oznacza, że niedopasowanie rozprzestrzeniło się już w całym stosie.
Powolny dryft i nagłe przesunięcie to nie to samo
Powolny dryft przypomina obserwowanie zmian linii brzegowej po kolejnych przypływach. Zmiana istnieje, ale zauważasz ją dopiero wtedy, gdy porównasz dzisiejsze dane z zestawem referencyjnym z zeszłego miesiąca. Nagłe przesunięcie przypomina raczej zamknięcie drogi po burzy. Wczorajsza trasa nadal istnieje w pamięci, ale nie sprawdza się już w bieżących operacjach.
Powolny dryft zazwyczaj pojawia się w strukturze klientów, wzorcach transakcji i zachowaniach sezonowych. Nagłe przesunięcia zazwyczaj wynikają z wydania nowej wersji, zmiany przepisów lub aktualizacji systemu źródłowego. Błędem jest traktowanie obu przypadków jako jednego problemu z dokładnością i nadzieja, że ponowne trenowanie naprawi wszystko na raz.
W europejskich strukturach raportowania ta różnica ma znaczenie poza samym modelem. Powolna zmiana w kanale przychodów może zniekształcać pulpity finansowe przez tygodnie, zanim ktokolwiek to zauważy. Nagła zmiana schematu może popsuć raporty zgodności (compliance), sfrustrować audytorów i zmusić zespoły do szukania fałszywego błędu w warstwie BI, podczas gdy system źródłowy działa dalej. Ten sam potok może wyglądać zdrowo na papierze, a jednocześnie podawać błędne dane w miejscach, w których zapadają decyzje biznesowe.
Zmiany strukturalne mogą uszkodzić Twój potok
Stabilna etykieta na niestabilnych danych to jeden z najprostszych sposobów na utratę zaufania.
Główni podejrzani stojący za katastrofą dryftu danych
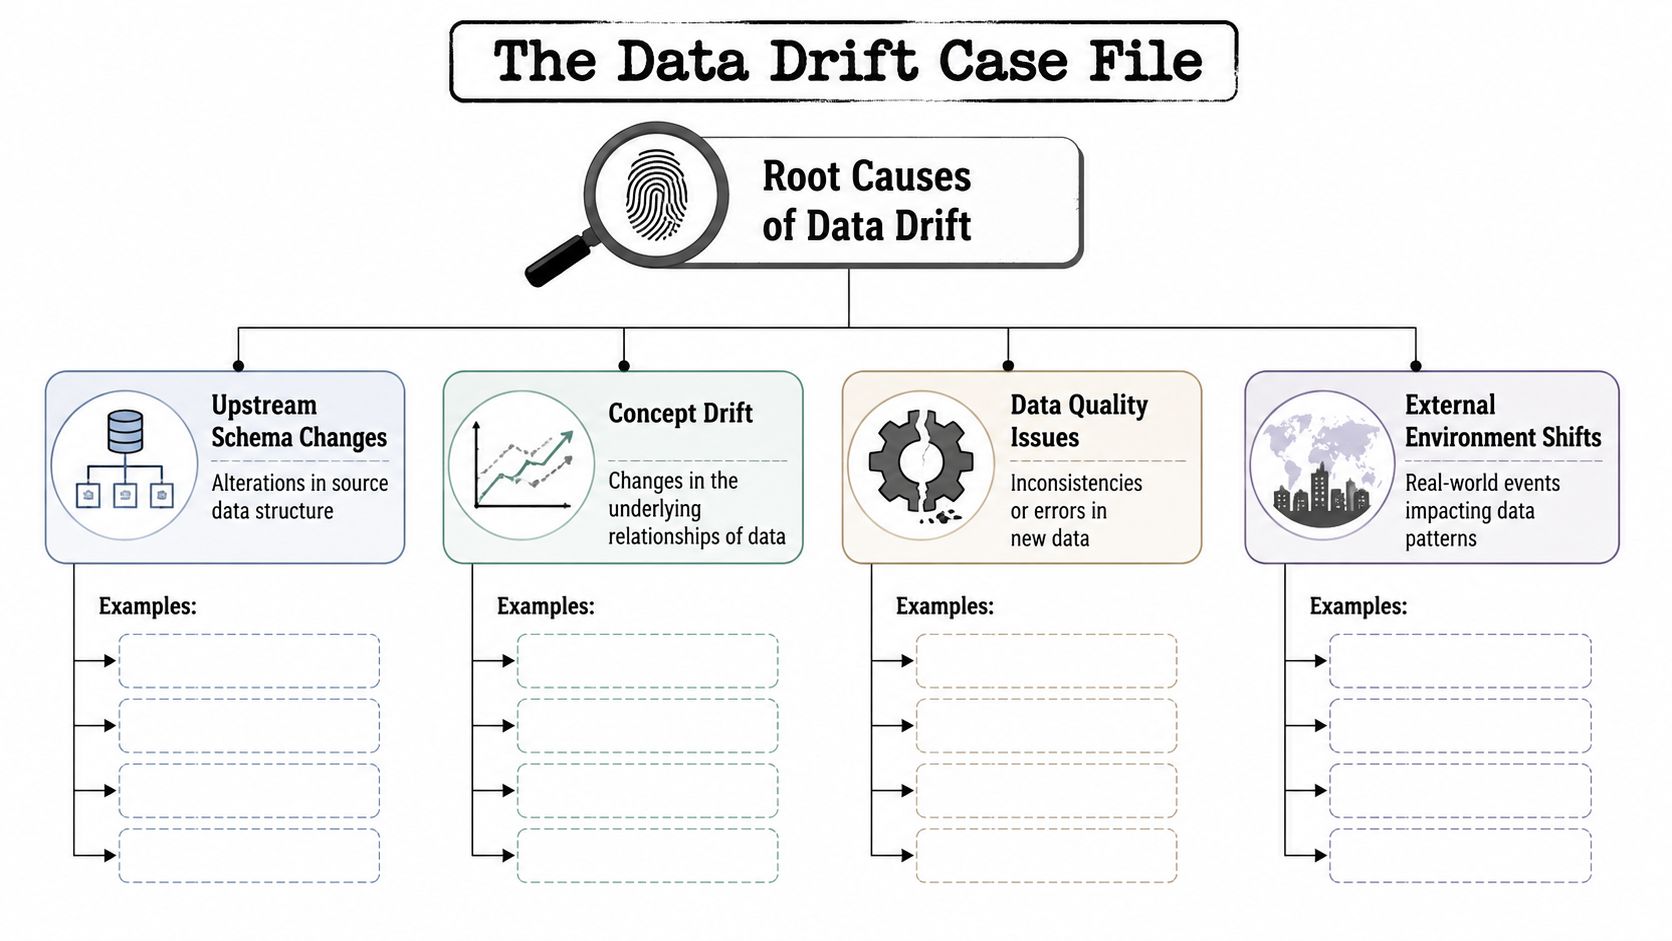
Najszybszym sposobem na zdiagnozowanie dryftu jest przyjrzenie się miejscom, w których zmiana zazwyczaj wchodzi do systemu. W hiszpańskich przedsiębiorstwach ma to większe znaczenie niż w czystym środowisku demonstracyjnym, ponieważ Państwowy Urząd Statystyczny poinformował w 2024 r., że 78,7% dużych przedsiębiorstw korzysta z usług chmury obliczeniowej, co oznacza więcej ruchomych części, więcej zależności i więcej miejsc, w których zachowanie może ulec zmianie (korzystanie z chmury a ryzyko dryftu w Hiszpanii). Złożony stos sam w sobie nie tworzy dryftu, ale daje mu więcej dróg wejścia.
Cztery miejsca, w których zazwyczaj zaczyna się dryft
Zmiany schematu na wyższym szczeblu: nazwa kolumny zostaje zmieniona, typ ulega zmianie lub pole znika. Pulpity nawigacyjne przestają pasować, potoki cech błędnie odczytują wartości, a raporty oddalają się od prawdy źródłowej.
Dryft koncepcyjny: zmienia się zależność między danymi wejściowymi a wynikami. Wzorzec, który dawniej sygnalizował jedną rzecz, nie oznacza już tego samego.
Problemy z jakością danych: brakujące wartości, zduplikowane rekordy, opóźnione ładowanie i błędnie sformatowane wpisy subtelnie zniekształcają zarówno analitykę, jak i dane wejściowe do modeli.
Zmiany w otoczeniu zewnętrznym: zachowania rynkowe, zmiany w przepisach i zakłócenia operacyjne zmieniają rytm danych bez ostrzeżenia.
Przyczyna, dla której te sytuacje są tak bolesne, tkwi w tym, że nie wpływają one wyłącznie na dokładność modelu. Mogą one zakłócić raportowanie ustawowe, zniekształcić aktualność BI i sprawić, że analityka skierowana do klientów będzie wyglądać na wiarygodną, mimo że jest przestarzała. W środowiskach silnie opartych na chmurze podatność na błędy jest rozproszona na więcej usług, harmonogramów i kanałów danych, dlatego zespoły muszą myśleć w kategoriach łańcuchów zależności, a nie tylko tabel.
Jednym z przydatnych nawyków jest śledzenie każdego uszkodzonego wskaźnika wstecz do pierwszego systemu, który uległ zmianie, a nie do ostatniego, który uległ awarii. Tam zazwyczaj kryje się główna przyczyna.
Twój zestaw narzędzi detektywistycznych do walki z dryftem danych
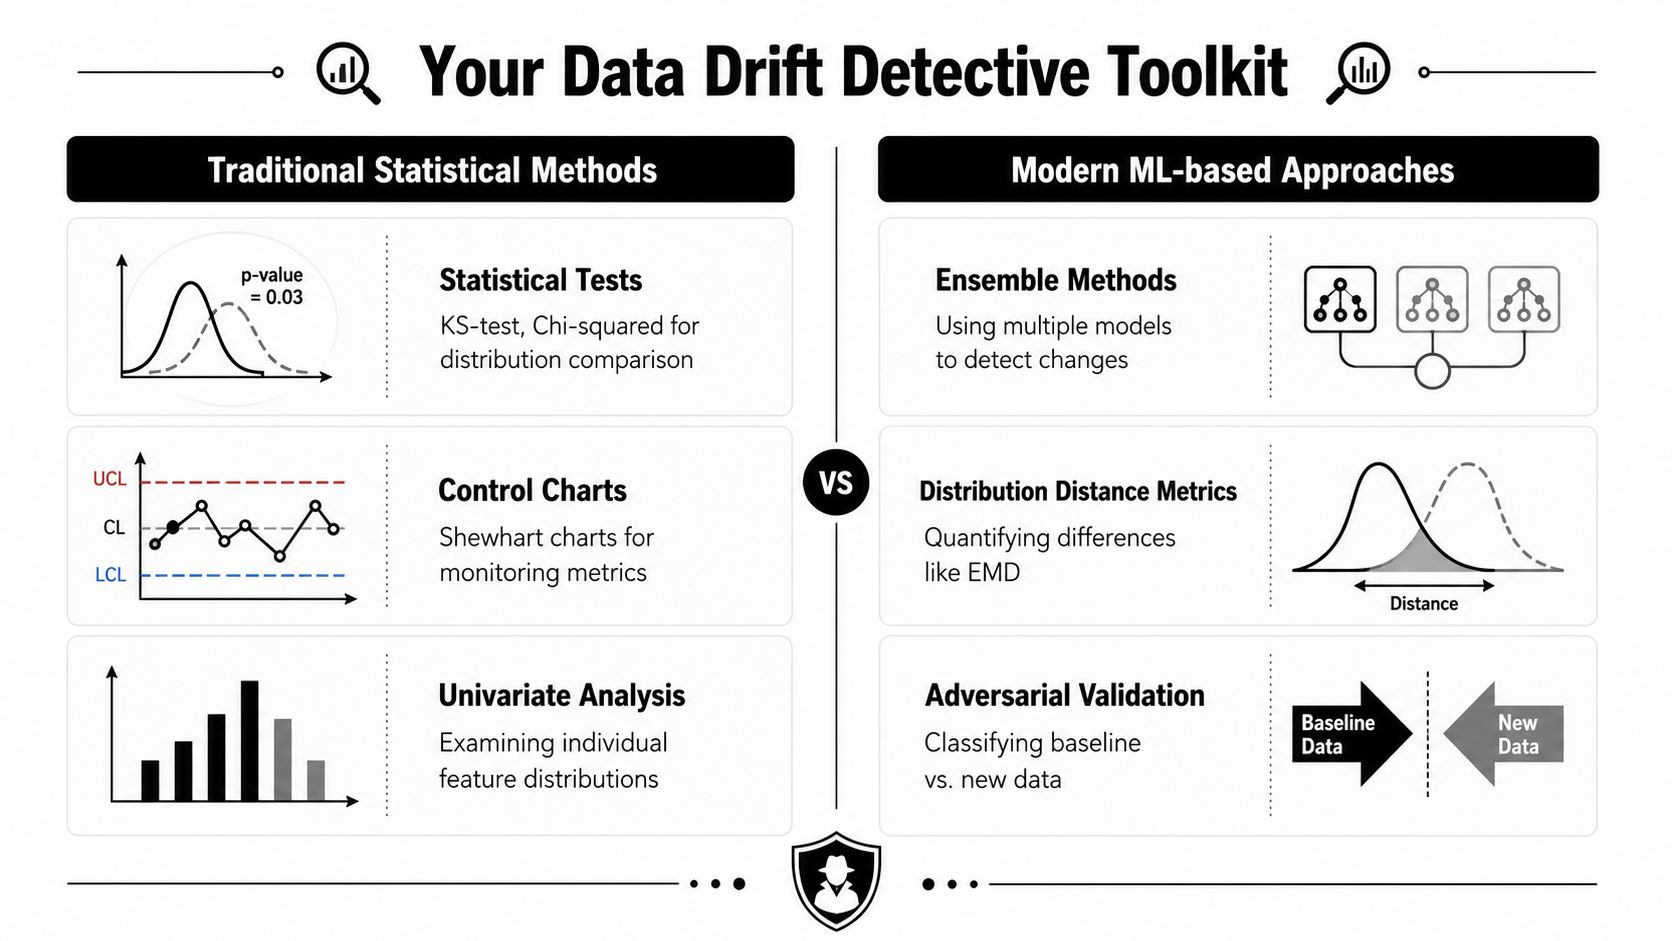
Detektor dryftu dobrze wykonuje jedno zadanie. Odpowiada na pytanie, czy aktywne dane wciąż są zgodne z linią bazową, i robi to, zanim przestarzały kanał zmieni się w uszkodzony pulpit nawigacyjny, wprowadzający w błąd raport lub problem z compliance. W europejskim stosie raportowania ma to tak samo duże znaczenie dla świeżości BI, jak i dla dokładności modelu.
Tradycyjne metody statystyczne wciąż na siebie zarabiają, ponieważ są jasne i łatwe do obrony. Nowoczesne narzędzia do Observability dodają ciągłe monitorowanie, dzięki czemu zespoły nie muszą czekać, aż ktoś zauważy, że wykres wygląda dziwnie, lub użytkownik końcowy zgłosi skargę.
Strona statystyczna
Tradycyjne narzędzia są proste i dlatego pozostają w użyciu. Test Kołmogorowa-Smirnowa porównuje dwa rozkłady i pokazuje, czy się różnią. Test chi-kwadrat nadaje się do przesunięć kategorialnych. Miary odległości, takie jak dywergencja Jensena-Shannona i wskaźnik stabilności populacji (PSI), pomagają zmierzyć, jak daleko obecna partia oddaliła się od zestawu referencyjnego (typowe metody porównywania dryftu).
Metody te sprawdzają się najlepiej, gdy zespół wie, które pola mają znaczenie i chce mieć jasny próg działania. Są mniej pomocne, gdy problem tkwi wewnątrz podgrupy, opóźnionego pliku lub niewielkiej kombinacji zmian rozproszonych w kilku kolumnach. Pojedynczy wynik podsumowujący może przeoczyć taki dryft, a w praktyce tak właśnie powstaje czysto wyglądający raport, który mimo to zawiera błędy.
Strona observability
Platforma taka jak digna pasuje do operacyjnej strony problemu. Potrafi uczyć się normalnego zachowania, śledzić anomalie w potoku i ujawniać zmiany strukturalne bez konieczności ręcznego utrzymywania każdej reguły przez analityka. Ma to znaczenie, gdy stos zawiera zbyt wiele tabel, harmonogramów i odbiorców końcowych, by kontrolować je pojedynczo.
Praktyczna zasada: używaj testów statystycznych do precyzji, a Observability do pokrycia. Jeśli masz tylko jedno z nich, coś na pewno umknie Twojej uwadze.
Najsilniejsze zespoły łączą oba podejścia. Porównują partie z linią bazową, obserwują zmiany rozkładu na poziomie cech, a także pilnują terminowości i zmian schematów. W ten sposób opóźniony plik, złe złączenie i rzeczywiste przesunięcie rozkładu nie trafią do tego samego ogólnego alertu. Szybki przykład tego, jak monitorowanie anomalii może ujawnić problemy, zanim się rozprzestrzenią, znajduje się w sekcji Wykrywaj problemy wcześnie, zanim się rozprzestrzenią.
Budowanie systemu obrony przed dryftem danych
Najsilniejsza obrona przed dryftem jest nudna, zdyscyplinowana i ciągła. Potrzebujesz jasnych kontraktów danych (Data Contract), wersjonowanych danych wejściowych, monitorowanych linii bazowych i alertów, które uruchamiają się w przypadku rzeczywistej zmiany, a nie przy każdym niegroźnym wahaniu. Jeśli zespół sprawdza błędy dopiero wtedy, gdy model zaczyna zawodzić, jest już za późno na utrzymanie zaufania do wyników.
Buduj z myślą o całej ścieżce danych, a do nie tylko o modelu
Zacznij od kontraktów, które definiują, jak powinny wyglądać dobre dane wejściowe. Następnie wersjonuj dane i model razem, aby móc stwierdzić, czy zmiana pochodzi ze źródła, czy z algorytmu. Na koniec dodaj monitorowanie, które śledzi zarówno zawartość, jak i czas dostarczenia, ponieważ opóźniony plik może zaszkodzić pulpitowi nawigacyjnemu w takim samym stopniu jak plik uszkodzony.
Znaczenie ma tutaj świadomość segmentów. Przesunięcie może istnieć w jednej linii produktów lub w jednej kohorcie klientów, podczas gdy zagregowane wskaźniki wciąż wyglądają dobrze – i tak właśnie wkrada się fałszywa pewność siebie. Monitorowanie odpowiedniego wycinka danych zmniejsza liczbę wyników fałszywie negatywnych i pomaga skierować działania naprawcze tam, gdzie powinny trafić (wykrywanie dryftu uwzględniające segmenty).
Dbaj o to, by alerty były użyteczne
Znużenie alertami zabija Observability szybciej niż dryft. Jeśli każde drobne wahanie wywołuje ten sam poziom ważności, ludzie przestają zwracać na nie wagę. Dobra konfiguracja odróżnia zmiany schematu, problemy z czasem od rzeczywistej zmiany rozkładu, a następnie kieruje każdy problem do odpowiedniego właściciela.
Kontrakty danych (Data Contract) zamieniają jakość we wspólne oczekiwanie
Używaj monitorowania, aby zawęzić promień rażenia. Łatwiej zignorować hałaśliwy alert, niż później odkryć cichą awarię.
Jak stać się czujnym zespołem ds. danych
Dla organizacji w Hiszpanii i w całej UE dryft to nie tylko uciążliwość inżynieryjna. Wpływa on na Compliance, raportowanie i odporność operacyjną, ponieważ RODO (GDPR), egzekwowane przez organy takie jak AEPD, wymaga, aby dane były dokładne i integralne (Oczekiwania RODO w zakresie dokładności i integralności). Jeśli rekordy, schematy lub wzorce dostarczania dryfują bez wiedzy nikogo, niedokładne dane mogą przedostać się do profilowania, raportowania i zautomatyzowanych decyzji, zanim ktokolwiek zdąży je wychwycić.
Dlatego właściwym podejściem nie jest „monitorowanie modelu”, lecz „ochrona środowiska danych”. Model jest tylko jednym z konsumentów tego środowiska. Finanse, BI, Compliance i operacje zależą od tych samych sygnałów, a cicha zmiana w tych sygnałach może stać się problemem biznesowym na długo przed tym, jak stanie się błędem modelowania.
Użyj listy kontrolnej niezawodności, aby uszczelnić swoje kontrole
Czujny zespół ds. danych traktuje dryft danych (data drift) jako kwestię ciągłości działania, a nie poboczne zadanie dla MLOps. Obserwuje zmiany struktury rozkładów, śledzi wersje, sprawdza świeżość i dba o jasną odpowiedzialność, gdy coś się zmienia. Na tym polega różnica między systemami, które po prostu działają, a systemami, którym ludzie wciąż mogą zaufać w gorszy dzień.
Zarezerwuj spersonalizowaną wersję demonstracyjną i zobacz, jak digna Schema Tracker stale monitoruje skonfigurowane tabele pod kątem dodawania, usuwania, zmiany nazw kolumn oraz zmian typów danych.
Najczęściej zadawane pytania
Czym jest data drift?
Data drift to zmiana właściwości statystycznych danych wejściowych w czasie, przez którą rozkład treningowy przestaje odpowiadać rzeczywistym warunkom. Artykuł podkreśla, że problem wykracza poza machine learning: rozbieżność może przenikać do warstw BI, procesów raportowych i zautomatyzowanych decyzji, podczas gdy pipeline'y nadal działają normalnie.
Co powoduje data drift?
Większość dryfu ma cztery źródła: zmiany schematu w systemach źródłowych, takie jak zmieniona nazwa kolumny lub typ, concept drift, gdy dane wejściowe inaczej wiążą się z wynikami, problemy z jakością danych, np. brakujące wartości lub opóźnione ładowania, oraz zmiany zewnętrzne na rynku, w regulacjach lub operacjach. Prześledź błędną metrykę do pierwszego systemu, który się zmienił.
Jak wykryć data drift za pomocą testów statystycznych?
Test Kołmogorowa-Smirnowa porównuje dwa rozkłady, test chi-kwadrat sprawdza się przy zmianach kategorialnych, a miary odległości, takie jak dywergencja Jensena-Shannona i Population Stability Index (PSI), określają, jak daleko partia danych odeszła od zbioru referencyjnego. Metody te działają najlepiej, gdy wiadomo, które pola są istotne, i potrzebne są jasne progi.
Czym różni się powolny data drift od nagłej zmiany?
Powolny dryf narasta stopniowo, często w strukturze klientów, wzorcach transakcji lub zachowaniach sezonowych, i ujawnia się dopiero po porównaniu dzisiejszych danych ze zbiorem referencyjnym z poprzedniego miesiąca. Nagła zmiana zwykle następuje po wdrożeniu, zmianie regulacji lub aktualizacji systemu źródłowego. Częstym błędem jest traktowanie obu przypadków jako jednego problemu dokładności, który rozwiąże ponowne trenowanie.
Czy ponowne trenowanie modelu wystarczy, aby zatrzymać data drift?
Nie. Artykuł zaleca obronę opartą na kontraktach danych, wspólnym wersjonowaniu danych i modelu, monitorowaniu treści oraz terminowości, a także kontrolach na poziomie segmentów, ponieważ zmiana może ukrywać się w jednej linii produktów, gdy agregaty wyglądają poprawnie. Łącz testy statystyczne dla precyzji z observability dla pokrycia i kieruj każdy alert do właściwego właściciela.



