Apache Iceberg: przewodnik praktyka
|
8
min. czyt.

Wdrożyłeś Apache Iceberg, zarejestrowałeś kilka tabel i skierowałeś Sparka na pamięć obiektową. Pierwszy incydent produkcyjny zwykle przychodzi, zanim architektura wyda się skończona: zapytanie niżej w łańcuchu czyta nieoczekiwany schemat, zmiana partycji zachowuje się inaczej w Trino albo nikt nie wie, które snapshoty można bezpiecznie usunąć. Pliki Parquet rzadko są trudną częścią. Prawdziwą pracą są własność, koordynacja katalogów, utrzymanie metadanych i dowody na to, że tabela jest wiarygodna.
Wartość Apache Iceberg bierze się z oddzielenia stanu tabeli od fizycznego układu plików. To rozdzielenie wspiera niezawodną analitykę w wielu silnikach, ale oznacza też, że zespoły potrzebują praktyk eksploatacyjnych wykraczających poza specyfikację formatu. Ten przewodnik traktuje otwarty format tabeli Apache Iceberg jako dyscyplinę platformową, z wyraźnymi granicami między pamięcią masową, katalogami, silnikami, utrzymaniem i obserwowalnością.
Spis treści
Dlaczego Iceberg to dyscyplina operacyjna, a nie tylko format pliku
Snapshoty, manifesty, ukryte partycjonowanie i podróż w czasie
Dobre praktyki partycjonowania, sortowania i rozmiaru plików
Eksploatacja tabel Iceberg z myślą o schemacie, jakości i Timeliness
Dlaczego Iceberg to dyscyplina operacyjna, a nie tylko format pliku
Zespół może szybko wdrożyć Iceberga i wciąż nie mieć odpowiedzi na pytania, które liczą się na produkcji. Kto odpowiada za wygasanie snapshotów? Który zespół zatwierdza zmianę schematu? Jak wykryć, że producent dodaje pole o niezgodnym znaczeniu? Co się dzieje, gdy Spark i Trino inaczej interpretują transformację partycji, bo ich konfiguracja katalogu lub konektora się rozjechała?
Iceberg zaczął się w Netfliksie w 2017 roku, by zaadresować ograniczenia skalowalności i spójności w tabelach Apache Hive. Netflix przekazał go Apache Software Foundation w listopadzie 2018, a w maju 2020 stał się projektem Apache najwyższego poziomu, jak podaje historia wydań projektu. Te kamienie milowe tłumaczą inżynierskie ukierunkowanie formatu, ale nie zdejmują odpowiedzialności operacyjnej, która pojawia się po wdrożeniu.
Fizyczna warstwa danych jest stosunkowo prosta. Silniki zapisują pliki, zwykle Parquet, do pamięci obiektowej. Trudna praca zaczyna się wokół tych plików:
Nadzór nad katalogiem: zdecyduj, kto może tworzyć, zmieniać, usuwać lub promować tabele i jak rozstrzygane są identyfikatory między środowiskami.
Higiena metadanych: kontroluj retencję snapshotów, usuwaj osierocone pliki i monitoruj przyrost manifestów.
Koordynacja silników: przetestuj, jak Spark, Flink, Trino i inni czytelnicy obsługują ten sam schemat, specyfikacje partycji, usunięcia i reguły izolacji.
Dowody: powiąż jakość danych, świeżość, pochodzenie i historię wdrożeń z konkretnym stanem tabeli.
Reguła praktyczna: traktuj każdą tabelę Iceberg jak zarządzany produkt z osobą odpowiedzialną, polityką eksploatacji i obserwowalnym cyklem życia.
Właśnie tu wpisuje się obserwowalność danych. Obserwowalność nie zastępuje katalogu ani silnika zapytań. Dostarcza dowodów potrzebnych, by odpowiedzieć, czy tabela jest teraz zdrowa, czy zmiana spowodowała regresję i czy inżynierka na dyżurze może zaufać bieżącemu snapshotowi.
Wydajność i poprawność rozstrzygają się w tej warstwie operacyjnej. Iceberg daje zespołom mocne elementy, ale platforma, która nie planuje utrzymania, nie koordynuje dostępu i nie monitoruje zachowania, wciąż będzie produkować niewiarygodne dane.
Podstawowe elementy tabeli Iceberg
Dobry model myślowy zaczyna się od zbioru fotografii. Zdjęcia to wiersze, foldery opisują grupy zdjęć, indeks albumu mówi, gdzie szukać, a katalog biblioteczny mówi, która kolekcja jest bieżąca.
Na samym dole pliki danych Parquet przechowują rzeczywiste wiersze w pamięci obiektowej. Parquet to kolumnowy format pliku, a Iceberg zarządza odwołaniami do tych plików, zamiast zmuszać czytelników do odkrywania ich przez skanowanie nazw katalogów. Skupione wyjaśnienie warstwy plików znajdziesz w tekście o tym, czym jest Parquet i jak działa.
Pliki manifestów działają jak uporządkowane teczki ze wskaźnikami do plików danych, wraz z informacjami pomagającymi silnikom zdecydować, które pliki są istotne. Lista manifestów to indeks konkretnego snapshotu. Wskazuje manifesty tworzące ten stan tabeli, dzięki czemu planista może zacząć od jednego uporządkowanego punktu wejścia, zamiast przeszukiwać całą pamięć obiektową.
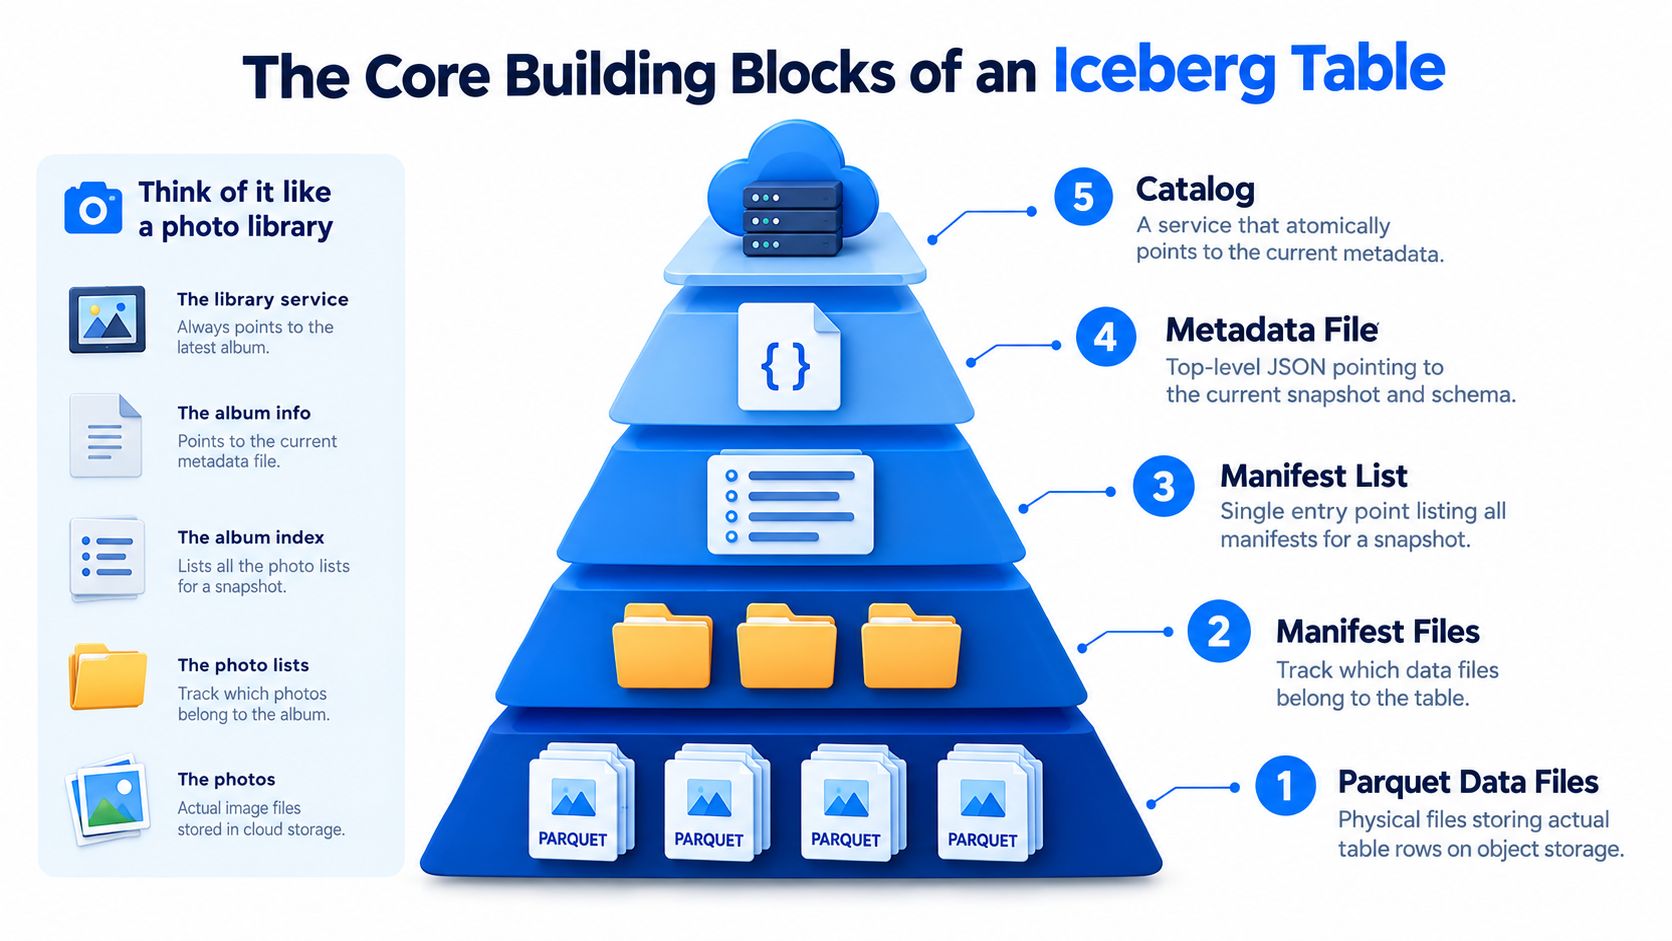
Warstwy metadanych i katalogu
Plik metadanych tabeli to karta katalogowa biblioteki. Iceberg przechowuje stan tabeli w metadanych JSON, w tym schematy, specyfikacje partycji, historię snapshotów i pochodzenie rodzic-dziecko. Snapshoty są osadzone w metadanych tabeli, a nie serializowane jako odrębny system stanu, co pozwala czytelnikom odtworzyć tabelę w danym punkcie czasu z dziennika snapshotów i informacji o pochodzeniu, jak opisuje specyfikacja tabel Iceberg.
Katalog trzyma atomowy wskaźnik na bieżący plik metadanych. Zapisujący tworzy nowe dane i metadane, a potem aktualizuje ten wskaźnik przez mechanizm commitu katalogu. Czytelnicy rozstrzygają identyfikator tabeli przez katalog, ustalają lokalizację bieżących metadanych i planują wobec manifestów wskazanych przez wybrany snapshot.
Model do wielokrotnego użytku jest prosty:
Pliki danych przechowują wiersze.
Pliki manifestów śledzą wpisy o plikach danych.
Listy manifestów wskazują manifesty danego snapshotu.
Metadane zapisują schematy, specyfikacje partycji, snapshoty i pochodzenie.
Katalog wskazuje atomowo bieżące metadane.
Ta pośredniość jest fundamentem atomowych commitów i odczytów niezależnych od silnika. Tłumaczy też, dlaczego ręczne usuwanie plików albo zmiana ścieżek w pamięci obiektowej poza procedurami Iceberga może naruszyć integralność tabeli.
Snapshoty, manifesty, ukryte partycjonowanie i podróż w czasie
Zapis w Icebergu zmienia stan tabeli przez commit nowego snapshotu. Snapshot zapisuje nowy punkt w historii tabeli i odwołuje się do listy manifestów opisującej pliki widoczne w tym punkcie. Ponieważ Iceberg trzyma historię snapshotów i pochodzenie rodzic-dziecko w metadanych, czytelnik może odtworzyć nie tylko najnowszy stan, lecz także wcześniejsze stany zatwierdzone.
Kolejność ma znaczenie:
Zapisujący tworzy lub przygotowuje nowe pliki danych.
Commit tworzy nowy snapshot.
Lista manifestów wskazuje manifesty dla tego snapshotu.
Czytelnicy używają metadanych manifestów i statystyk plików, by ograniczyć pracę.
Zapytanie historyczne może wybrać wcześniejszy snapshot zamiast bieżącego.
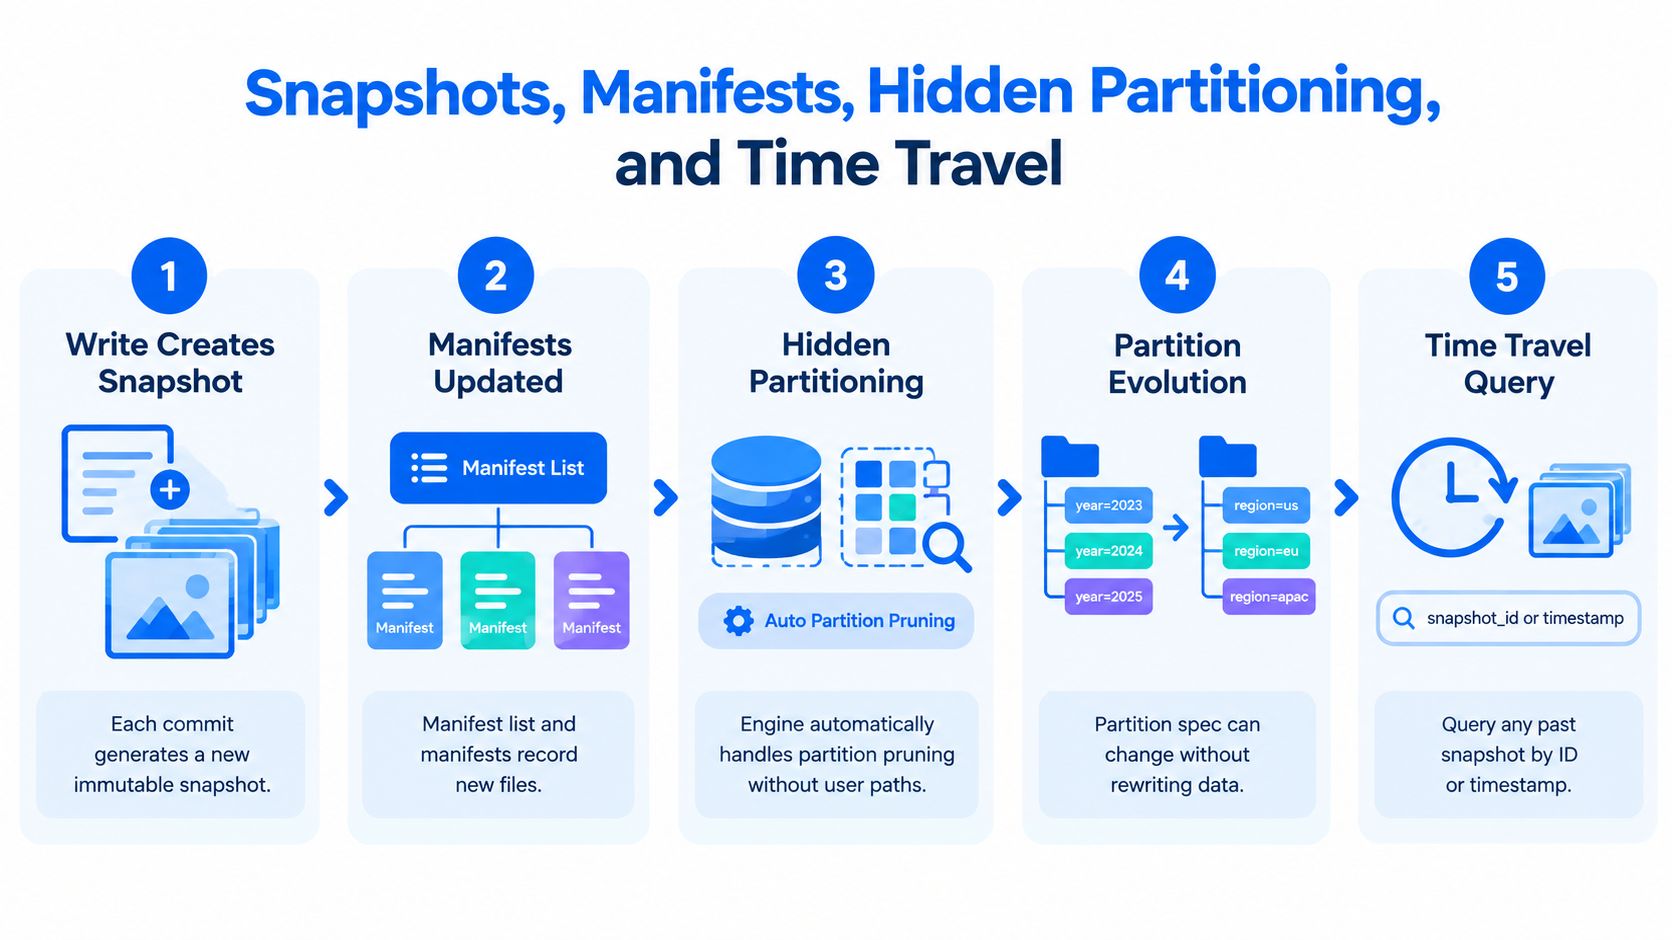
Ukryte partycjonowanie zdejmuje z zapytań logikę ścieżek
Iceberg zapisuje transformacje partycji w metadanych. Transformacja taka jak wyciągnięcie daty, bucketowanie czy skracanie może kierować przycinaniem, nie wymagając od użytkowników pisania filtrów wobec fizycznych kolumn partycji ani ścieżek pamięci obiektowej. Silnik interpretuje informacje o partycjach tabeli podczas planowania, co utrzymuje SQL przy kolumnach biznesowych.
To nie znaczy, że partycjonowanie staje się automatycznym strojeniem wydajności. Silnik wciąż potrzebuje użytecznych statystyk, sensownego układu plików i specyfikacji partycji pasującej do obciążenia zapytaniami. Ukryte partycjonowanie usuwa całą klasę błędów ścieżek po stronie użytkownika, ale nie uratuje nieodpowiedniego projektu.
Ewolucja bez przepisywania historii
Ewolucja partycji dotyczy wyłącznie metadanych. Zespół może zmienić specyfikację partycji, zostawić stare dane w pierwotnym układzie fizycznym i zapisywać nowe pod nową specyfikacją, jak dokumentuje ewolucja partycji w Icebergu. Tabela śledzi każdą wersję partycji osobno.
Ta elastyczność jest cenna, gdy zmieniają się wzorce dostępu. Tworzy też obowiązek planistyczny, bo silniki zapytań muszą interpretować wiele specyfikacji partycji w jednej tabeli. Korzyścią jest uniknięcie dużego zadania przepisania, kosztem są bardziej złożone metadane i planowanie.
Podróż w czasie staje się wtedy praktycznym narzędziem diagnostycznym. Odpytaj starszy snapshot, porównaj jego wyniki z bieżącym stanem, zbadaj zmianę i wróć do najnowszego snapshotu. Model zatwierdzonych snapshotów Iceberga daje izolację snapshotów, więc czytelnicy widzą spójny zatwierdzony stan, gdy zapisujący atomowo tworzą nowe. Dla pracy z danymi historycznymi ten sam wzorzec bywa przydatny poza Icebergiem, co pokazuje ten przewodnik po analizie danych historycznych.
Apache Iceberg kontra Delta Lake i Apache Hudi
Wybieranie formatu tabeli po liczbie funkcji to kiepska metoda produkcyjna. Użyteczne porównanie dotyczy zachowania metadanych, zasięgu silników i semantyki odczytów historycznych, a następnie obciążenia i ograniczeń nadzoru, które twoja platforma jest w stanie unieść.
Wymiar | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Model metadanych | Metadane oparte na snapshotach, z listami manifestów i manifestami opisującymi pliki tabeli i wspierającymi planowanie | Łańcuch plików JSON | Oś czasu commitów zaprojektowana wokół zmian na poziomie rekordów i operacji zorientowanych strumieniowo |
Najmocniejszy profil silnikowy | Szerokie użycie w wielu silnikach: Spark, Flink, Trino, Presto, Impala, Dremio i Snowflake | Najmocniejszy w środowiskach skupionych na Sparku | Najmocniejszy przy upsertach strumieniowych i przetwarzaniu przyrostowym |
Model podróży w czasie | Odczyty celują w zatwierdzone snapshoty, a retencją sterują operacje na tabeli | Odczyty zależą od zachowanej historii dziennika transakcji i punktów kontrolnych | Odczyty zależą od skonfigurowanej osi czasu commitów i okna retencji |
Główny kompromis produkcyjny | Koordynacja między katalogami i silnikami wymaga świadomego nadzoru | Przenośność bywa trudna poza najmocniejszym ekosystemem | Wybór między merge-on-read a copy-on-write dokłada złożoności operacyjnej |
Model metadanych Iceberga oddziela stan tabeli od plików danych. Silniki mogą używać list manifestów i statystyk na poziomie plików, by ograniczyć pracę planowania, nie wymagając od każdego czytelnika interpretowania konwencji katalogów. Łańcuch dziennika Delty skutecznie zapisuje zmiany, ale szeroka inspekcja historii może stać się kwestią zarządzania dziennikiem. Oś czasu Hudi naturalnie pasuje do aktualizacji strumieniowych, zwłaszcza tam, gdzie obciążeniu przewodzą konsumpcja przyrostowa i upserty.
Zasięg silników zmienia, jak ta sama tabela zachowuje się w praktyce. Spark i Flink mogą zapisywać tabele Iceberg i uczestniczyć w protokołach commitu, tworząc nowe snapshoty atomowo. Trino i Presto bywają używane jako planiści zorientowani na odczyt, którzy pobierają metadane manifestów, stosują pushdown filtrów i korzystają z transformacji partycji podczas planowania. Impala sięga do Iceberga przez swoją abstrakcję katalogu i może korzystać z przycinania po metadanych. Dremio i Snowflake dodają kolejne ścieżki konsumpcji, ale każda kombinacja konektora i katalogu wciąż wymaga testów zgodności.
Katalog jest punktem koordynacji
Katalogi REST, Hive, Glue, Nessie i Polaris rozstrzygają identyfikatory tabel do bieżącego wskaźnika metadanych. Ten wskaźnik to decyzja warstwy sterowania, która mówi silnikowi, który stan tabeli czytać lub aktualizować. Sama zgodność pamięci masowej nie gwarantuje spójnego nadzoru.
Równolegli zapisujący potrzebują obsługi konfliktów. Zapisujący może odkryć, że wskaźnik katalogu zmienił się po rozpoczęciu jego commitu, co wymusza ponowienie albo odpowiedź konfliktową. Różne silniki pokazują takie niepowodzenia inaczej, więc zespoły platformowe powinny przetestować ponowienia, obsługę błędów i odpowiedzialność operacyjną, zamiast zakładać, że każdy konektor zachowuje się tak samo.
Praktyczna lista wyboru wygląda tak:
Wybierz Iceberga, gdy wiele silników, otwarte katalogi i przenośny nadzór nad tabelami znaczą więcej niż ścisła integracja z platformą.
Wybierz Delta Lake, gdy Spark i otaczająca go platforma stanowią główną ścieżkę zapisu, nadzoru i udostępniania.
Wybierz Hudi, gdy upserty strumieniowe, odczyty przyrostowe i ingestia na poziomie rekordów są centralnymi wymaganiami.
Najpierw przetestuj katalog, gdy te same tabele muszą być nadzorowane w wielu silnikach.
Zweryfikuj odczyty historyczne na prawdziwych procedurach retencji i wycofania, a nie tylko udanym zapytaniu demonstracyjnym.
Działania w obszarze jakości danych też muszą pasować do wybranego środowiska wykonawczego. Dla zespołów na Databricks zarządzanie jakością danych w Databricks to jedna z istotnych ścieżek operacyjnych do oceny obok zachowania katalogu i silnika.
Praktyczny przykład: tworzenie i odpytywanie tabeli Iceberg
Mały przepływ w PySparku czyni model metadanych konkretnym. Konkretna implementacja katalogu bywa różna, więc przykład używa nazwanego katalogu Iceberg i lokalizacji magazynu, które zastąpisz ustawieniami swojego środowiska.
Definicja tabeli zapisuje transformację partycji w metadanych. Użytkownicy mogą filtrować po event_time; nie muszą odwoływać się do wygenerowanej kolumny partycji ani katalogu w pamięci obiektowej.
Dopisanie tworzy nowy zatwierdzony snapshot. By przejrzeć historię, odpytaj tabele metadanych, wybierz identyfikator pożądanego snapshotu i użyj go do odczytu historycznego.
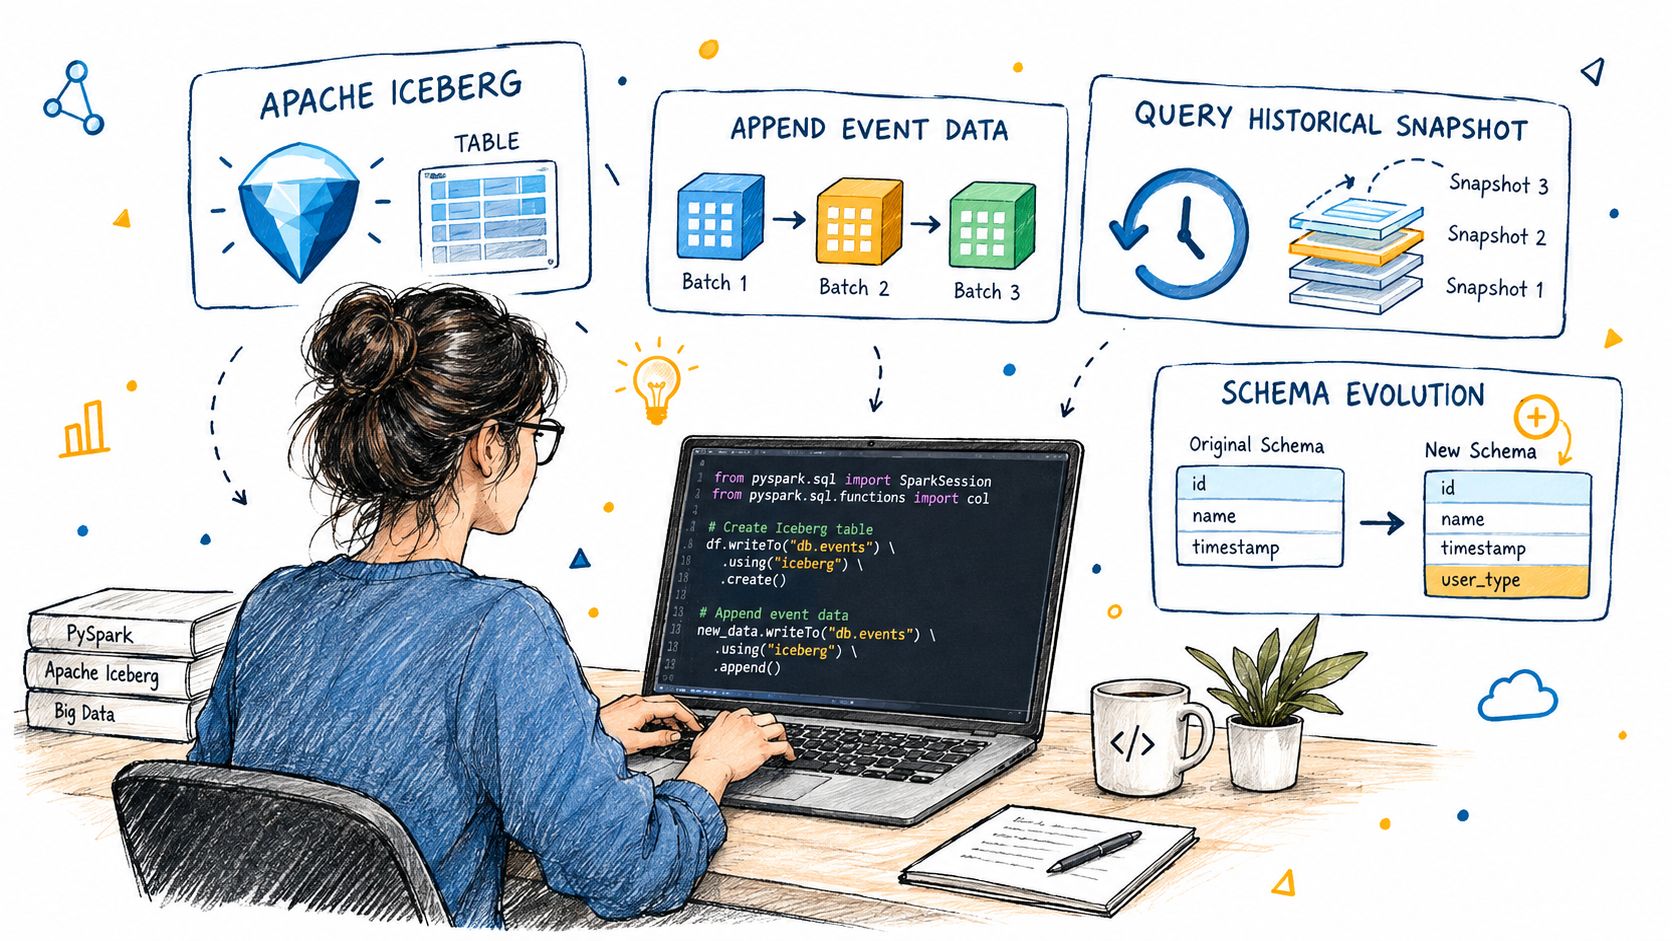
Ewolucja schematu przy wspieranych zmianach dotyczy tylko metadanych. Dodaj kolumnę, a potem dopisz rekordy, które ją wypełnią:
Czytelnicy celujący w starszy snapshot wciąż używają starszej projekcji schematu. Pod spodem katalog wskazuje zaktualizowane metadane tabeli, metadane odwołują się do nowego snapshotu, lista manifestów wskazuje istotne manifesty, a manifesty wskazują pliki danych. Ten układ systemu plików powinien być widoczny i wytłumaczalny dla zespołu eksploatującego tabelę.
Dobre praktyki partycjonowania, sortowania i rozmiaru plików
Iceberg nie przyspiesza wolnego zapytania automatycznie. Wydajność zapytań zwykle zależy od relacji między rozmiarem plików, porządkiem sortowania, transformacjami partycji i rzeczywistą mieszanką filtrów. Format daje mechanizmy rozwijania układu, ale inżynierowie wciąż muszą go testować i utrzymywać.
Zacznij od rozmiaru plików. Typowy zakres startowy to 128 do 512 MB, ale właściwy cel zależy od wzorców odczytu, ustawień formatu pliku, kompresji i zachowania silnika. Małe pliki podnoszą narzut planowania i czynią skany nieefektywnymi. Bardzo duże pliki mogą obniżyć równoległość albo sprawić, że odczyty selektywne przestaną się opłacać.
Sortowanie to druga dźwignia. Sortuj po czasie zdarzenia, gdy dominują skany po oknach czasowych. Użyj kolumny filtrującej o wysokiej kardynalności, gdy daje ona sensowne skupienia, a organizację w stylu Z-order rozważ tylko tam, gdzie silnik i narzędzia utrzymaniowe wspierają ją konsekwentnie. Klucz sortowania, który ładnie wygląda w dokumencie projektowym, może być zły dla rzeczywistej mieszanki zapytań.
Ukryte partycjonowanie to narzędzie dostrajania, nie zamiennik analizy obciążenia. Ewolucja partycji pozwala korygować specyfikację bez natychmiastowego przepisywania historycznych plików, ale każda dodatkowa specyfikacja zwiększa liczbę układów, które planiści muszą interpretować.
Dźwignia | Punkt wyjścia | Kiedy korygować | Częsty błąd |
|---|---|---|---|
Rozmiar pliku | Zacznij w okolicach 128–512 MB i zweryfikuj reprezentatywnymi skanami | Koryguj pod kątem odczytów selektywnych, współbieżności i równoległości silnika | Dopuszczanie do nagromadzenia wielu maleńkich plików |
Porządek sortowania | Zacznij od typowych filtrów czasowych lub stabilnych kolumn selektywnych | Zmień, gdy historia zapytań pokaże przewagę innych predykatów | Wybór klucza z intuicji zamiast z zaobserwowanych zapytań |
Transformacja partycji | Użyj zgrubnej transformacji istotnej biznesowo | Rozwiń ją, gdy wzorce dostępu zmienią się wyraźnie | Tworzenie zbyt wielu partycji |
Utrzymanie | Zaplanuj kompaktowanie i sprzątanie metadanych | Zwiększaj częstotliwość w miarę wzrostu ingestii i liczby tabel | Traktowanie sprzątania jak zadania awaryjnego |
Unikaj nadmiernego partycjonowania, które tworzy pliki poniżej 64 MB. Wybieraj granulację dzienną lub miesięczną zamiast godzinowej, gdy wynikowy wolumen danych jest niski. To heurystyki eksploatacyjne, nie gwarancje, więc sprawdź je na reprezentatywnych obciążeniach, zanim staną się standardem.
Kompaktowanie nie jest opcjonalne przy dużej skali. Procedury przepisywania w Sparku, utrzymanie oparte na Flinku lub narzędzia zewnętrzne mogą łączyć pliki i poprawiać układ, ale muszą być skoordynowane z retencją snapshotów i sprzątaniem osieroconych plików. Ewolucja partycji zmniejsza presję przepisywania, lecz nie znosi potrzeby monitorowania przyrostu metadanych.
Eksploatacja tabel Iceberg z myślą o schemacie, jakości i Timeliness
Gdy zespoły eksploatują wiele tabel Iceberg, większość incydentów zaczyna się jako niepowodzenie wykrywania. Producent zmienia pole bez powiadomienia odbiorców, spóźnione zdarzenia lądują po oczekiwanym oknie partycji, potok tworzy snapshoty, nie dostarczając użytecznych danych, albo utrzymanie zostawia tabelę technicznie czytelną, lecz kosztowną w eksploatacji.
Potraktuj każde ryzyko jako sygnał, który potrzebuje właściciela i reakcji:
Dryf schematu: wykrywaj pola dodane, usunięte, przemianowane lub o zmienionym typie, zanim zadania niżej w łańcuchu zinterpretują je błędnie.
Spóźnione dane: porównuj czas zdarzenia z czasem napływu, by zamknięta partycja czasowa nie ukryła problemów z dostawą.
Świeżość: śledź wiek najnowszego użytecznego snapshotu, a nie tylko to, czy zapisujący się uruchomił.
Jakość: wiąż wyniki walidacji z konkretnym snapshotem, by incydent dało się odtworzyć.
Kondycja metadanych: obserwuj liczbę snapshotów, przyrost manifestów, osierocone pliki i rozkłady rozmiarów plików.
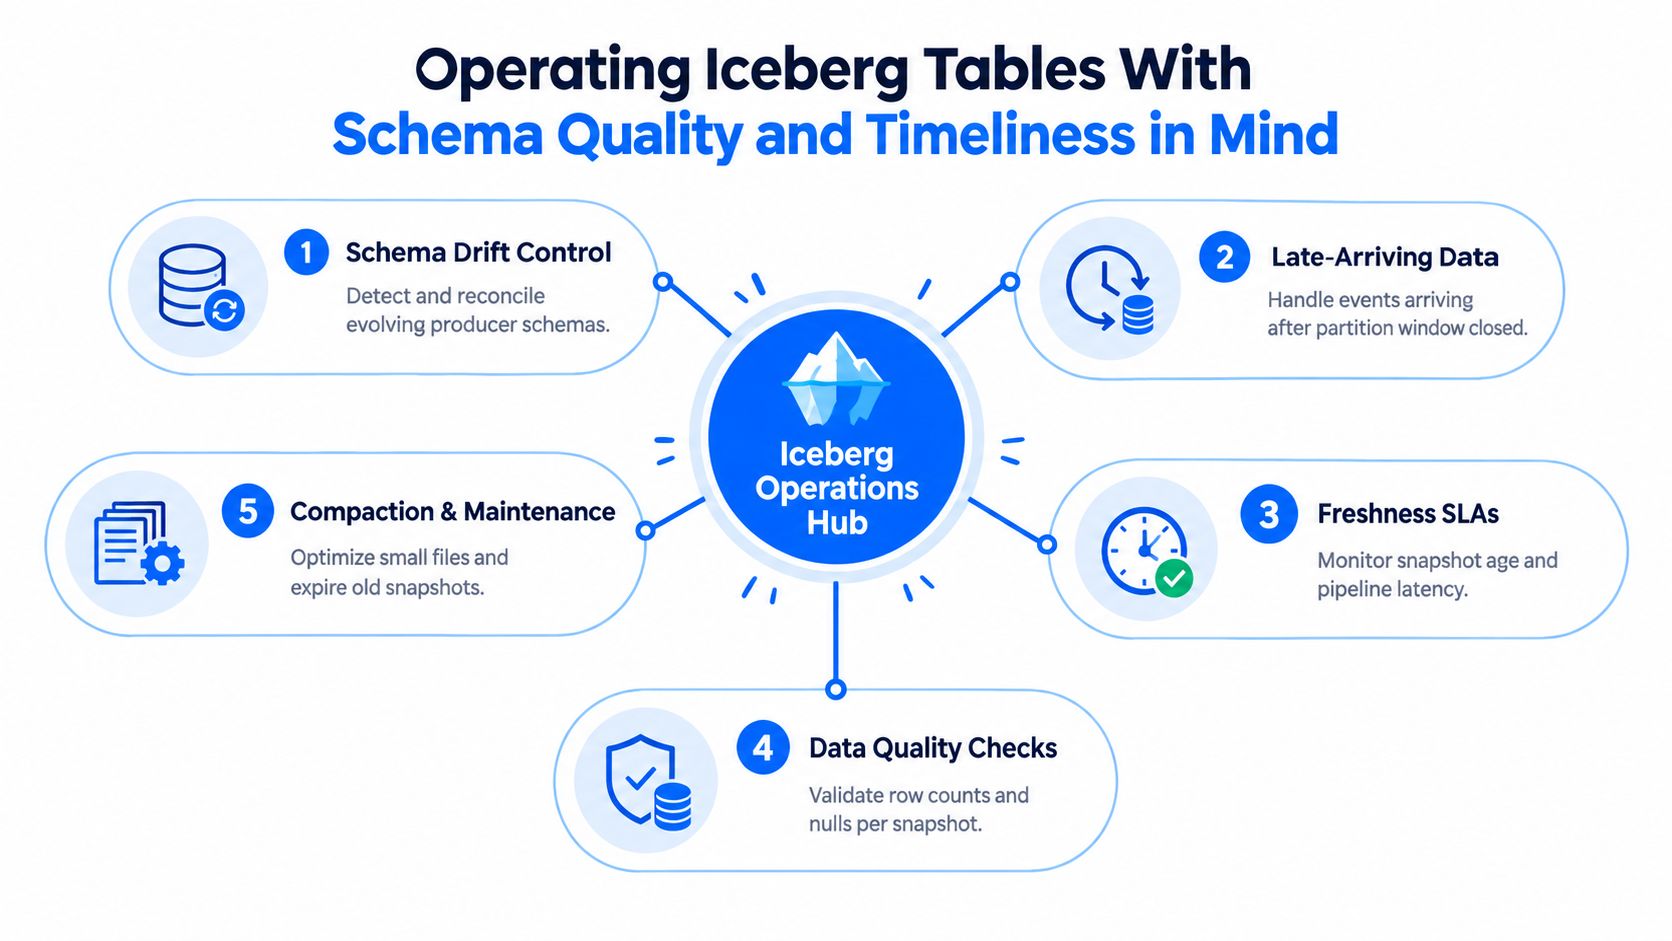
Uczyń bieżący snapshot wytłumaczalnym
Wiarygodny obraz operacyjny łączy stan tabeli z zachowaniem potoku. Kontrola liczby wierszy bez tożsamości snapshotu nie powie inżynierce, która wersja zawiodła. Alert świeżości oparty wyłącznie na zegarze może błędnie zakwalifikować tabelę, która dostała pustą lub zniekształconą partię. Alert schematu bez odpowiedzialności po stronie odbiorców tworzy hałas zamiast działania.
digna może w tym celu stanąć obok katalogu i warstwy obliczeniowej. Jej Schema Tracker monitoruje zmiany strukturalne, Data Validation stosuje kontrole biznesowe na poziomie rekordów, Timeliness śledzi oczekiwane napływy i opóźnienia, a widoki obserwowalności pomagają zespołom badać trendy i zachowanie platformy. Model wykonania wewnątrz bazy utrzymuje obliczanie metryk w środowisku klienta, zamiast przenosić dane produkcyjne do usługi zewnętrznej.
Pytanie operacyjne o drugiej w nocy nie brzmi, czy Iceberg poprawnie zacommitował. Brzmi ono: czy tabela jest teraz wiarygodna, którego snapshotu dotyczy problem i co zmieniło się od ostatniego zdrowego stanu. Ta odpowiedź wymaga sygnałów o jakości, terminowości, schemacie i metadanych w jednym kontekście incydentu.
Migracja z Hive, Delty lub Hudi bez podpalania jeziora
Ścieżki migracji różnią się ostro zależnie od formatu źródłowego. Zewnętrzne tabele Hive bywają najbardziej przystępne, bo istniejące pliki mogą już nadawać się do użycia, ale rozbieżne identyfikatory, założenia SerDe i rejestracja w katalogu wciąż mogą zepsuć czytelników niżej w łańcuchu. Konwersja metadanych albo ścieżka CTAS może zadziałać dla jednej tabeli i zawieść dla innej, gdy różnią się założenia o układzie fizycznym.
Delta wymaga baczniejszej analizy. Narzędzia konwersji lub przepisania muszą uwzględnić wektory usunięć, ustawienia change data feed i kolumny tożsamości, które nie mapują się czysto na model docelowy. Udana rejestracja tabeli nie dowodzi, że historyczne zachowanie, usunięcia czy odbiorcy przyrostowi zachowają się tak samo.
Hudi jest zwykle najtrudniejszą migracją, gdy źródło opiera się na zachowaniu merge-on-read, copy-on-write lub semantyce osi czasu. Snapshoty Iceberga nie dają bezpośredniego zamiennika jeden do jednego dla każdej operacji osi czasu Hudi, więc zespoły mogą potrzebować pełnego przepisania i starannie wyznaczonej granicy przełączenia.
Bezpieczniejsza kolejność przełączenia
Najpierw wybór katalogu. Zdecyduj, czy docelowe środowisko będzie używać REST, Glue, Nessie czy Hive Metastore, a potem przetestuj uprawnienia, identyfikatory, obsługę poświadczeń i zachowanie wycofania. Narzędzia BI często buforują w pełni kwalifikowane nazwy, więc zmiana ścieżek katalogu lub przestrzeni nazw może zepsuć raporty, nawet gdy same dane są poprawne.
Migracja partycji zasługuje na własny test. Ukryte partycjonowanie zmienia sposób, w jaki użytkownicy wyrażają filtry i w jaki silniki interpretują transformacje, a stary i nowy układ mogą współistnieć w trakcie przejścia. Podwójny zapis potrafi zachować opcje wycofania, ale tworzy też pracę uzgadniania, którą trzeba monitorować.
Użyj tej kolejności:
Inwentaryzacja: zapisz schematy, partycje, odbiorców, zapisy, reguły retencji i wymagania odczytu historycznego.
Pilotaż: przekonwertuj tabele niekrytyczne i przetestuj każdy ważny silnik.
Podwójny odczyt: porównaj wyniki, liczności, schematy, świeżość i zachowanie dostępu.
Przełączenie: przenoś odbiorców świadomie, zachowaj ścieżkę wycofania i utrzymuj starą trasę dostępną, aż walidacja się zakończy.
Przy szerszym planowaniu wykorzystaj dobre praktyki migracji z hurtowni danych do data lake jako listę kontrolną, a potem dostosuj ją do ograniczeń katalogu i silników w twoim środowisku.
digna dostarcza jakość danych i obserwowalność wewnątrz środowiska dla operacji wokół Iceberga, w tym śledzenie schematu, walidację rekordów, monitorowanie terminowości, wykrywanie anomalii i metryki platformy. Odwiedź digna, by ocenić, jak te sygnały mogą pomóc twojemu zespołowi eksploatować duże zbiory tabel z czytelniejszymi dowodami i szybszą reakcją na incydenty.
Historia snapshotów mówi, co się zmieniło, ale nie czy zmiana była błędna — do tego połącz metadane Iceberga z obserwowalnością platformy danych.
Najczęściej zadawane pytania
Skąd wziął się Apache Iceberg?
Zaczął się w Netfliksie w 2017 roku, by zaadresować ograniczenia skalowalności i spójności w tabelach Apache Hive. Netflix przekazał go Apache Software Foundation w listopadzie 2018, a w maju 2020 stał się projektem Apache najwyższego poziomu.
Dlaczego Iceberg to dyscyplina operacyjna, a nie format pliku?
Bo zespół może szybko go wdrożyć i wciąż nie mieć odpowiedzi na pytania, które liczą się na produkcji. Fizyczna warstwa danych jest stosunkowo prosta; wydajność i poprawność rozstrzygają się w warstwie operacyjnej ponad nią.
Czego naprawdę wymaga eksploatacja Iceberga?
Czterech rzeczy: nadzoru nad katalogiem, który rozstrzyga, kto może tworzyć, zmieniać, usuwać lub promować tabele i jak rozstrzygane są identyfikatory; higieny metadanych kontrolującej retencję snapshotów, usuwanie osieroconych plików i przyrost manifestów; koordynacji silników sprawdzającej, jak Spark, Flink i Trino obsługują te same specyfikacje; oraz dowodów wiążących jakość, świeżość i pochodzenie ze stanem tabeli.
Jaka jest główna idea projektowa Iceberga?
Oddzielenie stanu tabeli od fizycznego układu plików. Z tego rozdzielenia bierze się jego wartość i to samo sprawia, że pytania operacyjne przesuwają się poziom wyżej, zamiast znikać.
Jak należy traktować tabelę Iceberg?
Jak zarządzany produkt z osobą odpowiedzialną, polityką eksploatacji i obserwowalnym cyklem życia. Tabela bez tych trzech rzeczy ma specyfikację, ale nikogo, kto odpowiada za jej zachowanie w czasie.



