Validazione dei dati: regole, controlli e monitoraggio continuo della qualità dei dati
|
9
min di lettura

Cosa succede se un dataset soddisfa sulla carta una definizione di validità, ma nessuno testa la regola prima che i dati raggiungano una dashboard, un modello o un report normativo? La validazione dei dati è il processo operativo che applica regole, vincoli, formati, domini e condizioni di business definiti per stabilire se i dati soddisfano i requisiti specificati. Trasforma un'aspettativa di qualità astratta in un test esplicito che può superare, fallire, generare un avviso, rifiutare o mettere in quarantena un record.
La validità dei dati è una dimensione della qualità dei dati. La validazione dei dati è il processo usato per testare questa dimensione rispetto a requisiti definiti.
Questa distinzione è importante. La qualità dei dati descrive se i dati sono adatti all'uso previsto, mentre la validazione fornisce il meccanismo eseguibile che verifica i record rispetto a condizioni concordate. Questa guida spiega come regole di validazione dei dati, controlli di validazione dei dati, misurazione, automazione e monitoraggio continuo funzionano insieme.
Indice
Validazione dei dati, qualità dei dati e observability a confronto
Che cos'è la validazione dei dati e perché esiste
La validazione dei dati verifica se i record sono conformi ad aspettative predefinite su struttura, contenuto, relazioni e significato di business. Una regola potrebbe richiedere un identificativo cliente, limitare un codice paese a un dominio approvato, confermare che una data abbia il formato previsto o garantire che l'importo di un ordine soddisfi una condizione di business.
La validazione esiste perché gli errori diventano più difficili da isolare dopo aver attraversato più sistemi. Un record malformato può compromettere analytics, pipeline di machine learning, flussi di lavoro operativi o reporting normativo prima che qualcuno si accorga del problema a livello di dashboard. Testare in fase di ingestion o di trasformazione offre ai team la possibilità di bloccare, segnalare o isolare il record finché la sua origine è ancora visibile.
La distinzione tra una dimensione di qualità e il relativo test operativo si ritrova anche nel DAMA-DMBOK® 2.0 Revised Edition, comunemente usato come riferimento per le pratiche di data management. La validità descrive la conformità a formati, domini e regole definiti. La validazione dei dati è l'attività che misura tale conformità in un determinato dataset e in un determinato punto di una pipeline.
Perché una pulizia una tantum non basta
Un progetto di pulizia può correggere i difetti noti, ma non protegge il caricamento successivo. Il monitoraggio continuo della qualità dei dati misura la qualità nel tempo e applica controlli affinché i dati continuino a rispettare le aspettative di business. Questo ciclo di feedback costante aiuta i team a individuare derive, degradi e interruzioni dei processi prima che i consumatori a valle utilizzino valori inaffidabili, come descritto nella ricerca sul monitoraggio continuo della qualità dei dati.
Le indicazioni di Gartner sulla qualità dei dati citano un costo medio annuo di 12,9 milioni di dollari associato alla scarsa qualità dei dati, il che rende la validazione e il monitoraggio sistematici un controllo di business oltre che una pratica tecnica (indicazioni di Gartner sulla qualità dei dati). La risposta pratica non è testare senza limiti, ma scegliere le regole che proteggono i dati più importanti e collegare ogni errore a un owner e a un'azione.
Come funzionano le regole di validazione dei dati
Una regola di validazione dei dati ha tre componenti essenziali: condizione, ambito e azione. La condizione definisce il test logico, l'ambito identifica dove si applica il test e l'azione determina cosa deve fare la pipeline quando il test fallisce.
Prendiamo una tabella customer_orders:
order_total > 0customer_emailcorrisponde al pattern email approvatocountry_codeappartiene a un insieme consentito
La stessa condizione può produrre esiti diversi a seconda della gravità. L'assenza di un identificativo normativo potrebbe bloccare un caricamento, mentre un valore insolito ma verificabile potrebbe generare un avviso. Un record malformato potrebbe essere spostato in quarantena anziché scomparire, conservando le evidenze per la correzione e la rielaborazione.
Componente | Ruolo | Esempio ( |
|---|---|---|
Condizione | Definisce il test logico |
|
Ambito | Identifica l'oggetto e la fase da controllare |
|
Azione | Specifica la risposta all'errore | Mettere il record in quarantena e avvisare il data owner |
Le regole possono essere dichiarative, come i vincoli SQL o le configurazioni YAML, oppure procedurali, come i test implementati con dbt o Great Expectations. Le integrazioni enterprise possono esporre i controlli anche tramite API, ad esempio con la REST API di digna per la validazione dei dati.
Una regola utile dovrebbe essere riutilizzabile e parametrizzata. Ad esempio, un unico template di controllo degli intervalli può accettare valori minimi e massimi diversi per campi monetari diversi. Archiviate definizione della regola, gravità, owner e versione accanto al modello dati che protegge. In questo modo le modifiche sono verificabili quando cambia uno schema o una policy di business.
Tipi di controlli di validazione dei dati
Nessun tipo di controllo intercetta da solo ogni errore. Un framework di validazione dei dati maturo combina test strutturali con controlli su contenuto, relazioni e comportamento.
Tipo di controllo | Scopo | Esempio su un dataset clienti |
|---|---|---|
Schema | Conferma colonne, tipi di dato e ammissibilità dei null |
|
Dominio | Limita i valori a un insieme approvato |
|
Formato | Verifica un pattern obbligatorio | L'email segue la struttura accettata |
Intervallo | Applica limiti numerici o di data | La quantità non è negativa |
Unicità | Rileva identificativi duplicati |
|
Integrità referenziale | Conferma le relazioni tra dataset | Ogni ordine fa riferimento a un cliente esistente |
Statistico o di distribuzione | Individua comportamenti aggregati insoliti | Tassi di null o conteggi di righe variano inaspettatamente |
Controlli strutturali e di contenuto
I controlli di schema intercettano una colonna mancante, un tipo inatteso o un flag di ammissibilità dei null modificato prima che le trasformazioni a valle falliscano. I controlli di dominio rilevano valori sintatticamente accettabili ma non approvati, come un codice paese sconosciuto o uno stato cliente non supportato.
La validazione del formato gestisce i pattern di indirizzi email, date, codici postali e numeri di conto. La validazione degli intervalli verifica valori come età, quantità, percentuali e importi monetari rispetto a limiti definiti.
La validazione dei null distingue i campi obbligatori dagli attributi facoltativi. Un ID cliente può essere obbligatorio, mentre un numero di telefono secondario può essere facoltativo. Trattare ogni null come un errore genera rumore, quindi il requisito deve derivare dall'uso previsto.
Controlli su relazioni e comportamento
La validazione tra campi verifica la logica tra attributi. Una data di fine non può precedere una data di inizio e un valore in valuta deve soddisfare la condizione di business definita. La validazione referenziale verifica che un ID cliente esista nei master data dei clienti e che un ID prodotto esista in un dataset di riferimento approvato.
I controlli statistici aggiungono un livello diverso. Possono monitorare conteggi di righe, tassi di null, medie, deviazioni standard e distribuzioni, aiutando i team a individuare derive silenziose che le regole statiche potrebbero non cogliere. Le indicazioni sui controlli di coerenza dei dati sono utili quando più sorgenti dovrebbero descrivere la stessa entità o lo stesso evento.
Per gli elementi critici, combinate controlli di schema, dominio, formato, relazioni e distribuzione anziché affidarvi a un'unica categoria.
Progettare regole che reggono in produzione
Le regole di qualità dei dati efficaci devono essere esplicite, misurabili, pertinenti, testabili, manutenibili e riconducibili a un requisito di business. Una regola come “i dati dei clienti devono essere completi” non è eseguibile. “L'ID cliente non deve essere null in nessun record di fatturazione” è abbastanza specifica da poter essere testata e assegnata.
Le regole possono riguardare diverse dimensioni della qualità:
Completezza: i campi obbligatori contengono valori.
Validità: i valori sono conformi a un formato o dominio approvato.
Unicità: gli identificativi non si ripetono dove è richiesta l'unicità.
Coerenza: i sistemi correlati concordano sugli attributi condivisi.
Tempestività: i dati arrivano entro la finestra operativa concordata.
Accuratezza: i valori corrispondono a una fonte attendibile o a una condizione verificata.
Conformità: i record rispettano lo standard strutturale e di business pertinente.
Non applicate lo stesso rigore a ogni colonna. Date priorità agli elementi di dati critici e alle regole critiche per il business, in particolare ai campi usati in elaborazioni finanziarie, comunicazioni ai clienti, reporting regolamentato, decisioni operative o analytics ad alto impatto. Un backlog di regole può essere ordinato in base a costo di implementazione, potenziale raggio d'impatto, facilità di rilevamento di un errore e reversibilità dell'errore risultante.
Livello di criticità | Esempi | Tipi di controllo richiesti | Frequenza | Percorso di escalation |
|---|---|---|---|---|
Alto | Campi normativi o finanziari | Controlli stratificati su struttura, dominio, relazioni e trend | A ogni caricamento pertinente | Data owner e processo di gestione degli incidenti |
Medio | Campi operativi rivolti ai clienti | Controlli di formato, completezza, intervallo e coerenza | A ogni caricamento o pianificata | Coda del team con ownership |
Basso | Attributi analitici esplorativi | Controlli di base su schema e anomalie | Adeguata all'uso | Revisione durante la manutenzione del dataset |
I template parametrizzati riducono la logica duplicata. Versionate le regole insieme alle modifiche di schema, registrate il business owner e dismettete i controlli quando il requisito sottostante cambia. La ricerca sulle regole tecniche di qualità dei dati gestite manualmente evidenzia perché la manutenibilità debba essere considerata parte della progettazione dei controlli, non un ripensamento.
Misurare i risultati della validazione
La validazione diventa utile sul piano operativo quando i team misurano più di un semplice segnale di superamento o fallimento. Gli indicatori principali includono tasso di superamento della validazione, tasso di fallimento della validazione, numero di record non conformi, numero di regole fallite, trend degli errori e tasso di fallimento delle regole critiche.
Il calcolo standard è:
Tasso di superamento della validazione = record che superano una regola / record valutati × 100
La corrispondente vista degli errori può usare il numero di record che non hanno superato la regola, diviso per i record valutati e moltiplicato per 100. I team possono anche monitorare tempo medio di rilevamento, tempo medio di risoluzione, copertura delle regole e un indice composito di qualità dei dati, purché queste misure siano definite in modo coerente.
Un tasso di superamento del 99% non è automaticamente buono o cattivo. Se i record non conformi riguardano un attributo analitico a basso rischio, la soglia può essere tollerabile. Se riguardano un identificativo di fatturazione obbligatorio, lo stesso tasso può richiedere un intervento immediato. Le soglie devono riflettere la criticità per il business, l'impatto a valle e l'azione associata alla regola.
Leggere i trend, non istantanee isolate
Il monitoraggio dei trend mostra se gli errori sono stabili, in miglioramento o in peggioramento. Una regola superata oggi può comunque degradarsi gradualmente nei caricamenti successivi. Gli strumenti SAP per i master data illustrano questo approccio con valutazioni pianificate, monitoraggio dei trend, monitoraggio dello stato attuale e confronto con soglie definite (documentazione SAP su validazione e monitoraggio).
I punteggi compositi dovrebbero essere ponderati in base alla criticità degli elementi di dati anziché calcolati come media uniforme. Una dashboard che combina regole a basso e alto impatto in un unico punteggio non ponderato può far sembrare irrilevanti errori gravi. Le indicazioni dettagliate sulle metriche di qualità dei dati possono aiutare i team a definire un modello di misurazione che colleghi gli esiti delle regole a ownership e uso di business.
Validazione dei dati, qualità dei dati e observability a confronto
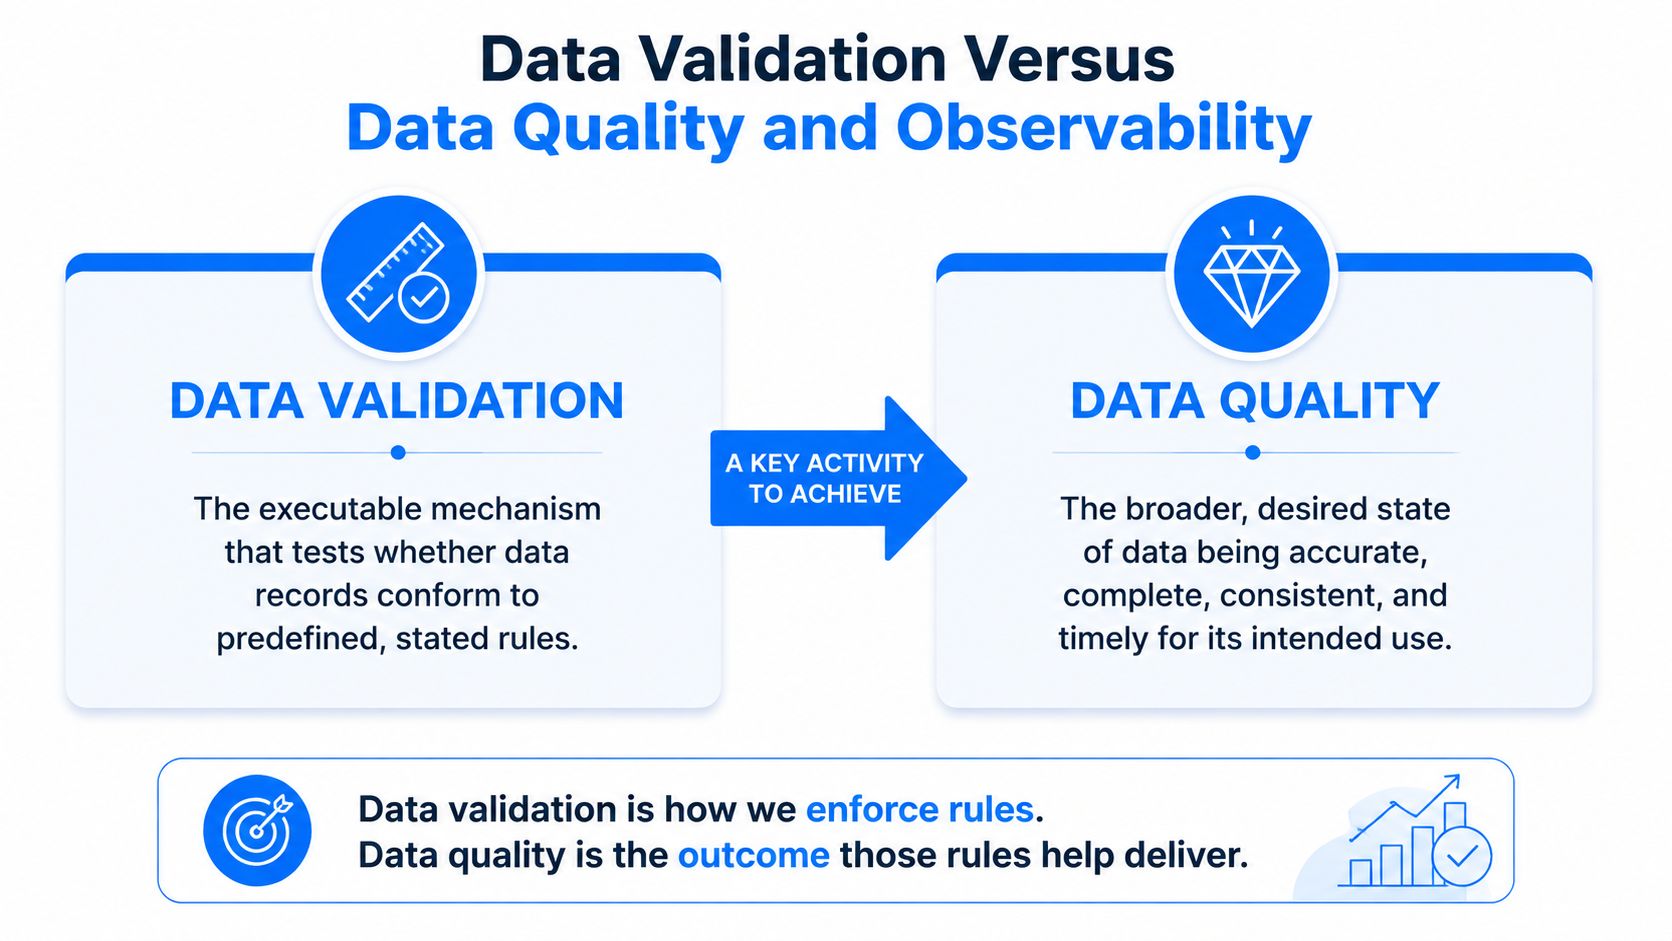
La qualità dei dati è il concetto più ampio che indica se i dati sono adatti all'uso. Include dimensioni come completezza, accuratezza, coerenza, tempestività, unicità e validità. La validazione dei dati è uno dei meccanismi per testare requisiti di qualità dei dati definiti.
Un controllo di validazione chiede: “Questo record soddisfa questa regola?” Una valutazione della qualità chiede se l'attributo o il dataset sia affidabile per lo scopo previsto. Una gestione più ampia della qualità dei dati può includere anche profiling, rilevamento delle anomalie, riconciliazione, monitoraggio della tempestività, analisi storica e correzione.
Validazione e observability rispondono a domande diverse
La validazione dei dati chiede:
Questi dati soddisfano questa regola definita?
La Data Observability chiede:
Cosa sta succedendo ai dati e come è cambiato il loro comportamento?
La validazione è di solito deterministica e basata su regole. L'observability aggiunge segnali comportamentali come trend, anomalie, contesto di lineage, aggiornamento dei dati e rilevamento delle modifiche strutturali. Le due si completano a vicenda. Una regola di validazione può individuare un codice postale non valido, mentre il monitoraggio delle anomalie può individuare un improvviso aumento degli errori sui codici postali.
Prendiamo una pipeline di indirizzi dei clienti. La validazione può rifiutare codici postali malformati. Il punteggio di qualità può mostrare un calo di completezza nei campi dell'indirizzo. L'observability può rilevare che una modifica di schema a monte ha introdotto un campo non mappato. Ogni livello risponde a una diversa domanda operativa e, insieme, offrono una diagnosi più solida di qualsiasi livello preso singolarmente.
Automatizzare e monitorare la validazione dei dati
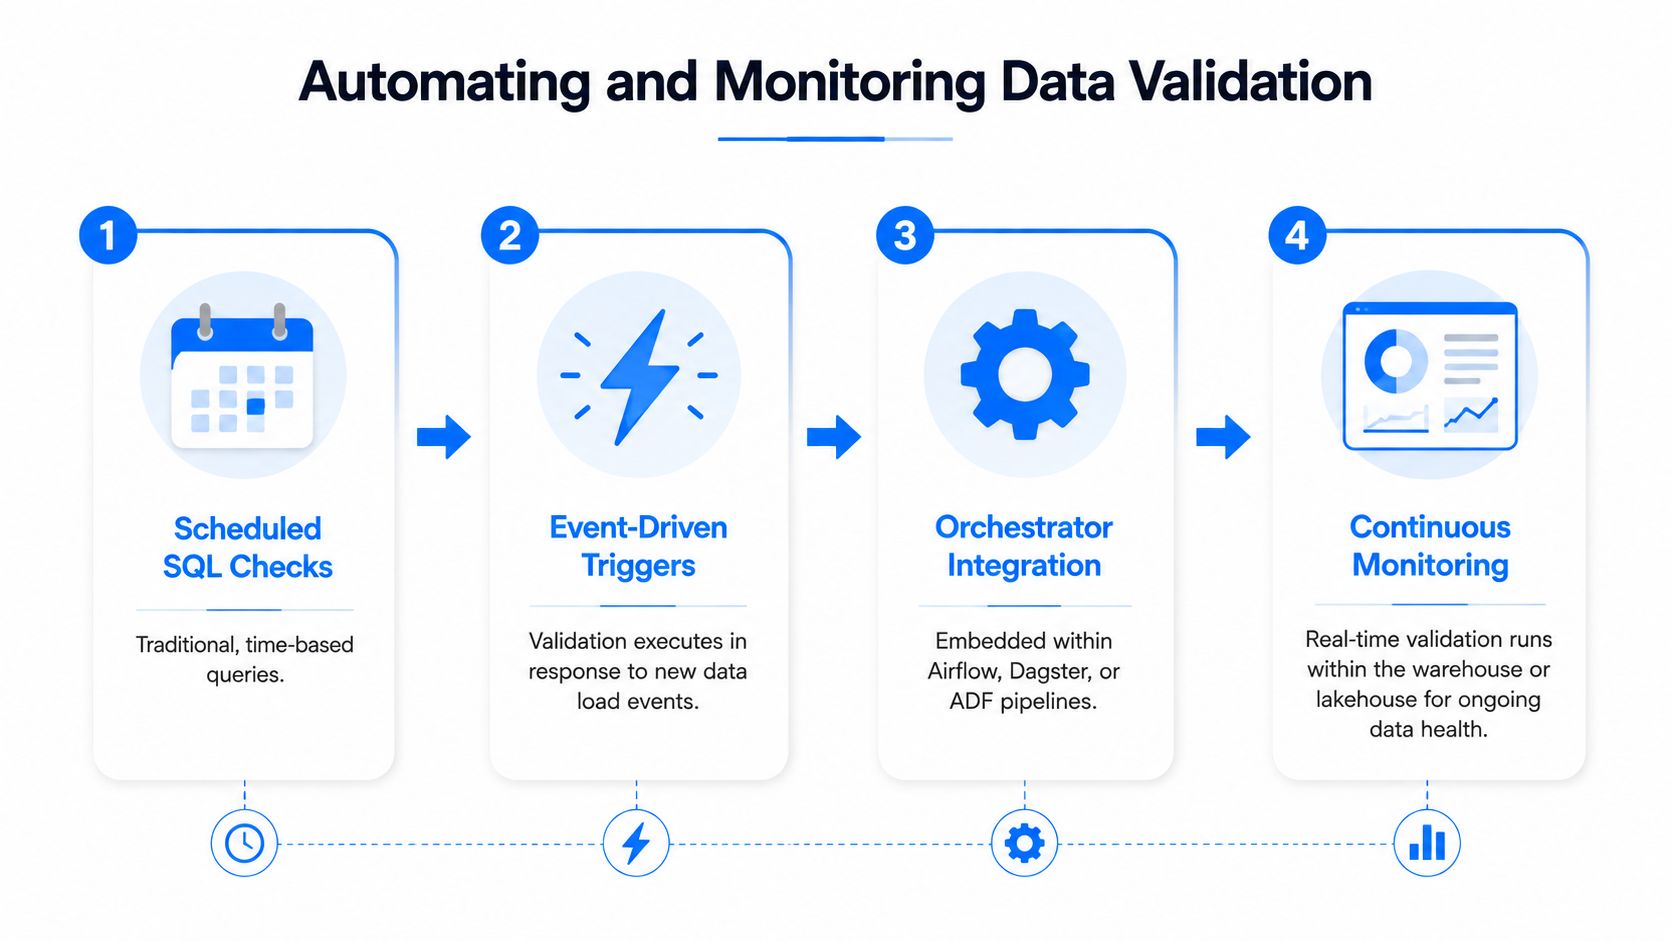
La validazione automatizzata dei dati dovrebbe essere eseguita come parte del ciclo di vita dei dati, non come uno script isolato che qualcuno si ricorda di lanciare. I team possono attivare i controlli dopo gli eventi di caricamento tramite Airflow, Dagster o Azure Data Factory, oppure pianificarli per i dataset che non dispongono di segnali di evento affidabili.
Eseguite i controlli nel data warehouse o nel lakehouse, ove possibile. L'esecuzione nel database mantiene i dati dove si trovano, supporta il lineage ed evita spostamenti superflui. Materializzate i risultati in uno schema di controllo con identificativo della regola, timestamp di esecuzione, ambito, stato, numero di record non conformi, gravità e owner.
Costruire il percorso di risposta
Usate alert graduati anziché trattare ogni errore come un'interruzione del servizio:
Avvisi: registrano un problema non bloccante da esaminare.
Blocchi: interrompono la pubblicazione quando una regola critica fallisce.
Quarantena: isola i record non validi per l'indagine o la rielaborazione.
Escalation: instrada gli errori urgenti verso Slack, PagerDuty o flussi di ticketing.
Una coda di triage dovrebbe assegnare un owner, rimandare a un runbook, identificare la regola fallita e registrare una categoria di causa principale. La risoluzione dovrebbe poi alimentare la progettazione dei controlli. A volte la regola va affinata. A volte deve cambiare il contratto a monte o la trasformazione.
I test dbt e Great Expectations offrono modelli ampiamente adottati per esprimere i controlli nel codice. I team operativi hanno inoltre bisogno di esecuzioni idempotenti, riesecuzioni sicure, gestione dello schema drift e aspettative di servizio chiare per l'aggiornamento dei dati rispetto al ritardo della validazione. I team che stanno costruendo un modello operativo possono consultare anche Hire-a.dev sul monitoraggio per considerazioni più ampie sui flussi di monitoraggio. Il monitoraggio della qualità dei dati continuo funziona al meglio quando i segnali tecnici sono collegati direttamente a una ownership umana.
Flusso di validazione end-to-end con un dataset clienti
Prendiamo un dataset clienti con un campo country_code. Il data contract dichiara il formato atteso ISO-3166 alpha-2 e una whitelist approvata di 30 regioni gestite. Il campo non deve essere null, deve appartenere a quel dominio e deve seguire la struttura prevista.
Dopo ogni batch, i controlli SQL individuano valori null, codici sconosciuti e variazioni nella distribuzione. Un monitor delle anomalie confronta i conteggi per paese di oggi con la baseline dei 30 giorni precedenti e fa emergere un picco improvviso di segnaposto XX. Gli analytics mostrano poi quando è iniziato il deterioramento, invece di segnalare soltanto che l'ultimo batch è fallito.
Passaggio | Azione | Strumento o livello | Output |
|---|---|---|---|
1 | Dichiarare il contratto del campo | Schema e metadati di business | Formato atteso e dominio approvato |
2 | Eseguire i controlli a livello di record | Livello di validazione SQL | Errori di null, dominio e formato |
3 | Confrontare il comportamento nel tempo | Rilevamento delle anomalie | Aumento insolito dei valori |
4 | Instradare l'incidente | Flusso di alerting e ownership | Il team di ingestion indaga |
5 | Correggere e riconciliare | Correzione ETL e backfill | Record interessati riparati |
6 | Ricalcolare gli usi a valle | Analytics e reporting | Viste dei ricavi regionali aggiornate |
Il team di ingestion scopre che un processo ETL a monte imposta per default XX quando la geocodifica fallisce. Corregge la trasformazione, esegue il backfill dei record interessati e rilancia gli analytics dei ricavi per regione a valle. La validazione individua i valori errati, il monitoraggio delle anomalie rivela la variazione insolita e gli analytics ricostruiscono la sequenza temporale. I tre livelli formano un ciclo di feedback chiuso anziché un insieme scollegato di controlli.
digna offre Data Validation a livello di record per regole esplicite che coprono campi obbligatori, formati, domini, intervalli, condizioni tra campi e vincoli referenziali o di business. La funzionalità complementare Data Anomalies può individuare variazioni insolite nei risultati di validazione o nel comportamento dei dati, mentre Data Analytics supporta l'analisi storica di metriche e trend della validazione. Visitate digna per valutare come queste funzionalità possano inserirsi nel vostro flusso di monitoraggio della qualità dei dati.
Domande frequenti
Che cos'è la validazione dei dati?
La validazione dei dati è il processo che applica regole, vincoli, formati, domini e condizioni di business definiti per stabilire se i dati soddisfano i requisiti specificati. Trasforma le aspettative di qualità dei dati in controlli espliciti e testabili.
Cosa sono le regole di validazione dei dati?
Le regole di validazione dei dati sono condizioni logiche applicate a un ambito definito, come un campo, un record, una tabella o una fase della pipeline. Quando i dati non le superano, possono attivare azioni come avviso, rifiuto, quarantena o correzione.
Quali sono i principali tipi di validazione dei dati?
I tipi più comuni includono controlli di formato, tipo di dato, dominio, intervallo, ammissibilità dei null, tra campi, referenziali, di unicità, di schema, di regole di business e statistici o di distribuzione. La combinazione giusta dipende da come verranno usati i dati.
Come si misura la validazione dei dati?
Misurate tasso di superamento, tasso di fallimento, numero di record non conformi, numero di regole fallite, trend degli errori e tasso di fallimento delle regole critiche. Le soglie dovrebbero riflettere l'importanza dell'elemento di dati e le conseguenze dell'errore.
La validazione dei dati coincide con la qualità dei dati?
No. La qualità dei dati è la valutazione più ampia dell'idoneità dei dati all'uso. La validazione dei dati è un meccanismo pratico per testare requisiti specifici di qualità dei dati.
Qual è la differenza tra validazione e verifica dei dati?
La validazione dei dati controlla se i dati sono conformi a requisiti definiti. La verifica dei dati in genere conferma che un valore o un processo corrisponda a una fonte o a un risultato atteso. La verifica può supportare la validazione, ma i due termini descrivono attività di controllo diverse.
La validazione dei dati può rilevare dati inaccurati?
Può rilevare l'inaccuratezza quando l'organizzazione dispone di un riferimento affidabile, di una regola di riconciliazione o di una condizione di business con cui confrontarsi. Un valore può superare i controlli di formato e dominio pur essendo errato nei fatti, quindi la validazione andrebbe combinata con profiling, riconciliazione e rilevamento delle anomalie.
Come si può automatizzare la validazione dei dati?
Eseguite le regole all'interno delle pipeline di ingestion e trasformazione, collegatele a orchestratori come Airflow, Dagster o Azure Data Factory, archiviate i risultati in uno schema di controllo e instradate gli errori attraverso flussi di alerting e triage. I test dbt e Great Expectations sono modelli di implementazione comuni.
In che modo digna Data Validation supporta la qualità dei dati?
digna Data Validation applica regole esplicite a livello di record e registra gli esiti per controlli di qualità mirati. Usata insieme al rilevamento delle anomalie e agli analytics storici, aiuta i team a collegare i singoli errori ai cambiamenti nel comportamento dei dati e ai trend di qualità di lungo periodo.


