Monitorare il tempo di consegna previsto delle pipeline di dati
|
6
min di lettura

La vostra dashboard direzionale dice che la pipeline di ieri è sana, ma i numeri sono obsoleti. Un caricamento notturno è slittato, la tabella è arrivata con ore di ritardo e nessuno se n'è accorto finché non è iniziata la riunione. È il tipo di mancanza che trasforma il tempo di consegna previsto da espressione della logistica a segnale operativo quotidiano per i team dati.
In pratica, il problema è raramente un singolo job guasto. È il divario tra il momento in cui un dataset dovrebbe arrivare, il momento in cui arriva davvero e la possibilità per gli utenti downstream di fidarsi del risultato prima di prendere una decisione. I team più solidi trattano questo divario come una proprietà misurabile del sistema, non come un vago fastidio.
Indice
Metodi statistici e di machine learning per apprendere le finestre di arrivo
Gestire stagionalità e calendari di business nelle stime di arrivo
Progettare SLA e strategie di alerting per la puntualità dei dati
Flussi di analisi delle cause per dati in ritardo o mancanti
Consigli di implementazione in-database con digna Timeliness e Analytics
Perché il tempo di consegna previsto conta per i team dati
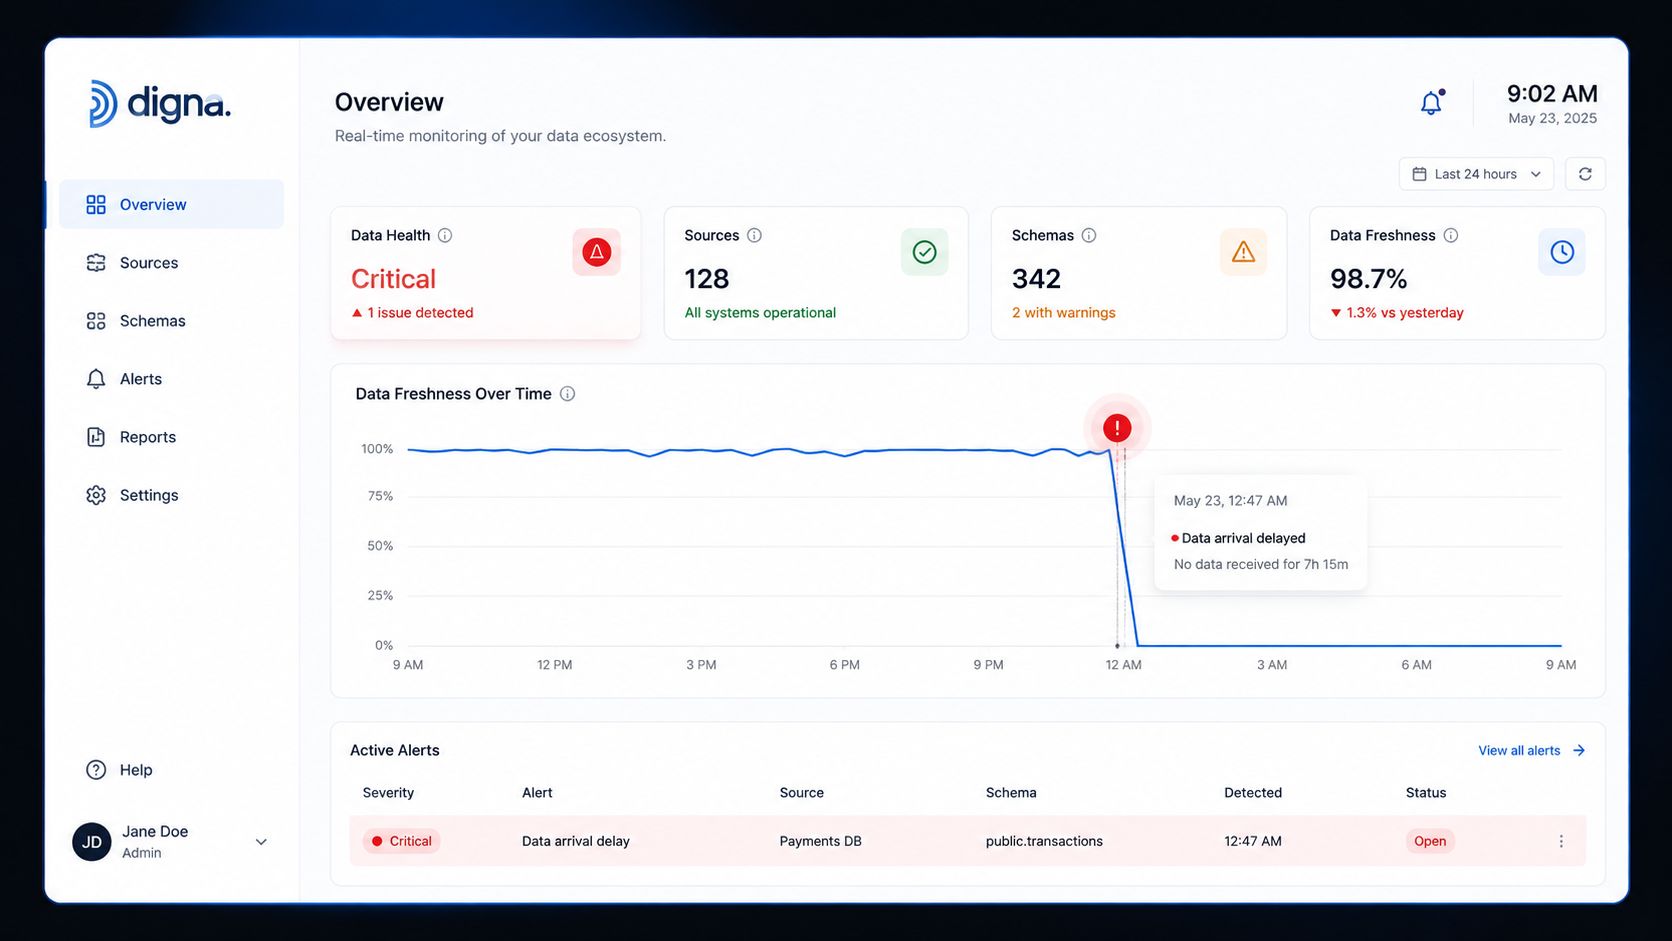
Una dashboard del lunedì mattina che mostra i numeri del venerdì di solito non è un bug di reportistica: è un problema di puntualità. Il caricamento è arrivato in ritardo, il warehouse lo ha accettato e il business se n'è accorto solo dopo che qualcuno ha chiesto perché i KPI sembravano congelati. È proprio per questo che il tempo di consegna previsto appartiene alla stessa discussione di freshness, completezza e correttezza.
Nel contesto dei dati, il tempo di consegna previsto è la finestra appresa o concordata entro cui un dataset, una tabella o una partizione dovrebbe essere popolata e pronta per l'uso downstream. A differenza delle date di spedizione, spesso intese come un singolo momento di arrivo a destinazione, l'arrivo dei dati è determinato da pianificazioni di orchestrazione, comportamento delle sorgenti upstream, orari di cutoff e calendari di business. Un controllo cron rigido può dire “il job è stato eseguito”, mentre la vera domanda è se i dati sono arrivati quando i consumatori ne avevano bisogno.
Regola pratica: se una tabella alimenta una riunione, un modello o un estratto normativo, la puntualità è un requisito di prodotto, non un dettaglio di backend.
Le ipotesi statiche basate su cron falliscono perché codificano una speranza, non un comportamento. I sistemi upstream deviano, le finestre batch si spostano e una sola partizione in ritardo può compromettere diversi job downstream prima che qualcuno apra un log. Quando un team inizia a misurare esplicitamente il tempo di consegna previsto, i report obsoleti smettono di essere una sorpresa e diventano un problema di affidabilità monitorato.
Metodi statistici e di machine learning per apprendere le finestre di arrivo
I team che memorizzano solo un orario di esecuzione pianificato finiscono con alert fragili. Il modello migliore è una finestra di arrivo appresa, in cui il comportamento storico definisce cosa significa di solito “puntuale” per ogni tabella, partizione o gruppo di file. Questo cambio di prospettiva trasforma un singolo timestamp in una distribuzione, molto più vicina al modo in cui si comportano davvero le pipeline.
Partire dalle baseline statistiche
La baseline più semplice resta utile. Le medie mobili vi danno un baricentro mobile per gli orari di arrivo, mentre le finestre percentili, come P50, P80 e P95, mostrano quanto sia davvero ampia la dispersione normale. Monitorare il coefficiente di variazione aiuta a distinguere un feed stabile da uno che oscilla fortemente da un'esecuzione all'altra, il che in molte pipeline conta più del semplice tempo medio.
Un modello interno utile consiste nel calcolare metriche a livello di riga per il lead time effettivo, il lead time promesso e lo scostamento tra i due. Questo corrisponde alle indicazioni di observability della panoramica di digna sul riconoscimento statistico dei pattern, dove l'obiettivo non è inseguire un singolo timestamp atteso, ma rilevare strutture ripetibili nel comportamento temporale.
Aggiungere il machine learning quando il comportamento smette di essere uniforme
Il ML diventa prezioso quando la baseline stessa cambia con il carico del sistema sorgente, con i cutover regionali o con percorsi di orchestrazione complessi. Può apprendere pattern stagionali e comportamenti di arrivo che cambiano gradualmente e che le soglie semplici non colgono. Il compromesso, però, è evidente. I metodi statistici sono trasparenti e facili da analizzare, mentre il ML richiede uno storico sufficiente e un monitoraggio attento, per evitare che scambi il rumore per normalità.
Le implementazioni più solide usano entrambi. Le baseline statistiche garantiscono spiegabilità. Il ML gestisce le sfumature. Questo mix conta ancora di più negli ambienti con molto streaming, dove i pattern dei workload cambiano abbastanza in fretta da invalidare le ipotesi fisse, come spiega questo utile articolo sull'impatto dei workload di streaming.
Confronto tra metodi di modellazione delle finestre di arrivo | Ideale per | Trasparenza | Adattabilità |
|---|---|---|---|
Media mobile | Pipeline stabili con piccole derive temporali | Alta | Da bassa a moderata |
Finestre percentili | Pipeline con arrivi asimmetrici o a raffica | Alta | Moderata |
Coefficiente di variazione | Confronto della stabilità tra feed | Alta | Moderata |
Baseline apprese con ML | Pipeline complesse con comportamento variabile | Moderata | Alta |
Regola empirica: partite dal modello più semplice in grado di spiegare i vostri guasti, poi aggiungete comportamenti appresi solo dove il rumore operativo lo giustifica.
Gestire stagionalità e calendari di business nelle stime di arrivo
Una stima di arrivo ingenua si rompe nel momento in cui entra in gioco la realtà del business. I caricamenti del fine settimana seguono spesso un pattern, le chiusure di fine mese un altro, e le finestre di manutenzione creano vuoti temporali che sembrano guasti se li ignorate. Il compito della logica del tempo di consegna previsto è assorbire questi pattern, non penalizzarli.
Definire cutoff basati sul calendario
Gli orari di cutoff contano perché cambiano la data promessa, non solo la soglia di alert. Se un file di dati arriva dopo la scadenza di elaborazione, la finestra prevista dovrebbe slittare al giorno lavorativo valido successivo, invece di essere considerata “in ritardo” rispetto al giorno precedente. È la stessa idea alla base delle regole di consegna del Regno Unito, che consentono di indicare una finestra promessa come intervallo, ad esempio “da 3 a 5 giorni” o “entro 10 giorni”, purché l'impegno rispetti comunque il termine legale predefinito di 30 giorni quando applicabile, come indicato nelle linee guida di Business Companion sulle consegne e nella regola predefinita di consegna per i consumatori nel Regno Unito.
La stessa logica si applica ai patrimoni di dati globali. Un feed del warehouse che si comporta in un modo a Londra e in un altro a Sydney non dovrebbe condividere un'unica finestra promessa rigida. Calendari delle festività, confini dei periodi fiscali e pianificazioni di manutenzione regionali modificano tutti il pattern di arrivo previsto.
Trattare la stagionalità come una caratteristica, non come un'eccezione
La stagionalità fa parte del modello stesso. Se un feed rallenta sempre durante la chiusura di fine mese, quel rallentamento fa parte della finestra prevista. Se lo escludete, l'alert fatigue arriva in fretta e gli ingegneri smettono di fidarsi del sistema. È così che i team perdono la vera anomalia, perché sono sommersi da prevedibili alert di “ritardo” che non avrebbero mai richiesto un'escalation.
Indicazione pratica: la logica basata sul calendario dovrebbe cambiare il denominatore prima di cambiare l'alert. Se l'attività era chiusa, i dati non erano in ritardo nello stesso senso in cui lo sarebbero in un normale giorno lavorativo.
Progettare SLA e strategie di alerting per la puntualità dei dati
Uno SLA di puntualità funziona solo quando corrisponde alla conseguenza di business di un mancato rispetto. Una tabella che alimenta una dashboard direzionale può richiedere un cutoff rigido, mentre un feed di staging interno può richiedere solo una finestra di indagine più flessibile. Confonderli porta a reazioni eccessive o a compiacenza.
Distinguere le scadenze rigide dalle finestre flessibili
Nel trasporto merci, una must arrive by date (MABD) è un cutoff rigido, e non rispettarla può comportare penali, spedizioni rifiutate o la perdita di rapporti commerciali, con una pianificazione fatta a ritroso partendo dalla data di consegna richiesta. I team dati dovrebbero adottare questa distinzione. Alcuni dataset richiedono una regola di arrivo tassativo perché i processi downstream non possono recuperare. Altri richiedono un intervallo previsto flessibile, in cui i mancati rispetti ripetuti contano più di un singolo slittamento isolato.
Il lato consumer mostra perché questa distinzione è importante. Entro il 2025, quasi due terzi degli acquirenti a livello globale si aspettavano di ricevere gli acquisti online entro 24 ore, circa la metà voleva la spesa alimentare in meno di due ore, e una stima separata del 2025 basata su più studi indicava al 64% la quota media globale di pacchi consegnati entro due giorni di calendario, secondo i dati di Statista sulle aspettative di consegna. Le aspettative cambiano rapidamente, quindi la promessa deve essere esplicita, non implicita.
Creare alert di cui le persone si fidano
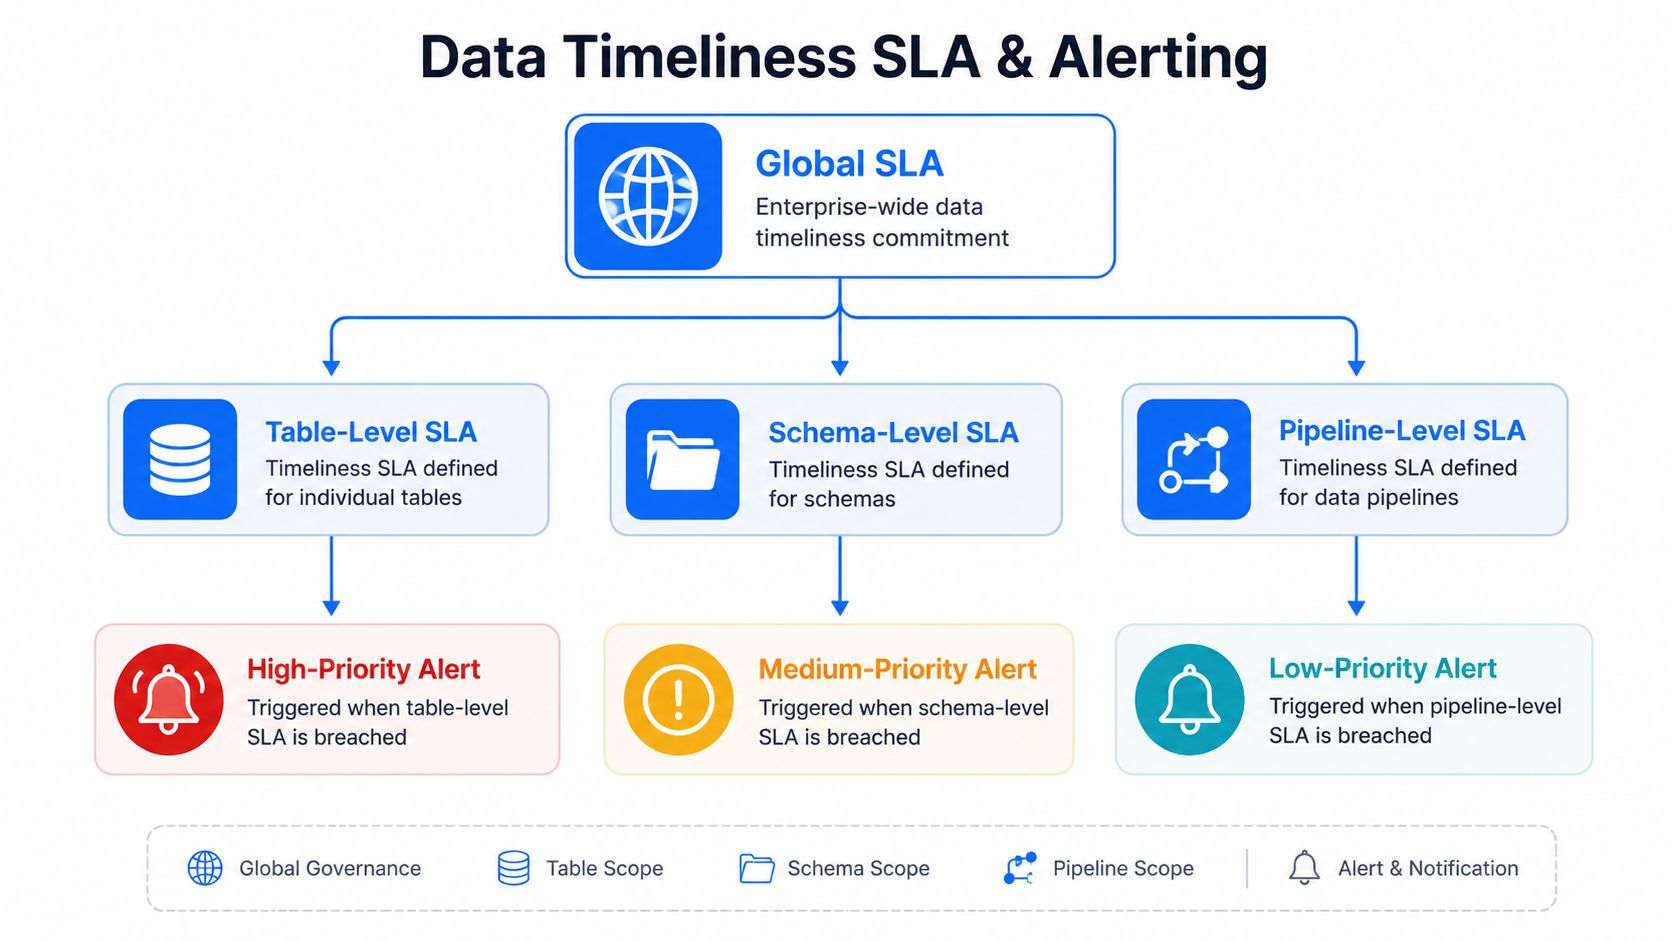
La progettazione degli alert dovrebbe ridurre il rumore prima di ridurre la latenza. Raggruppate i ritardi correlati, sopprimete gli alert durante le finestre di manutenzione note e, dove possibile, usate intervalli di confidenza invece di controlli binari superato/non superato. Uno SLA a livello di tabella può far scattare un alert ad alta priorità, mentre una variazione a livello di schema può giustificare un percorso di escalation diverso se la finestra di arrivo è ancora rispettata.
Regola operativa: se gli ingegneri ignorano un alert due volte, è sbagliato il design dell'alert, non il team.
Uno stack di SLA pratico parte dal livello delle policy globali e si restringe poi alle regole per tabelle, schemi e pipeline. Questa struttura mantiene visibile l'impatto sul business senza trasformare ogni esecuzione in ritardo in una chiamata alle 2 di notte.
Flussi di analisi delle cause per dati in ritardo o mancanti
Una finestra di arrivo mancata è un sintomo, non una diagnosi. I team più rapidi resistono alla tentazione di dare subito la colpa al warehouse. Ricostruiscono il ritardo a ritroso, dalla tabella in ritardo fino al sistema che ha introdotto il rallentamento.
Risalire dal sintomo alla sorgente
Partite dal dataset in ritardo e verificate se la sorgente upstream era in ritardo, non disponibile o incompleta. Poi esaminate i log di orchestrazione alla ricerca di esecuzioni pianificate saltate, retry falliti o colli di bottiglia nelle dipendenze. Se sorgente e scheduler sembrano a posto, passate agli errori di trasformazione e alla contesa di risorse nel warehouse, perché entrambi possono bloccare la consegna senza rendere evidente il problema in cima al DAG.
L'abitudine più utile è confrontare il ritardo attuale con i pattern storici di observability. Se la deriva temporale è isolata, probabilmente si tratta di un'anomalia. Se si allarga nel corso di diverse esecuzioni, potreste trovarvi di fronte a una pipeline che si sta degradando o a un sistema sorgente che si allontana lentamente dal suo pattern normale. È qui che l'observability sui tempi si combina bene con l'anomaly detection e lo schema tracking, perché una modifica allo schema può compromettere un caricamento senza cambiare il nome del job.
Usare una checklist di indagine ripetibile
Un flusso di lavoro conciso mantiene coerente la risposta agli incidenti.
Verificate lo stato del sistema sorgente. Confermate che il producer upstream abbia pubblicato il batch previsto.
Controllate i log della pipeline. Cercate retry, task saltati o errori di orchestrazione.
Esaminate gli errori di trasformazione. Individuate problemi di parsing silenziosi, esplosioni di valori nulli o join compromesse.
Rivedete la soglia dello SLA. Verificate che l'alert non sia stato classificato in modo errato a causa di una finestra non aggiornata.
Documentate i risultati. Registrate causa, correzione e nuova misura di protezione, così che lo stesso ritardo non si ripeta.
Il punto non è solo la velocità. È creare un percorso di indagine condiviso che riduca il tempo medio di risoluzione e renda più facile localizzare il prossimo incidente.
Consigli di implementazione in-database con digna Timeliness e Analytics
Spostare i controlli sui tempi fuori dal warehouse aggiunge attrito senza un buon motivo. Il modello più pulito è calcolare le metriche di arrivo dove i dati risiedono già, poi esporre i risultati nello stesso ambiente che conserva lo stato della pipeline. Così i dati restano nel sistema controllato dal cliente e si evita di spostare tabelle sensibili solo per misurarne la freshness.
Integrare i controlli nel warehouse
Il primo passo è calcolare in-database i tempi di arrivo effettivi, poi confrontarli con la finestra prevista appresa. digna Timeliness lo fa monitorando l'arrivo dei dati rispetto ai pattern appresi e alle pianificazioni definite dagli utenti, inclusi il tempo di consegna previsto e il rilevamento dei ritardi. In combinazione con digna Data Analytics, può esaminare le metriche storiche di observability alla ricerca di trend, segnali in rapido cambiamento e pattern statistici che aiutano a ricalibrare la finestra nel tempo.
Ho notato che questo conta soprattutto nei warehouse enterprise, dove tabelle di grandi dimensioni rendono il polling esterno scomodo e costoso. L'esecuzione in-database mantiene la metrica vicino ai dati, il che semplifica il percorso degli alert e rende il quadro operativo più affidabile.
Configurare per la pipeline che eseguite davvero
Usate la stessa logica per i pattern comuni, ma tarate la baseline sul comportamento della tabella. Per una tabella dei fatti giornaliera, la finestra prevista dovrebbe riflettere il normale slittamento dopo il cutoff. Per un feed volatile, la finestra dovrebbe essere più ampia e più probabilistica. Per un input critico di un modello downstream, abbinate il controllo sui tempi allo schema tracking e alla validazione a livello di record, così che un caricamento “in ritardo ma presente” non nasconda contenuti errati.
Se cercate un punto di partenza, il modulo digna Timeliness è progettato per monitorare gli arrivi rispetto a pattern appresi anziché a ipotesi cron fisse. Questo conta perché i sistemi di produzione non restano fissi, e non dovrebbe esserlo nemmeno il modello temporale.
Nota di implementazione: quando possibile, mantenete la metrica temporale e il consumatore degli alert nello stesso ambiente. Ogni passaggio in più aggiunge latenza, modalità di guasto e confusione.
Il modello più efficace è un piccolo ciclo: calcolare la metrica temporale, confrontarla con l'aspettativa appresa, mostrare un segnale nella dashboard e reinserire le misurazioni storiche nella baseline. Così ottenete un sistema che migliora senza trasformarsi in un insieme di regole da mantenere a mano.
Costruire una pratica sostenibile di puntualità dei dati
Il monitoraggio della puntualità funziona meglio quando fa parte di un programma più ampio di data observability, non come alert accessorio. Report obsoleti, dashboard rotte e input dell'AI inaffidabili nascono spesso dallo stesso arrivo mancato. Quando il tempo di consegna previsto diventa una metrica di primo piano, protegge contemporaneamente analisti, ingegneri e utenti di business.
Una pratica sostenibile di solito parte in piccolo. Individuate prima le tabelle critiche, stabilite una baseline iniziale, definite SLA legati all'impatto sul business, configurate l'alerting con livelli di gravità reali e poi affinate la finestra man mano che i pattern diventano più chiari. Aggiungete anomaly detection, schema tracking e validazione a livello di record allo stesso modello operativo, così che un guasto silenzioso non ne mascheri un altro.
Il business case è semplice. I dati che arrivano puntuali supportano decisioni migliori, audit più puliti e meno emergenze. Soprattutto, offrono ai team un linguaggio comune per definire cosa significhi davvero “in ritardo”, ed è questa la differenza tra reazioni sparse e un vero standard operativo.
Se volete sostituire i fragili controlli cron con finestre di arrivo apprese, visitate digna e scoprite come le sue funzionalità di puntualità, analytics, anomaly detection e validazione lavorano insieme all'interno del vostro warehouse. Iniziate dalle tabelle più importanti, poi usate lo stesso modello in-database per monitorare il rischio di ritardo prima che i dati obsoleti raggiungano il business.
Domande frequenti
Cos'è il tempo di consegna previsto per le pipeline di dati?
È la finestra appresa o concordata entro cui un dataset, una tabella o una partizione dovrebbe essere popolata e pronta per l'uso downstream. A differenza di una singola data di spedizione, è determinata da pianificazioni di orchestrazione, comportamento delle sorgenti upstream, orari di cutoff e calendari di business, e risponde alla domanda se i dati sono arrivati quando i consumatori ne avevano bisogno.
Come si calcola una finestra di arrivo prevista per una tabella?
Partite dalle baseline statistiche: medie mobili per l'orario di arrivo tipico, finestre percentili come P50, P80 e P95 per la dispersione normale e il coefficiente di variazione per distinguere i feed stabili da quelli volatili. Aggiungete il machine learning solo quando il comportamento cambia con il carico della sorgente, con i cutover regionali o con un'orchestrazione complessa.
Come dovrebbero gestire fine settimana e fine mese gli alert sulla puntualità dei dati?
Trattate la stagionalità come parte del modello, non come un'eccezione. Caricamenti del fine settimana, chiusure di fine mese e finestre di manutenzione seguono pattern propri. Se un file arriva dopo il cutoff di elaborazione, fate slittare la finestra prevista al giorno lavorativo valido successivo. Escludere questi pattern genera prevedibili alert di ritardo e alert fatigue.
Qual è la differenza tra una scadenza rigida e una finestra flessibile negli SLA sui dati?
Una scadenza rigida funziona come la must arrive by date (MABD) del trasporto merci: se non viene rispettata, i processi downstream non possono recuperare, quindi giustifica alert ad alta priorità. Una finestra flessibile è un intervallo previsto in cui i mancati rispetti ripetuti contano più di un singolo slittamento. Una tabella per una dashboard direzionale può richiedere la prima, un feed di staging la seconda.
Come si indaga su dati in ritardo o mancanti?
Risalite dal sintomo alla sorgente con una checklist ripetibile: verificate lo stato del sistema sorgente, controllate i log della pipeline per retry o task saltati, esaminate gli errori di trasformazione, valutate se la soglia dello SLA è superata e documentate la causa e la nuova misura di protezione. Confrontate il ritardo con i pattern storici per distinguere le anomalie isolate dalle pipeline in degrado.