Tecniche di profilazione dei dati che intercettano davvero il drift
|
7
min di lettura

Di solito non vi accorgete di una lacuna nella profilazione quando tutto è verde. Ve ne accorgete quando una dashboard si carica ancora, il team finance si fida ancora del numero e un modello inizia a prendere decisioni peggiori perché una tabella sorgente ha cambiato forma, un campo ha iniziato a contenere valori misti o un join ha smesso di allinearsi come faceva prima.
È questo il compito delle tecniche di profilazione dei dati. Non produrre un ordinato foglio di calcolo di statistiche, ma intercettare il drift strutturale, semantico e comportamentale prima che raggiunga gli analisti, i livelli di BI o le pipeline di ML. Nella pratica, i team che realizzano warehouse affidabili trattano la profilazione come parte del flusso dei dati, non come un audit collaterale che avviene una volta e poi viene archiviato.
Indice
Le tre classi di profilazione che ogni team dovrebbe conoscere
Confronto tra le tecniche fondamentali che intercettano i guasti reali
Analisi delle distribuzioni, rilevamento del drift e la trappola del campionamento
Dagli audit una tantum alla profilazione continua e all'osservabilità
Distinguere le variazioni innocue dai cambiamenti critici per il business
Checklist operativa per una profilazione pronta per la produzione
Quando un drift silenzioso rompe la dashboard
Una dashboard trimestrale dei ricavi può sembrare perfettamente in salute mentre la pipeline sottostante sta già andando alla deriva. La tabella sorgente arriva ancora, il job termina ancora e la metrica viene ancora visualizzata, ma un percorso di trasformazione non corrisponde più a un nuovo codice valuta. La previsione peggiora per prima, poi gli analisti iniziano a chiedersi perché i numeri sembrino “strani”, e solo in seguito qualcuno scopre che il warehouse stava accettando una forma di dati che la logica a valle non si sarebbe mai aspettata.
Ecco perché la profilazione deve vivere all'interno della pipeline. Un audit su foglio di calcolo può dirvi che una colonna contiene null, ma non vi salverà quando il problema è una modifica dello schema, una relazione interrotta tra tabelle o un pattern di valori che non corrisponde più alla regola di business che il vostro codice presuppone. Il valore fondamentale delle tecniche di profilazione dei dati è che fanno emergere questi problemi abbastanza presto da poter ancora intervenire.
Regola pratica: se un problema nei dati può rompere una dashboard, un report o un modello senza modificare il numero di righe, i semplici controlli di freschezza non bastano.
I team migliori considerano la profilazione una disciplina operativa. Non si chiedono se i dati siano “puliti” in un senso astratto. Si chiedono quale modalità di guasto può intercettare ciascuna tecnica, dove si colloca nel flusso e che cosa continua a non cogliere. È questa la differenza tra un'ispezione una tantum e una pratica di osservabilità.
Un modo utile per inquadrarla è attraverso la data observability stessa, che collega profilazione, monitoraggio e validazione in un unico ciclo operativo. Una buona panoramica è what is data observability di NanoPIM, perché aiuta a capire perché la profilazione vada affiancata al monitoraggio live anziché a una documentazione separata.
Il cambiamento importante è mentale, non tecnico. La profilazione non serve a creare altri artefatti. Serve a intercettare il drift prima che il business lo avverta.
Le tre classi di profilazione che ogni team dovrebbe conoscere
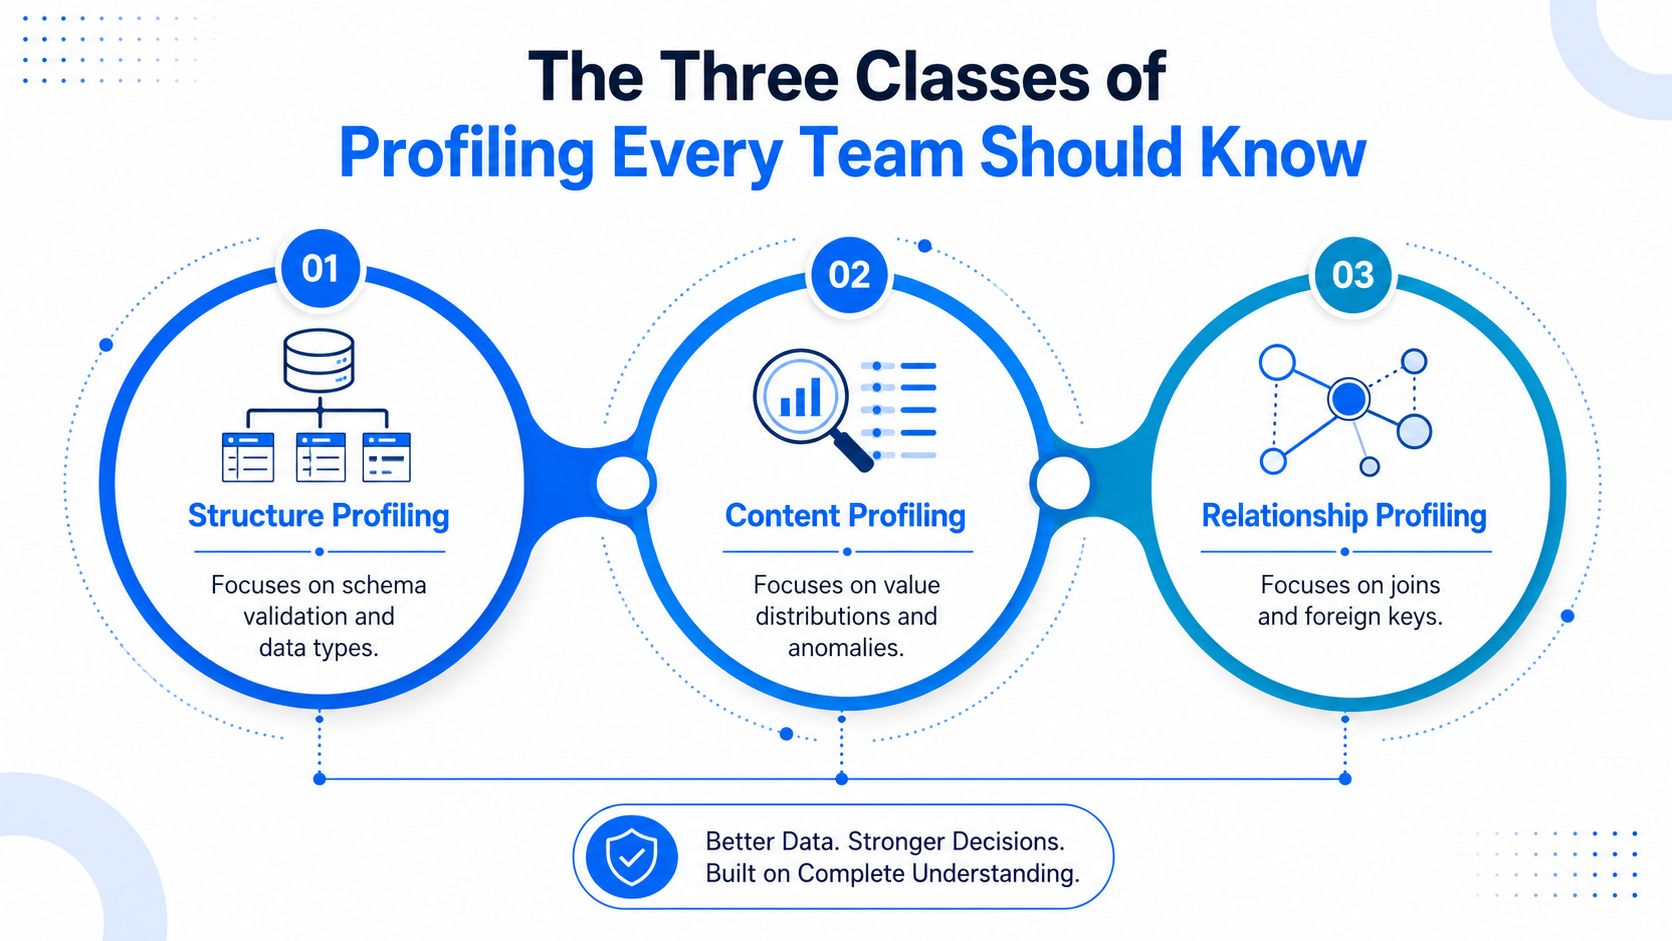
La profilazione dei dati è formalmente definita nella letteratura accademica come l'insieme di attività e processi utilizzati per determinare i metadati di un dataset, ed è descritta anche come la creazione di riepiloghi piccoli ma informativi di un database (HPI). Questa definizione è importante perché ancora il lavoro ai riepiloghi, non a un'ispezione manuale completa.
Scoperta della struttura
La scoperta della struttura risponde alla domanda: “Questo dataset ha l'aspetto che il sistema si aspetta?”. Controlla schema, tipi, chiavi e coerenza dei formati. In una tabella clienti, è qui che si intercetta una colonna che sembra numerica ma contiene in realtà un mix di stringhe formattate come valuta, oppure un campo che è stato riutilizzato per altro e ora contiene valori che la logica del warehouse non riesce ad analizzare correttamente.
Scoperta del contenuto
La scoperta del contenuto resta all'interno dei valori stessi. Misura null, conteggi distinti, valori minimi e massimi, lunghezza, frequenze e pattern, ed è per questo che spesso costituisce la prima linea di difesa per completezza e coerenza. La panoramica di stampo istituzionale di datos.gob.es sull'importanza della profilazione dei dati lo rende concreto, indicando conteggi dei null, valori distinti, tipi di dati e pattern frequenti come controlli fondamentali.
Scoperta delle relazioni
La scoperta delle relazioni guarda trasversalmente a campi e tabelle. È qui che si individuano dipendenze funzionali, candidati a chiave esterna, problemi di cardinalità e incongruenze tra tabelle. In termini di warehouse, intercetta i casi in cui due tabelle fanno riferimento alla stessa entità di business ma non concordano sul fatto che il null sia ammesso, oppure in cui una tabella ha smesso di corrispondere alle chiavi della tabella padre.
Il modello mentale utile è semplice. Se il problema è all'interno di una colonna, siete nel territorio del contenuto. Se è all'interno di una riga, aiuta la profilazione tra colonne. Se si estende su più tabelle, la profilazione delle relazioni è la lente giusta. È anche per questo che una piattaforma di osservabilità più ampia è preziosa: un warehouse moderno non fallisce in una sola dimensione. Fallisce quando struttura, contenuto e relazioni smettono di concordare tra loro, e il significato di profilazione dei dati secondo digna si inserisce naturalmente in questa visione operativa.
Confronto tra le tecniche fondamentali che intercettano i guasti reali
Molti consigli sulla profilazione si fermano all'elenco delle metriche. È troppo superficiale per il lavoro in produzione. La domanda è quale tecnica blocca quale guasto, e quale si limita a rendere visibile il problema dopo che ha già raggiunto il warehouse.
Tecniche di profilazione in sintesi | Intercetta | Non coglie | Ideale per |
|---|---|---|---|
Statistiche a livello di colonna | Tassi di null, intervalli, conteggi distinti, variazioni di lunghezza, outlier evidenti | Logica tra campi, rotture delle relazioni, contesto delle regole di business | Controlli di primo livello sulle colonne critiche |
Profilazione dei pattern e semantica | Tipi misti, stringhe malformate, drift dei formati, cambiamenti nei pattern dei valori | Valori apparentemente validi ma semanticamente errati | ID, email, codici, date, campi valuta |
Controlli di unicità e di chiave esterna | Chiavi duplicate, violazioni dell'integrità referenziale, mancate corrispondenze nei join | Drift della distribuzione all'interno di una colonna, variazioni stagionali | Integrità tra fatti e dimensioni, entity resolution |
Le statistiche a livello di colonna sono economiche e utili. Vi dicono quando la completezza di un campo cambia, quando l'intervallo si sposta o quando i conteggi distinti crollano all'improvviso. Non bastano quando i dati “sembrano” ancora validi ma non corrispondono più al modo in cui il business li utilizza.
La profilazione dei pattern e quella semantica hanno uno scopo diverso. Individuano problemi come colonne con tipi misti, formati rotti o campi che iniziano a contenere valori provenienti da un nuovo sistema sorgente. Qui i controlli con regex e le regole di formato si rivelano preziosi, perché un valore può essere non null ed essere comunque errato.
Un controllo di unicità su un campo email è un controllo di qualità. Un controllo di unicità su un campo di commento a testo libero è rumore.
I controlli sulle relazioni sono i più sottovalutati, perché intercettano guasti che le semplici scansioni dei campi non vedono mai. Chiavi duplicate, record padre mancanti e incongruenze tra tabelle possono distruggere la fiducia anche quando ogni tabella, presa singolarmente, sembra ragionevole. Per gli ingegneri del warehouse, spesso è questa la differenza tra un problema a livello di riga e un incidente a livello di pipeline.
Il compromesso è il costo. I controlli su scala completa possono essere costosi su tabelle molto grandi, quindi i team di solito riservano la logica relazionale più intensiva ai join di alto valore, alle dimensioni critiche e alle tabelle che alimentano reporting o modelli. È anche per questo che scegliere la tecnica conta più che scegliere una dashboard. Il controllo sbagliato può sembrare approfondito e lasciarsi sfuggire proprio il guasto che fa male.
Analisi delle distribuzioni, rilevamento del drift e la trappola del campionamento
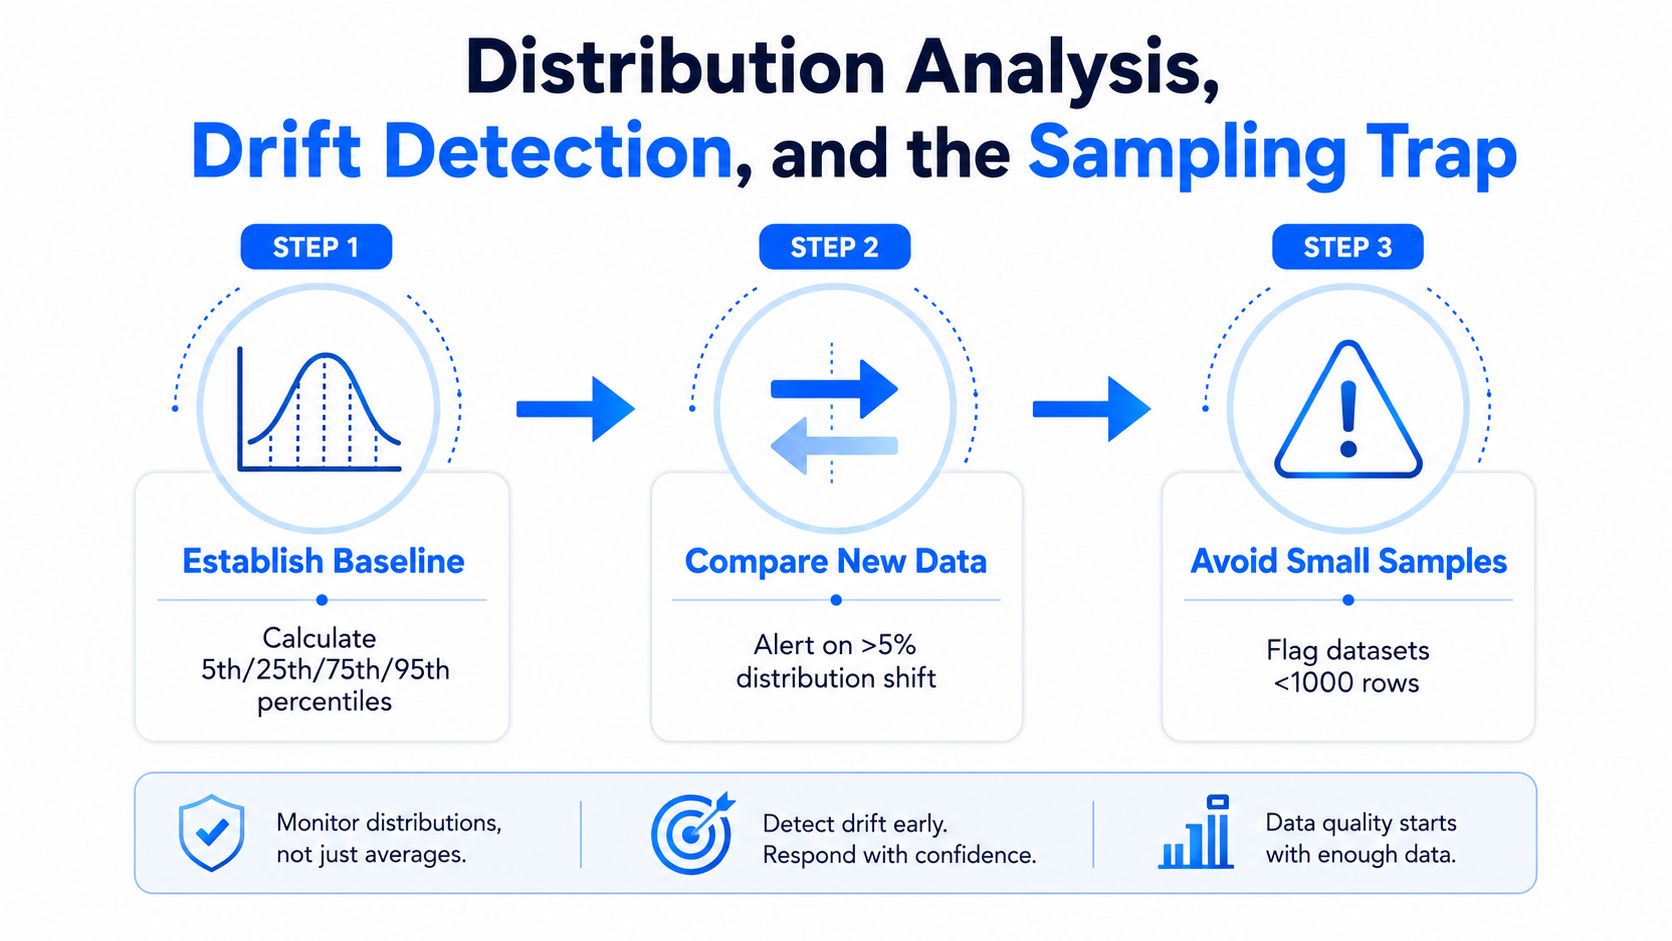
L'analisi delle distribuzioni è il punto in cui la profilazione inizia ad assomigliare all'osservabilità anziché alla contabilità. Istogrammi, sketch di quantili e frequenze categoriche vi permettono di vedere se una colonna si comporta ancora come ieri, la settimana scorsa o al lancio del progetto. L'obiettivo non è solo contare i valori, ma accorgersi quando la forma dei dati cambia abbastanza da minacciare le decisioni a valle.
Il vero patrimonio sono le baseline
L'errore che molti team commettono è considerare un singolo profilo come il prodotto finale. Il patrimonio utile è la baseline. Una volta che conoscete la dispersione abituale dei valori, potete confrontare con essa i nuovi arrivi e individuare un drift che non compare nel numero di righe o nei tassi di null. Questo è particolarmente importante per gli input di AI e analytics, dove spostamenti silenziosi della distribuzione possono degradare le prestazioni senza rompere la pipeline.
Il campionamento aiuta, finché non smette di farlo
Un pattern operativo comune consiste nel profilare un campione di 10.000 righe quando l'analisi dell'intera tabella non è praticabile, per poi ricavare da quel campione le stesse statistiche descrittive che guidano la correzione e la progettazione del reporting (sparvi.io). Funziona bene quando la tabella è enorme e l'obiettivo è ottenere una lettura rapida dei dati. Non funziona più quando le anomalie sono rare, asimmetriche o legate a partizioni specifiche che un campione casuale potrebbe non cogliere.
Il drift ha bisogno di contesto, non solo di soglie
Una baseline da sola non vi dice se un cambiamento è negativo. È qui che rilevamento del drift e contesto di business si incontrano. L'abitudine utile è mantenere metriche economiche in esecuzione continua, per poi passare a controlli più approfonditi quando il profilo cambia in un modo rilevante per uno specifico dominio, percorso di join o input di un modello.
La lezione pratica è trattare la profilazione come un problema a più risoluzioni. I riepiloghi a basso costo vengono eseguiti spesso. I controlli più costosi vengono eseguiti secondo una pianificazione o in caso di cambiamento. E il segnale conta solo quando viene valutato rispetto all'impatto reale sul business, non soltanto rispetto a una soglia universale.
Le indicazioni precedenti sul rilevamento del data drift di digna si sposano bene con questa logica, perché il drift è utile solo quando è legato a una baseline reale e a una risposta operativa reale.
Implementare la profilazione in SQL e nel database
I sistemi di profilazione più puliti sono quelli che mantengono i dati dove risiedono già. L'esecuzione push-down all'interno del warehouse evita spostamenti aggiuntivi, riduce i grattacapi di governance e rende la profilazione abbastanza economica da poterla eseguire spesso. L'approccio “estrai e poi profila” può funzionare per job piccoli o temporanei, ma aggiunge latenza e crea un ulteriore punto in cui i dati sensibili possono finire in un motore separato.
Partite da SQL basato sugli aggregati
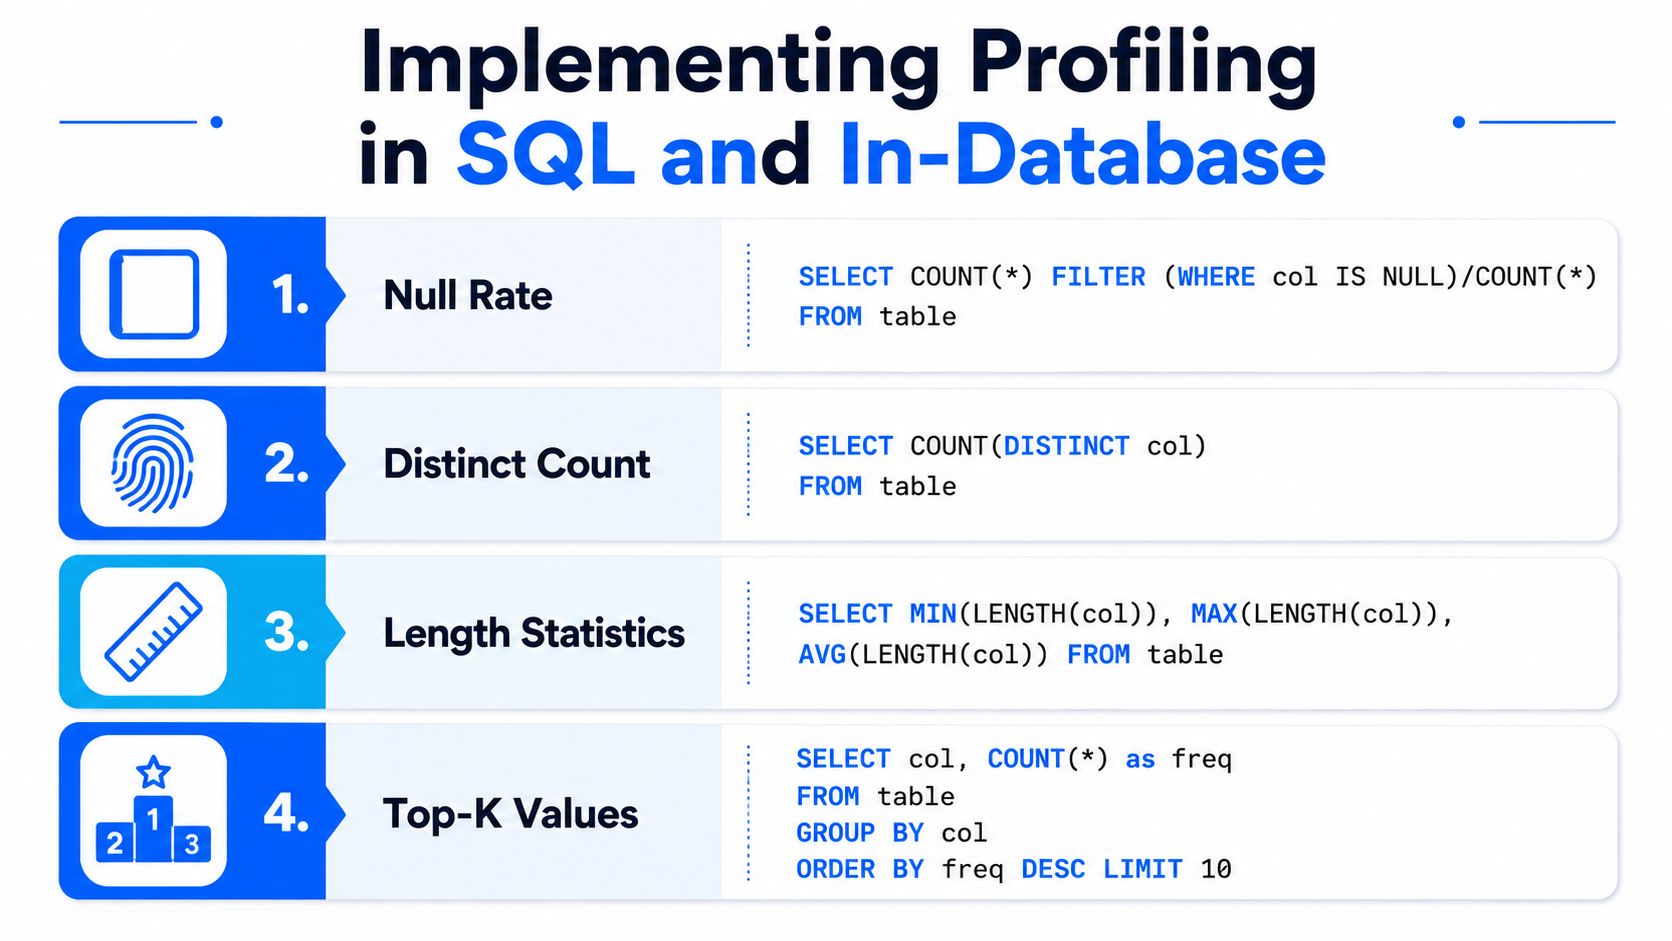
Tasso di null, conteggio distinto, statistiche sulla lunghezza e valori top-K sono i cavalli di battaglia della profilazione nel warehouse. Sono veloci, facili da spiegare e immediatamente utili per individuare dati mancanti, duplicazioni e drift dei formati. Nella maggior parte dei warehouse, sono le prime metriche che mi aspetterei vengano calcolate nativamente da un job di profilazione.
Usate algoritmi approssimati dove la scala lo richiede
Il calcolo esatto di cardinalità e distribuzioni diventa costoso su scala enterprise, ed è per questo che i metodi approssimati sono importanti. HyperLogLog aiuta con la cardinalità, mentre t-digest o gli sketch di quantili aiutano a preservare la forma della distribuzione senza scansionare ogni record nel modo più costoso. Lo scopo non è l'eleganza matematica, ma rendere la profilazione abbastanza economica da poterla eseguire in modo continuo.
Regola operativa: se un job di profilazione deve spostare i dati grezzi fuori dal warehouse per essere praticabile, probabilmente non ha la forma giusta per la produzione.
Conservate il riepilogo, non la copia grezza
La profilazione nel database aiuta anche con la residenza dei dati. Solo i riepiloghi escono dal warehouse, quindi l'output diventa metadati, trend e alert anziché un'ulteriore copia del sistema sorgente. Questo è importante per i team dei settori finanziario, sanitario, delle telecomunicazioni e della pubblica amministrazione, dove controlli di accesso e auditabilità fanno parte della progettazione, non sono ripensamenti.
Per i team che valutano le piattaforme, un utile punto di riferimento è verificare se lo strumento supporta baseline di profilo, tracciamento dello schema, conteggi di null e valori distinti e regole di validazione senza dipendere da una fase di estrazione separata. digna è un'opzione in questa categoria, perché calcola le metriche all'interno dell'ambiente del cliente e mantiene i dati residenti, mettendo in evidenza trend, modifiche allo schema e segnali di validazione.
I migliori flussi di profilazione non sembrano job che si “eseguono”. Sembrano strumentazione. Il warehouse sta già facendo il lavoro, e il livello di profilazione si limita a estrarre i segnali utili.
Dagli audit una tantum alla profilazione continua e all'osservabilità
Una profilazione eseguita solo all'avvio del progetto arriva già troppo tardi per le pipeline moderne. I sistemi sorgente cambiano, vengono aggiunte colonne, i tipi di dati si modificano e i pattern di arrivo slittano senza preavviso. Se la profilazione resta un audit una tantum, diventa documentazione, non protezione.
L'evoluzione utile è far confluire la profilazione nell'osservabilità. Statistiche sulle colonne, controlli sui pattern, tracciamento dello schema e confronti con le baseline diventano input per il rilevamento delle anomalie, il monitoraggio della tempestività e le regole di validazione all'interno di un'unica superficie operativa. Questa combinazione è importante perché un warehouse può essere strutturalmente valido e fornire comunque dati obsoleti o fuorvianti.
Che cosa cambia davvero la profilazione continua
La profilazione continua offre ai team tre cose che un report statico non dà. Offre uno storico, così che i cambiamenti possano essere confrontati nel tempo. Offre contesto, così che un alert possa essere collegato a una tabella, a un campo o a una dipendenza a valle. E offre una prioritizzazione, così che il team possa concentrarsi sui segnali che incidono sui flussi di lavoro reali anziché su ogni fluttuazione innocua.
Perché l'osservabilità vince sui fogli di calcolo
Una profilazione in stile foglio di calcolo va bene per un'indagine una tantum, ma non scala come piano di controllo. Nel momento in cui i dati cambiano più velocemente di quanto il foglio possa essere aggiornato, il processo manuale diventa un indicatore in ritardo. Una piattaforma di osservabilità trasforma la profilazione in un sistema di riferimento live per lo stato di salute dei dati.
Nel momento in cui i dati di profilazione iniziano a essere esaminati dopo che lo stakeholder ha già notato il problema, avete perso il vantaggio.
È anche qui che una piattaforma come digna si inserisce in modo naturale. Il suo rilevamento delle anomalie apprende il comportamento normale senza costringere i team a mantenere migliaia di regole scritte a mano, il tracciamento dello schema segnala colonne aggiunte, rimosse o con tipo modificato, e il monitoraggio della tempestività confronta l'arrivo effettivo con le aspettative apprese. Poiché viene eseguita nell'ambiente del cliente, l'analisi resta all'interno del warehouse o del deployment controllato, anziché far rimbalzare i dati attraverso sistemi aggiuntivi.
Il cambiamento pratico è semplice. La profilazione statica si chiede che aspetto avessero i dati. La profilazione continua si chiede che cosa è cambiato, quando è cambiato e se qualcuno deve intervenire subito.
Distinguere le variazioni innocue dai cambiamenti critici per il business
Più metriche non producono automaticamente una profilazione migliore. Possono creare un sistema di allarme più rumoroso che continua a non cogliere il cambiamento che conta. I team più esperti imparano a ordinare i segnali in base all'impatto sul business prima di decidere se un picco è un difetto, uno spostamento stagionale o solo una variazione da tenere d'occhio.
Date priorità a ciò che il business avvertirà
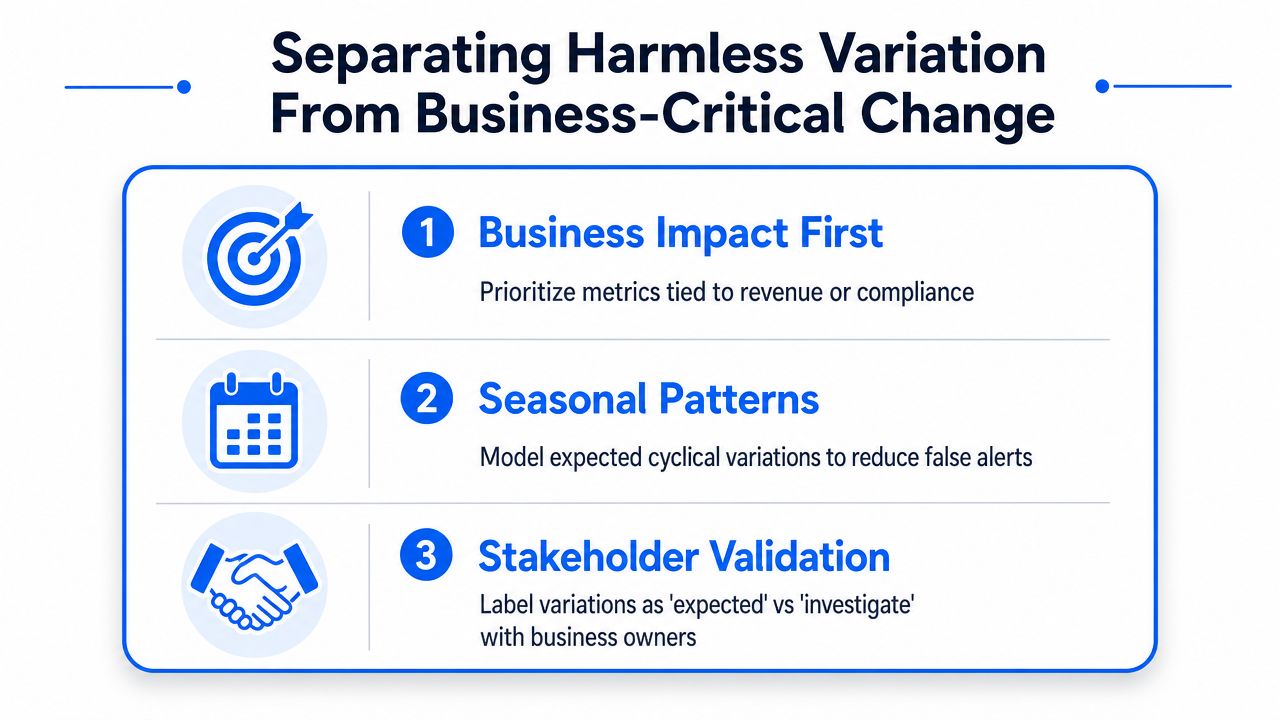
Se un cambiamento non incide su una metrica regolamentata, su una feature di machine learning, su uno SLA a valle o su un report per il management, non dovrebbe ricevere la stessa attenzione di uno che lo fa. La profilazione diventa gestione del rischio. La domanda giusta non è se un segnale esiste, ma chi ne subisce le conseguenze se viene ignorato.
Non trattate tutti i domini allo stesso modo
Finanza, sanità, telecomunicazioni e reporting della pubblica amministrazione non possono usare la stessa sensibilità predefinita. Le loro tolleranze differiscono perché differiscono i costi di un falso negativo e di un falso positivo. Un campo che può variare senza rischi in un dominio può essere inaccettabile in un altro, anche se i numeri grezzi sembrano simili.
Abbinate i controlli statistici alle regole di business
La profilazione statistica può dirvi che qualcosa è cambiato. Le regole di business vi dicono se quel cambiamento è previsto. Questo abbinamento riduce i falsi positivi senza attenuare la sensibilità, soprattutto quando pattern stagionali o ciclici fanno parte della normale operatività.
Un buon playbook di triage è breve. Indica il responsabile, il percorso di escalation e l'etichetta per la variazione: prevista o da indagare. Offre inoltre agli utenti di business un modo per verificare se lo spostamento corrisponde a un comportamento noto, prima che gli ingegneri perdano tempo a inseguire un falso problema.
La mentalità utile qui è l'onestà. La profilazione non è un conteggio dei punti, e un elenco di alert più lungo non significa un warehouse più sicuro. Significa più lavoro, a meno che i segnali non vengano ordinati in base all'impatto.
Checklist operativa per una profilazione pronta per la produzione
Il pattern di produzione più sicuro è profilare presto, profilare sul posto e profilare in modo continuo. Questo significa eseguire controlli all'avvio del progetto, prima dell'ETL, durante la trasformazione e di nuovo dopo che la pipeline è in produzione. Significa anche coprire il comportamento a livello di colonna, tra colonne e tra tabelle, perché il guasto che vi sfugge è di solito quello che esula dal perimetro del controllo attuale.
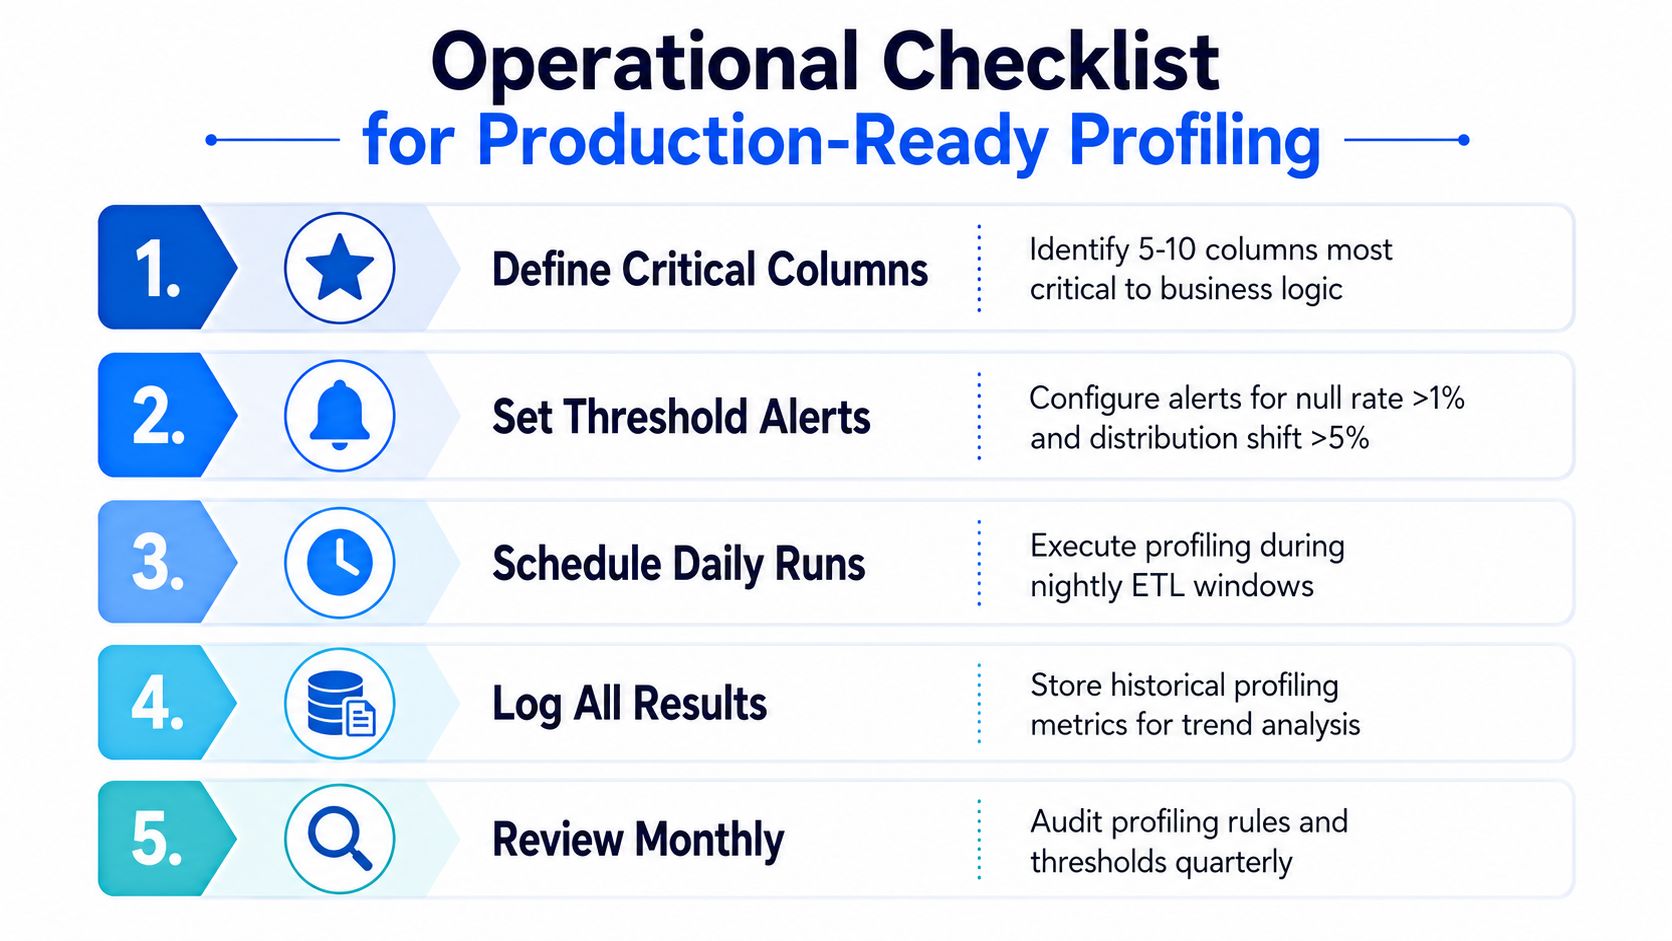
Che cosa mettere in atto per primo
Partite dalle colonne che contano per la logica di business, non dall'intero warehouse. Poi definite soglie per null, drift e regole di validazione su quei campi, e conservate i risultati per poter confrontare oggi con ieri. È il contesto storico a trasformare un profilo in un sistema di alerting.
Che cosa evitare
Non inviate i dati grezzi a un motore di profilazione separato se non è necessario. Non affidatevi solo alle medie. Non considerate una scansione dello schema come prova che i dati siano sicuri. E non lasciate che ogni team inventi le proprie soglie senza una policy condivisa, perché è così che il rumore degli alert si accumula.
L'abitudine di produzione che resta
Eseguite la profilazione dove i dati risiedono già, tracciate le modifiche allo schema insieme alle statistiche e instradate i segnali attraverso un unico punto in grado di combinare rilevamento delle anomalie, tempestività e validazione. È questa la forma di un vero piano di controllo, ed è il motivo per cui l'osservabilità nel database supera la profilazione in stile foglio di calcolo per i warehouse moderni.
Se state scegliendo una piattaforma o rafforzando un flusso di lavoro esistente, iniziate profilando le tabelle che determinano ricavi, reporting e qualità degli input dei modelli, poi collegate i controlli a più alto rischio a un livello di monitoraggio continuo. Se volete che tutto questo venga eseguito all'interno del warehouse, con rilevamento delle anomalie, tracciamento dello schema e validazione in un unico sistema, date un'occhiata approfondita a digna.
Per conservare le baseline di profilo come storico e confrontare le statistiche di oggi con quelle della settimana scorsa, scoprite come digna Data Analytics traccia trend e pattern statistici nel tempo.
Domande frequenti
Quali sono i principali tipi di profilazione dei dati?
Esistono tre classi. La scoperta della struttura controlla schema, tipi, chiavi e coerenza dei formati. La scoperta del contenuto misura null, conteggi distinti, valori minimi e massimi, lunghezze, frequenze e pattern. La scoperta delle relazioni analizza trasversalmente campi e tabelle alla ricerca di dipendenze funzionali, candidati a chiave esterna, problemi di cardinalità e incongruenze tra tabelle.
Il campionamento è sufficiente per la profilazione dei dati?
Il campionamento offre una lettura rapida, ma ha limiti chiari. Un pattern comune profila un campione di 10.000 righe quando l'analisi dell'intera tabella non è praticabile, per poi ricavarne statistiche descrittive. Non funziona più quando le anomalie sono rare, asimmetriche o legate a partizioni specifiche che un campione casuale può non cogliere, quindi le tabelle critiche richiedono una copertura più completa.
Come si profilano i dati in SQL su larga scala?
Partite da SQL basato sugli aggregati: tasso di null, conteggio distinto, statistiche sulla lunghezza e valori top-K, calcolati nativamente nel warehouse. Per le tabelle su scala enterprise, passate ad algoritmi approssimati come HyperLogLog per la cardinalità e t-digest o sketch di quantili per la forma della distribuzione, così che la profilazione resti abbastanza economica da essere eseguita in modo continuo senza spostare i dati grezzi.
Come rileva il data drift la profilazione dei dati?
Il drift emerge quando i nuovi dati vengono confrontati con una baseline memorizzata. Istogrammi, sketch di quantili e frequenze categoriche rivelano se una colonna si comporta ancora come ieri o la settimana scorsa, intercettando spostamenti che non compaiono mai nel numero di righe o nei tassi di null. Le metriche economiche vengono eseguite in modo continuo e i controlli più approfonditi si attivano quando il profilo cambia.
Qual è la differenza tra profilazione dei dati una tantum e continua?
La profilazione una tantum registra l'aspetto dei dati all'avvio del progetto; la profilazione continua traccia che cosa è cambiato, quando e se qualcuno deve intervenire. Aggiunge uno storico per i confronti nel tempo, un contesto che collega un alert a una tabella, a un campo o a una dipendenza, e una prioritizzazione che permette ai team di concentrarsi sui segnali che incidono sui flussi di lavoro reali.


