I 10 migliori strumenti di monitoraggio della qualità dei dati del 2026
|
6
min di lettura

Conoscete già lo schema. Una dashboard si rompe il lunedì mattina, il top management chiede se il fatturato è in calo o se la pipeline è in ritardo, e il vostro team passa le ore successive a dimostrare se il problema sta nei dati, nella logica di trasformazione o nel livello di reporting. È proprio in quel momento che molte organizzazioni iniziano a cercare strumenti di monitoraggio della qualità dei dati.
Il problema è che la categoria è affollata ed eterogenea. Alcuni ricercatori accademici hanno individuato 667 diversi strumenti software dedicati specificamente alla qualità dei dati, per poi restringere la raccolta a un insieme più piccolo da valutare in modo approfondito, osservando che il monitoraggio continuo è diventato un requisito aziendale fondamentale. In pratica, questo significa che i soli elenchi di funzionalità non aiutano molto. Molti prodotti sanno profilare una tabella o generare un alert su un picco di valori null. Molti meno sono in grado di supportare monitoraggio continuo, validazione delle regole di business, controlli di tempestività e workflow di gestione degli incidenti utilizzabili senza creare nuovo attrito operativo.
Anche il mercato si muove rapidamente. Mordor Intelligence prevede che il mercato globale degli strumenti di qualità dei dati passerà da 2,78 miliardi di USD nel 2025 a 7,39 miliardi di USD entro il 2031, con un CAGR del 17,7%. Questa crescita è legata a un reale cambiamento nelle aspettative degli acquirenti. I team vogliono il rilevamento automatico delle anomalie, meno regole fragili scritte a mano e una copertura che si estenda a data warehouse, data lake e output BI.
Questo elenco si concentra sui compromessi pratici. Quali strumenti sono più forti negli ambienti sensibili alla privacy. Quali si adattano ai moderni ecosistemi cloud. Quali sono più facili da introdurre di quanto sembri. E dove digna si distingue se la vostra organizzazione non può accettare spostamenti di dati non necessari.
Indice
1. digna
Uno scenario di acquisto aziendale tipico è questo. Il team dati vuole il rilevamento automatico delle anomalie su tabelle e pipeline del data warehouse. Poi security e ufficio legale bloccano la valutazione quando si rendono conto che lo strumento richiede un ampio accesso lato vendor ai dati di produzione. digna è uno dei pochi prodotti di questo gruppo che affronta il problema a livello di architettura, perché esegue l'analisi all'interno del data warehouse, del data lake, del private cloud o dell'ambiente on-premises del cliente.
Questa distinzione è importante perché il modello di deployment cambia il costo effettivo di gestione di uno strumento di qualità dei dati. Un monitoraggio esternalizzato può comportare spostamenti di dati, cicli di revisione aggiuntivi ed eccezioni di sicurezza che rallentano il procurement molto prima che la piattaforma arrivi in produzione. OvalEdge sottolinea un aspetto simile nella sua analisi degli strumenti di monitoraggio della qualità dei dati, in particolare per gli ambienti regolamentati che non possono accettare un ampio accesso di terze parti ai dataset live.
Perché digna si distingue
digna unisce data observability e qualità dei dati in un'unica piattaforma. Le funzionalità coprono rilevamento delle anomalie basato sull'AI, baseline statistiche, controlli di tempestività, analisi dei trend, validazione a livello di record e tracciamento dello schema. Per i team enterprise che cercano di razionalizzare lo stack, è una scelta progettuale concreta. Riduce la necessità di gestire un prodotto per gli alert, un altro per le regole e un insieme crescente di controlli personalizzati che nessuno vorrà più mantenere sei mesi dopo.
Anche il suo modello di monitoraggio rispecchia il modo in cui di solito evolvono i team maturi. I programmi iniziali possono cavarsela con soglie impostate a mano. Su larga scala, le regole statiche diventano costose da calibrare e facili da ignorare. Le analisi di settore sulle categorie moderne di strumenti di qualità dei dati distinguono sempre più spesso il rilevamento delle anomalie basato sul ML dai classici motori di regole proprio per questo motivo. digna segue questo approccio con l'apprendimento automatico delle baseline, invece di costringere ogni condizione in una logica scritta manualmente.
Un filtro pratico aiuta in questo caso.
Regola pratica: se l'ufficio legale, la security o il platform engineering non approveranno l'invio di dati di produzione a un servizio gestito dal vendor, eliminate quei vendor dalla shortlist prima che inizi il proof of concept.
digna sembra inoltre progettata per un pubblico eterogeneo, non solo per i data engineer. L'interfaccia è pensata per supportare utenti tecnici e di business, un aspetto importante nelle aziende in cui i team di stewardship, operations e analytics devono interpretare tutti gli stessi incidenti. Per una visione più ravvicinata del prodotto, il riferimento più chiaro è la panoramica di digna sul monitoraggio della qualità dei dati in ambienti privati.
Casi d'uso ideali e compromessi
In una valutazione di 10 strumenti, digna si distingue soprattutto per le organizzazioni attente alla privacy. Servizi finanziari, sanità, telecomunicazioni, pubblica amministrazione e grandi aziende B2B con controlli rigorosi sui dati dei clienti sono i casi d'uso più evidenti. Questi team hanno spesso bisogno di un'unica piattaforma in grado di monitorare la tempestività, validare i record e restare entro i perimetri di sicurezza esistenti.
I compromessi sono chiari.
Vantaggio principale: l'esecuzione all'interno del vostro ambiente mantiene i dati nel vostro stack, il che può semplificare le verifiche di compliance e ridurre gli spostamenti di dati.
Punto di forza operativo: il monitoraggio della tempestività e degli arrivi attesi è utile in produzione, soprattutto per intercettare i caricamenti in ritardo prima che dashboard obsolete provochino escalation fino al management.
Limite principale: i prezzi non sono pubblici, quindi la valutazione commerciale parte da un processo di vendita.
Realtà dell'implementazione: anche il monitoraggio basato sull'AI richiede un periodo di rodaggio delle baseline, la revisione degli alert e una calibrazione durante il rollout.
Per gli acquirenti enterprise che usano l'architettura come criterio di selezione vincolante, digna merita un'attenta valutazione. Non è la scelta predefinita per ogni team. È particolarmente adatta quando privacy, controllo del deployment e copertura operativa devono essere decisi insieme anziché come acquisti di strumenti separati.
2. Monte Carlo
Uno scenario aziendale tipico è questo. Il team dati gestisce Snowflake, dbt, Airflow e BI su decine di domini, ma durante un incidente nessuno sa rispondere a una domanda semplice: dove è iniziato il guasto, quali asset a valle sono coinvolti e chi deve intervenire per primo? Monte Carlo è costruito per questo modello operativo.
Monte Carlo è uno dei vendor più affermati nella data observability. Il suo punto di forza è l'ampiezza. Automatizza il monitoraggio di freshness, volumi, schema, lineage e comportamento delle pipeline, il che lo rende un'opzione seria per le aziende che hanno bisogno di un'unica piattaforma per sorvegliare gran parte dello stack invece di combinare strumenti più specifici.
Questo conta in un confronto tra 10 strumenti, perché Monte Carlo rappresenta il classico acquisto di observability enterprise. Dà il meglio quando la priorità è la visibilità centralizzata e l'organizzazione è disposta a investire nelle operations della piattaforma per sostenerla. È un approccio d'acquisto diverso da quello dei prodotti privacy-first come digna, dove i vincoli di deployment possono orientare la decisione prima dell'ampiezza delle funzionalità.
Dove Monte Carlo funziona meglio
Monte Carlo funziona meglio negli ambienti cloud-first con molta complessità a monte e a valle. Grandi team di analytics engineering, gruppi centralizzati di data platform e aziende con processi formali di incident management sono di solito quelli che ne traggono il massimo. Il lineage è una parte importante della proposta di valore, soprattutto quando il costo complessivo di un problema non è la tabella rotta in sé, ma l'incertezza che genera su dashboard, modelli e processi di business.
Contano anche le opzioni di deployment. I pattern basati su agent e su VPC offrono ai team di security e infrastruttura più margine di manovra rispetto a un modello puramente esterno. Per alcune aziende questa flessibilità basta. Per altre, soprattutto quelle con requisiti più severi di data residency o di ambiente privato, l'architettura di deployment resta comunque il fattore decisivo.
Il compromesso è il peso operativo.
Monte Carlo ha più senso quando l'azienda ha già una scala sufficiente, abbastanza produttori di dati e un volume di incidenti tale da giustificare un livello di observability dedicato. I team più piccoli possono acquistare un'ampia copertura e avere comunque difficoltà a trasformare gli alert in azioni se la ownership non è chiara o i data contract sono deboli. Un monitoraggio ampio non risolve una disciplina operativa debole. La fa emergere più in fretta.
Anche il costo è un fattore concreto. Negli ecosistemi di grandi dimensioni, la copertura si estende rapidamente a data warehouse, orchestratori, livelli di trasformazione e ambienti. Può essere il compromesso giusto se l'impatto di business dei dati errati è elevato e il team ha bisogno di un triage più rapido su molti sistemi. Se il programma è ancora agli inizi e le lacune principali riguardano una manciata di test critici per il business, Monte Carlo può risultare più pesante del necessario.
3. Anomalo
Anomalo è un'opzione pratica per i team che vogliono un rilevamento delle anomalie basato sul machine learning senza rinunciare ai controlli basati su regole. Questa combinazione è importante perché il solo rilevamento delle anomalie può non cogliere vincoli evidenti della logica di business, mentre le sole regole generano rapidamente debito di manutenzione.
Il suo punto di forza principale è la rapidità con cui genera valore. Anomalo è adatto ai team che vogliono attivare rapidamente il monitoraggio a livello di tabella e di colonna, soprattutto quando non intendono definire a mano decine di soglie prima di vedere segnali utili.
Cosa fa bene Anomalo
L'approccio non supervisionato del prodotto corrisponde al modo in cui il rilevamento delle anomalie funziona meglio nelle data operations. La spiegazione di Monte Carlo sui metodi di rilevamento delle anomalie osserva che tecniche come Z-Score e scarto interquartile sono efficaci per identificare outlier e anomalie di distribuzione quando esistono dati storici sufficienti per stabilire una baseline. In pratica, ciò significa che strumenti come Anomalo funzionano meglio quando possono osservare abbastanza storico da distinguere un cambiamento reale dalla normale volatilità.
Anomalo offre inoltre flessibilità di deployment. La versione SaaS è adatta ai team che puntano sulla velocità, mentre il deployment in VPC è una risposta migliore quando nella discussione entrano le questioni di data residency. La disponibilità su AWS Marketplace può anche semplificare il procurement nelle aziende che preferiscono canali di acquisto cloud standardizzati.
Ecco il compromesso. Anomalo è interessante perché riduce la scrittura manuale delle regole, ma in alcune configurazioni questa comodità può tradursi in un minore controllo sul comportamento delle scansioni e sui costi. I team con ecosistemi molto grandi dovrebbero verificare come viene definito il perimetro di monitoraggio prima del rollout. Altrimenti, un pilota rapido può trasformarsi in seguito in un lento esercizio di ottimizzazione dei costi.
Ideale per: un rilevamento rapido delle anomalie sugli asset di dati cloud moderni.
Da tenere d'occhio: governance dei costi e perimetro delle scansioni nei deployment più grandi.
Complemento efficace: integrazioni con i cataloghi che mostrano i segnali di qualità là dove gli utenti già consultano i dati.
4. Bigeye

Bigeye piace in genere alle organizzazioni che vogliono un'observability enterprise con un modello di deployment attento alla sicurezza. La piattaforma offre monitoraggio automatizzato, triage basato sul lineage e flessibilità di deployment con approcci agentless e basati su agent. Questo facilita l'allineamento a standard di sicurezza interni più rigorosi.
Bigeye si adatta anche agli acquirenti che cercano un vendor con un onboarding strutturato e servizi professionali. Alcuni team liquidano questi aspetti come fronzoli enterprise, finché non affrontano il primo rollout su più domini e si rendono conto che la parte difficile non è lo strumento in sé, ma l'allineamento dei processi.
Perché i team inseriscono Bigeye nella shortlist
Molti progetti di observability falliscono nello stesso punto. Il prodotto rileva i problemi, ma nessuno ha una ownership chiara o un contesto sufficiente per valutarne la portata. Il triage basato sul lineage di Bigeye aiuta proprio qui, perché offre ai team di piattaforma un percorso più diretto dal rilevamento all'analisi dell'impatto.
Anche la sua impostazione in materia di sicurezza è un vantaggio concreto per le grandi aziende. Se i vostri team di procurement, security e compliance hanno bisogno di risposte formali prima di approvare una piattaforma, Bigeye è più facile da giustificare rispetto a strumenti che offrono solo un modello di deployment leggero in stile startup.
Avvertenza per l'acquirente: se il vostro team è ancora in una fase iniziale di maturità della data platform, un rollout di observability enterprise impegnativo può superare le capacità del vostro modello operativo.
Il punto debole è l'adeguatezza. Bigeye è più indicato per organizzazioni di grandi dimensioni con una complessità dei dati e un budget sufficienti a giustificare un programma di observability più ampio. I team più piccoli possono certamente usarlo, ma potrebbero non ricavare abbastanza valore da un apparato enterprise così pesante.
5. Soda
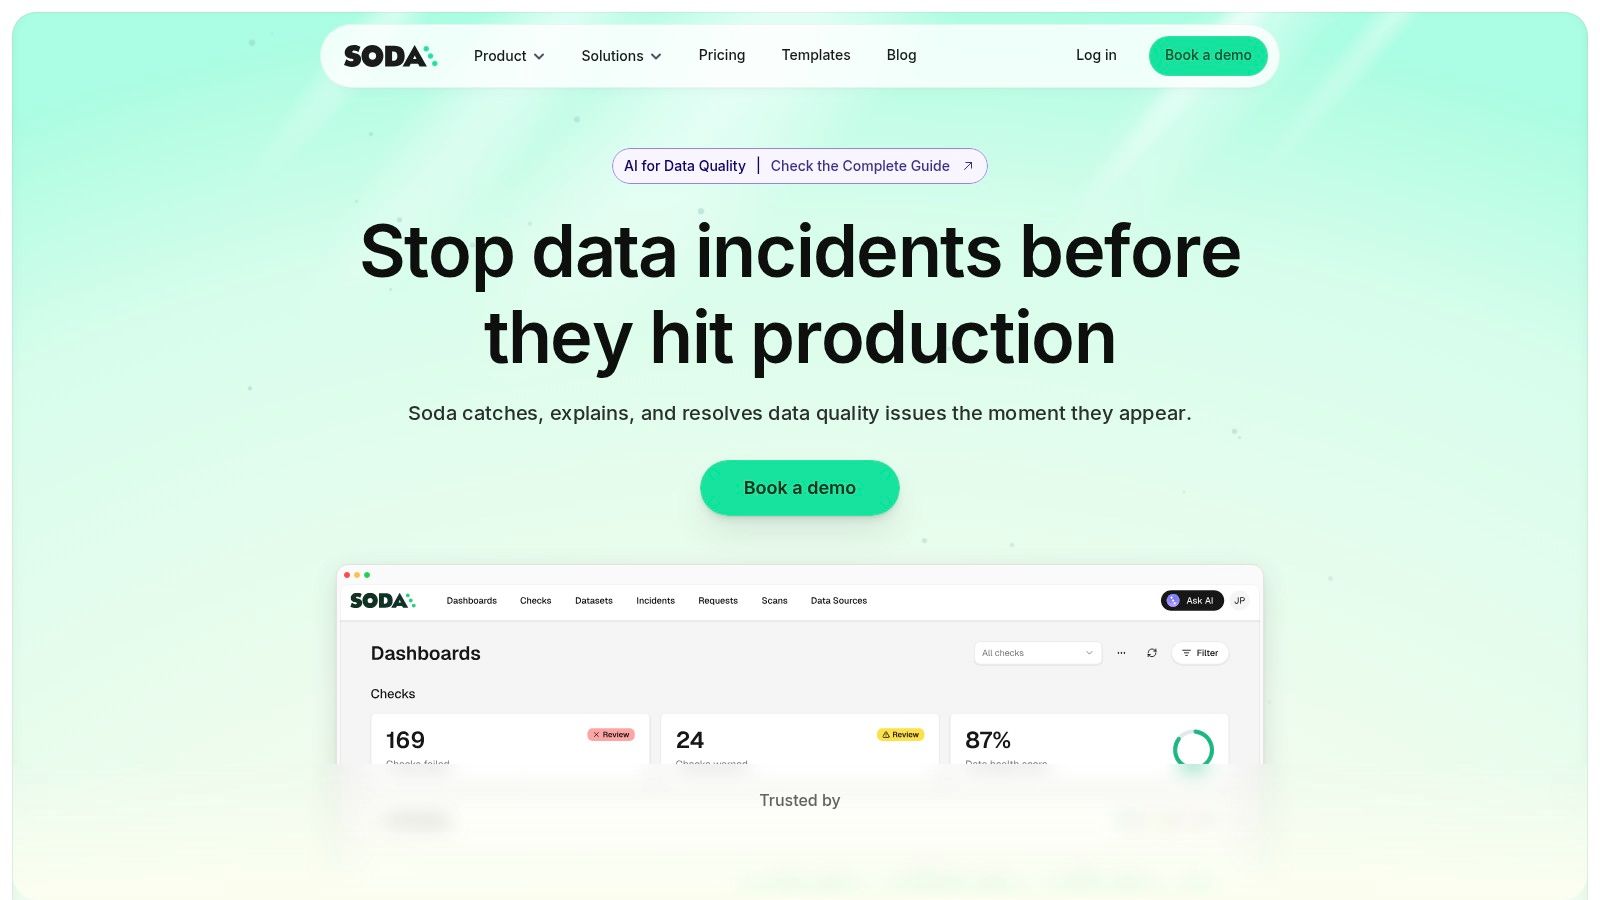
Soda si colloca in un'utile via di mezzo. Non è solo un classico motore di regole, ma non punta nemmeno a fare scena con l'observability. Combina controlli basati su regole, data contract collaborativi e workflow cloud gestiti in un modo che funziona bene per i team dati moderni che vogliono comunque mantenere il controllo diretto sulla logica di qualità.
Questo è importante perché gran parte del lavoro enterprise sulla qualità dei dati si riduce ancora a requisiti di business espliciti. «Questo campo non può essere vuoto» e «questo ID deve essere univoco all'interno di questo dominio» non richiedono un rilevamento delle anomalie sofisticato. Richiedono un'esecuzione affidabile e buoni workflow.
Dove Soda funziona meglio
Soda dà il meglio quando i team di engineering e di analytics condividono la responsabilità della qualità. La piattaforma supporta un onboarding no-code in Soda Cloud, ma mette anche a disposizione dei team tecnici librerie e agent per eseguire i controlli su tutto lo stack. Questa flessibilità facilita il supporto sia di una governance centralizzata sia di pratiche DataOps operative.
Il prodotto è particolarmente interessante per i team che vogliono integrare i data contract nello stesso modello operativo. In pratica, ciò può ridurre l'attrito tra produttori di dati e consumatori a valle, perché le aspettative vengono esplicitate prima.
Questo equilibrio comporta alcuni compromessi.
Cosa funziona bene: regole, contratti e monitoraggio in stile observability possono coesistere senza sembrare elementi aggiunti a forza.
Cosa verificare subito: prezzi enterprise e limiti operativi per i deployment più grandi.
Chi ne trae il massimo valore: i team che vogliono una collaborazione tra data engineer, analytics engineer e stakeholder della governance.
Soda è spesso più adatto di quanto gli acquirenti si aspettino quando hanno superato i test di base ma non vogliono sostenere tutti i costi e la complessità delle suite di observability più grandi.
6. Acceldata
Acceldata si presenta meno come un puro strumento di qualità dei dati e più come una piattaforma di affidabilità operativa per i sistemi di dati. Questa distinzione è importante. Alcuni team di piattaforma non hanno bisogno dell'ennesimo prodotto specifico per i controlli sui null. Hanno bisogno di un unico punto per comprendere affidabilità, prestazioni e costi in ambienti ibridi e multi-cloud.
Se questa descrizione corrisponde alla vostra realtà, Acceldata merita un'attenta considerazione.
Punti di forza operativi
Il vero punto di forza di Acceldata è che parla il linguaggio del platform engineering. Non si chiede soltanto se i dati sembrano sbagliati. Si chiede se le pipeline sono in buona salute, se le scelte infrastrutturali incidono sull'affidabilità e se le data operations stanno generando spese evitabili.
Questo lo rende interessante per i team di piattaforma centralizzati che supportano più business unit. In questi ambienti, gli incidenti di qualità si affiancano spesso a problemi di runtime, errori di orchestrazione e preoccupazioni sui costi del data warehouse. Uno strumento in grado di collegare questi fili è di solito più utile di un validatore più specifico.
Il compromesso è l'ampiezza. I team più piccoli possono trovare Acceldata più ampio del necessario, e un'offerta guidata dalle vendite significa che servirà un vero processo d'acquisto, non la mentalità di una rapida prova self-service.
Alcune organizzazioni hanno bisogno di strumenti per la qualità. Altre hanno bisogno di un livello operativo per la data platform. Acceldata ha più senso nel secondo caso.
Se il vostro management chiede al platform engineering di essere responsabile contemporaneamente di affidabilità e spesa, questo prodotto risponde a tale mandato meglio di molti concorrenti della stessa categoria.
7. Metaplane
Metaplane è una delle piattaforme più facili da consigliare ai team snelli e alle organizzazioni del mid-market. Monitora freshness, volumi e modifiche dello schema nei data warehouse moderni, e il suo modello di prezzo è più accessibile di quello di molti concorrenti orientati principalmente all'enterprise.
Questo non lo rende piccolo. Lo rende mirato.
Perché piace ai team più piccoli
Il punto di forza di Metaplane è la chiarezza. I team possono capire che cosa stanno acquistando, come vengono applicati i monitor e come scalano i prezzi. Questo conta quando la vostra azienda non è pronta per un lungo ciclo di procurement enterprise e non vuole scoprire sei mesi dopo che l'observability è diventata un tema di discussione sul budget.
La piattaforma è inoltre generalmente più facile da introdurre negli stack comuni incentrati sul data warehouse. Se la vostra realtà ruota attorno alla moderna analytics in cloud piuttosto che ad ambienti dati enterprise ampiamente federati, questa semplicità è una caratteristica, non un limite.
C'è però un tetto. Ecosistemi molto grandi con una governance complessa, ampie esigenze di lineage e molteplici vincoli di deployment possono superare le capacità della struttura più leggera di Metaplane. Per queste organizzazioni, una piattaforma più robusta può offrire una migliore aderenza organizzativa anche se la configurazione iniziale è più lenta.
Caso d'uso ideale: team di piattaforma e di analytics snelli che vogliono prezzi prevedibili.
Vantaggio principale: configurazione rapida e UX chiara.
Limite principale: minore profondità funzionale per ambienti enterprise molto grandi.
8. Collibra Data Quality & Observability
Collibra Data Quality & Observability è di solito la risposta giusta quando sono la governance, la stewardship e l'allineamento alle policy a guidare la decisione d'acquisto, più della comodità per l'engineering. Se la vostra organizzazione usa già Collibra come catalogo e spina dorsale della governance, estenderlo alla qualità e all'observability è una mossa logica.
È questo il motivo principale per sceglierlo. Non perché sia il prodotto più leggero o più veloce, ma perché può collegare i segnali di qualità agli asset governati, ai modelli di ownership e alle strutture di policy già esistenti.
Ideale per ambienti con una forte governance
Esiste una distinzione pratica tra data observability e qualità dei dati che gli acquirenti spesso confondono. L'observability aiuta i team a comprendere il comportamento dei sistemi e l'impatto degli incidenti. La qualità dei dati si concentra più direttamente sul fatto che i dati siano accurati, completi, tempestivi e adatti all'uso. Se il vostro team ha bisogno di un modo più preciso per inquadrare questo confine, questo approfondimento su data observability e qualità dei dati lo spiega bene.
Collibra dà il meglio quando questa distinzione deve essere resa operativa nei programmi di governance. Il riutilizzo delle regole, il collegamento alle policy e il supporto per pattern di deployment cloud, Kubernetes e on-premises lo rendono una scelta valida nelle grandi aziende con strutture formali di data management.
I compromessi sono noti. L'implementazione può essere più impegnativa, il carico amministrativo più elevato e i prezzi sono definiti tramite il team commerciale. Ma nelle organizzazioni in cui la governance non è facoltativa, questi non sono necessariamente motivi di esclusione. Spesso sono il prezzo da pagare per integrarsi in un framework di controllo più ampio.
9. Google Cloud Dataplex Knowledge Catalog Data Quality
Google Cloud Dataplex è la scelta nativa per i team che hanno già puntato su BigQuery e sull'intero stack di Google Cloud. Offre profiling, definizione di regole, regole di qualità dei dati riutilizzabili, scansioni automatizzate e alerting all'interno di un modello GCP gestito.
Per l'acquirente giusto, la soluzione nativa di solito vince. Meno componenti, meno connettori da giustificare e meno piattaforme separate da gestire.
Una scelta solida per i team nativi GCP
Dataplex è convincente perché trasforma la qualità dei dati in un servizio di piattaforma invece che in un ulteriore rapporto con un vendor. Le regole riutilizzabili nel Knowledge Catalog aiutano a standardizzare i controlli tra i team, il che è particolarmente utile quando più domini sviluppano analytics su un'infrastruttura cloud condivisa.
Il compromesso è altrettanto chiaro. Se il vostro stack non è incentrato su GCP, i vantaggi del prodotto si riducono rapidamente. E anche per i team incentrati su BigQuery, i prezzi a consumo richiedono disciplina su frequenza delle scansioni, complessità delle regole e volumi di dati. Nativo non significa automaticamente economico.
Un'ultima considerazione pratica. Dataplex è più adatto alle organizzazioni che preferiscono una gestione della qualità guidata dalle regole che a quelle che cercano un livello di observability ampio e multipiattaforma. Può certamente supportare operations di qualità serie, ma è più naturale all'interno di un modello operativo GCP-first.
10. IBM Databand
IBM Databand è lo strumento di questo elenco che parte più chiaramente dall'affidabilità delle pipeline e dalla gestione degli SLA, piuttosto che da un'ampia copertura della qualità incentrata sul data warehouse. È un aspetto utile, perché molti incidenti sui dati sono in realtà incidenti di tempestività. I dati non sono sbagliati. Sono in ritardo, mancanti o elaborati solo in parte.
Se il vostro problema principale sono job falliti, aggiornamenti in ritardo e aspettative di consegna disattese, Databand è costruito proprio per questo.
Ideale quando sono gli SLA delle pipeline a guidare la decisione d'acquisto
Databand utilizza baseline ad autoapprendimento, rilevamento delle anomalie, dashboard e monitoraggio degli SLA per far emergere i rischi prima che uno SLA venga mancato. Ciò è in linea con il modo in cui il rilevamento delle anomalie basato sull'AI viene sempre più spesso descritto nelle diverse categorie di monitoraggio operativo. La panoramica di Plixer spiega che i sistemi di rilevamento delle anomalie basati sull'AI apprendono il comportamento normale dai dati grezzi e valutano i dati in tempo reale rispetto alle baseline apprese, anziché affidarsi a soglie statiche. Lo stesso schema è utile per la salute delle pipeline, perché le derive nei tempi si manifestano spesso prima di un vero e proprio errore.
Il punto di forza è la specializzazione. Databand può integrare gli strumenti di qualità dei dati a livello di data warehouse proteggendo il livello di consegna e aiutando i team operativi a fare un triage tempestivo dei problemi.
Anche i limiti sono chiari. Se avete bisogno di una validazione approfondita delle regole di business, di workflow incentrati sul catalogo o di una gestione ampia della qualità su molti domini, Databand non sostituirà tutti gli altri strumenti della categoria. Dà il meglio come livello di affidabilità e tempestività negli ambienti con un uso intensivo di pipeline.
Confronto tra i 10 migliori strumenti di monitoraggio della qualità dei dati
Piattaforma | Funzionalità principali | UX e affidabilità ★ | Prezzo/valore 💰 | Pubblico di riferimento 👥 | Punti di forza distintivi ✨ |
|---|---|---|---|---|---|
digna 🏆 | Rilevamento delle anomalie con AI, validazione a livello di record, tempestività, schema tracker, analytics in-database | ★★★★★, UI unificata; installazione rapida (≤2h) | 💰 Tramite il team commerciale (contatto), ROI enterprise | 👥 Aziende regolamentate e team dati/analytics | ✨ Esecuzione in-database; apprendimento delle baseline; i dati di produzione non lasciano mai l'ambiente del cliente. |
Monte Carlo | Freshness, volumi, schema, lineage; deployment con agent/VPC | ★★★★☆, ampia adozione e riconoscimento da parte degli analisti | 💰 Enterprise, tramite il team commerciale; TCO potenzialmente più alto | 👥 Ecosistemi di dati grandi e complessi | ✨ Lineage solido, ampia presenza nell'ecosistema |
Anomalo | Anomalie con ML non supervisionato + controlli basati su regole; in VPC; integrazioni con i cataloghi | ★★★★☆, time-to-value rapido | 💰 SaaS e in VPC; acquisto tramite AWS Marketplace | 👥 Team che necessitano di una rapida copertura delle anomalie | ✨ ML non supervisionato + controlli basati su regole; acquisto tramite marketplace |
Bigeye | Monitor automatizzati, triage basato sul lineage, agent/agentless, sicurezza enterprise | ★★★★☆, onboarding e servizi maturi | 💰 Tramite il team commerciale; prezzi enterprise | 👥 Organizzazioni grandi e mature sul piano dei dati | ✨ Triage della portata dell'impatto; conformità SOC2/ISO |
Soda | Observability + data contract, controlli basati su regole, Cloud + agent | ★★★★☆, UX collaborativa; documentazione e integrazioni | 💰 Prezzo d'ingresso pubblico; piani enterprise tramite il team commerciale | 👥 Team che bilanciano regole, contratti e observability | ✨ Data contract + integrazioni con ticketing/cataloghi |
Acceldata | Affidabilità, salute delle pipeline, governance dei costi in ambienti ibridi/multi-cloud | ★★★★☆, dashboard incentrate sulla piattaforma | 💰 Tramite il team commerciale; SKU su marketplace per le aziende | 👥 Team di piattaforma e operations che gestiscono costi/affidabilità | ✨ Focus combinato su affidabilità + governance dei costi |
Metaplane | Monitoraggio di freshness, volumi e schema; prezzi per tabella | ★★★★☆, leggero, UX chiara; configurazione rapida | 💰 A consumo/per tabella, prevedibile | 👥 Team di analytics snelli e del mid-market | ✨ Prezzi prevedibili; onboarding rapido per i data warehouse |
Collibra Data Quality & Observability | Rilevamento automatizzato delle anomalie, riutilizzo delle regole, collegamento alla governance | ★★★☆☆, incentrato sulla governance; carico amministrativo più elevato | 💰 Tramite il team commerciale; licenze enterprise | 👥 Organizzazioni che usano il catalogo/la governance di Collibra | ✨ Stretta integrazione con governance e policy |
Google Cloud Dataplex (Knowledge Catalog) Data Quality | Profiling, regole riutilizzabili, scansioni automatizzate collegate al Knowledge Catalog | ★★★★☆, esperienza GCP nativa e completamente gestita | 💰 A consumo (volume di scansione), i costi crescono con le scansioni | 👥 Team incentrati su BigQuery / GCP | ✨ Integrazione nativa con GCP; regole DQ centralizzate |
IBM Databand | Baseline, rilevamento delle anomalie, monitoraggio degli SLA, triage delle pipeline | ★★★☆☆, potente ma l'interfaccia può risultare densa | 💰 SaaS a livelli / opzioni marketplace, da verificare con IBM | 👥 Team di pipeline/piattaforma ed enterprise | ✨ Pipeline observability focalizzata sugli SLA; opzioni self-service a livelli |
Considerazioni finali
Spesso i team non hanno bisogno del «migliore» strumento di monitoraggio della qualità dei dati. Hanno bisogno dello strumento adatto al loro modello operativo. Sembra ovvio, ma è proprio qui che molte valutazioni vanno fuori strada. Gli acquirenti confrontano tabelle di funzionalità, non realtà di deployment. Chiedono se un vendor è in grado di monitorare schema drift, freshness e anomalie, ma non chiedono dove avviene l'elaborazione, chi è responsabile degli incidenti o se la piattaforma rientra nei loro vincoli di compliance.
Quest'ultimo punto conta oggi più di un tempo. La categoria si sta espandendo rapidamente e gli acquirenti premiano chiaramente l'automazione. Coherent Market Insights prevede che il mercato globale degli strumenti di qualità dei dati passerà da 3,50 miliardi di USD nel 2026 a 10,80 miliardi di USD entro il 2033, con un CAGR del 17,5%. La crescita è trainata dall'automazione basata sull'AI per il rilevamento delle anomalie e la pulizia predittiva dei dati. In parole semplici, i team non vogliono più mantenere a mano infinite regole se un sistema può apprendere il comportamento normale e segnalare automaticamente le derive significative.
Ma la sola automazione non basta. Lo studio accademico citato in precedenza è utile perché evidenzia che cosa dovrebbero verificare gli acquirenti enterprise maturi. Monitoraggio continuo, profiling, misurazione, archiviazione dei risultati e visualizzazione nel tempo non sono extra facoltativi. Sono la base per gestire la qualità dei dati come disciplina operativa e non come progetto di bonifica. Ciò che distingue ancora gli strumenti è se supportano i workflow end-to-end in modo abbastanza pulito per un reale utilizzo in produzione.
Ecco perché questi dieci prodotti occupano corsie diverse:
Scegliete digna quando contano soprattutto privacy, deployment privato, esecuzione in-database, monitoraggio della tempestività e un'unica soluzione per observability e qualità dei dati.
Scegliete Monte Carlo o Bigeye quando i fattori principali sono un'ampia copertura di observability enterprise e la risoluzione dei problemi basata sul lineage.
Scegliete Anomalo quando volete un rilevamento rapido delle anomalie basato sul ML con la possibilità di mantenere alcuni controlli basati su regole.
Scegliete Soda quando il vostro team vuole controlli di qualità collaborativi, contratti e workflow adatti agli sviluppatori.
Scegliete Acceldata quando l'affidabilità della piattaforma e la governance dei costi si affiancano ai temi di qualità.
Scegliete Metaplane quando un team snello ha bisogno di un monitoraggio semplice e di prezzi prevedibili.
Scegliete Collibra quando la struttura di governance e l'allineamento alle policy dominano il processo d'acquisto.
Scegliete Dataplex quando il vostro stack è saldamente nativo GCP e volete un'esecuzione gestita delle regole all'interno di quell'ambiente.
Scegliete IBM Databand quando gli SLA delle pipeline e la tempestività sono il rischio operativo principale.
Se dovessi consigliare un'azienda con requisiti di privacy rigorosi, stakeholder tecnici e di business eterogenei e il mandato di ridurre la proliferazione degli strumenti, digna sarebbe l'opzione più distintiva di questo elenco. Non perché ogni team abbia bisogno di un'esecuzione privata in-database, ma perché i team che ne hanno bisogno scoprono di solito molto in fretta che la maggior parte dei vendor non è stata costruita attorno a questo vincolo.
Per tutti gli altri, la decisione si riduce a una domanda. Vi serve uno strumento di monitoraggio, un livello di observability, un'estensione della governance o un sistema di affidabilità della piattaforma? Una volta data una risposta accurata, la shortlist si riduce notevolmente.
Se il vostro team ha bisogno di monitorare la qualità dei dati senza esporre i dati di produzione a un ambiente gestito dal vendor, digna merita un'analisi più approfondita. Combina rilevamento delle anomalie, validazione a livello di record, monitoraggio della tempestività, analisi dei trend e tracciamento dello schema in una piattaforma privata e in-database pensata per gli ambienti enterprise. Prenotate una demo per verificare se il suo approccio si adatta al vostro data warehouse, al vostro data lake e ai vostri requisiti di compliance.
Scoprite come digna lo fa nella pratica: monitoraggio della qualità dei dati là dove risiedono i vostri dati.
Monitorare volumi e freshness non vi dirà quando le righe smettono di corrispondere ai loro record padre. Per questo, aggiungete controlli di integrità referenziale sulle join da cui dipendono i vostri report.
Domande frequenti
Che cosa fa uno strumento di monitoraggio della qualità dei dati?
Osserva i dati stessi anziché i sistemi che li circondano: volumi, distribuzioni, tassi di valori null, freshness e modifiche dello schema, generando un alert quando un dataset smette di comportarsi come fa di solito.
Che cosa confrontare nella scelta di uno strumento di qualità dei dati?
Il metodo di rilevamento (regole statiche o baseline apprese), dove avviene l'elaborazione e se i dati lasciano il vostro ambiente, la copertura delle vostre piattaforme, il rumore degli alert e l'impegno necessario per integrare ogni nuovo dataset.
Qual è la differenza tra monitoraggio della qualità dei dati e data observability?
Il monitoraggio della qualità dei dati si concentra sul fatto che i dati siano corretti e completi. L'observability è più ampia e comprende la salute delle pipeline e dei sistemi. In pratica la maggior parte dei team ha bisogno di entrambi, perché una pipeline può essere in buona salute mentre i dati che consegna sono sbagliati.
Gli strumenti di qualità dei dati devono copiare i miei dati?
Non necessariamente. Alcune piattaforme, tra cui digna, calcolano le metriche all'interno del vostro ambiente e conservano solo le metriche e i metadati risultanti, un aspetto importante quando si applicano norme di data residency o privacy.
Quante regole bisogna scrivere con uno strumento di qualità dei dati?
Dipende dall'approccio. Gli strumenti basati su regole richiedono una regola esplicita per ogni aspettativa, il che non è scalabile oltre qualche centinaio di dataset. Gli strumenti che apprendono il comportamento normale di ciascun dataset coprono i casi sconosciuti senza che sia necessario scrivere prima una regola.


