Rilevamento delle anomalie nella cyber security: best practice 2026
|
6
min di lettura

Probabilmente in questo momento vi trovate in una di due situazioni. O il vostro SIEM è pieno di alert che nessuno ha il tempo di analizzare, oppure un incidente reale è sfuggito perché non corrispondeva a nessuna firma nota. Entrambi i problemi indicano la stessa lacuna. I controlli tradizionali sono bravi a individuare ciò che già conoscete, ma fanno fatica quando un attaccante si comporta in modo appena abbastanza diverso da sembrare normale.
È qui che il rilevamento delle anomalie si guadagna il suo posto nella cyber security. Non come uno strato magico, né come sostituto di firme, EDR o threat intelligence, ma come modo pratico per rilevare comportamenti che escono dalla baseline che il vostro ambiente produce di solito. Negli ambienti aziendali reali, la parte difficile non è far scattare un modello. La parte difficile è garantire che gli alert siano affidabili, rispettosi della privacy e sostenibili per le persone che devono rispondere.
Indice
Che cos'è il rilevamento delle anomalie nella cyber security
Metodi di rilevamento fondamentali: statistica e machine learning a confronto
Come rendere operativo il rilevamento delle anomalie nel vostro stack
Che cos'è il rilevamento delle anomalie nella cyber security
Il rilevamento delle anomalie nella cyber security è la pratica di identificare i comportamenti che si discostano da ciò che i vostri sistemi, utenti, workload o pipeline di dati fanno normalmente. Sembra semplice, ma non lo è. In un'azienda operativa, la “normalità” cambia per ora, team, area geografica, stagione, rilascio applicativo e ciclo di business.
Il motivo per cui i team investono in programmi di rilevamento delle anomalie per la cyber security è semplice. Gli strumenti basati sulle firme possono riconoscere solo ciò che è già stato descritto. Se un attaccante si muove lateralmente usando credenziali legittime, prepara l'esfiltrazione dei dati lentamente o abusa di un processo interno non coperto da alcuna regola, una firma statica potrebbe non scattare mai.
Questa pressione è visibile sul mercato. La proiezione di Precedence Research sul mercato dell'anomaly detection indica che il mercato globale del rilevamento delle anomalie valeva circa 6,90 miliardi di dollari nel 2025 e si prevede che raggiunga 28,00 miliardi di dollari entro il 2034, con un CAGR del 16,83%. Questa crescita è legata all'esigenza di sistemi automatizzati in grado di individuare minacce avanzate più rapidamente rispetto alla revisione manuale o agli approcci a regole fisse.
Cosa cambia davvero il rilevamento delle anomalie
Un buon rilevamento delle anomalie cambia la domanda di sicurezza da “Riconosco questo attacco?” a “Questo comportamento è coerente con l'ambiente?”. Questo cambio di prospettiva conta quando il segnale è sottile:
Un account di servizio si comporta diversamente rispetto al suo pattern di accesso storico.
Un workload del database ha un picco in un orario insolito senza una finestra di manutenzione corrispondente.
Una sequenza di azioni di un utente sembra innocua evento per evento ma sospetta nel complesso.
Una pipeline di dati deriva senza che nessuno se ne accorga e crea punti ciechi di sicurezza a valle.
Regola pratica: trattate il rilevamento delle anomalie come un sistema di baseline e deviazione, non come un rilevatore di minacce universale.
Questa distinzione aiuta i team a usarlo bene. Un'anomalia non è automaticamente malevola. Può essere un deployment, un evento di business, una modifica di configurazione o un'intrusione reale. Il compito del motore è far emergere le deviazioni. Il compito del programma di sicurezza è classificarle per priorità, arricchirle e indagarle.
Dove sbagliano i team
L'errore più comune è acquistare o costruire il rilevamento delle anomalie come se la sola accuratezza bastasse a risolvere il problema. Non è così. Un modello può essere tecnicamente impressionante e fallire comunque sul piano operativo se sommerge gli analisti, richiede troppi spostamenti di dati o non sa adattarsi quando la normale attività di business cambia.
Un programma solido parte da casi d'uso circoscritti e ad alto valore. Le modifiche agli accessi privilegiati, i movimenti insoliti di dati in uscita, le anomalie dei workload nei sistemi core e le deviazioni nel comportamento di autenticazione di solito ripagano prima dei progetti generici del tipo “rileva qualsiasi cosa strana”. Questo perché i team possono definire le baseline con maggiore chiarezza, convalidare i risultati più rapidamente e instradare gli alert verso responsabili che conoscono il sistema.
I tre tipi fondamentali di anomalie
I team di sicurezza parlano spesso di anomalie come se fossero una cosa sola. Non lo sono. La classificazione conta perché la logica di rilevamento, il percorso di triage e il probabile impatto sul business cambiano a seconda del tipo di deviazione che state affrontando.
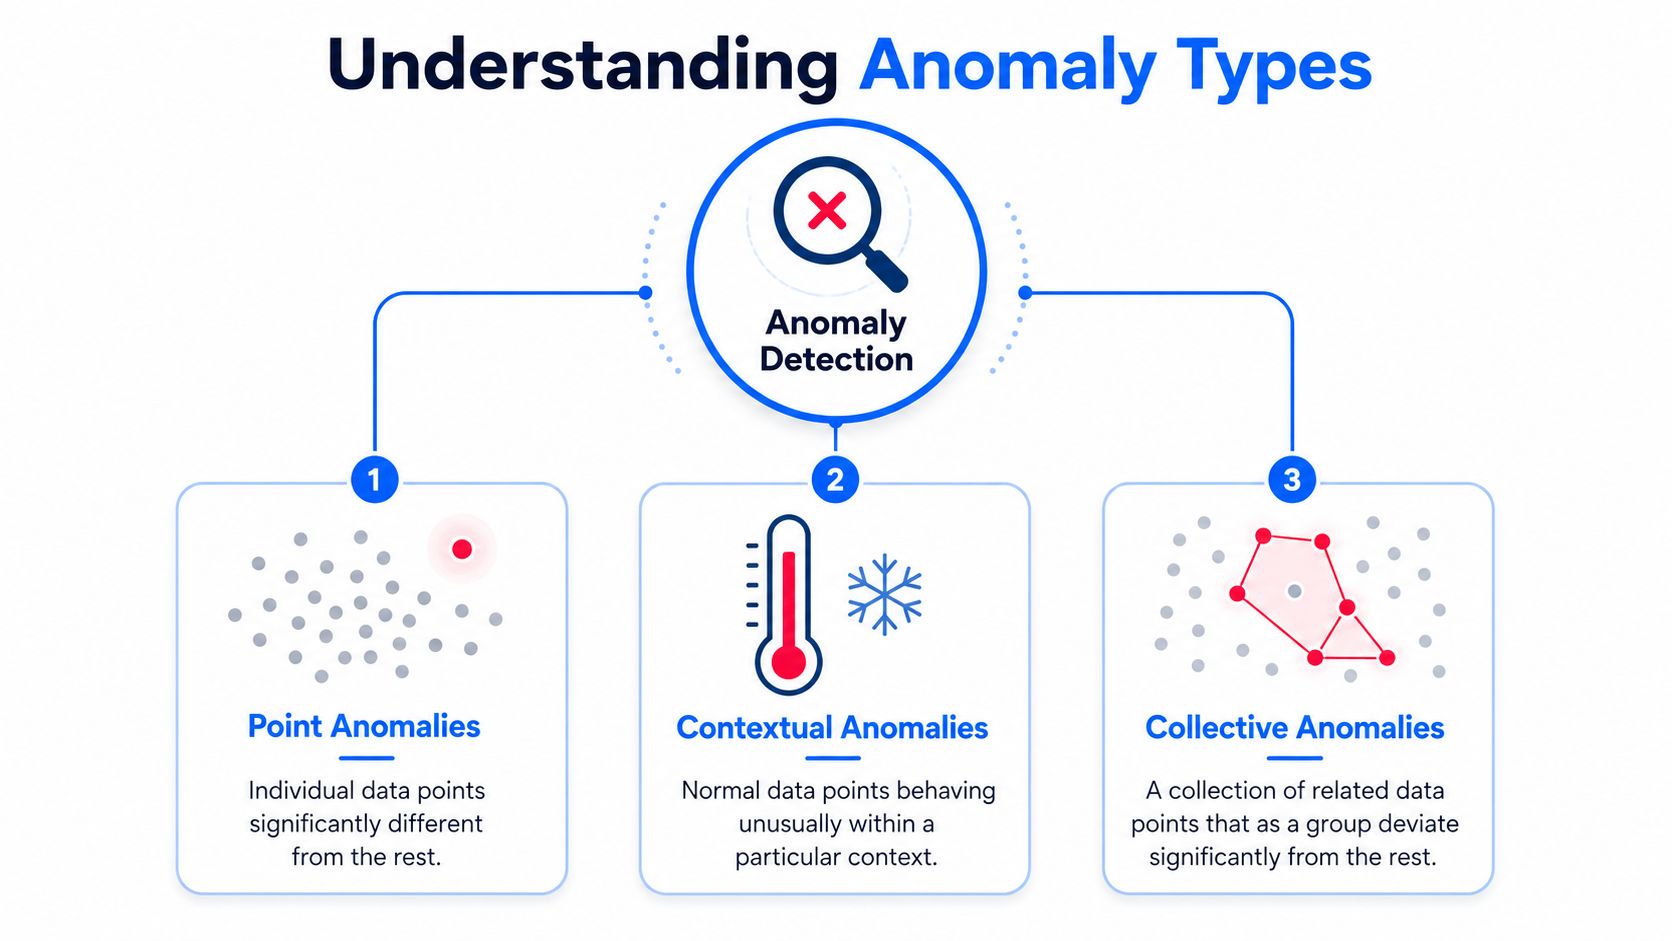
Il modello di base è consolidato. Questa tassonomia delle anomalie nella cybersecurity individua tre classi: anomalie puntuali, anomalie contestuali e anomalie collettive. In pratica, queste categorie aiutano gli analisti a porsi più rapidamente le domande giuste.
Perché la classificazione è importante
Un'anomalia puntuale è un singolo evento che spicca da solo. Pensate a un picco improvviso di traffico in uscita da un sistema di solito silenzioso. Basta un evento per destare preoccupazione.
Un'anomalia contestuale dipende dalle condizioni circostanti. Un accesso da una posizione, in un orario, con uno stato del dispositivo o in un contesto di business che rende l'evento anomalo anche se l'evento in sé è valido. Accedere a mezzogiorno può essere normale. Accedere durante un insolito congelamento per manutenzione, con un ruolo che non accede mai a quella risorsa, può non esserlo.
Un'anomalia collettiva compare solo quando osservate una sequenza nel suo insieme. Ogni evento può sembrare ordinario, ma lo schema complessivo no. Ricognizioni lente, uso graduale dei privilegi ed esfiltrazioni a basso volume si collocano spesso qui.
Come gli analisti usano le categorie
Il modo più semplice per ragionarci è associare ciascuna a uno stile di indagine.
Tipo di anomalia | Come si presenta | Come indagare |
|---|---|---|
Puntuale | Un unico outlier evidente | Convalidare l'evento, confermare il responsabile, verificare l'impatto immediato |
Contestuale | Un evento strano solo nel suo contesto | Confrontarlo con il contesto di utente, sistema, orario e business |
Collettiva | Una sequenza sospetta composta da eventi apparentemente normali | Ricostruire la timeline e cercare l'intento attraverso i vari passaggi |
Molti programmi di rilevamento migliorano cambiando i playbook di triage. Se una regola di rilevamento dice “anomalia” ma non dice all'analista di che tipo, l'analista perde tempo a decidere come ragionare. Se la regola inquadra già l'alert come puntuale, contestuale o collettivo, il percorso si accorcia.
Un alert che dice “rilevato comportamento insolito” è debole. Un alert che dice “anomalia collettiva che coinvolge autenticazione, modifica dei privilegi e accesso ai dati all'interno di un'unica catena di sessioni” è utilizzabile.
Per i team aziendali, le anomalie collettive meritano di solito un'attenzione particolare. Gli attaccanti sanno come restare sotto le soglie fisse. Distribuiscono l'attività nel tempo, tra i sistemi e attraverso identità valide. Ecco perché il rilevamento consapevole delle sequenze trova spesso ciò che i sistemi basati solo su soglie non vedono.
Metodi di rilevamento fondamentali: statistica e machine learning a confronto
Alcuni metodi di rilevamento si comportano come una guardia di sicurezza con una checklist. Altri somigliano di più a un investigatore che impara nel tempo i pattern di un quartiere. Di solito servono entrambi.

Dove i metodi statistici funzionano ancora bene
Il rilevamento statistico è la famiglia più antica e più semplice. Stabilite una baseline e generate un alert quando l'attività esce dai limiti previsti. Questo può significare tracciare variazioni di frequenza, varianza, valori mancanti, cali imprevisti o superamenti di soglia.
Questi metodi sono utili perché sono veloci, spiegabili ed economici da gestire. Gli analisti di solito capiscono perché una regola statistica è scattata. Se il volume dei trasferimenti in uscita supera un intervallo previsto, o se la durata di un job si discosta nettamente dalla sua finestra normale, il motivo è evidente.
Falliscono anche in modi prevedibili. Le soglie fisse diventano rumorose negli ambienti dinamici. Le baseline diventano obsolete. Le regole mantenute a mano si moltiplicano finché nessuno vuole più toccarle.
Perché il machine learning è diventato necessario
Il machine learning dimostra il suo valore quando l'ambiente è troppo complesso per essere descritto in modo pulito da regole fisse. Fidelis osserva nella sua panoramica sui metodi di rilevamento delle anomalie che gli algoritmi di machine learning non supervisionato dominano il rilevamento delle anomalie in ambito aziendale perché individuano gli outlier senza etichette predefinite, il che è particolarmente vantaggioso quando i dati etichettati sugli attacchi scarseggiano. La stessa fonte sottolinea inoltre l'importanza di una feature engineering rigorosa e di soglie dinamiche per ridurre i falsi alert.
È un punto operativo importante. Nella cyber security gli esempi etichettati sono spesso incompleti, sbilanciati verso attacchi vecchi o costosi da mantenere. Gli approcci non supervisionati possono rilevare comportamenti che non corrispondono ai pattern normali appresi, anche quando nessuno li ha etichettati in anticipo.
Qui contano alcuni schemi pratici:
I modelli supervisionati sono utili quando disponete di un buono storico etichettato e di un problema circoscritto.
I modelli non supervisionati si adattano meglio agli ambienti aziendali dinamici perché possono far emergere outlier nuovi.
Gli approcci ibridi di solito offrono le prestazioni migliori, perché i controlli statistici forniscono dei paletti mentre il ML gestisce le deviazioni sottili.
Se cercate un parallelo utile al di fuori del classico rilevamento delle intrusioni, questa guida su come prevenire le violazioni dell'integrità sul posto di lavoro mostra come il machine learning possa far emergere pattern di comportamento che le regole rigide spesso non colgono.
Cosa funziona nella pratica
I team ottengono risultati migliori quando smettono di discutere di statistica contro ML come se uno dei due dovesse vincere. I programmi maturi li combinano.
Usate la statistica per ciò che dovrebbe essere facile da spiegare e costoso da non vedere. Usate il ML dove il pattern è multivariato, ad alto volume o in evoluzione. Poi aggiungete soppressione, arricchimento e soglie adattive, così gli analisti non annegano.
Un'architettura pratica è spesso questa:
Prima la baseline statistica. Intercettate deviazioni grossolane, dati mancanti, picchi dei workload e anomalie di tempistica.
Poi il ML non supervisionato. Assegnate un punteggio al comportamento di utenti, host, rete o pipeline che non corrisponde al profilo appreso.
Quindi il livello di contesto. Aggiungete identità, criticità degli asset e modifiche recenti prima di generare l'alert.
Infine il ciclo di feedback. Contrassegnate i falsi positivi, riaddestrate e regolate le soglie in base alle operations.
Per i team che lavorano sul comportamento temporale, i pattern di rilevamento delle anomalie nelle serie temporali sono particolarmente utili, perché molti segnali cyber sono in realtà problemi di sequenza e di tempistica, non solo outlier di singoli eventi.
Alimentare il rilevamento con le giuste sorgenti dati
Un modello debole con dati buoni spesso batte un modello brillante con dati scadenti. Questo vale in particolare nel rilevamento delle anomalie per la cyber security, dove la qualità della telemetria decide se il sistema apprende baseline significative o memorizza rumore.
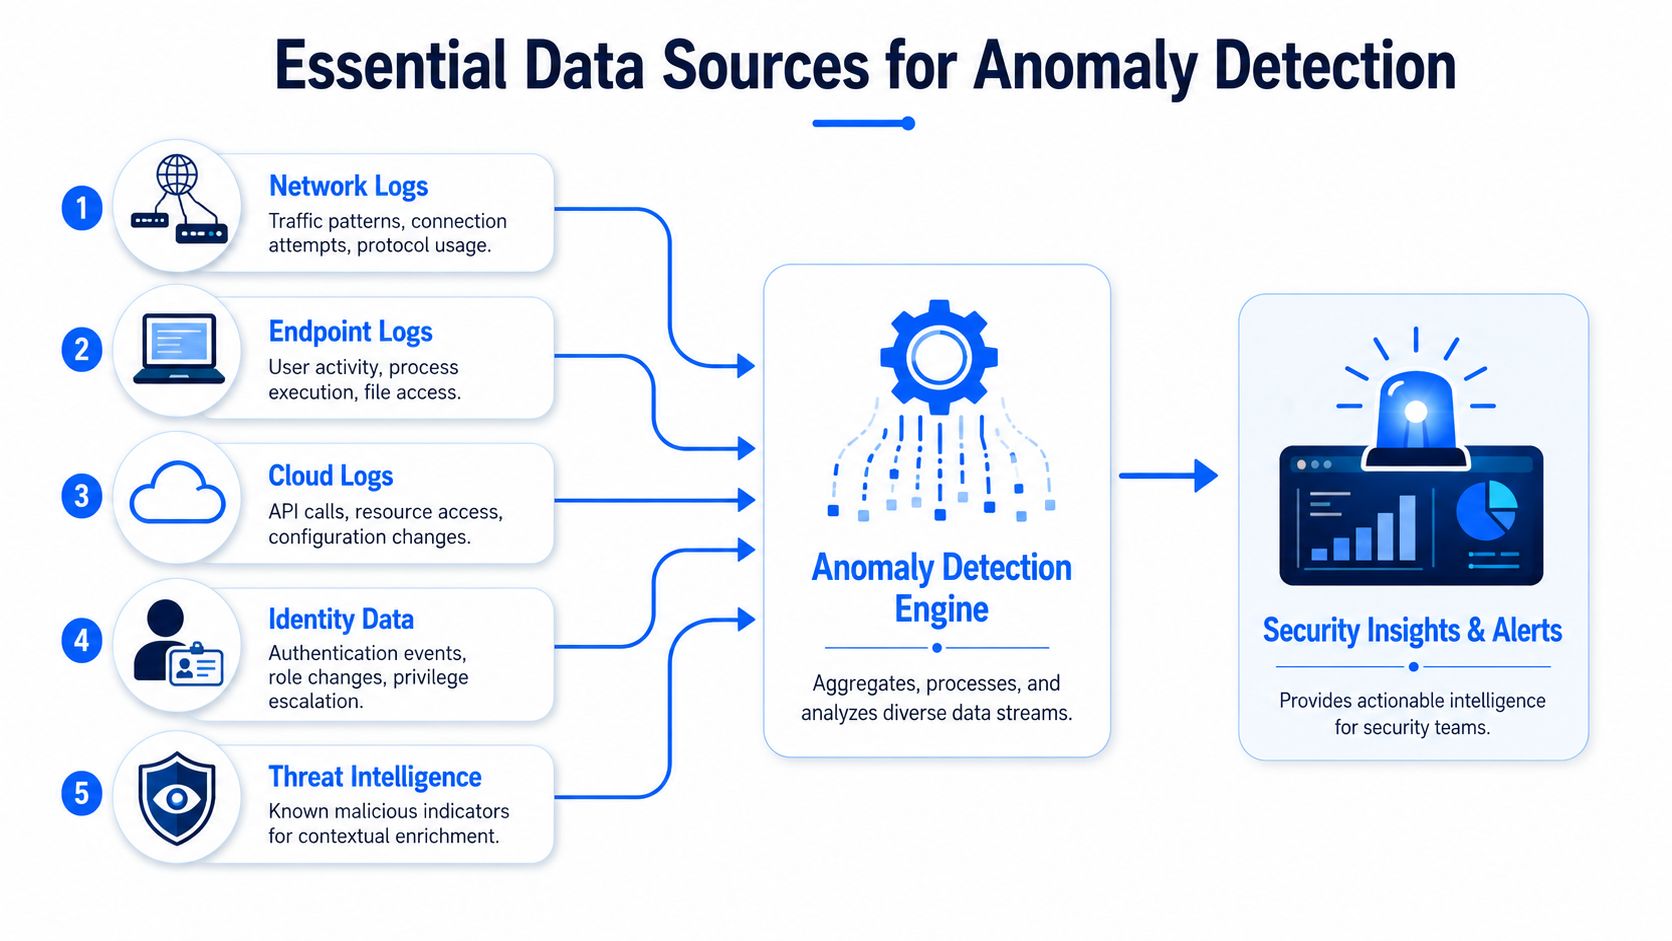
Cosa raccogliere per primo
Molte organizzazioni partono con troppi feed e troppa poca struttura. Un approccio migliore è dare priorità alle sorgenti dati che spiegano il comportamento da angolazioni diverse.
Il set di partenza abituale è:
Log di rete per pattern di connessione, variazioni di traffico e movimenti insoliti tra sistemi.
Telemetria degli endpoint per comportamento dei processi, accesso ai file e attività degli utenti.
Log del cloud e della piattaforma per uso delle API, modifiche alle risorse e azioni sul control plane.
Eventi di identità per autenticazione, cambi di ruolo ed escalation dei privilegi.
Contesto sulle minacce per l'arricchimento, non per il rilevamento primario.
Ciò che conta non è solo il volume, ma la copertura di azioni, identità e asset.
Perché la feature engineering conta più della scelta del modello
I log grezzi raramente sono buone feature per le anomalie. Gli analisti hanno bisogno di metriche operative da cui il modello possa apprendere, come frequenza di accesso, raffiche di login falliti, pattern di trasferimento, variazioni nella durata dei job, correlazioni insolite tra comportamento degli utenti e degli asset e record mancanti o duplicati nella telemetria.
È qui che la generazione delle metriche diventa un compito di ingegneria centrale. Questa panoramica sulle metriche di anomalia calcolate nel database spiega che il rilevamento delle anomalie può calcolare statistiche chiave come somma, minimo e conteggio dei valori su tre specifici tipi di dati all'interno di ogni colonna, consentendo ai sistemi di apprendere le baseline senza configurare regole manualmente né mantenere costantemente le soglie.
Questo approccio è utile anche oltre la qualità dei dati. Nelle security operations, lo stesso principio aiuta a costruire feature di monitoraggio stabili vicino alla sorgente dei dati, invece di inviare eventi grezzi ovunque sperando che il SIEM se ne occupi in seguito.
Un buon set di feature dovrebbe rispondere a domande come queste:
Stabilità comportamentale. Questa entità si comporta di solito così?
Velocità di cambiamento. Questa metrica si è mossa bruscamente o gradualmente?
Sensibilità al contesto. Il comportamento è insolito per questo orario, ruolo, workload o flusso di lavoro?
Integrità dei dati. I record di supporto sono abbastanza completi da potersi fidare dell'alert?
Perché l'elaborazione nel database cambia il modello operativo
Spostare grandi volumi di telemetria rilevante per la sicurezza tra sistemi crea due problemi. Il rischio per la privacy aumenta, e con esso la complessità operativa. Quando i team possono calcolare le metriche più vicino a dove i dati risiedono già, riducono entrambi.
Riducete al minimo lo spostamento dei dati grezzi. Inviate risultati e contesto, non ogni evento sottostante, a meno che non vi servano per un'indagine.
Questa architettura aiuta anche quando i team di sicurezza lavorano con team di data engineering o di piattaforma che non approverebbero un'esportazione estesa dei dati. Se le feature di anomalia possono essere calcolate sul posto, il programma di rilevamento diventa più facile da implementare in ambienti regolamentati o sensibili.
Come rendere operativo il rilevamento delle anomalie nel vostro stack
Il modello è raramente la prima decisione che conta. Lo è l'architettura. Se sbagliate il modello di deployment, il programma diventa costoso, lento o politicamente impraticabile molto prima che la logica di rilevamento raggiunga la maturità.
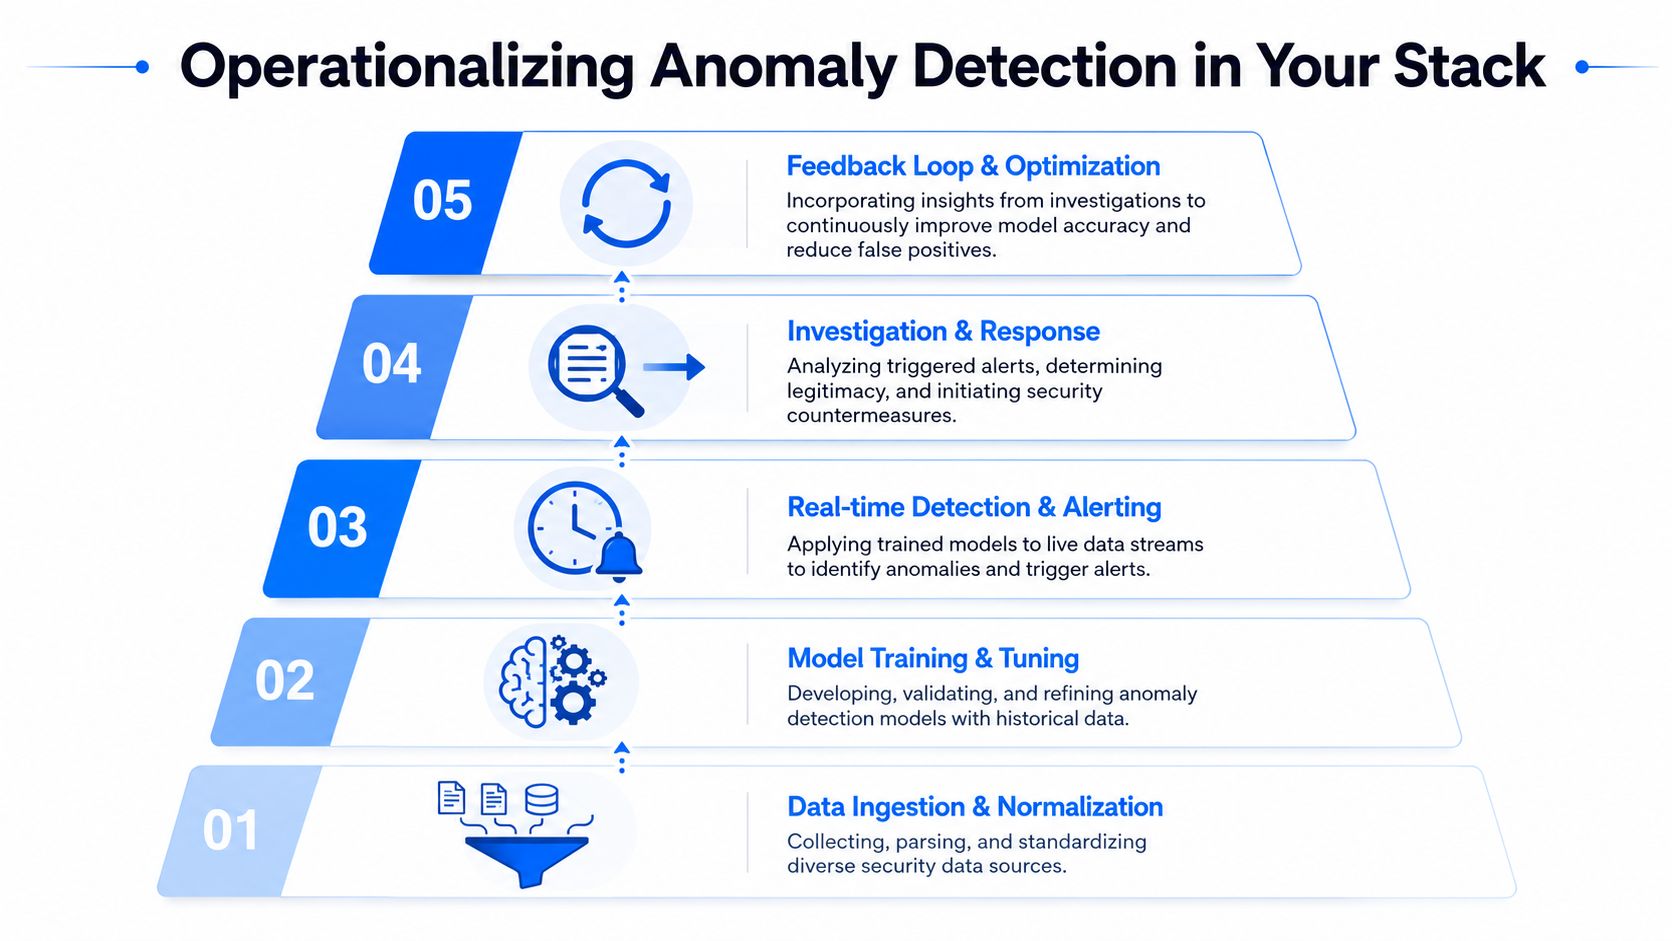
Scegliete l'architettura prima del modello
I team aziendali di solito scelgono tra tre grandi schemi:
Modello di deployment | Punto di forza | Compromesso |
|---|---|---|
SaaS in cloud | Rollout rapido e operations più semplici | Maggiori preoccupazioni su spostamento e residenza dei dati |
On-premises o cloud privato | Controllo più stretto e allineamento alle policy | Più responsabilità interna e manutenzione |
Esecuzione nel database o sul posto | Forte tutela della privacy e minore spostamento dei dati | Richiede un'integrazione ponderata con le piattaforme esistenti |
Negli ambienti sensibili dal punto di vista della sicurezza, l'analisi sul posto è spesso il compromesso più pratico. Questa descrizione del monitoraggio nel database orientato alla privacy illustra un'architettura che mantiene i dati nell'ambiente del cliente leggendo direttamente le tabelle di sistema e applicando il rilevamento delle anomalie basato sull'AI senza esportare i dati, consentendo un monitoraggio dei workload in tempo reale man mano che si verificano le deviazioni.
Questo conta quando la telemetria include dettagli operativi sensibili, dataset regolamentati o comportamenti interni dei sistemi che i team non vogliono vedere copiati nell'ennesima piattaforma.
La progettazione degli alert decide se il programma sopravvive
Il più grande errore operativo è inviare i punteggi di anomalia grezzi direttamente nella coda del SOC. Gli analisti non rispondono ai punteggi, ma alle evidenze e al contesto.
Un alert efficace dovrebbe includere:
Cosa è cambiato, in linguaggio semplice
Perché è importante per questo utente, host, workload o dataset
Quanto è insolito rispetto alla baseline appresa
Quali modifiche correlate sono avvenute nelle vicinanze, nel tempo o nella sequenza
Quale percorso di risposta si applica all'interno dell'organizzazione
È anche qui che l'integrazione con SIEM e SOAR richiede misura. Non automatizzate ogni anomalia. Automatizzate prima l'arricchimento e l'instradamento prevedibili. Attivare il contenimento sulla base di segnali di anomalia deboli è il modo in cui i team perdono fiducia nell'intero programma.
Se state costruendo runbook attorno a questi alert, conta anche la pianificazione della risposta legale e del management. Una risorsa complementare pratica è questa guida alla risposta agli incidenti per le aziende di Washington, in particolare per le organizzazioni che devono allineare la gestione degli incidenti agli obblighi aziendali formali.
La valutazione deve rispecchiare le operations
Nelle discussioni di ingegneria si ama parlare di precision e recall. In produzione la domanda migliore è più semplice: questo alert aiuta il team ad agire più velocemente senza creare più lavoro di quanto ne faccia risparmiare?
Questo significa che dovreste valutare i rilevamenti in base a criteri operativi, non solo a metriche offline del modello:
Indagabilità. Un analista riesce a capire perché è scattato?
Responsabilità. C'è un team in grado di convalidarlo o di porvi rimedio?
Latenza. L'alert è arrivato abbastanza presto da essere utile?
Azionabilità. Corrisponde a un playbook, a un percorso di escalation o a un controllo?
Sostenibilità. Il team riesce a gestirne il volume?
Un programma di rilevamento delle anomalie ha successo quando gli analisti se ne fidano abbastanza da agire rapidamente sugli alert, non quando un modello appare elegante in un notebook.
Gestire i falsi positivi e la deriva dei modelli
La parte più difficile del rilevamento delle anomalie non è scoprire comportamenti insoliti. È mantenere il segnale utilizzabile dopo che l'ambiente è cambiato e il flusso di alert inizia ad accumularsi.
Il paradosso dei falsi positivi è un problema operativo
Molti fornitori presentano ancora i falsi positivi come un piccolo problema di calibrazione. Nelle operations aziendali reali sono un problema di personale e di fiducia. Questa analisi dell'alert fatigue nei sistemi di rilevamento delle anomalie osserva che fino al 60% degli alert di sicurezza viene ignorato perché il volume sommerge i team.
Questo dato dovrebbe cambiare il vostro modo di intendere un “buon rilevamento”. Se gli analisti ignorano la coda, anche gli alert tecnicamente accurati perdono valore. Un motore di anomalie rumoroso non si limita a far perdere tempo: può insegnare all'organizzazione a sottovalutare del tutto i comportamenti anomali.
La deriva dei modelli si presenta come cambiamento del business
La deriva dei modelli di solito non si annuncia come un problema di machine learning. Ha l'aspetto di un normale cambiamento aziendale.
L'introduzione di un nuovo SaaS cambia i pattern di autenticazione. Una fusione cambia il comportamento degli utenti. Una migrazione sposta i tempi dei workload. Il lancio di un prodotto cambia la forma del traffico. Se il sistema di rilevamento considera ancora normale la baseline del trimestre scorso, la qualità degli alert cala rapidamente.
Tra i fattori scatenanti più comuni della deriva:
Cambiamenti organizzativi, come nuovi team, spostamenti di ruolo o acquisizioni
Cambiamenti di piattaforma, come migrazioni al cloud, nuovi strumenti per gli endpoint o riprogettazioni dell'architettura
Stagionalità del business, dovuta a cicli finanziari, picchi di assistenza o variazioni della domanda regionale
Cambiamenti della telemetria, quando cambiano i formati di logging, la disponibilità dei campi o la qualità delle pipeline
Come mantenere il segnale utilizzabile
La soluzione non è allentare tutto finché gli alert non si fermano: così si creano punti ciechi. L'approccio migliore è un adattamento controllato.
Usate un mix di metodi:
Soglie adattive, così la normale variazione giornaliera e stagionale non genera rumore
Riaddestramento pianificato, legato ai cambiamenti dell'ambiente e non solo al calendario
Cicli di feedback degli analisti, per etichettare i falsi positivi persistenti e calibrare le feature
Alert a più livelli, così le anomalie a bassa confidenza arricchiscono i casi invece di chiamare gli analisti
Soppressione consapevole delle modifiche durante finestre approvate di manutenzione, rollout o migrazione
Un team maturo considera la calibrazione parte delle security operations, non un lavoro di pulizia dopo il deployment. Se la gestione della deriva non ha un responsabile, il programma di rilevamento delle anomalie si degrada senza che nessuno se ne accorga.
Casi d'uso aziendali e best practice per il 2026
Il rilevamento delle anomalie ripaga di più quando supporta decisioni che le persone devono già prendere sotto pressione. Ecco perché i casi d'uso più forti riguardano di solito minacce sottili, sistemi sensibili o modalità di guasto che non lasciano firme evidenti.
Dove il rilevamento delle anomalie aggiunge più valore
Spiccano tre schemi aziendali.
Il rilevamento delle minacce interne trae vantaggio da baseline contestuali. Un utente legittimo che fa qualcosa di illegittimo è difficile da intercettare con le sole firme. I cambiamenti nelle abitudini di accesso, nei tempi, nella gestione dei dati o nell'uso dei privilegi sono spesso più rivelatori di qualsiasi singolo evento.
L'attività delle minacce avanzate persistenti si presenta spesso come anomalia collettiva. I primi passaggi possono sembrare innocui. Ciò che conta è lo schema che attraversa autenticazione, movimenti e accessi graduali.
Il rilevamento di zero-day o di tecniche sconosciute è il punto in cui la deviazione dalla baseline giustifica il proprio budget. Se il comportamento è nuovo, la firma non aiuta. Un motore di anomalie può comunque far emergere la discrepanza tra comportamento atteso e osservato.
Il business case è solido quando il programma è gestito bene. Questa sintesi di ricerca sui risultati della sicurezza basata sull'AI riporta che le organizzazioni che adottano la sicurezza basata sull'AI identificano le violazioni 108 giorni prima e riducono il costo medio delle violazioni del 43%, da 4,44 a 2,54 milioni di dollari.
Per i team che vogliono vedere come il monitoraggio nel database supporti un rilevamento più precoce, questa guida su come rilevare in anticipo gli attacchi informatici nel vostro database è un utile punto di riferimento.
Best practice che reggono in produzione
Partite da un unico problema operativo. Accessi privilegiati, anomalie dei workload o movimenti sospetti di dati sono obiettivi iniziali migliori di una caccia generica alle anomalie.
Richiedete spiegabilità a livello di alert. Gli analisti hanno bisogno di contesto sufficiente per indagare rapidamente.
Mantenete i dati dove le policy dicono che devono restare. I vincoli di privacy e di residenza dovrebbero orientare l'architettura fin dall'inizio.
Progettate per la deriva fin dal primo giorno. Riaddestramento, adattamento delle soglie e cicli di feedback non sono facoltativi.
Misurate i risultati in termini di flusso di lavoro. Triage più rapido, meno indagini inutili e contenimento più precoce contano più dell'eleganza astratta del modello.
digna aiuta i team a rilevare le anomalie dove i loro dati risiedono già, con un approccio orientato alla privacy che viene eseguito negli ambienti controllati dal cliente invece di esportare dataset sensibili. Se vi serve un rilevamento delle anomalie che supporti flussi di lavoro operativi reali tra qualità dei dati, osservabilità e rilevamento delle modifiche rilevanti per la sicurezza, date un'occhiata a digna.
Domande frequenti
Che cos'è il rilevamento delle anomalie nella cyber security?
È la pratica di identificare i comportamenti che si discostano da ciò che i vostri sistemi, utenti, workload o pipeline di dati fanno normalmente. A differenza degli strumenti basati sulle firme, può far emergere attaccanti che usano credenziali legittime o che preparano lentamente l'esfiltrazione dei dati. L'articolo raccomanda di trattarlo come un sistema di baseline e deviazione, non come un rilevatore di minacce universale.
Quali sono i tre tipi di anomalie nella cyber security?
Sono le anomalie puntuali, contestuali e collettive. Un'anomalia puntuale è un singolo outlier evidente, come un picco di traffico in uscita. Un'anomalia contestuale è strana solo in relazione a orario, ruolo o posizione. Un'anomalia collettiva è una sequenza sospetta di eventi apparentemente normali, come una ricognizione lenta o un'esfiltrazione a basso volume.
Per la sicurezza è meglio il rilevamento delle anomalie statistico o basato sul machine learning?
I programmi maturi combinano entrambi invece di sceglierne uno. L'articolo suggerisce un ordine a livelli: prima una baseline statistica per le deviazioni grossolane, poi il machine learning non supervisionato per i comportamenti che non corrispondono ai profili appresi, quindi un livello di contesto con identità e criticità degli asset e infine un ciclo di feedback per il riaddestramento.
Come si riducono i falsi positivi nel rilevamento delle anomalie per la sicurezza?
Trattate i falsi positivi come un problema operativo, dato che fino al 60% degli alert di sicurezza viene ignorato quando il volume sommerge i team. Tra i controlli utili ci sono soglie adattive, riaddestramento legato ai cambiamenti dell'ambiente, cicli di feedback degli analisti, alert a più livelli che arricchiscono i casi invece di chiamare gli analisti e soppressione consapevole delle modifiche durante le finestre di manutenzione approvate.
Di quali sorgenti dati ha bisogno il rilevamento delle anomalie per la sicurezza?
Partite da log di rete, telemetria degli endpoint, log del cloud e della piattaforma ed eventi di identità, usando il contesto sulle minacce per l'arricchimento anziché per il rilevamento primario. La copertura di azioni, identità e asset conta più del volume grezzo, e la feature engineering, ad esempio sulle raffiche di login falliti o sui pattern di trasferimento, spesso conta più della scelta del modello.


